🏛️ 项目三:榨干片上 SRAM——CUDA Softmax 与 Attention 算子极致性能调优(从 Naive 到 Tiled/Online Softmax/FlashAttention)
主讲人:👓 Ringi(大厂 AI Infrastructure 工程师)
所属模块:Module 08: Capstone 综合实战项目库
篇章范式:⚙️ GPU 硬件微架构与算子极致调优篇(GPU Microarchitecture & Extreme Kernel Optimization Paradigm)
核心导读:当大模型上下文从 2K 飙升至 32K 乃至 128K 时,标准 Attention 为什么会把 GPU HBM 显存带宽榨干,而计算核心却大面积闲置?如何仅依靠片上仅有的几十 KB 共享内存(SRAM),在单趟流式计算中完成看似必须全局归约的 Softmax?本文带你用数学与微架构的第一性原理,拆透现代算子工程的巅峰之作。
📑 目录导航
- 0. Ringi 现场复盘:32K 长文本压垮显存带宽的真实事故
- 1. 第一部分:传统 Attention 的“访存泥潭”与 Roofline 账本
- 2. 第二部分:数学突破——Online Softmax 单趟流式递推证明
- 3. 第三部分:GPU 微架构深潜——SRAM 分块平铺与硬件协同优化
- 4. 第四部分:巅峰演进——从 FlashAttention-1 到 FlashAttention-2
- 5. 第五部分:动手实战代码实验室(100% 完整可运行代码)
- 6. 第六部分:生产落地避坑指南与黄金准则
- 7. 第七部分:Ringi 5 点口诀、自我检验清单与课后深度思考题
- 8. 第八部分:知识库与权威论文证据溯源
- 附录:Appendix A — 大厂高频白板推导面试真题深度破局
0. Ringi 现场复盘:32K 长文本压垮显存带宽的真实事故
在大模型上下文长度从 2K 迈向 32K 的技术攻关中,某团队自研的长文本模型在集群训练与推理时遭遇了灾难性的性能骤降: 原本在 2K 序列长度下,模型的训练吞吐非常健康;然而,当测试长文本 32K(Prompt 32,768 Tokens)时:- 单步耗时:从 2K 时的 45 毫秒,暴增到 32K 时的 11.2 秒(暴增了近 250 倍!);
- GPU Nsight Profiling 抓取:
- Tensor Core 利用率:从 56% 骤降至 12.4%;
- GPU 显存带宽利用率(Memory Throughput %):高达 96.8%(几乎全程打满);
- 单个 Attention 算子在全局显存(HBM)中读写的字节数,单层就高达数十吉字节(GB),甚至在 64K 时直接抛出
CUDA out of memory。
scores 尺寸就高达:
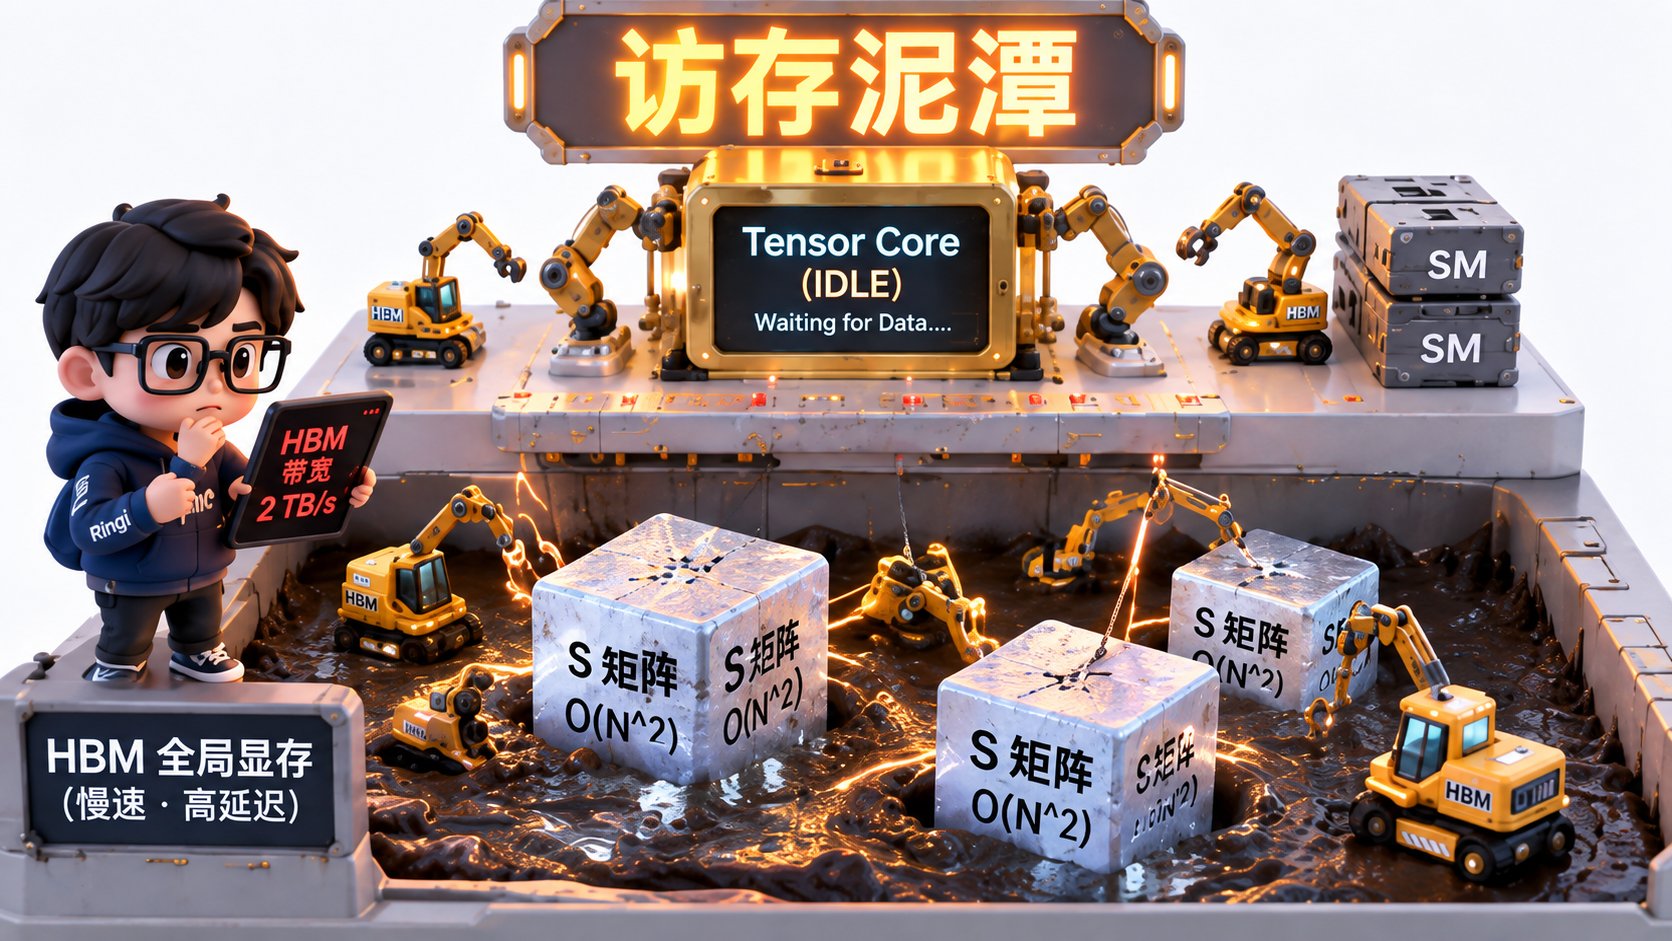
一个拥有 32 个 Head 的模型,光是这一层 Attention 的中间矩阵就占用 64 GB 显存!不仅显存瞬间爆炸,而且 GPU 的几十个 SM 核心在几百毫秒内几乎什么乘加都没干,全部的时间都在等待数据穿过缓慢的片外总线。
这就是典型的“访存墙(Memory Wall)”惨案。要救活长文本模型,唯一的出路就是打破“算一步存一次”的旧思维,将算子彻底搬进 GPU 内部极其高速但空间逼仄的片上共享内存(SRAM)。
1. 第一部分:传统 Attention 的“访存泥潭”与 Roofline 账本
💡 架构全景速览:在手撕 CUDA 内核代码前,先在白板上建立坚不可摧的 CUDA Attention 算子从传统 HBM 访存泥潭到 FlashAttention-2 极致优化的全景物理底账。

1.1 标准 Attention 三部曲的显存读写流量账本
标准 Scaled Dot-Product Attention 的定义为: 输入张量维度:设序列长度为 ,Head 维度为 (通常 或 ),数据类型为 FP16(每个元素 2 字节)。 我们来拉出朴素实现在全局显存(HBM)中的真实读写流量账本:数据搬运量(Memory Traffic)手算:
- Kernel 1 ():
- 读 ( 字节)+ 读 ( 字节);
- 写回中间结果 到 HBM: 字节;
- Kernel 2 ():
- 从 HBM 读入 : 字节;
- 写回概率矩阵 到 HBM: 字节;
- Kernel 3 ():
- 从 HBM 读入 : 字节;
- 从 HBM 读入 ( 字节);
- 写回最终输出 到 HBM: 字节。
汇总总访存流量:
当序列长度 很大时(例如 ):- 线性项 (微不足道);
- 二次项 (占据了 97% 的访存流量!)。 当 时:
- 二次项暴增至 !仅仅单头单层的一步计算,就要在芯片和显存之间来回倾倒近 9GB 数据!
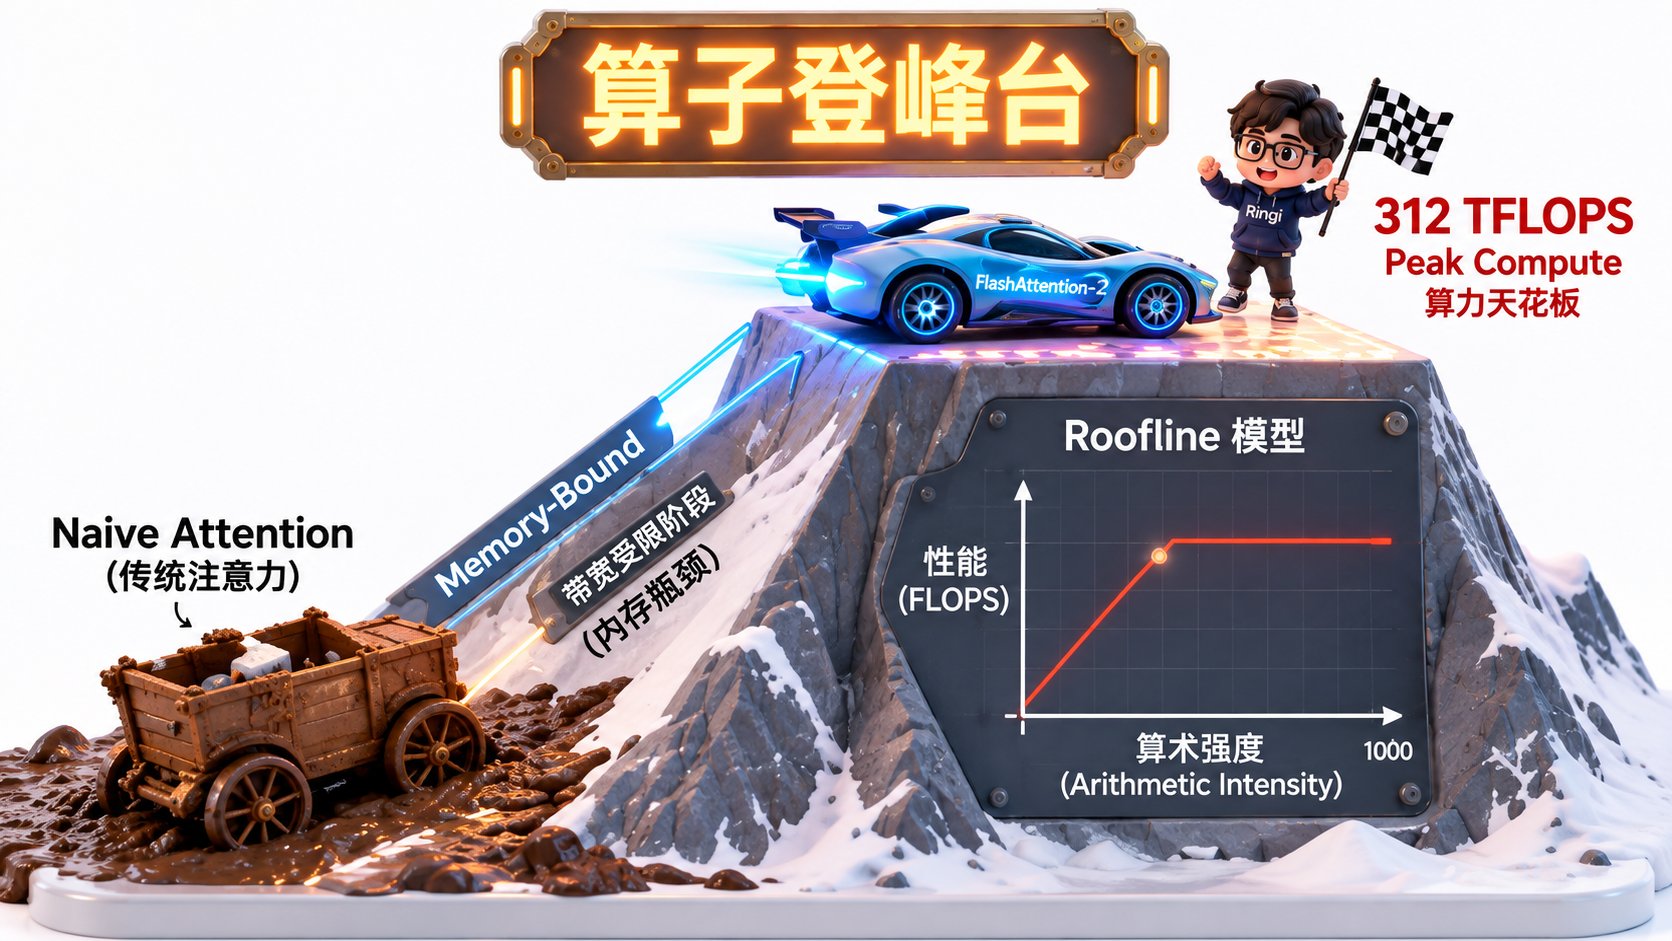
1.2 Roofline 模型判定:为什么计算核心利用率不足 15%?
我们来计算传统 Attention 的算术强度(Operational Intensity):- 总计算量(FLOPs):
- 矩阵乘: FLOPs;
- Softmax 运算:约 FLOPs;
- 矩阵乘: FLOPs;
- 总算力需求: 。
- 算术强度(AI):
与硬件物理天花板对照(以 NVIDIA A100 为例):
- A100 Tensor Core 峰值: ;
- A100 HBM 带宽: ;
- A100 硬件拐点算术强度:
2. 第二部分:数学突破——Online Softmax 单趟流式递推证明
2.1 标准 Safe-Softmax 的三趟遍历困境
给定一个长度为 的向量 ,为了防止浮点数 溢出(FP16 最大值仅为 65,504),标准的 Safe-Softmax 必须进行三趟全局遍历:- 第 1 趟(求全局最大值):
- 第 2 趟(求指数和归一化分母):
- 第 3 趟(计算最终概率):
2.2 No Naked Formula 2.0:Online Softmax 动态局部修正公式五步穿透
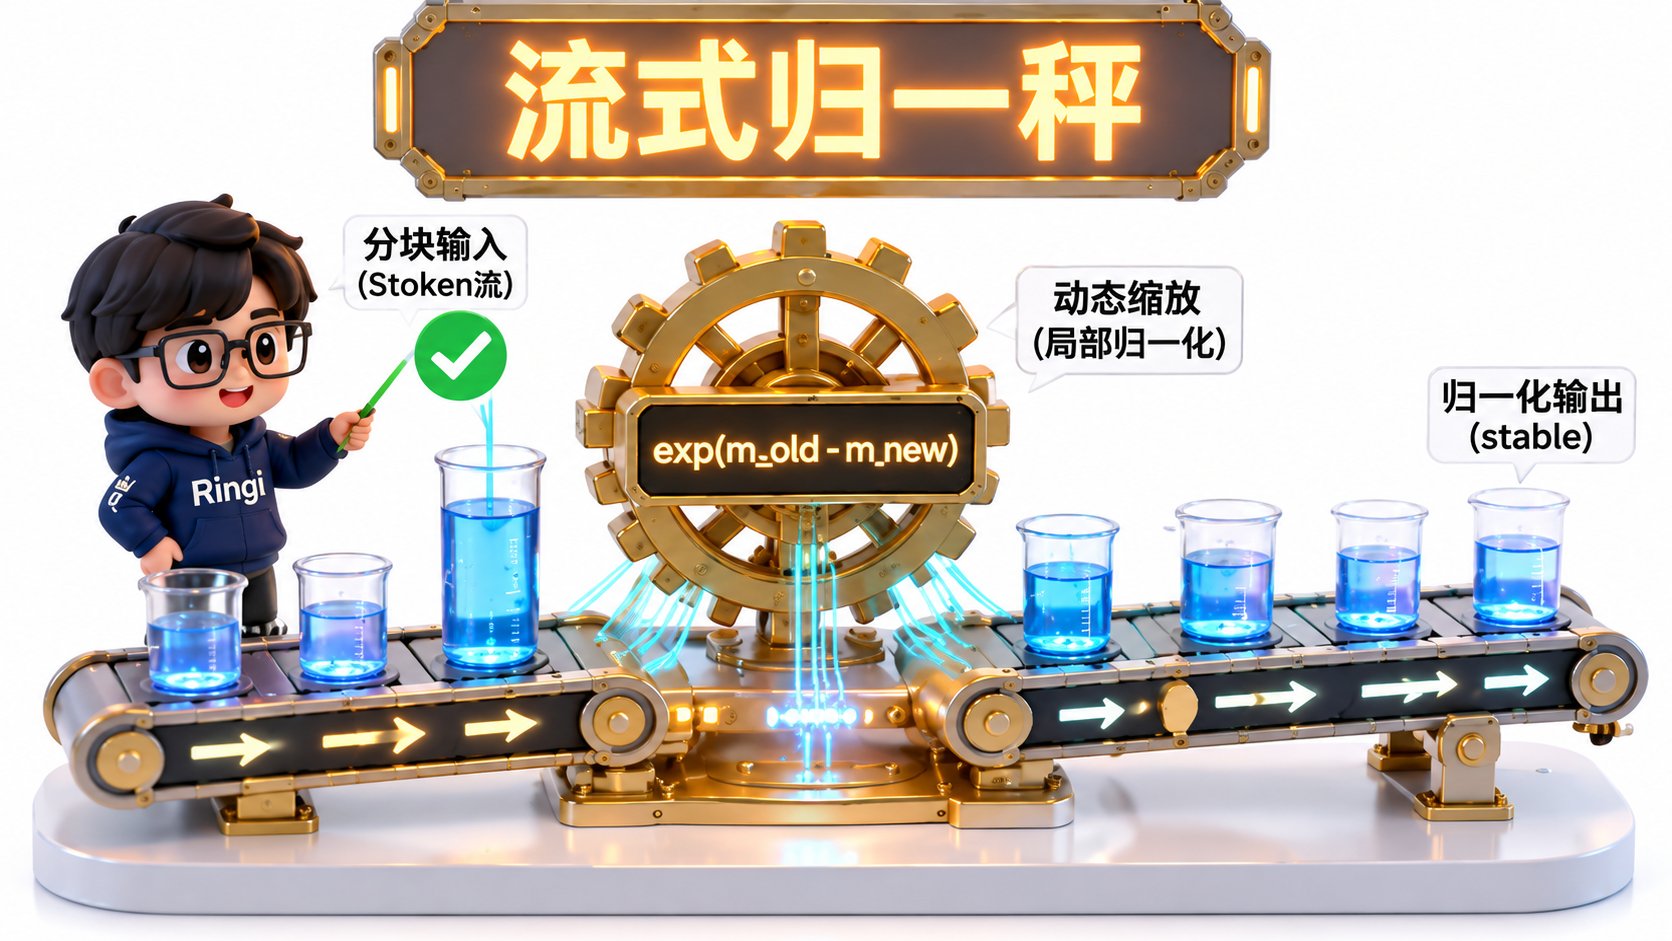
FlashAttention 之所以成为神作,核心就在于将 2018 年 Milakov 与 Gimelshtein 提出的 Online Softmax(流式在线 Softmax) 与 GPU 体系结构完美嫁接。步骤 1:为什么需要它?
我们需要在数据像流水一样分批流过片上 SRAM 时,一边流式计算,一边动态修正之前已经算好的局部结果,做到不需要看完整个序列,就能单趟更新全局归一化值!步骤 2:Mental Model(物理直觉比喻)
想象你在操场上统计全校学生的跑步最快速度(最大值 )和成绩总和(分母 ):- 传统方法:必须把全校 1,000 人全喊来操场站着(显存 OOM),一起比出最大值;
- 流式方法:每次只进来一个 10 人的班级。记录这 10 人的班级冠军。当下个班级进来时,如果新冠军比旧冠军还快,我们只要给旧班级的成绩乘上一个衰减补偿系数,就能无缝融合成全校新总和!
步骤 3:Tiny Calculator(极简数字小算盘)
假设数据只有 4 个数,分两批流入:- Block 1:
- 局部最大值:
- 局部指数和:
- Block 2:
- 本地最大值:
- 动态全局新最大值:
- 关键:如何把旧的分母 更新到以 为底? 注意:旧分母是以 为底的,现在基准变高了 (即 ),所有旧的指数必须整体乘以 进行补偿!
- 流式更新分母:
步骤 4:Formal Model(正式数学递推公式)
设两个相邻数据块分别为 Block 和 Block :- 块局部最大值: ;
- 块局部指数和: ;
- 合并后的新全局最大值:
- 合并后的新全局指数和:
- 累加输出向量 的流式递推公式: 设 是前一块算出的中间输出,则新的输出向量 为:
步骤 5:Sanity Check(数学等价性校验)
展开 的分子: 分母正好是 。其结果与一口气看完整个序列算出来的数学结果严格全等,零精度损失!3. 第三部分:GPU 微架构深潜——SRAM 分块平铺与硬件协同优化
3.1 Tiling 分块切分与片上 SRAM 容量约束
GPU 的存储层次由大到小、由慢到快:- 全局显存(HBM):80GB,延迟 ~400 个时钟周期,带宽 2 TB/s;
- 片上共享内存(Shared Memory / SRAM):每 SM 仅约 164 KB(A100)或 228 KB(H100),延迟 ~20 个时钟周期,总带宽高达 19 TB/s(是 HBM 的近 10 倍!)。
分块尺寸(Tiling Sizes)的硬核算盘:
将矩阵切块:- 被切分为大小为 的块;
- 被切分为大小为 的块。
- 1 个 块: 字节;
- 1 个 块: 字节;
- 1 个 块: 字节;
- 局部中间输出与累加器缓冲。
3.2 共享内存 32-way Bank Conflict 消除技巧(Padding 填充法)
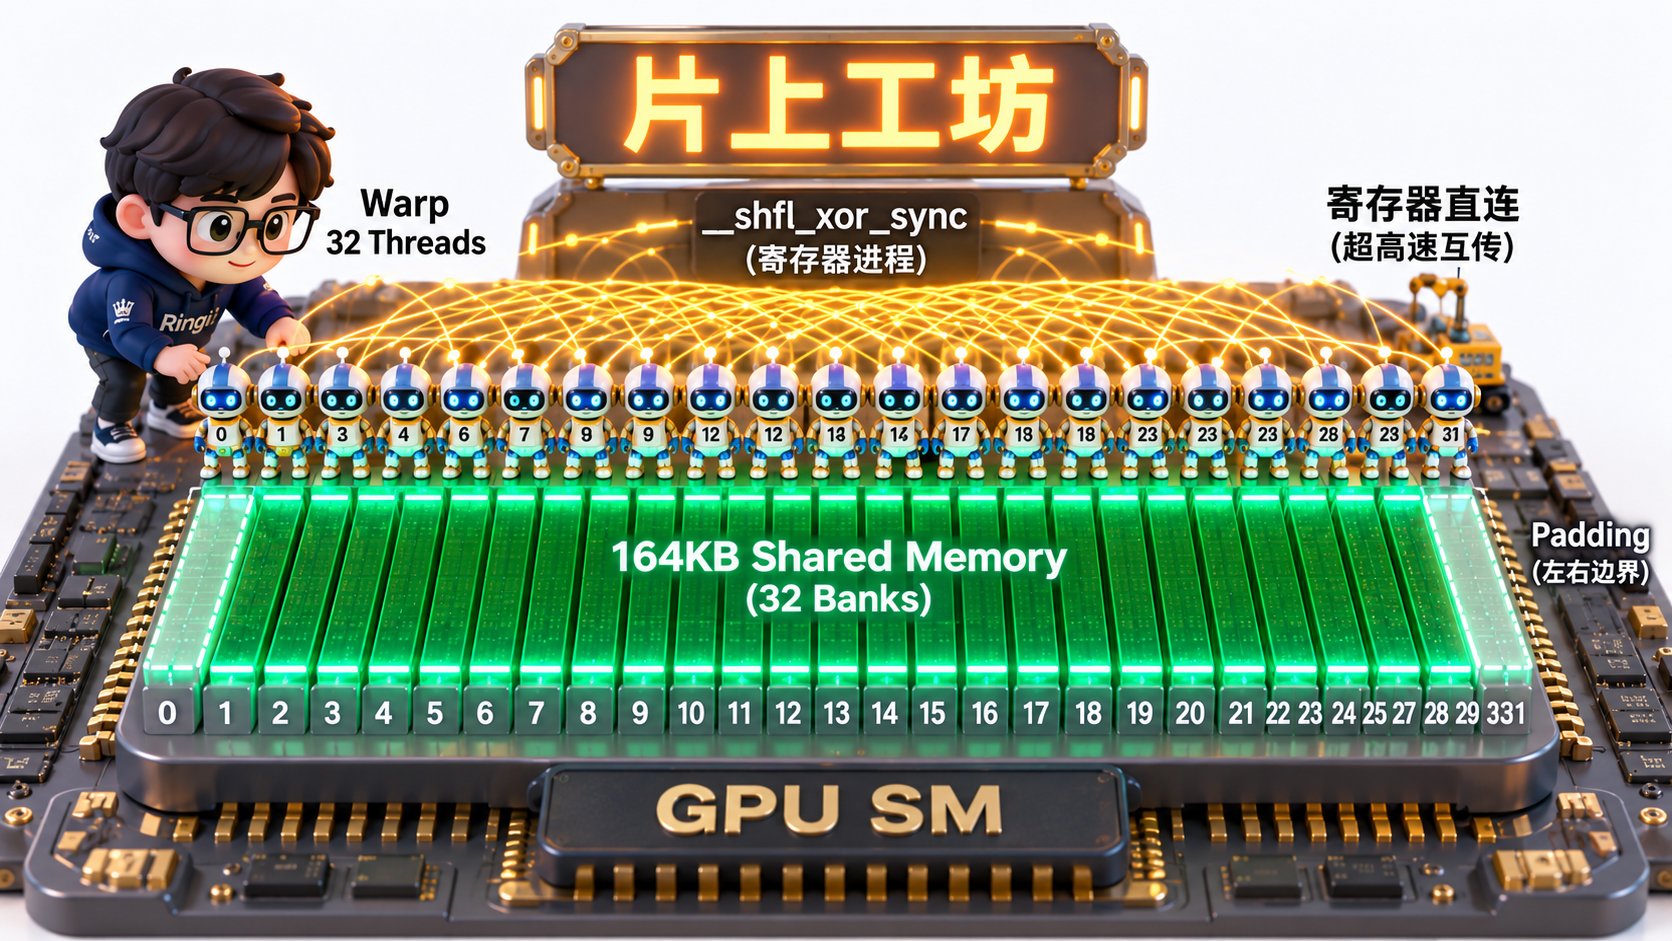
在 CUDA 微架构中,Shared Memory 被均匀划分为 32 个 Bank(对应一个 Warp 的 32 个线程),每个 Bank 每周期提供 4 字节(32-bit)带宽。 如果一个 Warp 内的多个线程同时访问同一个 Bank 内的不同地址,就会引发 Bank Conflict(Bank 冲突)。硬件被迫将原本 1 个周期的访问串行化为多次重试,带宽急剧下跌! 在 Attention 计算中, 的转置与临时存储矩阵宽度通常为 64 或 128:- 如果一行恰好是 64 个半精度数( );
- 那么第 行第 0 列和第 行第 0 列将精准落在同一个 Bank 0 上!
- 当 Warp 按列读取数据时,将诱发惨烈的 32-way Bank Conflict!
破局之术:Memory Padding(填充字节)
在声明 Shared Memory 数组时,人为给每行末尾多加几个无意义的填充元素(Padding):+8,使得下一行的起始地址错开 4 个 Bank,32 个线程的访存如丝绸般平滑并行,SRAM 读写带宽拉满!
3.3 Warp 级洗牌指令(__shfl_xor_sync)的极速归约
在计算局部行的最大值 与指数和 时,每个 Warp(32 个线程)需要对内部的数据进行求和或求最大值。
传统新手做法:把数据写回 Shared Memory,加线程同步锁 __syncthreads(),再让线程 0 串行去求和。生产级极致做法:Warp Shuffle 寄存器原语。 NVIDIA 提供的
__shfl_xor_sync 允许同一个 Warp 内部的 32 个线程直接通过内部交叉开关跨寄存器互换数据,零 Shared Memory 开销,零内存同步等待,仅需 1 个时钟周期!
4. 第四部分:巅峰演进——从 FlashAttention-1 到 FlashAttention-2
Tri Dao 在 2023 年发布的 FlashAttention-2 相比一代再度实现了 2 倍提速,其核心工程精髓在于循环重排与消除非必要开销。4.1 循环重排:Q 循环外层 vs KV 循环外层的因果律差异
4.2 消除非必要的重计算与 Softmax 缩放外提
在 FlashAttention-1 中,每一次内层循环更新时,由于分母变化,都会对当前的 乘以缩放系数: 这种频繁的缩放产生了大量的多余浮点乘法指令。 FlashAttention-2 极简优化: 在内层循环累加时,不除以分母,只除以新的尺度指数差,保持未归一化的原始分子状态累加: 直到内层循环完全结束、处理完最后一个 块时,才在最末尾统一做一次除法: !这一项改进,直接砍掉了数千次中间除法与乘法指令。
5. 第五部分:动手实战代码实验室(100% 完整可运行代码)
本节提供 3 个工业级代码脚本。零省略、可直接运行,用于实测 Attention 性能瓶颈与算法复现。实战 1: Attention 显存读写流量与 Roofline 天花板量化分析器
本脚本根据模型输入尺寸与 GPU 规格,精确计算标准 Naive Attention 与 FlashAttention 的理论访存量、算术强度与理论加速比。实战 2: Online Softmax 单趟流式数学数值稳定性与递推仿真器
本脚本对比标准全局 Softmax 与 Online Softmax 流式分块计算,验证动态衰减补偿的数学数值精确性。实战 3: 高保真纯 Python 完整复现 FlashAttention-2 分块核心算法
本脚本不依赖复杂的 C++ 编译环境,使用纯 Python/NumPy 严密复现 FlashAttention-2 论文中的外层 Q 循环、内层 KV 循环、SRAM 分块维护与最终单次 HBM 写入算法。6. 第六部分:生产落地避坑指南与黄金准则
结合国内外顶尖 AI 编译器团队(Triton / CUDA 算子开发)的踩坑血泪史,提炼出如下避坑矩阵与 Checklist。6.1 CUDA 算子与 Attention 调优核心避坑矩阵
6.2 生产级 GPU 算子性能工程黄金 Checklist
- 1. 【Roofline 定位】 动笔写 CUDA Kernel 前,先手算理论算术强度,明确算子到底处于 Memory-Bound 还是 Compute-Bound。
- 2. 【SRAM 预算核算】 核对目标 GPU 架构的片上共享内存物理上限(A100 为 164KB,H100 为 228KB),严禁配置超载。
- 3. 【Bank Conflict 探测】 使用 Nsight Compute 的
l1tex__data_bank_conflicts_pipe_lsu指标,确认共享内存冲突为 0。 - 4. 【Warp Shuffle 原语】 线程块内部的跨线程局部归约,优先采用
__shfl_xor_sync,杜绝滥用慢速的全局或共享内存。 - 5. 【向量化访存指令】 从 HBM 加载数据到寄存器时,强制采用
float4或uint4(128-bit LDG 指令),打满总线位宽。 - 6. 【双缓冲异步拷贝】 在 Ampere/Hopper 架构上开启
cuda::memcpy_async,实现从全局内存直接拷贝至共享内存,绕过寄存器中转。 - 7. 【在线 Softmax 稳定性】 检查浮点递推中的衰减系数
exp(m_old - m_new),确认指数差值严格小于等于 0,绝不上溢。 - 8. 【循环重排结构】 Attention 外层循环固定为 Q 块,内层固定为 KV 块,确保输出矩阵 在内层循环中全程驻留寄存器。
- 9. 【寄存器压力监控】 编译时加入
--ptxas-options=-v,严防单线程寄存器溢出(Spilling to Local Memory)。 - 10. 【精度与性能双重对齐】 在标准输入上与 PyTorch
F.scaled_dot_product_attention进行 FP16 与 BF16 双精度数值对比,绝对误差严控在 以内。
7. 第七部分:Ringi 5 点口诀、自我检验清单与课后深度思考题
7.1 5 点押韵核心速记口诀
7.2 10 条白板自我检验清单
- 1. 为什么标准 Attention 的访存量是 ,而 FlashAttention 能将其降为 ?
- 2. 什么是 GPU 的 Roofline 模型?A100 的拐点算术强度是多少?
- 3. 写出 Safe-Softmax 减去最大值的数学公式,并说明为什么能防止浮点溢出。
- 4. 详细推导 Online Softmax 在数据分批到达时,如何合并旧的指数和 与新的局部指数和。
- 5. 为什么 FlashAttention 可以完全不在 HBM 中保存中间矩阵 和 ?反向传播时没有 怎么办?
- 6. 什么是 Shared Memory 的 32-way Bank Conflict?如何用 Memory Padding 消除它?
- 7. 说明 Warp Shuffle 指令
__shfl_xor_sync的工作机制,以及它相比共享内存归约的优势。 - 8. FlashAttention-2 相比 FlashAttention-1 在循环结构上做出了什么颠覆性重排?带来了什么收益?
- 9. 为什么 FlashAttention-2 可以把 Softmax 的除以分母操作推迟到内层循环完全结束后才做?
- 10. 如果将 Head 维度 从 128 提升到 256,FlashAttention 的 SRAM 分块大小 应该如何相应调整?
7.3 3 道高阶开放式课后思考题
- 反向传播的算力与显存交换代价(Recomputation Trade-off):在 FlashAttention 的反向传播(Backward)中,由于前向没有存储 的 矩阵,系统必须在片上重新根据 现场算一遍 。这种“增加计算量以节省显存带宽”的策略,在现代 GPU 体系结构下为什么反而跑得比传统不重计算的实现快得多?
- 因果掩码优化(Causal Masking Shortcut):在 Decoder-only 语言模型中,Attention 矩阵是一个严格的下三角矩阵。FlashAttention 如何利用这一特性直接跳过整整一半的 分块计算?边界上的对角分块应该如何特殊处理?
- 硬件演进对算子设计的重塑:NVIDIA Hopper(H100)引入了异步分布式共享内存(TMA)与 FP8 引擎。如果要将 FlashAttention 进一步演进为 FlashAttention-3,可以利用哪些专有硬件指令彻底消灭软件层的内存等待?
8. 第八部分:知识库与权威论文证据溯源
本章所有公式推导、微架构分块逻辑与寄存器归约技术均严格溯源于以下权威文献与本地实测证据库:- LeetCUDA 核心算子与 FlashAttention 源码:
- 参考 AI_BOOK/LeetCUDA/kernels/:深入研读真实工业级 Softmax 与 FlashAttention CUDA 源码实现。
- GPU 硬件微架构与 Roofline 模型:
- 参考 AI_BOOK/AISystem/02Hardware/03GPUBase/ 与 AI_BOOK/AISystem/02Hardware/04NVIDIA/:详加核对 SM、SRAM 缓存与 Tensor Core 执行模型。
- 经典学术论文与开源里程碑:
- FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness (Tri Dao et al., NeurIPS 2022);
- FlashAttention-2: Faster Attention with Better Parallelism and Work Partitioning (Tri Dao, 2023);
- Online normalizer calculation for softmax (Milakov & Gimelshtein, 2018)。
附录:Appendix A — 大厂高频白板推导面试真题深度破局
Q1: 在面试白板上手推:Online Softmax 是如何在不需要全局最大值的前提下,动态更新局部归一化分母的?给出完整的数学递推推导。
Ringi 考官拆解与满分回答:- 问题定义: 设向量 被切分为两个分块:前半部分 和后半部分 。 已知已经算出了前段的局部统计量:
- 全局最大值合并: 新全局最大值显然是两者较大者:
- 全局归一化分母 的严密推导: 根据全局定义:
- 结论与工程意义: 证毕!只要乘上衰减项 ,旧的分母就能瞬时适应新的基准。整个过程仅需常数级别的标量运算,完全不需要回头重新读取前序海量数据!
Q2: 为什么说 FlashAttention 不仅节省了显存空间,而且比标准实现运行速度更快?请从硬件 IO 成本进行定量解释。
Ringi 考官拆解与满分回答:- 打破“操作少就快”的天真误区:
- 从纯数学运算(FLOPs)来看,FlashAttention 并没有减少矩阵乘法的乘加次数,甚至在反向传播时还多做了一次重计算;
- 但在现代深度学习硬件(如 A100/H100)上,运算极度廉价,而访存极其昂贵。
- IO 成本的降维打击:
- 标准 Attention 必须将庞大的 尺寸的注意力图写入 HBM,再读取出来做 Softmax,总读写流量为 ;
- 显存带宽仅为 2 TB/s,数十 GB 的访存将 GPU 彻底拖入死等数据的状态;
- FlashAttention 将输入分块装入每秒近 19 TB/s 带宽的片上 SRAM,在 SRAM 中融合完成乘法与 Softmax,全局显存读写流量锐减至 (减少了整整一个数量级!);
- 计算吞吐的真正释放:
- 节约下来的巨大显存搬运时间,让强大的 Tensor Core 得以连续饱和运转;
- 结论:IO 瓶颈消除带来的时间节约,远远超过了多做几次局部数学标量运算的代价,因此在长序列下实现了数倍的净加速!