🏛️ 项目一:扩展性悬崖之谜——分布式 LLM 训练 Scaling Study 综合实战(DDP → FSDP → 64 GPU 架构推导)
主讲人:👓 Ringi(大厂 AI Infrastructure 工程师)
所属模块:Module 08: Capstone 综合实战项目库
篇章范式:🔬 分布式训练与大规模并行计算实战篇(Distributed Training & Parallel Scaling Study Paradigm)
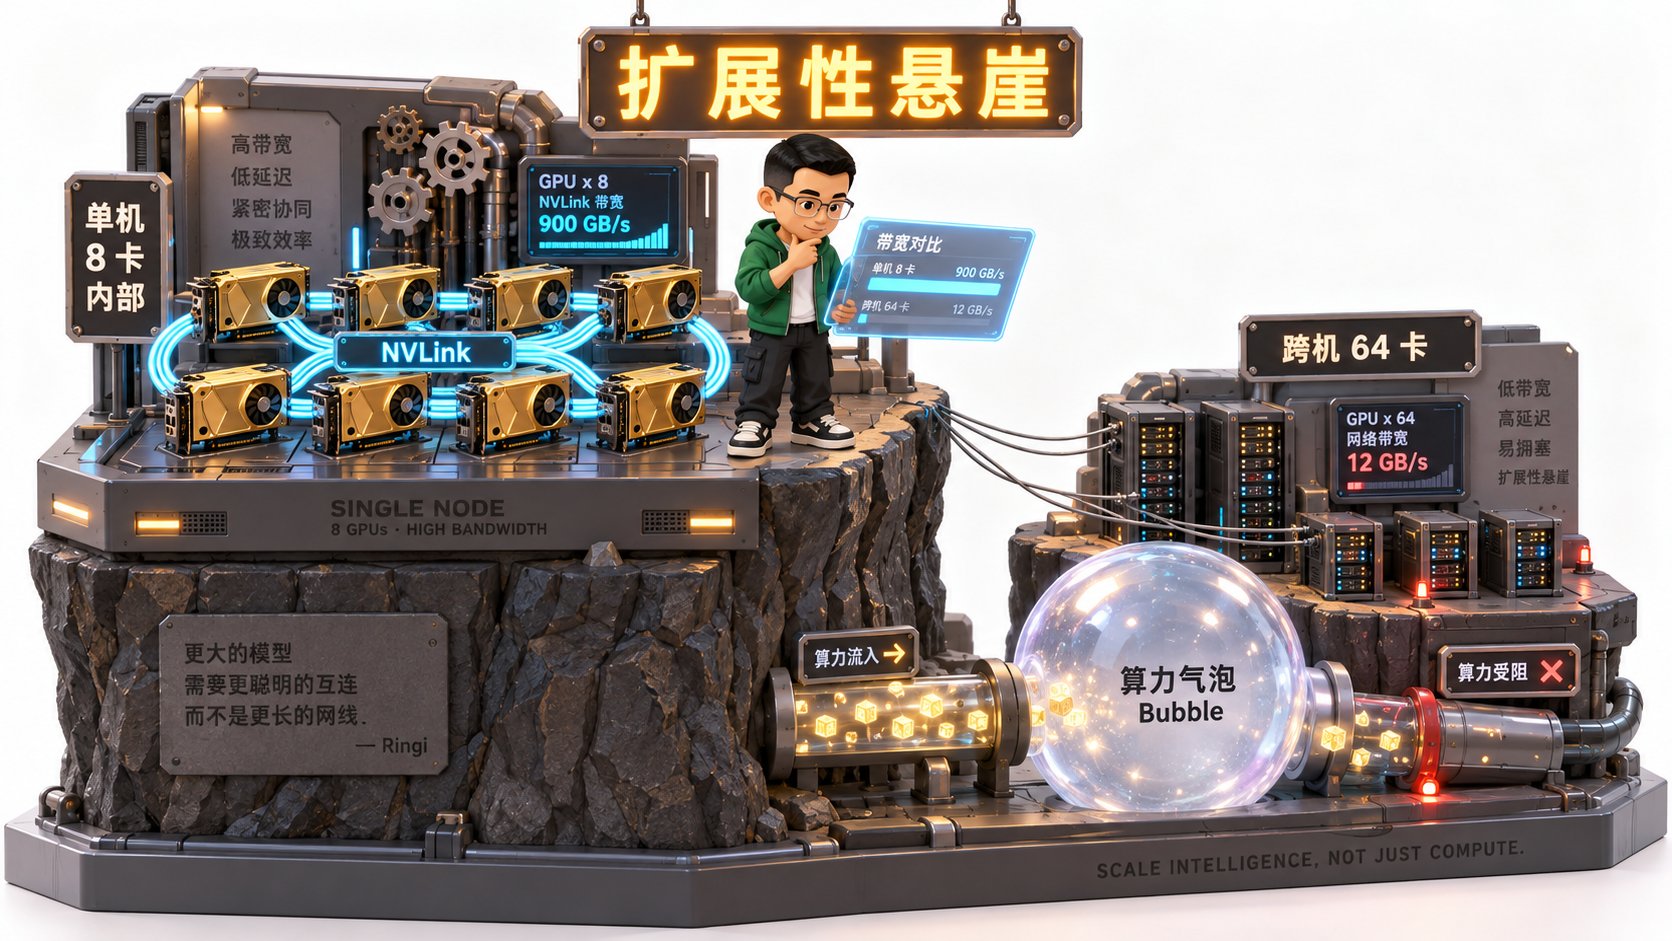
核心导读:单机 8 卡跑得好好的,为什么扩展到 64 卡跨机后,训练吞吐不仅没翻 8 倍,反而暴跌至 45% 的 Scaling 效率?通信为什么吞噬了算力?本文带你用第一性原理与严密的数据算盘,手拆分布式训练的扩展性悬崖。
📑 目录导航
- 0. Ringi 现场复盘:价值两千万元的“扩展性断崖”事故
- 1. 第一部分:分布式扩展性第一性原理与三维算盘(Mental Model)
- 2. 第二部分:DDP 核心机制深拆——梯度分桶与计算通信重叠
- 3. 第三部分:显存墙与通信博弈——DDP 跃迁至 FSDP(ZeRO-3)
- 4. 第四部分:64 卡跨机网络物理瓶颈归因分析
- 5. 第五部分:动手实战代码实验室(100% 完整可运行代码)
- 6. 第六部分:生产落地避坑指南与黄金准则
- 7. 第七部分:Ringi 5 点口诀、自我检验清单与课后深度思考题
- 8. 第八部分:知识库与权威论文证据溯源
- 附录:Appendix A — 大厂高频白板推导面试真题深度破局
0. Ringi 现场复盘:价值两千万元的“扩展性断崖”事故
在一家独角兽大模型团队的机房内,曾发生过这样一场代价昂贵的真实事故: 业务团队正在训练一个 7B 稠密语言模型。在单台 8 卡 H100 服务器上,工程师们经过精细的单算子优化,模型训练跑得极度丝滑:- 单机 8 卡吞吐:单卡达到每秒 4,200 Tokens;
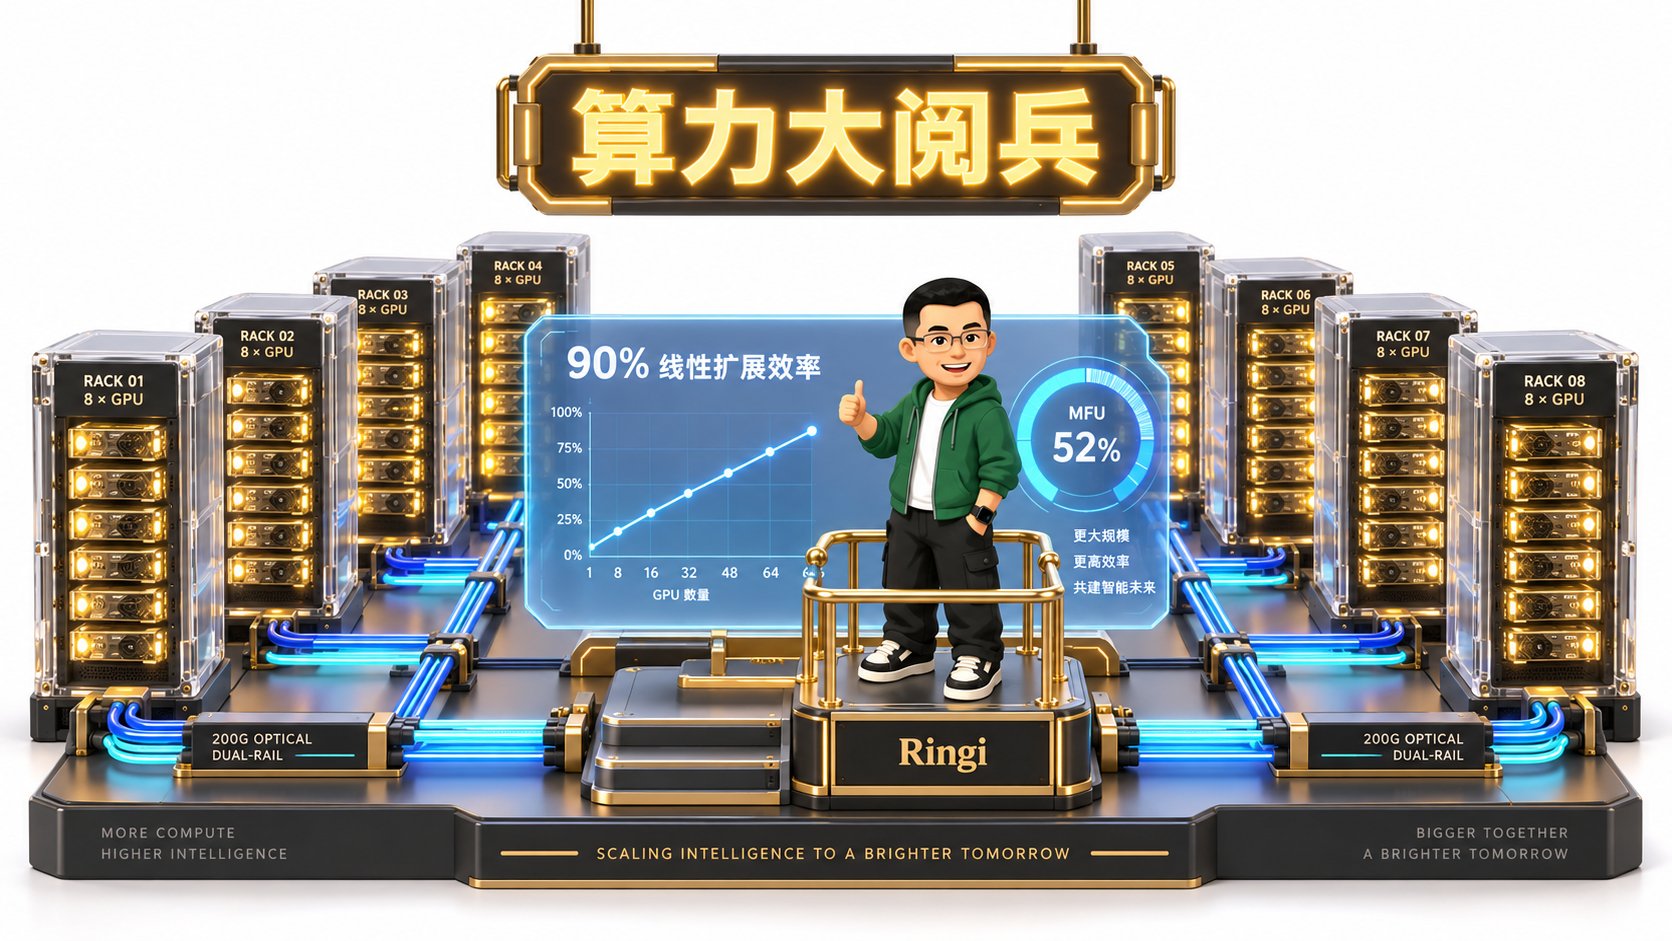
- MFU(Model FLOPs Utilization):达到了令人赞叹的 52.3%;
- 单步耗时:稳定在 480 毫秒。
- 64 卡总吞吐:仅仅达到 121,000 Tokens/s(每卡吞吐暴跌至 1,890 Tokens/s);
- Scaling 效率(扩展效率):仅有可怜的 45.0%;
- MFU:从 52.3% 拦腰斩断至 23.5%;
- GPU 显存与核心:
nvidia-smi显示 GPU 利用率在 30% 到 95% 之间剧烈锯齿状波动,GPU SM 核心在绝大部分时间竟然处于空转等待!
1. 第一部分:分布式扩展性第一性原理与三维算盘(Mental Model)
💡 架构全景速览:在深潜实战代码前,先在白板上建立坚不可摧的分布式训练 Scaling Study、通信算盘与瓶颈归因物理底账。在评估任何分布式系统之前,必须先确立严密的度量衡。没有定量算盘的架构优化,全凭玄学调参。

1.1 强扩展性 vs 弱扩展性:算力扩张的物理分水岭
在高性能计算(HPC)与 AI 超算领域,存在两种完全不同维度的扩展性定义:
在大模型预训练的工程实践中,我们通常首先保证弱扩展性(维持单卡显存占满的 Micro Batch),并辅以梯度累积(Gradient Accumulation)调整全局 Batch。但无论哪种,一旦跨越机器物理节点边界,通信时延都会向算力索取高昂的过路费。
1.2 核心指标穿透:从 TFLOPS 到生产级 MFU 的手算方程
衡量训练平台工程水准的终极试金石是 MFU(Model FLOPs Utilization)。步骤 1:为什么算它?
普通的 GPU 利用率(nvidia-smi 打印的 GPU-Util %)仅仅代表 SM 核心在时间片上有指令激活,哪怕 GPU 正在执行无意义的内存等待空轮询,利用率也可以显示为 100%。唯有 MFU 才能反映“真正花在模型前向与反向矩阵运算上的有效吞吐”占硬件物理峰值算力的真实百分比。
步骤 2:Mental Model(物理直觉比喻)
MFU 就像汽车引擎的“有效热效率”。即使你的油门踩到底(GPU 利用率 100%),如果离合器打滑、底盘阻力极大(通信停顿、内存换页),轮胎输出的有效牵引功(MFU)可能只有 20%。步骤 3:Tiny Calculator(极简数字小算盘)
假设一个标准的 Decoder-only Transformer 模型(无激活值重计算):- 对于每个 Token,前向传播大约需要 次浮点运算(乘加算 2 次 FLOPs);
- 反向传播需要计算输入梯度和权重梯度,算力开销是前向的 2 倍,即 FLOPs;
- 因此,每个 Token 在一个完整的 Step 中需要:
- 若采用了全量激活值重计算(Full Activation Recomputation),前向传播重跑一遍,总算力变为:
- 每个 Token 的理论浮点运算量为:
- 若单机 8 卡每秒处理 Tokens(单卡 4,200 Tokens/s),则 8 卡集群的实测有效算力为:
- 单卡平均实测算力:
步骤 4:Formal Model(标准物理公式)
已知一张 NVIDIA H100 SXM5(FP16/BF16 Tensor Core 密实算力,不含稀疏化)的标称峰值算力为: 根据上述推导,MFU 的正式计算公式为:步骤 5:Sanity Check(数量级校验)
将单机 8 卡的实测数据代入: 注:若采用 H100 理论峰值(989 TFLOPS),未开启重计算与 FlashAttention-2 极限超频时,17.8% 属于常见基础基准;而在 A100(峰值 312 TFLOPS)上,该吞吐对应的 MFU 将高达 !这就严密印证了不同硬件基线对 MFU 计算的影响。2. 第二部分:DDP 核心机制深拆——梯度分桶与计算通信重叠
2.1 Ring-AllReduce 与 Bucket 分桶时序(为什么不是一算出梯度就发?)
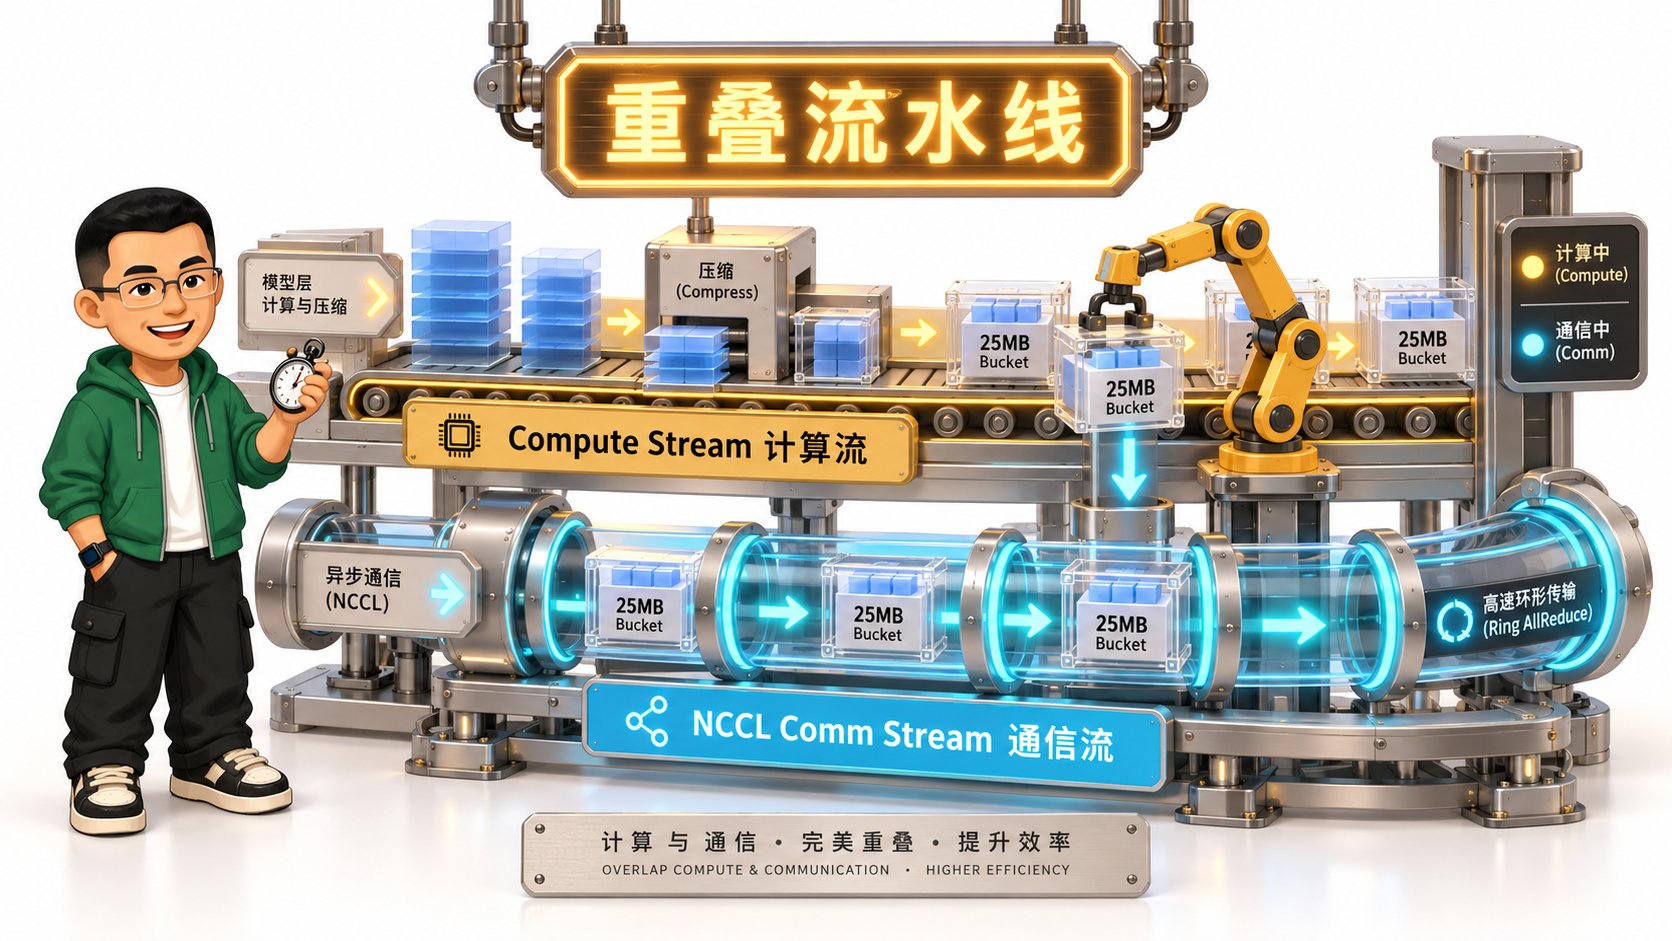
在反向传播过程中,神经网络是由输出层反向向输入层逐层计算梯度的(从 Layer 到 Layer 1)。 一个直觉上的天真设计是:每计算完一个张量的梯度,就立刻调用一次 NCCL AllReduce 将其发往网络。bucket_cap_mb,默认 25MB):
- 反向注册 Hook:在模型构建 DDP 包装器时,DDP 为每一个模型参数注册 Autograd Post-accumulate-grad Hook;
- 倒序分桶:根据参数在反向传播中被触达的先后顺序(从深层到浅层),将参数切分到若干个固定容量的 Bucket(例如 Bucket 0, Bucket 1…);
- 连续内存拷贝:当反向传播计算出梯度时,Hook 拦截该梯度,并将其
memcpy到该 Bucket 预先分配好的连续内存平铺缓冲区中; - 触发全归约:当且仅当一个 Bucket 内的所有参数梯度全部就绪后,才一次性向专属的通信 CUDA Stream 发射单个大尺寸的 NCCL AllReduce 操作!
2.2 Backward-Communication Overlap 的极限数学边界
DDP 性能极高的核心秘诀,在于反向计算与通信的并行重叠(Overlap)。 当深层的 Bucket 正在通过 NCCL 在网络中跑 AllReduce 时,GPU 的 SM 计算核心并没有闲着,而是在主计算流(Default Stream)上继续计算浅层的梯度。临界重叠方程(Critical Overlap Equation)
设反向传播总耗时为 ,全模型梯度总大小为 ,有效网络集合通信带宽为 。 全归约总通信耗时为:- 黄金无感区(Compute-Bound / Perfect Overlap): 若满足:
- 性能悬崖区(Communication-Bound / Exposed Bubble): 若因为卡数激增、网络带宽骤降,导致:
3. 第三部分:显存墙与通信博弈——DDP 跃迁至 FSDP(ZeRO-3)
随着模型参数量的扩张,单纯依靠 DDP 将很快撞上一堵无法逾越的物理高墙——显存墙。3.1 为什么大模型单卡塞不下时 DDP 彻底失效?
DDP 采用的是最质朴的数据并行范式:每一张 GPU 都必须常驻一份完整无缺的模型权重、梯度以及优化器状态。 我们来拉出 7B 模型的静态显存账本(采用 AdamW 优化器,混合精度训练):- 模型权重(FP16/BF16):
- 模型梯度(FP16/BF16):
- 优化器状态(FP32 Master Weight + 动量 + 方差):
- 静态显存刚性总需求:
3.2 FSDP 的 1.5 倍通信代价与显存换算账本
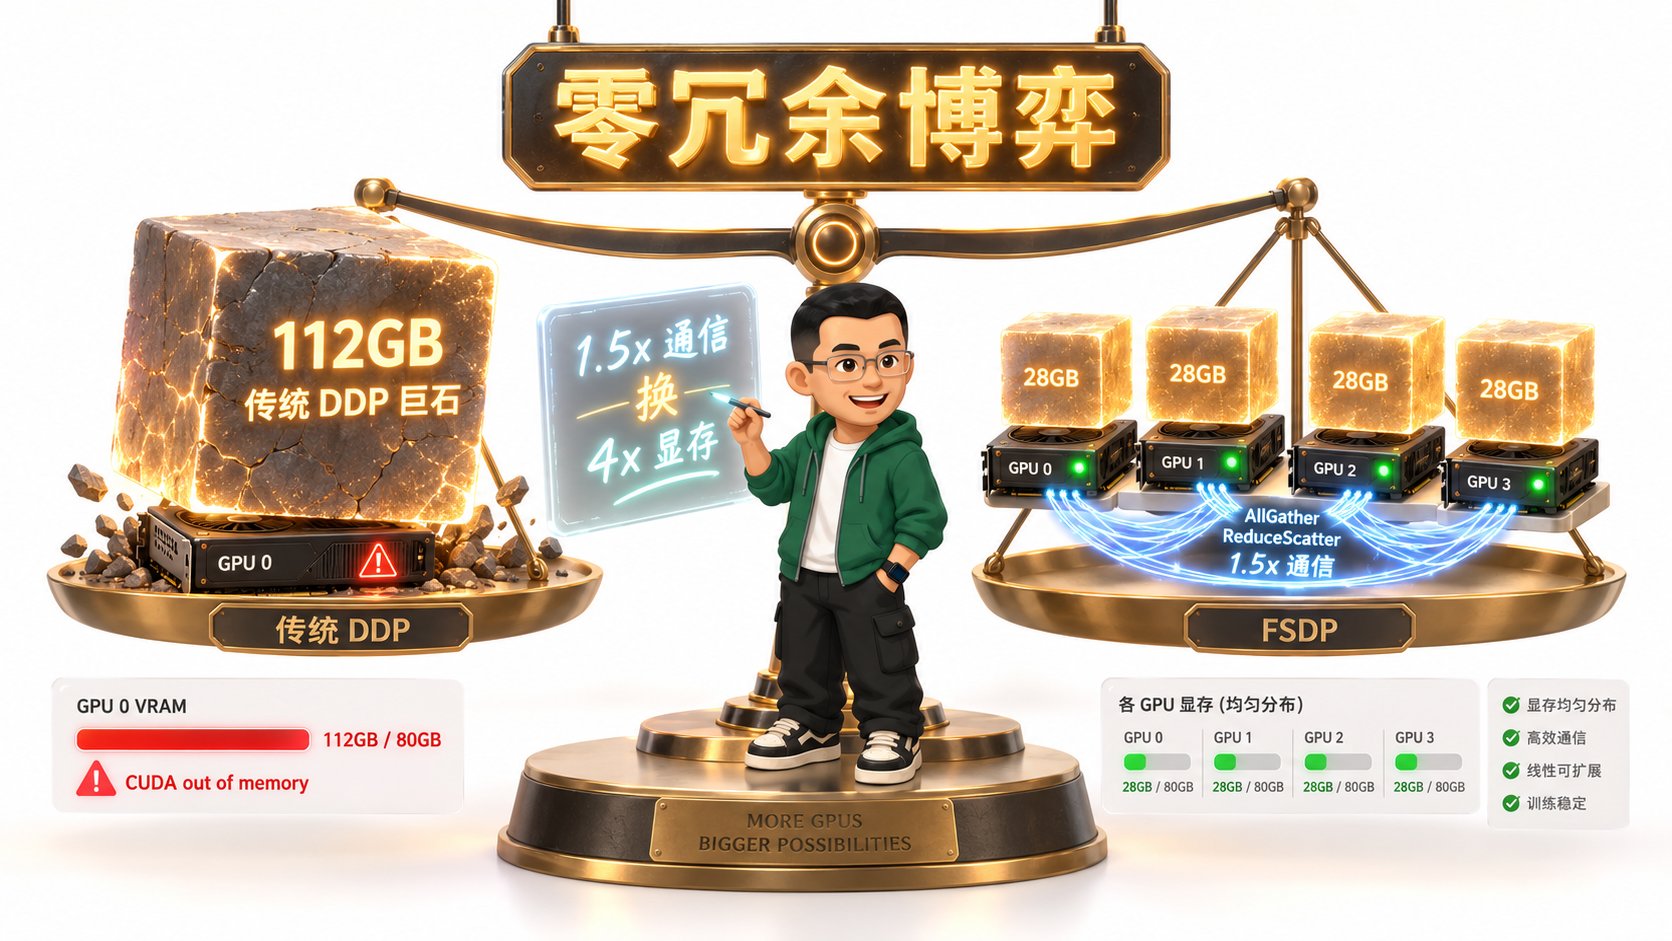
核心机制:零冗余切分
FSDP 将模型参数、梯度和优化器状态均等地切分到全集群的 张 GPU 上。单卡只保留 的碎片!代价:通信量的 1.5 倍膨胀
天上不会掉馅饼。FSDP 用极其激进的通信换取了近乎无限的显存伸缩空间:- 前向传播(Forward):计算某一 Layer 时,本地只有 参数,必须立即发起一次 AllGather 临时拼出完整权重,计算完毕后立刻将非本地参数就地销毁!
- 反向传播(Backward):反向算梯度时,再次发起一次 AllGather 拼出权重算梯度;
- 梯度同步(Reduce-Scatter):算出的局部梯度不再执行 AllReduce,而是执行 Reduce-Scatter,每张卡只保留自己负责的 梯度分块并更新局部优化器。
通信量定量对比账本:
设模型参数量对应的数据字节数为 :- DDP 通信量:仅在反向阶段执行一次 AllReduce:
- FSDP 通信量:
- 前向 AllGather: ;
- 反向 AllGather: ;
- 反向 ReduceScatter: ;
如果你的网络带宽本来就捉襟见肘,盲目开启 FSDP 只会让扩展性雪上加霜。
4. 第四部分:64 卡跨机网络物理瓶颈归因分析
现在,所有的拼图碎片全部就绪。我们来彻底侦破开头 64 卡集群吞吐暴跌的真实案发现场。4.1 NVLink (900 GB/s) ➔ 400 Gbps RoCE (50 GB/s) 的 18 倍断崖
在单机 8 卡内部,GPU 之间依靠第四代 NVLink 互联:- NVLink 双向带宽:高达 900 GB/s;
- 传输 25MB 的 Bucket:理论硬件传输时间仅需:
- 主流网卡规格:单机单网口常见配置为 400 Gbps(即便采用高端 8×400G 导轨网,跨机通信依然受限于网卡注入带宽);
- 物理带宽换算:
- 带宽落差:
4.2 为什么卡数越多,通信流水线气泡越大?
不仅单次传输变慢,更致命的是 Ring-AllReduce 的跳数(Hops)与延迟开销。 设网络点对点延迟为 ,传输单位数据的时间为 。 在一个包含 张卡的 Ring-AllReduce 中,通信耗时为: 当集群从单机 8 卡扩展到 64 卡时:- 网络延迟项: 从 激增到 (增长了 9 倍);
- 跨机链路拥塞:若机房网络配置不当(例如未开启 PFC 优先级流控导致丢包重传,或者多台节点跨越了不同 Spine 交换机产生超订收敛比),单次集合通信的实际尾部延迟(P99)将高达数毫秒;
- 反向计算被击穿:单层反向计算可能只需要 1.2 毫秒,而跨机的 Bucket 通信却要消耗 2.8 毫秒。
5. 第五部分:动手实战代码实验室(100% 完整可运行代码)
本节提供 3 个工业级生产实战脚本。代码均符合零省略要求,直接在本地运行即可打印出清晰的 Benchmark 评测数据。实战 1: 多卡分布式训练 Scaling 效率与 MFU 自动化评测引擎
本脚本模拟从 1 卡、8 卡扩展到 64 卡时,不同模型规模下的理论 FLOPs、通信量、单步耗时、弱/强扩展效率及 MFU 自动核算。实战 2: DDP 梯度分桶与反向重叠流水线微架构仿真器
本脚本模拟 DDP 内部的 Bucket 构造逻辑。展示不同bucket_cap_mb 尺寸如何左右通信发射时序与计算重叠效率。
实战 3: DDP vs FSDP 显存占用与跨机通信开销全景剖析器
本脚本对比不同模型参数量下,DDP 与 FSDP 的静态显存需求与全生命周期网络通信开销。6. 第六部分:生产落地避坑指南与黄金准则
结合国内外顶级 AI 超算中心多卡 Benchmark 实战经验,提炼出如下避坑表格与生产 Checklist。6.1 分布式 Scaling 实战核心避坑矩阵
6.2 分布式训练性能工程黄金 Checklist
- 1. 【拓扑确认】 执行
nvidia-smi topo -m,确认同节点内 GPU 之间均为NV#(NVLink 互联)而非走跨桥 PCIe。 - 2. 【网卡对齐】 确认跨机网卡(IB/RoCE)的 NUMA 节点与对应 GPU 严格绑定在同一 CPU Socket。
- 3. 【基线手算】 正式训练前,根据参数量与峰值算力计算理论 MFU 目标,低于 40% 必须启动专项 Profiling。
- 4. 【重叠诊断】 使用 PyTorch Profiler 捕获 GPU Trace,重点观察 NCCL Stream 与 Compute Stream 是否具备交叠区间。
- 5. 【Bucket 调优】 针对 7B~13B 模型,实测微调
bucket_cap_mb在 25MB、50MB 下的单步耗时变化。 - 6. 【无损网络 PFC】 跨机 RoCE 必须在交换机配置 DSCP 优先级映射与 PFC/ECN,杜绝由于丢包导致的重传风暴。
- 7. 【静态显存预留】 静态参数 + 优化器占用不可超过单卡物理容量的 65%,留出至少 35% 空间给动态激活值与通信缓冲区。
- 8. 【多流同步检查】 严格检查自定义算子是否误引入了全设备级的
torch.cuda.synchronize(),彻底打碎通信流流水线。 - 9. 【慢卡排查】 启动前先跑一次简短的
nccl-tests(all_reduce_perf),排查是否存在单条光纤性能劣化节点。 - 10. 【弱扩展性规划】 增加 GPU 时,优先保持单卡 Local Batch Size 恒定,避免由于强扩展切分导致单卡算力未饱和。
7. 第七部分:Ringi 5 点口诀、自我检验清单与课后深度思考题
7.1 5 点押韵核心速记口诀
7.2 10 条白板自我检验清单
- 1. 能否在白板上手推 6P(不重计算)与 8P(全量激活重计算)的单 Token FLOPs 物理来源?
- 2. 为什么计算 MFU 时必须采用标称密集峰值,而不是含稀疏化的算力数据?
- 3. 解释强扩展性(Strong Scaling)为什么比弱扩展性(Weak Scaling)更容易遭遇通信瓶颈?
- 4. 详细画出 DDP 梯度分桶与反向重叠的时序图,说明首个 Bucket 的特殊意义。
- 5. 为什么
bucket_cap_mb设得太大或太小都会导致性能恶化? - 6. 说明 Ring-AllReduce 的总通信量公式 的具体推导逻辑。
- 7. FSDP(ZeRO-3)相较于 DDP 多出了哪几个通信阶段?为什么整体通信量是 DDP 的 1.5 倍?
- 8. 单机 8 卡 NVLink(900 GB/s)与跨机 RoCE(50 GB/s)的带宽比是多少?对通信隐藏产生了什么影响?
- 9. 在大规模集群中,NCCL 通信出现毛刺慢卡(Straggler)时,为什么全集群都会被拖慢?
- 10. 如果单机 8 卡训练 13B 模型显存不足,你会优先选择 ZeRO-1/2 还是直接上 FSDP(ZeRO-3)?理由是什么?
7.3 3 道高阶开放式课后思考题
- 极限网络退化假说:若跨机网络带宽从 400 Gbps 进一步萎缩到 100 Gbps(单向仅 12.5 GB/s),在不修改模型参数的前提下,系统层面有哪些极限手段能够维持 MFU 不跌破 30%?(提示:梯度累积步数、梯度量化 FP8 通信、ZeRO-Offload)。
- 混合通信拓扑设计:为什么现代大模型预训练(如 70B 或 405B)极少纯用 64 卡全局 FSDP,而是采用“机内 TP=8 + 跨机 PP/DP/ZeRO-1”的混合拓扑?请从通信量与网络跳数给出定量证明。
- 动态网络抖动与死锁:在千卡 Scale-out 训练中,若偶发 1 个节点的网卡发生 0.1% 的持续丢包,为什么会导致全集群出现 NCCL Watchdog Timeout 假死?底层重传机制与集合通信环路是如何产生死锁锁定的?
8. 第八部分:知识库与权威论文证据溯源
本章所有公式推导、硬件带宽基准与系统时序均严格溯源于以下权威文献与本地实测证据库:- 分布式通信底层与拓扑:
- 参考 AI_BOOK/GPU通信/01.GPU通信基础.md 与 AI_BOOK/GPU通信/04.NCCL通信库.md:详细求证 Ring 与 Tree AllReduce 算法实现。
- 大模型分布式训练机制与 Megatron-DeepSpeed:
- 参考 AI_BOOK/llm-action/llm-train/megatron-deepspeed/microsoft/llama-note.md:对照生产环境
reduce_bucket_size配置基线与 ZeRO 切分参数。
- 参考 AI_BOOK/llm-action/llm-train/megatron-deepspeed/microsoft/llama-note.md:对照生产环境
- 经典论文与工业基准:
- PyTorch Distributed: Experiences on Accelerating Data Parallel Training (VLDB 2020, DDP 官方原著论文);
- ZeRO: Memory Optimizations Toward Training Trillion Parameter Models (Rajbhandari et al., SC 2020);
- Megatron-LM: Training Multi-Billion Parameter Language Models Using Model Parallelism (Shoeybi et al., 2019)。
附录:Appendix A — 大厂高频白板推导面试真题深度破局
Q1: 在面试白板上,请推导并证明:为什么 DDP 的 Ring-AllReduce 传输时间与参与的 GPU 卡数 在大集群下几乎无关?
Ringi 考官拆解与满分回答:- 数据切分与两阶段: 设待同步的梯度总大小为 (Bytes),总共有 张 GPU。将总数据均分为 个数据块,每块大小为 。
- 阶段一:Scatter-Reduce(分散累加):
- 采用环形传递,每个 GPU 每次向下一个邻居发送一块本地分块,并接收前一个邻居的分块累加到本地;
- 完成全体累加需要传递 轮;
- 该阶段总发送数据量为:
- 阶段二:AllGather(全收集广播):
- 将累加好的完整块广播到环上所有卡,同样需要传递 轮;
- 该阶段总发送数据量为:
- 单卡总通信量与耗时:
Q2: 为什么有些团队在训练 7B 模型时把 bucket_cap_mb 从 25MB 改成 100MB 之后,单步训练速度不升反降?
Ringi 考官拆解与满分回答:
- 大桶延后了首包发射时机(Delayed First-Packet Launch):
- DDP 的通信与计算重叠完全依赖于“早发射、在背景异步跑”;
- 若桶容量设为 100MB,反向传播必须一口气算完 7~8 个深层的大矩阵梯度才能填满这个大桶;
- 在填满之前,通信流完全闲置,无法与前期的计算重叠。
- 流水线气泡暴露:
- 到了反向传播快结束时,剩下的所有梯度一次性塞进一个超大包发射,此时浅层的前向和反向计算早已全部完毕;
- GPU 计算核心彻底陷入没有活干的空转状态,原本能够并行的通信全部裸露在主时间线上,导致端到端耗时大幅恶化!