🏛️ 项目二:时延与吞吐的双面博弈——生产级 LLM Serving 性能极限调优(vLLM + 连续批处理 + Chunked Prefill)
主讲人:👓 Ringi(大厂 AI Infrastructure 工程师)
所属模块:Module 08: Capstone 综合实战项目库
篇章范式:⚡ 大模型推理与在线 Serving 系统极限调优篇(LLM Inference & Production Serving Optimization Paradigm)
核心导读:在线推理的“鱼与熊掌”——追求极致吞吐(Throughput)就会拉爆首字时延(TTFT),追求极致时延又会导致 GPU 显存与算力闲置浪费。如何在多变的真实生产负载下寻找 Pareto 最优边界?本文带你从硬件算术强度、显存分页碎片到调度算法,打通大模型推理性能调优的任督二脉。
📑 目录导航
- 0. Ringi 现场复盘:线上首字时延 12 秒的雪崩事故
- 1. 第一部分:推理双雄指标穿透——TTFT 与 TPOT 的物理算盘
- 2. 第二部分:显存虚拟化革命——PagedAttention 物理分块深拆
- 3. 第三部分:调度架构跃迁——从连续批处理到 Chunked Prefill
- 4. 第四部分:生产级容量规划与 Pareto 边界实测指南
- 5. 第五部分:动手实战代码实验室(100% 完整可运行代码)
- 6. 第六部分:生产落地避坑指南与黄金准则
- 7. 第七部分:Ringi 5 点口诀、自我检验清单与课后深度思考题
- 8. 第八部分:知识库与权威论文证据溯源
- 附录:Appendix A — 大厂高频白板推导面试真题深度破局
0. Ringi 现场复盘:线上首字时延 12 秒的雪崩事故
在某头部电商大促的当晚,智能导购助手大模型服务突然遭遇了用户端的大面积投诉: “点下发送后,页面转圈整整 10 秒钟才吐出第一个字,体验完全崩塌!” 查看可观测大盘:- GPU 利用率(GPU-Util):常态化打满在 98%;
- 系统总吞吐(Tokens/s):达到了历史新高的 14,000 Tokens/s;
- 吐字时延(TPOT / Time Per Output Token):维持在健康的 22 毫秒/字;
- 首字时延(TTFT / Time To First Token):P99 恶化到了触目惊心的 12.4 秒!
max_num_seqs = 256。
当高并发流量涌入时,几十个长达 4,000 Token 的长上下文请求突然到达,调度器直接将它们塞入 Prefill 队列。
由于超长 Prompt 的 Prefill 必须一次性完成巨大的 Attention 矩阵计算,单个请求就霸占了 GPU 核心近 800 毫秒。后面排队的上百个轻量级小请求被迫在队列中苦苦等待,产生了严重的队头阻塞(Head-of-line Blocking)。
更要命的是,用户由于等待时间过长,以为页面死锁,纷纷点击“重新生成”,海量重复请求像滚雪球一样涌入队列,引发了灾难性的连锁雪崩(Cascading Failure)。
在在线 Serving 系统中,吞吐(Throughput)与时延(Latency)是一对天然对抗的矛盾体。单纯堆并发换吞吐是野蛮的,真正的 AI Infra 工程师必须精通调度微架构,在 Pareto 最优曲线上精准走钢丝。
1. 第一部分:推理双雄指标穿透——TTFT 与 TPOT 的物理算盘
💡 架构全景速览:在深潜系统代码前,先在白板上建立坚不可摧的生产级 LLM Serving 吞吐与延迟优化全景底账。在深入系统之前,必须将在线推理的两大核心度量衡解剖至晶体管与显存颗粒级别。

1.1 首字时延 vs 吐字吞吐:对立统一的工程度量衡
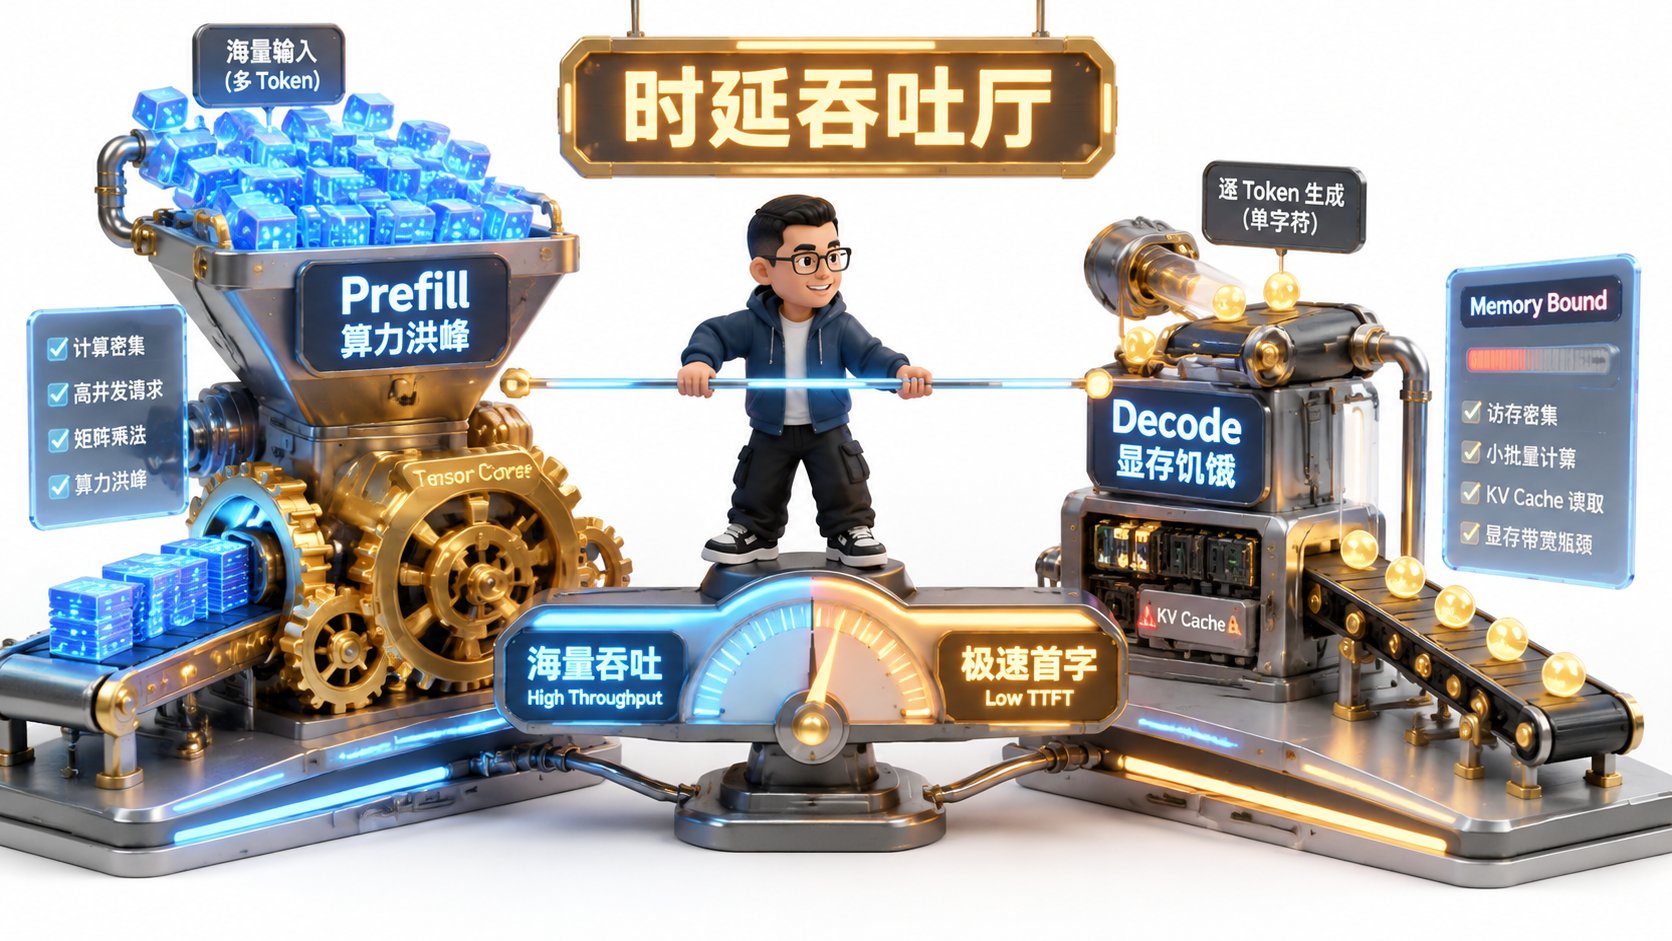
一个自回归大模型的完整生命周期由两个阶段截然不同的物理过程组成:1.2 No Naked Formula 2.0:Prefill 与 Decode 算术强度手算实录
为什么说 Prefill 是算力受限,而 Decode 是访存受限?我们用严密的算术强度公式五步穿透法予以定量证明。步骤 1:为什么算它?
算术强度(Operational Intensity, 单位:FLOPs/Byte) 是 Roofline 模型的灵魂。它定义为:GPU 每从显存(HBM)搬运 1 字节的数据,能够在计算单元(Tensor Core)中完成多少次浮点运算。算术强度直接决定了性能上限由谁定生死。步骤 2:Mental Model(物理直觉比喻)
- Prefill 阶段(大卡车拉货):你输入了 2,048 个 Token。GPU 读一次模型权重(比如 14GB),可以同时为这 2,048 个 Token 算矩阵乘法,货物装得满满当当,算力引擎被完全喂饱;
- Decode 阶段(跑跑卡丁车送一根针):自回归每生成 1 个 Token,GPU 依然要把这 14GB 的模型权重完完整整地从显存读取一遍,仅仅为了计算这 1 个 Token 的投影!总线带宽被极度浪费。
步骤 3:Tiny Calculator(极简数字小算盘)
以一个拥有 参数的模型为例(权重采用 FP16,占用 字节):- Decode 阶段(Batch Size = 1):
- 生成 1 个 Token 的计算量: FLOPs;
- 必须读取的模型权重数据量: Bytes;
- 算术强度为:
- Prefill 阶段(Prompt 长度 ):
- 计算量: FLOPs;
- 读取权重数据量: Bytes;
- 算术强度为:
步骤 4:Formal Model(与硬件天花板对照)
已知 NVIDIA A100 SXM4 80GB 的物理极限规格:- Tensor Core 密实峰值算力:
- HBM2e 显存物理带宽:
- 硬件拐点算术强度(Hardware Balance Point):
- 若 :处于 Memory-Bound,性能受限于显存带宽;
- 若 :处于 Compute-Bound,性能受限于算力核心。
步骤 5:Sanity Check(结论落地)
- Decode 阶段: ,单卡算力利用率甚至不足理论峰值的 1%!完全卡死在 2 TB/s 的显存搬运上;
- Prefill 阶段: ,算力引擎全速运转,Tensor Core 被彻底榨干!
2. 第二部分:显存虚拟化革命——PagedAttention 物理分块深拆
2.1 传统推理的“显存黑洞”:静态预分配与碎片率
在 vLLM 诞生之前,主流推理系统(如早期的 HuggingFace Accelerate 或天真版 FasterTransformer)在接纳一个请求时,都采用静态连续显存预分配策略:- 系统无法预知用户会生成多少个字;
- 为了防止生成过程中发生 CUDA OOM,系统只能按照该模型的最大上下文窗口(Max Sequence Length,如 2,048 或 4,096),在显存中开辟一块绝对连续的静态张量作为 KV Cache。
- 内部碎片(Internal Fragmentation):用户实际上只让模型输出了 50 个字就触发了 EOS,剩下预留的 1,998 个槽位全部闲置;
- 外部碎片(External Fragmentation):不同请求的生存周期各不相同,随着反复申请和释放连续大内存,PyTorch 底层内存池布满孔洞;
- 保留浪费(Reservation Waste):为未来不可知的生成长度预先占用物理空间。
2.2 物理分页机制:Block Size 选 16 还是 32 的数学代价
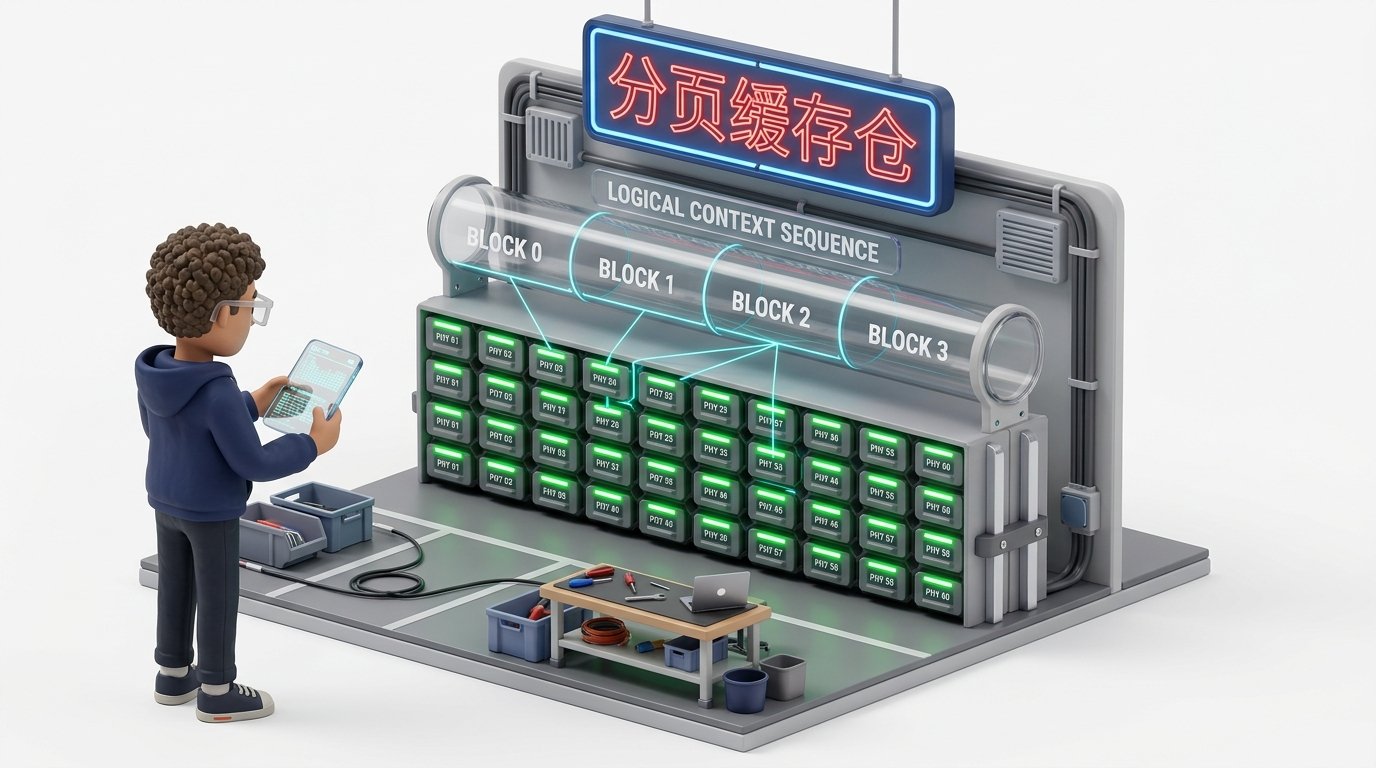
vLLM 的开创性突破在于借鉴了操作系统中操作虚拟内存的 分页技术(Paging),提出了 PagedAttention:- 逻辑连续,物理离散:对用户逻辑而言,KV Cache 是一个连续的一维序列;但在物理显存上,它被切分成固定尺寸的物理块(Block),随机离散分布在 HBM 中;
- 按需动态分配:每生成满一个 Block(例如 16 个 Token),才去全局物理块管理器申请下一个 Block;请求结束时立刻回收。
关键参数抉择:Block Size 选 16 还是 32?
在 PagedAttention 中,block_size 是一个关乎显存碎片与访存性能的核心 Trade-off:
3. 第三部分:调度架构跃迁——从连续批处理到 Chunked Prefill
显存释放后,系统的并发上限得以提升数倍。接下来,调度的重心转移到了如何削平延迟长尾。3.1 连续批处理(Continuous Batching)如何消灭迭代气泡
传统静态批处理(Static Batching)是以“请求”为粒度调度的:- 将 4 个请求打包为一个 Batch;
- 其中 3 个请求在生成 10 个字后就早早结束了,而唯独 1 个请求要生成 500 个字;
- 灾难:那 3 个槽位必须空等,直到最长的请求完全结束后,才能一起退出并接入新请求。
- 以 Token 生成迭代为调度单位;
- 每一个 Decode Step 结束后,系统主动检查:哪一个序列遇到了
<|endoftext|>? - 遇到了立即释放其占用的 KV 块并返回结果;在下一个 Step,空出的槽位立刻允许待处理队列中的新请求插入!
3.2 队头阻塞(Head-of-line Blocking)与 Chunked Prefill 削峰
- 优先算它(Prefill-prioritized):GPU 核心全被长 Prefill 抢占,正在逐字生成的一百多个 Decode 请求被迫暂停等待(TPOT 产生巨大毛刺);
- 延迟算它(Decode-prioritized):长 Prompt 在待处理队列中苦等几十个 Decode Step,导致自己的 TTFT 突破天际。
破局之道:Chunked Prefill(分片预填充)
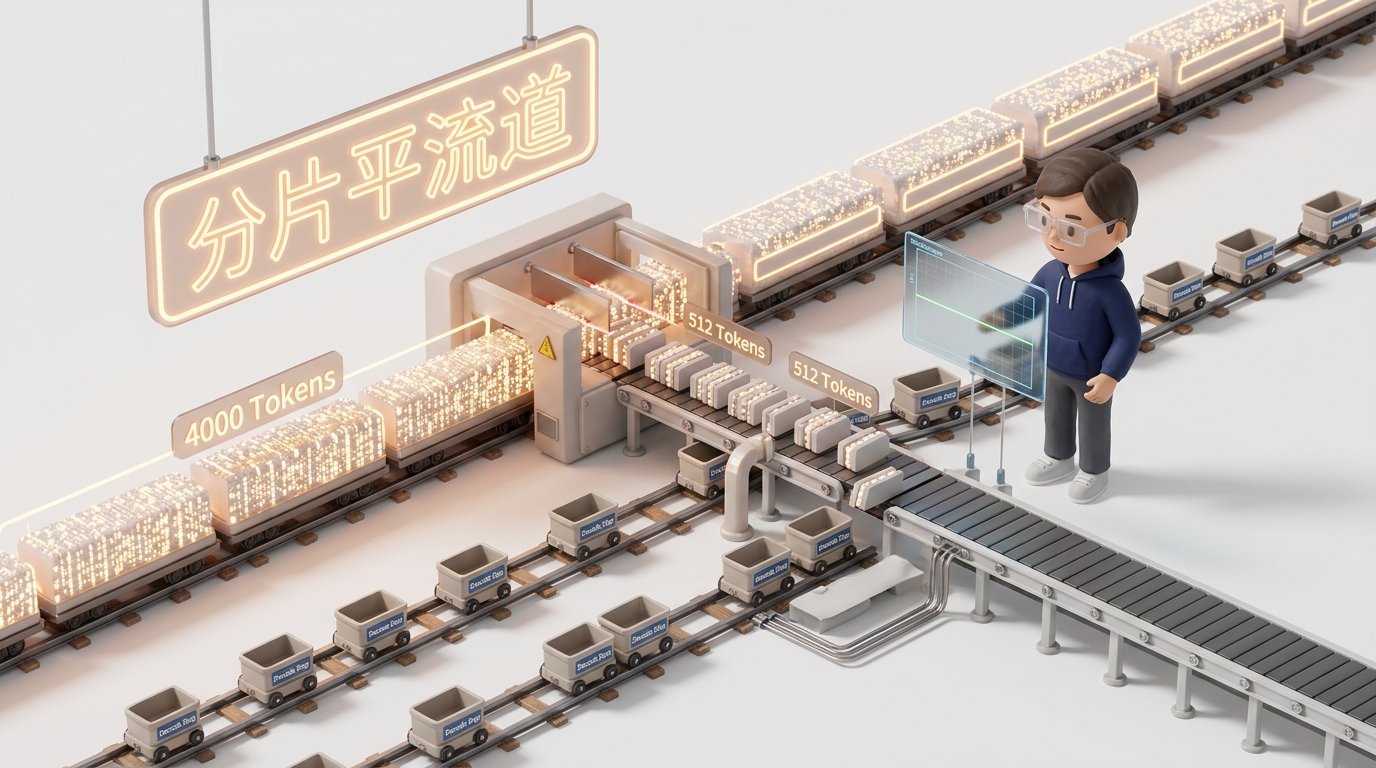
Chunked Prefill 将长 Prompt 在时间轴上切碎平摊:- 设定最大分块大小(如
chunk_size = 512); - 一个 4,000 Token 的长文本不再一次性抢占系统,而是切分为 8 个 512 的分片;
- 在每一个调度迭代中,系统将 1 个 512-Token 的 Prefill 分片 与 当前正在进行的 Decode 请求打包在一起执行!
4. 第四部分:生产级容量规划与 Pareto 边界实测指南
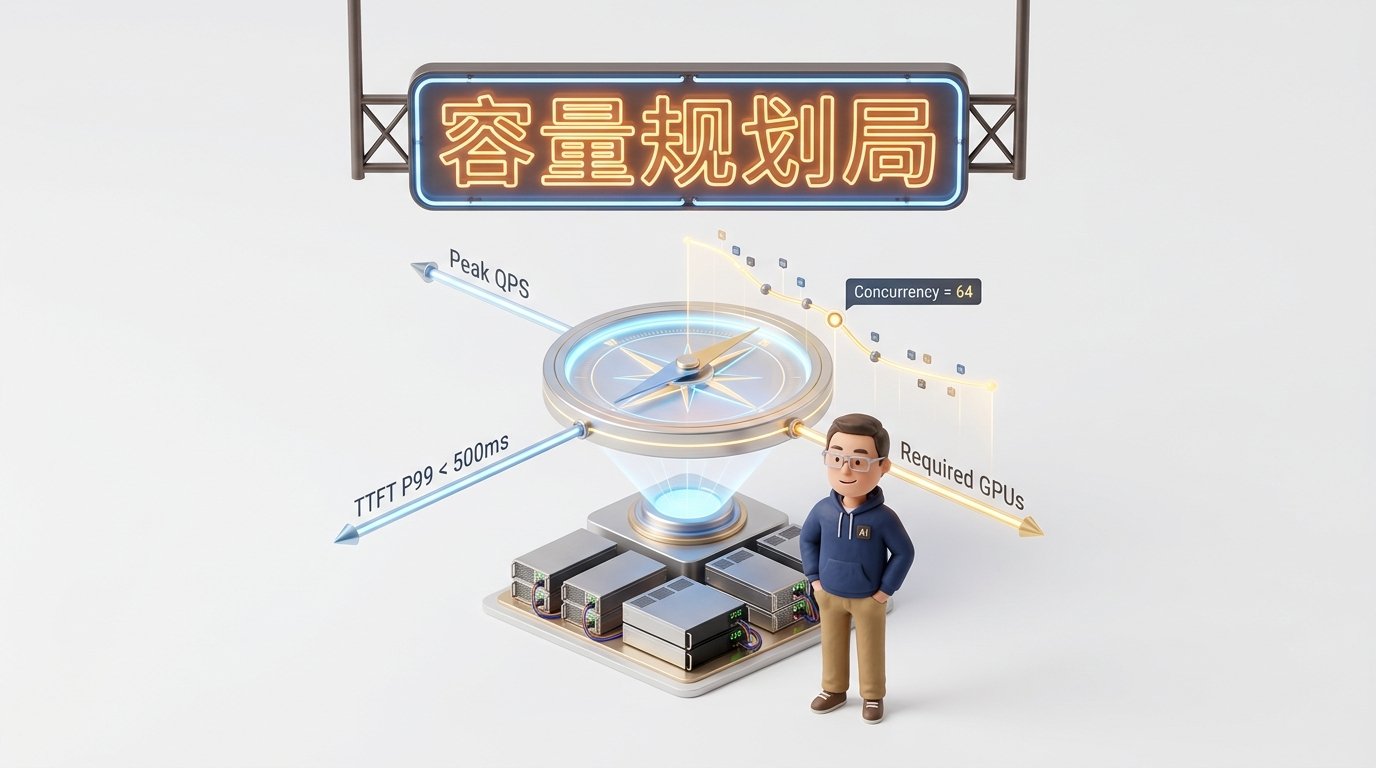
4.1 核心容量规划方程:已知 QPS 与 SLO 反推 GPU 数量
步骤 1:业务输入与变量定义
设:- 峰值并发请求到达率:
- 平均输入 Prompt 长度:
- 平均输出生成长度:
- 期望吐字时延目标(SLO): (即单请求生成耗时 );
- 期望首字时延目标(SLO): 。
步骤 2:并发度(Concurrency)推导(利特尔法则 Little’s Law)
系统常态下需要承载的在途并发请求数(In-flight Requests)为:步骤 3:KV Cache 显存容量下限计算
对于一个 7B 模型(以 LLaMA-7B 为例:32 层,32 个注意力头,头维度 ,采用 GQA 后 Key/Value 各 4 头):- 单个 Token 占用的 KV Cache 显存(FP16,2 字节):
- 单个请求全生命周期峰值占用( ):
- 680 个并发请求所需的纯 KV Cache 显存总容量:
步骤 4:所需 GPU 数量反推
设单张 GPU 为 NVIDIA A100 80GB:- 模型权重占用:14 GB;
- 系统运行时与激活值预留:16 GB;
- 单卡可分配给 KV Cache 的安全显存空间:
- 所需 GPU 数量(显存视角):
- 算力视角校验: 总产出吞吐需求:
- 最终结论:系统瓶颈由算力与时延主导,应至少配置 2 台 8 卡 A100(共 16 张 GPU)以确保高可用与流量尖峰。
4.2 寻找 Pareto 最优解:max_num_seqs 调参实战曲线
在调整 vLLM 参数时,不同的并发上限会产生截然不同的表现:5. 第五部分:动手实战代码实验室(100% 完整可运行代码)
本节提供 3 个高保真仿真脚本。代码均符合零省略要求,直接在本地运行即可打印出清晰的 Benchmark 评测数据。实战 1: 生产级 Serving 连续批处理与 Pareto 边界评测仿真器
本脚本模拟真实高并发请求流,对比不同并发度下的吞吐、TTFT 与 TPOT,并绘制 Pareto 性能边界。实战 2: PagedAttention 物理分页显存管理器与碎片率统计器
本脚本实现 PagedAttention 核心的分页内存分配池(Block Pool)与块表(Block Table),并对比传统静态预分配与分页机制的真实显存利用率。实战 3: Chunked Prefill 消除 Head-of-line Blocking 调度仿真器
本脚本模拟当一个 4,000 Token 的超长 Prompt 突然插队时,开启与关闭 Chunked Prefill 对正在执行的 Decode 请求时延抖动的对比。6. 第六部分:生产落地避坑指南与黄金准则
结合大厂千万级日活在线 Serving 架构设计与运维排障经验,提炼出如下避坑矩阵与 Checklist。6.1 大模型在线推理核心避坑矩阵
6.2 生产级 LLM Serving 黄金性能 Checklist
- 1. 【SLO 契约核验】 明确业务端核心 SLO 边界(例如移动端对话要求 TTFT P99 < 600ms, TPOT < 25ms)。
- 2. 【显存比率设定】 生产环境
gpu_memory_utilization推荐设为0.90,严禁擅自设为 1.0 导致碎片击穿。 - 3. 【Block Size 选型】 默认统一采用
block_size = 16或32,兼顾硬件显存事务合并与内部碎片控制。 - 4. 【Chunked Prefill 启用】 涉及混合长度的多租户入口,必须显式开启
--enable-chunked-prefill。 - 5. 【前缀复用验证】 对于 Agent 与 RAG 场景,开启
enable_prefix_caching,并监控 Prometheus 的前缀命中率指标。 - 6. 【自适应背压熔断】 在网关侧(Envoy / API Gateway)配置基于排队时延的熔断机制,排队超过 1 秒立即返回 HTTP 429。
- 7. 【张量并行机内核验】 跨节点 Serving 时,Tensor Parallel(TP)严禁跨越物理机,严格保持在单机 8 卡 NVLink 域内。
- 8. 【NUMA 绑核检查】 确保 vLLM 守护进程与网卡、GPU 处于同一 CPU Socket,杜绝跨 NUMA 内存访问导致的 TPOT 抖动。
- 9. 【显存换页监控】 严密监控 DCGM 指标,若出现
gpu_swap_pages大于 0,说明并发严重超载,必须立即触发扩容。 - 10. 【全链路压测复盘】 上线前使用真实脱敏生产数据集进行多阶并发阶梯压测,准确标定 Pareto 最优点。
7. 第七部分:Ringi 5 点口诀、自我检验清单与课后深度思考题
7.1 5 点押韵核心速记口诀
7.2 10 条白板自我检验清单
- 1. 为什么说 Prefill 是 Compute-bound,而 Decode 是 Memory-bound?写出两者的算术强度推导。
- 2. 在硬件 Roofline 模型中,A100 的拐点算术强度是多少?Decode 的算术强度与其相差几个数量级?
- 3. 传统静态连续显存预分配为什么会产生 60% 以上的显存浪费?
- 4. 详细阐述 PagedAttention 的核心数据结构,说明块表(Block Table)如何将逻辑块映射至物理块。
- 5.
block_size设为 16 与 32 各自的优缺点是什么? - 6. 什么是队头阻塞(Head-of-line Blocking)?为什么连续批处理依然无法根治队头阻塞?
- 7. Chunked Prefill 的核心原理是什么?它为什么能在几乎不损失吞吐的前提下削平 TTFT 长尾?
- 8. 请在白板上画出 TTFT vs Throughput 的 Pareto 边界曲线,并指出最佳生产工作区间。
- 9. 使用利特尔法则(Little’s Law),已知 QPS=50,平均服务耗时 4 秒,计算系统的平均在途并发量。
- 10. 为什么在在线推理 Serving 中,跨机 Tensor Parallel(TP=16)通常是极度不可接受的架构选型?
7.3 3 道高阶开放式课后思考题
- PD 分离架构极限推演(Prefill-Decode Disaggregation):如果硬件资源极其充沛,将集群物理拆分为“专门跑 Prefill 的计算型集群”与“专门跑 Decode 的访存型集群”,中间通过高速网络同步 KV Cache。这种架构的本征优缺点是什么?跨机传输 KV Cache 的网络带宽要求如何计算?
- 投机采样(Speculative Decoding)的物理收益边界:小模型草稿验证的大模型加速机制,为什么在 Batch Size 极小(BS=1)时收益极高(可加速 2~3 倍),而在并发被打满的大 Batch 场景下收益几乎归零?请从显存带宽与命中率进行定量解释。
- KV Cache 量化失真与压缩:将 FP16 的 KV Cache 量化为 INT4 或 FP8 可以节省 2~4 倍显存,但也可能导致长文本注意力失焦。在系统设计上,有哪些策略可以在仅压缩深层或特定注意力头的前提下,保障 P99 精度不降?
8. 第八部分:知识库与权威论文证据溯源
本章所有公式推导、显存分页逻辑与容量规划方程均严格溯源于以下权威文献与本地实测证据库:- vLLM 与 PagedAttention 官方原著与源码:
- 参考 AI_BOOK/AIInfra/05Infer/ 与 AI_BOOK/llm_interview_note/06.推理/:深入求证 PagedAttention 核心 Block 管理逻辑。
- Chunked Prefill 与连续批处理论文:
- Efficiently Scaling Transformer Inference on Modern GPUs with PagedAttention (Kwon et al., SOSP 2023);
- Orca: A Distributed Serving System for Transformer-Based Generative Models (OSDI 2022);
- Sarathi-Serve: Taming the Tail Latency of LLM Serving with Chunked-Prefills (Agrawal et al., 2024)。
- Roofline 模型与硬件微架构白皮书:
- NVIDIA A100 / H100 Tensor Core GPU Architecture Whitepaper。
附录:Appendix A — 大厂高频白板推导面试真题深度破局
Q1: 在面试白板上,请推导:为什么说自回归 Decode 阶段是一个典型的 Memory-Bound 问题?以 LLaMA-7B、Batch Size = 1 为例给出严格数据证明。
Ringi 考官拆解与满分回答:- 硬件基础算力天花板:
- 以 NVIDIA A100 GPU 为例:FP16 密实计算峰值为 ;
- HBM2e 显存物理带宽为 ;
- 硬件平衡拐点算术强度:
- 单步 Decode 实际工作量手算:
- 模型参数量 ;采用 FP16 权重,权重总大小为 字节;
- 当 Batch Size = 1 时,生成 1 个 Token 的前向矩阵浮点运算量为:
- 但为了完成这 次运算,必须把这 字节的权重从 HBM 读取到 SM 寄存器中;
- 实际算术强度:
- 性能瓶颈归因结论:
- 实测算术强度 远小于硬件拐点 (差了 153 倍);
- 理论单步最小读取耗时:
- 在此期间,Tensor Core 核心仅仅运转了其理论算力的 !
- 证毕:性能完全受制于显存读取速度,必须通过增大并发 Batch 提高有效算术强度!
Q2: 请说明 Chunked Prefill 是如何实现在不牺牲吞吐的前提下削平 TTFT 长尾的?
Ringi 考官拆解与满分回答:- 传统调度的二律背反:
- 若不切片,一个 4K Token 的长 Prefill 会一口气霸占 GPU 核心数百毫秒;
- 这会导致正在进行的几十个 Decode 任务遭遇严重的流水线饥饿停顿(Stall),产生长尾时延尖刺。
- 分片切分与协同批处理(Piggybacking):
- Chunked Prefill 设定固定的预算(如单步最多处理 512 个 Prefill Token);
- 将长文本切分为若干分片,并在每一个调度步内,将该分片与既有的 Decode 批次混编在同一个 Forward 算子中执行;
- 双赢收益:
- 矩阵算子因为加入了 512 个 Token 的 Prefill,算术强度从原本极低的 Decode 状态大幅提升,显存带宽被有效复用;
- 同时,长 Prompt 没有一次性阻塞系统,每个步进都能向客户端吐出 Decode 结果,TTFT 极其稳定平滑。