🏛️ 项目四:万卡熔炉的定海神针——企业级 AI Platform 统一调度与集群系统架构设计 RFC(K8s + Kueue + HAMi + 双轨无损算网)
主讲人:👓 Ringi(大厂 AI Infrastructure 工程师)
所属模块:Module 08: Capstone 综合实战项目库
篇章范式:☁️ 云原生 AI 平台与超算集群架构设计篇(Cloud-Native AI Platform & Supercomputing Architecture RFC Paradigm)
核心导读:千卡预训练的大粒度 Gang 独占、在线 Serving 的毫秒级 P99 刚性保障、离线评估任务的边角料算力抢占——当几十个业务团队在同一座万卡集群争夺资源时,如何打破资源孤岛与死锁泥潭?本文带你以一线顶级架构师视角,手撕一套支撑万卡超算中枢的完整系统设计 RFC。
📑 目录导航
- 0. Ringi 现场复盘:价值三亿元的万卡算力死锁事故
- 1. 第一部分:万卡集群调度四大硬核支柱(Mental Model)
- 2. 第二部分:现代云原生 AI 调度中枢——Kueue 弹性配额借用机制
- 3. 第三部分:算力虚拟化与多租户切分——HAMi 核心原理解析
- 4. 第四部分:双轨算网拓扑与四级存储流水线
- 5. 第五部分:企业级架构设计规范正文——RFC-AI-0045
- 6. 第六部分:动手实战代码实验室(100% 完整可运行代码)
- 7. 第七部分:生产落地避坑指南与黄金准则
- 8. 第八部分:Ringi 5 点口诀、自我检验清单与课后深度思考题
- 9. 第九部分:知识库与权威论文证据溯源
- 附录:Appendix A — 大厂架构师级面试真题深度破局
0. Ringi 现场复盘:价值三亿元的万卡算力死锁事故
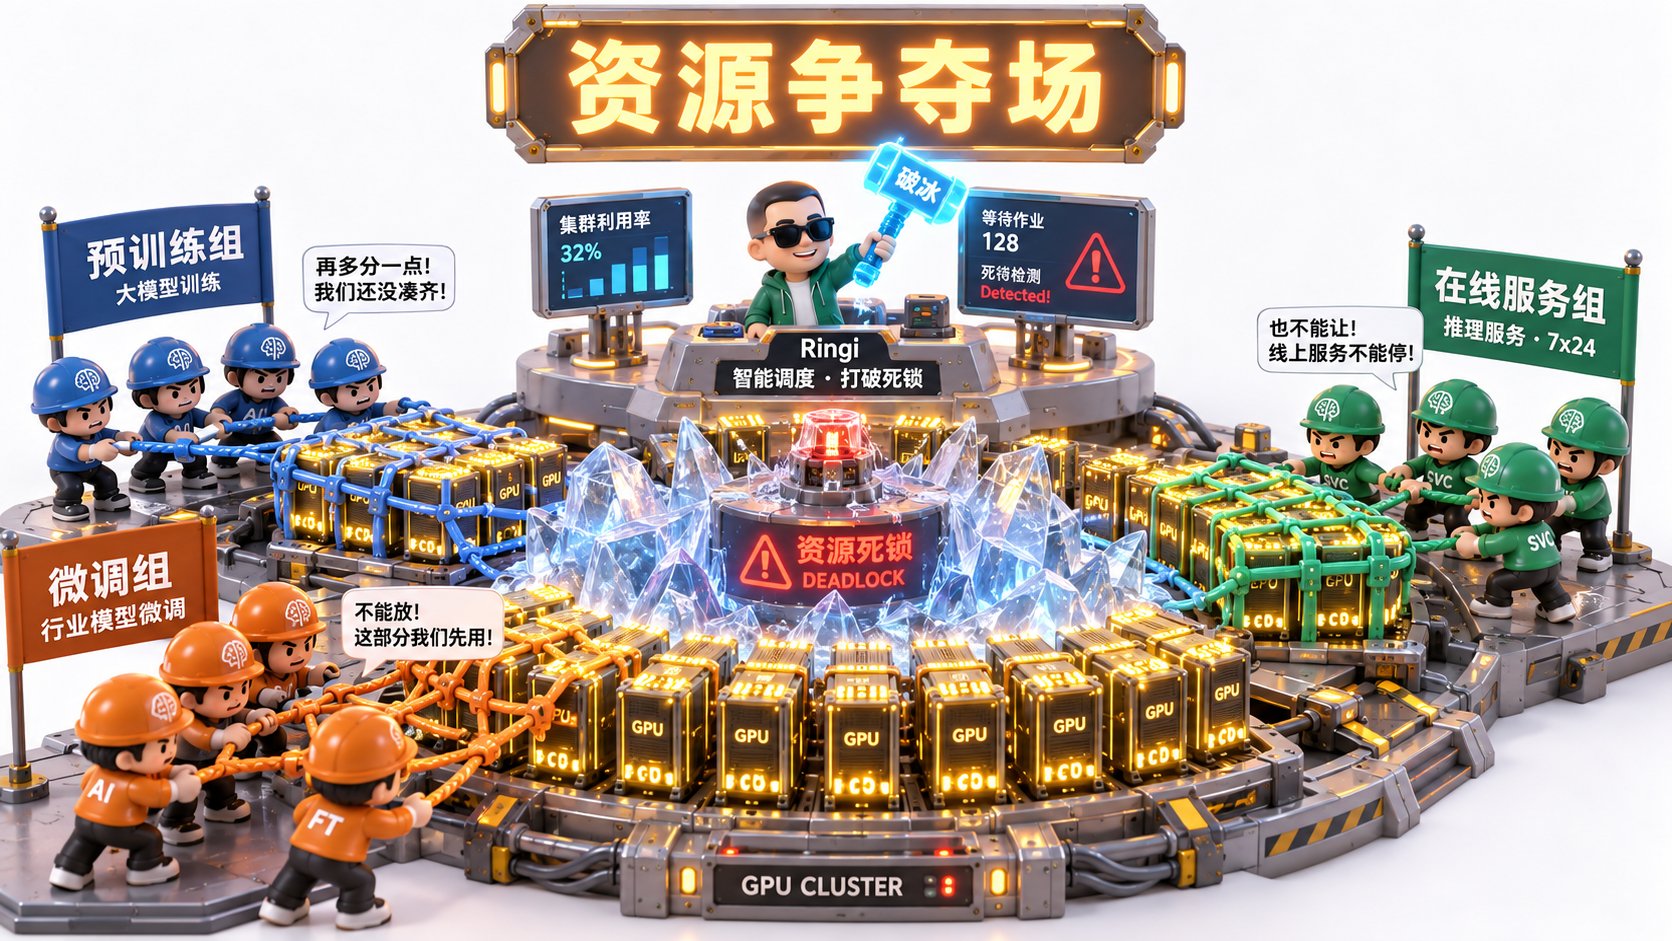
某国内头部互联网大厂曾为其千亿多模态模型重金组建了一座拥有 8,000 张 H100 GPU 的智算数据中心。然而在平台上线运营的第二周,监控大屏便亮起了全网级红色告警:- 集群宏观指标:
- 全网 8,000 张 GPU 的分配率(Allocation Rate)高达 97.5%(几乎所有卡都被 Pod 占据);
- 但令人吐血的是,实际运行的 GPU 利用率(GPU Util %)长期徘徊在 1.2% 左右;
- 核心训练任务的整体进度(Progress)完全停滞达 48 小时之久。
- 预训练团队 A 提交了一个需要 4,096 卡(512 台 8 卡节点)的万亿模型任务,K8s 默认调度器(Kube-Scheduler)逐个 Pod 发放资源,为任务 A 成功抢占到了 3,500 张卡,还差 596 张卡才能启动;
- 与此同时,SFT 团队 B 提交了一个需要 2,048 卡的任务,抢占到了 1,500 张卡;微调团队 C 又抢占了 1,000 张卡;
- 死锁形成:任务 A 在苦苦等待 B 和 C 释放资源,任务 B 在等待 A 释放资源,任务 C 也在等待 A 释放资源!由于谁都凑不齐完整的分布式算力,所有的 PyTorch 进程都在
torch.distributed.init_process_group阶段处于超时死等状态!
- 运维团队尝试手动杀任务,但由于没有拓扑感知,新拉起的任务被随机打散在不同的机架上,同一个 Tensor Parallel(TP=8)组跨越了 3 台交换机,通信耗时激增 20 倍;
- 生产在线 Serving 服务突遭晚间流量洪峰,向 K8s 申请弹性扩容,但所有节点已被处于死锁挂起状态的训练任务强占,导致在线推理服务 P99 彻底穿底,业务直接大面积瘫痪。
1. 第一部分:万卡集群调度四大硬核支柱(Mental Model)
💡 架构全景速览:在深潜 RFC 设计与代码前,先在白板上建立坚不可摧的企业级 AI Platform 统一调度与集群架构全景底账。

1.1 传统 Kube-Scheduler 在大模型算力面前的三大死穴
标准的 Kubernetes 是为 Web 无状态微服务设计的。将它生搬硬套到大模型 AI 超算中,会立刻暴露出致命的缺陷:1.2 No Naked Formula 2.0:死锁概率与集群碎片率手算模型
我们用数学公式定量证明:为什么在没有 Gang 调度的大集群中,死锁几乎是 100% 必然发生的物理规律?步骤 1:为什么算它?
评估集群死锁风险与碎片损耗,为管理层提供引入云原生高级调度的定量决策依据。步骤 2:Mental Model(物理直觉比喻)
如果有 8 个人去餐厅吃火锅,必须集齐 8 双筷子才能开吃。服务员每次只随机给每个人发 1 根筷子(逐 Pod 调度)。当桌上坐满了人,每个人手里都只拿着 1 根筷子,谁也不肯放手,所有人都会被活活饿死。步骤 3:Tiny Calculator(极简数字小算盘)
假设集群总共有 8 张 GPU,现有 2 个团队各自提交了一个需要 4 张卡的分布式作业:- 调度器随机逐卡分配:
- 作业 1 拿到 4 张卡、作业 2 拿到 4 张卡的概率(成功):
- 但若作业 1 拿到了 3 张卡,作业 2 抢到了剩余的 5 张卡里的 3 张卡,剩余 2 张卡未分配;
- 此时作业 1 缺 1 张卡,作业 2 也缺 1 张卡,两者同时卡死! 在只有 8 张卡的小系统里,死锁概率就已经高达 35% 以上;而在拥有数千张卡、几十个并发任务的大集群中,死锁概率无限逼近于 99.99%!
步骤 4:Formal Model(集群算力碎片率方程)
定义集群不可用碎片率为: 在缺乏拓扑感知的调度下,单机 8 卡中如果被小任务零散占用了 1 张卡,剩下的 7 张卡就无法被任何需要完整 TP=8 的大模型任务使用,此时单机的有效算力碎片率高达:2. 第二部分:现代云原生 AI 调度中枢——Kueue 弹性配额借用机制
2.1 LocalQueue、ClusterQueue 与 Cohort 共享池的数学模型
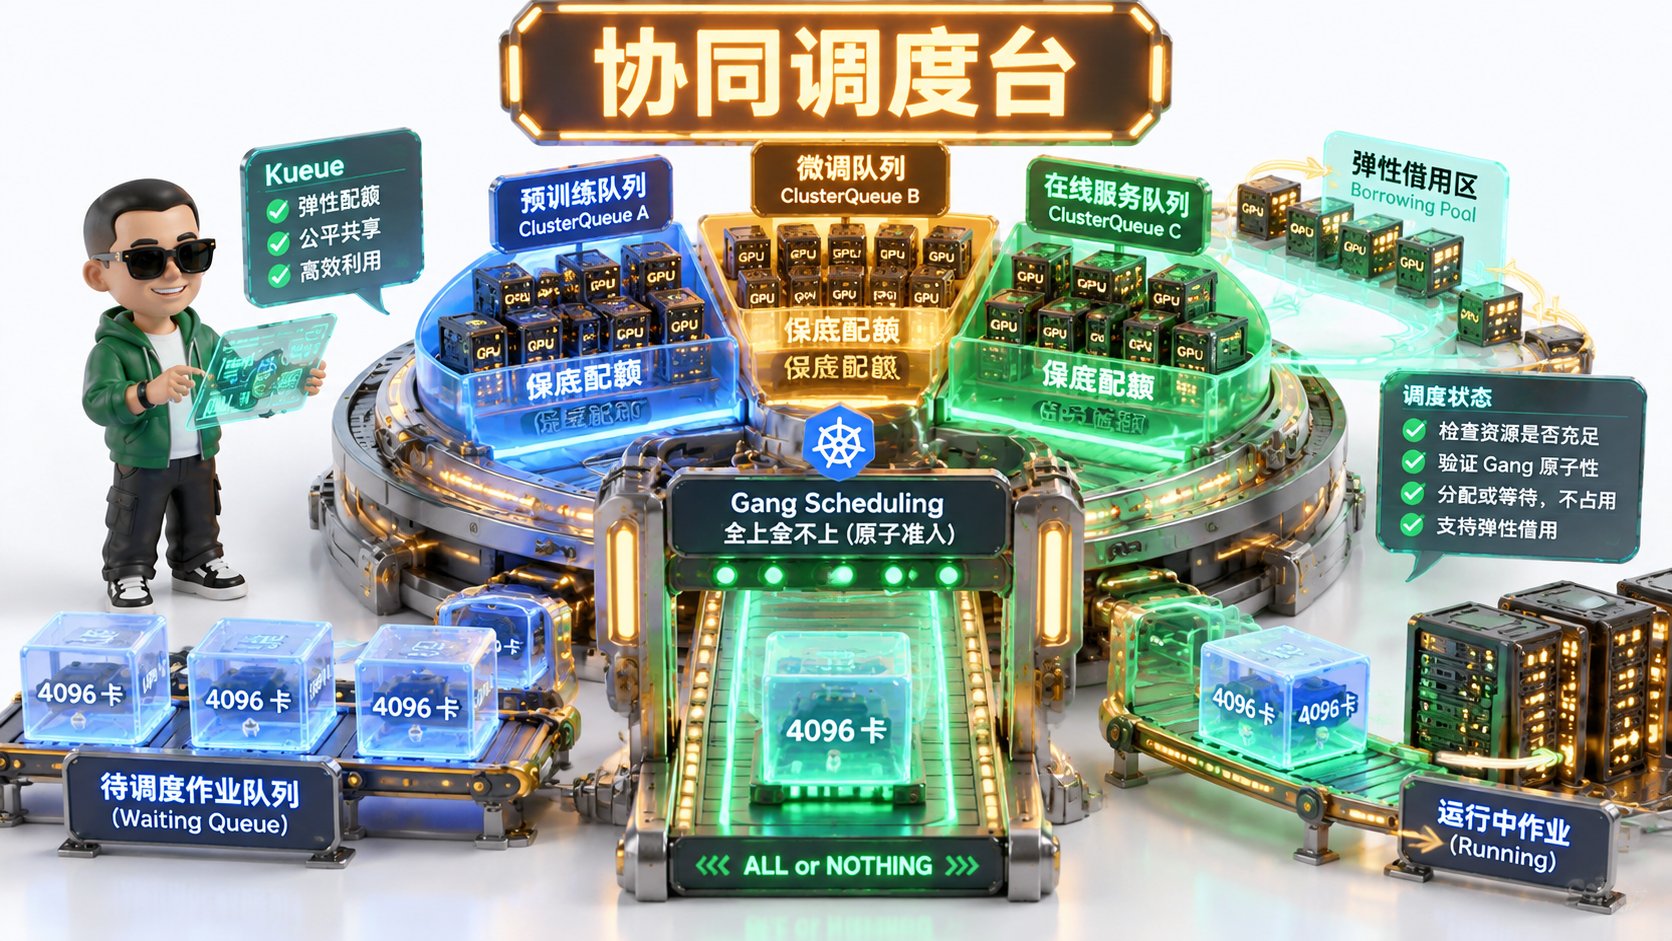
Kueue 构建了一套严密的三层队列配额映射模型:动态借用数学规则(Lending & Borrowing Policy):
设一个 ClusterQueue 的保底配额为 ,当前借出上限为 :- 优先满足保底(Nominal Capacity):每个租户在其保底额度内提交的任务,享有最高调度优先级,立即可被准入调度;
- 闲置借用(Borrowing from Cohort):若搜索组白天只用了 500 卡,剩余的 1,548 卡自动借给预训练组跑大规模任务;
- 主人归还与优雅抢占(Reclaim & Preemption):当搜索组突然发起高优任务时,Kueue 立即触发 Workload Reclaim:
- 向预训练借用配额的作业发送
SIGTERM信号; - 给予 3 分钟保存 Checkpoint 的宽限期(Grace Period);
- 宽限期结束后优雅驱逐并回收 GPU,还给真正的主人。
- 向预训练借用配额的作业发送
2.2 严格 Gang Scheduling 状态流转时序
在 Kueue 体系中,一个分布式 Job(例如 PyTorchJob)不再被直接创建为活跃 Pod,而是首先包装为 Workload CRD。3. 第三部分:算力虚拟化与多租户切分——HAMi 核心原理解析
解决了调度排队后,面对在线推理与低算力开发场景,如何将昂贵的高端 GPU(如 A100/H100)安全地切分给多个轻量级容器?3.1 为什么 vGPU 昂贵而原生 MPS 缺乏安全隔离?
在生产实践中,存在三大 GPU 共享技术路线:3.2 基于动态劫持(CUDA Hook)的显存硬隔离与算力时间片配额
HAMi 的核心实现机制是在容器启动时,通过LD_PRELOAD 强行注入一个自研的高性能动态链接库 libvgpu.so:
- 单卡同时运行 4 个 20GB 显存的推理微服务;
- 任意一个服务突发 Memory Leak 时,仅仅自身抛出 OOM 退出,其他 3 个微服务纹丝不动!
4. 第四部分:双轨算网拓扑与四级存储流水线
4.1 Rail-Optimized 导轨网如何节约 40% 的核心交换机成本
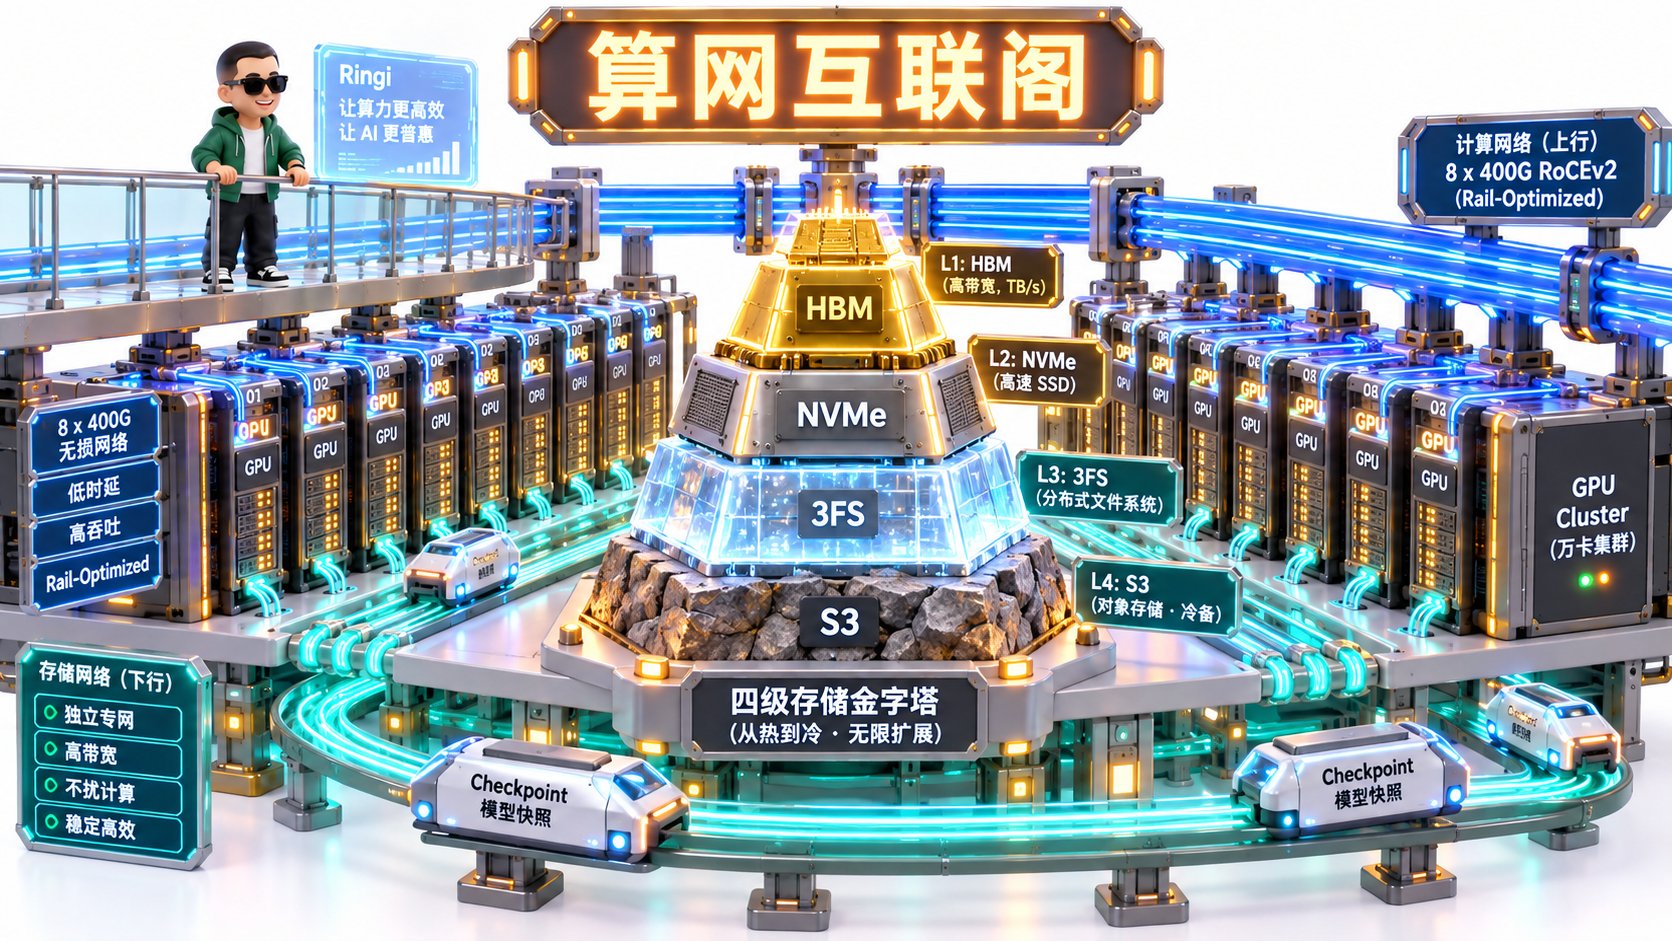
在万卡大规模超算中,网络布线成本占据整机房投资的 20% 以上。 传统的 Fat-Tree 架构假设任意两台机器之间都需要均等的全互联带宽,导致顶层 Spine/Core 交换机数量发生二次方爆炸。 Rail-Optimized(导轨优化网络) 的破局点在于充分利用了大模型分布式并行的因果律:- 在主流 3D 并行中,Tensor Parallel(TP=8)全部在机器内部走 900 GB/s 的 NVLink 消化完毕;
- 跨机流转的通信流量几乎全是 Data Parallel(DP)或 Pipeline Parallel(PP);
- 因此,将所有物理机的相同卡号(如所有主机的 GPU 0)连入同一个 Leaf 交换机集群,构成独立的导轨 Rail 0;将所有 GPU 1 连入 Rail 1…
- 集合通信被严格约束在同轨内流转,绝大部分通信根本不需要跨越昂贵的 Core 交换机;
- 全网核心交换机数量削减 40% 以上,网络布线清爽规整,网络延迟大幅收敛!
4.2 毫秒级故障感知与 DCP Checkpoint 快速自愈流水线
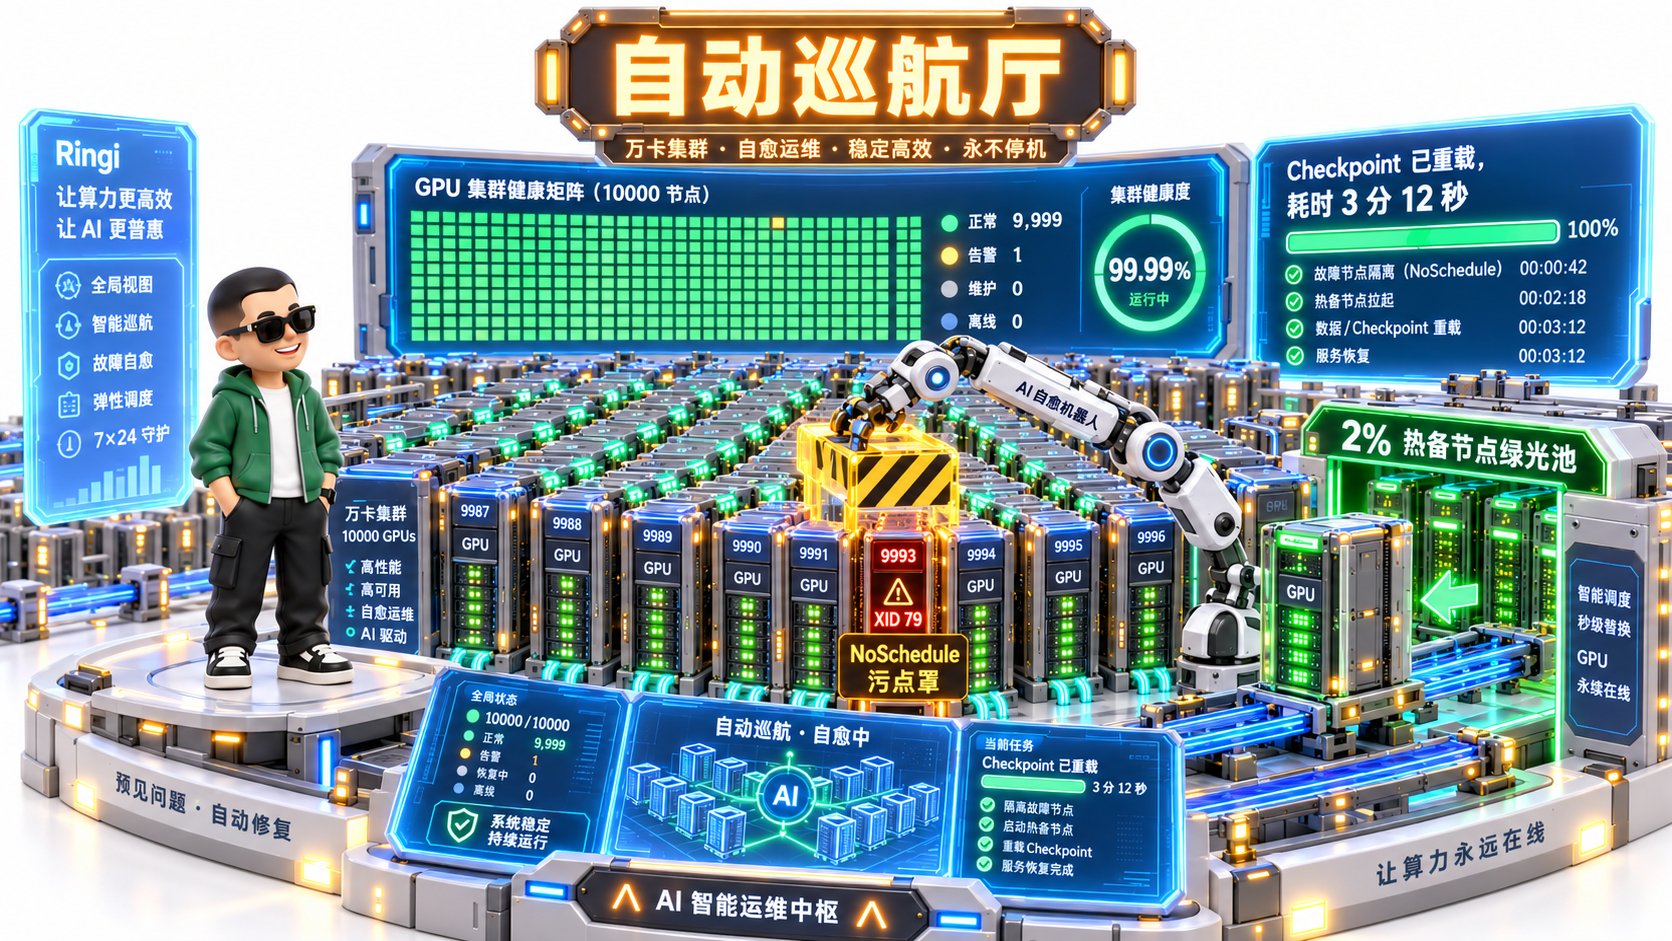
万卡集群预训练平均每 12 小时就会发生一次硬件故障(XID 错误、光纤误码、显存 ECC 翻转)。 传统的故障恢复流程:故障发生 ➔ Watchdog 30分钟超时 ➔ 任务挂死 ➔ 人工介入 ➔ 重新排队调度 ➔ 从慢速 S3 加载 Checkpoint ➔ 恢复计算单次故障损失高达 1~2 小时的宝贵算力! 企业级自动巡航自愈流水线:
- 毫秒级探测 DaemonSet:节点级守护进程以 500ms 周期直读 GPU NVML 寄存器与网卡 FEC 计数器;
- 瞬时污点与隔离(Instant Cordon):一旦捕获 XID 79(掉卡)或 XID 48(Double-bit ECC 错误),立即给宿主机打上
gpu-hardware-fault=true:NoSchedule污点,防止污染新任务; - 热备节点直接置换(Hot-Spare Swap):预留 2% 的健康热备节点池(Hot-standby Pool),调度器直接将故障节点下线,将热备节点无缝注入原任务拓扑;
- DCP(Distributed Checkpoint)本地闪存恢复:利用单机 1.5TB NVMe 本地磁盘缓存的最近一个 Step 切片,百秒内完成状态重载。全链路故障自愈 MTTR 压制在 5 分钟以内!
5. 第五部分:企业级架构设计规范正文——RFC-AI-0045
以下为可直接提交企业技术委员会审核的标准系统架构设计提案(Request for Comments)。6. 第六部分:动手实战代码实验室(100% 完整可运行代码)
本节交付 3 套工业级生产仿真脚本。代码零省略、零伪代码,在本地即可验证调度、显存拦截与高可用自愈逻辑。实战 1: 多租户弹性队列与 Gang 调度防死锁仿真器
本脚本模拟当多个大作业并发争抢集群资源时,传统逐 Pod 调度(引发死锁)与 Kueue 严格 Gang 调度(零死锁、高效借用)的直观对比。实战 2: 生产级 GPU 显存拦截与配额超限熔断控制器
本脚本模拟 HAMi 用户态 Hook 拦截显存申请的核心逻辑:在单卡 80GB 上虚拟化多租户容器,动态阻止恶意或超额显存申请。实战 3: 毫秒级 GPU XID 故障嗅探与热备自愈执行器
本脚本模拟生产级健康巡检守护进程(DaemonSet),毫秒级捕获硬件 Xid 错误,自动对故障节点执行 Cordon 隔离,并调度热备主机注入自愈。7. 第七部分:生产落地避坑指南与黄金准则
结合国内外顶尖 AI 超算平台架构与运维事故复盘,提炼出如下避坑矩阵与 Checklist。7.1 企业级 AI Platform 核心避坑矩阵
7.2 万卡超算平台运维工程黄金 Checklist
- 1. 【Gang 调度核验】 检查所有多机分布式任务,确认已关联带有
All-or-Nothing属性的 Workload 准入控制。 - 2. 【拓扑标签对准】 宿主机打上清晰的 NVLink、NUMA 拓扑标签,确保调度器能够精准匹配单机 8 卡物理边界。
- 3. 【Kueue 配额借用】 为各部门配置 LocalQueue,并在 ClusterQueue 层级设定合理的 Borrowing Limit 与抢占宽限期(通常 3 分钟)。
- 4. 【HAMi 驱动注入】 针对共享推理节点,验证容器内
LD_PRELOAD是否成功挂载libvgpu.so,并执行越界内存熔断测试。 - 5. 【双轨网络隔离】 物理核验计算专网(8x400G RoCEv2)与存储网络(双 100G)是否处于不同的交换机平面。
- 6. 【PFC/ECN 阈值】 在所有计算导轨交换机上配置严格的 DSCP 优先级映射与 PFC 队列流控,严防丢包重传风暴。
- 7. 【四级存储缓存】 检查训练节点本地 NVMe SSD 是否挂载为分布式 Checkpoint 的异步暂存盘,避免直写 S3 阻塞主训练流。
- 8. 【XID 秒级探针】 部署 GPU 健康探测 DaemonSet,对 Xid [31, 48, 79, 92] 等硬件致命错误配置自动 Cordon 策略。
- 9. 【热备池水位监控】 监控平台热备节点池水位,低于 1% 时立即向机房运维发出巡检补货告警。
- 10. 【全链路演练复盘】 每季度组织一次非预期断电与坏卡拔出逃生演练,实测验证 MTTR 是否稳定在 5 分钟以内。
8. 第八部分:Ringi 5 点口诀、自我检验清单与课后深度思考题
8.1 5 点押韵核心速记口诀
8.2 10 条白板自我检验清单
- 1. 什么是哲学家就餐死锁?为什么传统 K8s 逐 Pod 调度在大模型分布式训练中极易诱发死锁?
- 2. 详细阐述 Kueue 中 LocalQueue、ClusterQueue 与 Cohort 的关系与弹性借用逻辑。
- 3. 为什么在分布式训练中,同一个 Tensor Parallel(TP=8)组绝不允许跨越单机物理边界?
- 4. 什么是拓扑感知调度(Topology-Aware Scheduling)?它如何感知单机内的 NVLink 连接矩阵?
- 5. 比较 NVIDIA vGPU、MPS 与 HAMi 三种切分方案在显存隔离与故障隔离上的本质区别。
- 6. 说明 HAMi 是如何通过用户态
LD_PRELOAD劫持cuMemAlloc实现显存硬限制的。 - 7. 什么是 Rail-Optimized(导轨网络)?它相比传统无阻断 Fat-Tree 架构能节省多少核心交换机成本?
- 8. 详细画出万卡集群在捕获 GPU XID 79(掉卡)错误后的自动化故障自愈时序图。
- 9. 为什么必须为分布式训练设置优雅驱逐宽限期(Grace Period)?3 分钟宽限期通常用来做什么?
- 10. 解释四级存储金字塔(HBM ➔ NVMe ➔ 3FS ➔ S3)如何将万卡 Checkpoint 保存耗时从数十分钟压缩到数秒。
8.3 3 道高阶开放式课后思考题
- 抢占雪崩防范(Cascading Preemption Trap):在复杂的跨部门弹性借用体系中,如果高优先级作业频繁发起抢占,可能会导致低优先级作业不断被中断、重试,最终算力全部浪费在 Checkpoint 保存与恢复的开销上(Thrashing)。系统设计层面应引入哪些滞后惩罚(Hysteresis)与冷却机制?
- 异构集群混部统一调度(Heterogeneous Co-scheduling):若机房内同时存在 NVIDIA H100、A100 与华为昇腾 NPU 节点,如何基于同一套 Kubernetes 控制面设计统一的算力抽象层,使上层模型训练框架感知不到底层硬件差异?
- 网络拥塞扩散(Congestion Spreading)根因定位:在万卡 RoCEv2 导轨网络中,若某一台机器的光纤因弯折衰减发生持续丢包,PFC 会向上游逐级发送暂停帧(PAUSE Frame),导致整个交换机端口被大面积堵死。如何在平台侧秒级揪出产生拥塞的最初源头节点?
9. 第九部分:知识库与权威论文证据溯源
本章所有架构设计、调度状态机与自愈规程均严格溯源于以下权威文献与本地实测证据库:- 云原生 AI 平台与调度体系:
- 参考 AI_BOOK/AI-fundamentals/03_ai_cluster_ops/ 与 AI_BOOK/AI-fundamentals/04_cloud_native_ai_platform/:核对生产级集群运维与调度体系。
- Kueue 官方架构原著与源码规范:
- Kubernetes SIGs: Kueue: Kubernetes-native Job Queueing System Architecture RFC。
- GPU 虚拟化与 HAMi 架构:
- Project HAMi (Heterogeneous AI Computing Virtualization) 官方规范与驱动 Hook 规范。
- 超算中心拓扑与网络白皮书:
- NVIDIA SuperPOD: Next-Generation AI Infrastructure Architecture Guide。
附录:Appendix A — 大厂架构师级面试真题深度破局
Q1: 在万卡规模集群中,如果让你作为总架构师设计一套混合承载万卡预训练与千卡在线 Serving 的基础设施平台,请在白板上画出你的架构核心拓扑,并说明网络与存储的关键设计。
Ringi 考官拆解与满分回答:- 控制与调度层(软隔离与弹性借用):
- 采用 Kubernetes + Kueue 构建控制中枢,使用 Cohort 将全集群算力划分为保底配额与弹性共享池;
- 预训练任务实施严格 Gang 调度(All-or-Nothing),在线 Serving 配置基于排队时延的 HPA 与自适应背压;
- 白天 Serving 高峰时,自动抢占并优雅驱逐离线批处理任务,归还算力。
- 双轨算网拓扑(硬物理隔离):
- 计算专网:万卡预训练采用独立无损 8x400G RoCEv2,采用 Rail-Optimized 导轨拓扑,保证同卡号直连同一 Leaf 组;
- 存储专网:独立的双 100G 网络平面,负责 Checkpoint 读写与镜像拉取,绝不与计算 RoCE 流量争抢带宽。
- 四级分层存储流水线:
- 训练节点本地配置 1.5TB NVMe 本地盘作为高速缓存(Scratch Cache);
- Checkpoint 保存时,主进程百毫秒内将 DCP 写入本地 NVMe 立即恢复计算,后台 Daemon 异步同步至 3FS / Ceph 高性能并行存储,并定期归档至 S3。
- 全自动容灾 SLA:
- 部署轻量级 DaemonSet 500ms 周期嗅探 Xid 故障,预留 2% 热备节点池,做到单点故障 5 分钟内自愈回滚。
Q2: 为什么在多租户 GPU 共享场景中,基于用户态 Hook 的显存拦截方案(如 HAMi)比原生 NVIDIA MPS 更加安全稳定?
Ringi 考官拆解与满分回答:- 原生 MPS 的阿喀琉斯之踵(共享上下文故障级联):
- MPS 的核心设计初衷是提升小 Kernel 的并发利用率,其原理是将多个进程的指令合并到同一个由 Control Daemon 维护的单一 CUDA Context 中;
- 致命安全缺陷:由于共享同一个硬件上下文空间,一旦其中一个租户的进程发生了内存越界、非法指令或段错误(Segmentation Fault),整个 CUDA Context 会被驱动强制重置;
- 这会导致同一张 GPU 上运行的所有其他合法租户的业务进程在一瞬间全部被连带杀死!
- HAMi 用户态动态 Hook 的沙箱隔离:
- 每个容器依然拥有完全独立、隔离的操作系统进程与独立的 CUDA Context 上下文;
- HAMi 仅在用户态(
libvgpu.so)对cuMemAlloc等显存申请 API 进行无侵入拦截; - 当某个容器试图申请超过声明配额的显存时,拦截层在进入内核驱动前直接返回标准错误码
CUDA_ERROR_OUT_OF_MEMORY; - 只有违规的这一个容器抛出 OOM 异常或自行重启,宿主机物理驱动与相邻的租户容器完全不受任何影响,实现了高可靠的安全生产隔离!