第44讲:从八股背诵到白板手撕——AI Infra 大厂全真面试演练与系统设计题库全栈实战
主讲人:👓 Ringi(大厂 AI Infrastructure 资深架构师)
所属模块:Module 07: Post-Training 与相邻 AI Infra(选修)
篇章范式:☁️ 终局演练与架构设计篇(Grand Finale & System Design Paradigm)
核心导读:全面打破“背八股文”的虚假繁荣,直面一线大厂(阿里、字节、腾讯、美团、阶跃、MiniMax 等)最严苛的 AI Infra 面试试金石。从 405B 千卡资源与 3D 并行白板手算、NCCL 线上雪崩排查树,到万卡级统一训练推理集群端到端 System Design 终局答辩实战。
0. Ringi 为什么要做全真面试演练与系统设计真题集?
在很多准备 AI Infra 面试的候选人电脑里,往往存着几十篇所谓“高频八股合集”: “什么是 ZeRO 的三个阶段?Transformer 的 Attention 怎么算?什么是 RDMA?什么是 PagedAttention?” 很多同学把这些概念背得滚瓜烂熟。然而,一旦坐进顶级大厂资深架构师的面试间,或者推开线下面试的白板会议室,大部分人会在 10 分钟内遭遇降维打击:真实大厂面试评价标准:段位分水岭
- L4 / 初级工程师(概念知晓):能说出名词、参数定义与框架调用 API。但无法解释底层为什么这么做。
- L5 / 资深工程师(定量手算与物理穿透):心中有账本(No Naked Formula 2.0),提笔就能手算 FLOPs、显存占用、网络带宽与 Roofline 模型,给出严密数字。
- L6 / 技术专家(线上疑难杂症攻坚者):遇到 Xid 报错、NCCL 死锁、内存碎片、慢节点(Straggler)有条理清晰的逻辑排查树,能看懂底层内核与网络抓包。
- L7 / 顶尖架构师(千卡千亿生产级 System Design):能在白板上从零构建万卡算力平台,在算力利用率(MFU)、故障自愈容灾、多租户弹性调度与千万级成本之间做出精准权衡。
1. AI Infra 大厂面试考察雷达图与四大段位能力矩阵
💡 架构全景速览:在深潜源码前,先在白板上建立坚不可摧的大厂面试雷达、405B 千卡资源账本与万卡 System Design 物理底账。

1.1 大厂四大段位考察标准与淘汰标准矩阵
1.2 Ringi 工程师五问闭环:面试白板答辩基石
2. 第一部分:硬核定量手算与推导真题演练(No Naked Formula 2.0)
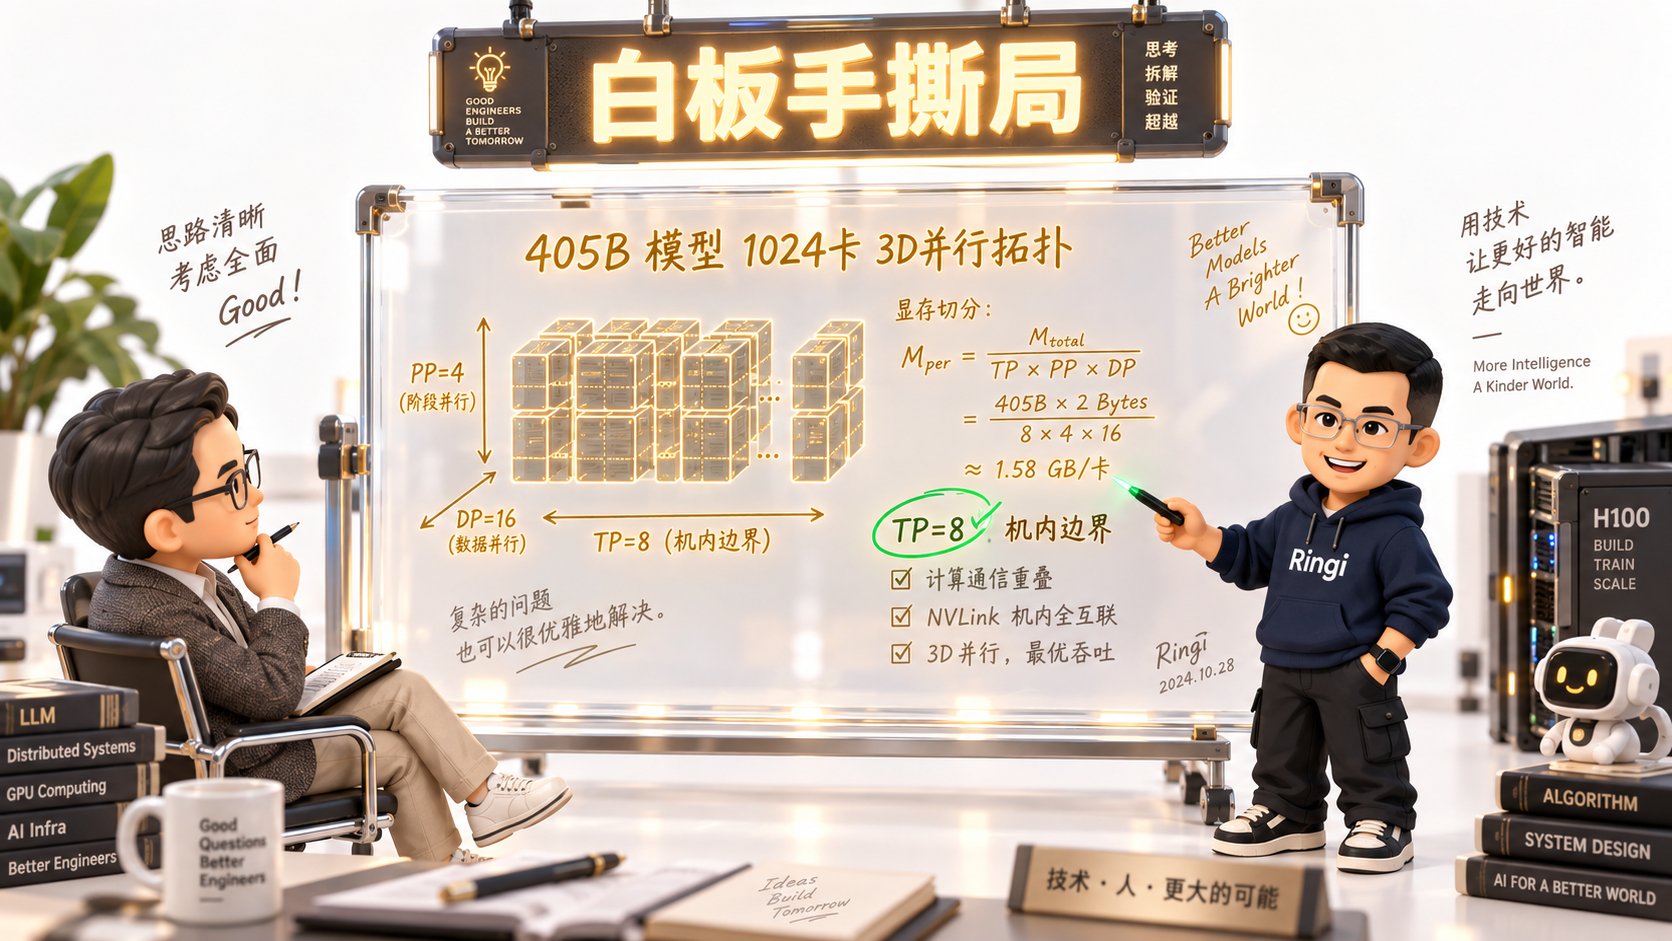
真题 1:【千亿模型资源与并行切分】手算 405B 模型 1024 卡训练全套账本
【面试官考题】: “我们需要在 128 台 8 卡 H100(共 1024 卡,单卡 80GB HBM3,NVLink 机内带宽 900 GB/s,机间 400 Gbps RoCEv2)上预训练一个 405B 参数的 Dense 大模型,全局序列长度 。 请你在白板上给出:- 3D 并行(TP, PP, DP/ZeRO)的推荐切分维度与理由;
- 单卡静态显存(参数+梯度+优化器)与动态显存(激活值)的严格手算;
- 假设集群实际达成的 MFU(模型浮点利用率)为 42%,单步耗时大约多少秒?训练 2 万亿 Token 需要多少天?机时费大约多少?”
Ringi 满分答辩与五步推导拆解:
步骤 1:3D 并行维度设计
- 张量并行(Tensor Parallel, TP) = 8:
- 物理铁律:TP 产生极高频的 GEMM 前后向 AllReduce,通信量巨大(每层两次)。
- 单台 H100 服务器内部 8 张卡通过 NVSwitch 提供 900 GB/s 双向互联带宽,而机间网卡仅 400 Gbps(有效带宽约 45 GB/s),二者带宽相差近 20 倍!
- 因此 TP 必须严格等于单机卡数(TP=8),坚决禁止跨物理机!
- 流水线并行(Pipeline Parallel, PP) = 8:
- 405B 模型层数约为 126 层。若 ,每个 Stage 承载约 16 层。
- PP 仅在 Stage 边界传递隐层激活值 ,通信量小,非常适合跨越机间网络。
- 数据并行(Data Parallel, DP) = 1024 / (TP × PP) = 1024 / (8 × 8) = 16:
- 采用 ZeRO-1(优化器状态分片):在 DP 组内将 AdamW 状态切为 16 份。
步骤 2:单卡显存精确账本手算
设模型参数量 ,采用 FP16/BF16 混合精度:- 模型权重(Weights): 通过 TP=8 与 PP=8 切分后,单卡持有的物理权重参数量为 。
- 梯度(Gradients):
- 优化器状态(AdamW Optimizer States): 单参数对应 12 字节(FP32 权重副本 4 字节 + 一阶动量 4 字节 + 二阶动量 4 字节)。 在 DP=16 组内采用 ZeRO-1 切分:
- 静态显存总计:
- 动态激活值显存(Activations): 开启 FlashAttention-2 与 Selective Activation Recomputation(选择性重计算)。 设单卡 Micro-batch ,序列长度 ,Hidden Size : 每个 PP Stage(16 层)重计算后的激活值峰值约为:
- 单卡显存峰值总计:
步骤 3:训练耗时、MFU 与机时费估算
- 单步训练 Token 量(Global Batch Size in Tokens): 设 Micro-batch ,流水线 Micro-batch 数为 64,则全局 Batch 大小 个序列。 单步处理 Token 数:
- 单步理论计算量(FLOPs): 采用经典大模型计算量法则(单 Token 对应 次浮点运算):
- 千卡硬件理论峰值算力: 单张 H100 SXM5 密集 BF16 峰值为 。 1024 卡总算力:
- 单步实际耗时(在 MFU = 42% 下):
- 训练 2T(2 万亿)Tokens 所需总步数与总天数:
- 机时费账单评估: 按当前公有云 8 卡 H100 服务器约 180 元/小时计算,128 台单日租金约 。 132 天总算力账单约 73,000,000 元(约 7300 万人民币)!
3. 第二部分:生产线上疑难杂症与事故排查真题(Troubleshooting Tree)
在高级面试中,面试官最看重的是候选人定位隐蔽线上事故的逻辑排查树(Decision Tree)。真题 2:【千卡 AllReduce 随机超时 Hang 死】排障实战
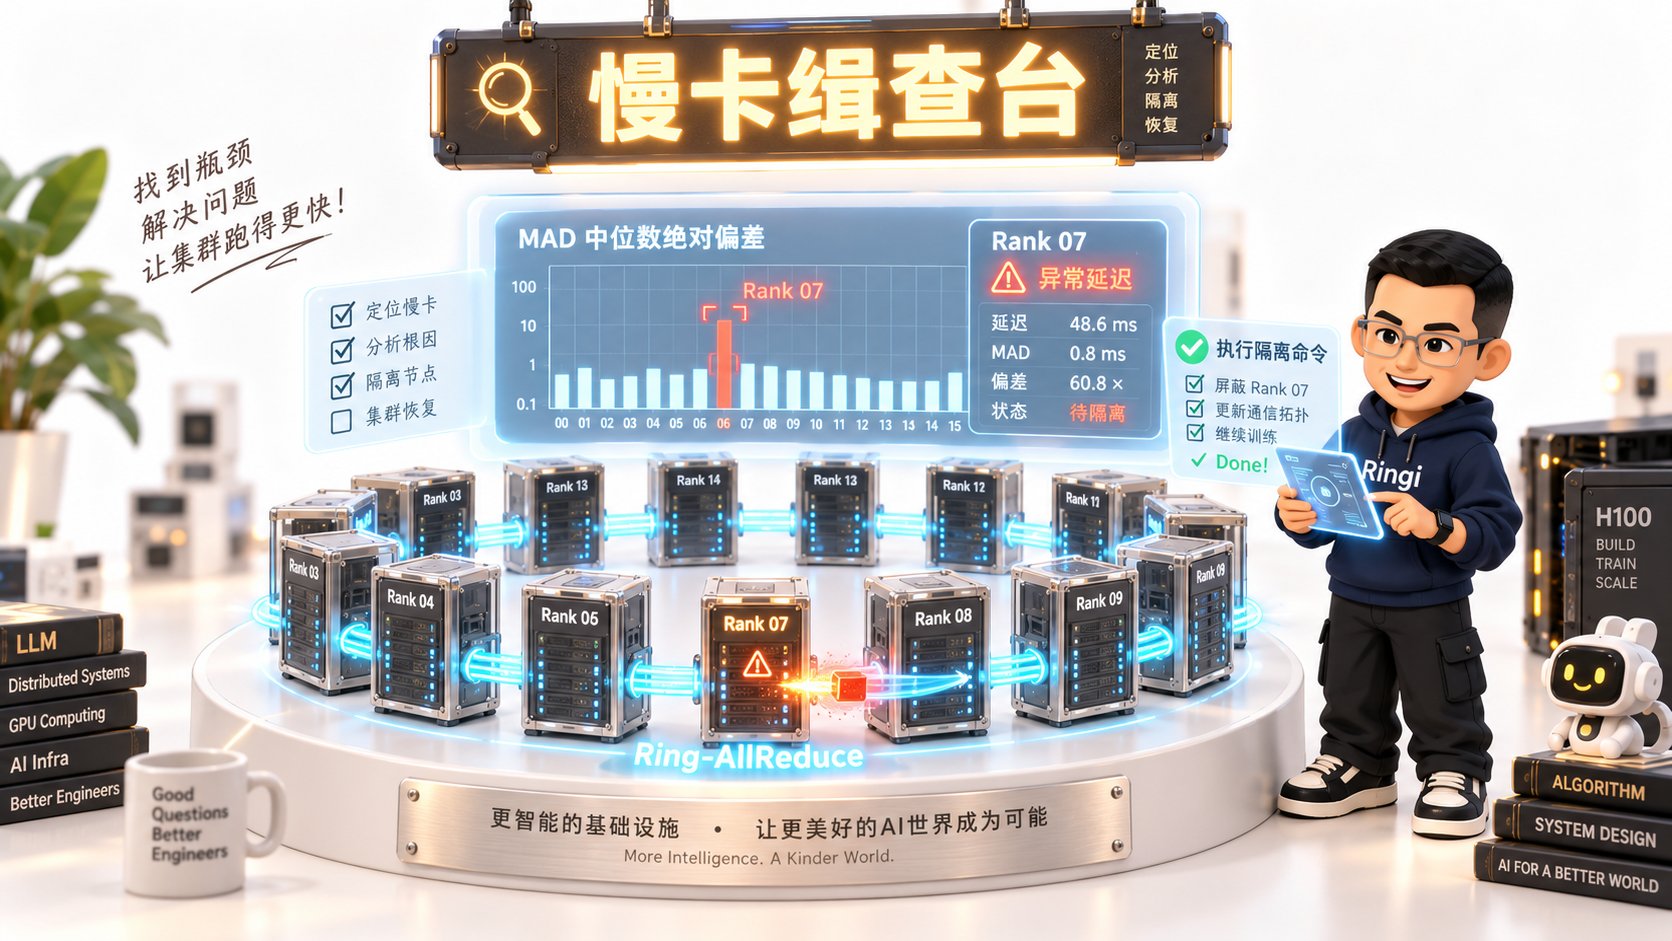
NCCL WARN Watchdog caught collective operation timeout: work timeout 1800000ms。
没有显存 OOM 报错,全集群 GPU 状态全部显示 100% 占用,但 Loss 停止更新。
请给出你从软到硬、从网络到硬件的体系化排查树,并说明如何快速揪出造成全集群停摆的慢卡(Straggler)或故障节点?”
Ringi 满分回答与体系化排查树:
4. 第三部分:千卡生产级 System Design 实战(架构师终局答辩)
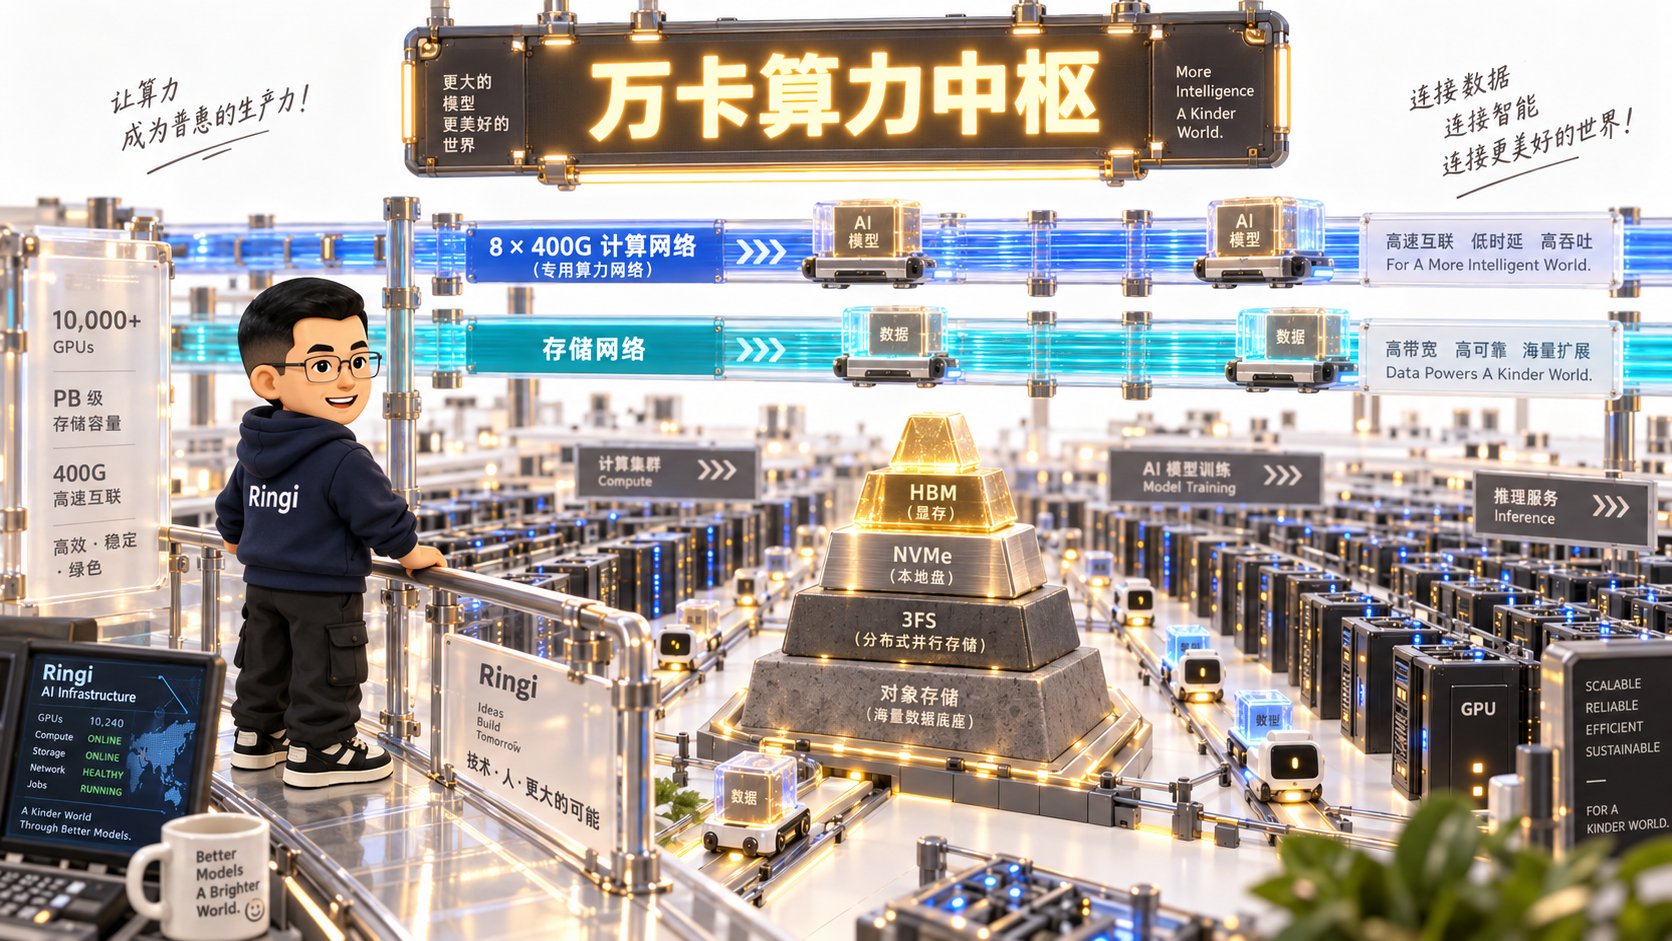
真题 3:【万卡统一算力中枢】端到端系统架构设计 RFC
- 千卡百亿/千亿模型大规模预训练与 SFT(要求长周期稳定运行,MFU > 40%);
- 万并发在线长文本 LLM Serving 服务(要求 P99 首字延迟 TTFT < 500ms,严格 SLO 保障);
- 海量 RAG 知识库检索与 Agent 多租户代码沙箱。 请画出全景架构图,给出网络拓扑、多级存储设计、调度策略与高可用容灾 SLA 方案。”
Ringi 顶尖架构师全景 RFC 设计案答辩:
架构核心抉择说明:
- 物理网络算网分离(Dual-Rail Network Topology):
- 每台 8 卡 GPU 主机配备 8 张 400Gbps 计算专网网卡(连入 Leaf-Spine 无损以太网,专跑 NCCL,启用 RoCEv2 PFC/DCQCN);
- 额外配备 2 张专用存储与业务网卡(连入独立存储网络,专跑 3FS 与 Kubernetes API),物理阻断存储写入突发流量对训练通信的冲击。
- 训练与推理物理隔离,流水线解耦(Disaggregated Architecture):
- 训练集群(8000 卡)专攻 Compute-Bound GEMM,追求最高 MFU;
- 推理集群(2000 卡)专攻 Memory-Bound 自回归生成,部署 PagedAttention 与 Radix 上下文缓存;
- 两者通过 3FS 分布式存储与机间 RDMA 定期做权重与偏好轨迹同步。
- 容灾与高可用 SLA 设计:
- 自动化故障隔离与自愈(MTTR < 5 分钟):DaemonSet 实时监控 DCGM Xid 错误与网卡丢包,一旦发现坏卡,自动触发 K8s 污点驱逐并从热备机器池拉起替代节点;
- 零开销异步内存快照:采用 Host RAM Staging(0.34 秒内存快照后立即恢复训练),每 200 步滚动保存,最多丢失 5 分钟算力。
5. 第四部分:动手实战代码实验室(100% 完整可运行)
本节提供 四个 100% 完整可运行、工业级无省略 的核心实战脚本,涵盖大厂面试推导自动化判卷引擎、慢卡与通信延迟异常离群值抓捕器、Serving P99 抖动与自适应背压模拟器,以及企业级 System Design RFC 架构模版。实战 1: 工业级 AI Infra 面试自动化判卷与 3D 并行手算引擎
本脚本模拟大厂面试官的评测机:候选人输入模型参数量、集群卡数、序列长度,脚本自动计算出标准理论值,并对候选人的白板切分方案进行打分与显存/通信校验。实战 2: NCCL 通信健康度与慢节点(Straggler)离群值探测器
在千卡集群中,单张卡变慢会拖垮全集群。本脚本实现高灵敏度离群值探测算法(基于滑动窗口中位数绝对偏差 MAD),秒级揪出产生通信微抖动的慢卡。实战 3: 生产级 Serving P99 抖动模拟与自适应背压限流器
在高并发在线大模型服务中,由于请求突增,KV Cache 显存暴涨会导致服务排队雪崩。本脚本实现自适应滑动窗口与排队时延感知背压限流器,确保 P99 严格在 SLO 预算内。实战 4: 企业级千卡 System Design 架构 RFC 规范模版
在架构答辩中,提供一份结构严谨的 RFC(Request for Comments)工程规范文案是顶级架构师的标准职业素养。以下是可直接复用的企业级规范模版。6. 第五部分:生产落地避坑指南与黄金准则
根据数十场大厂 P8/P9 级面试答辩与生产大事故复盘,提炼出如下核心避坑矩阵与 Checklist。6.1 大厂面试与技术选型核心避坑矩阵
6.2 AI Infra 架构答辩 10 条黄金 Checklist
- 1. 数据真实不脑补:所有硬件参数(H100 80GB, NVLink 900GB/s, RoCE 400Gbps)张口即来,绝不瞎猜。
- 2. 坚持五问闭环:陈述任何方案时,主动交代 Shape、Cost、Machine、Evidence、Production 五要素。
- 3. 牢记 16 字节法则:FP16/BF16 混合精度 AdamW 训练,静态显存保底算按 字节精确计算。
- 4. 守住 TP 机内边界:张量并行(TP)坚决不能跨越 NVSwitch 单机物理界限。
- 5. 重视激活值重计算:长序列训练必须主动提及 FlashAttention-2 与 Selective Recomputation 节省 70% 显存。
- 6. 区分 algbw 与 busbw:回答集合通信耗时必须分清算法带宽与总线有效带宽的换算倍率( )。
- 7. 掌握 MAD 慢卡算法:面对 Straggler 慢节点排查,给出中位数绝对偏差(MAD)而非简单的均值标准差。
- 8. 强调算网物理分离:千卡集群设计必须阐述专有计算网与专有存储网的双轨(Dual-Rail)硬隔离。
- 9. 给出业务妥协折中:不追求理论完美,主动探讨开发成本、算力账单、调试复杂度与系统吞吐的平衡。
- 10. 沉着冷静列排查树:面试官抛出线上事故题时,按“调用栈 ➔ 硬件指标 ➔ 驱动 ➔ 网络光模块”分层递进。
7. 第六部分:Ringi 总结与白板面试清单
7.1 5 点速记口诀
7.2 10 条高频终极大厂白板考察清单
7.3 3 道终极高阶思考题
- 思考题 1:在超大规模万卡训练中,随着网络节点数暴增,即使完全消除了慢卡,交换机网络的多径哈希(ECMP)不均匀导致单链路拥塞(Hash Collision)也是常见现象。现代无损网络是如何通过自适应路由(Adaptive Routing / Packet Spraying)从根本上消除这一问题的?
- 思考题 2:在 MoE(混合专家模型)万卡训练中,除了传统的 3D 并行,还引入了 Expert Parallel(EP)。EP 的跨机 All-to-All 通信量与模型稀疏度(Top-K)有着怎样的函数关系?在异构网络带宽下该如何放置专家?
- 思考题 3:从长远看,随着大模型进入“测试期计算(Test-Time Compute)”与长思维链(CoT)时代,推理系统的算力消耗正在迅速赶超训练系统。未来的 AI 数据中心应该如何动态平衡训练集群与在线推理集群的硬件规格复用?
8. 第七部分:权威参考文献与 AI_BOOK 映射
本讲所有公式、排查逻辑与系统设计真题均严格溯源自业界顶级实战开源项目与知识库底账:- 分布式训练 3D 并行与显存精确推导:
- 核心溯源:
AI_BOOK/AIInfra/04Train/、AI_BOOK/llm_interview_note/04.分布式训练/ - 重点参阅:Megatron-LM 论文推导、ZeRO-1/2/3 内存模型与通信开销分析。
- 核心溯源:
- 高频大厂面试题与故障排查库:
- 核心溯源:
AI_BOOK/llm_interview_note/、AI_BOOK/Algorithm_Interview_Notes-Chinese/ - 重点参阅:GPU 故障排查、NCCL 超时定位与分布式死锁诊断。
- 核心溯源:
- GPU 物理微架构与通信拓扑:
- 核心溯源:
AI_BOOK/AISystem/02Hardware/、AI_BOOK/GPU通信/ - 重点参阅:NVLink、RoCEv2、PFC/ECN 调优与 In-Network Computing 原理。
- 核心溯源:
- 推理系统与上下文存储:
- 核心溯源:
AI_BOOK/AIInfra/05Infer/、AI_BOOK/storage/inference_context_memory_storage/ - 重点参阅:RadixAttention、PagedAttention 与分布式多级缓存设计。
- 核心溯源:
附录 A: 4 道大厂最硬核高频面试题深度破局
Q1: 请在白板上手推 Ring-AllReduce 的通信时间与数据量公式,证明为什么通信耗时与 GPU 卡数 几乎无关?
Ringi 考官拆解与满分回答:- 算法两阶段解构:
- 设待同步的数据量为 (Bytes),总共有 张 GPU,将数据均分为 块;
- Phase 1: Scatter-Reduce:每个 GPU 向相邻节点发送一块数据并接收一块做本地累加。需要环形传递 轮,每轮发送大小为 :
- Phase 2: AllGather:将累加完成的结果环形广播给所有卡。同样需要传递 轮,每轮发送大小为 :
- 总通信量推导: 单卡总共发送的数据量为两阶段之和:
- 极限定量分析: 设网络单向物理带宽为 (Bytes/s),总通信时间(忽略极微小的每轮握手延迟 ):
Q2: 在大模型微调或预训练中,为什么训练往往在第 1 步能够跑通,却在几百步之后突然遭遇显存 OOM 崩溃?
Ringi 考官拆解与满分回答:- 动态变长序列输入(Dynamic Sequence Length Spike):
- DataLoader 在前几百步抽样到的文本长度较短,而在第 500 步偶然抽样到一个由多个超长样本(如 8192 Token 极限)组成的大批次;
- 激活值显存与序列长度呈二次方或线性激增,瞬间突破显存防线。
- PyTorch 内存分配器(C10 Allocator)的碎片化陷阱:
- PyTorch 采用按需分块内存池管理,若模型内部存在尺寸动态变化的中间张量,多次分配释放后会导致显存内部布满孔洞;
- 此时
torch.cuda.memory_reserved()已经接近 80GB,但当需要一块连续的 2GB 显存时,由于没有足够大的连续页,操作系统被迫抛出 OOM 崩溃。
- 梯度累积(Gradient Accumulation)中间计算图滞留:
- 开发者未显式调用
loss.backward()后的 detach,或者误将带有计算图引用的中间张量 append 到了全局 Python 列表中,导致计算图随 Step 递增发生巨额泄露。
- 开发者未显式调用
- 优化器状态的延迟初始化(Lazy Initialization):
- 部分优化器(如未显式预热的 AdamW 变种)的一阶与二阶动量不是在构造时申请,而是在第一次参数更新时才动态申请显存,正好在 Step 1 结束、进入反向更新的瞬间诱发崩溃。
Q3: 为什么说大模型在线推理 Serving 的 P99 治理比平均时延(Avg Latency)难十倍?工程上有哪些核心兜底手段?
Ringi 考官拆解与满分回答:- P99 恶化的本质是系统多级排队与长尾拥塞:
- 大模型自回归生成的解码长度高度不确定(有的请求输出 5 个 Token,有的输出 2048 个 Token);
- 少量超长请求会长时间霸占 GPU 计算槽位与 KV Cache 块,导致后续数十个短请求在调度队列中严重积压(Head-of-Line Blocking);
- 当并发冲高时,KV Cache 显存耗尽,系统被迫触发频繁的动态换入换出(Swap to CPU),PCIe 带宽瞬间打满,P99 呈断崖式恶化。
- 四大工程兜底利器:
- Chunked Prefill 与连续批处理(Continuous Batching):将超长 Prompt 的 Prefill 切片为微小分块,与轻量级的 Decode 阶段在同一个 Step 流水线交叠执行,彻底消除调度饥饿;
- Radix Context Caching 前缀复用:使公共参考知识库命中显存缓存,跳过耗时数秒的长文档 Prefill;
- 请求分级调度与动态降级:根据客户端 SLO 区分高低优先级,当 P99 逼近阈值时,自动向低优先级请求下发背压(429 限制或截断生成长度);
- 推训硬件解耦与前置预取:将高并发长文本路由至具有充沛本地 NVMe 缓存的高配节点,从根本上隔离长尾毛刺。
Q4: 面试官让你在白板上画出“万卡集群算网拓扑”,请说明 Fat-Tree 胖树架构与 Rail-Optimized 轨优化的本征区别与优劣。
Ringi 考官拆解与满分回答:- 传统无阻断 Fat-Tree(胖树架构):
- 结构:采用三层架构(Leaf ➔ Spine ➔ Core),下行与上行带宽收敛比为 1:1 无收敛;
- 优点:全互联无阻断,任意两台机器之间的理论双向通信带宽完全对等,调度器可以随意打散调度任务;
- 致命代价:在万卡规模下,Core 核心层交换机数量呈二次方膨胀,光模块和光纤布线成本极度高昂,能耗与建网成本令企业难以承受。
- Rail-Optimized(轨优化架构 - 现代 AI 超算事实标准):
- 结构:打破全互联假设。将每台 8 卡服务器的相同卡号(如所有主机的 GPU 0)集中连入同一组专属的 Leaf 交换机,形成独立的“计算导轨(Rail)”;
- 优势:
- 在大模型 Tensor Parallel(TP=8)在机内解决的前提下,机间集合通信主要是 Data Parallel(DP)或 Pipeline Parallel(PP);
- 每一条通信流水线被严格限制在对应的 Rail 导轨内部流转,绝大部分通信不需要经过昂贵的顶层 Core 交换机;
- 收益:全网交换机数量与光模块减少 40% 以上,网络布线极度清爽整洁,千卡集合通信吞吐反而更稳定可靠!