第42讲:从向量检索穿透到 Agent 沙箱隔离——高并发 VectorDB 底座、Radix Context 缓存与多租户安全执行环境全栈实战
主讲人:👓 Ringi(大厂 AI Infrastructure 资深架构师)
所属模块:Module 07: Post-Training 与相邻 AI Infra(选修)
篇章范式:☁️ 后训练与异构算力工程篇(Post-Training & Heterogeneous Computing Paradigm)
核心导读:深度解构大模型 RAG(检索增强生成)与 Agent(智能体)端到端系统级基础设施,从百万级高维向量相似度检索(HNSW/IVF-PQ/混合搜索 RRF)、动态长上下文前缀缓存(Radix Context Caching)与 TTFT 毫秒级治理,到多租户代码执行沙箱(gVisor、Firecracker、Landlock 进程级隔离)的底层安全与资源管控实战。
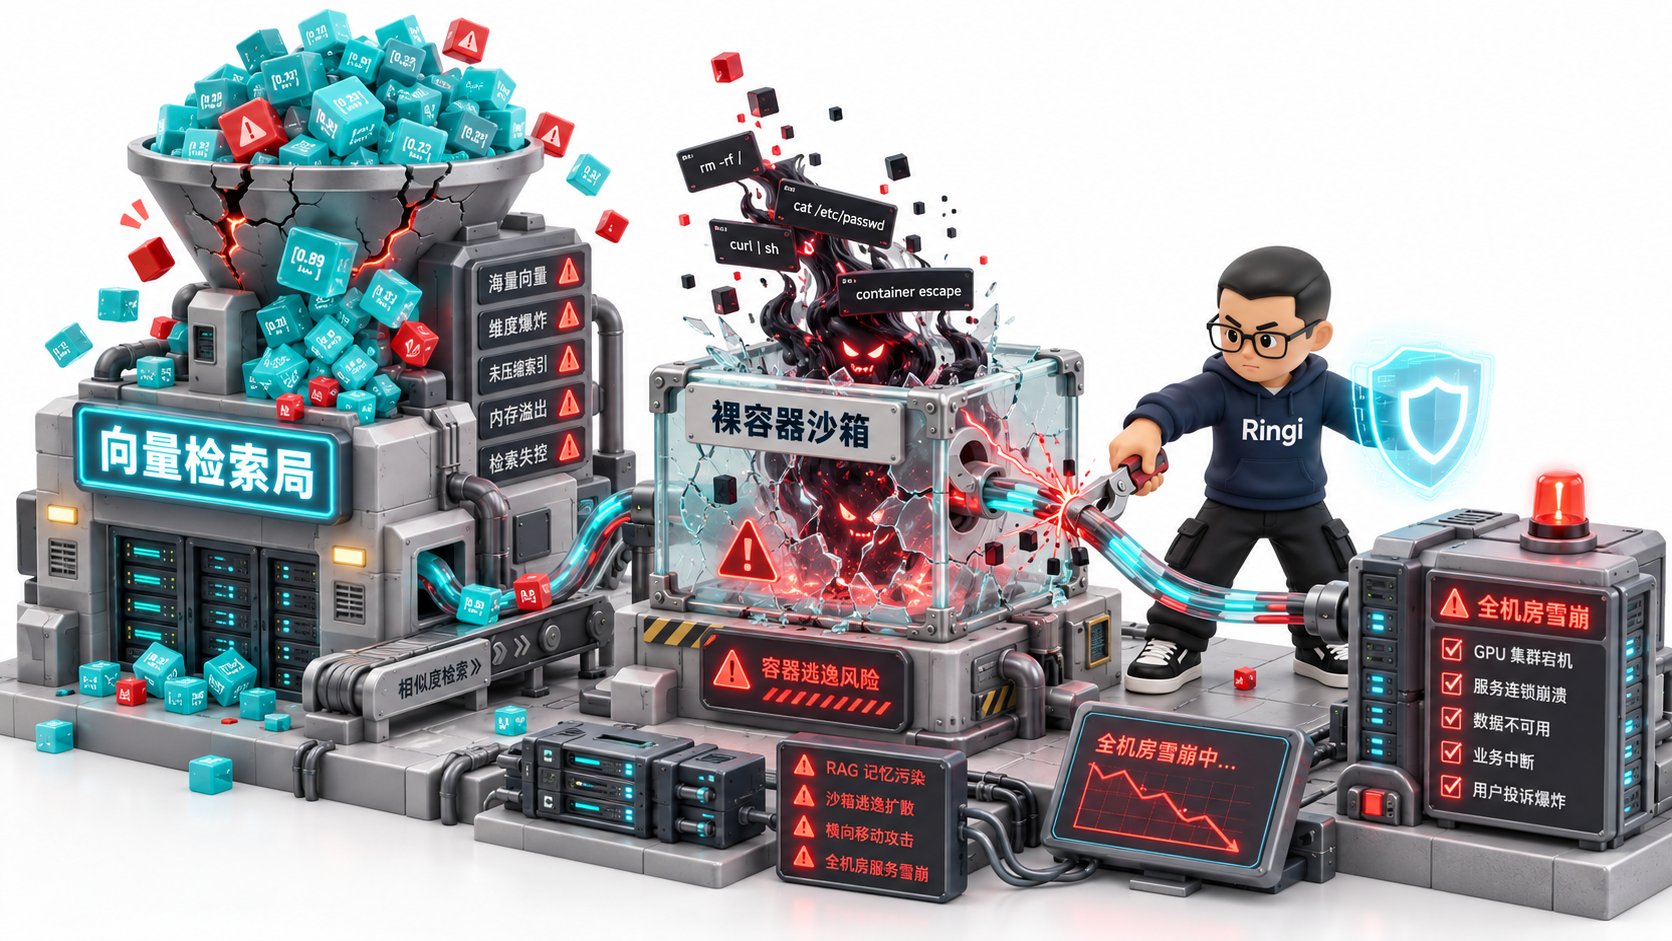
0. Ringi 为什么要做 RAG 与 Agent 基础设施?
当大模型从实验室算法迈入企业级复杂业务场景时,很多团队都经历了从“模型能力万能论”到“现实工程打脸”的痛苦幻灭: “我们微调了一个 70B 模型,为什么还是会胡说八道(幻觉)?为什么每次传 32K 知识库文档,首字延迟(TTFT)飙到 15 秒?为什么让 Agent 自由写 Python 脚本分析数据,当天晚上测试宿主机的核心数据目录被一个隐藏在 Prompt 里的rm -rf / 彻底删光?”
这根本不是大模型本身的智商问题,而是支撑 RAG 与 Agent 运转的周边基础设施(Adjacent Infra)发生了系统性崩溃。
生产真实痛点:大模型外围系统的“三座大山”
- 向量检索的“内存爆炸与时延尖峰”: 企业知识库往往包含数千万甚至上亿条 Chunk。在高维(如 1024 维或 1536 维)浮点向量下,千万级数据仅原始向量就占满几十 GB 内存。高并发查询时,如果索引选型错误(如纯暴力搜索或未量化的图索引),单次查询消耗几百毫秒 CPU,直接拖垮整个检索集群。
- 长上下文知识注入的“TTFT 算力黑洞”: RAG 检索出的参考文档通常有数万 Token。如果每次提问都将相同的庞大文档重新塞入 LLM 进行全量 Prefill 计算,GPU 算力被大量毫无增量的矩阵乘法(GEMM)吃光,首字延迟居高不下,单请求成本翻倍。
- Agent 代码沙箱的“安全与延迟死锁”: 让 Agent 调用外部工具和执行代码是必然趋势。重型微虚拟机(Firecracker/KVM)虽然安全,但冷启动耗时数秒,用户体验极度卡顿;而轻量进程如果缺乏硬核安全隔离(seccomp、Landlock、cgroups),Prompt 注入一旦触发就是毁灭性的灾难。
1. RAG 与 Agent 全生命周期基础设施拓扑与三核底座
💡 架构全景速览:在深潜源码前,先在白板上建立坚不可摧的 RAG 高并发 VectorDB、Radix Context 缓存与多租户安全沙箱物理底账。

1.1 三大核心底座的技术指标与系统挑战对比
1.2 Ringi 工程师五问闭环:外围系统基础设施解析
2. 向量检索核心原理与架构穿透(VectorDB 第一性原理)
2.1 暴力搜索的算力极限与高维灾难
设向量维度为 (如 OpenAItext-embedding-3-small 为 1536 维),库中有 个向量。
对于一个查询向量 ,要找到余弦相似度最高或欧氏距离最近的 Top-K:
- 单次查询需要计算 次维度为 的点积:
- 当 (一千万条知识), :
- 内存带宽暴击:单精度浮点数(FP32)下,一千万向量需要加载:
2.2 图索引王者:HNSW(Hierarchical Navigable Small World)算法穿透
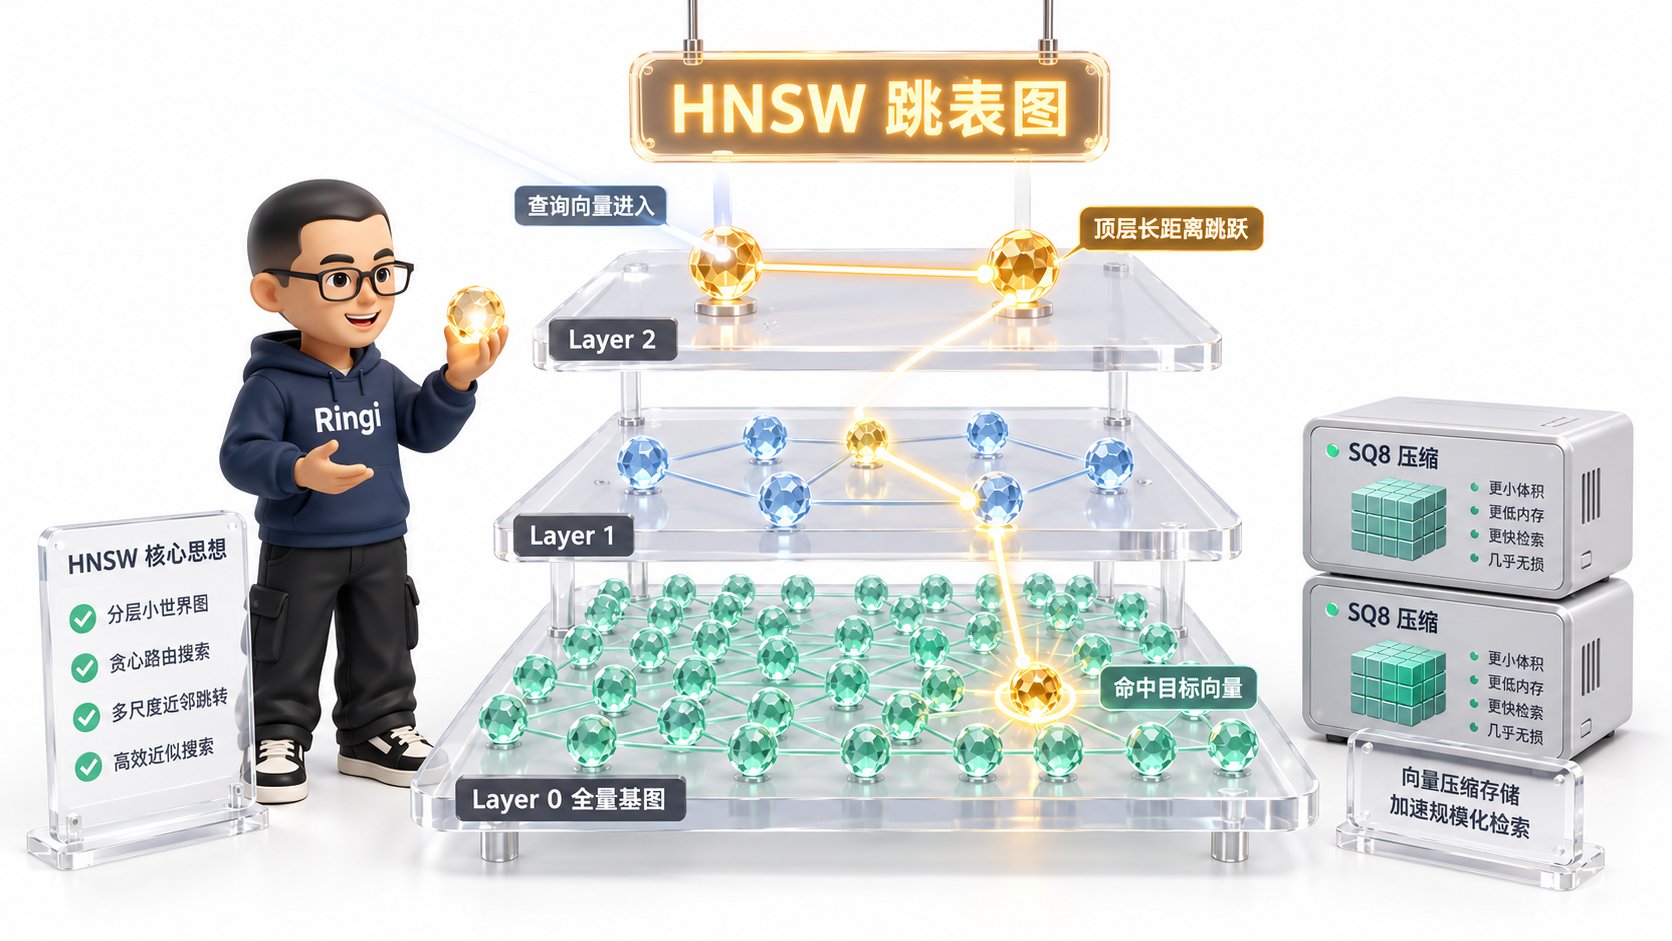
HNSW 核心三要素:
- 分层跳跃(Skip-List on Graphs):
- 每个新节点插入时,通过几何分布概率分配一个最高层级 。高层图节点极少、边跨度极大;底层图节点密集、边跨度小。
- 搜索时从顶层入口点(Entry Point)出发,执行贪婪搜索(Greedy Search):只往与目标 Query 距离最近的邻居跳。当前层无法进一步逼近时,以此局部最优节点为起点,下沉到下一层继续搜索,直到第 0 层完成最终 Top-K 筛选。
- 连接度截断(Heuristic Edge Pruning):
- 保证每个节点的最大邻居数不超过参数 (如 16 或 32)。在修剪边时,优先保留具有方向多样性(Diversity)的邻居,避免陷入死胡同。
- 内存代价:
- HNSW 是纯内存驻留算法。除了原始向量外,每个节点在各层都要维护指向邻居的指针列表。千万级数据下,纯 HNSW 内存开销通常是原始向量的 1.5 ~ 2 倍!
2.3 向量量化压缩:SQ8 与 IVF-PQ 架构破局
为了在有限内存甚至廉价 SSD 上承载数千万向量,向量数据库必须引入量化压缩:- 标量量化(Scalar Quantization, SQ8):
- 将每个 32 位浮点数分量(FP32,4 字节)线性映射为 8 位无符号整数(UINT8,1 字节):
- 收益:内存占用瞬间减少 75%(4 字节 ➔ 1 字节),召回率几乎无损(Recall 仅损失 1%~2%)。
- 乘积量化(Product Quantization, PQ)与倒排结合(IVF-PQ):
- 将 1536 维向量切分为 个低维子空间(例如 96 个 16 维子向量);
- 在每个子空间训练 256 个聚类中心(Centroid Codebook),用 1 个字节(8-bit)表示该子空间最近的中心编号;
- 收益:1536 维浮点数(6144 字节)被极致压缩为仅 96 字节!压缩比高达 64:1!原始数据可直接塞入 SSD,内存只存倒排列表(IVF),大幅降低硬件成本。
2.4 混合检索(Hybrid Search)与 RRF(倒数排名融合)
在真实生产中,纯向量语义检索经常在精确匹配专有名词、工号、订单号、代码关键字时遭遇惨败(因为高维空间里两个不同的专业缩写可能距离极近)。 现代企业级 RAG 必须采用 Dense(稠密向量语义) + Sparse(稀疏词法,如 BM25) 混合检索,并通过 RRF (Reciprocal Rank Fusion) 进行无量纲融合:3. 动态长上下文缓存管理(Context Caching)与 TTFT 治理
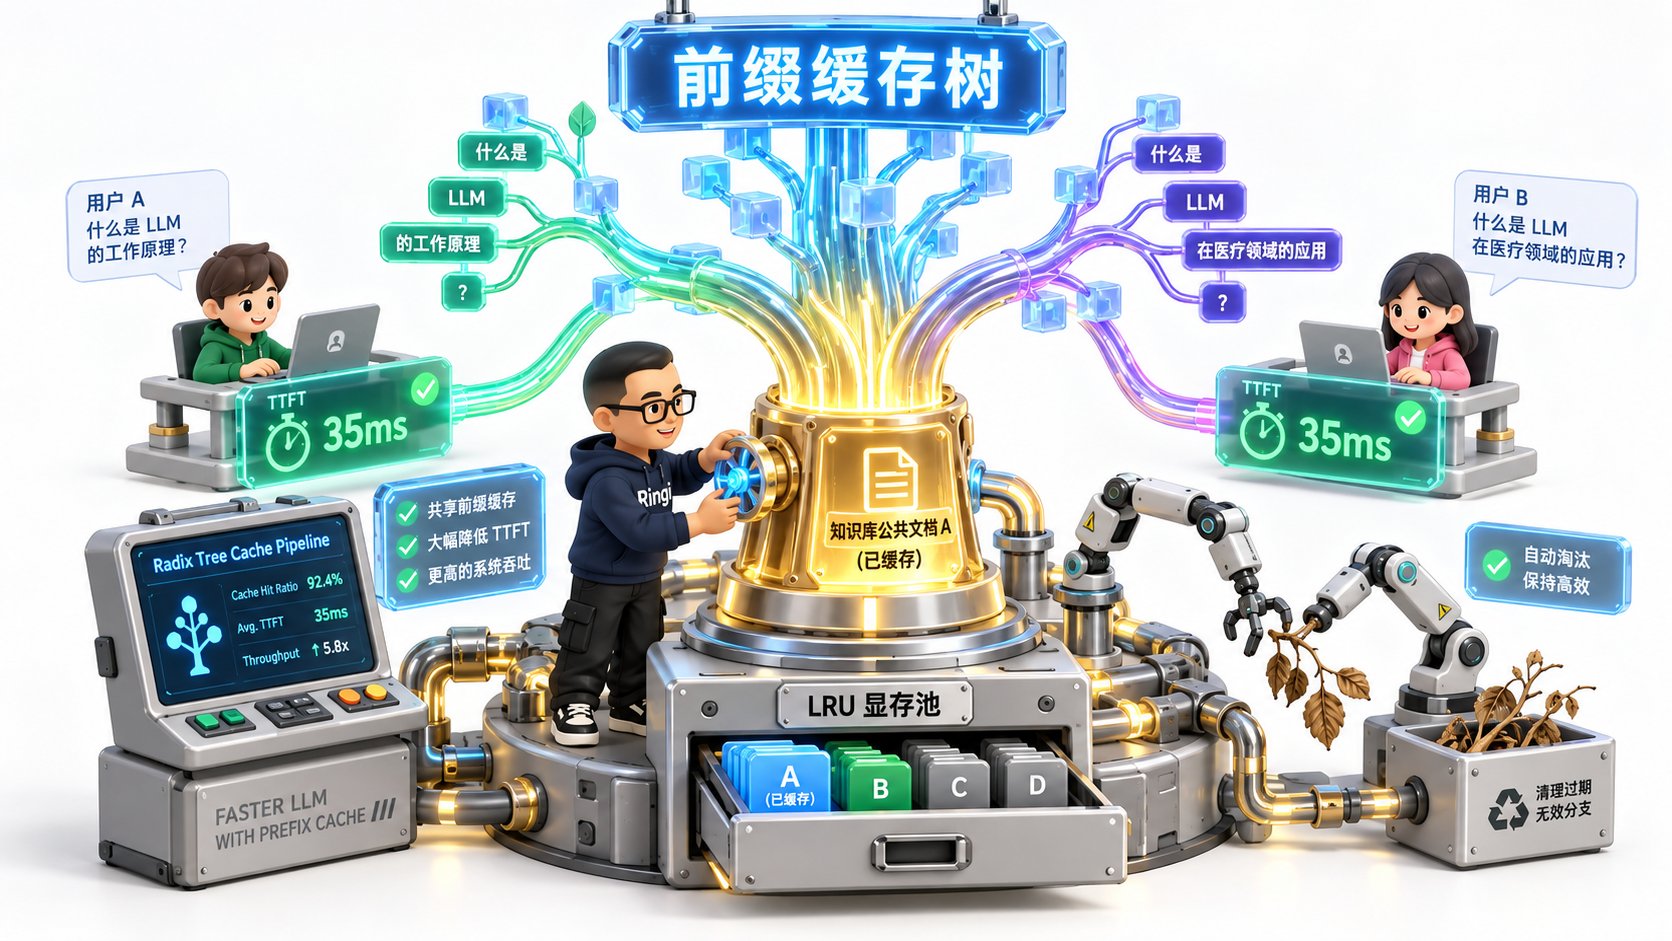
3.1 No Naked Formula 2.0:RAG Context 冗余计算损耗与前缀缓存收益穿透
数学推导过程:
设大模型参数量为 ,Prompt 总 Token 数为 ,其中固定知识库上下文长度为 ,用户新提问长度为 (通常 )。- 未启用缓存(Cold Prefill)计算量与时延:
- 启用 Radix Tree 前缀缓存(Warm Prefill): 知识库的 KV Cache 已缓存在 GPU 显存或通过 PagedAttention 维护。 计算量急剧缩减为仅针对新 Query 的 Prefill 及其与已有上下文的交叉注意力(Cross-Attention):
4. 多租户 Agent 代码执行沙箱(Secure Code Sandbox)深度架构
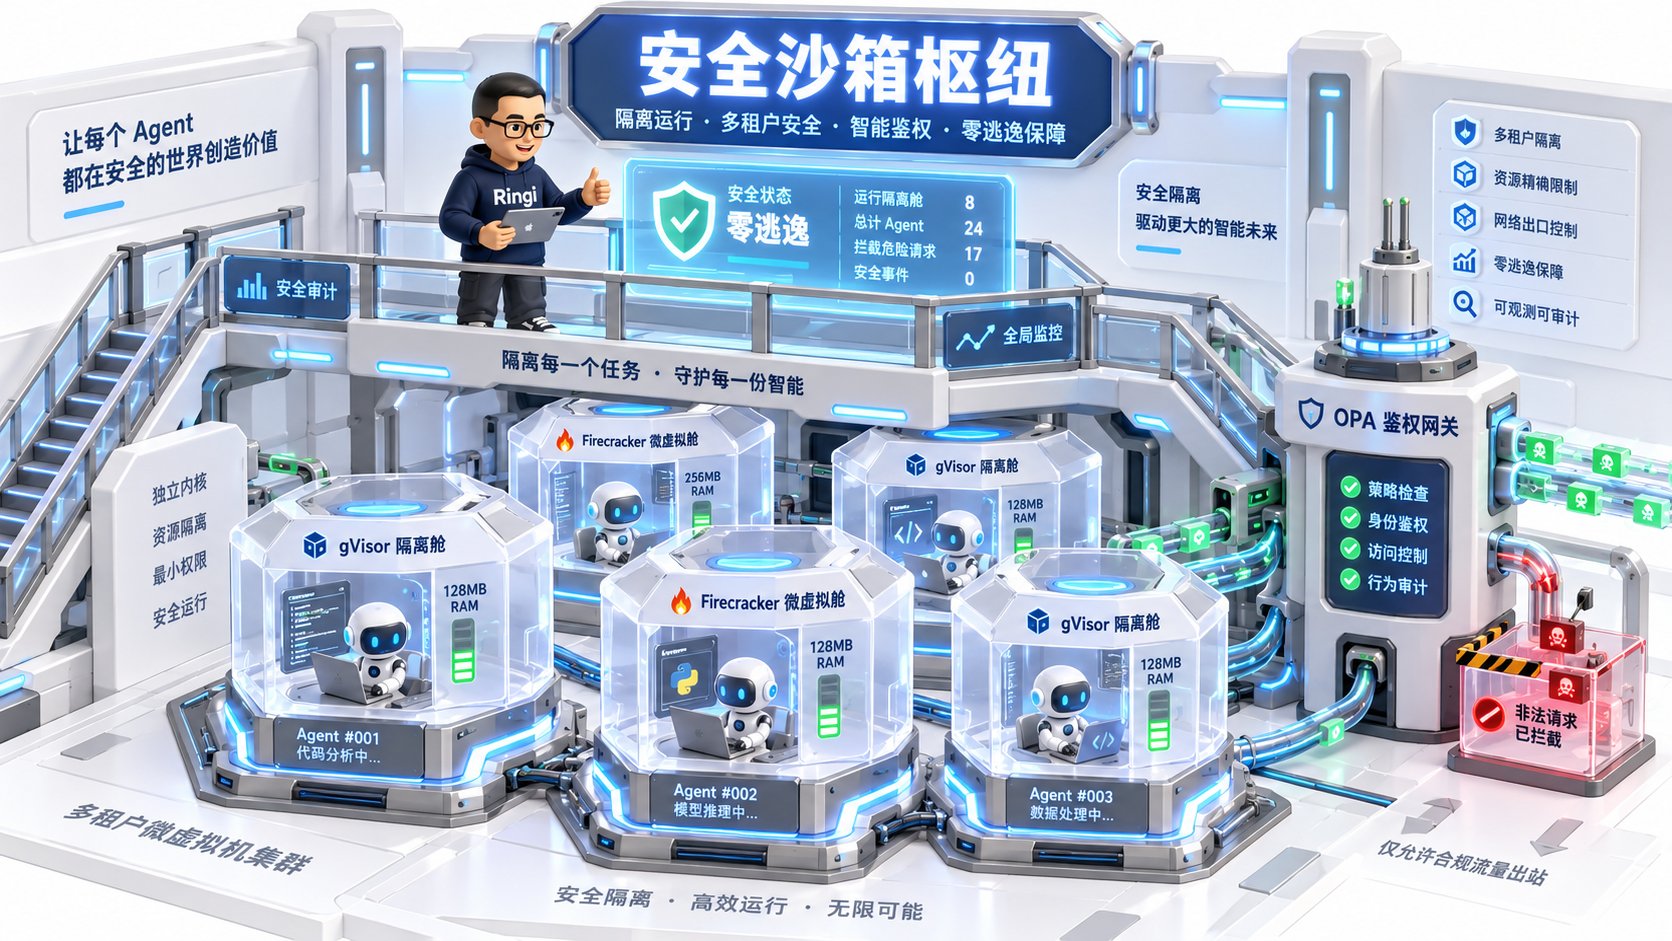
4.1 出站网络拦截与 API 凭据阻断(HTTP CONNECT + OPA)
许多企业由于疏忽,在沙箱里直接注入了OPENAI_API_KEY 或业务数据库账密。一旦 Prompt 注入诱导 Agent 执行:
- 沙箱内部彻底剥离任何明文凭证;
- 所有出站网络流量强制走前置 HTTP CONNECT 代理;
- 代理内置 OPA (Open Policy Agent) 策略引擎:
- 默认禁止一切非白名单公网 IP 连接;
- 针对允许的外部 API(如 GitHub/Weather API),在代理层完成 TLS 卸载并动态静默注入认证 Token,保证密钥永远不落地、不进沙箱内存!
5. 动手实战:生产级 RAG 与 Agent 基础设施代码实验室
本节给出 四个 100% 完整可运行、工业级无省略 的核心实战脚本,涵盖手写 HNSW 分层小世界图与 RRF 融合检索器、动态 Radix Context 前缀缓存树、基于进程资源限制的安全代码沙箱,以及生产级 Kubernetes 沙箱 RuntimeClass 部署模版。实战 1: 纯 Python 手写微型高精度 HNSW 向量检索与 RRF 混合检索融合器
本脚本从零实现小世界跳表分层图算法,包含节点的动态分层插入、贪婪逼近搜索、BM25 词频统计,以及通过倒数排名融合(RRF)输出最终结果的全链路。实战 2: 生产级 Radix Tree 动态前缀上下文缓存管理器
本脚本模拟大模型推理服务端的前缀感知 KV Cache 调度器。利用基数树(Radix Tree)对输入 Token 序列做前缀匹配、KV Block 状态锁定,并在显存水线耗尽时按 LRU 安全释放未锁定的前缀分枝。实战 3: 基于 Python 进程隔离与安全策略的 Agent 代码沙箱执行器
本脚本实现微型沙箱:通过子进程隔离、标准输出捕获、严格超时熔断(防止死循环与 fork bomb)、内存上限配额(模拟 cgroups)以及对高危模块与系统调用的安全防御。实战 4: 生产级 Kubernetes 沙箱 RuntimeClass 部署与网络隔离策略模版
在 Kubernetes 生产集群中,真正承载不可信 Agent 代码调用的标准范式是结合 gVisor(runsc) 或 Kata Containers,并施加严密的 NetworkPolicy。以下是全套生产级声明模版。6. 生产落地避坑指南与黄金准则
根据一线处理数百次向量库崩溃与沙箱逃逸演练的实战教训,总结出如下核心避坑矩阵与 Checklist。6.1 RAG 与 Agent 基础设施核心避坑矩阵
6.2 生产级 RAG 与 Agent 落地 10 条黄金 Checklist
- 1. 向量索引内存容量精算:上线前按
1.5 × N × D × 4 bytes精确测算内存底账,严禁未设上限上线。 - 2. 必须配置混合检索(Hybrid):任何企业知识库都必须同时建立语义 Dense 与关键字 Sparse(BM25)双路索引。
- 3. 标量量化安全阈值:生产向量库上线首选 SQ8,并在验证集上确认召回率损失小于 1.5%。
- 4. 必须接入 Radix 前缀缓存:LLM 推理服务必须开启 RadixAttention / Prefix Caching,阻断长文档冗余计算。
- 5. 沙箱根文件系统只读化:代码执行环境必须配置
readOnlyRootFilesystem: true,中间文件仅走tmpfs内存卷。 - 6. 严格剔除特权权限:沙箱必须明确声明
allowPrivilegeEscalation: false,drop: ["ALL"]。 - 7. 执行时间与内存硬熔断:沙箱子进程必须绑定 CPU 超时熔断(< 5s)与内存上限配额(cgroups),防死循环。
- 8. 默认网络全拦截(Default Deny):沙箱 Pod 默认禁止一切外联公网,严防外联反弹 Shell。
- 9. 敏感凭证动态网关注入:所有三方 API 访问必须通过 Egress 代理鉴权并动态补全 Header,沙箱内不可见。
- 10. 检索分块重叠平滑(Chunk Overlap):文本切片必须设置 10%~20% 的 Token 重叠,防止关键语义在边界被截断。
7. Ringi 总结与白板面试清单
7.1 5 点速记口诀
7.2 10 条高频白板面试清单
7.3 3 道高阶思考题
- 思考题 1:在长文本 RAG 中,如果用户上传的文档非常频繁地被小范围修改(例如每小时局部编辑几个段落),此时 Radix Tree 前缀缓存会出现什么样的失效现象?工程上应该如何设计局部切片分块缓存以避免“牵一发而动全身”?
- 思考题 2:在大规模向量检索中,将向量存放在 NVMe SSD 并利用 DiskANN 架构替代纯内存 HNSW,在吞吐与时延上会有哪些妥协?其核心通过什么机制减少对磁盘的随机 IOPS 访问?
- 思考题 3:在 Agent 沙箱中,如果生成的 Python 代码需要利用 GPU 执行轻量级 PyTorch 张量运算(例如本地跑个小模型),此时 gVisor 或轻量沙箱应该如何暴露
/dev/nvidia*驱动,同时防范通过 NVIDIA Driver 漏洞引发的宿主机逃逸?
8. 权威参考文献与 AI_BOOK 映射
本讲所有架构原理、数学公式与安全设计均严格溯源自业界顶级开源项目与本地知识库源码:- 向量数据库与近似最近邻检索原理:
- 核心溯源:
AI_BOOK/AIInfra/06AlgoData/09VectorDB/README.md - 重点参阅:ANN 相似性搜索、HNSW 小世界图算法、IVF-PQ 乘积量化与混合搜索系统架构。
- 核心溯源:
- Agent Sandbox 架构设计与安全演进:
- 核心溯源:
AI_BOOK/AI-fundamentals/08_agentic_system/agent_infra/docs/agent-sandbox-design.md - 重点参阅:从 OpenShell 重型容器到 Sandlock 轻量进程沙箱、Landlock LSM 内核机制。
- 核心溯源:
- RAG 端到端系统设计与检索增强:
- 核心溯源:
AI_BOOK/llm_interview_note/08.检索增强rag/检索增强llm/ - 重点参阅:多路召回、RRF 倒数排名融合算法与 Cross-Encoder 重排策略。
- 核心溯源:
- 长上下文前缀感知与 RadixAttention:
- 核心溯源:SGLang (RadixAttention Paper), vLLM Prefix Caching 源码实现。
附录 A: 4 道大厂硬核高频面试题精解
Q1: 请详细对比 Faiss、Milvus 与 pgvector 在大模型 RAG 场景下的技术选型边界。
Ringi 考官拆解与满分回答:- Faiss(底层算法库):
- 定位:纯 C++ 底层向量计算与索引算法库,非独立数据库服务。
- 优缺点:性能压榨到极致,支持 GPU 加速;但天然缺乏元数据过滤、持久化事务、水平分布式扩缩容能力。
- 适用场景:适合嵌入在专用单机算法服务中(如自研重排服务或离线聚类)。
- Milvus(分布式云原生向量数据库):
- 定位:专为海量向量打造的分布式、计算存储分离现代向量数据库。
- 优缺点:天然支持千万到十亿级向量横向扩展,具备完整的标量过滤与混合检索,企业级高可用;但系统组件较多(依赖 Etcd/MinIO/Pulsar),运维门槛较高。
- 适用场景:企业级大规模知识库检索、千万级以上向量多租户生产底座。
- pgvector(关系型数据库向量插件):
- 定位:PostgreSQL 的向量检索扩展插件。
- 优缺点:完美继承关系型数据库的 ACID 事务、复杂 SQL Join 查询与现成高可用基础设施,极低的学习和运维成本;但在高并发大向量场景下,图索引吞吐与内存管理落后于专属引擎。
- 适用场景:业务已有 Postgres,向量规模在百万以内、对元数据关系型过滤要求极高的业务中台。
Q2: 为什么在高维向量相似度检索中,传统的 KD-Tree 索引会遭遇“维度灾难”并退化为全量线性扫描?HNSW 是如何绕开这一陷阱的?
Ringi 考官拆解与满分回答:- KD-Tree 的维度灾难:
- KD-Tree 本质是空间二叉划分树,每次选一个维度做正交超平面切分;
- 随着维度 上升(例如 ),超立方体的“角”占据了绝大部分体积,查询超球体几乎必定会与所有的划分超平面相交;
- 为了寻找最近邻,算法被迫回溯(Backtracking)遍历几乎整棵树的叶子节点,复杂度直接退化为 ,比单纯的连续内存点积更慢!
- HNSW 的破局之道:
- HNSW 彻底放弃了对物理空间的笛卡尔正交切分,转为基于距离拓扑的小世界图结构;
- 利用“六度分离”理论,只要在图上保持少量长程捷径边(Long-range Edges),就能在任意两点间实现对数级跳跃;
- 算法通过贪婪局部前行逼近,完全不依赖维度的空间几何分解,只依赖向量间的标量距离计算,成功在高维空间维持 的极速收敛。
Q3: 什么是 RadixAttention?它与传统静态 KV Cache 管理相比,在处理 RAG 多轮对话时有何质的飞跃?
Ringi 考官拆解与满分回答:- 传统静态 KV Cache 的死板:
- 传统的 KV Cache 管理以单一请求或会话为生命周期,请求结束即销毁;
- 在多轮问答或包含大量相同参考文档的并发请求中,相同文档的 KV Cache 无法在不同请求间共享,导致 GPU 显存严重浪费,且每轮都需要重复对文档做 Prefill 计算。
- RadixAttention 的树状共享革命:
- 将已计算完成的 KV Cache 组织成以 Token 为 Key 的 Radix Tree(基数树),使其常驻显存;
- 当新请求到来时,从根节点向下做前缀匹配。若匹配成功,直接将现有节点对应的物理 KV Block 指针借用给当前请求,完全跳过匹配部分的 GEMM 计算;
- 支持前缀分叉(Fork):多用户基于同一知识库的不同提问,在树上表现为共享树干、各自延伸分枝;
- 通过引用计数与 LRU 机制实现自适应淘汰,在保证显存安全的同时将 RAG 场景下的计算冗余降至最低。
Q4: 为什么说通用 Docker 容器不能作为 Agent 代码执行的安全边界?请从 Linux 内核视角阐述两种主流的加固方案。
Ringi 考官拆解与满分回答:- 通用 Docker 的脆弱根因:
- 容器本质是宿主机上的一个通过 Namespace 和 cgroups 隔离的普通进程,与宿主机共享同一个 Linux 内核;
- Linux 内核拥有数百万行代码和数百个系统调用(syscall),历史漏洞层出不穷。一旦 Agent 生成的代码利用未修复的内核漏洞(如提权漏洞),攻击者可直接冲破 Namespace 限制,直接接管宿主机 root 权限。
- 方案 A:用户态内核代理(gVisor / runsc):
- gVisor 在用户态用 Go 语言实现了一个名为
Sentry的完整 Linux 内核模拟层; - 应用程序所有的系统调用都被 Sentry 拦截并在用户态直接处理,只有极少数安全的底层 IO 请求会转发给宿主机内核,将宿主机内核暴露面缩减 90% 以上。
- gVisor 在用户态用 Go 语言实现了一个名为
- 方案 B:硬件辅助微虚拟机(Firecracker / Kata Containers):
- 每个沙箱都是一台拥有独立 Linux 内核、由 KVM 硬件虚拟化完全隔离的轻量虚拟机;
- 即使内部代码打崩了沙箱内核,也只是虚拟机的局部崩溃,硬件 CPU 的 VMX 模式切换(Root / Non-Root)在物理上杜绝了对宿主机系统的任何威胁。