🏛️ 第14讲:物理邻居还是异地恋?——GPU 节点与集群硬件拓扑(PCIe/NVLink/NVSwitch/Clos/Rail-Optimized)
主讲人:👓 Ringi(大厂 AI Infrastructure 工程师)
所属模块:Module 01: GPU 硬件架构、数据搬运、集群通信与 Overlap
篇章范式:🏛️ 硬件物理架构与网络组网篇(Hardware Topology & Networking Paradigm)
核心导读:
很多初入分布式大模型领域的算法工程师,在写 PyTorch 分布式代码时,脑海中往往存在一个极具欺骗性的抽象模型:集群里所有的 GPU 都是同构的、扁平的,它们仅仅是由一个整型变量rank_id标识的无差别计算单元。
然而在物理世界中,这种虚拟抽象会瞬间引爆系统的性能雪崩!
在真实的智算中心里,GPU 0 与 GPU 1 之间通过机内 4 颗 NVSwitch 实现了 900 GB/s 的双向极速对轰(纳秒级近邻);GPU 0 与 GPU 4 之间虽然在同一个机箱,却分属两个不同的 CPU NUMA 节点,中间横亘着高延迟的 UPI 总线;而如果你不慎让 GPU 0 与另一台机器的 GPU 通信,数据就必须挤过只有 50 GB/s 的跨机网卡;更致命的是,如果跨机通信走错了交换机轨道(Rail),56 对流量会瞬间挤爆上层 Spine 交换机,导致集群利用率断崖式暴跌 70%!
物理拓扑决定了通信带宽与延迟的阶梯,而拓扑感知调度(Rank Placement)则决定了大模型集群的算力生死。
本讲我们将彻底撕开虚拟抽象的幕布,把单机 8 卡服务器与万卡集群的物理机箱大卸八块,深度推导 PCIe Switch、NVSwitch、Clos 无收敛架构与 Rail-Optimized 轨道组网的第一性原理!
📑 目录导航
- 0. Ringi 开场:生产真实现场与痛点冲突
- 1. 单机 8 卡物理机箱解剖:从 CPU NUMA 到 NVSwitch 巨网
- 2. 机内总线代际演进:PCIe 与 NVLink 的物理对决
- 3. 跨机集群组网:Clos 架构与 Fat-Tree 无收敛网络
- 4. Rail-Optimized(轨道优化)组网:大厂集群的无损高速公路
- 5. Rank Placement 拓扑感知映射:让分布式算子住进最优工位
- 6. 拓扑诊断利器:
nvidia-smi topo与 NCCL 拓扑探测深度解构 - 7. 动手实战与代码实验室(Minimal Runnable Code)
- 8. Ringi 避坑指南与生产性能工程黄金 Checklist
- 9. Ringi 5 点核心速记口诀、自我检验清单与课后深度思考题
- 10. 📚 参考资料与核心源码/经典论文指引
- 附录:Appendix A — 大厂硬核高频面试题与白板推导(Interview Drill)
0. Ringi 开场:生产真实现场与痛点冲突
0.1 真实工程矛盾:同样是 64 卡集群,为什么 MFU 相差 2.5 倍?
在大厂的基础设施运维中,我们曾遇到过一起极其诡异的性能归因迷案: 公司两个算法团队分别申请了 8 台同规格的 8 卡 H100 服务器(共计 64 张 GPU),运行完全一致的 LLaMA-3-70B 预训练脚本(采用 3D 并行:张量并行 TP=8,流水线并行 PP=2,数据并行 DP=4):- A 团队(老牌 Infra 团队):模型浮点利用率(MFU)稳定在 52.4%,每步迭代耗时 1.35 秒;
- B 团队(新业务团队):模型浮点利用率(MFU)却只有惨淡的 20.8%,每步迭代耗时高达 3.42 秒!
为什么同样是 64 张卡,性能会硬生生拉开 2.5 倍的鸿沟? 当 Infra 工程师深入排查其分布式启动脚本时,真相瞬间大白:
- A 团队在调度启动时,严格设置了拓扑感知参数,让 TP=8 的通信组严格收敛在每台单机内部的 8 张卡上(走 900 GB/s 的机内 NVLink);
- B 团队直接使用了默认的随机容器调度,其 Rank 映射在物理拓扑上是错乱的:每个 TP=8 组的 8 张卡被稀稀拉拉地分摊到了 4 台不同的物理机上!
0.2 线上真实事故复盘:网线全插在同一个 ToR 引发的“跨 Rail 流量血崩”
我们再来看一起记录在数据中心网络建设中的真实 P1 事故: 某千万级智算中心新建了一个由 32 台 8 卡 H100 节点构成的算力集群。根据大厂标准规范,该集群必须采用 Rail-Optimized(按卡分轨) 的方式组网。然而,现场机房施工团队由于缺乏对大模型分布式通信的理解,为了“省事美观”,在机柜布线时做出了一个致命改动:- 将一台机箱背后的 8 根 400G OSFP 高速光缆,全部整整齐齐地插入了同一个机柜顶部的同一台 ToR(Leaf)交换机中!
All-to-All 通信阶段时,灾难爆发了:
- 32 台机器并发向全网打散分发微型 Token 切片;
- 由于同机的所有网卡全部挂在同一台 Leaf 交换机上,原本设计中应该分流到 8 条独立物理轨道的全网流量,瞬间全部涌向了机柜顶部的单台 ToR 交换机;
- ToR 交换机向上连通 Spine 交换机的上行链路瞬间被挤爆,端口队列缓冲区发生严重的 Micro-burst 丢包;
- 紧接着触发了漫延全网的 PFC 死锁风暴(Deadlock Storm),所有网卡的 QP 队列全部挂起,训练单步耗时直接从 300ms 狂飙到 4.5 秒,最终引发全网 NCCL Timeout 崩溃离线!
0.3 集群物理互联层级与性能矩阵全景速查表
在深入机箱与交换机之前,我们先把物理世界中从芯片到集群的六大互联层级底账摊开:1. 单机 8 卡物理机箱解剖:从 CPU NUMA 到 NVSwitch 巨网
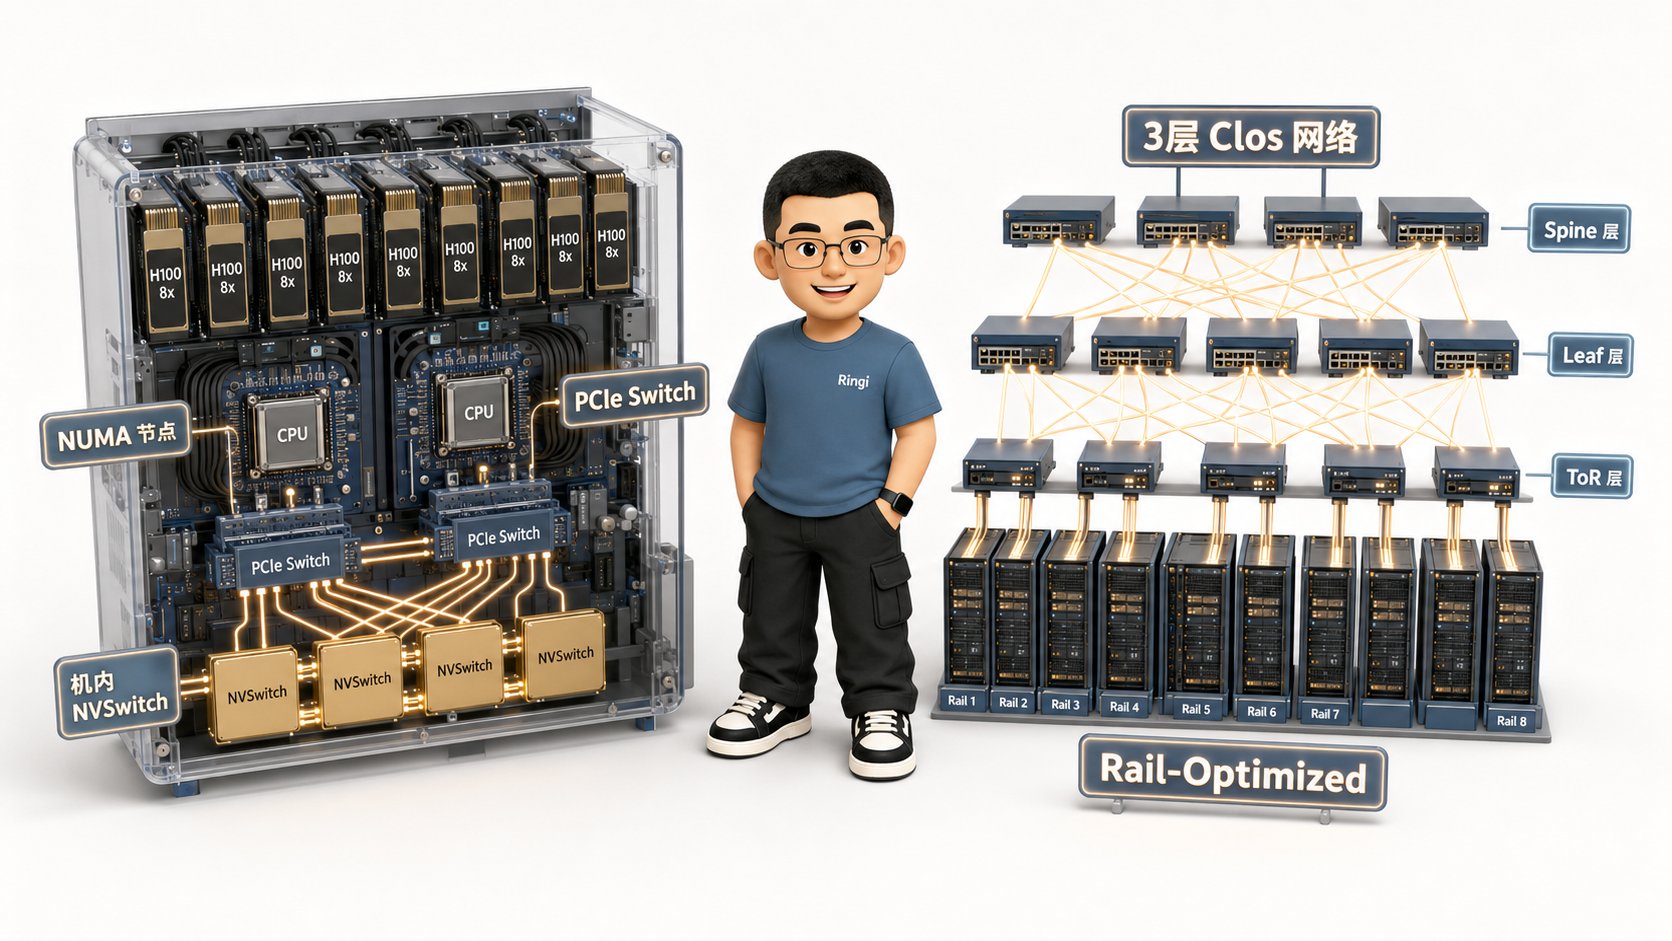
为了在深入具体细节前建立全局的拓扑心智模型,下方给出了现代 AI 智算中心从机内 8 卡 SXM 底板全交叉互联,到跨机 3 层 Clos 无收敛胖树与 8 轨道独立优化(Rail-Optimized)的工业级全景架构拓扑:
1.1 HGX H100 8-GPU 物理拓扑俯瞰:双路 CPU、两颗 PCIe Switch 与 8 卡布局
当前工业界最标准的单机 8 卡训练服务器形态(如 NVIDIA HGX H100 / DGX H100)内部,绝不仅仅是把 8 块 GPU 简单插在主板上。它的物理主板被划分为高度精密的两个平面:计算与互联平面(NVLink Domain) 与 控制与网络平面(PCIe/Host Domain)。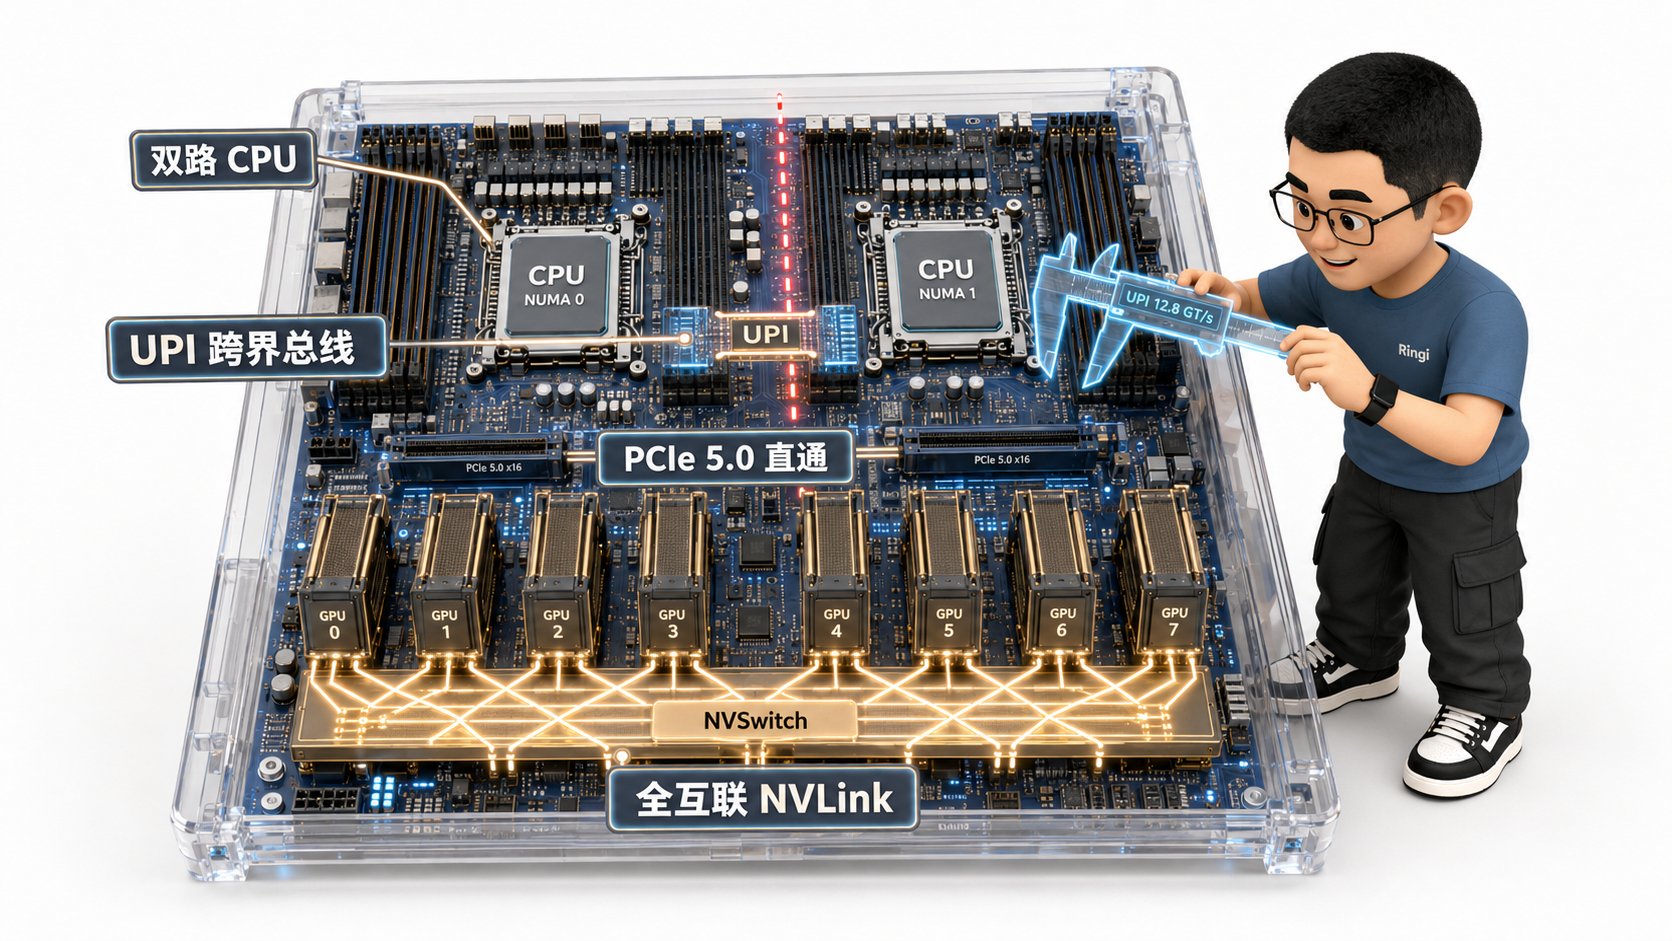
- 下层:NVSwitch 构成的纯 GPU 极速王国:8 张 GPU 彼此之间完全不依赖主板 PCIe,而是直接插入底部的 NVLink 背板,通过 4 颗 NVSwitch 实现两两直连;
- 中层:PCIe Switch 构建的 GPUDirect 直通桥梁:网卡并不是插在 CPU 上的,而是与对应的 GPU 一同接入专用的 PCIe Switch,形成极短的 P2P 路径;
- 上层:双路 CPU NUMA 的跨域裂痕:GPU 0
3 归属 CPU 0,GPU 47 归属 CPU 1。两者之间唯一的数据桥梁是一根脆弱的 UPI 总线。
1.2 CPU NUMA 架构与 UPI 总线陷阱:为什么跨 Socket 访问会成为隐形刺客?
在现代服务器中,双路 CPU 采用的是 NUMA(Non-Uniform Memory Access,非一致性内存访问) 架构。每个 CPU Socket 拥有自己独立挂载的本地 DDR 内存通道与 PCIe 控制器:- CPU 0 访问挂载在自己本地通道的 DDR 内存,时延通常为 80~100 ns,带宽打满可达 200~300 GB/s;
- 如果 CPU 0 试图去读写挂在 CPU 1 上的内存,或者去操作插在 CPU 1 侧 PCIe 插槽上的网卡,数据就必须通过连接两个 CPU 的 UPI(Ultra Path Interconnect / AMD Infinity Fabric) 总线跨界漫游!
📌 生产避坑法则: 如果你的分布式进程在启动时没有做 NUMA 亲和性绑定(CPU Affinity Binding),操作系统调度器可能会把驱动 GPU 0 的 Python 进程随意调度到 CPU 1 的核心上运行。 此时该进程发起的每一次网卡通信敲 Doorbell、每一次主机显存拷贝,都在疯狂跨越 UPI 总线,直接导致机间通信延迟暴增 40% 以上!
1.3 PCIe Switch 的角色与 GPUDirect P2P 直通:解密 GPU 与网卡的同巢设计
在早期的 GPU 服务器中,GPU 和网卡直接插在 CPU 的 PCIe 插槽上。当时如果要把数据从 GPU 显存发给网卡,数据路径是: 这条路径被称为 Staged Copy,不仅浪费了两倍的 PCIe 带宽,还强行占用了 CPU 算力。 而在现代 HGX 服务器中,硬件架构引入了 PCIe Switch(PCIe 交换芯片):- PCIe Switch 作为一个独立的硬件数据包路由交换机,向下同时连接 1 块 GPU 和 1 块 400G 网卡(ConnectX-7);
- 当 GPU 想要向网卡发送数据时,触发 GPUDirect RDMA (P2P):
- 数据完全不需要向上流经 CPU Root Complex,更不需要进入 Host 内存! 物理数据包直接在 PCIe Switch 内部掉头完成转发,实现了极致的亚微秒级延迟与全带宽直通。
1.4 NVSwitch 革命:从点对点跳步到 8 卡 900 GB/s 全互联(Full-Mesh)
在没有 NVSwitch 的前代架构中(如早期 PCIe 服务器或使用简单桥接器的系统),GPU 之间的物理连接是点对点的(Ring 或 Mesh)。这带来了一个致命困局:- GPU 0 要给 GPU 1 发数据,可以一跳直达;
- 但 GPU 0 要给身处远端的 GPU 3 发数据,就必须把数据先发给 GPU 1,由 GPU 1 作为中继节点转发给 GPU 2,最后到达 GPU 3!
- 多跳中转的灾难:中间节点的显存总线被无情打扰,端到端延迟随跳步数线性累加,有效带宽发生严重折损!
在 HGX H100 基板上,整整集成了 4 颗第三代 NVSwitch 芯片。每颗芯片拥有高达 64 个 NVLink 端口,单机内部的总双向交换容量达到了惊人的 7.2 TB/s!这就是为什么在单机 8 卡内部,你可以肆无忌惮地跑高频 AllReduce 的底层物理倚仗!
2. 机内总线代际演进:PCIe 与 NVLink 的物理对决
2.1 物理层技术参数对照表:PCIe 4.0/5.0 vs NVLink 3.0/4.0/5.0
很多人只知道 NVLink 比 PCIe 快,但不知道它到底快在哪些物理维度。我们把近三代物理互联的硬核参数进行精准对齐:2.2 为什么 PCIe 无论怎么升级也追不上 NVLink?(引脚、损耗与专有协议栈)
这是一个非常高频的大厂架构面试深水题:“既然 PCIe 也在从 Gen4 升级到 Gen5、Gen6,为什么在 GPU 互联领域,它永远只能当配角,无法取代 NVLink?” 从第一性原理分析,有三大难以逾越的物理与工程屏障:1. 物理引脚密度与走线布局的死局(Pinout & PCB Density)
- PCIe 是通用总线:它必须向后兼容各种声卡、网卡、RAID 卡和固态硬盘,其金手指插槽的标准尺寸与引脚定义被 PCIe SIG 联盟严格锁死。一张标准的 PCIe x16 插槽只有 164 个引脚,走线密度受限;
- NVLink 是专用板级互联:H100 SXM5 模块底部采用了密集的高科技微型触点(Mezzanine Connector),引脚数量高达数千个!它可以肆无忌惮地铺设 18 条高速差分 Link,物理通道供给量直接碾压了标准 PCIe 插槽。
2. 高频信号衰减与调制技术(PAM4 vs 铜线损耗)
- PCIe 5.0 虽然跑到了 32 GT/s,但依然采用传统的 NRZ(单电平) 调制,在高频下信号衰减极大,主板走线超过 20 厘米就必须加装昂贵的 Retimer 芯片来放大信号;
- NVLink 从第 3 代开始全面切换为 PAM4(四电平脉冲幅度调制),每个时钟周期编码 2 个比特,在相同的物理频率下直接将传输效率翻倍,配合定制的高频低介电常数 PCB 背板,实现了恐怖的吞吐。
3. 协议栈开销的本质差异(Transaction Layer Overhead)
- PCIe 协议极其厚重:包含事务层(TLP)、数据链路层(DLLP)和物理层。每次传输都要封装庞大的报头,进行复杂的流控额度(Credit)通告与中断处理,硬件协议解包固定耗费数百纳秒;
- NVLink 专为显存共享设计:它从底层原生支持 GPU 显存原子操作(Remote Memory Atomic)与细粒度 Load/Store,硬件直接将内存地址映射为高速数据包,协议开销被压缩到极致,端到端延迟直接压进 100 纳秒以内!
2.3 NVLS(NVLink SHARP)网内计算:NVSwitch 芯片内部的硬件加法归约
在前一讲中我们提到:普通的 DMA 引擎只能搬运,遇到含加法的 AllReduce 必须交由 SM 计算。但在 H100 时代的 NVSwitch 3 芯片上,NVIDIA 释放了一项黑科技——NVLS(NVLink Network SHARP)!NCCL_NVLS_ENABLE=1 直接激活这一底层硬件加速!
2.4 Blackwell 架构的物理飞跃:NV-HBI(10 TB/s)与 NVL72 机架级铜缆背板
在最新发布的 NVIDIA Blackwell(B200 / GB200)架构中,硬件拓扑的设计哲学再次跨越了历史性的台阶:- NV-HBI(High-Bandwidth Interface)超高速片间互联:
- B200 芯片由两颗完全对称的 GPU Die 拼接而成;
- 两个 Die 之间通过定制的 NV-HBI 硅中介层直接相连,带宽高达恐怖的 10 TB/s!
- 在软件和 CUDA 驱动视角下,两颗物理 Die 完全融为一体,共享统一的 192GB HBM3e 内存池与一致性缓存。
- NVL72 机架级超大规模全互联:
- 过去一个 NVLink 域最多只能覆盖单机 8 张卡;
- GB200 NVL72 彻底打破了机箱的物理边界:整整一个 42U 机柜内部,集成了 72 颗 B200 GPU 与 18 颗专用外部 NVSwitch 交换机托盘;
- 机柜背后不再使用易损且昂贵的光模块,而是铺设了由 5000 多根精密高速铜缆构成的重型立体无损背板(Over-Rack Copper Cable Cartridges)!
- 革命性意义:72 张 GPU 构成了一个史无前例的巨型单一 NVLink 域,任意两卡之间独享 1.8 TB/s 的无阻塞全互联带宽! 原本需要跨机走慢速 RDMA 的张量并行(TP),在 NVL72 上可以直接狂飙到 TP=72,超大模型的训练与推理延迟被直接降维打击!
3. 跨机集群组网:Clos 架构与 Fat-Tree 无收敛网络
3.1 为什么万卡集群不能用传统大二层交换机?
当我们走出单台服务器、构建百卡甚至万卡的大型智算集群时,我们立刻会撞上一道网络工程的物理铁墙:我们为什么不能制造一台拥有 10000 个端口的超级大交换机,让所有 GPU 插在上面? 答案是绝对不可能,原因有三:- 交换芯片内部 Crossbar 面积极限:芯片内部的交叉开关复杂度与端口数呈平方级关系( )。以目前最顶级的 Tomahawk 5 或 Quantum-2 芯片为例,单芯片的极限接入端口通常只有 64 个(800G)或 128 个(400G),物理硅片面积已经逼近光刻掩模版的极限;
- MAC 表与 ARP 广播风暴:大二层网络如果接入上万个节点,一旦有节点发起 ARP 寻址广播,风暴会瞬间瘫痪全网控制面;
- 故障爆炸半径:如果单台中心交换机发生宕机,全网所有万张卡瞬间殉爆。
3.2 3 层 Clos / Fat-Tree 网络拓扑架构解构(Leaf ➔ Spine ➔ Core)
为了用小规模的交换芯片拼装出无限扩展的巨型网络,1953 年贝尔实验室的 Charles Clos 提出了划时代的 Clos 多级交换网络模型。在 AI 集群中,该架构以 Fat-Tree(胖树) 的形态落地:3.3 收敛比(Oversubscription)的第一性原理:为什么大模型训练必须严格要求 1:1 无收敛?
在传统的互联网 Web 服务中,交换机的设计普遍采用 收敛网络(如 3:1 或 4:1 收敛):- 例如:一台 ToR 交换机向下连服务器的总带宽是 400 Gbps,而向上连 Spine 交换机的总带宽只有 100 Gbps;
- 这是因为 Web 用户的访问是随机且稀疏的,不可能所有服务器同时把网络打满(统计复用原理)。
- 第一性原理:分布式训练受制于 BSP(Bulk Synchronous Parallel)同步屏障;
- 反向传播结束时,全网成千上万张卡会在同一毫秒内并发调用 AllReduce 广播自己的梯度;
- 如果网络存在 2:1 的收敛比,意味着 50% 的流量在冲上 Spine 交换机时必须原地排队!
- 排队直接触发交换机队列拥塞、丢包重传,瞬间拉低所有节点的速度。由于整个集群受限于最慢的那张卡(Straggler Effect),只要有一个节点被拥塞卡顿,全网所有昂贵 GPU 全部被迫停机干等!
💡 架构黄金标准: 大模型智算集群的主干网络,下行总带宽必须严格等于上行总带宽,即 1:1 绝对无收敛(Non-blocking Fabric)!
3.4 光模块(OSFP/QSFP-DD)、DAC 铜缆与 AOC 有源光缆的选型物理账本
连接服务器与交换机、交换机与交换机之间的物理线缆,直接决定了机房建设的预算与故障率:
大厂万卡机房通常严格采用 “机柜内走 DAC 铜缆以保稳定与功耗,跨机柜走单模光模块以保距离与扩展” 的混合互连工程体系。
4. Rail-Optimized(轨道优化)组网:大厂集群的无损高速公路
4.1 传统组网 vs Rail-Optimized 组网的本质差异
现在,让我们进入本讲最具含金量、也是现代大厂大模型集群最核心的网络设计——Rail-Optimized(按卡分轨)网络!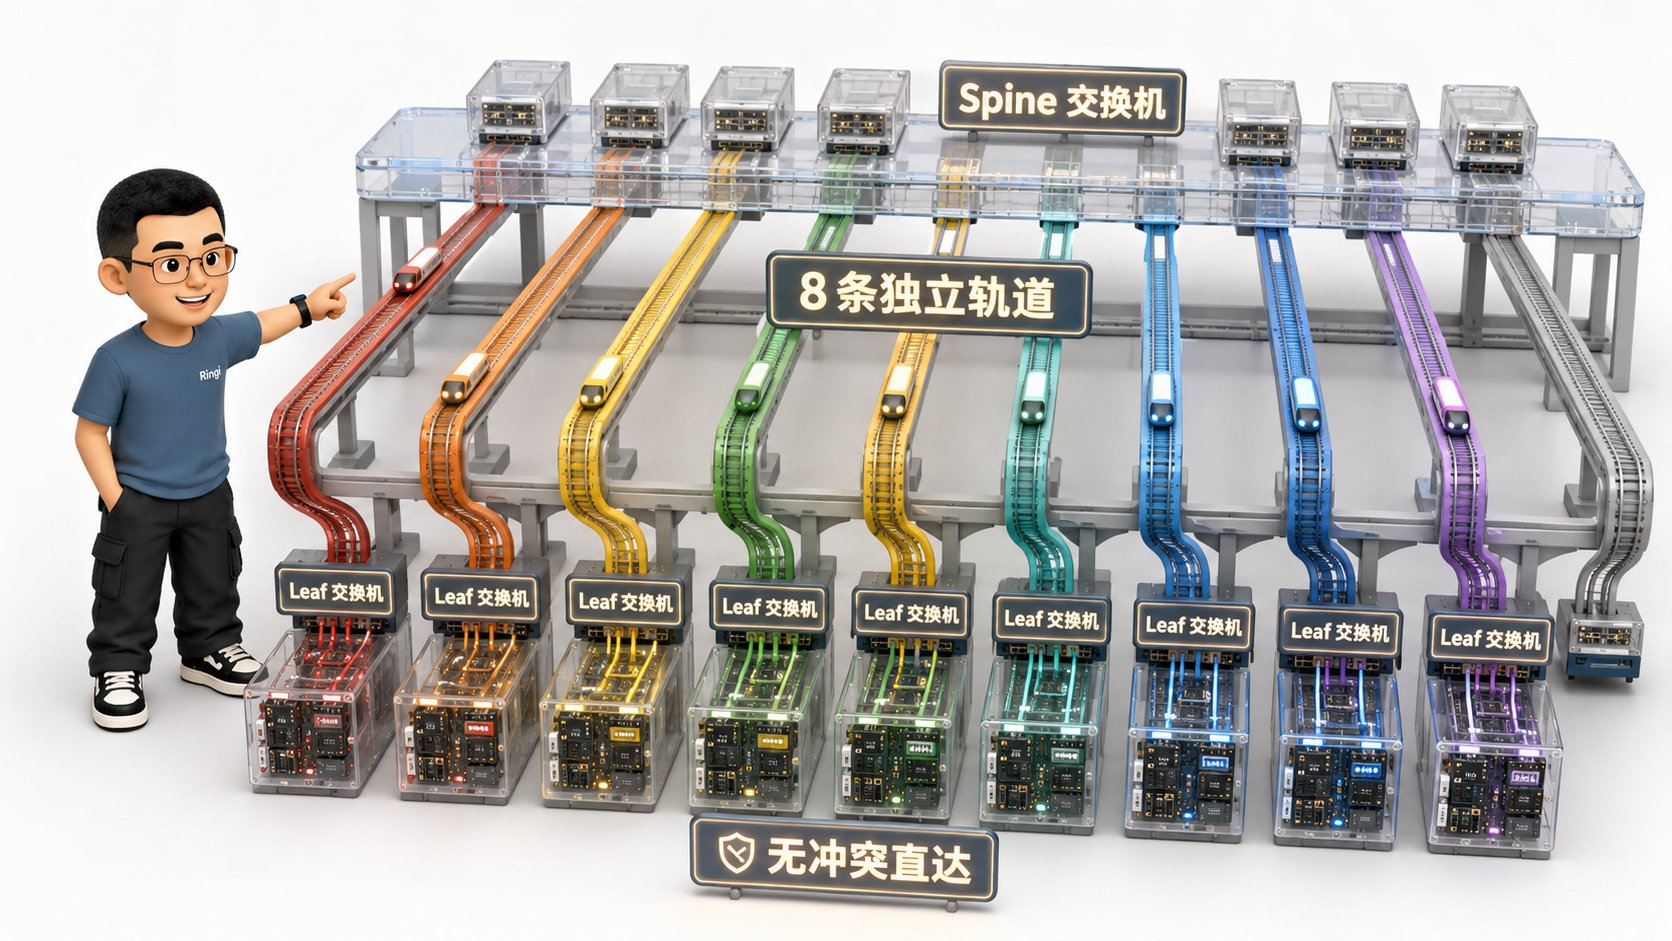
4.2 为什么全网同号 GPU 必须连同一个 Leaf 交换机?(8 条物理轨道完全隔离)
这种设计的精妙之处,在于它完美契合了大模型数据并行(DP)与流水线并行(PP)的数学本质:- 当我们进行跨机数据并行时,每个节点的同号 GPU(例如 Node 0 的 GPU 0 与 Node 1 的 GPU 0)属于同一个通信环路;
- 在 Rail-Optimized 拓扑中,它们之间的通信完全闭环在各自所属的那个 Leaf 交换机内部!
- 惊人收益:
- 8 条轨道在物理上 100% 绝对隔离,互不干涉!
- 数据并行(DP)的梯度同步通信,根本不需要向上经过任何 Spine 交换机!
- 全网 8 条轨道同时全速狂飙,机房网络瞬间打满 8 × 400G = 3.2 Tbps 的无损聚合吞吐!
4.3 为什么 All-to-All 在跨 Rail 时带宽暴跌?(56 对绕行 Spine 的数学推导)
然而,天下没有免费的午餐。Rail-Optimized 在让同号卡通信爽到极致的同时,也埋下了一个巨大的地雷——跨 Rail 通信性能悬崖! 我们以两台 8 卡服务器之间的全互联通信(All-to-All,例如 MoE 路由分发)为例手算这笔账:
- 两台机器之间总共有:
- 仔细盘点这 64 对连接的物理走线:
- 同 Rail 对号连接: (如 GPU 0 发给 GPU 0,GPU 1 发给 GPU 1),刚好有 8 对。这 8 对流量只走各自的 Leaf 交换机,畅通无阻;
- 跨 Rail 错号连接: (例如 GPU 0 要把数据发给远端的 GPU 1 到 GPU 7),整整有:
- 灾难降临: 这 56 对流量分属不同的 Leaf 交换机,它们唯一能碰面的地方就是顶层的 Spine 交换机! 原本宽敞的 8 条独立高速公路,瞬间变成了 56 辆重型卡车同时争抢 Spine 交换机上的狭窄立交桥!Spine 交换机迅速发生严重拥塞,有效带宽直接断崖式跌落至理论值的 20% 以下!
📌 Ringi 工程师结论: Rail-Optimized 拓扑对 DP / PP 极度友好,但对未经优化的 MoE All-to-All 是毒药!
这就是为什么像 DeepEP 这样顶级的大厂 MoE 通信库,必须在机内引入网关转发机制——严禁 GPU 私自发起跨 Rail 的跨机通信,必须先在机内通过 900 GB/s NVLink 汇聚到同号网关卡,再走规整的同 Rail 轨道出机!
5. Rank Placement 拓扑感知映射:让分布式算子住进最优工位
5.1 3D 混合并行(TP + CP + PP + DP)的物理映射黄金法则
在真实千卡集群中部署大模型时,我们通常会同时开启张量并行(TP)、上下文并行(CP)、流水线并行(PP)与数据并行(DP)。如何将这四种并行的抽象进程分配到物理卡上?大厂架构师恪守以下 物理映射黄金法则: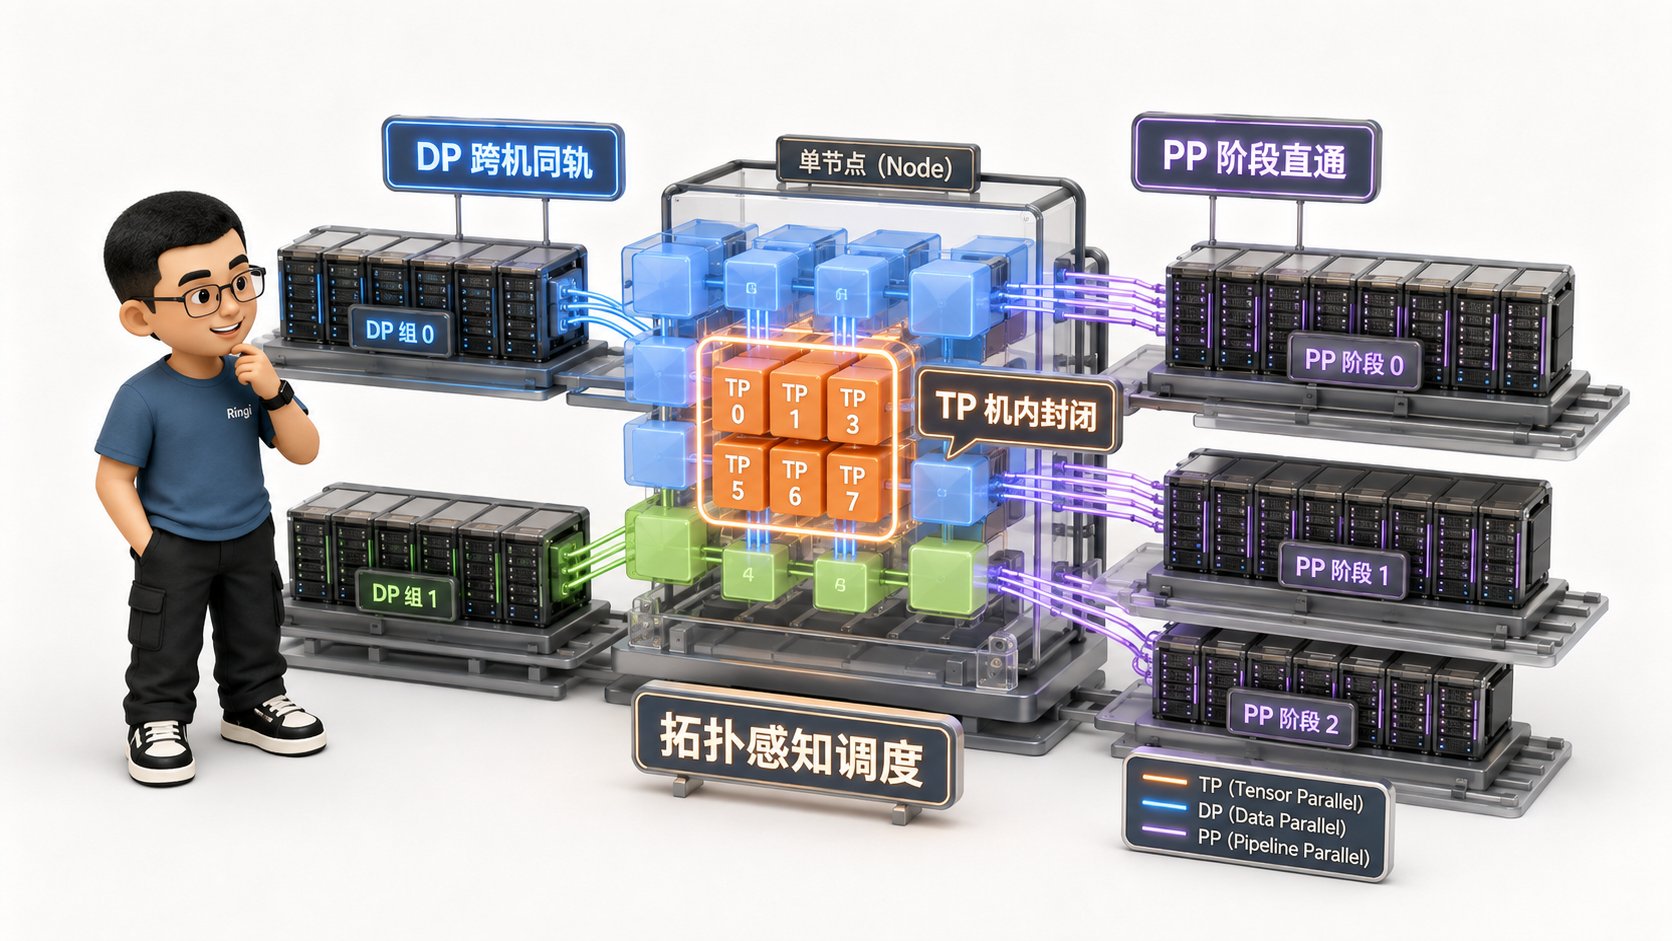
5.2 Megatron 与 PyTorch 分布式环境变量映射(LOCAL_RANK vs RANK)
在排查分布式通信故障时,必须分清以下三个核心环境变量的物理映射关系:6. 拓扑诊断利器:nvidia-smi topo 与 NCCL 拓扑探测深度解构
6.1 nvidia-smi topo -m 矩阵完全解析
进入一台全新的 GPU 服务器,第一件事永远是打出拓扑矩阵:nvidia-smi topo -m。我们来彻底看懂输出矩阵中每一个代码的物理含义:
6.2 NCCL topo.xml 文件生成机制与虚拟通信环路(Channels)构建
在分布式作业拉起时,NVIDIA NCCL 会在后台静默执行拓扑探测,扫描全机的 PCIe 总线与 NVLink 计数,并在内存中生成一个详尽的 XML 拓扑描述符(可以通过设置 export NCCL_TOPO_DUMP_FILE=topo.xml 导出到磁盘)。
基于该物理拓扑,NCCL 的算法调度器会自动决策:
- 构建多少个并发 Channel(通常为 8 到 32 个):每个 Channel 是一条独立的通信流水线环路;
- 选择 Ring 算法还是 Tree 算法:大消息建立 NVLink 满血环,小消息构建跨卡二叉树;
- 决定通信数据通路是走 P2P、NVLink 还是网卡 DMA。
7. 动手实战与代码实验室(Minimal Runnable Code)
本实验室提供 4 个完整、无占位符的生产级拓扑探测与仿真脚本。7.1 实验 1:全网拓扑矩阵探测与 NUMA/PCIe 亲和性自动化审计器
本实验利用 Python 自动探测本地 GPU、NUMA 节点以及绑定的 CPU 核心亲和性,输出严格的健康审计报告:7.2 实验 2:单机跨 NUMA 与同 NUMA 内存拷贝延迟带宽基准对比
本实验通过测试在同 NUMA 与跨 NUMA 内存中进行主机显存搬运(HtoD / DtoH),定量展现 UPI 总线瓶颈:7.3 实验 3:Rank Placement 拓扑感知最优编排仿真器
本实验通过纯数学算法,输入物理集群的机器数与 3D 并行参数,自动生成符合物理拓扑最优解的 Rank 排布字典:7.4 实验 4:Rail-Optimized 流量冲突与 Spine 负载仿真器
本实验定量仿真在 Rail-Optimized 组网中,同 Rail 数据并行 vs 跨 Rail 全对全通信在 Spine 交换机上的流量负载与拥塞倍数:8. Ringi 避坑指南与生产性能工程黄金 Checklist
8.1 避坑表格(❌ 常见小白拓扑误区 vs ✅ 大厂 AI Infra 正解)
8.2 生产硬件拓扑与网络布线黄金十条 Checklist
📋 智算集群硬件拓扑与物理布线生产黄金 Checklist (Ringi 审稿器)
- 1. 【NUMA 严格对齐】:每个 GPU 绑定的驱动进程必须通过
numactl锁死在本地 CPU Socket, 杜绝跨越 UPI 总线漫游。 - 2. 【TP 物理锁死】:Megatron-LM 等框架中的张量并行度(TP)绝不允许超过单机物理卡数(8)。
- 3. 【Rail 分轨接线】:每台机器的 NIC 0
7 必须按物理顺序精准插入对应的 Rail 07 Leaf 交换机, 严禁跳线或集中插入单台交换机。 - 4. 【1:1 无收敛审查】:严格核对 ToR 到 Spine 的上行光纤数量,必须与下行服务器连接数严格 1:1, 坚决消灭任何收敛比。
- 5. 【P2P 矩阵审计】:上线前执行
nvidia-smi topo -m,确保机内 8 卡两两之间均为NV18, GPU 与网卡之间均为PIX或NODE,全表绝不允许出现SYS! - 6. 【NCCL 拓扑导出】:分布式作业启动脚本中显式配置
export NCCL_TOPO_DUMP_FILE=topo.xml, 确认 NCCL 正确识别到 4 颗 NVSwitch 与所有独立网卡。 - 7. 【NVLS 硬件激活】:在 H100/B200 集群上,显式配置
NCCL_NVLS_ENABLE=1,榨干 NVSwitch 机内硬件归约芯片的极致性能。 - 8. 【DAC/光模块选型】:机柜内部 2 米内连接一律采用无源 DAC 铜缆,跨机柜长距连接一律采用单模 光模块,严禁混用破损光纤。
- 9. 【Rank 步长对齐】:在 3D 并行调度编排中,严格遵循
(dp, pp, cp, tp)坐标映射,确保全局 Rank 编号与底层机箱物理卡完美重合。 - 10. 【跨 Rail 流量拦截】:针对 MoE 架构,全面引入 DeepEP 或两跳转发机制,杜绝未经聚合的碎包 直冲跨 Rail Spine 交换机。
9. Ringi 5 点核心速记口诀、自我检验清单与课后深度思考题
9.1 5 点押韵核心速记口诀
9.2 10 条白板自我检验清单
- 1. 徒手画出 HGX H100 单机 8 卡的物理拓扑图,标明 CPU、PCIe Switch、NIC 与 NVSwitch 的连接通路。
- 2. 解释什么是 CPU NUMA 架构,为什么未做亲和性绑定的进程会在 UPI 总线上引发性能雪崩?
- 3. 为什么 GPU 和 400G 网卡要挂在同一个 PCIe Switch 下面?GPUDirect P2P 是如何绕过 CPU 的?
- 4. 解释 NVSwitch 相比传统点对点(Ring)拓扑的核心革命是什么。
- 5. 从引脚物理密度、信号调制(PAM4)与协议栈开销三个维度,论证为什么 PCIe 永远无法取代 NVLink。
- 6. 什么是 NVLS(NVLink SHARP)?它在机内 AllReduce 中起到了什么革命性作用?
- 7. 什么是 3 层 Clos / Fat-Tree 网络拓扑?为什么大模型训练必须严格要求 1:1 无收敛?
- 8. 详细阐释 Rail-Optimized(按卡分轨)的网络接线规则,说明它为什么能让数据并行(DP)完全避免跨 Spine 通信。
- 9. 在 8-Rail 组网中,为什么全对全(All-to-All)通信会导致 56/64 的流量涌向 Spine 交换机?
- 10. 解释
nvidia-smi topo -m输出中NV18、PIX、NODE、SYS的底层物理含义。
9.3 3 道高阶开放式课后思考题(含极端 Corner Case)
-
NVLink 物理坏道与静默降级(Link Degradation)排查:
在生产集群中,某台 8 卡 H100 机器偶尔会出现一个极隐蔽的硬件故障:某张 GPU 的 18 条 NVLink 中,有 2 条因金手指微小形变发生了静默降级,从
NV18跌落为NV16。此时硬件驱动不会直接报错死机,但该节点在参与全局 Ring AllReduce 时,其所在的通信通道带宽会瞬间从 450 GB/s 跌落至 400 GB/s。作为集群架构师,你会设计怎样的自动化轻量级健康探测探针,在作业拉起前精准揪出这种导致全网木桶效应的“慢节点(Straggler)”? - 单机混合架构下的异构拓扑感知调度: 在某些云厂商的物理机房中,为了节省成本,同一台服务器内可能采用了不同规格的硬件组合(例如 4 块 H100 走 NVLink,另外 4 块 H100 仅通过 PCIe Switch 互联)。面对这种非对称的“畸形”单机拓扑,标准的 Megatron-LM 默认 Rank 映射会直接发生严重的通信阻塞。你将如何重新设计并切分张量并行组(TP)与流水线并行组(PP),使得通信权重与硬件带宽实现精确的几何对齐?
- 机架级 NVL72 液冷铜缆背板的单点失效容灾: 在 NVIDIA GB200 NVL72 的机架级一体化架构中,72 块 GPU 共享同一个物理 NVLink 域。如果在训练过程中,机架内部的某一颗中央 NVSwitch 芯片因过热发生硬件故障熔断,整整 72 张 GPU 的全互联拓扑会被瞬间撕裂。在无法立即停机换件的极限生产场景下,软件通信库(如 NCCL)能否做到不重启容器、动态将 72 卡 NVLink 全互联在线降级为多个局部的微型拓扑,并自动调整并行切分策略继续维持训练?这在体系结构上面临哪些致命挑战?
10. 📚 参考资料与核心源码/经典论文指引
- 顶级网络与通信实战专著:
- 廖一桥(快手可灵 AI Infra 训练团队): 大模型通信基础 第一节:通信硬件拓扑, 2024. (详尽剖析 Rail-Optimized 组网、NVSwitch 代际与带宽层级的经典力作,收录于本地
AI_BOOK/GPU通信/)
- 廖一桥(快手可灵 AI Infra 训练团队): 大模型通信基础 第一节:通信硬件拓扑, 2024. (详尽剖析 Rail-Optimized 组网、NVSwitch 代际与带宽层级的经典力作,收录于本地
- NVIDIA 官方系统架构与网络白皮书:
- NVIDIA Corporation: NVIDIA DGX H100 System Architecture: The Universal System for AI Infrastructure, 2022. (权威解密单机 8 卡内部走线与 PCIe Switch / NVSwitch 布局)
- NVIDIA Corporation: NVIDIA SuperPod at Scale Architecture Guide: Building Scalable Fat-Tree Fabrics, 2023. (权威指导 3 层 Clos 1:1 无收敛网络建设)
- NVIDIA Corporation: NVIDIA Blackwell Architecture Technical Brief: GB200 NVL72 and NV-HBI, 2024.
- 经典拓扑与网络论文:
- Charles Clos: A Study of Non-Blocking Switching Networks, Bell System Technical Journal, 1953. (Clos 多级交换网络的奠基之作)
- Charles Leiserson: Fat-Trees: Universal Networks for Hardware-Efficient Supercomputing, IEEE Transactions on Computers, 1985.
- Youwei Zhuo et al.: DeepEP: An Efficient Expert-Parallel Communication Library for Large-Scale MoE Training and Inference, 2024.
附录:Appendix A — 大厂硬核高频面试题与白板推导(Interview Drill)
💬 面试题 1:请在白板上手绘出 NVIDIA HGX/DGX H100 单机 8 卡的完整物理硬件拓扑图,明确标出双路 CPU、PCIe Switch、GPU、网卡(NIC)与 NVSwitch 之间的连接关系,并写明核心总线的物理带宽与时延。
🎯 大厂标准答题路径与白板推导:
- 双路 CPU 与 NUMA 分界:
- 绘制两个独立的 CPU Socket(CPU 0 与 CPU 1);
- 中间连线标明 UPI 总线(带宽约 32 GT/s,延迟约 150ns),明确划分出两个独立的 NUMA 域。
- 控制与网络平面(PCIe 域):
- 每个 CPU 向下引出 PCIe 5.0 x16 通道(64 GB/s 双向),分别接入一颗专用的 PCIe Switch 芯片;
- PCIe Switch 向下引出两路直通分流:一路直连对应的 GPU,另一路直连 CX7 400G 网卡(NIC);
- 强调:GPU 0
3 属于 CPU 0 域,GPU 47 属于 CPU 1 域。GPU 与同侧网卡挂在同一 PCIe Switch 下,具备 GPUDirect P2P 直通能力(不经过 CPU,时延 <1.5μs)。- 计算与互联平面(NVLink 域):
- 在 8 张 GPU 下方绘制 4 颗独立的 NVSwitch 3 芯片;
- 8 张 GPU 每卡引出 18 条 NVLink 4.0 链路(每链路单向 25 GB/s、双向 50 GB/s),全部分布式连入 4 颗 NVSwitch;
- 核心结论:形成两两直接连通的 Full-Mesh 拓扑,任意两卡间恒定提供 单向 450 GB/s、双向 900 GB/s 的极速带宽,端到端硬件直通延迟低于 100ns,并支持 NVLS 网内计算硬件加法归约。
💬 面试题 2:详细阐述大模型集群中 Rail-Optimized(按卡分轨)组网的设计原理。为什么它能让数据并行(DP)实现零冲突,却可能在专家并行(MoE All-to-All)时引发性能崩溃?
🎯 大厂标准答题路径与白板推导:
- Rail-Optimized 核心接线规则:
- 设立 8 台独立的 Leaf(ToR)交换机,分别命名为 Rail 0 至 Rail 7;
- 全集群所有物理服务器的同号网卡接入同一台 Leaf(例如全网 Node 的 NIC 0 全部接入 Leaf 0,NIC 1 接入 Leaf 1);
- 为什么数据并行(DP)零冲突:
- 在标准的分布式数据并行中,相同号的 GPU(如全网所有节点的 GPU 0)组成同一个 DP 梯度归约环;
- 此时它们的通信流量全部在对应的 Rail Leaf 交换机内部循环掉头,物理上完全不需要跨越到 Spine 交换机!
- 8 条轨道在物理链路上彻底解耦,全网带宽供给达到 100% 满血,无任何跨流干扰与拥塞。
- 为什么 MoE 跨 Rail 通信会引发性能崩溃:
- 在 MoE 专家并行的 All-to-All 通信中,Token 是随机打散分发的,GPU 必须向全网任意编号的 GPU 发包;
- 在 8 卡服务器间,64 对通信路径中,只有 8 对是同号(走 Leaf 本地),其余 56 对全部是跨 Rail 的异号通信!
- 这 56 对流量必须全部强行冲上顶层的 Spine 交换机寻找路由,导致 Spine 交换机下行端口面临巨大的拥塞汇聚压力,瞬间打爆交换机 Buffer,诱发严重的 PFC 拥塞风暴与吞吐暴跌。
- 工业级解决方案:
- 采用两跳聚合机制(如 DeepEP 架构):跨机通信前,小包先在机内通过 900 GB/s 的 NVLink 高速汇聚到同号网关卡,再由网关卡严格沿同 Rail 轨道向远端发送,彻底消灭跨 Rail 流量乱蹿。
💬 面试题 3:nvidia-smi topo -m 命令打印的拓扑矩阵中,NV18、NODE、SYS 分别代表什么物理硬件连接状态?如果在生产环境发现某两张 GPU 之间显示为 SYS,会对分布式训练带来什么影响?如何系统性排查与修复?
🎯 大厂标准答题路径与白板推导:
- 三个符号的物理底层含义:
NV18:代表两卡之间通过 18 条 NVLink 4.0 满血互联(900 GB/s 双向),延迟 <100ns,属于机内顶级通信;NODE:代表两设备处于同一个 NUMA 节点内部,但未走 NVLink,需要通过主机内存/PCIe Host Bridge 桥接,延迟约 1.5μs;SYS:代表两设备跨越了不同的 CPU Socket,数据必须穿过 CPU 之间的 UPI 总线以及主板系统芯片组,延迟通常 >3.5μs,带宽受到 UPI 严重压制。- 显示为
SYS对训练的破坏性影响:
- 如果本该走 NVLink 的两张卡显示为
SYS,说明 NVLink 物理链路完全未被识别或发生硬断开;- 在执行全机 AllReduce 时,NCCL 会被迫降级走低速的 PCIe/UPI 总线,单次通信耗时暴增 10 倍以上,整台机器瞬间沦为集群的严重拖后腿节点(Straggler),拉垮全网吞吐。
- 系统化排查与修复路径:
- 第 1 步(硬件日志排查):执行
nvidia-smi nvlink -s与dmesg | grep -i nvlink,检查是否报NVLink Error或训练掉 Link;- 第 2 步(驱动与固件检查):检查 NVSwitch 驱动服务是否正常拉起(
systemctl status nvidia-nvswitch),固件版本是否一致;- 第 3 步(物理基板硬件报修):若确认是 PCB 背板接触不良或金手指氧化,执行热下线隔离,通知机房硬件工程师重新插拔紧固 SXM5 模块。
💬 面试题 4:在大规模 3D 混合并行(TP + PP + DP)训练中,如何进行拓扑感知的 Rank Placement 编排?为什么业界公认 TP 必须放在最内层,而 PP 必须放在最外层?
🎯 大厂标准答题路径与白板推导:
- 并行的通信特征对比:
- TP(张量并行):通信频率极高(每个 Transformer 层包含 4 次 AllReduce),且消息属于中等尺寸,无法与主计算 Overlap 隐藏;
- DP(数据并行):通信频率低(每个 Iteration 仅在反向最后发生一次全局梯度汇总),数据量巨大,但可以通过 DDP 分桶实现近乎 100% 的计算重叠;
- PP(流水线并行):通信频率低,且通信内容仅仅是相邻 Stage 之间的边界激活值与反向梯度(极小体量的点对点 P2P),对绝对带宽要求最低。
- 为什么 TP 必须放在最内层:
- 最内层意味着在逻辑 Rank 编号上是连续相邻的(如 Rank 0~7);
- 连续的 8 个 Rank 能够被调度器精准绑定在同一台物理服务器内部;
- 使得每秒上百次的 AllReduce 能够全部享受机内 900 GB/s 的 NVLink 极致带宽与亚微秒延迟;
- 如果 TP 跨出机箱走 RDMA 网络,其高频通信会瞬间把整个训练吞吐拉垮 70% 以上。
- 为什么 PP 必须放在最外层:
- 最外层意味着两个相邻的 PP Stage 跨越了极其遥远的物理距离(跨机柜、跨交换机);
- 由于 PP 只需要进行点对点的激活值传递,数据包极小,哪怕走跨机的 400G 网卡甚至跨 Spine 交换机,也只需要几微秒,完全不会触碰带宽天花板;
- 这种排布完美契合了“大通信量走大管道、小通信量走远距离”的物理互联第一性原理!