🏛️ 第12讲:GPU-Util 100% 算力却只有 15%?——SM 执行、Warp 调度、Tensor Core 与 Roofline 模型的第一性原理
主讲人:👓 Ringi(大厂 AI Infrastructure 工程师)
所属模块:Module 01: GPU 硬件架构、数据搬运、集群通信与 Overlap
篇章范式:📐 硬件体系与性能建模篇(Hardware Architecture & Performance Modeling Paradigm)
核心导读:
刚进大厂做性能工程时,很多初学者看到终端里nvidia-smi实时跳动的GPU-Util: 100%,就长舒一口气以为硬件算力已经被榨干了。然而,只要掏出 Nsight Compute(NCU)或 PyTorch Profiler 仔细一测,你往往会被残酷的技术现实泼一盆冷水——Tensor Core 的实际活动利用率(Tensor Core Active)可能连 15% 都不到!
为什么明明一张价值数十万的旗舰计算卡显卡风扇狂转、监控利用率拉满,真正干核心矩阵计算的算力单元却大部分时间在“带薪摸鱼”?
GPU 硬件到底是以什么粒度在调度代码?流式多处理器(SM)内部除了算力,到底还在忙什么?数据在 Register、Shared Memory、L2 Cache、HBM 之间穿梭时,究竟付出了怎样令人绝望的时延代价?
本讲我们将彻底撕开 GPU 硬件的物理黑盒,从硅片微架构第一性原理层层拆解 SM、Warp 调度器、Tensor Core 与存储金字塔的协同分工,并掌握大厂性能工程的终极试金石——Roofline 性能模型!
📑 目录导航
- 0. Ringi 开场:生产真实现场与痛点冲突
- 1. GPU 物理芯片拓扑与 SIMT 执行模型:从硅片到网格
- 2. SM(流式多处理器)心脏深度解构:调度与搬运枢纽
- 3. Tensor Core 革命:从标量乘加到高维张量微内核(MMA)
- 4. GPU 存储层次金字塔与内存搬运的物理极限
- 5. 性能工程终极试金石:Roofline 性能建模第一性原理
- 6. 经典 AI 算子 Roofline 逐案推导与生产优化解法
- 7. 动手实战与代码实验室(Minimal Runnable Code)
- 8. Ringi 避坑指南与生产性能工程黄金 Checklist
- 9. Ringi 5 点核心速记口诀、自我检验清单与课后深度思考题
- 10. 📚 参考资料与权威文档指引
- 附录:Appendix A — 大厂硬核高频面试题与白板推导(Interview Drill)
0. Ringi 开场:生产真实现场与痛点冲突
0.1 真实工程矛盾:nvidia-smi 采样的“皇帝新衣”
先别急着背硬件参数,我们先来看一个几乎所有做大模型训练与推理系统优化的工程师都踩过的真实“性能深坑”:
在单台 8 卡 NVIDIA H100-SXM(80GB HBM3)节点上,你启动了一个 70B 大语言模型的预训练任务或多并发压测。你在终端敲下:
GPU-Util: 100%!
绝大多数初学者看到这里都会心满意足地得出结论:“硬件已经跑满了,这个系统没有优化空间了。”
然而,当你用 torch.profiler 或者 NVIDIA 官方的 Nsight Compute(NCU)对这块 GPU 抓取内核分析报告时,底层的数据却会让你大吃一惊:
nvidia-smi 的采样陷阱(The Emperor’s New Clothes):
nvidia-smi所汇报的GPU-Util,其物理定义是:在过去 1 秒的采样窗口时间内,整块 GPU 上是否“至少有 1 个 Warp 处于活跃分配状态(Active State)”的时间占比。- 如果你的 Kernel 因为显存对齐混乱、频繁跨步访问 HBM、或者在做 Element-wise(逐元素)激活函数计算,导致 32 个线程的 Warp 在绝大部分时钟周期内都在傻傻等待数据从片外显存加载回来(处于
Memory Stalled挂起态),nvidia-smi依然会毫不犹豫地向你汇报:100%!
👓 Ringi 工程师比喻:
nvidia-smi 看到 100% 利用率,就像车间主任看到工人坐在工位上打卡了 8 小时。但如果这个工人每干 1 秒钟的活,就要停下来花 20 秒去门口等物流货车送原材料(Memory Stalled),或者手里的螺丝刀根本拧不动大螺栓(Compute Stalled),那么工位虽然被占满了,工厂的总装配产能依然是极度低下的!
0.2 线上真实事故复盘:显卡跑满,训练耗时却暴增 4.3 倍
这个指标错觉在生产环境会导致什么灾难?我们看一个真实的重构惨案: 某团队在优化一个包含自研掩码注意力(Custom Masked Attention)的模型算子。原版代码使用的是 PyTorch 原生算子拼接;一位算法同学为了“消除多余的临时显存”,使用 CUDA C++ 手写了一个融合 Kernel,并在测试脚本中观察到了稳定的GPU-Util: 100%。
但在千卡集群合并上线后的第一个 Iteration:
- 单步迭代耗时从 210ms 暴增至 940ms(性能恶化 4.4 倍);
- 集群整体算力利用率(MFU)从 48% 直接雪崩至 11%;
- 整个训练任务引发了调度器的超时期杀,数千万算力成本在几小时内被白白空转蒸发。
Long Scoreboard 饥饿等待状态,整块 GPU 的有效计算硬件只能在无尽的等待中空转。
如果不穿透 GPU 执行与存储架构的第一性原理,工程师在面对性能悬崖时只能如同盲人摸象。
0.3 AI Infra 各层级映射全景速查表
在深入每一个物理细节之前,我们先把软件编程抽象与物理硅片硬件的映射关系建立一张全景对照表。在未来的所有内核开发、CUDA 算子编写与 Profiling 中,这张表是你随时定位瓶颈的指南针:1. GPU 物理芯片拓扑与 SIMT 执行模型:从硅片到网格
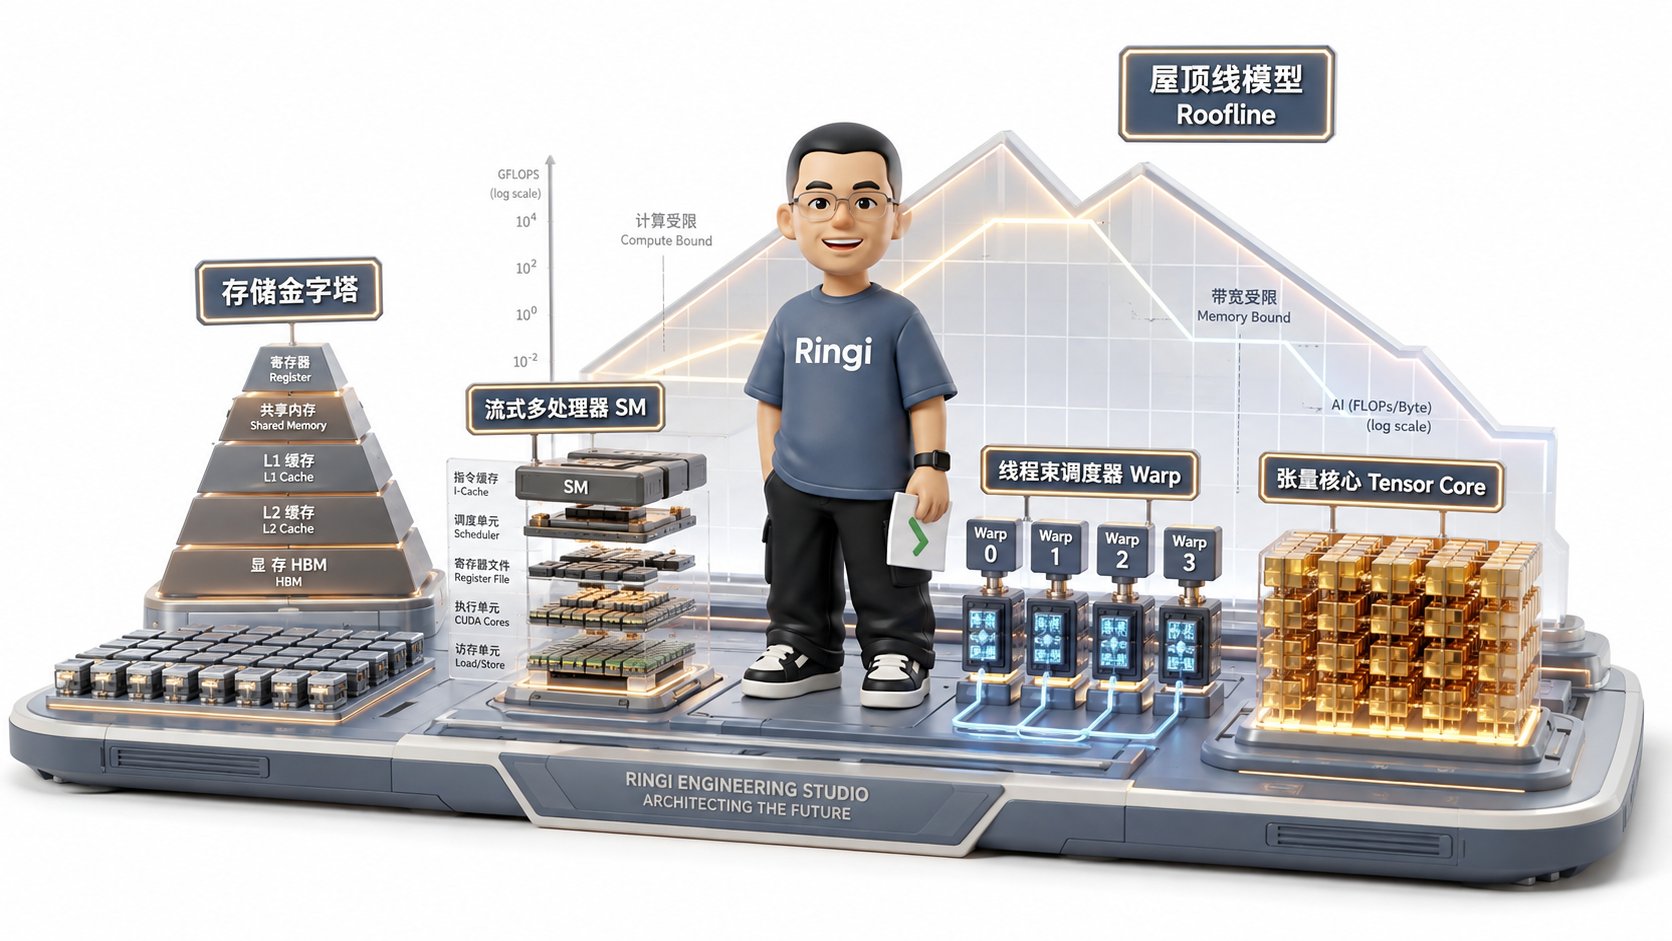
为了在深入具体细节前建立完整的物理心智模型,下方给出了现代 GPU(Hopper / Blackwell)从 SM 子核心计算阵列、存储金字塔时延梯级、到 Roofline 理论运行边界的工业级全景架构拓扑:
1.1 硬件第一性原理:为什么是 GPU?胖核心 vs 瘦核心的宿命分歧
要理解 GPU 为什么长成今天这个样子,必须追溯计算机体系结构关于芯片面积分配的第一性原理决策:- CPU 的使命是“消灭延迟(Minimize Latency)”:
CPU 必须假定即将运行的代码充满不可预测的
if-else、指针跳转、文件 IO 以及系统中断。为了让单个线程跑得尽可能快,CPU 将 80% 以上的晶体管预算砸在了分支预测器、乱序执行重排序缓冲区(ROB)、超标量投机执行引擎以及层层嵌套的超大缓存(L1/L2/L3)上。真正的 ALU 计算单元在芯片面积中只占一小撮。 - GPU 的使命是“吞吐至上(Maximize Throughput)”: GPU 彻底放弃了复杂的分支预测与激进的乱序执行。它的基本哲学是:我不尝试加速任何一个单独的线程,我也从不预测未来。我把成千上万个轻量级的 ALU 单元整齐排列在晶体管上,并建立一套超大容量的寄存器堆与硬件调度器。当某些线程在等待显存加载时,我零开销切到另一批就绪的线程去算!
1.2 GPU 物理芯片宏观拓扑:GPC、TPC、SM 与 Crossbar 互联
以当今大模型训练的核心基石——NVIDIA H100 SXM(Hopper 架构) 为例,物理硅片内部被严整地划分成网格化集群:- GPC(Graphics Processing Cluster):顶级硬件处理集群,H100 满血版包含 8 个 GPC;
- TPC(Texture Processing Cluster):每个 GPC 包含最多 9 个 TPC;每个 TPC 内部封装了 2 个 SM;
- SM(Streaming Multiprocessor):整块芯片的核心计算单元,H100 SXM 启用了 132 个 SM(物理存在 144 个,屏蔽部分以确保良品率);
- 片上共享 L2 Cache:容量高达 50 MB,通过内部 Crossbar 高速总线直连所有 SM,提供每秒数十 TB 的聚合访问带宽;
- HBM3 存储堆栈:采用台积电 CoWoS 2.5D 先进封装,将 5 颗活跃的 HBM3 颗粒与计算逻辑芯片堆叠在中介层上,提供超宽的 5120 位内存接口。
1.3 软件抽象与硬件物理实体的四级严格对齐
在 CUDA 编程模型中,我们构建的层次与物理芯片是一一严密对应的。任何一个概念脱节都会导致错误预估显存与并发:- Thread(线程) ➔ CUDA Core / ALU: 程序员编写的最小逻辑执行实体。拥有自己独立的寄存器命名空间(由编译器分配)与程序计数器(逻辑抽象)。
- Warp(线程束) ➔ SIMT 执行管线: 32 个 Thread 组成一个 Warp,这是硬件调度的最小绝对原子单位! 硬件从不单独调度单个线程。一个 Warp 内的 32 个线程在物理上共享同一个指令发射器。
- Thread Block / CTA ➔ SM(流式多处理器):
同一个 Block 内的所有线程必然被调度到同一个物理 SM 上执行。因此,Block 内的线程可以且仅可以利用该 SM 上的片上 Shared Memory(共享内存) 进行高速协同通信与屏障同步(
__syncthreads())。不同的 Block 之间绝不能假定有任何执行先后顺序。 - Grid ➔ 整张 GPU 物理芯片: 由一个 Kernel 启动调度的所有 Block 构成的集合。硬件调度器(GigaThread Engine)负责把 Grid 中的成千上万个 Block 分发到各个空闲的 SM 上。
1.4 SIMT 执行机制:32 线程锁步发射的物理契约
这里存在一个极高频的技术混淆点:SIMD(单指令单数据)与 SIMT(单指令多线程)到底有什么物理区别?- SIMD(如 CPU 的 AVX-512 / ARM Neon): 在指令集层面显式定义向量寄存器。一条指令显式操控一个 512-bit 的寄存器(例如同时操作 16 个 32 位浮点数)。如果程序员要做条件分支,必须显式在汇编中做向量 Blend 或位掩码。
- SIMT(GPU 的单指令多线程模型):
程序员在编写代码时,思维模型是纯粹的**“标量多线程”**——你写的是单个线程如何读写数据:
但在物理底层,硬件的 Warp 调度器会自动抓取相邻的 32 个线程,将它们打包成一个 Warp。在时钟周期的发射沿,硬件只向执行管线发射一条加法指令,这 32 个 ALU 单元在锁步(Lock-step)状态下并行吞入各自线程对应的数据并完成计算!
2. SM(流式多处理器)心脏深度解构:调度与搬运枢纽
2.1 SM 四大子核心分区(Sub-Core / Partition)物理切分
流式多处理器(SM)不是一个铁板一块的巨型处理器,而是高度模块化对称设计的典范。在 NVIDIA Volta、Ampere、Hopper 以及最新的 Blackwell 架构中,每个 SM 内部都被严整地横向切分为 4 个完全独立的子核心分区(Sub-Core,硬件手册中常称 SMSP 或 Processing Block):- 1 个 Warp Scheduler(线程束调度器) 与指令分发单元(Dispatch Unit);
- 64 KB 物理寄存器文件(Register File)(整个 SM 聚合拥有 256 KB,即 64K 个 32-bit 寄存器);
- 算力计算单元阵列:
- 32 个 FP32 标量 CUDA Core;
- 16 个 FP64 双精度核心;
- 32 个 INT32 整数处理核心;
- 1 个第 4 代 Tensor Core(负责超高密度矩阵乘加 MMA 计算);
- 8 个 LSU(Load/Store Unit,负责全局显存与共享内存的加载和写回);
- 特殊函数单元(SFU,负责执行
sin,cos,exp,sqrt等耗时非线性算子)。
2.2 Warp Scheduler 零开销上下文切换机制:延迟掩盖(Latency Hiding)的第一性原理
很多习惯了操作系统 CPU 线程调度的同学,第一次听说“GPU 能在 0 周期内完成线程切换”时,都会觉得这违反了物理定律: “CPU 切换一个线程,要触发内核中断、保存上下文、刷寄存器、换页表、刷新 TLB,耗费几千个 CPU 周期(微秒级)。为什么 GPU 切换一个 Warp 能不花时间?” 答案隐藏在硬件寄存器的物理分配方式中:- 在 GPU 上,所有处于分配状态的 Warp,它们的寄存器在 Kernel 启动时就已经一次性物理映射在 SM 的寄存器文件(RF)中了!
- Warp 0 和 Warp 1 的数据同时物理存在于相邻的寄存器硬件槽位里。
- 当 Warp 0 发起了一条全局显存读取指令(
LDG),需要等漫长的 400 个周期数据才能从片外 HBM 返回时,Warp Scheduler 只需要在下一时钟周期将指令发射指针切换指向 Warp 1。 - 这就是 延迟掩盖(Latency Hiding) 的终极秘密:通过极大规模的硬件级轻量并发,让计算管线永远有就绪的指令可以发射,从而把漫长的内存等待完全“淹没”在并发计算的洪流之中!
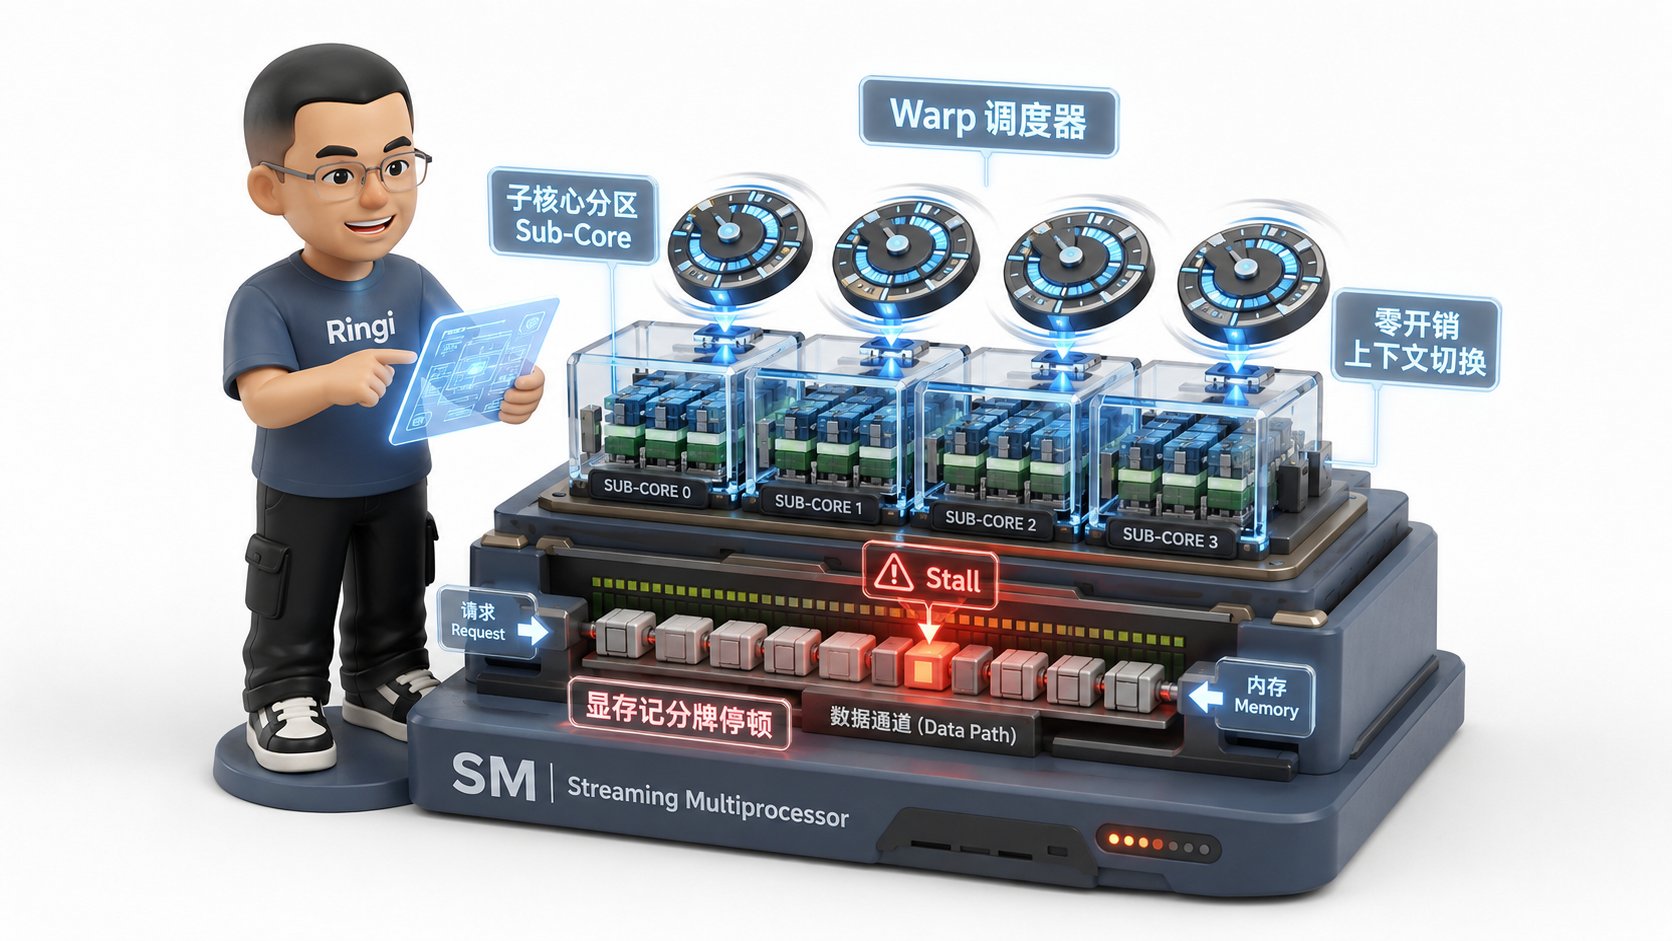
2.3 Warp 停顿(Warp Stalls)六大真凶深度解构
然而,在生产实战中,这种延迟掩盖绝非无限生效的。一旦并发的 Warp 全部陷入等待状态,SM 就会发生不可避免的指令停顿(Warp Stall)。 在 NVIDIA Nsight Compute 中,有六大最致命的 Warp 停顿真凶:2.4 Warp Divergence(分支分化)的第一性原理:为什么 if-else 会让算力腰斩?
我们用放大镜深入看一下第 6 种真凶——分支分化(Branch Divergence) 的底层硬件过程:
假设我们在 Kernel 里写了这么一段看似人畜无害的代码:
if,奇数线程跑 else,两者各司其职同时结束。
但在硬件底层,SIMT 的物理发射器只有一个!它无法同时发射两条不同的机器指令!
硬件的真实执行过程如下:
📌 Ringi 工业级避坑契约: 在编写高性能 CUDA/Triton 算子时,分支语句并不是绝对不能用,而是不能在 Warp 内部(32 个连续线程内)发生条件割裂! 如果你的分支条件是以 Warp 或 Block 为粒度整齐划分的(例如if (warpId == 0)或if (blockIdx.x > 2)),那么整个 Warp 内的 32 个线程始终步调一致(Active Mask 全 1 或全 0),此时绝对不会产生任何分支分化开销!
3. Tensor Core 革命:从标量乘加到高维张量微内核(MMA)
3.1 为什么标量 CUDA Core 算大矩阵会遭遇指令发射天花板?
在 Volta 架构(V100)诞生之前,深度学习的所有矩阵乘加都是用传统的标量 CUDA Core 硬算的。 我们来算一笔账:对于一个经典的通用矩阵乘法 GEMM( ),假设我们要算一个 的子矩阵块:- 完成这个计算需要进行 次乘法与 4096 次加法,共计 8192 次浮点运算(8192 FLOPs)。
- 如果用标量 FMA(Fused Multiply-Add)指令来算,一条 FMA 指令完成 2 次浮点操作(一次乘加)。
- 硬件必须向执行流水线连续发射 4096 条独立的标量指令!
- 指令发射单元(Dispatch Unit)被挤爆:SM 很大一部分晶体管开销都在处理指令的取指、译码与发射;
- 寄存器堆读写端口彻底瘫痪:每一次标量乘加都要从寄存器读取两个操作数、写回一个操作数,寄存器堆的读写带宽成了最大瓶颈。
3.2 Tensor Core 物理执行机制:Warp 级协同与 MMA 原语
NVIDIA 的突破性方案,就是将矩阵计算的原语从“单线程标量”提升到了 “Warp 协同的张量微内核”——Tensor Core。 在汇编底层,NVIDIA 引入了 MMA(Matrix Multiply and Accumulate) 指令集体系: 其中 不再是标量数字,而是小维度的矩阵切片!mma.sync 硬件指令,在极少量的时钟周期内,由 32 个线程协同将矩阵块输入硬件阵列,一次性吐出 8192 次浮点运算结果!
- 指令发射带宽需求暴跌了整整两个数量级!
- 内部采用高度定制的硬连线交叉逻辑,数据复用在计算阵列内部完成,大幅解放了通用寄存器堆的读取压力。
3.3 MMA 指令的 Shape 演进与寄存器数据布局( 到 FP8)
从 Volta 到 Hopper,Tensor Core 的微架构经历了一场波澜壮阔的演进:
在 Ampere 和 Hopper 时代,硬件最核心的微内核 Shape 稳定为 (针对 FP16) 或 (针对更小精度)。
这是极其反直觉的一点:为什么不是对称的 ,而是 ?
这是因为在物理布线中, 能够最完美地契合 Warp 32 线程的寄存器对齐,让 32 个线程的寄存器切片在不发生任何 Bank 冲突的情况下,以最大的位宽(128-bit 向量化)直接喂入 Tensor Core 阵列。
3.4 计算单元饥饿(Starvation)的算力账本:喂饱 Tensor Core 究竟需要多快?
掌握了 Tensor Core 的狂暴算力之后,我们必须立刻拿出性能工程师的“小算盘”,算一笔极其恐怖的数据喂料账本: 以一台普通的 NVIDIA H100 SXM 为例:- 其 Dense FP16 的峰值算力高达 ;
- 每次浮点乘加操作需要 2 个输入操作数(每个 FP16 占 2 字节),产生 1 个输出;
- 如果我们要让 Tensor Core 跑满,且假设每次计算的数据都是从片外显存 HBM 实时读取、没有做任何片上数据复用,那么每秒钟需要从 HBM 读入的数据量是:
4. GPU 存储层次金字塔与内存搬运的物理极限
4.1 物理存储金字塔:越靠近计算核心,每字节代价越高昂
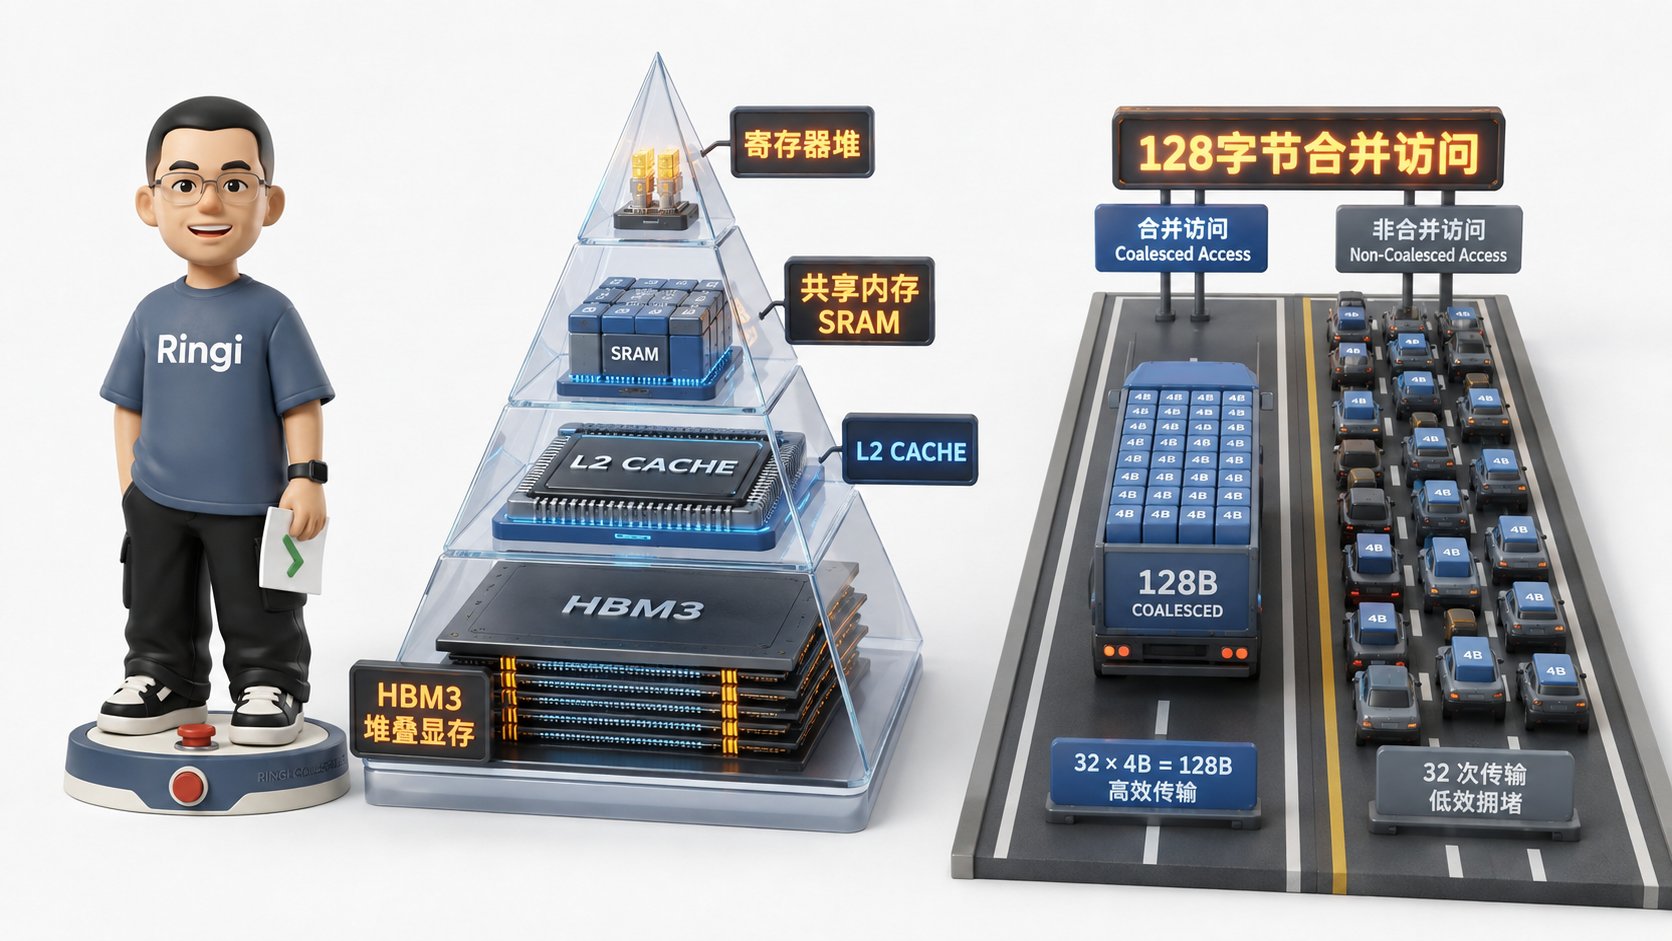
物理定律规定:存储容量、访问延迟与物理带宽三者永远不可能同时兼得!越靠近硅片计算核心的存储,晶体管开销越昂贵、发热越剧烈、延迟越低,但容量只能极其微小:
4.2 存储层级量化全景对照表(以 NVIDIA H100 为基准)
我们把这些硬核参数固化为一张精密的基准表:
请仔细盯着这组数字对比:
- 从寄存器读一个数:0.5 纳秒;
- 从 HBM 读一个数:60 纳秒(慢了 120 倍以上);
- 从 CPU 内存通过 PCIe 读一个数:慢了数万倍!
4.3 全局显存合并访问(Memory Coalescing)与 128 字节物理事务契约
当你的线程不得不访问片外 HBM 时,你必须恪守 GPU 最重要的一条物理定律:全局内存合并访问(Memory Coalescing)。 GPU 的显存控制器(Memory Controller)与 L2 缓存之间,从来不会以 4 字节为单位单独搬运 float 数据! 硬件在物理总线上操作的最小单位是 Cache Line(缓存行),通常为 128 字节(或 32 字节扇区 Sector)。 当一个 Warp(32 个线程)同时执行一条加载指令(LDG.E.32,每个线程读 4 字节)时:
- 32 个线程总共需要读取 字节的数据。
4.4 Shared Memory 架构:32 个 Bank、4 字节跨度与 Bank Conflict 消除
为了让同一个 Thread Block 内部的线程能够以超过 10 TB/s 的速度交换数据,SM 配备了超高速的片上 SRAM——Shared Memory(共享内存)。 但为了在有限的芯片面积内提供如此恐怖的并发吞吐,硬件工程师将 Shared Memory 物理切分成了 32 个独立工作的存储体(Memory Banks):- Bank 的数量恰好等于一个 Warp 内的线程数(32 个);
- 每个 Bank 的宽度是 4 个字节(32-bit word);
- 连续的 4 字节地址交替轮流分布在 Bank 0 到 Bank 31 中:
4.5 现代硬件异步数据搬运演进:从 cp.async 到 Hopper TMA 引擎
在传统 CUDA 编程中,数据从 HBM 搬到 Shared Memory 必须经过通用寄存器堆中转:
HBM ──(LDG 指令)──► Register File ──(STS 指令)──► Shared Memory
这不仅浪费了宝贵的通用寄存器资源,还白白占用了 SM 算力核心的执行周期。
- Ampere 时代(
cp.async硬件原语): NVIDIA 引入了异步复制指令,允许 LSU 单元直接将数据从全局显存搬运至 Shared Memory,全程彻底绕过通用寄存器堆!SM 只需要发射一条异步请求,即可继续去干其他计算活。 - Hopper 时代(TMA: Tensor Memory Accelerator 硬件引擎):
硬件演进到了极致形态:SM 内部配备了专用的物理张量搬运加速器(TMA)。
开发者只需要在主机端或核函数中配置一个张量描述符(Tensor Map),指定全局张量在显存中的 Shape、Stride、Box Size 和维度边界。随后 SM 仅需一条指令通知 TMA,TMA 专用硬件便会自动处理所有跨步、分块、边界对齐检查,以接近物理理论极限的带宽将高维张量子块搬入 Shared Memory,并自动与硬件异步屏障(
mbarrier)联动!
5. 性能工程终极试金石:Roofline 性能建模第一性原理
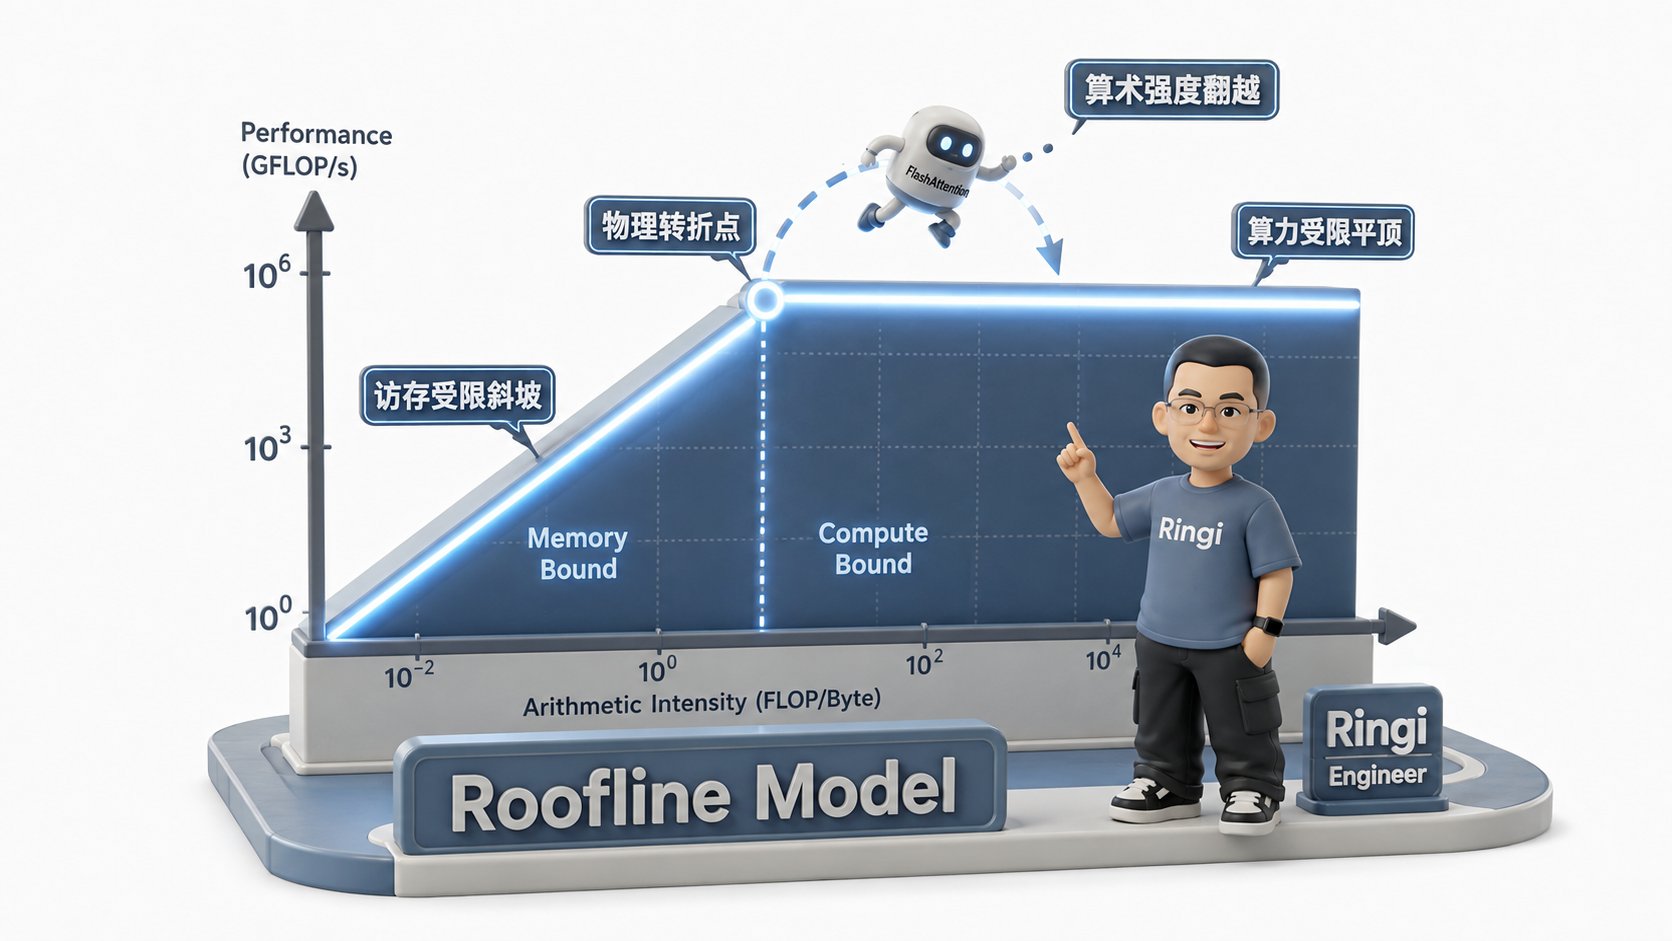
5.1 为什么需要 Roofline 模型?摆脱拍脑袋调优的几何判决书
当我们优化一个大模型自定义算子时,经常会陷入迷茫:- “这个算子耗时 5ms,它算快还是算慢?”
- “我到底应该花精力去手写循环展开(增加计算并行度),还是去优化内存排布(减少 HBM 读写)?”
5.2 核心公式五步穿透(No Naked Formula 2.0)
遵循我们的最高准则,绝不让任何核心公式裸奔:Step 1: 为什么需要算它?
因为任何计算系统的最大能力,都同时受限于两个独立的物理极值:- 处理器算力的峰值上限(算力瓶颈);
- 显存总线能够供给数据的物理带宽上限(带宽瓶颈)。 我们需要一个指标将代码自身的算法特性与物理硬件的能力直接挂钩,明确当前的死穴究竟在哪一边。
Step 2: Mental Model(物理直觉比喻)
👓 Ringi 工程师比喻: 想象一个建筑工地:
- 工地里有一群泥瓦匠,他们双手砌砖的极限速度是每秒 1000 块( 峰值算力);
- 运送砖块的道路只有一条,卡车车队每秒最多只能向工地倾倒 10 吨砖( 物理显存带宽)。
- 如果你的工程规范要求“每搬来 1 吨砖,泥瓦匠必须在其上反复精雕细琢 150 次”(高计算强度),那么卡车送来的砖足够泥瓦匠忙个不停,限制整体进度的是泥瓦匠手速的极限(Compute-Bound 算力受限);
- 如果你的工程规范要求“砖块只要往地上一铺就行,每吨砖只要敲 2 下”(低计算强度),那么泥瓦匠每秒钟都在原地干等卡车卸货,限制进度的绝对不是泥瓦匠的能力,而是公路的运载极限(Memory-Bound 访存受限)!
Step 3: Tiny Calculator(极简数字小算盘)
我们拿两个极简的例子在草稿纸上手算一遍:- 算例 A(标量向量加法: ,数组长度 ,FP16 2 字节):
- 浮点运算量(FLOPs):每个元素做 1 次加法,共 ;
- 访存量(Bytes):读取 (8 字节)+ 读取 (8 字节)+ 写回 (8 字节)= ;
- 计算访存比(Arithmetic Intensity):
- 算例 B(极简小矩阵乘法: 乘 ,FP16 2 字节):
- 浮点运算量:
- 访存量(假设无缓存):读 (8 字节)+ 读 (8 字节)+ 写 (8 字节)= ;
- 计算访存比:
Step 4: Formal Model(正式数学模型与硬件映射)
给定硬件平台与特定算子,该算子在该硬件上所能达到的理论最大计算性能 (单位:TFLOPS) 由下式唯一决定: 其中核心参量物理定义如下:- (硬件峰值算力):芯片在当前数据精度下的理论硬件算力顶峰(单位: );
- (硬件显存物理带宽):显卡主存储总线的理论或实测最大吞吐速率(单位: );
- (Arithmetic Intensity,算术强度 / 计算访存比):算法自身固有的数学物理特征:
- 当 时:算子落在左侧斜坡区,属于 Memory-Bound(访存受限)。此时就算你把计算指令优化上天,性能也纹丝不动;唯一的破局手段是减少 HBM 访存字节数(提高 AI 值)!
- 当 时:算子落在右侧平顶区,属于 Compute-Bound(算力受限)。此时显存带宽已经不再是瓶颈,限制性能的是硬件 Tensor Core 的算力供给能力。
Step 5: Sanity Check(数量级自检)
我们代入当前工业界最主流的两款旗舰大模型加速卡手算校验:- NVIDIA A100-SXM4-80GB (Ampere 架构):
- Dense FP16 峰值算力:
- HBM2e 物理实测带宽:
- A100 硬件固有转折点:
- NVIDIA H100-SXM5-80GB (Hopper 架构):
- Dense FP16 峰值算力:
- HBM3 物理实测带宽:
- H100 硬件固有转折点:
💡 惊心动魄的工程事实: 在 H100 上,只有当一个算子每从显存中搬运 1 个字节的数据,就能在其上完成 295 次以上的乘加计算,才配把 H100 的 Tensor Core 彻底喂饱!
如果一个算子的 AI 只有区区 10 或 20,那么它在 H100 上连 10% 的算力峰值都不可能发挥出来!
5.3 现代双顶与多顶 Roofline 模型:Tensor Core 顶、CUDA Core 顶与多级缓存顶
在真实的大厂技术架构分析中,传统的单线 Roofline 已经被拓展为更加精细的 分层多顶 Roofline 模型:- Top 1 vs Top 2(算力双顶): 如果你的代码没有调用 Tensor Core(例如手写的普通标量加乘循环),你的算力天花板不是 989 TFLOPS,而是跌落到了 CUDA Core 的 67 TFLOPS!
- 斜率 1 vs 斜率 2(带宽双坡): 如果你的数据能全部命中片上 50MB 的 L2 Cache,你的访存斜率从 3.35 TB/s 飙升到 6 TB/s,硬件转折点将大幅左移,算子更容易进入满血状态!
5.4 算术强度的迁移法则:如何让算子翻越物理转折点?
在 Roofline 坐标系中,性能工程优化的核心本质只有两件事:- 纵向向上推(Vertical Push):在算术强度不变的前提下,通过指令级并行、消除 Warp Divergence、消除 Bank Conflict,让实际性能逼近当前的理论屋顶;
- 横向向右移(Horizontal Shift):这是更高阶的架构级优化! 通过算法数学重构、算子融合、SRAM Tiling、重计算,彻底消除冗余的 HBM 读写字节,将算子的算术强度 强行向右推过转折点 ,实现性能从量变到质变的飞跃!
6. 经典 AI 算子 Roofline 逐案推导与生产优化解法
现在,我们把大模型中最核心的四个算子推上 Roofline 白板,逐一验明正身!6.1 算子 A:大矩阵乘法 GEMM( )的算术强度推导与 Tiling 阶梯
考虑大模型 Linear 线性层中最标准的矩阵乘法:- 矩阵 ,矩阵 ,输出 ;
- 数据格式:FP16(每元素 2 字节);
- 经典大模型维度:取 。
1. 浮点运算量(FLOPs):
每一个输出元素都需要做 次乘法和 次加法( 次操作):2. 物理访存量(Bytes):
- 读矩阵 :
- 读矩阵 :
- 写矩阵 :
- 总 HBM 搬运量(假定理想片上复用):
3. 算术强度计算:
4. Roofline 判决:
- 结论:大矩阵 GEMM 是毫无争议的纯 Compute-Bound(算力受限)算子!
- 它深深扎根在 Roofline 的最右侧平顶区。因此,优化大 GEMM 的核心手段是:提高 Tensor Core 的 MMA 指令填充率、隐藏指令延迟、优化流水线分块(Tiling),而根本不用担心 HBM 物理带宽被榨干。
6.2 算子 B:FlashAttention 如何通过片上 SRAM 分块将 Attention 变成 Compute-Bound?
标准自注意力机制(Self-Attention)的公式: 设序列长度为 ,特征维度为 。1. 标准 PyTorch Attention 的悲剧:
在 FlashAttention 出现之前,PyTorch 的标准执行流是:- 从 HBM 读 ,计算 ,将大小为 的中间注意力矩阵 写入 HBM;
- 从 HBM 读回 ,在全局显存执行 Softmax 归一化,将大小为 的归一化概率矩阵 重新写回 HBM;
- 从 HBM 读回 和 ,计算最后的输出 ,写回 HBM。
- 的中间读写量高达数个 GB!
- 算术强度被稀释至:
- 标准 Attention 被死死锁在 Memory-Bound 的低效斜坡上!算力硬件 90% 的时间在等 HBM 搬运中间矩阵 和 !
2. FlashAttention 的相变突破:
Tri Dao 等人提出的 FlashAttention,其核心系统思想不是改动数学,而是彻底重塑数据流:- Online Softmax(在线分块 Softmax):通过缩放数学恒等式,允许 Softmax 在分块流式输入时动态维护局部最大值与指数和;
- SRAM 块级融合:将 按照 的小块加载进 SM 的片上 Shared Memory(SRAM);
- 在 SRAM 中直接完成 、Softmax 归一化以及与 的相乘!
- 中间那两个巨大的 矩阵 和 彻底灰飞烟灭,它们的一生全在片上高速 SRAM 里走完,从始至终没有向片外 HBM 写入哪怕 1 个字节!
6.3 算子 C:LayerNorm / RMSNorm / Softmax 为什么永远被困在 Memory-Bound 深渊?
我们再来看大模型中密密麻麻的逐元素(Element-wise)与规约算子,以 RMSNorm 为例: 对于一个长度为 的向量(FP16,每个数 2 字节):- 运算量(FLOPs):
- 平方 次,求和规约 次,除法加开方约 3 次,乘以缩放权重 次;
- 总运算量约 ;
- 访存量(Bytes):
- 从 HBM 读取输入 : 字节;
- 读取权重 : 字节;
- 将结果 写回 HBM: 字节;
- 总访存量约 ;
- 算术强度:
🏭 大厂生产解法:Kernel Fusion(算子融合)
既然单个 RMSNorm 的算术强度无法拯救,大厂的唯一破局方案就是连横合纵:
将 RMSNorm + Linear前序 + Residual Add(残差相加)+ Dropout 强行融合在同一个 Triton / CUDA Kernel 中。前序算子的计算结果死死锁在寄存器中,直接作为下一个算子的输入,消除多余的显存往返,把综合 AI 强行拉升数倍。
6.4 算子 D:LLM Decode 阶段的 KV Cache 访存危机(Batch Size = 1 为什么是算力杀手?)
在大语言模型(LLM)推理生产中,存在一个著名的两阶段分化:- Prefill(预填充阶段):用户输入一段长 Prompt,整段 Prompt 并发输入,属于典型的 GEMM 矩阵乘矩阵,算术强度极高,处于 Compute-Bound;
- Decode(自回归生成阶段):模型每一步只能吐出 1 个新 Token。
- 原本的矩阵乘矩阵(GEMM)直接退化成了 矩阵乘向量(GEMV)!
- 每一个新 Token 的生成,都必须把该层过去所有的历史 KV Cache 从片外 HBM 完整加载进片上一次,同时把巨大的模型权重完整从 HBM 读入一次!
- 假设权重参数量为 ,FP16 占用字节数 ;
- 每次与 的向量相乘,进行的浮点运算量是 ;
- 算术强度:
7. 动手实战与代码实验室(Minimal Runnable Code)
代码是穿透一切理论迷雾的最佳武器。本实验室提供 4 个完整、可直接在本地运行且自带严格度量基准的实验脚本。7.1 实验 1:Warp Divergence 性能悬崖微基准(Python/PyTorch 真实耗时阶梯)
本实验模拟在 GPU 上执行密集逻辑时,存在分支分化与消除分支分化的性能反差对比:7.2 实验 2:全局显存合并访问 vs 跨步访存有效带宽实测(现场还原 15 倍带宽跌落)
本实验通过测试不同访问步长(Stride)下的显存读取吞吐率,直观呈现 128 字节合并事务被破坏后的“带宽断崖”:7.3 实验 3:Shared Memory Bank Conflict 触发与错位 Padding 消除测试
本实验通过仿真模拟 Shared Memory 在连续列式读取时产生的跨步访问与加入 Padding 后的效果:7.4 实验 4:真实算子 Roofline 自动绘制与分析工具(纯 Python + Matplotlib)
本实验是一个完全自包含、可独立运行的 Python 自动化工具。它内嵌了 A100 与 H100 的物理硬件模型,支持输入任何自研算子的 FLOPs 与 Bytes,自动计算算术强度、在图形中标注算子落点并输出完整的饱和度体检报告:8. Ringi 避坑指南与生产性能工程黄金 Checklist
8.1 避坑表格(❌ 常见小白错误理解 vs ✅ 大厂 AI Infra 正确理解)
8.2 生产环境 GPU 性能优化黄金十条 Checklist
📋 生产环境 GPU 性能工程黄金 Checklist (Ringi 审稿器)
- 1. 【指标真伪排查】:杜绝仅依赖 nvidia-smi,必须挂载 NCU / Profiler 查看 SM Active 与 Tensor Core Active 的真实差值。
- 2. 【分化规避契约】:检查热点循环与内层 Kernel,确认所有 if-else 分支是否已对齐至 Warp 粒度,消除 Warp 内部掩码分化。
- 3. 【显存合并对齐】:确保全局内存访问地址为 128 字节对齐,连续线程读取连续数组下标。
- 4. 【Bank 冲突消除】:在 2D 共享内存数组中引入错位 Padding(如 float smem[32][33]),彻底 消灭 32-way Bank Conflict。
- 5. 【绕过寄存器堆】:在 Ampere/Hopper 架构上显式启用 cp.async 或 TMA 异步搬运,释放通用寄存器 资源。
- 6. 【Roofline 定位先行】:在动手重构代码前,手工推导算子的 FLOPs 与 Bytes,画出在当前硬件 上的具体落点(明确是左侧还是右侧)。
- 7. 【小算子连横合纵】:对于 AI < 10 的 Element-wise、Norm、Softmax 算子,坚决采用 Triton/ CUDA 进行 Kernel Fusion 深度融合。
- 8. 【片上 Tiling 极致复用】:对于 GEMM/Attention,必须将数据切块尺寸设计为与 SRAM/Shared Memory 完美适配,确保从 HBM 加载一次在片上复用数十次以上。
- 9. 【占有率与延迟掩盖】:确保每个 SM 驻留的活跃 Warp 数(Occupancy)足以掩盖 400 个周期的 HBM 访存延迟,防止寄存器或 Shared Memory 溢出导致并发断崖。
- 10. 【动态 Batching 策略】:在 LLM 推理生产服务中,严禁长期运行单并发 BS=1,必须通过 Continuous Batching 提升计算访存比。
9. Ringi 5 点核心速记口诀、自我检验清单与课后深度思考题
9.1 5 点押韵核心速记口诀
9.2 10 条白板自我检验清单
在不翻看本文任何内容的前提下,你能否在白板上流畅解答以下 10 项:- 1. 为什么
nvidia-smi的 100% GPU 利用率不能证明计算单元被跑满了?其底层的物理统计口径是什么? - 2. 为什么说 Warp(32 线程)是 GPU 调度的基本粒子,而不是单个 Thread?
- 3. 为什么 GPU 的 Warp 上下文切换耗时是 0 周期,而 CPU 线程切换需要成千上万个周期?
- 4. 解释 Active Mask 与 Divergence Stack,当 Warp 内执行
if (threadIdx.x < 16)时硬件发生了什么? - 5. 为什么 Tensor Core 必须以 Warp 为单位协同计算?它相比传统 CUDA Core 解决了什么瓶颈?
- 6. 为什么跨步访问(Strided Memory Access)会导致有效显存带宽发生十几倍的暴跌?
- 7. 画出 Shared Memory 的 32 个 Bank 结构,说明为什么
tile[32][32]会发生 32-way 冲突,而tile[32][33]可以完美消除它? - 8. 默写 Roofline 模型的标准公式,并给出 NVIDIA H100 SXM 在 FP16 下的物理转折点数值与单位。
- 9. 为什么 FlashAttention 在数学等价的前提下,能够实现数倍的端到端训练加速?它改变了 Roofline 上的哪个参数?
- 10. 为什么在 LLM 生成(Decode)阶段,Batch Size = 1 会导致 GPU 性能严重受限?
9.3 3 道高阶开放式课后思考题(含极端 Corner Case)
- 极端 Occupancy 与 Register 溢出悖论: 在 CUDA 性能优化中,是不是活跃 Warp 数占满整个 SM(Occupancy = 100%)性能就一定最好?如果一个 Kernel 为了追求 100% 的 Occupancy,强制将每个线程的寄存器压到 32 个以下,导致原本可以放在寄存器中的局部变量被迫溢出到 Local Memory(物理实际上是片外全局显存 HBM),会引发什么惨烈的系统后果?请从 Roofline 角度分析这个 Trade-off。
- 异步 TMA 引擎与流水线 Double Buffering: 在 NVIDIA Hopper 架构的 TMA 硬件机制下,SM 可以在第 步计算当前 Tile 的同时,异步通知 TMA 加载第 步甚至第 步的数据到片上不同的 Shared Memory 缓冲区(多级缓冲流水线)。如果 Shared Memory 的容量被切分成了 3 块(Triple Buffering),这会对 SM 的并发 Block 驻留数量产生什么制约?如何找到最优的缓冲级数平衡点?
- 超长上下文下的注意力计算相变: 当大语言模型的上下文长度从 4K 飙升至 128K 乃至 1M 时,即使采用了 FlashAttention,整个 Attention 算子的 FLOPs 依然按 扩张,而 HBM 访存按 扩张。推导当上下文长度 趋于无穷大时,Attention 算子的算术强度 将会发生什么变化?此时制约系统的终极瓶颈会重新回到算力、显存容量还是网络通信?
10. 📚 参考资料与权威文档指引
- NVIDIA 官方体系结构白皮书:
- NVIDIA Corporation: NVIDIA H100 Tensor Core GPU Architecture (Hopper Architecture Whitepaper), 2022. (深入研究 SM 分区、TMA 引擎与第 4 代 Tensor Core 的权威一手资料)
- NVIDIA Corporation: NVIDIA A100 Tensor Core GPU Architecture (Ampere Architecture Whitepaper), 2020.
- CUDA 官方编程与性能指南:
- NVIDIA: CUDA C++ Programming Guide (Release 12.x), Section: Hardware Implementation & Performance Guidelines.
- NVIDIA: Nsight Compute Documentation - Kernel Profiling Guide & Warp Stall Reasons.
- 经典学术论文与奠基之作:
- Samuel Williams, Andrew Waterman, David Patterson: Roofline: An Insightful Visual Performance Model for Multicore Architectures, Communications of the ACM, Vol. 52 No. 4, 2009. (Roofline 模型的开山之作)
- Tri Dao, Daniel Y. Fu, Stefano Ermon, Atri Rudra, Christopher Ré: FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness, NeurIPS 2022.
- Tri Dao: FlashAttention-2: Faster Attention with Better Parallelism and Work Partitioning, 2023.
- 体系结构经典教材:
- John L. Hennessy, David A. Patterson: Computer Architecture: A Quantitative Approach (6th Edition), Chapter 4: Data-Level Parallelism in Vector, SIMD, and GPU Architectures.
附录:Appendix A — 大厂硬核高频面试题与白板推导(Interview Drill)
💬 面试题 1:在 NVIDIA H100 SXM(Dense FP16 峰值 989 TFLOPS,HBM3 带宽 3.35 TB/s)上运行 70B 密集模型单 Token 生成(Batch Size = 1),请推导其理论最大生成速度上限(Tokens/sec)。
🎯 大厂标准答题路径与白板推导:
- 第一性原理定性:
- 在 Batch Size = 1 的自回归生成阶段,每生成一个 Token,必须将模型的 70B 权重从 HBM 完整加载一次。
- 矩阵乘向量计算量: ;
- FP16 权重显存读取量: ;
- 该算子的计算访存比:
- 在 Roofline 上判定瓶颈:
- H100 的转折点 ;
- 因为 ,系统处于绝对的 Memory-Bound(显存带宽受限)极限斜坡上。
- 计算单 Token 物理时延极限与吞吐上限:
- 生成 1 个 Token 所需搬运权重的理论最短物理时间:
- 理论最高生成吞吐:
- 架构结论与生产启示:
- 单卡跑 70B(甚至装不下,需量化为 4-bit 或跨卡 TP),在 BS=1 下单卡单流生成绝不可能超过 24 Tokens/s;
- 想要提升吞吐,必须提高 Batch Size(分摊权重搬运),或者采用投机采样(Speculative Decoding)将多步验证合并为批处理矩阵计算。
💬 面试题 2:详细阐述 CUDA Warp 调度器的延迟隐藏(Latency Hiding)机制。假设一个 Kernel 的访存指令需要等待 400 个时钟周期,每个 Warp 每次发射一条指令耗时 1 个周期,至少需要并发驻留多少个活跃 Warp 才能完全掩盖显存时延?
🎯 大厂标准答题路径与白板推导:
- 利特尔法则(Little’s Law)在体系结构中的应用:
- 并发隐藏模型公式:
- 定量推导:
- 若访存延迟为 个周期;
- 单个 Warp 发射完一条访存指令后,必须等待 400 个周期才能发射下一条依赖该数据的指令;
- 如果每个周期调度器都需要发射一条指令以保证计算流水线 100% 满负荷,那么在这 400 个周期的时间空窗内,必须有其他独立的 Warp 处于就绪状态并供调度器发射;
- 因此,理论最少需要并发维护的活跃 Warp 数为:
- 指令级并行(ILP)的分摊:
- 如果每个线程自身具有独立的指令级并行度(例如通过循环展开,一个线程连续发射 4 条完全无依赖的独立运算指令),那么每个 Warp 可以连续支撑 4 个周期的发射;
- 此时需要的活跃 Warp 数可以降为 个 Warp。
- 硬件配额校验(Sanity Check):
- 单个 SM 最多支持驻留 64 个活跃 Warp(Hopper 架构为 64 Warp = 2048 线程);
- 因此,仅靠线程级并发往往不足以完全掩盖 400 周期的长延迟,现代高性能 Kernel 必须同时结合 线程级并行(TLP: 多 Warp 轮转) 与 指令级并行(ILP: 循环展开与寄存器双缓冲) 才能实现真正的零停顿。
💬 面试题 3:为什么在编写 CUDA Shared Memory 矩阵转置时容易产生 32-way Bank Conflict?如何用一行代码的 Padding 技巧彻底解决?请推导其数学映射关系。
🎯 大厂标准答题路径与白板推导:
- 硬件寻址映射模型:
- Shared Memory 划分为 32 个 Bank,每个 Bank 宽 4 字节(1 个 32-bit float)。
- 任意元素下标 所对应的物理 Bank 编号公式为:
- 转置冲突诱因推导:
- 声明二维共享数组
float tile[32][32];- 其在内存中的线性展开为:
tile[row][col]对应的扁平下标为 ;- 当 Warp 写入该数组时按行写入( 固定, ), ,32 个线程落入 32 个不同的 Bank,无冲突;
- 但在转置读取阶段,线程必须按列读取( 固定, ):
- 32 个线程计算出的 Bank ID 完全相同!全部砸在同一个 Bank 上!触发最高级别的 32-way Bank Conflict,原本 1 个周期的访问被强制分拆为 32 个连续周期!
- 错位 Padding 的数学解法:
- 将数组定义修改为:
__shared__ float tile[32][33];(每行末尾多加 1 个无用 float);- 新的扁平下标为: ;
- 按列读取时( ):
- 对于不同的 , 严格互不相同、单调双射覆盖 !
- 32 个线程的访问被完美分流到 32 个互不冲突的 Bank 中,冲突瞬间归零!
💬 面试题 4:为什么现代 AI Infra 性能分析不仅要看基于 HBM 的普通 Roofline,还要看基于 L2 Cache 的多级 Roofline?对于计算访存比 的算子,如何通过 L2 驻留将其性能提升一倍?
🎯 大厂标准答题路径与白板推导:
- 单级 Roofline 的局限性:
- 传统 Roofline 默认假设所有数据都必须从片外 HBM 读写(带宽为 )。
- 但现代旗舰 GPU(如 H100)配备了高达 50 MB 的超大片上统一 L2 Cache,其内部 Crossbar 互联带宽高达 (几乎是 HBM 的 2 倍)。
- 多级 Roofline 物理模型:
- 当算子所需的数据体量小于 50MB,或者经过精巧的 Cache-Blocking 能够高频命中 L2 Cache 时,算子的访存倾斜线不再受限于 3.35 TB/s,而是受限于 L2 的 6 TB/s!
- 定量性能跳变推导:
- 算子计算强度 ;
- 若数据未命中 L2,受限于 HBM:
- 若重构 Kernel 网格调度,引入 CUDA 12 的 L2 Cache Residency Controls(持久化缓存保留) 或调整 Thread Block 的遍历顺序(Z-Curve / Hilbert Curve 保持时间局部性),使数据 100% 命中 L2:
- 算子在算法 FLOPs 完全不变的前提下,仅靠调整片上缓存命中,吞吐直接提升了 1.79 倍!