🏛️ 第20讲:智算集群的听诊器——Benchmark、监控与 AI 集群故障诊断(Step Time 三层分解、慢节点木桶短板、NCCL Hang 排障决策树与 Xid 故障图谱)
主讲人:👓 Ringi(大厂 AI Infrastructure 工程师)
所属模块:Module 01: GPU 硬件架构、数据搬运、集群通信与 Overlap
篇章范式:🛠️ 生产运维与故障排障篇(Production Troubleshooting & Diagnostics Paradigm)
核心导读:
在千卡/万卡大模型预训练的漫长征程中,AI Infra 团队最恐惧的报警永远有两个:
第一个是“训练突然暴毙卡死(NCCL Hang)”——集群监控上所有 GPU 依然显示 100% 占用,但 Step 进度彻底冻结,上百名算法与平台工程师半夜被电话叫醒,抓着几万行杂乱日志在排障迷宫里通宵抓瞎;
第二个是更加隐蔽而致命的“静默降速(Silent Slow Node / Straggler)”——任务没有任何报错,甚至没有掉卡,但原本 800 毫秒的单步迭代耗时莫名其妙暴增到 1300 毫秒,大模型训练速度凭空蒸发了 35%,每天几百万元的昂贵算力在无声无息中被白白焚烧!
面对千卡集群的庞大机器阵列,如何用一套科学的金字塔漏斗层层下钻、三分钟锁定性能瓶颈?为什么说在集合通信的木桶短板中,“通信等待时间最长的人往往是无辜的,那个通信等待时间为 0 的才是真凶”?面对死一般的 NCCL Hang,如何沿着标准化四步决策树在 15 分钟内完成硬核定损?操作系统内核抛出的 Xid 79、Xid 31、Xid 61 到底对应着哪些无法逆转的物理创伤?无损以太网的 PFC 暂停帧又是如何酿成整网死锁风暴的?
本讲我们将彻底走出“两眼一抹黑、重启解千愁”的业余运维泥潭,将大厂一线沉淀数万机时提炼出的听诊兵法与止血手册倾囊相授!
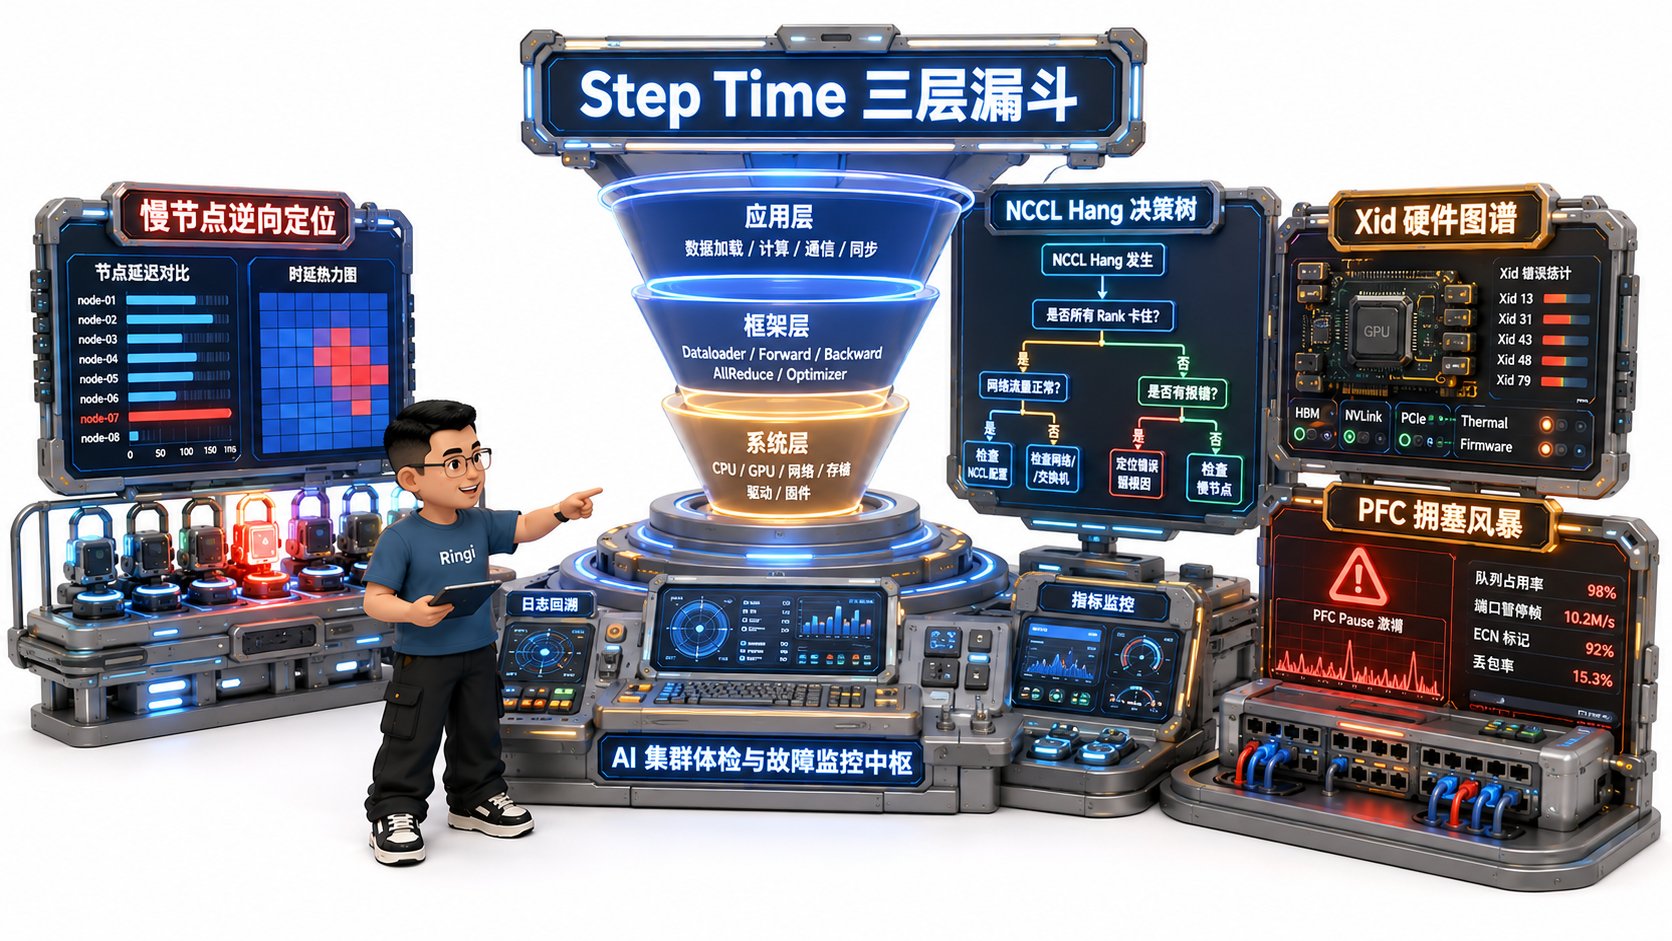
📑 目录导航
- 0. Ringi 开场:生产真实现场与痛点冲突
- 1. 性能分析第一性原理:Step Time 三层分解金字塔(No Naked Formula 2.0)
- 2. 木桶短板抓凶手:慢节点(Slow Rank / Straggler)逆向定位法
- 3. 午夜梦魇破局:NCCL Hang(死锁)排障四步决策树
- 4. 芯片物理病理学:GPU Xid 错误代码深度图谱
- 5. 网络层死穴:RoCE / InfiniBand 无损网络监控与 PFC / ECN 拥塞风暴
- 6. 智算中心监控中枢:四层指标体系与秒级熔断自愈
- 7. 动手实战与代码实验室(Minimal Runnable Code)
- 8. Ringi 避坑指南与生产性能工程黄金 Checklist
- 9. Ringi 5 点核心速记口诀、自我检验清单与课后深度思考题
- 10. 📚 参考资料与核心源码/经典论文指引
- 附录:Appendix A — 大厂硬核高频面试题与白板推导(Interview Drill)
0. Ringi 开场:生产真实现场与痛点冲突
0.1 真实工程矛盾:千卡大模型训练的两大午夜梦魇(NCCL Hang vs Slow Node)
在大厂负责千卡大模型训练平台的工程师,手机永远不敢调成静音。因为有两个足以让所有人神经衰弱的报警,随时会在凌晨三点撕裂夜空:梦魇一:死一般的冻结(NCCL Hang)
监控面板上,全集群 1024 张 GPU 的利用率整整齐齐地趴在 100%,GPU 温度正常、显存显存全满,看似算力全开。然而,模型训练的 Step 计数器却静止了整整 40 分钟!既没有抛出异常,也没有显卡报错,所有节点仿佛陷入了一场深不见底的集体冬眠。梦魇二:无声的钝刀子割肉(Slow Node)
任务跑得很稳定,已经连续运行了 3 天,然而大盘监控上的 MFU(Model FLOPs Utilization)只有可怜的 26%(理论基线应该在 48% 以上),单步迭代耗时比基线慢了整整 350 毫秒! 算法团队抱怨底层网络太差,网络团队指责算法模型架构写得烂,运维团队反复执行nvidia-smi 却发现 128 台机器全部“状态健康”!
0.2 线上真实事故复盘:某万亿参数大模型因 1 张单卡热降频拖垮 1024 卡训练达 3 天的惨痛教训
回顾国内某头部 AI 团队在一次万亿 MoE 模型训练中的血泪教训: 该项目动用了 128 台 8-GPU 满配服务器(共 1024 张 A100-SXM4-80GB)。上线初期,训练按预期推进,但三天后团队发现整体训练进度严重滞后:- 理论上 3 天应跑完 120,000 个 Step,实测仅跑完 78,000 个 Step,整体算力浪费折合资金超过两百万元;
- 抓取分布式日志,各节点日志整齐划一,没有一个进程崩溃退出。
0.3 AI 集群故障分层与排障全景速查表
智算集群的故障绝非孤立事件,必须将其划分为清晰的物理与系统层级:1. 性能分析第一性原理:Step Time 三层分解金字塔(No Naked Formula 2.0)
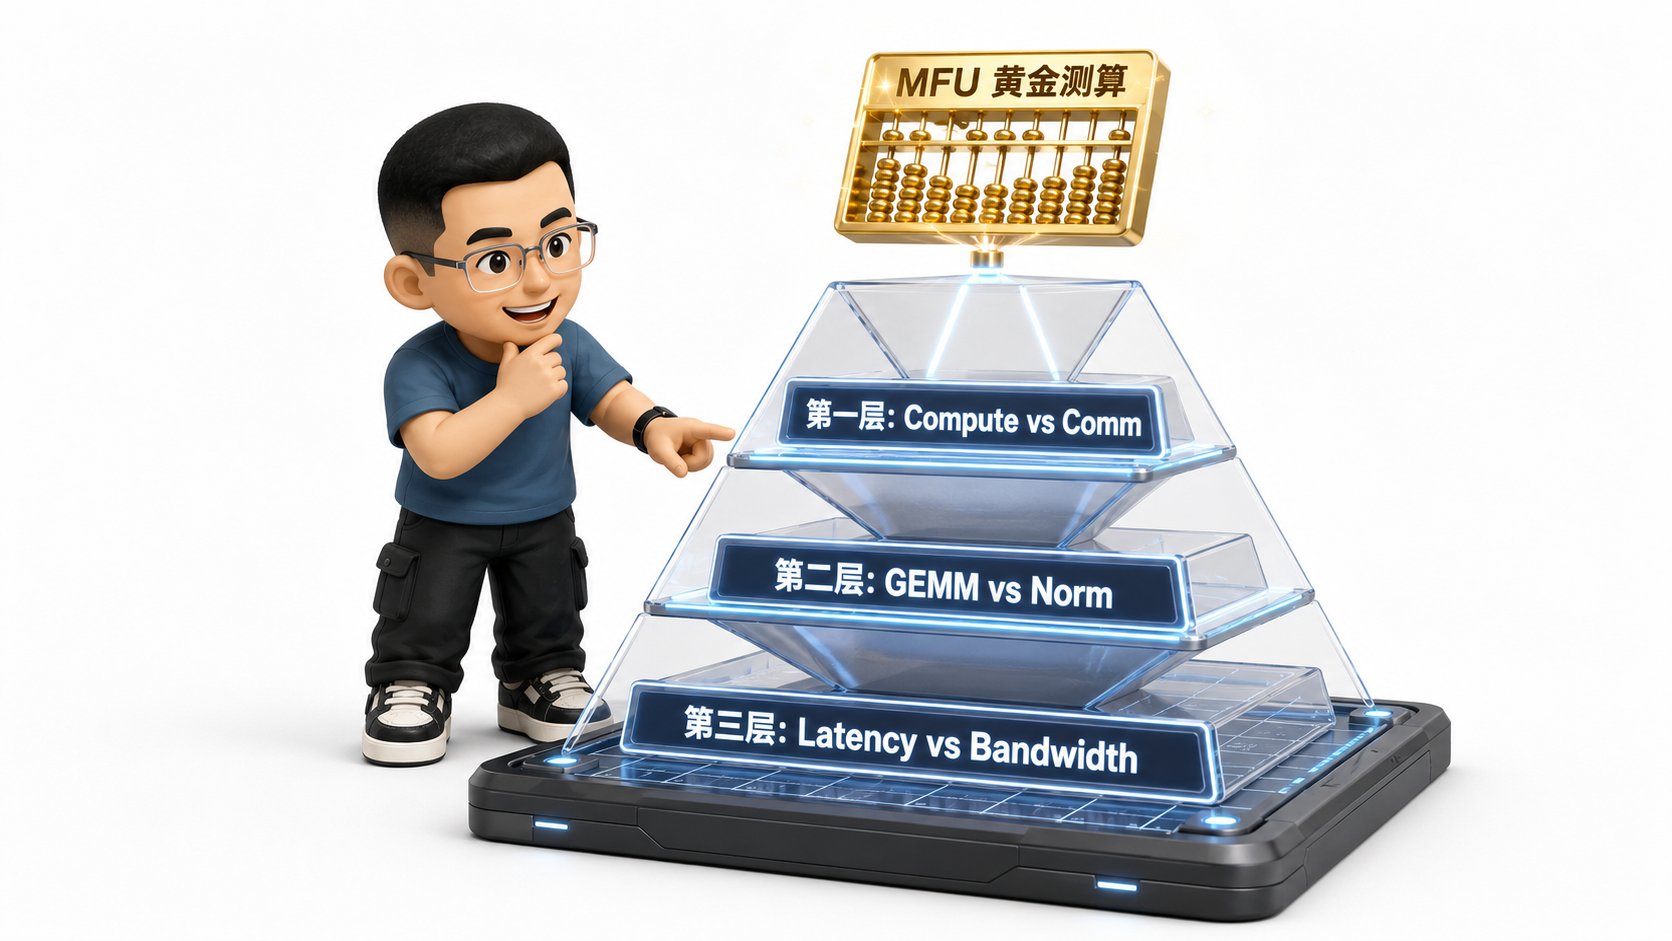

1.1 为什么需要分解?盲目优化单点往往南辕北辙
在大模型性能调优中,最业余的做法是“盲人摸象”:看一眼 GPU 利用率不高,就去调批次大小(Batch Size);看到耗时较长,就去强行改 FlashAttention。 在大厂 AI Infra 工业实践中,面对任何性能不达标的集群,第一步永远是构建 Step Time 三层分流漏斗(Funnel Model)。每一层漏斗只回答一个物理问题,层层下钻,绝不跳步!1.2 第一层:计算时间( ) vs 暴露通信时间( )
单步训练迭代耗时(Step Time)由计算与未被重叠隐藏的通信共同组成:1.3 第二层:计算内部细分——算力瓶颈(Compute-Bound) vs 访存瓶颈(Memory-Bound)
如果第一层判定瓶颈在计算( 过长),必须沿 Roofline 模型将其拆解为两大算子阵营:- 算力受限(Compute-Bound):
- 典型算子:高维 GEMM 矩阵乘法( 、FFN Linear);
- 诊断指标:Tensor Core 利用率 是否达到理论峰值的 60%~75%?如果利用率极低,检查是否是 Batch Size 太小导致 SM 核心吃不饱,或者是 Tile 切分失配;
- 访存受限(Memory-Bound):
- 典型算子:RMSNorm、LayerNorm、Softmax、RoPE 旋转位置编码;
- 诊断指标:HBM 带宽饱和度。如果显存带宽打满(如 H100 达到 3.0 TB/s),必须采用 算子融合(Kernel Fusion),将多次读写显存合并在 Shared Memory 中完成!
1.4 第三层:通信内部细分——小包启动时延(Latency-Bound) vs 大包网络带宽(Bandwidth-Bound)
如果第一层判定瓶颈在暴露通信,依据 Alpha-Beta 模型对其进行解剖:- 时延受限(Latency-Bound):
- 特征:张量切片极小( M < 1\,\text{MB} ),通信耗时被单步网络启动时延 和跨机跳步主导;
- 药方:开启 DDP 梯度分桶(Gradient Bucketing),强行把小包拼接为 25MB 以上的大桶,或开启 CUDA Graph;
- 带宽受限(Bandwidth-Bound):
- 特征:大包通信( ),通信耗时完全由网络物理线速 决定;
- 药方:检查网卡速率协商、RoCE/IB 多轨对齐(Multi-Rail Affinity),排查交换机丢包与慢卡。
1.5 Step Time 分解公式与 MFU / MBU 算盘校验
在实际验收时,我们通过 MFU(Model FLOPs Utilization) 对集群进行终极测算:1. 为什么需要算 MFU?
单纯看nvidia-smi 的 GPU 利用率(GPU-Util)是巨大的骗局——GPU 空转轮询或者等待通信时,利用率依然显示 100%!MFU 才是唯一不撒谎的工业黄金标准!
2. 极简计算公式(No Naked Formula 2.0):
- 设模型单步理论计算量为 (对于 Dense Transformer,前向约 ,反向约 ,单步总计约 );
- 设集群总卡数为 ,单卡硬件理论峰值算力为 (如 H100 SXM 为 989 TFLOPS BF16);
- 实测单步迭代耗时为 (秒):
2. 木桶短板抓凶手:慢节点(Slow Rank / Straggler)逆向定位法
2.1 慢节点的三大物理病灶:供电与热降频、PCIe 物理金手指掉速、光纤弱光
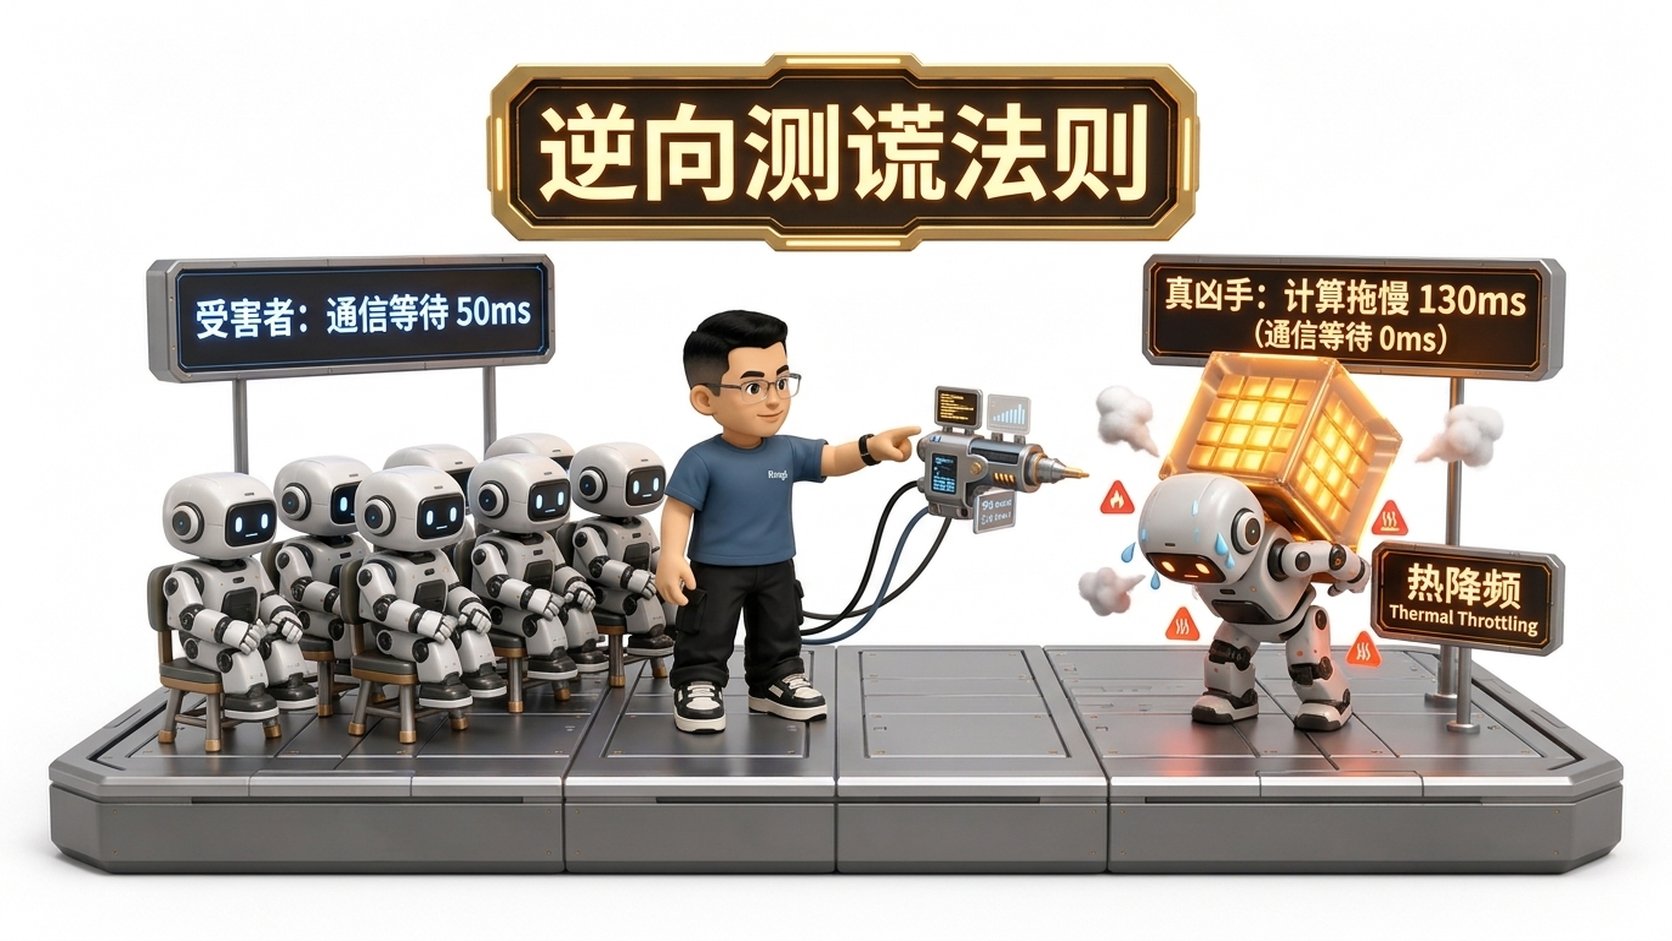
慢节点(Straggler)之所以难抓,是因为它没有死,而是像一个生病的搬运工,速度变慢了,却依然在系统里机械地交接班。它的三大典型物理病灶包括:2.2 颠覆直觉的逆向测谎逻辑:等待时间最长的人是无辜受害者!
在集合通信(如 AllReduce)的同步壁垒下,初级工程师抓出 Profiler 性能追踪图时,常常会犯下一个颠覆黑白的致命错误:
“看!Rank 0 到 Rank 6 在 c10d::all_reduce 上整整耗费了 50 毫秒!而 Rank 3 在通信上只花了 0 毫秒!所以一定是 Rank 0~6 的网络通信出了大问题!”
这是完全颠倒因果的荒谬结论!
2.3 慢节点定位三大实战工具:跨 Rank 耗时分布、DCGM 时钟偏离度与心跳监控
1. 跨 Rank 耗时倒挂定位法(Profiler Inversion)
导出 PyTorch Profiler 的 Chrome Trace,聚合所有卡在aten::linear 或反向算子的耗时。计算耗时高出平均线 20% 以上、且通信等待时间为最低值的 Rank,直接锁定为慢节点!
2. DCGM 硬件时钟实时巡检(Clock Skew Detection)
通过 NVIDIA DCGM 实时轮询全集群 GPU 的核心时钟频率(SM Clock):clocks.current.sm 严重低于基准(例如正常卡 1830 MHz,某卡仅 1120 MHz),且标志位显示 Thermal Slowdown 或 Power Brake,无需看代码,100% 确认硬件物理降频!
3. 分布式心跳与步长看门狗(Step Heartbeat Watchdog)
训练框架内注入轻量级心跳探针,记录每张卡完成前向和反向计算的绝对时间戳。只要某节点的计算完成时间戳持续偏离中位数超过阈值,自动触发告警并标记该节点下线(Cordon)。3. 午夜梦魇破局:NCCL Hang(死锁)排障四步决策树
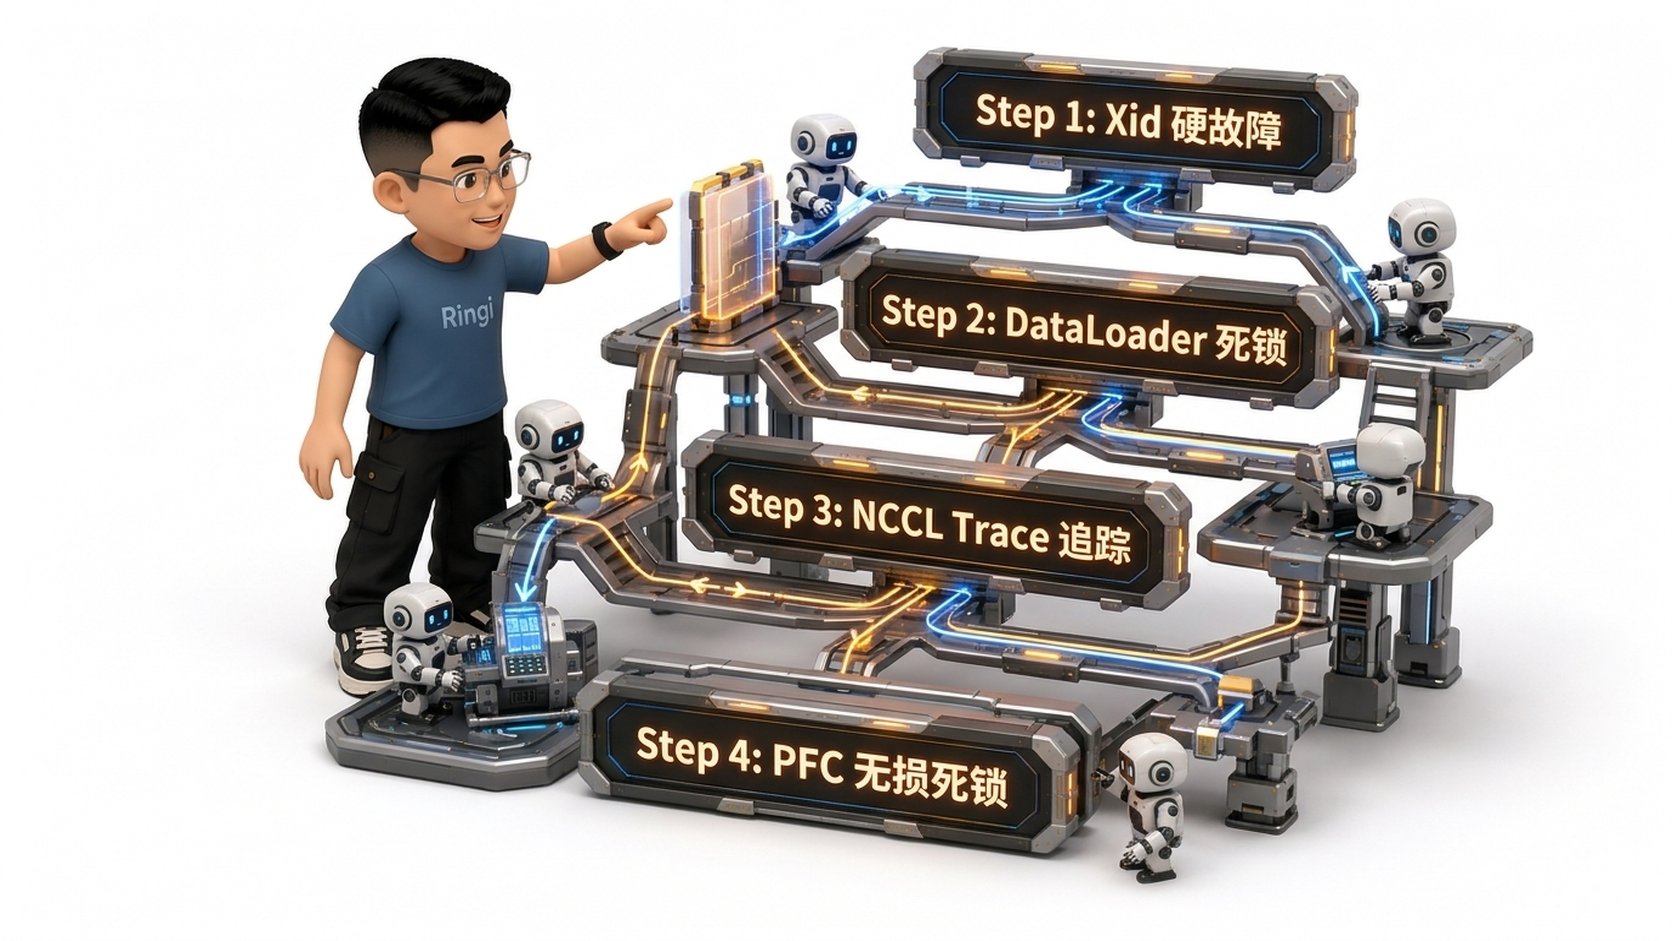
3.1 为什么说 NCCL Hang 是分布式系统最难排查的幽灵?
当一个千卡任务遭遇 NCCL Hang 时,之所以排查极其痛苦,是因为 CUDA 的异步执行模型(Async Execution)掩盖了真正的事故现场:- 当某张卡发生硬件掉卡或代码死锁时,它停止了发包;
- 其余 1023 张卡已经在各自的 GPU Stream 上发射了通信 Kernel,CPU 主机端早已返回;
- GPU 核心陷入无休止的内存轮询等待(Polling Loop),从外部监控看,GPU 利用率死死卡在 100%,CPU 占用极低,系统表现得像是在“全速运行”!
3.2 决策树第 1 步:硬件硬故障秒级排查(dmesg | grep NVRM 锁定致命 Xid)
铁律:永远优先排除硬件物理猝死!登录任意疑似卡死的主机,执行:
- 如果看到
NVRM: Xid: 79, GPU has fallen off the bus:恭喜你,直接破案!该 GPU 已经彻底脱离 PCIe 总线,硬件掉电或烧毁,任何软件重试都是徒劳,必须立刻踢掉该节点并报修; - 如果看到
Xid 61/62或Xid 31:说明 NVLink 物理断链或显存遭遇不可纠正的多比特翻转(Uncorrectable ECC)。
3.3 决策树第 2 步:主机端进程与 DataLoader 死锁排查(py-spy 堆栈透视)
如果内核日志干干净净,说明硬件安然无恙,问题出在软件层!
使用生产级无侵入性能探针 py-spy,直接 Dump 出挂起进程的 Python 完整调用栈:
- 典型真凶 1:DataLoader 读盘死锁:如果某个 Rank 的堆栈卡在
torch.utils.data.DataLoader内部的multiprocessing.Queue.get(),通常是某台机器的分布式存储(如 NFS / Lustre)响应超时或句柄耗尽,导致该 Rank 根本没拿到数据,后续所有卡在 AllReduce 等死! - 典型真凶 2:分支逻辑失配(Rank Divergence):
3.4 决策树第 3 步:NCCL 通信算子与拓扑阻塞定位(NCCL_DEBUG=INFO 逐行解密)
如果排除了数据加载问题,必须让 NCCL 吐出底层交互轨迹。在启动脚本中注入:
NCCL INFO Comm config nvlinkCentricSched set to 1:表明 NVLink 拓扑识别成功;如果是pcieCentricSched,说明 NVLink 掉线被降级走 PCIe;Ring 00 : 0 -> 1 -> 2 ...:检查逻辑环的顺序是否完整对齐;Call to connect returned Connection timed out:直接打印出在尝试握手哪一个目标 IP 和端口时超时,立刻顺藤摸瓜找到目标机器!
3.5 决策树第 4 步:无损网络 PFC 死锁与微突发丢包风暴排查
如果所有卡都进入了通信,日志停留在某个具体的 AllReduce,则说明网络包在物理交换机中被堵死了! 登录 RoCE/IB 交换机或在主机端执行:rx_prio4_pause_duration(优先级 4 暂停帧持续时间)数值异常庞大,说明整网已触发 PFC 死锁风暴(PFC Deadlock Storm),数据包在交换机环路中无限期循环阻塞!
4. 芯片物理病理学:GPU Xid 错误代码深度图谱
4.1 什么是 Xid?NVIDIA 驱动内核级硬件异常上报机制
Xid 是 NVIDIA GPU 驱动向 Linux 内核(/var/log/messages 或 dmesg)输出的 驱动与硬件异常中断事件代码。它是 GPU 硬件健康状态的“心电图”,每一个 Xid 编号都严格映射了底层不同物理单元(GPU 核心、MMU、NVLink、PCIe 控制器、显存控制器)的异常状态。
4.2 致命硬故障代码速查:Xid 79、Xid 31/48、Xid 61/62 与 Xid 43/45
在 AI Infra 运维中,必须对以下高频 Xid 形成肌肉记忆:4.3 软故障与驱动异常的隔离与自愈恢复策略
- 伴生 Xid 误导:当 GPU 掉卡(Xid 79)时,内核往往会连带抛出数十个 Xid 45 和 Xid 31。排查时切记:只抓时间戳最早的那一个 Xid,它是唯一的真正诱因!
- 软重置(Soft Reset):针对 Xid 43 等挂起状态,在无需重启整台服务器的前提下,可尝试热重置:
5. 网络层死穴:RoCE / InfiniBand 无损网络监控与 PFC / ECN 拥塞风暴
5.1 无损网络的双刃剑:消灭了丢包,却换来了致命的 PFC 死锁(Deadlock)
在跨机分布式大模型训练中,RDMA 必须运行在 无损网络(Lossless Network) 之上:- 传统的有损以太网:网络拥塞时,交换机直接丢弃数据包,由 TCP 负责超时重传。但重传的时延高达数十毫秒,分布式训练根本承受不起;
- RoCE v2 无损网络:利用 PFC(Priority-based Flow Control,基于优先级的流量控制)。当交换机下游队列快被塞满时,向上游发送 Pause 暂停帧,强制上游暂停发包,从而实现“零丢包”。
5.2 PFC 反压雪崩机制:从单网卡拥塞到整网端口瘫痪的时空扩散
5.3 生产核心测谎指标:Pause Duration、Discards、Symbol Error 与 ECN 标记率
在智算中心的交换机与网卡监控大盘上,必须对以下四大核心指标设置毫秒级告警:6. 智算中心监控中枢:四层指标体系与秒级熔断自愈
6.1 四层立体监控:GPU 硬件 ➔ 机内互联 ➔ 网络集群 ➔ 业务应用
一个工业出版级智算平台的监控中枢,绝不是简单的单机监控堆砌,而是构建由下至上的 四层立体防御雷达:6.2 工业级健康检查脚本体系(L1 快速巡检 ➔ L2 结构排查 ➔ L3 压力验证)
在大厂运维规范中,物理机交付或故障诊断必须按深度执行三级体检:- L1 快速巡检(< 10 秒):一键扫清温度、功耗、基础利用率与 Xid 错误;
- L2 结构排查(< 1 分钟):比对 NVLink 拓扑矩阵(确保无
SYS/NODE降级)、校验 ECC 显存 Retired Pages 与 PCIe 协商带宽; - L3 压力验证(> 5 分钟):拉起
dcgmproftester与all_reduce_perf,将整机功耗与总线带宽压至 100% 极限,拷机无暗病后再行入池。
6.3 生产故障秒级自愈闭环:自动 Cordon、热备节点替换与弹性 Checkpoint 恢复
一个成熟的大模型训练运维系统,必须具备 无人值守的自动化自愈闭环:7. 动手实战与代码实验室(Minimal Runnable Code)
本节提供 4 个可以直接在本地完整运行并打印清晰结果的 Python 实验,彻底把 Step Time 分解、慢节点逆向定位、Xid 解析与网络风暴监测剥开揉碎!7.1 实验 1:Step Time 三层分流性能漏斗与 MFU 自动化诊断脚本
本实验实现对单步训练耗时的三层下钻分析,并自动计算全集群 MFU 与瓶颈归因:7.2 实验 2:慢节点(Straggler)逆向定位算法实验
本实验模拟 8 卡节点中单卡发生热降频后,各卡在计算时间与通信等待时间上的倒挂表现,并执行自动化定位:7.3 实验 3:GPU Xid 错误日志解析与自愈决策引擎
本实验解析来自 Linux 内核的dmesg 真实硬件报错,并映射到大厂运维的秒级自愈指令流:
7.4 实验 4:RDMA / RoCE 网络健康与 PFC 拥塞风暴检测器
本实验模拟多网卡端口性能计数器巡检,快速甄别 PFC 死锁风暴与光纤弱光丢包:8. Ringi 避坑指南与生产性能工程黄金 Checklist
8.1 避坑表格(❌ 常见小白误区 vs ✅ 大厂 AI Infra 正解)
8.2 生产 AI 集群运维与故障定位黄金十条 Checklist
- 1. 【开机体检基线】 新节点入池前必须跑通 L1~L3 完整体检,确保
nvidia-smi topo -m全为NVLink,无SYS/NODE降级。 - 2. 【Xid 内核监听】 部署 DaemonSet 实时监听
/dev/kmsg,捕获到 Xid 79/31/61 时在 5 秒内自动标记节点为NoSchedule。 - 3. 【逆向慢卡测谎】 建立全集群计算耗时分布监控,对计算耗时偏离均值 15% 且通信等待为 0 的慢卡实施秒级报警。
- 4. 【时钟频率巡检】 通过 DCGM 定期轮询
clocks.current.sm,若出现由于温度(>83℃)触发的Thermal Slowdown立即隔离排查。 - 5. 【无损网络防死锁】 RoCE 网络交换机必须启用 PFC Watchdog,当端口单次 Pause 时长超过 100ms 时自动丢弃并恢复队列。
- 6. 【光路质量体检】 周期性采集网卡
symbol_error_rate与 SFP 光模块收发光功率,光衰低于 -10dBm 时提前预防性更换。 - 7. 【NCCL 阻塞防护】 训练启动脚本统一注入
export NCCL_ASYNC_ERROR_HANDLING=1与合理的NCCL_COMM_TIMEOUT。 - 8. 【DataLoader 保护】 严格审计 PyTorch DataLoader,设置合理的超时退出保护,防止数据读盘死锁阻断分布式流水线。
- 9. 【MFU 连续看板】 实时大盘展示全集群 MFU 折线图,若 MFU 出现突发阶梯式下滑(下跌 > 5%),自动触发诊断流程。
- 10. 【秒级弹性自愈】 建立基于轻量级 Checkpoint 与热备机器池的故障切换架构,将节点损坏的集群恢复时间压至 3 分钟以内。
9. Ringi 5 点核心速记口诀、自我检验清单与课后深度思考题
9.1 5 点押韵核心速记口诀
9.2 10 条白板自我检验清单
- 能否在白板上手绘出 Step Time 三层分流金字塔,并说明每一层的排障分流逻辑?
- 解释为什么在 AllReduce 同步机制下,通信等待时间最长的 Rank 反而是“无辜受害者”?
- 列举导致慢节点(Straggler)出现的三大硬件物理诱因,以及对应的监控指标是什么?
- 简述遭遇训练无响应(NCCL Hang)时,标准化的四步排查决策树流程。
- 什么是 GPU Xid 错误?Xid 79、Xid 31 与 Xid 45 分别代表什么物理含义?哪个是致命故障?
- 在 RoCE 无损网络中,PFC 流量控制是如何由于反压扩散酿成整网死锁风暴的?
- 解释为什么说单看
nvidia-smi的 GPU-Util 利用率无法真实反映集群的算力利用水平? - MFU(Model FLOPs Utilization)的物理定义与计算公式是什么?及格线一般是多少?
- 在 Nsight Systems 时间轴中,如何一眼分辨出是“小包延迟受限”还是“网络物理带宽受限”?
- Kubernetes 设备插件(NVIDIA K8s Device Plugin)是如何通过监听 NVML 事件实现坏卡秒级隔离的?
9.3 3 道高阶开放式课后思考题(含极端 Corner Case)
思考题 1:静默数据损坏(Silent Data Corruption / SDC)与梯度毒化
在万卡集群上,如果某张 GPU 没有发生死机(没有 Xid 报错),也没有发生降频(Step Time 正常),但其内部的 Tensor Core 在执行 BF16 矩阵乘法时由于偶然的物理缺陷产生了静默计算错误(如偶尔算出的数字出现低位翻转)。这种静默数据损坏不会导致任务 Hang 住,但会导致训练的 Loss 曲线缓慢发散或梯度爆炸。思考:作为 AI Infra 工程师,你该如何设计一套低开销的在线检测与巡检机制,在不中断训练的前提下揪出这种“内鬼卡”?思考题 2:跨交换机多轨网络中的“木桶短板转移”
在一个采用 8-Rail 对齐架构的 1024 卡集群中,若某一台 Leaf 交换机上的一个 400G 端口发生了光衰降速(协商降级为 200G)。思考:这个单点降速会如何影响属于该 Rail 平面的全量节点?在结合了数据并行(DP)与流水线并行(PP)的复杂拓扑下,这种降速会表现为全网均匀变慢,还是特定 Stage 的耗时突变?思考题 3:无损网络与自适应路由(Adaptive Routing / AR)的利弊抉择
为了防止 PFC 死锁并提高带宽利用率,许多现代互联方案(如 NVIDIA SHARP、Spectrum-4、UEC)主张引入自适应路由(Packet-based Adaptive Routing),允许数据包乱序到达并在网卡重组。思考:开启自适应路由后,对接收端网卡的重组缓冲区大小(Reassembly Buffer)提出了什么要求?在极端微突发流量下,自适应路由是否会因为乱序重传而恶化 NCCL 通信?10. 📚 参考资料与核心源码/经典论文指引
- 官方权威文档与排障指南:
- NVIDIA XID Errors Official Documentation:NVIDIA 官方全量 Xid 错误代码手册与硬件诊断定义;
- NVIDIA DCGM (Data Center GPU Manager):大厂数据中心集群监控、拓扑诊断与健康排查黄金工具库;
- PyTorch Distributed Troubleshooting Guide:官方分布式超时、死锁与 Watchdog 排错体系;
- 顶会经典论文与工业界实战文献:
- “Understanding and Mitigating Stragglers in Distributed Deep Learning”:大模型分布式训练慢节点定位与成因分析奠基之作;
- “Deadlocks in Lossless Ethernet: Analysis and Prevention”:数据中心 RoCE 网络 PFC 死锁风暴与预防机制经典论文;
- “MegaScale: Scaling Large Language Model Training to More Than 10,000 GPUs” (NSDI 2024, ByteDance):万卡智算集群稳定性保障、监控与秒级故障自愈实战经验总结;
- AI_BOOK 本地一手知识库对照出处:
- 🏛️ AI_BOOK / AI-fundamentals / 03_ai_cluster_ops / 01_gpu_ops / 06_gpu_health_check.md:8-GPU SXM4 真实集群三级健康检查全流程;
- ⚡ AI_BOOK / AI-fundamentals / 03_ai_cluster_ops / 01_gpu_ops / 08_gpu_driver_troubleshooting.md:GPU 驱动故障与内核态 Xid 错误深度速查;
- 🗺️ AI_BOOK / AI-fundamentals / 03_ai_cluster_ops / 03_nccl / 05_nccl_debug_output.md:NCCL Debug 逐行输出解密与通信死锁追踪底账。
附录:Appendix A — 大厂硬核高频面试题与白板推导(Interview Drill)
Drill 1:在线上 1024 卡训练任务中,如何利用“逆向倒挂法则”在 1 分钟内定位慢节点?
考察重点:
深入考察候选人是否具备超大规模智算中心的真实排障实战直觉,能否透过复杂的集合通信同步表象,秒级揪出降频拖垮全网的慢卡。标准参考答案:
- 揭示表象误区:
- 在分布式集合通信(如 AllReduce)中,所有 Rank 必须等待最后一个成员到达同步屏障才能完成数据归约;
- 因此,正常的卡由于算得快,早早进入通信阶段等待,表现为通信耗时极长(如 50ms);
- 而慢节点由于自身计算拖慢,当它终于算完进入通信时,全网数据立刻就绪,其通信耗时几乎为 0ms;
- 一分钟逆向定位三步法:
- 第 1 步(耗时指标倒挂排查):拉取全集群各卡在当前迭代的耗时指标,寻找 “计算耗时最大值(Max Compute)”与“通信等待最小值(Min Comm Wait)”交汇的 Rank;
- 第 2 步(时钟频率横向比对):通过 DCGM 提取该 Rank 的
clocks.current.sm;如果全网正常卡都在 1830 MHz,唯独该卡处于 1100 MHz 左右,且伴随Thermal Slowdown标记,铁证如山,直接锁定为慢节点; - 第 3 步(隔离止血):通知调度器将该节点从当前运行拓扑中摘除,使用热备节点替换,恢复集群正常步长。
Drill 2:推演从捕获 Xid 79 到 Kubernetes 自动完成 Pod 隔离漂移的完整工业链路
考察重点:
考察候选人对云原生 AI 平台(Cloud-Native AI Platform)、K8s Device Plugin 与硬件底层联动的系统级全链路工程认知。标准参考答案:
完整的工业自愈闭环经历以下六个阶段:- 硬件发生物理异常:GPU 供电故障或 PCIe 总线断开,NVIDIA 驱动捕获到硬件中断丢失,向 Linux 内核写日志:
NVRM: Xid (PCI:0000:4c:00): 79, GPU has fallen off the bus; - 节点问题探测器(NPD / DCGM)上报:部署在宿主机上的 Node-Problem-Detector 守护进程通过
/dev/kmsg捕获到 Xid 79 事件,或 DCGM Exporter 抛出DCGM_FR_GPU_FALLEN_OFF_BUS严重异常; - K8s 节点污点标记(Cordon & Taint):节点健康控制器监听到异常,瞬时向该 Kubernetes Node 打上污点:
node.kubernetes.io/gpu-unhealthy=true:NoSchedule,同时将其标记为不可调度(Cordon),防止新任务派发至坏卡节点; - 训练引擎优雅熔断:PyTorch 分布式通信进程感知到目标卡通信无响应,触发
c10dWatchdog 超时;训练主进程捕获中断信号,快速保存最近一次完整的 Checkpoint 元数据至全局分布式存储(如 3FS / Lustre); - 容器主动驱逐与重新编排:训练调度器(如 Volcano 或 Kubeflow Training Operator)销毁挂死容器,向调度队列重新申请一组健康的 GPU 资源;
- 热备替换与冷启动恢复:调度器从预留的热备节点池(Hot Standby Nodes)中借调一台健康物理机,挂载历史 Checkpoint,重启分布式训练,整个自愈流程在 3 分钟内全自动闭环。
Drill 3:为什么说 RoCE 网络的 PFC 死锁比丢包更致命?如何通过 ECN 和 Watchdog 防御?
考察重点:
考察候选人对数据中心无损以太网(Lossless Ethernet)协议栈深层冲突的理解深度,以及工业界针对拥塞控制的调优经验。标准参考答案:
- 为什么 PFC 死锁比丢包更致命?
- 丢包的代价是可控的:当网络拥塞发生丢包时,尽管 RDMA 会产生重传开销,但网络本身依然具备转发能力,其他无关联端口的任务依然能正常推进;
- PFC 死锁是全网瘫痪:PFC 依靠反压机制强制上游暂停发包。在复杂的网络环路(如多路径 ECMP 或 Clos 拓扑)中,Pause 帧会像雪崩一样逆向扩散,最终形成首尾相接的有向等待闭环;
- 一旦死锁形成,所有交换机队列全部被死死冻结,整网吞吐瞬间跌至 0,且永远无法自我恢复,只能依赖人工硬重启交换机!
- 工业防御与治理体系:
- 第一道防线:ECN(显式拥塞通知)先发制人:在交换机队列尚未填满、尚未达到 PFC Pause 触发阈值之前,提前在数据包 IP 报头打上 CE 标记;接收端收到后回发 CNP 报文,促使发送端网卡主动降速,在拥塞演变为暂停前就化解危机;
- 第二道防线:PFC Watchdog(死锁看门狗)强制熔断:交换机内部配置 PFC Watchdog 监测机制;当某个端口的连续处于 Pause 状态的时长超过阈值(如 100ms),判定发生死锁,看门狗强制破除死锁循环,直接丢弃该队列的积压数据包并恢复转发,宁可承受丢包重传,也绝不容忍整网死锁!