🏛️ 第19讲:时空折叠的艺术——Compute-Communication Overlap 深度剖析(CUDA Stream 异步机制、DDP 分桶、Chunk 细粒度流水线与 Warp Specialization 硬件解耦)
主讲人:👓 Ringi(大厂 AI Infrastructure 工程师)
所属模块:Module 01: GPU 硬件架构、数据搬运、集群通信与 Overlap
篇章范式:⚡ 系统并发与流水线工程篇(Concurrency & Pipeline Engineering Paradigm)
核心导读:
在分布式大模型训练的工程调优中,我们经常听到一句话:“把通信藏进计算里”。许多初入行的工程师误以为只要在 PyTorch 里加上一句async_op=True,或者把通信函数塞进独立的torch.cuda.Stream,通信时间就会像魔术一样凭空消失。
现实却极其骨感——当你满怀信心地抓出一张 Nsight Systems 时间轴时,往往会遭遇当头一棒:要么通信算子在时间轴上依然与计算 Kernel 串行排队;要么两者看似在时间上并发了,但原本只要 20 毫秒的矩阵乘法(GEMM)被活活拖慢到 32 毫秒!更离谱的是,全集群的单步耗时(Step Time)不仅没降,反而因为缓存污染和带宽踩踏暴增了 25%!
为什么异步调用(Async)绝不等于物理重叠(Overlap)?DDP 内部经典的 25MB 梯度分桶(Gradient Bucketing)到底是如何在纳秒级平衡网络延迟与流水线机会的?FSDP 是如何在仅保存 权重的苛刻显存约束下,通过双向预取实现“零暴露通信”的?计算与通信并发时,底层的 SM 核心、L2 Cache 和 HBM 带宽究竟是如何产生血腥争抢的?现代体系结构又是如何通过 Warp Specialization 走向 SM-free 的终极硬件解耦的?
本讲我们将化身系统外科医生,彻底撕开“时空折叠”的黑盒:建立严密的暴露通信第一性原理,拆解从框架层到芯片微架构的四级流水线,量化争抢惩罚因子,并交付一套真正可落地的 Overlap 性能工程兵法!
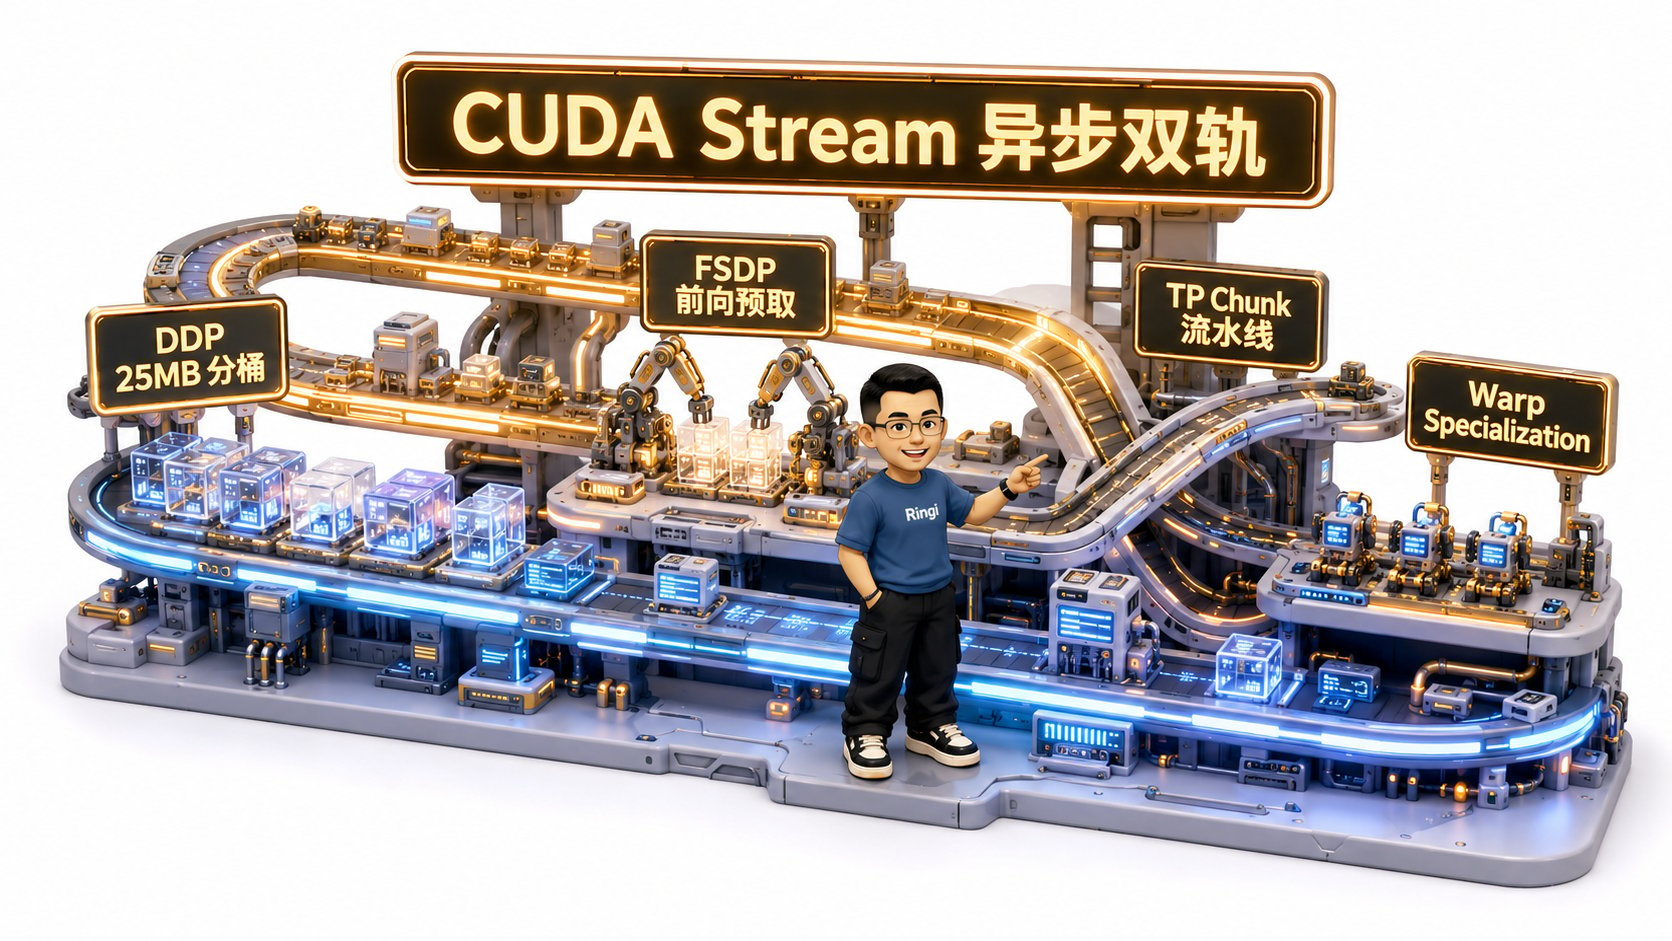
📑 目录导航
- 0. Ringi 开场:生产真实现场与痛点冲突
- 1. 软件栈与物理铁律:Async 绝不等于 Overlap
- 2. 数据并行基石:DDP 梯度分桶(Gradient Bucketing)全流程解密
- 3. 显存折叠飞跃:FSDP / ZeRO-3 双向预取流水线(Prefetch & Overlap)
- 4. 张量并行精细化:Megatron-LM TP Comm Overlap 与 Chunk 细粒度流水线
- 5. 隐形刺客:Overlap 资源争抢惩罚因子模型( )
- 6. 硬件解耦革命:Hopper / Blackwell Warp Specialization 与 SM-free 演进
- 7. 动手实战与代码实验室(Minimal Runnable Code)
- 8. Ringi 避坑指南与生产性能工程黄金 Checklist
- 9. Ringi 5 点核心速记口诀、自我检验清单与课后深度思考题
- 10. 📚 参考资料与核心源码/经典论文指引
- 附录:Appendix A — 大厂硬核高频面试题与白板推导(Interview Drill)
0. Ringi 开场:生产真实现场与痛点冲突
0.1 真实工程灾难:为什么加了 async_op=True,训练 Step Time 却纹丝不动甚至更慢了?
在某大厂 130B 大语言模型的预训练调试现场,一位算法同学满头大汗地找到架构组:
“我们在通信代码里显式加上了 dist.all_reduce(..., async_op=True),并且创建了独立的 torch.cuda.Stream,把通信发射移到了下一个 GEMM 之前。按理说,通信时间有整整 35 毫秒,计算时间有 45 毫秒,只要重叠起来,暴露通信时间归零,每步耗时应该直接从 80 毫秒降低到 45 毫秒!”
“但实测结果让人崩溃:Step Time 不仅丝毫没降,依然是整整 82 毫秒!更诡异的是,原本只占 45 毫秒的前向 GEMM 计算,在时间轴上生生被拉长到了 58 毫秒!”
- 隐式同步屏障(Implicit Sync Barrier):算法同学在异步通信发出后,下一行不经意地执行了一句
loss.item()(为了打印日志),这一行直接触发了 CPU 对 GPU 全队列的阻塞式同步,强制等待通信完成! - 显存总线大撞车:通信采用的 NCCL Kernel 启动了多个 Thread Block,与前向计算里的 LayerNorm 访存算子同时抢占 HBM 物理控制器,导致显存访问严重拥塞,两败俱伤!
0.2 线上真实事故复盘:某百亿模型开启全量异步通信后遭遇“L2 冲刷与带宽踩踏”,总耗时暴增 25%
再看一起大厂千万级日活业务上的经典事故: 工程师在尝试对一个 MoE 模型的 All-to-All 算子进行异步重叠时,粗暴地将通信与主干网络的 RMSNorm 及 Attention 算子拉平发射。 上线后,分布式集群的整体 MFU(Model FLOPs Utilization)从 42% 暴跌至 31%,Step Time 恶化了整整 25%。0.3 分布式并行体系与 Overlap 流水线机制全景速查表
在不同的并行范式中,Overlap 的设计粒度与实现手段截然不同:1. 软件栈与物理铁律:Async 绝不等于 Overlap

1.1 CPU Host 非阻塞发射与 GPU Device 物理并发的时空断层
要搞清 Overlap,首先必须斩断对“异步”的迷信。 在 CUDA 编程模型中,所有向 GPU Stream 发射的 API 调用,默认对 CPU Host 而言都是“异步”的:1.2 真正实现物理 Overlap 的三大硬件铁律
要让 GPU 硬件在空间和时间上真正实现“边炒菜边备菜”,必须同时满足以下三大物理铁律。哪怕违背其中半条,GPU 调度器都会无情地将操作降级为串行:铁律 1:独立发射流(Independent CUDA Streams)
- 计算 Kernel 必须发射在计算流(如
compute_stream); - 通信 Kernel(NCCL 队列)必须发射在专用的通信流(如
comm_stream); - 硬件层面的两组不同 Work Queue 才能被并发推送到 GPU 的硬件调度引擎中。
铁律 2:零前序数据依赖(Zero Forward Data Dependency)
- 正在进行物理通信的 Tensor,绝对不能是当前并发计算 Kernel 的输入或输出!
- 如果计算 Kernel 试图读取一个正在被 RDMA DMA 写入的缓冲区,CUDA 必须插入硬件屏障(Memory Dependency Barrier),强制挂起计算流,直到通信写入完全落盘!
铁律 3:硬件物理资源未饱和(Physical Resources Non-Saturated)
- SM 核心未占满:如果计算 GEMM 的 Grid Size 巨大,把 GPU 所有的 SM 核心(如 H100 的 132 个 SM)和寄存器文件全部打满(Occupancy 100%),NCCL 的通信 Block 将因无处安放而被推迟调度;
- 总线通道未打满:如果并发的两个算子都极度饥渴地索取 HBM 显存带宽,物理控制器将发生严重的排队仲裁。
1.3 暴露通信时间(Exposed Communication Time)第一性原理推导(No Naked Formula 2.0)
1. 为什么需要算它?
分布式系统的端到端吞吐,取决于通信耗时中有多少是赤裸裸暴露在关键路径上的(Exposed)。我们的目标不是消灭通信物理时间,而是将暴露通信时间压缩至零!2. Mental Model(物理直觉比喻):
你点了一份外卖(通信耗时 ),同时你开始在家里打扫房间(计算耗时 ):- 如果你一边打扫一边等外卖,只要外卖在打扫结束前送到,你感觉到的额外等待时间就是 0!
- 如果打扫完了外卖还没到,你坐在沙发上无聊刷手机干等的时间,就是暴露时间(Exposed Time)!
3. Tiny Calculator(极简数字小算盘):
- 情况 A:计算耗时 ,通信耗时 。
- 暴露通信时间:
- 总耗时: (通信完全隐形!)。
- 情况 B:计算耗时 ,通信耗时 。
- 暴露通信时间:
- 总耗时:
4. Formal Model(标准形式化公式):
单步执行总时间(Step Time)的通用数学模型为: 其中,暴露通信时间定义为: 如果考虑到资源争抢惩罚因子 (第 5 节将深度推导),实际总时间将被修正为:2. 数据并行基石:DDP 梯度分桶(Gradient Bucketing)全流程解密
2.1 为什么逐层 AllReduce 会沦为“小包延迟地狱”?
在最朴素的数据并行实现中,模型拥有数百甚至上千个参数张量(LayerNorm 权重、Bias 偏置、线性层权重等):- 如果反向传播每算出一个参数的梯度,就立刻发射一次
dist.all_reduce(param.grad); - 灾难降临:一个 7B 模型可能拥有超过 300 个小参数张量(很多只有几 KB 或几十 KB)。每一次 AllReduce 都必须经历网络底噪 (约 )以及 GPU Kernel 启动开销(约 );
- 300 次独立通信的静态底噪开销累计超过数毫秒,网络带宽利用率不足 5%,整个反向传播彻底被小包通信撕裂!
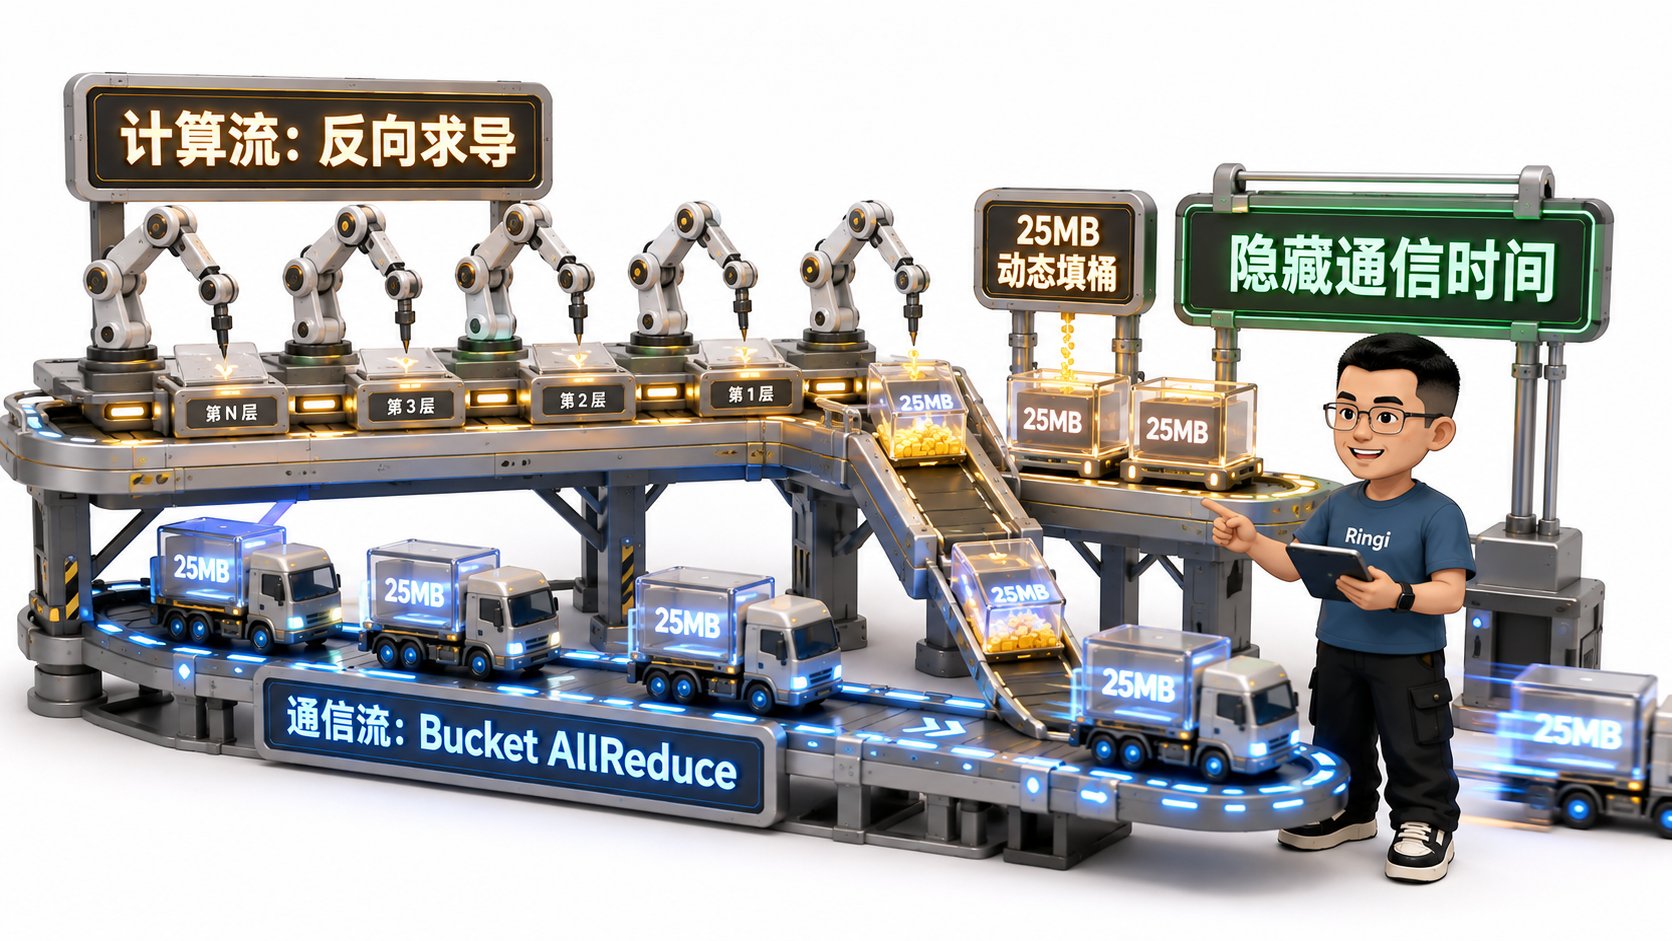
2.2 Mental Model:超市结账时的传送带与打包箱
- 逐层通信(无分桶):顾客每拿出一盒口香糖,收银员就叫快递员单独打包送一次,快递员来回跑断腿,运费(时延)比商品本身还贵;
- DDP 梯度分桶(Gradient Bucketing):收银台放着标准容量的打包箱(默认 25MB)。顾客一边扫描商品,一边往箱子里塞;一旦这个箱子装满了 25MB,立刻封箱贴单交给快递员送走;与此同时,收银员继续扫描下一个箱子的商品!
2.3 Tiny Calculator:3 层模型 6 个参数梯度按序落桶与通信触发手算
让我们用一个微型 3 层神经网络、共 6 个参数张量进行手算演练(设 DDP Bucket 阈值为 10MB):动态落桶与流水线状态推演:
2.4 为什么默认桶容量是 25MB(bucket_cap_mb=25)?网络启动时延 与反向流水线重叠机会的黄金平衡点
PyTorch DDP 经过数年的工业界演进,将默认的 bucket_cap_mb 固定在 25MB。这个数字绝非凭空臆造,而是两大物理矛盾碰撞妥协的极限平衡点:
2.5 DDP 内部状态机:Bucket Ready ➔ Async AllReduce ➔ 梯度就绪通知
在 PyTorch 底层的c10d 模块中,DDP 通过 Hook 机制实现了一个高效的状态机:
3. 显存折叠飞跃:FSDP / ZeRO-3 双向预取流水线(Prefetch & Overlap)
3.1 FSDP 的痛点:显存仅存 ,每一层计算前必须现拉权重
在 ZeRO-3 和 PyTorch FSDP(Fully Sharded Data Parallel)中,为了在有限显存中塞下数百亿参数,每张 GPU 仅保存模型权重的 。 这带来了一个巨大的工程挑战:- 在前向计算第 层之前,GPU 必须先在网络上通过
AllGather收集齐该层其余 个分片; - 如果完全串行排队:
AllGather(Layer 0) ➔ Compute(Layer 0) ➔ AllGather(Layer 1) ➔ Compute(Layer 1) ... - 训练过程将陷入漫长的“等数据、算一下、再等数据”的卡顿死循环,MFU 将跌至 20% 以下!
3.2 前向预取流水线(Forward AllGather Prefetch):在计算 Layer 时,通信流异步拉取 Layer
FSDP 的破局之道是构建精密的 前向预取流水线(Prefetch Pipeline):3.3 反向双流交织(Backward ReduceScatter Overlap):反向梯度计算与上一层梯度归约的并行推进
反向传播更为复杂,它必须同时驾驭两组截然相反的通信流:- 反向权重预取(Backward AllGather):反向传播是倒着算的,算 Layer 时需要预取 Layer 的权重;
- 反向梯度归约(Backward ReduceScatter):Layer 算完局部梯度后,必须通过
ReduceScatter将梯度累加并均分回各卡,随后立刻在显存中将全量梯度释放!
3.4 显存换通信的极限:为什么预取不能跨太多层?预取缓冲区与峰值显存膨胀的控制
很多工程师会产生一个幼稚的想法:“既然预取这么好,为什么不一口气把后面 5 层的权重全部预取出来,彻底杜绝通信等待?” 答案是:显存预算会瞬间被打爆!- 预取出来的完整权重必须保存在 GPU HBM 中;
- 如果预取深度为 1(默认):同一时刻显存中只多驻留 1 层的全量参数;
- 如果预取深度为 4:显存中必须同时驻留 4 层的全量参数与对应的反向激活值,瞬间抵消了 FSDP 节省显存的初衷,直接导致 OOM(Out of Memory)!
- 工业界的准则是:严格维持预取深度为 1,最多不超过 2!
4. 张量并行精细化:Megatron-LM TP Comm Overlap 与 Chunk 细粒度流水线
4.1 TP 处于计算关键路径的死结:ColumnParallel 与 RowParallel 内部的硬性通信屏障
在 Megatron-LM 的张量并行(Tensor Parallelism,TP)中,Transformer 的每一层都被切开:- MLP 模块:
ColumnParallelLinear(无通信) ➔ 激活函数 ➔RowParallelLinear➔ AllReduce(或 ReduceScatter); - Attention 模块:QKV 投影 ➔ Self-Attention ➔ Out-Projection ➔ AllReduce(或 ReduceScatter)。
在过去,必须等矩阵乘法完全算完,才能做 AllReduce;AllReduce 不结束,后面的层根本无法启动,暴露通信比例高达 30%~40%!
4.2 Sequence 维度切分:将 Batch/Seq 划分为 个微块(Chunks)
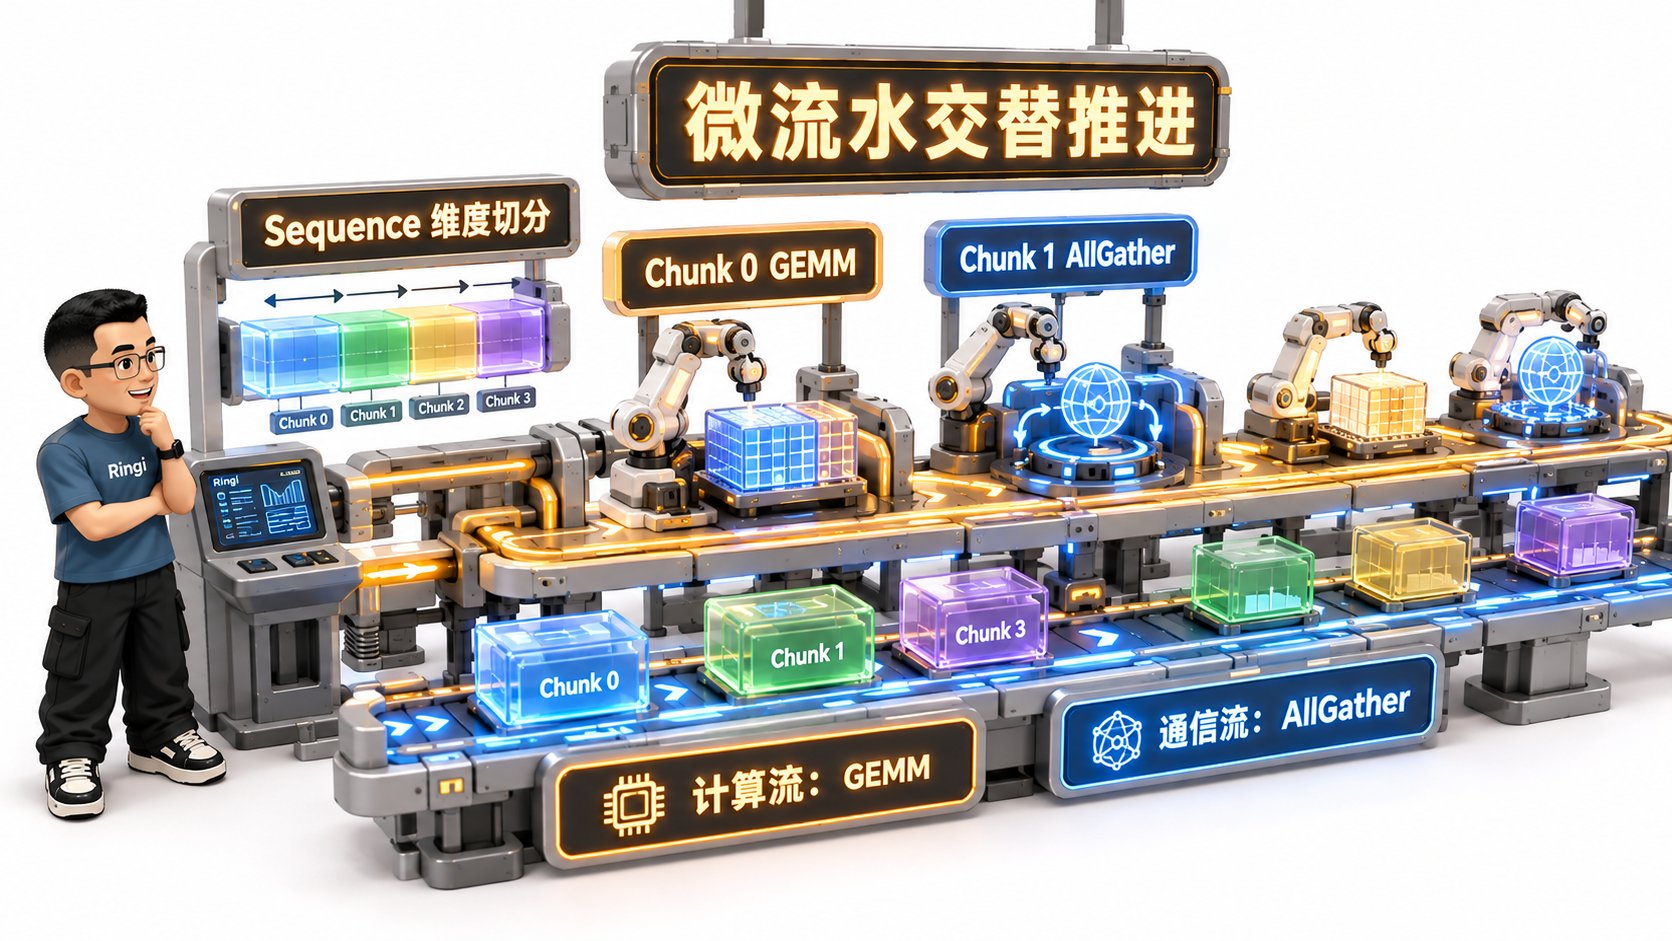
为了破解 TP 的关键路径死结,Megatron Core 引入了 TP Comm Overlap(Chunk 微流水线):- 第一性原理切入点:矩阵乘法 在行维度上是完全解耦的!
- 将输入的激活值张量按照 Sequence(或 Batch)维度均匀切分为 个分块(通常 或 ):
4.3 Chunked GEMM + ReduceScatter / AllGather 交叉流水线(Gemm 与 Comm 重叠)
切分后,计算与通信被重新编排为交错并行的精美微流水线:4.4 CUDA Graph 与 User-Defined Overlap 在微秒级调度上的收益
在微秒级高频通信的 TP 场景中,CPU Launch 的开销会成为严重瓶颈。工业界通常结合 CUDA Graph:- 把 Chunked GEMM 与异步通信的整个 DAG 图捕获(Capture)为单一切片;
- 由 GPU 硬件执行引擎以纳秒级时钟连续分发,将调度开销彻底清零!
5. 隐形刺客:Overlap 资源争抢惩罚因子模型( )
5.1 为什么并发后的耗时不是 ?
初学者在画甘特图时,总是习惯性地写下: 但在真实的 GPU 芯片上,实测总耗时总是令人沮丧地大于理论值。这背后的隐形刺客就是硬件资源冲突带来的惩罚因子(Penalty Factor ):5.2 争抢冲突点 1:SM 计算单元与 NCCL 通信 Kernel 的夺核之争
- 真相:NCCL 并非无影无形的硬件幽灵,它的底层是一个个实实在在的 CUDA Kernel(例如
ncclKernel_AllReduce_RING_LL128); - 夺核:NCCL 默认需要创建 16~32 个 Channel,每个 Channel 霸占 GPU 的一个完整 SM 核心;
- 在只有 108 个 SM 的 A100 上,通信直接吃掉了 近 20% 的 SM 核心!原本可以全速运行计算 Warp 的硬件资源被强行剥夺。
5.3 争抢冲突点 2:L2 Cache 污染——巨量通信 DMA 流量冲刷 GEMM 热点缓存行
- 高性能 GEMM 能够逼近理论算力峰值的前提,是输入矩阵的 Tile 能够在 L2 Cache 中被反复读取复用;
- 当后台通信流以数百 GB/s 的速率通过 PCIe/NVLink 往 HBM 倾泻数据时,海量数据流经片上 Crossbar,会触发激进的 L2 缓存行驱逐机制;
- GEMM 的热数据被冷酷冲刷出 L2,迫使计算单元频频发生 L2 Cache Miss,进而产生流水线停顿(Stalls)。
5.4 争抢冲突点 3:HBM 物理带宽饱和——算术强度(AI)决定惩罚因子
这是决定惩罚因子 大小的决定性物理法则!它严格受制于当前算子的 算术强度(Arithmetic Intensity, ):5.5 惩罚因子的数学建模与生产评估公式
大厂性能工程团队将惩罚因子建模为并发访存强度的连续函数:- 当算子算术强度 (如超大 GEMM), ;
- 当算子算术强度低且通信吞吐极高,惩罚项急剧发散,甚至会导致 Overlap 后的耗时反超纯串行耗时!
6. 硬件解耦革命:Hopper / Blackwell Warp Specialization 与 SM-free 演进
6.1 从“软件调度争抢”到“硬件角色特化”的范式跃迁
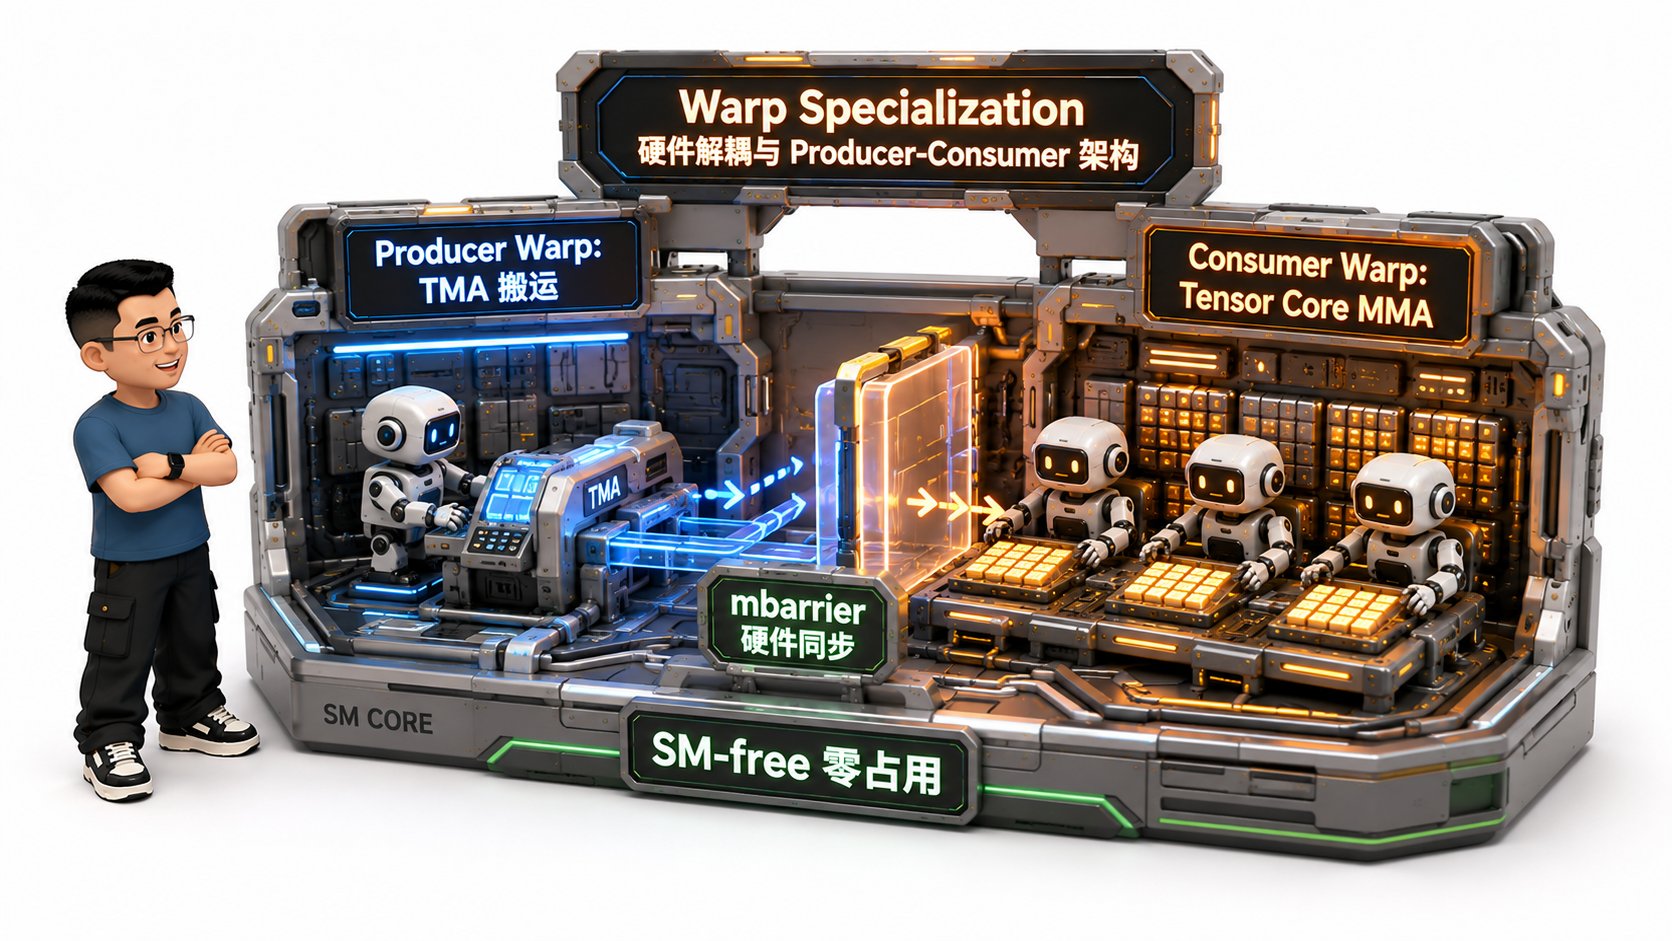
在 Ampere(A100)及以前,同一个 SM 内的所有 Warp 都在浑浑噩噩地轮流执行搬运指令与计算指令,由于缺乏专职分工,无法在硬件层面彻底消除争抢。 从 Hopper(H100) 开始,NVIDIA 推出了革命性的 Warp Specialization(线程束专业化) 体系结构,将通算重叠推向了物理极限!6.2 Warp Group 任务特化:1 个 Producer Warp + 3 个 Consumer Warps 的协同舞蹈
在 Hopper SM 的一个 128 线程(Warp Group)内部,硬件执行了绝对的角色特化:6.3 硬件级同步基石:mbarrier 硬件屏障与 TMA 异步搬运
- TMA(Tensor Memory Accelerator):
- 独立的硬件协处理器,直接在 Global Memory(HBM)与 Shared Memory 之间建立高速通道;
- 搬运过程完全绕过 SM 的寄存器堆,实现真正的 SM-free 数据搬运!
mbarrier(Memory Barrier 硬件对象):- SM 芯片内部集成的硬件原子计数器;
- Producer Warp 发射 TMA 后立刻声明阶段期望(Arrive);TMA 硬件在后台自动递减计数器;
- Consumer Warp 只需轮询
mbarrier.wait,一旦数据到位,硬件中断瞬时唤醒 Tensor Core 投入战斗!
6.4 Green Context 与 Cooperative Persistent Block 资源隔离方案对比
在超大规模分布式通信(如 DeepSeek-V3 MoE 的 DeepEP 引擎)中,针对如何将用于通信的 SM 与计算 SM 进行物理隔离,工业界形成了两派经典方案:7. 动手实战与代码实验室(Minimal Runnable Code)
本节提供 4 个可以直接在本地完整运行并打印清晰结果的 Python 实验,彻底把 Overlap 的并发、分桶、惩罚因子与流水线剥开揉碎!7.1 实验 1:多 CUDA Stream 异步并发与数据依赖排队验证
本实验对比串行、伪异步(因同步操作阻塞)与真重叠三种模式的时间消耗与暴露通信:7.2 实验 2:DDP 梯度分桶与暴露通信时间仿真器
本实验模拟全模型 500MB 梯度在反向传播期间,桶容量从 1MB、25MB 到 500MB 时暴露通信时间的演变轨迹:7.3 实验 3:计算-通信并发资源争抢(Penalty Factor )测定实验
本实验定量重现“朴素无脑 Overlap 导致性能倒退”的硬件现场,对比计算密集与访存密集场景下的惩罚因子差异:7.4 实验 4:Chunk 流水线微重叠算法模拟
本实验模拟张量并行(TP)中将全量矩阵按 Sequence 维度切分为 个 Chunk 时的流水线收益:8. Ringi 避坑指南与生产性能工程黄金 Checklist
8.1 避坑表格(❌ 常见小白误区 vs ✅ 大厂 AI Infra 正解)
8.2 生产 Overlap 性能调优黄金十条 Checklist
- 1. 【独立流发射】 确认通信任务(NCCL 调用)运行在与前向/反向计算完全隔离的专用
torch.cuda.Stream上。 - 2. 【严防隐式同步】 严格审查训练主循环,彻底杜绝在 Step 内部调用
tensor.item()、tensor.cpu()或无屏障的print()。 - 3. 【DDP 分桶校验】 检查
torch.nn.parallel.DistributedDataParallel的bucket_cap_mb参数,维持在 25MB 左右黄金区间。 - 4. 【FSDP 预取保护】 开启 FSDP 前向与反向预取(
forward_prefetch=True),并确认预取深度不超过 1 层以防 OOM。 - 5. 【关键路径避让】 严禁在 Attention Softmax、LayerNorm 或 RMSNorm 执行期间发射大包跨机通信,保护 HBM 物理带宽。
- 6. 【TP Chunk 调优】 在 Megatron-LM 张量并行中启用
tp_comm_overlap,推荐切片数配置为 ,并配合 CUDA Graph 消除开销。 - 7. 【Nsight 空间审查】 周期性导出 Nsight Systems
.nsys-rep,展开 CUDA Streams 查看计算流与通信流是否有垂直时间重叠。 - 8. 【SM 占用审计】 检查 NCCL 通信通道数(
NCCL_MIN_NCHANNELS),避免通信 Kernel 占用过多 SM 导致 GEMM 算力饥饿。 - 9. 【Hopper TMA 使能】 在 H100 集群上确认底层算子采用 Warp Specialization 架构,通过硬件 TMA 引擎卸载搬运开销。
- 10. 【MFU 闭环核对】 开启 Overlap 后,对比单步 Step Time 与模型 MFU(Model FLOPs Utilization),确保净收益为正。
9. Ringi 5 点核心速记口诀、自我检验清单与课后深度思考题
9.1 5 点押韵核心速记口诀
9.2 10 条白板自我检验清单
- 解释为什么 CPU 端的异步非阻塞调用(Non-blocking Launch)不等于 GPU 端的物理并发重叠(True Overlap)?
- 真正实现物理级 Compute-Communication Overlap 必须同时满足哪三大硬件约束?
- 在公式 中,如何理解“暴露通信时间”的物理意义?
- DDP 的梯度分桶机制(Gradient Bucketing)为什么能有效降低网络通信开销?
- 为什么 DDP 默认将桶容量设为 25MB,而不是 1MB 或 1GB?请分别分析设太大与设太小的弊端。
- FSDP 的前向预取(Forward Prefetch)是在什么时间点、通过什么机制拉取下一层权重的?
- 为什么 FSDP 的预取深度通常限制为 1,而不能提前把整个模型的权重全部预取到显存中?
- 解释为什么在 LayerNorm / Softmax 期间并发通信会导致总耗时暴增(从算术强度 AI 与 HBM 带宽角度分析)?
- 什么是争抢惩罚因子 ?为什么实际并发耗时往往大于 ?
- 简述 Hopper 架构中 Warp Specialization 的工作机理,Producer Warp 与 Consumer Warp 分别承担什么角色?
9.3 3 道高阶开放式课后思考题(含极端 Corner Case)
思考题 1:非对称执行时间下的动态分桶(Dynamic Bucketing)
在超深的大模型(如深度达 120 层的 MoE)中,底层 Transformer 层的反向传播耗时往往明显短于顶层(因为顶层可能包含复杂的 Loss 与多头路由计算)。此时固定 25MB 的静态分桶策略会导致在底层时计算速度快于通信速度,产生通信暴露;而在顶层时计算等待分桶填满,产生计算气泡。思考:能否设计一种根据各层实测反向时间动态调整 Bucket 容量的自适应调度算法?其工程代价是什么?思考题 2:Blackwell NVL72 机架级单域下的 NVLink Overlap 范式跃迁
在 NVIDIA GB200 NVL72 机架架构中,72 张 GPU 通过全互联 NVLink 组成了一个拥有 130 TB/s 双向互联带宽的超大单域。思考:当机内通信带宽逼近单卡 HBM 局部带宽的 30% 时,传统的“用计算掩盖通信”的设计哲学是否会发生逆转?我们是否需要为了通信带宽的充分享受,而主动调整矩阵乘法的分块尺寸(Tile Size)?思考题 3:流水线气泡(1F1B Bubble)与 Activation Checkpointing 的深层耦合
在流水线并行(PP)的 1F1B 调度中,每个 Stage 都在异步接收上一 Stage 的激活值并发送当前 Stage 的输出。如果模型开启了选择性重计算(Selective Activation Checkpointing),反向传播期间的计算耗时会增加约 33%。思考:重计算带来的额外计算时间,究竟是扩大了通信重叠的黄金窗口,还是加剧了显存控制器的争抢?在什么网络条件下开启重计算反而有利于提高通信隐藏率?10. 📚 参考资料与核心源码/经典论文指引
- 官方开源项目与核心源码研读:
- PyTorch c10d ProcessGroup (GitHub):深入研读
reducer.cpp中 DDP 梯度分桶与反向 Hook 状态机实现; - PyTorch FSDP (FullyShardedDataParallel):精读
_unshard.py中前向与反向 Prefetch 双流调度机制; - Megatron-LM (NVIDIA):查看
megatron/core/tensor_parallel/中 TP Comm Overlap 的 Chunk 切片实现; - DeepSeek / DeepEP (GitHub):大模型 MoE 专家并行高精通算融合源码;
- PyTorch c10d ProcessGroup (GitHub):深入研读
- 工业界奠基论文与权威架构指南:
- “PyTorch Distributed: Experiences on Accelerating Data Parallel Training” (VLDB 2020):DDP 梯度分桶与通信重叠奠基论文;
- “NVIDIA Hopper Architecture In-Depth” (NVIDIA Technical Blog):深入剖析 Warp Specialization、TMA 硬件与
mbarrier机制; - “ZeRO: Memory Optimizations Toward Training Trillion-Parameter Models” (Samyam Rajbhandari et al.):ZeRO 显存切分与预取流水线设计经典;
- AI_BOOK 本地一手知识库对照出处:
- 🏛️ AI_BOOK / GPU通信 / 从零开始的通信计算overlap【第一章】.md:Warp Specialization、Green Contexts、SM 物理层级与资源分配深度指南;
- ⚡ AI_BOOK / AIInfra / 04Train / 01ParallelBegin / 02SPTD.md:分布式训练 3D/5D 并行与通信重叠宏观设计;
- 🗺️ AI_BOOK / AI-fundamentals / 02_gpu_programming / 04_cuda_streams.md:CUDA Stream 硬件调度队列与事件同步机制底账。
附录:Appendix A — 大厂硬核高频面试题与白板推导(Interview Drill)
Drill 1:在白板上手绘 DDP 25MB 分桶在反向传播中的时间轴(Timeline),并证明其最理想状态下的暴露时间
考察重点:
深入考察候选人对 PyTorch DDP 底层调度机制的理解深度,能否用精确的时间轴图解反向计算与网络通信的双轨推进。白板解题推导过程:
- 绘制反向双轨时间轴:
- 轴 1(计算流 Compute Stream):从最后一层(Output)开始向前倒序执行反向求导计算(
d_Loss ➔ d_W3 ➔ d_W2 ➔ d_W1); - 轴 2(通信流 Comm Stream):由 DDP Reducer 内部维护的专用流,负责发射
ncclAllReduce;
- 轴 1(计算流 Compute Stream):从最后一层(Output)开始向前倒序执行反向求导计算(
- 分桶流水线阶段切分:
- :计算流计算 Layer 3 梯度,累计达到 25MB,触发 Bucket 0 Ready;
- :DDP 向通信流发射 Bucket 0 的异步 AllReduce,通信流开始在后台物理搬运数据;
- :计算流毫不等待,继续全速计算 Layer 2 梯度(累计又达到 25MB,触发 Bucket 1 Ready);
- :计算流计算 Layer 1 梯度;通信流串行完成 Bucket 0 通信后,立刻无缝衔接发射 Bucket 1;
- :全模型反向计算结束;此时只有最后一个尾部桶(Bucket Tail)可能仍在通信;
- 最理想状态暴露时间证明:
- 设全模型共有 个桶,每个桶的通信时间为 ,每个桶对应的反向计算时间为 ;
- 只要单桶计算时间满足 (计算吞吐大于通信吞吐);
- 则第 至第 个桶的通信时间均被完全重叠在下一桶的计算窗口内部;
- 最终暴露在关键路径上的通信时间,仅为最后一个桶(Bucket )的收尾通信时间:
- 相对整步数百毫秒的计算而言,暴露时间无限趋近于 0!
Drill 2:为什么 FSDP 的 Prefetch 不能无限制提前预取全模型所有层?请推导最优预取深度
考察重点:
考察候选人对分布式系统显存-通信 Trade-off(空间换时间)的数学建模能力。标准参考答案:
- 显存物理边界建模:
- 设单层参数完全解包后的全量大小为 (字节);
- 集群卡数为 ,在 FSDP 中,单卡仅驻留分片权重 ;
- 若预取深度设为 (即当前计算第 层时,显存中同时保存从 到 层的全量解包权重);
- 预取引入的额外驻留显存为:
- 流水线气泡与临界深度推导:
- 设单层的纯计算耗时为 ,单层参数的 AllGather 通信耗时为 ;
- 要实现无气泡的完全重叠,所需的预取准备时间必须满足:
- 工业生产权衡(Trade-off)结论:
- 在现代高速网络(NVLink 或 400G IB)环境下,单层通信通常快于或接近单层计算(即 );
- 此时取 即可实现 的流水线隐藏;
- 若盲目将 提高至 3 或 4,显存将凭空多吃数个 GB,挤占原本用于扩大 Batch Size 或长上下文的显存空间,直接诱发 OOM;故最优预取深度恒为 。
Drill 3:在 Nsight Systems 抓取的时间轴中,如何精准判定通信与计算是否真正发生了“有效重叠”?
考察重点:
深入考察候选人对 Profiling 工具链底层时间轴指标的实战研判经验,能否识破“表面并发、实际踩踏”的假重叠。标准参考答案:
在 Nsight Systems(.nsys-rep)中,判定是否发生“有效重叠”需遵循以下四步黄金准则:
- 第一步(检查 Stream 拓扑):
- 在 CUDA GPU 轨道下展开所有 Streams;
- 观察主计算流(通常包含
volta_fp16_s884gemm或wgmma等 GEMM Kernel)与通信流(通常包含ncclKernel_AllReduce)是否在垂直时间轴上有重叠的时间区间; - 若两者处于同一 Stream,或通信流执行期间计算流出现大片空白(Gaps),判定为零重叠(完全串行);
- 第二步(检查前序与后序事件):
- 点击通信 Kernel,查看其关联的
cudaStreamWaitEvent; - 检查是否存在未解耦的前序计算事件导致通信被推迟发射;
- 点击通信 Kernel,查看其关联的
- 第三步(核心测谎:检查计算 Kernel 的执行时间膨胀率):
- 单独测量没有通信并发时,该 GEMM Kernel 的基准执行时间 ;
- 测量并发重叠状态下,该 GEMM Kernel 的实测时间 ;
- 计算膨胀比:
- 若 :说明争抢极小,为高效黄金重叠;
- 若 :说明发生了严重的 L2 缓存冲刷或 HBM 控制器争抢,属于表面重叠、实则降速的负向优化;
- 第四步(检查 SM 利用率与吞吐指标):
- 展开 GPU SM Activity 指标;在并发时间区间内,SM 活跃度应保持在饱满的平稳状态,且无高频的
Memory Throttle(显存节流警报)。
- 展开 GPU SM Activity 指标;在并发时间区间内,SM 活跃度应保持在饱满的平稳状态,且无高频的