🏛️ 第17讲:谁在敲击网卡门铃?——跨机数据搬运(CPU-controlled vs GPU-initiated RDMA、两跳聚合与 IBRC 传输调优)
主讲人:👓 Ringi(大厂 AI Infrastructure 工程师)
所属模块:Module 01: GPU 硬件架构、数据搬运、集群通信与 Overlap
篇章范式:🌐 跨机互连与控制面卸载篇(Inter-Node Communication & Control Offload Paradigm)
核心导读:
在绝大多数算法工程师的潜意识里,只要分布式集群开启了 GPUDirect RDMA(GDR),跨机通信就已经彻底旁路了 CPU,实现了“GPU 显存到远端 GPU 显存的纯硬件直通”。
然而在万卡生产集群的真实监控面板上,这一神话会被现实击得粉碎:在千亿密集型大模型(Dense DDP)训练中,网卡能轻松跑满 400 Gbps 线速;但一旦切换到 MoE(混合专家模型)或在线 Decode 推理,有效通信带宽会瞬间腰斩至不足 20 GB/s,端到端延迟暴涨 5 倍,整机数百个 SM 核心集体陷入空转!
为什么数据面明明直连了,系统却依然在延迟断崖前崩溃?
因为 GPUDirect RDMA 仅仅统一了“数据面(Data Plane)”,却将最致命的“控制面(Control Plane)”遗留在了 CPU 宿主机的泥潭中! 每一笔微小的跨机通信,依然需要 CPU 线程在主机内存中构建工单描述符(WQE),再跨越漫长的 PCIe 总线去敲响网卡的“门铃(Doorbell)”。
当海量微小数据包(如 MoE Token Dispatch、细粒度 KV 缓存交换)席卷网络时,CPU 根本来不及敲门铃!
本讲我们将彻底撕开机间通信控制面的面纱:深度推导 CPU-controlled(IBRC)与 GPU-initiated(IBGDA/NVSHMEM)的物理鸿沟,用详实的数据算盘解密 两跳聚合(Two-Hop)与一跳直达(One-Hop)在 DeepSeek-V3 风格 MoE 架构下的生死博弈,并带你深入拆解 DeepEP 是如何在单个 CUDA Kernel 内通过 Warp 级角色分工,实现 NVLink 与 RDMA 双通道极限并发的工程神迹!
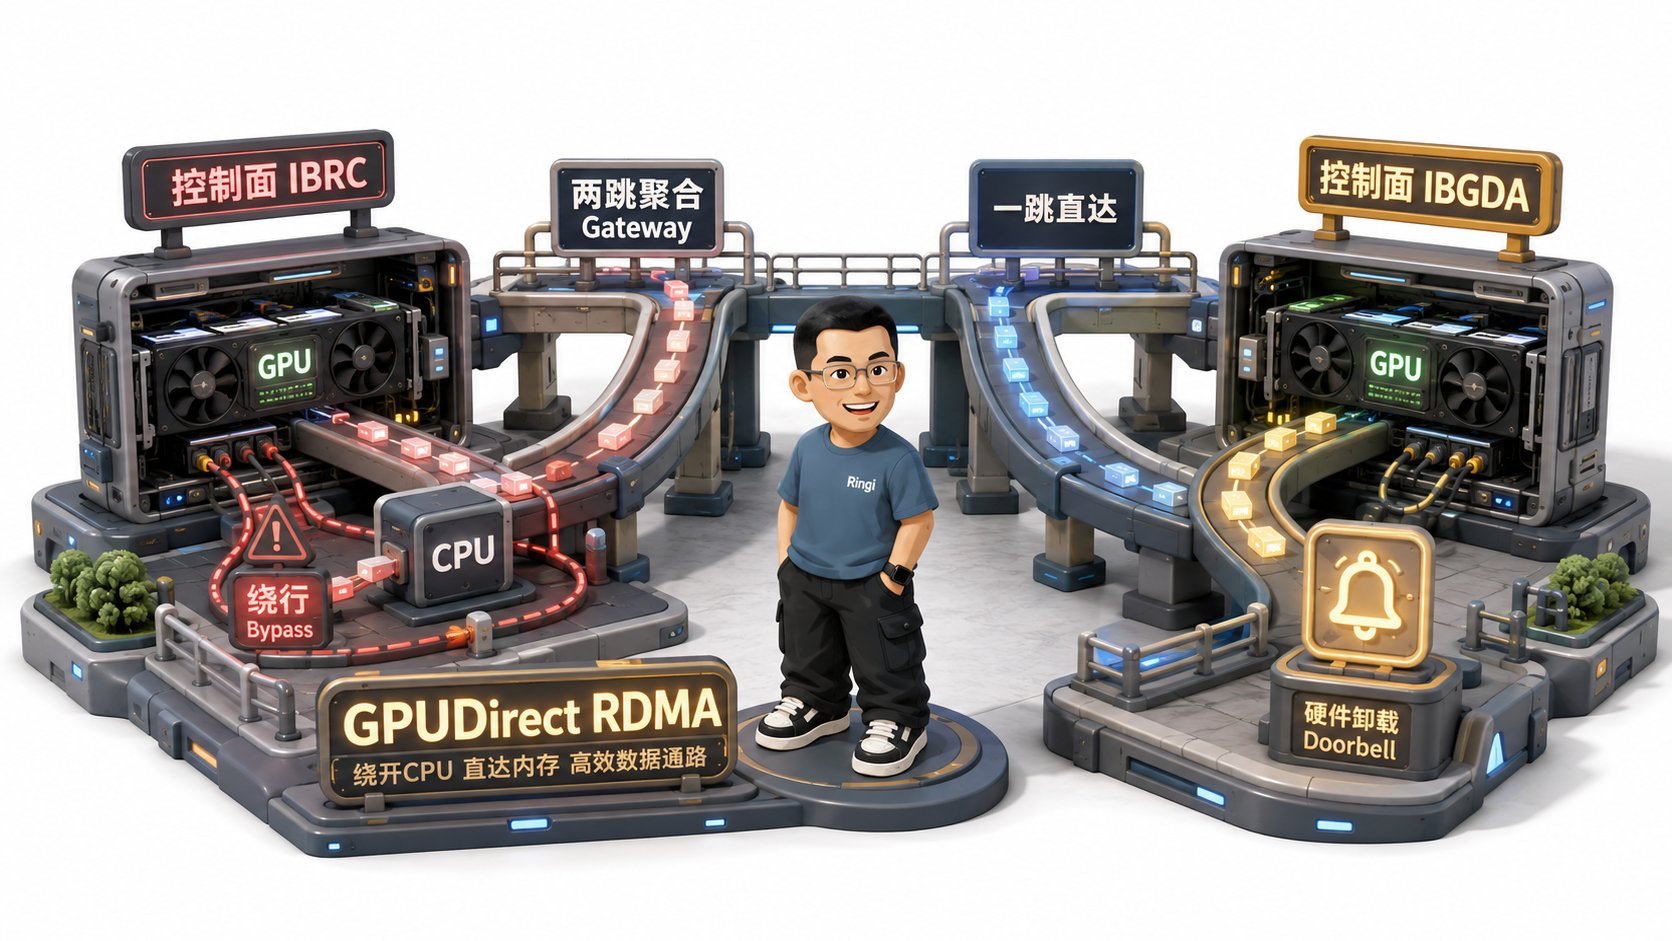
📑 目录导航
- 0. Ringi 开场:生产真实现场与痛点冲突
- 1. 控制面裂痕:GPUDirect RDMA 为什么“只统一了数据面”?
- 2. 控制面革命:GPU-initiated RDMA 与 IBGDA 核心机制
- 3. 路径之争:两跳聚合(Two-Hop)vs 一跳直达(One-Hop)架构对决
- 4. 生产级实战:DeepEP 内核实现哲学与 Warp 级角色分配
- 5. 网络协议与单边通信致命陷阱:Put+Signal Blocking 退化复盘
- 6. 拓扑诊断与硬件监控:NCCL 与 IBGDA 线上状态排查
- 7. 动手实战与代码实验室(Minimal Runnable Code)
- 8. Ringi 避坑指南与生产性能工程黄金 Checklist
- 9. Ringi 5 点核心速记口诀、自我检验清单与课后深度思考题
- 10. 📚 参考资料与核心源码/经典论文指引
- 附录:Appendix A — 大厂硬核高频面试题与白板推导(Interview Drill)
0. Ringi 开场:生产真实现场与痛点冲突
0.1 真实工程矛盾:千卡 MoE 训练为什么只有 18% MFU?全网都在等 CPU“敲门铃”
在大厂某万卡智算中心的一次真实大模型重构中,我们团队经历了这样一场惊心动魄的性能追凶: 业务团队将一套运行极其成熟的 70B Dense 稠密模型,改造成了 8 节点(64 卡)规模的 MoE(Mixture of Experts,专家混合模型,Expert Parallelism EP=64)。硬件基础设施是清一色满配的 HGX H100 8-GPU 节点,每台机器插满 8 张 400G ConnectX-7 网卡,机间网络配置了 1:1 无收敛的 3 层 Clos 胖树无损 InfiniBand 网络:- 基线期望:根据算力估算,激活参数减少后,单步迭代耗时理应从 1.2 秒压缩到 400 毫秒以下,模型浮点利用率(MFU)至少冲上 45%;
- 残忍现实:模型一上线,每步迭代耗时居然死死卡在 1.85 秒!MFU 从原来的 51% 暴跌至悲惨的 18.2%!
All-to-All Dispatch 通信算子中!
而在抓取到底层通信流水线时,我们发现了极其反直觉的一幕:
每个 GPU 正在疯狂向远端 56 个不同节点抛出极其零碎的 Token 切片(每个包仅仅只有约 100 KB)。而每一次发包,虽然数据是通过 GPUDirect RDMA 从 GPU 显存直出的,但每一次下发通信指令,GPU 都必须暂停计算流水线,向 Host CPU 发出信号;CPU 进程被唤醒,在主机内存构建 WQE 描述符,跨越 PCIe 总线敲击网卡 Doorbell 寄存器,再由网卡执行 DMA!
这就是所谓的 “控制面绞杀(Control Plane Strangulation)”:
数据面的管道虽然拓宽到了 400 Gbps,但发令枪却依然握在慢吞吞的 CPU 操作系统手中!海量碎片包的下发频率彻底压爆了 CPU 的调度极限,上千张 GPU 算力被硬生生饿死在等待 CPU 敲门铃的漫长旅途中!
0.2 线上真实事故复盘:Put+Signal 伪单边通信阻塞引发的 10μs RTT 性能雪崩
再来看一起 recorded in production 的典型网络通信死锁事故: 某个专门针对在线 Decode 推理加速的高性能网络中间件,采用了基于 RDMA 的单边通信协议(One-Sided RDMA Write)。为了实现端到端的事件通知,工程师设计了经典的 Put Data + Put Signal 流程:- 发送端向远端 GPU 显存执行 RDMA Write 搬运数据(Put Data);
- 随后发送端发送一个状态标志位,告知对端数据准备就绪(Put Signal)。
0.3 机间数据搬运四象限全景速查表(控制面维度 × 路径策略维度)
在彻底拆解硬件微架构之前,我们先把当代 AI Infra 跨机互联的四象限技术栈底账摊开:1. 控制面裂痕:GPUDirect RDMA 为什么“只统一了数据面”?

1.1 经典 CPU-controlled GDR 的致命时序缺陷:数据面直通,控制面跑断腿
要理解 GPU-initiated RDMA 的技术革命,我们必须首先看清传统 GPUDirect RDMA(GDR)的物理极限。 在第二讲中我们建立过直觉:数据总线与控制总线是两条截然不同的物理轨道。GPUDirect RDMA 宣称的“零拷贝直达”,本质上仅仅是指 DMA 数据流:网卡(RNIC)的 DMA 控制器直接通过 PCIe Switch 读取 GPU 显存中的物理页面(通过 BAR 空间映射),把数据直接扔进网络光纤。在这条路径上,数据确实没有经过 CPU 的 DDR 内存中转。 但是,谁来告诉网卡该去哪块显存搬多少数据?谁来下达搬运指令?
在传统的 InfiniBand Verbs 体系中,下达指令的权力被死死锁在操作系统内核与 Host CPU 进程手中! 仔细审视上述时序图,你会发现一个令人啼笑皆非的物理现实: 在这场耗时数微秒的通信中,真正用于网络数据搬运的只有第 5 和第 6 步!其余全部是在 CPU、PCIe 和内存之间来回空转的控制面开销!
1.2 WQE 工单下发与 Doorbell 敲击的真实硬件旅程(SM ➔ PCIe ➔ CPU ➔ PCIe ➔ NIC)
让我们把时钟拉伸到纳秒级别,拆解传统 CPU 控制型 RDMA(IBRC)发起一笔传输所经历的底层硬件搬运成本:- SM ➔ Host CPU 通知延迟( ):
- GPU 算子计算出结果后,必须在显存或 Host 内存中置位一个 Completion Flag,或者触发一个中断;
- CPU 核心通过自旋轮询(Spinning)或操作系统信号唤醒感知到该事件,白白消耗总线带宽;
- CPU 操作系统调度抖动( ):
- 现代 Linux 服务器运行着成百上千个系统线程。即使设置了 CPU Affinity 亲和性绑定,内核的上下文切换、中断打断与电源管理节电状态(C-States),也会引入高达数微秒的不可控抖动(Jitter);
- Host 内存构造 WQE 描述符( ):
- CPU 进程调用
ibv_post_send()驱动接口,在 Host DDR 内存的发送队列(SQ)中写入一个 64 字节的 WQE(Work Queue Element),详细记录远程虚拟地址、rkey、本地显存地址与数据长度;
- CPU 进程调用
- 跨 PCIe 总线敲击 Doorbell( ):
- CPU 向网卡在 PCIe 配置空间映射的物理地址发起一次 MMIO Write(内存映射 I/O 写);
- 这是一个强行同步的 PCIe TLP 事务,CPU 必须等待总线确认,时延恒定在微秒级;
- 网卡反向抓取 WQE 并启动 DMA( ):
- 网卡收到 Doorbell 后,向 Host 内存发起一次 PCIe DMA Read,把刚才 CPU 写的 64 字节 WQE 抓取到网卡片上缓存(QP Cache)中,解析后才真正启动数据搬运!
1.3 大包吞吐掩盖 vs 小包延迟窒息:为什么 DDP 感觉不到,MoE / Decode 却痛不欲生?
为什么在过去几年的深度学习大潮中,整个业界很少有人抱怨这 6 微秒的控制面开销? 答案在于 消息体量(Payload Size)的掩蔽效应。我们在第二讲中推导过通信耗时的 Alpha-Beta 模型:- 场景 A:传统 Dense 模型的 DDP / Megatron AllReduce:
- 张量并行或数据并行通常会进行梯度分桶(Bucket),每次触发通信的数据量高达 ;
- 在 400 Gbps( )的网卡上,传输 256 MB 数据所需的物理网卡串行耗时为:
- 此时控制面耗时占总通信时间的比例为:
- 结论:在千万级的大包面前,6 微秒的控制开销就像汪洋大海里的一滴水,完全被带宽瓶颈所淹没!
-
场景 B:MoE Token Dispatch 与在线推理 Decode:
- 在 MoE 专家并行中,每个 Token 经过 Gating 门控路由后,被分发给特定的专家 GPU。以批大小 Batch=8、Hidden=7168、BF16 为例,一个分发消息的大小仅为:
- 在线推理 Decode 阶段更加极端,每个生成步可能仅仅传递一个 Token( 甚至几 KB);
- 在 400G 网卡上,传输 14 KB 数据的物理纯传输时间仅需:
- 此时控制面耗时占总通信时间的比例飙升至:
2. 控制面革命:GPU-initiated RDMA 与 IBGDA 核心机制
2.1 IBGDA(IB GPU Direct Async)物理架构:把网卡 Doorbell 映射进 GPU BAR 空间
为了彻底消灭 CPU 介入这一系统级毒瘤,现代 AI Infra 架构发起了一场控制面革命:GPU-initiated RDMA(在 NVIDIA 体系下被称为 IBGDA 或 NVSHMEM)。 其第一性原理极其纯粹直白:既然数据已经在 GPU 显存里了,为什么不把网卡的“发令枪(Doorbell)”直接交到 GPU 的 SM 手里?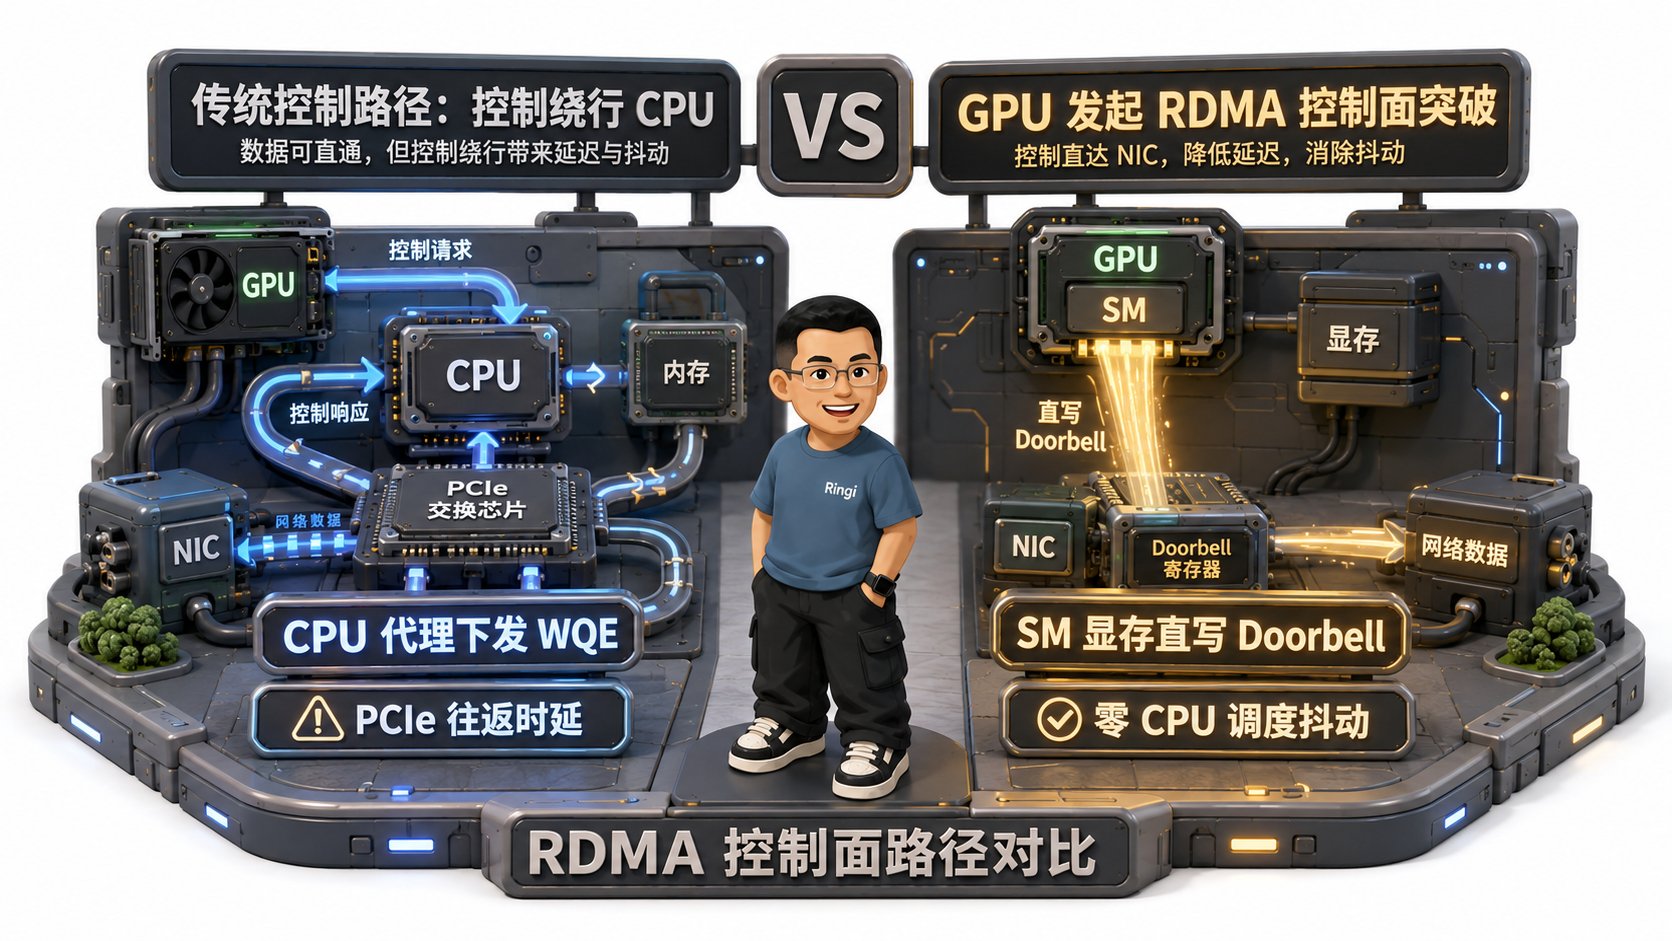
- 网卡 Doorbell 显式映射:NVIDIA 驱动通过
nv_peer_mem/nvidia-peermem模块,将 ConnectX 网卡的 UAR(User Access Region)Doorbell 物理地址,直接映射到 CUDA 上下文的虚拟地址空间中; - GPU SM 原生写入:CUDA Kernel 内部的线程可以直接对这个指针执行 64 位的强序写入指令:
- 零操作系统打扰:整个过程完全在 GPU 用户态与网卡硬件之间发生,没有任何上下文切换,没有内核系统调用,CPU 处于 100% 旁路状态!
2.2 NVSHMEM 与 PGAS(分区全局地址空间):Kernel 内直接写 nvshmem_put
在软件生态层面,直接操作裸的 IBGDA Verbs 寄存器极其晦涩且容易引发硬件死锁。为了让算法工程师能够自如运用 GPU-initiated 通信,NVIDIA 推动了 NVSHMEM(基于 PGAS 架构的高性能通信库)。
PGAS(Partitioned Global Address Space,分区全局地址空间) 为集群中所有的 GPU 显存建立了一张统一的虚拟大画卷:
- 集群中的每一张卡拥有一个全局唯一的
PE_ID(Processing Element,等同于 Rank); - 任何一张卡上的 CUDA 线程,都可以像访问本地内存一样,直接向任意远端卡上的地址发起单边读写:
2.3 GDRCopy 技术精髓:用户态低延迟显存映射与跨总线流水线
除了完整的 NVSHMEM 体系,在工程落地中还有一个经常被顶级 Infra 团队奉为神器的底层开源库——GDRCopy(A fast GPU memory copy library based on GPUDirect RDMA)。 GDRCopy 解决的是另一个极其尖锐的工程痛点:如果 CPU 确实需要极快地读写 GPU 显存里的一两个控制状态位(如检查通信完成了没有),该怎么办?- 传统方式的灾难:调用
cudaMemcpy(),一次传输哪怕只有 4 字节,也要承受 CUDA 运行时调用驱动、下发命令队列的巨大开销,单程延迟高达 10~15 微秒; - GDRCopy 的黑科技:
- 它通过内核驱动将 GPU 的特定显存页面直接映射到 CPU 用户态的虚拟地址空间,并配置为 WC(Write-Combining,写入合并) 内存属性;
- CPU 线程可以使用极速的 SSE / AVX512 向量指令直接读写这块显存,4 字节状态位的同步延迟被不可思议地压缩到了 0.5 微秒(500 纳秒)以内!
- 在很多混合通信框架中,GDRCopy 被广泛用于构建极低延迟的 CPU-GPU 跨总线无锁环形队列(Lock-free Ring Buffer)。
2.4 IBRC vs IBGDA 工业级全维度对比矩阵(WQE位置、时延、SM消耗、并发上限、容错)
我们把大模型基础设施中最核心的两种机间搬运方案摆上解剖台,进行全维度横向对齐:3. 路径之争:两跳聚合(Two-Hop)vs 一跳直达(One-Hop)架构对决
3.1 物理互联经济学:为什么 NVLink 带宽“便宜”,跨机网卡带宽“昂贵”?
探讨完控制面的革命,我们必须走向宏观的物理网络拓扑。在第一讲和第三讲中,我们推导出了智算中心最核心的物理事实——分层带宽断崖:3.2 一跳直达(One-Hop Direct):8 卡 8 网卡的全网散弹枪与 Incast 拥塞
在最朴素的分布式设计中,工程师通常倾向于选择 一跳直达(One-Hop Direct):- 既然单机 8 卡拥有 8 张独立的 400G ConnectX-7 网卡,那么每张 GPU 要给远端的任意 GPU 发送数据时,就直接调用自己的专属网卡打出去。
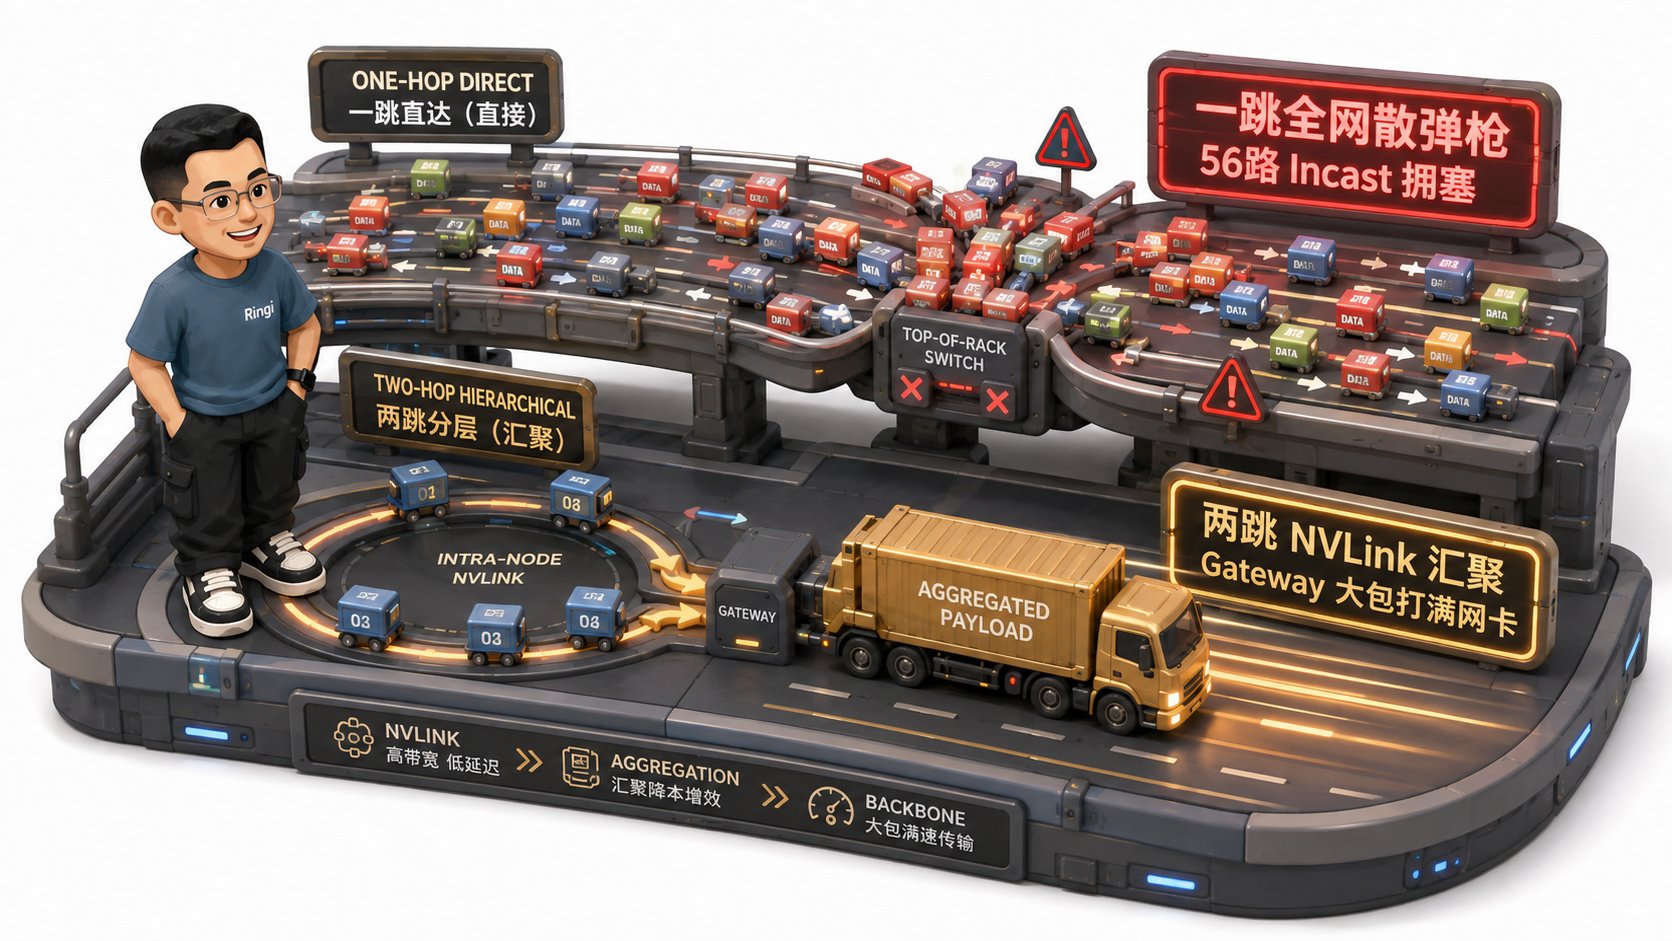
All-to-All 时,系统会瞬间遭受致命的 双重暴击:
- 网卡发包效率断崖(Per-Packet Overhead):网络硬件的物理包头封装(IP + UDP + BTH + ICRC)以及 QP 状态机轮转是有固定成本的。传输 100 KB 的小包,网卡很难进入流式 DMA 的全速状态;
- 多打一拥塞死锁(Incast Congestion):全网 64 张卡同时寻找自己的目标专家,极大概率出现几十张卡在同一瞬间向同一台机器的同一张网卡倾泻流量!交换机下行端口的缓冲区在纳秒级被填满,瞬间丢包并触发漫延全网的 PFC 暂停风暴!
3.3 两跳聚合(Two-Hop Hierarchical):Gateway 汇聚网关设计与 NVLink/RDMA 协同
为了破解一跳直达的灾难,大厂顶级架构(如 DeepEP Normal 模式)采用了划时代的 两跳分层聚合(Two-Hop Hierarchical) 策略:3.4 DeepSeek-V3 风格 MoE (EP=64) 真实数据流五步手算对比(包大小、NIC 利用率、RTT)
让我们按照 No Naked Formula 2.0 原则,把真实工业界顶流大模型——DeepSeek-V3 风格 MoE(EP=64,8 台 × 8 卡 H100 服务器,共 64 个 Expert) 的真实通信账本在白板上一步步手算清楚!1. 业务场景基准参数设定:
- 专家并行度: (每个 GPU 承载 1 个独立专家);
- 单卡处理 Token 数:每个 GPU 每步分配 512 个 Token;
- 模型隐藏层维度: ,采用 BF16 数据类型(每个元素 2 字节);
- 单 Token 数据体量:
- 单 GPU 产生的总通信量:
2. 真实流量分布推导:
假设门控路由将 Token 均匀分配给全网 64 个专家:- 留在本 GPU 的 Token 比例: ;
- 留在本机内(通过 NVLink 走同机其他 7 卡)的比例: ;
- 必须跨物理机(走跨机 RDMA 网卡)的比例: ;
- 单 GPU 必须跨机外发的净数据量:
3. 一跳直达 vs 两跳聚合 深度手算对决表
我们将手算结果汇总为最严谨的标准 GFM 对比表:4. 生产级实战:DeepEP 内核实现哲学与 Warp 级角色分配
4.1 单 Kernel 吞噬一切:为什么绝不能把两跳拆成独立 Kernel 串行?
两跳聚合在宏观数学上看起来无比美妙,但在很多工程团队手中落地时,却往往以失败告终。这是因为新手往往会把它直觉性地拆解为三个顺序执行的 CUDA 算子:
整个两跳聚合被精雕细琢地熔铸在 一个单一的持久化 CUDA Kernel(Persistent Kernel) 内部!
4.2 五大 Warp 角色分工(RDMA+NVL Forwarder、Receiver、Sender、Local Handler)
在 DeepEP 的生产内核中,不是让所有的 SM 执行相同的代码,而是 以 Warp 为单位,将一个 Block 内部的计算资源精准切分为五种完全不同的硬件特种兵:4.3 偶数 SM 与奇数 SM 的物理正交:消除 NVLink 与 RDMA 通道竞争
为什么 DeepEP 的多角色流水线能够打出近乎理论极限的吞吐?这里蕴含着极其精妙的硬件微架构洞察: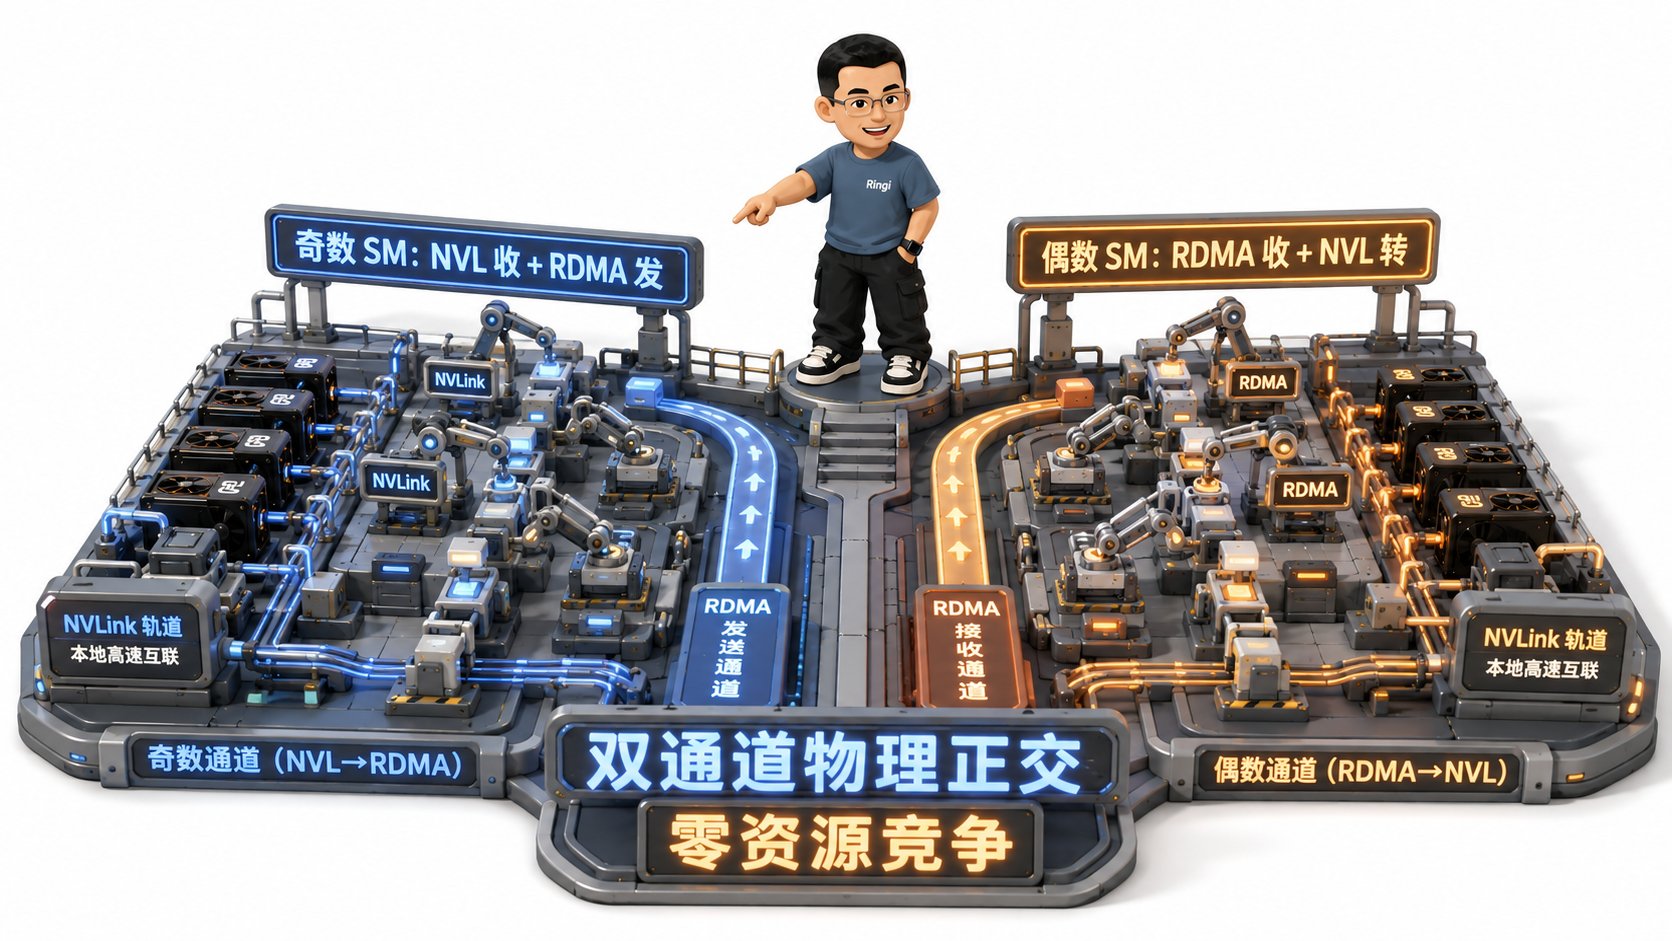
- NVLink 通道:依靠底部的 NVSwitch 硬件,拥有独立的机内读写通道;
- RDMA 通道:通过 PCIe Switch 与 ConnectX 网卡直通,拥有完全独立的 DMA 引擎;
- 物理正交,零互斥竞争:奇数 SM 在打满网卡发送带宽的同时,偶数 SM 也在全速消耗网卡接收带宽;与此同时,机内 NVLink 在以 900 GB/s 的速度进行双向对轰。 两套硬件在纳秒级别完全并行运转,端到端实际耗时退化为:
4.4 为什么 DeepEP LL 模式坚决放弃两跳聚合?(Decode 场景 TPOT 极度敏感法则)
在掌握了两跳聚合的精妙之后,我们必须清醒地认识到它的边界:为什么在在线推理 Decode 阶段,DeepEP LL(Low Latency)模式却毫不犹豫地倒戈,坚决选择一跳直达? 这就是 AI 基础设施工程师必须具备的全局业务洞察:- Decode 阶段特征:每张卡在一个生成步中,分发给远端专家的往往只有 1~2 个 Token(体量仅有微不足道的几 KB);
- 两跳聚合的致命负收益:
- 此时网络早已不是带宽受限,而是 绝对延迟受限(Latency-Bound);
- 走两跳聚合,即使 NVLink 只需要 1 微秒,但多了一道转发与拼包,端到端延迟仍然会平白多出整整 ;
- 在在线推理系统中,用户体感直接由 TPOT(Time Per Output Token) 决定。多出 3 微秒,在 100 步生成下就是累积增加近半毫秒的延迟;
- LL 模式的正解:
- 采用 IBGDA + 一跳直达!
- 即使网卡利用率只有 20 GB/s,即使 56 个碎包效率低下,但因为绝对数据量太小(几微秒就传完了),它换来了 物理单程最极致的 1 跳光速直达!
5. 网络协议与单边通信致命陷阱:Put+Signal Blocking 退化复盘
5.1 伪单边通信惨案:发送方等待接收方 ACK 导致的单边退化双边
在第 0.2 节的事故中,我们揭露了 Put+Signal 伪单边通信陷阱。现在我们从 RDMA 状态机与物理链路层,彻底透视其致命诱因:5.2 真正单边通信的三大物理铁律:同 QP 保序、Write with Immediate、内存屏障 Fence
既然不能加 Blocking 等待,我们如何在没有对端确认的前提下,百分之百确保数据一定比完成信号先落入远端显存? 大厂性能工程必须死守以下三大底层机制:1. 同 QP 严格保序(In-Order Delivery Rule)
- RDMA 规范物理保证:在同一个 RC(Reliable Connection)QP 队列 中,网卡硬件保证所有的 WQE 严格按照下发顺序在接收端提交!
- 正解操作:将 Put Data 操作与 Put Signal 操作 绑定挂载在同一个 QP 队列中!先投递 Put Data WQE,紧接着投递 Put Signal WQE。硬件电路确保:只要 Signal 写入显存,前面所有的 Data 必定已经完成全局显存落盘!
2. RDMA Write with Immediate(带立即数写)
- 抛弃独立的 Signal 发送,采用
IBV_WR_RDMA_WRITE_WITH_IMM指令; - 数据载荷在写入远端显存的同时,硬件报头中夹带一个 32 位的立即数(Immediate Value);
- 远端网卡写入数据后,硬件自动消耗远端的一个接收队列(RQ)并生成一个包含该立即数的完成事件(CQE),一步到位完成数据搬运与事件触发,零多余报文!
3. 内存屏障(nvshmem_fence() vs nvshmem_barrier())
- 严禁用带有全局跨节点同步开销的
nvshmem_barrier_all(); - 必须使用仅约束本地发送引擎次序的轻量级内存屏障
nvshmem_fence():
5.3 IBRC 传输协议调优:QP Cache Thrashing(网卡 SRAM 缓存击穿)与 DCT 动态连接扩展
在千卡甚至万卡规模下,哪怕控制面全用 IBGDA,网络底层依然会撞上一堵物理墙——网卡片上 QP 缓存击穿(QP Cache Thrashing)!1. QP 数量的平方级爆炸陷阱( Scalability Crisis):
- 在标准 RC(Reliable Connection)模式下,两个 GPU 进程通信必须独占一对专属的 QP 队列;
- 一个拥有 1024 张 GPU 的集群,若跑全互联 All-to-All,每张卡需要维持的 RC QP 数量为:
- 如果考虑每个 GPU 分配 8 个通信通道(Channels),单张卡上的活动 QP 数量高达 8,000 个!
2. 网卡片上 SRAM 的物理极限:
- ConnectX-7 等高速网卡内部的片上高速静态存储(SRAM Cache)极其宝贵(通常只有十几兆字节);
- 每个 QP 上下文(包含状态机、序列号、重传缓冲区、滑窗指针)大约占用数千字节;
- 当活跃 QP 数量超过数百个时,网卡的片上 SRAM 发生严重击穿(Cache Thrashing),网卡硬件被迫频繁跨 PCIe 总线去主机内存中换入换出 QP 上下文,导致网卡处理时延暴增 300%!
3. 破局之道:DCT(Dynamically Connected Transport)
- 为了解决千万级扩展性,NVIDIA Mellanox 提出了专有的 DCT(动态连接传输) 协议:
- 发送端不再为每个远端维护持久化 RC QP,而是维护少量的共享发送端(DCI);
- 发送时由硬件根据数据包目标动态与远端的 DCT 目标进行瞬时绑定,通信完毕立即复用释放;
- 收益:将网卡常驻 QP 数量从 降维到 ,彻底消灭片上 SRAM 击穿风险,为万卡 MoE 铺平了道路!
6. 拓扑诊断与硬件监控:NCCL 与 IBGDA 线上状态排查
6.1 NCCL_CROSS_NIC 与 NCCL_NET_GDR_LEVEL 环境变量关键配置
在生产环境中,确保机间数据搬运工作在最优硬件直通路径上,高度依赖 NCCL 与网络驱动的环境变量调优:
6.2 抓取 NVSHMEM / IBGDA 运行日志识别控制面瓶颈
当使用 NVSHMEM 运行 GPU-initiated 通信时,开启NVSHMEM_DEBUG=INFO 可以清晰抓取控制面与传输层的底层决策:
Falling back to CPU-controlled,说明宿主机内核模块异常,系统已经退化回了慢速模式,必须立即重启排查 nvidia-peermem 驱动服务。
6.3 RDMA 网卡性能计数器监控(PFC 帧、ECN 标记、QP 队列拥塞)
在万卡集群的网络排障中,网卡底层的硬件计数器(Hardware Counters)是唯一的测谎仪。运维工程师必须定时巡检/sys/class/infiniband/ 下的指标:
7. 动手实战与代码实验室(Minimal Runnable Code)
本节提供 4 个可以直接在本地完整运行并打印清晰输出的 Python 实验,彻底还原控制面、路径策略与多 Warp 调度的物理本质。7.1 实验 1:CPU 控制面与 GPU 直通 Doorbell 延迟模拟对比基准
本实验精确复现由于消息载荷大小变化,导致 IBRC(CPU 主导)与 IBGDA(GPU 主导)在不同负载下的延迟构成与吞吐差异:7.2 实验 2:两跳聚合 vs 一跳直达网络带宽利用率与 Incast 拥塞仿真器
本实验完整模拟 DeepSeek-V3 风格 MoE(EP=64)在 8 台服务器共 64 卡下,一跳直达与两跳聚合的真实数据切分与网络行为:7.3 实验 3:单边通信(Fire-and-Forget)与双边阻塞退化性能衰减实验
本实验量化揭示在跨机单边通信中,如果错误地加入了阻塞等待确认逻辑,端到端吞吐量会承受怎样毁灭性的惩罚:7.4 实验 4:DeepEP 风格多 Warp 角色调度器仿真模型
本实验建立 DeepEP 核心流水线调度器数学模型,验证奇数 SM 与偶数 SM 如何做到 NVLink 与 RDMA 双通道并发饱和:8. Ringi 避坑指南与生产性能工程黄金 Checklist
8.1 避坑表格(❌ 常见小白误区 vs ✅ 大厂 AI Infra 正解)
8.2 生产跨机数据搬运与网卡调优黄金十条 Checklist
- 1. 【驱动基线自检】 宿主机必须成功加载
nvidia-peermem内核模块,确保 IB 驱动能直接解析 GPU 显存物理地址,严禁降级到 Host 内存中转。 - 2. 【GDR 直通级别】 生产启动脚本必须显式配置
export NCCL_NET_GDR_LEVEL=5,确保网卡与 GPU 之间无论走 PCIe Switch 还是同一 NUMA 均实现满血 P2P 直通。 - 3. 【NUMA 亲和严防】 必须设置
export NCCL_CROSS_NIC=0,严格保证驱动 GPU 0 的网卡只使用同一 CPU Socket 侧的 PCIe 链路,严禁跨 UPI 总线漫游。 - 4. 【场景协议匹配】 密集型 Dense 预训练(DDP/TP)统一采用 IBRC 协议保证稳定性;高频小包(MoE/Decode)开启 IBGDA 或 NVSHMEM 旁路 CPU。
- 5. 【单边保序设计】 编写单边通信代码时,严禁在 Put 操作后加入等待对端握手的逻辑;必须依赖同 QP 严格保序或
RDMA Write with Immediate实现单向闭环。 - 6. 【两跳大包整流】 在大 batch MoE 训练(EP 32)中,优先采用类似 DeepEP 的两跳聚合架构,用机内 NVLink 整合出 1MB 以上大包以打满网卡物理线速。
- 7. 【在线推理直达】 在线推理 Decode 阶段坚决采用一跳直达(DeepEP LL 模式),牺牲部分网卡带宽换取单程绝对物理延迟的极限压榨。
- 8. 【硬件双通道正交】 通信 Kernel 内部必须对 SM / Warp 进行角色解耦(奇数出站、偶数入站),保证机内 NVLink 与跨机 RDMA 在物理上不产生争用。
- 9. 【网络流控排查】 线上巡检定期检查网卡
rx_prio4_pause_duration与np_ecn_marked_roce_packets,出现狂飙立即排查 Incast 与丢包。 - 10. 【连接池与 DCT】 当集群规模突破千卡且通信对数量爆炸时,评估开启 DCT(动态连接传输),防止网卡片上 SRAM 缓存击穿。
9. Ringi 5 点核心速记口诀、自我检验清单与课后深度思考题
9.1 5 点押韵核心速记口诀
9.2 10 条白板自我检验清单
- 能否在白板上画出传统 GPUDirect RDMA 从 WQE 组装到 Doorbell 敲击的完整 9 步时序图?
- 为什么说传统 GDR 只是统一了数据面,控制面依然存在跨 PCIe 与 CPU 调度的延迟?
- 在 Alpha-Beta 模型中,什么样的数据量会导致控制面时延 占据总通信时间的 90% 以上?
- IBGDA 是通过什么硬件技术(PCIe BAR 空间)让 SM 核心能够直接敲响网卡门铃的?
- NVSHMEM 的 PGAS(分区全局地址空间)与普通 MPI 发送接收在调用哲学上有何根本不同?
- 为什么机内 NVLink 带宽被称为“便宜资源”,而跨机 RDMA 网卡被称为“昂贵资源”?
- 一跳直达(One-Hop)在多节点 MoE 场景下为什么会引发极其严重的交换机 Incast 拥塞?
- 两跳聚合中,Gateway GPU 如何通过单 Kernel 内部的 Warp 角色分工,同时吃满 NVLink 与 RDMA?
- 为什么在 Put Data 与 Put Signal 之间加入等待对端响应的阻塞,会导致单边通信性能暴跌 20 倍?
- 当集群规模达到万卡时,RC 传输模式的 QP 数量爆炸为什么会导致网卡片上 SRAM 击穿?
9.3 3 道高阶开放式课后思考题(含极端 Corner Case)
思考题 1:极端非对称拓扑下的 Gateway 算力倾斜风险
在两跳聚合设计中,每个节点需要指定 Gateway GPU 来承担机内汇总与外发的重任。如果一个训练任务不仅有 MoE 的 All-to-All,同时还交织着张量并行(TP)和数据并行(DP),作为 Gateway 的 GPU 0 其 SM 计算资源被通信 Warp 占用了 16 个 SM。此时,GPU 0 的密集计算速度落后于同机其他未承担网关职责的 GPU,会引发怎样的系统级“木桶短板(Straggler)”效应?工程上该如何平摊网关角色?思考题 2:IBGDA 硬件死锁的极端容错 Corner Case
传统的 CPU-controlled 模式下,如果跨机网络中断或发生光模块掉电,CPU 驱动可以通过超时定时器(Timer)优雅地捕获错误并触发 Checkpoint 保存。但在 IBGDA 模式下,如果一个正在执行nvshmem_put 的 CUDA Kernel 在显存中轮询远端标志位,而远端节点因掉电永远无法返回数据,GPU SM 核心会陷入永久的硬件级自旋死锁(Spinlock Deadlock)。此时主机操作系统无法调度该 GPU,甚至会导致整个 PCIe 链路冻结(Bus Reset 失败)。在工业级高可用设计中,如何为 GPU-initiated 通信设计看门狗(Watchdog)?
思考题 3:Blackwell NVL72 机架级全互联对两跳聚合的降维打击
在最新发布的 GB200 NVL72 架构中,整整 72 颗 GPU 被装进同一个机柜,并通过 5000 根铜缆背板实现了全互联单一 NVLink 域(任意两卡 1.8 TB/s 双向互联)。思考:在 NVL72 内部运行 64 专家的 MoE 时,原本为跨机设计的两跳聚合(Two-Hop)是否还有存在的必要?当机内全互联域突破了单机 8 卡物理边界后,分布式通信协议栈该如何重新洗牌?10. 📚 参考资料与核心源码/经典论文指引
- NVIDIA 官方体系结构与源码:
- NVIDIA GPUDirect RDMA Architecture & Programming Guide:解密 PCIe BAR 空间物理映射、页面锁定与驱动接口;
- NVSHMEM Documentation & GitHub Repository:深入 PGAS 架构、单边通信原语与 IBGDA 底层驱动实现;
- GDRCopy: Fast GPU Memory Copy Library:低延迟跨总线 CPU-GPU 状态同步黑科技;
- 顶会经典论文与工业界前沿实现:
- DeepEP 源码实现:DeepSeek-AI / DeepEP (GitHub) — 工业级 MoE 高性能通信库,深入研读其 Warp 级角色分配与两跳聚合 Kernel;
- DeepSeek-V3 Technical Report:详细推导了在万卡规模下利用通信计算重叠实现近乎零开销 All-to-All 的架构考量;
- “GPU-Initiated On-Demand High-Performance Networking” (IEEE Micro):系统论述了消除 CPU 控制面开销对大规模 AI 计算的决定性意义;
- AI_BOOK 本地一手知识库对照出处:
- 🌐 AI_BOOK / GPU通信 / 大模型通信基础 2.4 机间数据搬运.md:两跳聚合、控制面 IBRC vs IBGDA 与 MoE 真实通信量推导;
- ⚡ AI_BOOK / AI-fundamentals / 01_hardware_architecture / gpudirect / 01_gpudirect_technology.md:GPUDirect RDMA 核心物理机制与驱动层交互;
- 🏛️ AI_BOOK / AISystem / 02Hardware / 04NVIDIA / 06DeepNvswitch.md:NVSwitch 机内高速全互联物理底座。
附录:Appendix A — 大厂硬核高频面试题与白板推导(Interview Drill)
Drill 1:为什么 GPUDirect RDMA 无法根治 MoE Token Dispatch 的延迟悬崖?
考察重点:
深入考察候选人是否真正理解计算机体系结构中的“数据面与控制面分离”,能否精准指出传统 GDR 在处理细粒度小消息时的瓶颈。解题思考路径:
- 先肯定 GPUDirect RDMA 在数据面上的卓越贡献(P2P DMA 直通显存,消除 Host 内存拷贝);
- 指出其在控制面上的软肋:传统 Verbs 架构下,构造 WQE 和敲 Doorbell 仍然依赖 Host CPU;
- 结合 MoE 的数据特征:Token Dispatch 产生的是成千上万个离散碎片小包(每包约几十 KB);
- 运用 Alpha-Beta 性能模型进行数量级对比:小包场景下物理传输耗时仅需纳秒,而 CPU 的控制面时延与操作系统抖动(数微秒)占据了总耗时的 90% 以上;
- 给出最终正解:必须演进至 GPU-initiated RDMA(如 IBGDA),让 GPU SM 核心直接接管 Doorbell 敲击。
Drill 2:推导 DeepEP 两跳聚合中 Gateway GPU 的带宽瓶颈平衡点
考察重点:
考察候选人对机内 NVLink 与机间 RDMA 带宽配比的量化计算能力,以及两跳聚合架构的适用边界。白板推导过程:
设单节点包含 张 GPU,每张 GPU 拥有单向 NVLink 带宽 ;整机配置 张跨机网卡,每张网卡单向物理带宽为 。在 MoE Dispatch 阶段,设每张 GPU 产生的跨机外发数据量为 。
- 阶段 1:机内聚合: 张卡的数据通过 NVLink 汇总到网关 GPU。总汇聚量为 。NVLink 聚合耗时为:
- 阶段 2:跨机外发:网关 GPU 将本机的全部外发数据 通过网卡打出。跨机耗时为:
- 平衡点推导: 两跳聚合的最佳吞吐重叠状态,要求机内聚合速率与跨机外发速率完美匹配,即:
Drill 3:如何用 RDMA 原子操作或 Write with Immediate 实现零 CPU 介入的状态同步?
考察重点:
考察候选人对 RDMA 高阶单边原语的掌握深度,能否给出免除双边通信 RTT 惩罚的工程解法。标准参考答案:
- 传统双边同步的痛点:发送方发送数据后,必须等待接收方回复确认,导致流水线承受一次完整的跨机网络 RTT(约 8~10 );
- Write with Immediate 解法:
- 发送方使用
IBV_WR_RDMA_WRITE_WITH_IMM,将数据与一个 32 位的标志位打包在同一个网络报文中发出; - 接收端网卡硬件在完成显存 DMA 写入后,直接消耗预置的一个空接收请求(RR),并在远端生成一个 CQE 完成事件;
- 整个过程在一次物理单向飞行中同时完成了“数据落盘”与“事件通知”,彻底消灭了双边反向握手开销;
- 发送方使用
- 同 QP 单边原子操作解法(Atomic Compare & Swap):
- 发送方利用同一 RC QP 严格保序的硬件特性,先发起
RDMA Write写入数据,紧随其后发起一个RDMA Atomic Fetch-and-Add递增远端显存中的完成计数器; - 接收方 SM 核心在本地显存轮询该计数器,一旦数值达标立即启动消费,实现 100% 旁路两端 CPU 的纯硬件级状态同步。
- 发送方利用同一 RC QP 严格保序的硬件特性,先发起