🏛️ 第16讲:大厨不必亲自搬砖——机内数据搬运(LSU/TMA/Copy Engine/mbarrier/IPC)与 SM-Free 革命
主讲人:👓 Ringi(大厂 AI Infrastructure 工程师)
所属模块:Module 01: GPU 硬件架构、数据搬运、集群通信与 Overlap
篇章范式:⚙️ 卡内与机内数据路径篇(Intra-Node Data Movement Paradigm)
核心导读:
在过去的 CUDA 性能优化教程中,有一套被奉为圭臬的“黄金法则”:让线程自己把数据从全局显存(HBM)加载到寄存器,再一条条写入共享内存(Shared Memory)。
然而,在当代以万亿参数大模型与 Tensor Core 超高算力密度为代表的 AI 时代,这一传统范式正在引发一场静默的算力海啸——负责搬运数据的指令疯狂霸占通用寄存器与指令发射端口,导致真正负责干核心矩阵乘法的 Tensor Core 频繁陷入饥饿!明明计算单元嗷嗷待哺,SM 却被繁重的“内存倒手”活活累死!
SM 参与搬运究竟是一场怎样的零和博弈?Hopper 架构引入的 TMA(Tensor Memory Accelerator)是如何在硬件层面做到多维张量直通与寄存器零污染的?Copy Engine 与 SM 之间有着怎样不可逾越的调度边界?硬件级屏障 mbarrier 又是如何让控制面彻底摆脱轮询停顿的?在多进程单机 8 卡环境下,CUDA IPC 是如何打通进程隔离实现 900 GB/s 极速狂飙的?而在大模型通算重叠中,通信耗时为何会出现神秘的“k 倍率时间膨胀”?
本讲我们将深入单卡内部与单机机箱,以极致的硅片微架构视角,解密现代 AI 算力系统走向 “SM-Free 硬件彻底卸载” 的技术革命!
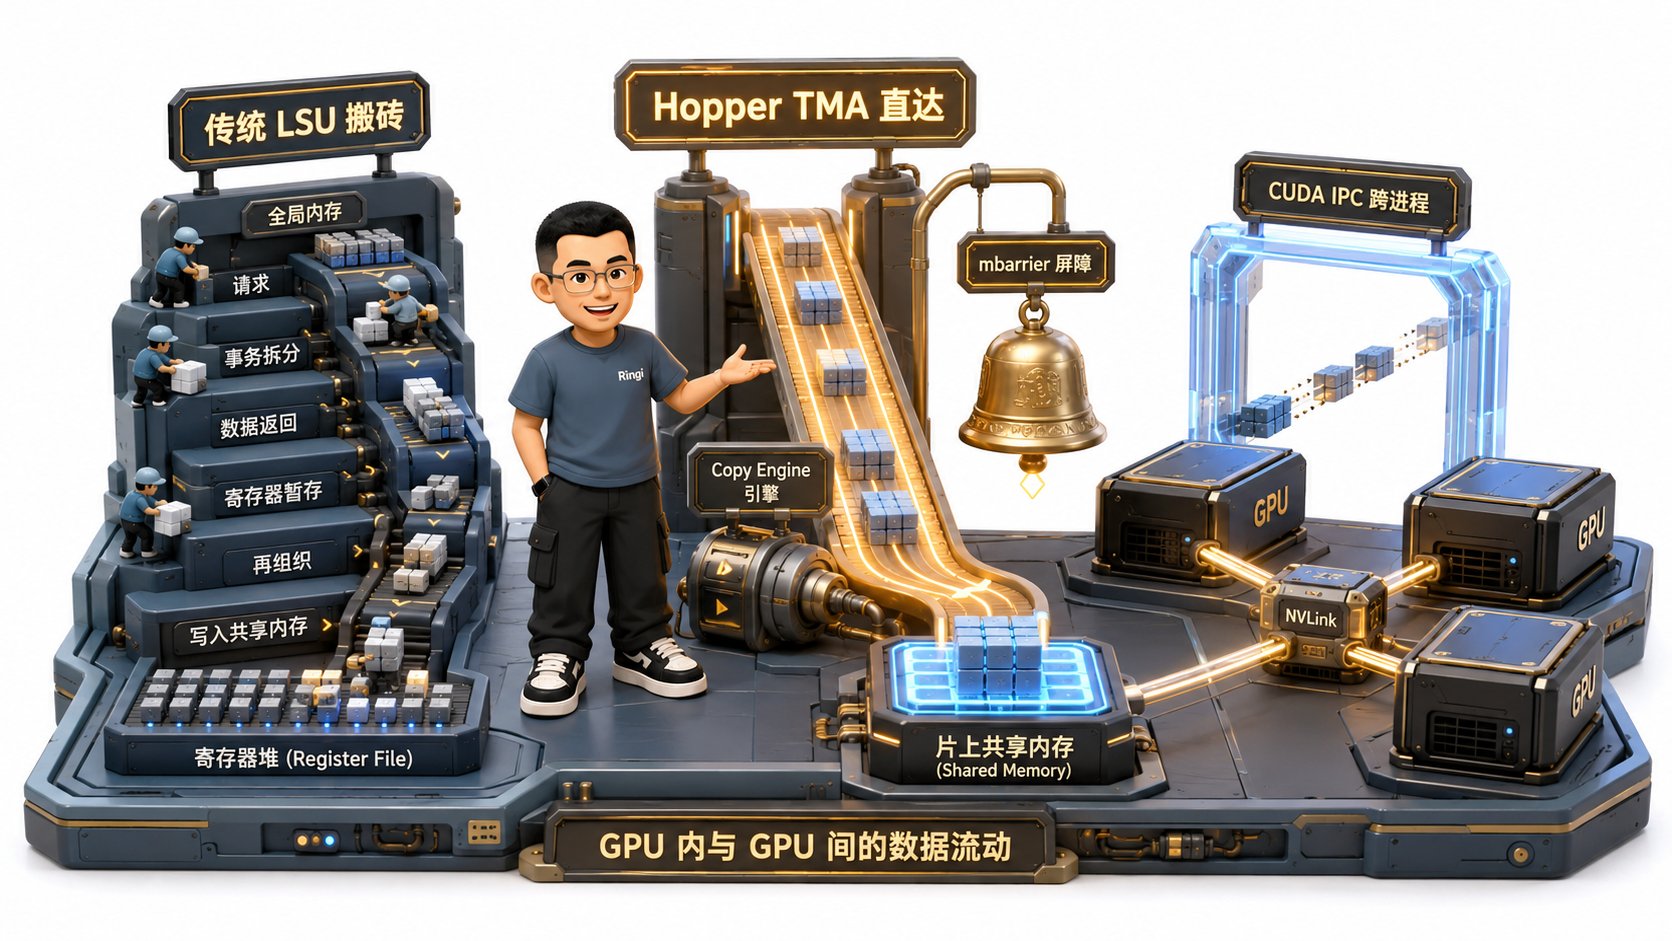
📑 目录导航
- 0. Ringi 开场:生产真实现场与痛点冲突
- 1. 机内数据搬运四大引擎:SM 占用的四级阶梯
- 2. TMA vs LSU:数据面 SM-Free 的硬件底层革命
- 3.
mbarrier:控制面彻底卸载的硬件钥匙 - 4. 通算重叠(Overlap)的残酷真相:SM 竞争与 k 倍率膨胀
- 5. CUDA IPC 与跨卡共享内存:打破进程地址隔离
- 6. 生产典型故障排障实战指南
- 7. 动手实战与代码实验室(Minimal Runnable Code)
- 8. Ringi 避坑指南与生产性能工程黄金 Checklist
- 9. Ringi 5 点核心速记口诀、自我检验清单与课后深度思考题
- 10. 📚 参考资料与核心源码/经典论文指引
- 附录:Appendix A — 大厂硬核高频面试题与白板推导(Interview Drill)
0. Ringi 开场:生产真实现场与痛点冲突
0.1 真实工程矛盾:米其林大厨炒菜前必须自己跑冷库搬牛肉——计算与访存的零和博弈
在现代高性能 GPU 内部,流式多处理器(SM)所扮演的角色,极其类似于一家顶级餐厅里的米其林主厨: 主厨的核心价值在于其鬼斧神工的颠勺手艺(即 Tensor Core 的矩阵乘加 MMA 计算)。 然而,在过去很长一段时间的底层 CUDA 代码中,主厨的日常工作状态却是极其荒诞的:- 每当要炒一盘菜,主厨必须自己脱下围裙,一路小跑穿越大半个厨房,来到零下 20 度的冷库(HBM 显存);
- 亲手扛起两箱冻牛肉,费力地把它们搬回自己的操作台(通用寄存器堆 Register File);
- 再从操作台一块块切好放进手边的备料盘(片上共享内存 Shared Memory);
- 最后,气喘吁吁的主厨才能开火颠两下勺!
因此,在大模型性能工程的世界里,机内数据搬运的终极命题绝不是“怎么把搬运代码写得更巧”,而是:“怎么在硬件上把数据搬了,同时 1% 的 SM 算力都不占用(SM-Free)!” 不仅如此,一次完整的数据搬运必须包含两个阶段:
- 数据面(Data Plane):谁把这几个 GB 的字节从 A 搬到 B?
- 控制面(Control Plane):谁负责确认“数据搬完了”并通知下游开始消费?
0.2 线上真实事故复盘:Hopper 架构强行将通信塞入 GEMM Epilogue 导致吞吐暴跌 35%
我们来看一起发生在大厂自研高性能通信库团队的真实工程翻车惨案: 在 Ampere(A100)时代,有一套业界非常知名的融合优化技巧——GEMM + ReduceScatter 融合(以字节跳动开源的 Flux 算子为典型代表)。其核心原理是:利用传统 GPU 在 Epilogue(算子尾声)阶段的空闲周期,让计算线程在算完一个 Tile 矩阵块后,直接把结果通过 NVLink 跨卡写到目标 GPU 的显存缓冲区里。因为 Ampere 每个 SM 会并发调度多个 Block,当某个 Block 在执行跨卡远程 I/O 时,硬件调度器能自然切到同 SM 上的其他 Block 继续算 GEMM,从而近乎免费地隐藏了机内通信延迟。 该团队在升级到 Hopper H100(SM90 架构) 后,工程师自以为是地照搬了这套逻辑,直接把机内通信写入塞进了 Hopper GEMM 的 Epilogue 中。 上线测试一跑,所有人都惊呆了:端到端训练吞吐不但没有提升,反而比未融合的版本暴跌了整整 35%! 事故根因剖析:
- Hopper 架构的执行范式发生了范式转移:每个 SM 运行的是 单 Persistent Warp-Specialized Threadblock(持久化专用线程块);
- 内部被极其精密地切分为 Producer Warp(负责 TMA 异步拉取数据) 与 Consumer Warp(负责 MMA 算力轰鸣),两者依靠硬件级
mbarrier咬合成为一条极致紧凑的微观流水线; - 当工程师强行把包含数十微秒长延迟的 NVLink 远端通信操作塞进这个紧凑流水线的 Epilogue 时,同 SM 上根本没有多余的 Block 可供调度器切换!
- 整个高度精密的 TMA + MMA 流水线瞬间被这个长延迟操作彻底冻结,在流水线中硬生生打出了巨大的空泡(Bubble)!
0.3 机内数据搬运四大引擎横向对比全景速查表
在深入硅片内部之前,我们先把单机多卡环境下的四大搬运引擎底账彻底算清:1. 机内数据搬运四大引擎:SM 占用的四级阶梯

1.1 阶梯一:SM Load/Store(LSU)——逐元素消耗寄存器,指令管线全程锁死
这是最原始、最经典的 CUDA 搬运方式:- 程序员编写
for循环,利用线程束中的 32 个线程,通过ld.global指令从 HBM 全局显存加载数据; - 致命痛点:每一个加载回来的浮点数,必须首先存放在该线程专属的**通用物理寄存器(Register File)**中!
- 随后,线程再发射
st.shared指令,把寄存器里的数值写入片上共享内存(Shared Memory)。
- 寄存器压力溢出(Register Spilling):为了隐藏访存延迟,程序员往往会展开循环预取数据,导致单个线程所需的寄存器数量暴增(如从 32 个飙升到 128 个)。SM 内部总共只有 64K 个 32 位寄存器,寄存器消耗翻倍,直接导致每个 SM 能同时驻留的活跃 Warp 数(Occupancy)腰斩!
- 指令发射端口堵塞:SM 内部的指令分发单元(Dispatch Unit)在数十个周期内排满了纯粹的搬砖指令,负责核心算力的 Tensor Core 管线只能空转等待。
1.2 阶梯二:TMA(Tensor Memory Accelerator)——1 条指令下单,硬件代搬直达 Shared Memory
NVIDIA 在 Hopper(H100)架构中引入了一颗革命性的硬件芯片模块——TMA(张量内存加速器)。 它在微架构上将搬运彻底剥离出了 SM 的计算管线:- SM 中的线程只需要构建一个微小的 128 字节描述符(描述张量的维度、步长、源地址与目的地址);
- 单个线程发射 1 条汇编指令(如
cp.async.bulk.tensor); - 发射完毕的下一瞬间,该线程与所属 Warp 立即解脱,可以自由转身去调用 Tensor Core 执行矩阵乘法!
- TMA 专用硬件控制器接管总线,直接从 L2 缓存或片外 HBM 抽取多维张量,彻底绕过寄存器文件,直接灌入共享内存(Shared Memory)!
1.3 阶梯三:Copy Engine(CE)——DMA 独立于 SM,但为什么 Kernel 内无法调用?
在 GPU 芯片的宏观拓扑中,除了成百上千的 SM 核心外,芯片边缘还独立封装了数颗专用的硬件控制器——Copy Engine(拷贝引擎,即 GPU 专属 DMA 引擎)。 当我们调用cudaMemcpyAsync() 时,执行搬运的正是这个独立于 SM 的物理引擎。它拥有极高带宽(打满 PCIe 5.0 的 64 GB/s 或 NVLink 4.0 的 900 GB/s),并且 0% 占用 SM 算力。
为什么在编写 CUDA Kernel 时,我们不能直接调 Copy Engine?
很多底层开发者经常提出这个灵魂拷问:“既然 Copy Engine 完全不占 SM,为什么不让我在 GPU Kernel 代码里直接发射指令调 CE 呢?” 这是体系结构设计上的刻意解耦与特权隔离:- 调度权限隔离:Copy Engine 由位于 Host 端和 GPU 前端的 命令处理器(Command Processor / Host Interface) 直接管理,它只接收来自 CUDA Stream 任务队列的宏观命令流(Command Buffer);
- 执行粒度不匹配:CE 是粗粒度的批处理 DMA 设备,一次启动与握手开销在微秒(μs)级;而 Kernel 内的线程调度是以纳秒(ns)为周期的微观流水线。让微观线程直接抢占宏观 CE 会引发不可调和的仲裁冲突;
- 架构解耦的红利:正因为 CE 完全独立在 Kernel 外部,它才能在独立的 CUDA Stream 上与正在 GPU 内部轰鸣的计算 Kernel 实现绝对物理并发!
1.4 阶梯四:Staged Copy——PCIe Host 内存中转兜底的物理代价
当两张 GPU 之间既没有 NVLink 物理金手指,主板上的 PCIe Switch 又不支持 P2P(Peer-to-Peer)寻址时(在消费级主板或部分云厂商低端虚拟化环境中常见),系统只能无奈启用 Staged Copy(主机内存分段中转):1.5 为什么 NCCL 机内 AllReduce 必须走 SM?(搬运 vs 归约计算的本质分水岭)
现在我们来回答一个非常具有工业实战深度的考题: 在大模型机内 8 卡通信中,NCCL 默认为什么依然使用基于 SM 的 Kernel(从对端 Load,相加后再 Store),而不是纯用 Copy Engine? 答案就在于 搬运(Movement)与 归约(Reduction)的本质分水岭:- 纯搬运(Pure Movement,如 AllGather / Broadcast / P2P SendRecv): 数据只是从卡 A 瞬移到卡 B,不需要对数据做任何修改。这种操作理应 100% 追求 SM-Free,交给 DMA 引擎或 TMA;
- 含计算搬运(Reduction Movement,如 AllReduce / ReduceScatter): 在把梯度发给邻居卡的同时,必须把本地的梯度与邻居送来的梯度执行逐元素浮点加法(FP16/BF16 Sum)! 而 Copy Engine 是一个纯粹的搬运工,它内部根本没有浮点加法器(ALU)! 如果纯用 CE 搬运,流程就必须退化为:CE 先把数据搬到内存缓冲区 ➔ 触发一个 GPU 加法 Kernel 读出相加并写回 ➔ 再用 CE 发给下一个卡。这平白无故多出了整整两倍的显存读写流量!
- 因此,NCCL 宁可消耗部分 SM(通常分配 8~16 个 Channel,占一小部分 SM),让 SM 的 LSU 或 TMA 在高速缓存流水线中“边读、边加、边发”,换取极限吞吐与最低的全局显存开销!
2. TMA vs LSU:数据面 SM-Free 的硬件底层革命
2.1 硬件微架构对决:LSU 数据流(经 RF 中转)vs TMA 数据流(绕过 RF 直通)
为了直观展现 Hopper 架构 TMA 的革命性突破,我们把两种搬运模式在硅片内部的物理数据流并列拆解: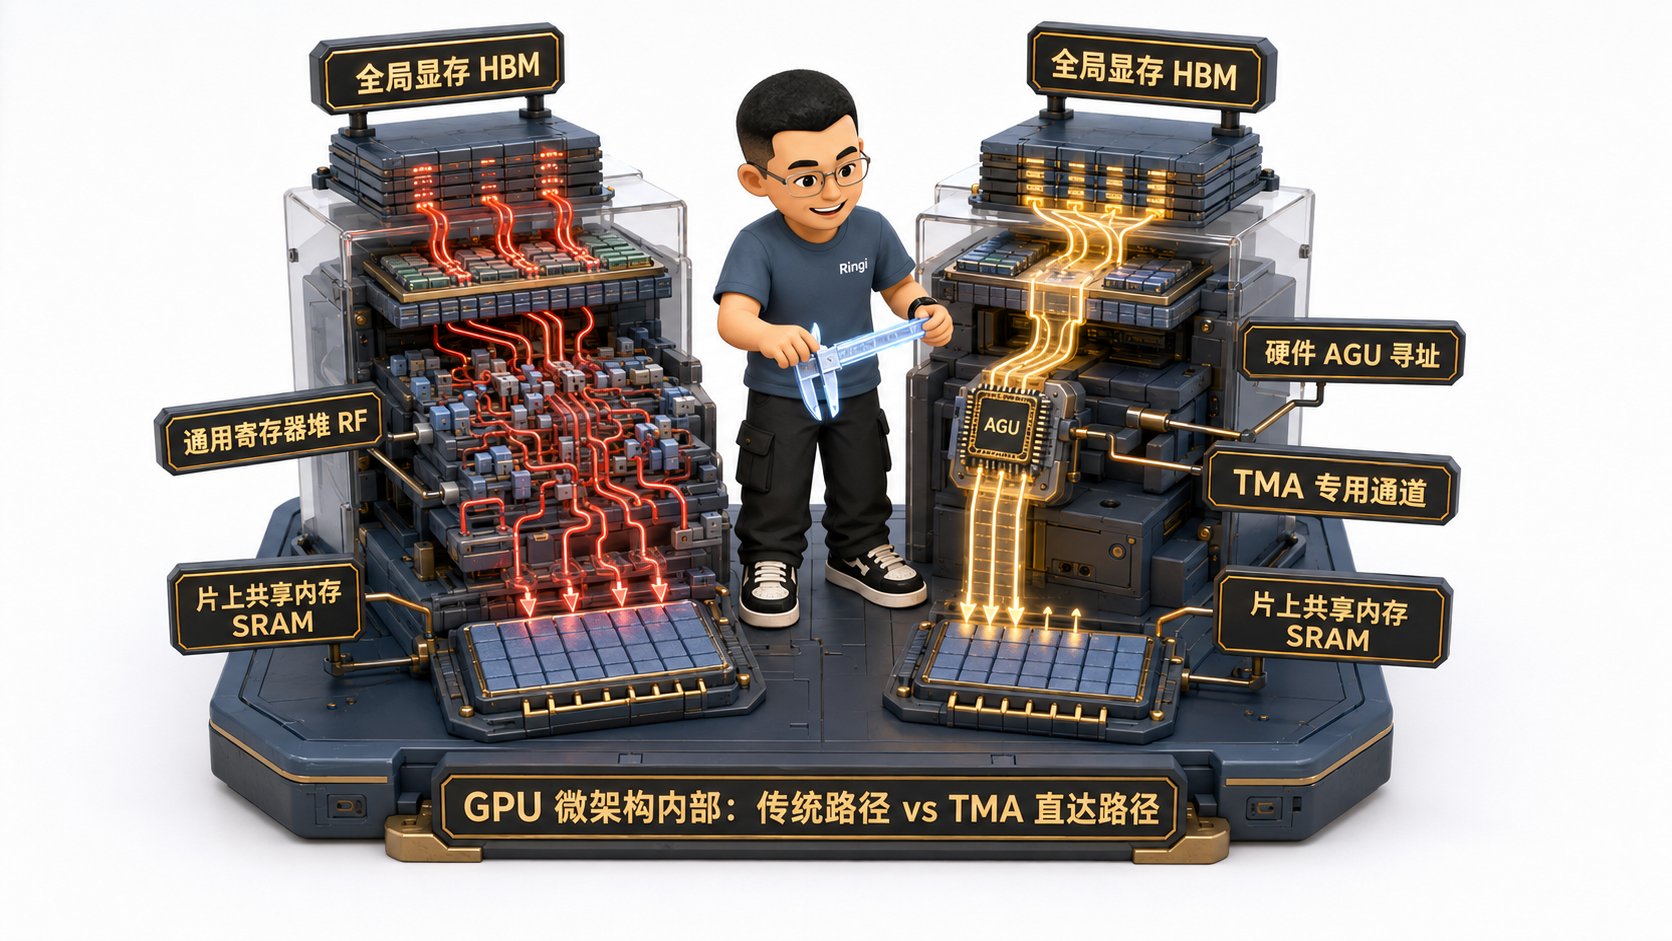
2.2 内置硬件 AGU(地址生成单元):硬件级多维张量(1D~5D)切块与自动越界 Padding
在过去编写高性能 GEMM 或 Convolution 算子时,程序员至少有 30% 的代码是在算复杂的数组下标与边界检查:- TMA 内部集成了一个专用的 多维地址生成单元(Hardware AGU);
- 在 Host 端或 Kernel 初始化阶段,我们创建一个
CUtensorMap描述符,直接填入张量的维度(1 维到 5 维)、全局步长、切块尺寸(Tile Size)以及边界填充模式(Zero-Padding); - TMA 硬件在搬运时,自主根据硬件步长推进多维指针,在遇到矩阵边界时硬件自动补零,不需要 SM 消耗任何一条分支跳转指令!
2.3 吞吐与延迟的物理拐点:为什么小包(<1KB)LSU 更快,而大包(>2KB)TMA 碾压式胜出?
在工程实践中,很多初学者容易走向极端,认为“既然 TMA 这么好,我代码里所有读写全部改成 TMA”。结果在小数据量场景下一测,性能反而严重劣化。 这背后是不可动摇的 硬件启动与流水线拐点定律:2.4 字节 Flux 在 Dense MLP 中的架构启示:Layer0 纯搬运走 CE,Layer1 归约计算融进 SM Epilogue
在大模型机内并行优化中,字节跳动开发的 Flux(Dense MLP 通算融合架构) 提供了一份极具教科书价值的工程答卷。 在一个标准的 Transformer MLP 结构中包含两层全连接: 在张量并行(TP=8)切分下:- Layer 1(Up-Projection,列并行):需要对输入做 AllGather,然后执行 GEMM;
- Layer 2(Down-Projection,行并行):执行 GEMM,最后必须对输出做 ReduceScatter。
3. mbarrier:控制面彻底卸载的硬件钥匙
3.1 为什么控制面也必须 SM-Free?(避免 SM 陷入“搬完没”的软件轮询泥潭)
在没有硬件屏障的年代,即使数据由异步引擎搬运到了内存,上层的消费线程依然面临一个尴尬的困境: “我怎么知道它搬完了?” 传统的软件解法只有两种:- 全局硬同步(
cudaStreamSynchronize()或__syncthreads()): 粗暴地强迫所有 Warp 停下来等待,把整个芯片的流水线彻底打空; - 内存标志位软轮询(Flag Polling):
在共享内存里放一个整型标记
volatile int flag,搬运方搬完后写入 1;消费线程用一个死循环while (*flag == 0) {}拼命轮询。 这种死循环轮询极其昂贵! 它持续霸占了 SM 的指令分发槽位,让硬件调度器以为这个 Warp 处于高负荷运算状态,白白烧干了功耗,却一无所获!
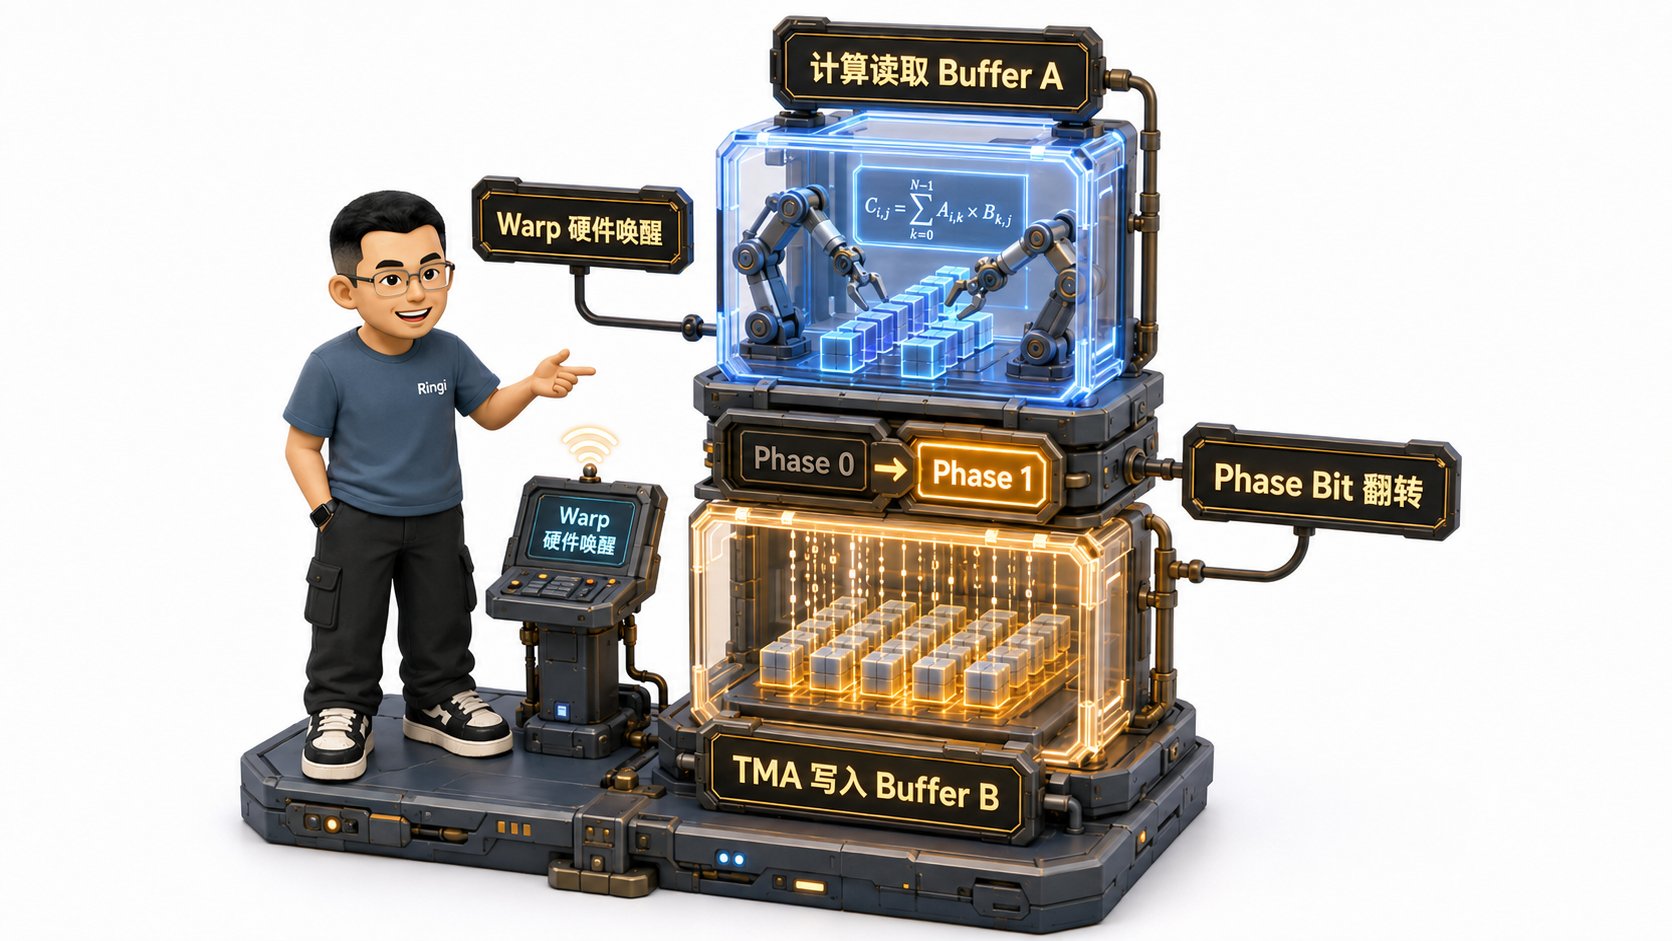
3.2 mbarrier 核心机制三位一体:字节级硬件计数 + Phase Bit 翻转 + Warp Scheduler 硬件挂起/唤醒
NVIDIA 从 Ampere 架构开始萌芽、在 Hopper 架构达到完全体形态的mbarrier(Memory Barrier,片上硬件异步屏障),从物理上终结了软件轮询。
它由三大硬件机制紧密咬合而成:
3.3 Ping-Pong 双缓冲异步流水线:计算读 Buffer A 时 TMA 写入 Buffer B,mbarrier 翻转后角色瞬间对调
在高性能算子内部,TMA 与mbarrier 最优雅的协同范式是 Ping-Pong(双缓冲双轨流水线):
4. 通算重叠(Overlap)的残酷真相:SM 竞争与 k 倍率膨胀
4.1 通算重叠不是免费的午餐:通信与计算同跑时,耗时发生的乘性膨胀
在很多架构师的理想图纸上,通算重叠被描述成一个近乎无损的美好公式: 然而,一旦你把通信 Kernel 与计算 Kernel 真实地挂到两个不同的 CUDA Stream 上并发运行,拿出 Nsight Systems 抓包,你会被冰冷的现实迎头痛击: 原本单独执行只需 1.0 毫秒的通信操作,在与计算重叠执行时,耗时居然悄悄膨胀到了 1.3 甚至 1.5 毫秒! 通信耗时相比单独独占执行,会出现一个明显的乘性膨胀系数 : 在大模型训练小规模集群的真实测试中:- 当与 Compute-Bound 的大 GEMM 算子重叠时,竞争相对缓和, ;
- 而当与 Memory-Bound 的 Attention、Softmax、RMSNorm 算子重叠时, 倍率会剧烈飙升至 !
4.2 资源争夺的五重战场:SM 核心配额、寄存器堆、L2 Cache 带宽、HBM 内存控制器、Warp 调度器
为什么会发生这种剧烈的性能膨胀?因为虽然开了不同的 CUDA Stream,但它们跑在同一颗物理硅片上,必须在微架构的五重战场上残酷厮杀:4.3 工业级破局利器:字节 Flux 的 sm_margin 显式预留切分,与 DeepEP Normal 的 Buffer.set_num_sms(n) 硬件级配额
面对残酷的 SM 争抢与 倍率膨胀,工业界最前沿的系统给出了硬核的工程破局方案:
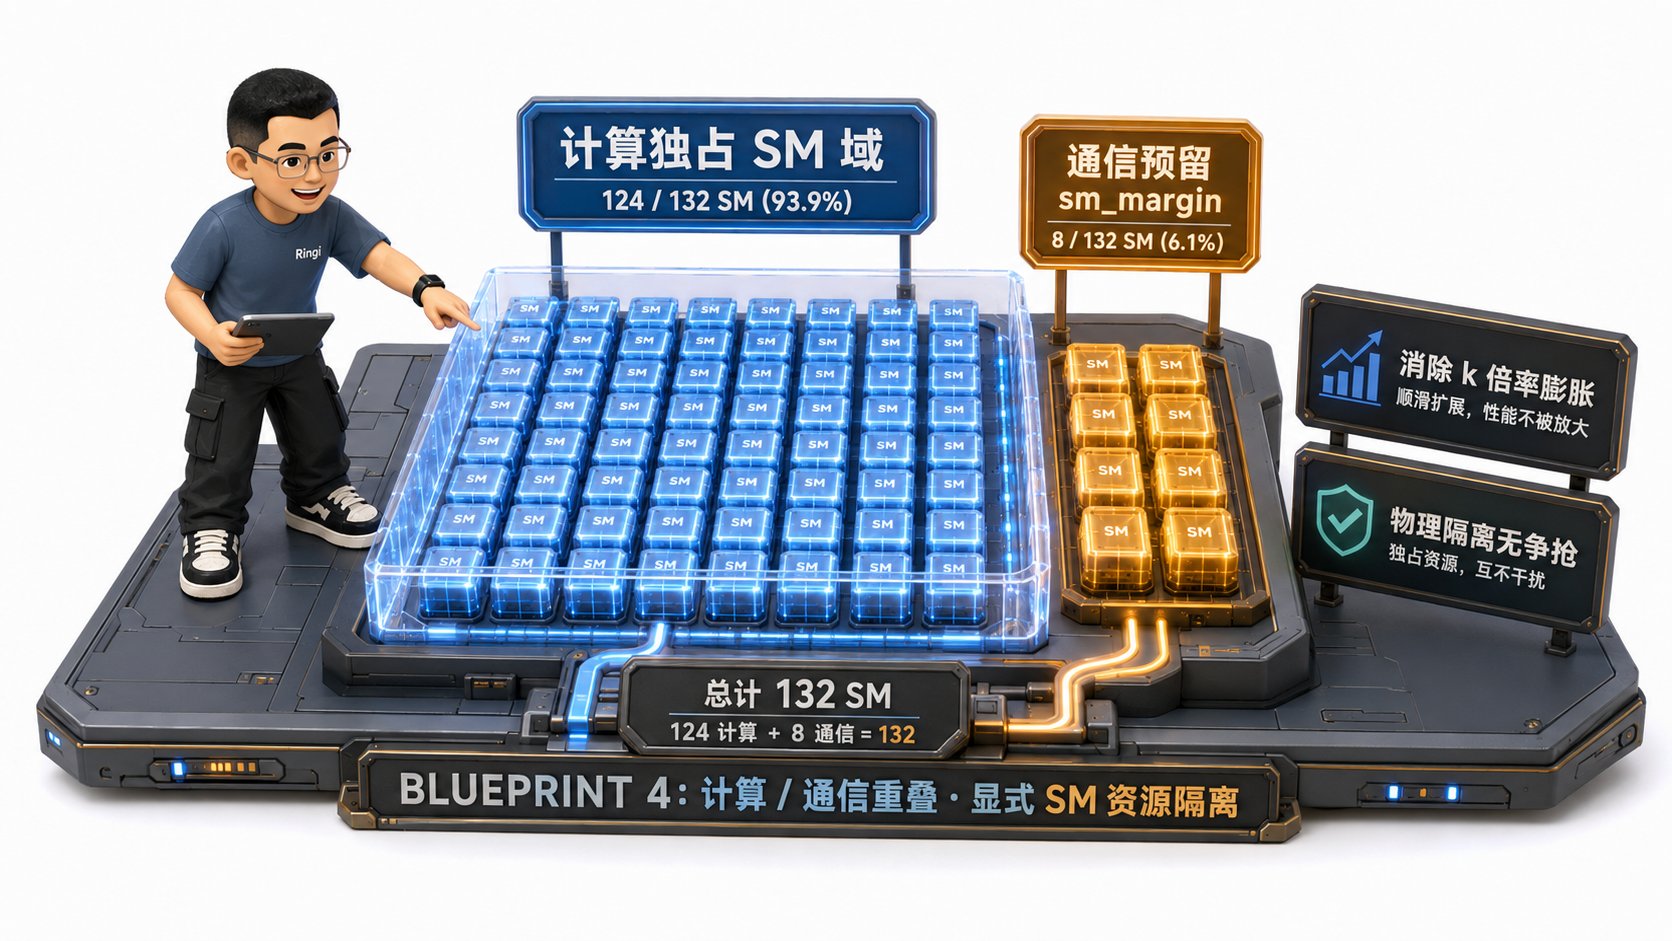
1. 字节 Flux 的 sm_margin 显式隔离参数
NCCL 默认只能通过全局环境变量 NCCL_MAX_NCHANNELS 极其粗暴地控制通道数,缺乏微观粒度。Flux 在其 GEMM + 通信融合 Kernel 中直接暴露了
sm_margin 参数:
- 允许开发者在代码中显式声明:
sm_margin = 8(即强行要求底层调度器仅划拨 8 个 SM 给通信专用); - 芯片上剩下的 124 个 SM 100% 独占给 GEMM 计算,严禁通信插入!
- 彻底固化了计算与通信在物理 SM 维度的边界,杜绝了无序竞争。
2. 深度求索 DeepEP 的 Buffer.set_num_sms(n) 配额
在 MoE 大模型通信库 DeepEP 中,Normal 模式直接提供了 Buffer.set_num_sms(n) 接口:
- 内部严格按照
num_channels = n / 2计算最优通信车道; - 开发者可根据当前层的算力特征动态调节:在算力冗余的 Compute-Bound 层多划拨几个 SM 给通信,在访存紧张的 Memory-Bound 层将 SM 配额压至最低,实现了全生命周期的自适应压榨!
4.4 激活值卸载(Activation Offloading)的三大必要条件:异步流、Pinned Memory 与 NUMA 亲和性
除了卡间通信,机内数据搬运的另一个高频场景是 显存卸载(Offloading):将暂时不用的激活值(Activations)通过 PCIe 搬到 CPU 内存,反向传播时再预取回来。 要想把 PCIe 5.0 的 64 GB/s 带宽打满,必须严格满足 三大不可违背的硬性契约:- 绝对异步流驱动(Asynchronous Stream):
严禁在默认流上调用阻塞式的
tensor.to('cpu'),必须在独立的通信流上发起非阻塞式copy_(),让 PCIe DMA 搬运与后续计算完全重叠; - 锁页内存(Pinned Host Memory):
普通的 CPU 内存页随时可能被操作系统换出到磁盘,GPU 硬件 DMA 引擎无法直接寻址。如果不事先调用
pin_memory(),数据必须在 CPU 内核中多做一次内存中转拷贝,传输有效带宽直接跌去 50% 以上; - 严格对齐 CPU NUMA 节点(NUMA Affinity): 双路服务器中,GPU 0 在物理上直连 CPU Socket 0。如果你的 CPU 锁页内存分配在 CPU Socket 1 上,PCIe 数据流必须横跨极度拥堵的跨 Socket UPI/QPI 总线,带宽瞬间暴跌 2 到 3 倍!
5. CUDA IPC 与跨卡共享内存:打破进程地址隔离
5.1 为什么机内跨 GPU 访问需要 IPC?(多进程架构下的虚拟显存地址空间隔离)
在现代大模型分布式系统(如 PyTorch DDP、Megatron-LM、vLLM)中,为了规避 Python 全局解释器锁(GIL)的性能锁死,最标准的部署模式是单机多进程(Multi-Process):即每个 GPU 绑定一个独立的 Linux 操作系统进程。 这带来了一个巨大的软件鸿沟:- 进程 A 与 进程 B 拥有完全隔离的虚拟内存地址空间;
- 即使物理上两张卡通过 NVLink 以 900 GB/s 的极速紧密相连,进程 B 也绝不可能直接拿着进程 A 里的一个虚拟显存指针(如
0x7f9a8000)去读写数据——这会立即引发操作系统的段错误(Segmentation Fault)!
5.2 cudaIpcGetMemHandle 与 cudaIpcOpenMemHandle 物理时序:句柄序列化与 NVLink P2P 900 GB/s 直通
CUDA IPC 的底层握手时序极其严整:
5.3 句柄生命周期管理:频繁申请/销毁的性能灾难 vs 持久化池化复用
在实际生产中,很多初级工程师在实现自定义跨卡通信时,经常在每次算子调用时都临时去申请一次 IPC Handle:cudaIpcOpenMemHandle与cudaIpcCloseMemHandle涉及操作系统的内核上下文切换、MMU 页表重置与 NVLink 路由表硬件寄存器刷新;- 单次调用耗时高达 数百微秒甚至毫秒级!这比通信本身还要慢两个数量级!
- 在系统初始化阶段(Warmup 阶段),一次性分配大块连续显存(Slab/Buffer);
- 跨进程交换一次 IPC Handle,各端长期持有映射得到的虚拟基地址;
- 运行时通信仅在共享显存内通过原子偏移量进行无锁读写,将运行时 IPC 握手开销彻底砸平为 0 纳秒!
5.4 对称内存(Symmetric Memory / NVSHMEM)的终极演进:批量化全局统一地址空间
CUDA IPC 本质上是点对点的“手动开通行证”。当集群规模扩大、多卡交互变得极其繁复时,NVIDIA 推动了体系结构的终极演进——Symmetric Memory(对称内存,NVSHMEM 基础)。 在对称内存模型中:- 节点内所有 GPU 在初始化时分配相同大小的对称显存池;
- 驱动程序在底层预先自动打通所有卡之间的全局地址映射;
- 任意一张卡上的线程,只需要知道目标卡号与内存相对偏移,即可直接使用类似于
nvshmem_float_p(dest_ptr, value, target_pe)的单边指令完成数据瞬移,代表了机内数据搬运的最高工程范式!
6. 生产典型故障排障实战指南
6.1 故障 A:Activation Offload 遭遇严重带宽腰斩(排查未锁定内存与跨 NUMA UPI 瓶颈)
当大模型分布式训练开启激活值卸载,发现单步耗时极长、PCIe 带宽仅有 10 GB/s 左右时,按以下两板斧排查:6.2 故障 B:TMA 与 MMA 流水线发生致命死锁(mbarrier 初始计数不匹配导致永久挂起)
在使用 Hopper TMA 开发自定义融合算子时,如果 Kernel 启动后毫无反应、GPU 处于 100% 假死状态,通常是mbarrier 计数器失步引发的死锁:
6.3 故障 C:CUDA IPC 句柄泄漏引发 Driver OOM(多进程频繁开闭 Handle 导致内核资源枯竭)
在长时间运行的大模型多进程推理服务中,如果频繁报错CUDA error: out of memory,但 nvidia-smi 显示显存非常充裕,这往往是 IPC 句柄内核泄露:
7. 动手实战与代码实验室(Minimal Runnable Code)
本实验室提供 4 套完全可运行、自包含的生产级机内数据搬运与 SM 争抢度量实验。7.1 实验 1:LSU vs Copy Engine 异步重叠与 SM 争用 k 倍率实测
本实验在本地真实测量:当通信操作与密集矩阵乘法(GEMM)在不同 Stream 上重叠运行时,通信耗时发生的乘性膨胀 倍率:7.2 实验 2:CUDA IPC 跨进程零拷贝显存共享与 NVLink 直通仿真
本实验利用多进程模型,完整演示基于 CUDA IPC 句柄的跨进程显存零拷贝共享与 NVLink P2P 读写逻辑:7.3 实验 3:TMA + mbarrier 硬件异步双缓冲流水线状态机仿真
本实验用纯 Python 状态机,精确还原 Hopper 架构下 字节级计数追踪、Phase Bit 翻转防 ABA 问题、以及 Ping-Pong 双缓冲无缝流水调度:7.4 实验 4:Activation Offloading 卸载 vs 重计算(Checkpointing)代价判决天平
本实验建立系统级决策模型:根据当前 GPU 显存容量、PCIe 带宽、Sequence Length 与计算算力,定量推导何时应该选择“搬运换显存”,何时应该选择“算力换显存”:8. Ringi 避坑指南与生产性能工程黄金 Checklist
8.1 避坑表格(8 组常见小白机内搬运误区 vs 大厂正解)
8.2 生产环境机内数据搬运黄金十条 Checklist
📋 生产环境机内数据搬运与硬件卸载黄金 Checklist (Ringi 审稿器)
- 1. 【搬运与计算解耦】:严格审查算子内部数据流,大块纯数据搬运坚决剔除出寄存器中转链路,优先启用 TMA 直通 Shared Memory。
- 2. 【搬运体量阈值对齐】:在 Kernel 优化中坚持分级策略:小于 1KB 走 LSU,大于 2KB 走 TMA,严禁对碎片标量滥用异步描述符。
- 3. 【硬件屏障闭环】:使用 TMA 时必须强制绑定
mbarrier,严禁在 Shared Memory 中编写volatile标志位进行软件死循环轮询。 - 4. 【Ping-Pong 双缓冲设计】:共享内存必须设计为双缓冲或多缓冲结构,确保计算消费 Buffer A 时,TMA 硬件在后台独立向 Buffer B 灌入数据。
- 5. 【SM 竞争显式配额】:在大规模通算融合算子中,显式通过类似
sm_margin或Buffer.set_num_sms设置配额,为计算核心预留绝对独占阵地。 - 6. 【锁页内存强制声明】:所有涉及 Host ↔ Device 异步传输的内存缓冲区,在申请时必须强制声明
pin_memory=True。 - 7. 【NUMA 亲和性锁死】:多路 CPU 服务器上启动分布式训练时,必须使用
numactl将进程严格绑定在与物理 GPU 处于同一 PCIe 域的 CPU Socket 上。 - 8. 【CUDA IPC 句柄预热池化】:跨进程共享显存必须在 Warmup 阶段一次性建立映射,严禁在迭代热循环中高频触发
cudaIpcOpenMemHandle。 - 9. 【归约与搬运明确分流】:纯搬运操作(AllGather)积极探索 CE / SM-Free 路径;含计算操作(AllReduce)坚决依托 SM 算术流水线深度融合。
- 10. 【通算重叠 k 倍率压测】:在大规模上线 Overlap 算子前,必须在真机上实测独占耗时与并发耗时,确认 k < 1.15 具备真实收益后再行合入。
9. Ringi 5 点核心速记口诀、自我检验清单与课后深度思考题
9.1 5 点押韵核心速记口诀
9.2 10 条白板自我检验清单
- 1. 为什么说“SM 做搬运就不能做计算”是一个绝对的零和博弈?
- 2. 画出传统的 SM LSU 搬运与 Hopper 架构 TMA 异步搬运的数据流动路径,标明寄存器文件的参与状态。
- 3. 什么是 TMA 内部集成的硬件 AGU(地址生成单元)?它为开发者省去了哪些底层指令?
- 4. 为什么小数据量(<1KB)下 LSU 的延迟反而优于 TMA?物理拐点由什么决定?
- 5. 为什么 Copy Engine(CE)不能在 GPU Kernel 内部由线程直接调用?
- 6. 详细阐述
mbarrier硬件屏障的工作机理:字节级计数与 Phase Bit 翻转是如何消除软件轮询和 ABA 问题的? - 7. 什么是通算重叠中的 倍率时间膨胀?它在哪些微架构硬件资源上爆发了激烈冲突?
- 8. 字节跳动的 Flux 架构是如何通过
sm_margin参数在算子内部划分计算与通信边界的? - 9. 为什么多进程架构下跨卡访问显存需要调用
cudaIpcGetMemHandle?它与 Host 内存中转有何物理区别? - 10. 为什么在训练热循环中高频调用
cudaIpcOpenMemHandle会引发性能灾难?工业界如何进行池化管理?
9.3 3 道高阶开放式课后思考题(含极端 Corner Case)
-
Hopper Persistent Threadblock 下 TMA 与 MMA 的极致微观调频:
在 Hopper H100 架构上,单个 Persistent Threadblock 内部通常分配 1 个 Producer Warp 负责发射 TMA 指令,以及 3~4 个 Consumer Warps 负责执行 Tensor Core MMA 计算。如果 Producer Warp 的 TMA 搬运速度极快(如从 L2 缓存命中),而 Consumer Warps 的矩阵乘加计算速度稍慢,流水线中会出现什么样的微架构反压(Backpressure)?反之,如果发生显存严重未命中,Producer Warp 产生停顿,Consumer Warps 的
mbarrier.wait会如何被调度器压制?在大厂底层内核优化中,如何通过调节 Register Allocation 与 Shared Memory Bank 映射达到两者的黄金共振点? - 跨 NUMA 激活值卸载与 CPU 内存带宽饱和风暴: 在长文本大模型训练中,当 Sequence Length 扩大至 128K 时,单张 GPU 需要卸载的激活值规模高达数十 GB。如果在单机 8 卡节点上,所有 8 张 GPU 同时通过 PCIe 5.0 异步向 CPU 内存发起卸载,会导致服务器 CPU 端的 DDR5 内存控制器瞬间陷入死锁级的内存饱和(Memory Bus Congestion)。作为 AI Infra 架构师,你该如何设计一套基于微批次时间差(Staggered Offloading Pipeline)或结合 CPU 侧直接压缩(In-Flight Compression)的调度流控机制,来平抑对主机内存系统的冲击?
-
CUDA IPC 跨节点扩展的物理失效与 Unified Memory(UVM)演进:
CUDA IPC 仅在“单机物理机箱内部”(通过 PCIe Switch 或 NVLink 互联)生效,一旦跨越机箱边界,
cudaIpcOpenMemHandle会直接报错崩溃。为什么操作系统的虚拟内存句柄无法跨越物理以太网/IB 网络?而在 Grace Hopper(GH200)或 GB200 等超节点(NVL72)大一统架构下,基于 NVLink-C2C 与硬件级跨机缓存一致性(Cache Coherence),未来的多进程显存共享机制会发生怎样根本性的范式洗牌?
10. 📚 参考资料与核心源码/经典论文指引
- 顶级 AI 通信底层权威论述:
- 廖一桥(快手可灵 AI Infra 训练团队): 大模型通信基础 2.3 机内数据搬运, 2024. (系统解密 SM-Free 阶梯、TMA/LSU 硬件机理、mbarrier 屏障与通算重叠 k 倍率的巅峰力作,收录于本地
AI_BOOK/GPU通信/) - 廖一桥: 从零开始的通信计算overlap【第一章】, 2024. (通信计算重叠第一性原理,收录于本地
AI_BOOK/GPU通信/)
- 廖一桥(快手可灵 AI Infra 训练团队): 大模型通信基础 2.3 机内数据搬运, 2024. (系统解密 SM-Free 阶梯、TMA/LSU 硬件机理、mbarrier 屏障与通算重叠 k 倍率的巅峰力作,收录于本地
- 官方硬件微架构与编程指南:
- NVIDIA Corporation: NVIDIA Hopper Architecture In-Depth (H100 Whitepaper), 2022. (权威解剖 TMA 引擎、Asynchronous Transfer 与 mbarrier 硬件架构)
- NVIDIA: CUDA C++ Programming Guide - Asynchronous Data Copies and Tensor Memory Accelerator, Release 12.x.
- NVIDIA: CUDA Interprocess Communication (IPC) Documentation & Best Practices, 2023.
- 前沿工业界开源项目与学术论文:
- ByteDance Inc.: Flux: Fast Software-based Communication Overlap Library for LLM Training, GitHub:
bytedance/flux, 2024. (深入学习sm_margin显式预留与 Dense MLP 通算融合) - DeepSeek-AI: DeepEP: An Efficient Expert-Parallel Communication Library for Large-Scale MoE Training and Inference, 2024. (学习
Buffer.set_num_sms配额机制与 CUDA IPC 缓冲区管理)
- ByteDance Inc.: Flux: Fast Software-based Communication Overlap Library for LLM Training, GitHub:
附录:Appendix A — 大厂硬核高频面试题与白板推导(Interview Drill)
💬 面试题 1:请在白板上手绘出从 Ampere(LSU + cp.async)到 Hopper(TMA + mbarrier)的机内数据搬运演进时序图,标明通用寄存器、Shared Memory 与 SM 指令发射管线的参与度。
🎯 大厂标准答题路径与白板推导:
- Ampere 时代(cp.async 阶段):
- 时序推导:线程依然需要通过通用算术指令在寄存器中计算出多维地址,然后发射一条
cp.async指令;- 参与度:数据虽然可以绕过通用寄存器直达 Shared Memory,但地址计算(AGU 任务)仍然由 SM 标量计算单元分摊,且每个线程必须各自发射指令;
- 同步机制:依赖
cp.async.wait_all或cp.async.wait_group,属于粗粒度的组同步。- Hopper 时代(TMA + mbarrier 阶段):
- 时序推导:SM 仅由 1 个线程发射 1 条
cp.async.bulk指令,随后整个 Warp 彻底解放;- 参与度:通用寄存器占用 = 0,地址计算指令 = 0(TMA 硬件 AGU 自带算盘),数据经 L2 直灌 Shared Memory;
- 同步机制:硬件级
mbarrier接管,字节级到达自动递减,Phase 自动翻转,Warp 调度器硬件休眠与唤醒,彻底实现数据面与控制面双重 SM-Free!
💬 面试题 2:为什么 Copy Engine(CE)不能在 GPU Kernel 内部被线程直接调用?在遇到需要同时进行搬运与归约(如 AllReduce)的机内通信场景时,现代通信库是如何在 SM 占用与通信延迟之间做权衡的?
🎯 大厂标准答题路径与白板推导:
- CE 无法在 Kernel 内调用的微架构根因:
- 硬件控制域隔离:CE 由 GPU 的前端主机接口与命令处理器(Command Processor)管理,只认宏观 Command Buffer 队列;SM 属于微观执行引擎,两者处于不同的时钟域与调度域;
- 延迟粒度鸿沟:CE 的启动与仲裁开销在微秒(μs)级,而 Kernel 内部指令调度在纳秒(ns)级,将粗粒度设备暴露给细粒度线程会导致严重的资源死锁与仲裁崩塌。
- 搬运与归约的权衡法则(NCCL 实践):
- 物理约束:CE 是纯 DMA 引擎,无浮点加法器(ALU);若纯用 CE,必须“CE 搬到显存 ➔ 启动加法 Kernel ➔ CE 再次搬运”,造成多倍显存流量;
- 工程折中:NCCL 机内 AllReduce 放弃 CE,选择划拨少量 SM(例如 8~16 个 Channel,占总 SM 数的 5%~10%);
- 流水线收益:让这些专职 SM 的 LSU/TMA 管线在从 NVLink 读取邻居卡数据的同时,就地在片上高速缓存中完成加法归约并立刻转发,以少量的 SM 牺牲换取了翻倍的有效显存带宽与极致微秒级延迟!
💬 面试题 3:详细推导为什么通信与计算同时重叠执行(Overlap)时会出现“k 倍率时间膨胀”?它与理论上的“完全掩盖(Zero Overhead Overlap)”冲突在哪些具体的微架构硬件资源上?工业界如何通过 sm_margin 破解?
🎯 大厂标准答题路径与白板推导:
- 数学模型与现象:
- 理论公式假设两者物理互不相干: ;
- 实际上实测通信耗时膨胀: ( )。
- 微架构资源的五大冲突点:
- L2 Cache 带宽挤占:跨卡 NVLink 传输的大流量穿透 L2,冲垮了 GEMM 矩阵计算的权重缓存命中,迫使计算线程向 HBM 发起昂贵的重加载;
- 内存控制器(Memory Controller)排队:通信的突发写入与计算的密集读取在片外显存总线端口迎头相撞,队列溢出导致平均延迟翻倍;
- SM 与寄存器配额争夺:通信 Kernel 占用的 SM 无法跑计算,降低了全局 Occupancy;
- Warp 调度器发射槽仲裁:同一 SM 上计算与通信 Warp 互相挤压发射周期。
- 工业级破解利器(以 Flux
sm_margin为例):
- 在融合 Kernel 中直接硬编码物理隔离:例如总共 132 个 SM,显式设置
sm_margin = 8,限定通信只准在特定的 8 个 SM 上运行;- 剩余 124 个 SM 形成“计算禁区”,完全不受通信 Warp 调度与寄存器分配的干扰,将 倍率的恶劣影响物理封印在局部,保全核心算力!
💬 面试题 4:在多进程训练中,CUDA IPC 是如何实现单机 8 卡之间显存零拷贝共享的?频繁调用 cudaIpcOpenMemHandle 会带来什么生产隐患?如何实现优雅的持久化池化?
🎯 大厂标准答题路径与白板推导:
- CUDA IPC 的底层实现:
- 进程 A 通过
cudaIpcGetMemHandle获取物理显存的全局 64 字节硬件描述符;- 进程 B 通过 Unix Domain Socket 接收该句柄,并调用
cudaIpcOpenMemHandle;- NVIDIA 统一内存驱动(UVM)修改进程 B 的页表,把卡 0 的物理显存总线地址直接映射到进程 B 的虚拟地址空间;
- 进程 B 的 GPU 1 可以直接通过指针经由 NVLink Switch 发起 P2P 读写,零 CPU 拷贝、零 Host 内存中转,跑满 900 GB/s 物理线速!
- 动态开闭的生产隐患:
cudaIpcOpenMemHandle涉及操作系统内核调用(ioctl)、跨进程安全审计、MMU 页表更新与硬件 MMU 刷新;- 单次开闭耗时在毫秒级,如果在训练热循环中反复调用,会导致系统发生严重的驱动级抖动与内核锁争用,甚至引发 Driver 内核资源泄露导致假性 OOM。
- 优雅池化方案(Persistent IPC Pool):
- 初始化对齐:在分布式初始化阶段,各卡一次性预分配固定大小的连续显存池(Buffer Pool);
- 全局握手一次:交换一次 IPC Handle,各进程建立并长期维持映射基地址;
- 运行时零握手:后续高频通信仅在本地计算相对字节偏移量(
base_ptr + offset),结合原子标志位无锁推进,实现真正的运行时零开销共享!