🏛️ 第10讲:AI Infra 性能工程方法论与三账本——FLOPs、显存与通信
主讲人:👓 Ringi(大厂 AI Infrastructure 工程师)
所属模块:Module 00: 性能工程与系统前置
篇章范式:🏛️ 性能工程与系统前置篇(Performance Engineering & System Baseline)
核心导读:一个顶级的 AI Infra 工程师与普通算法调包侠之间,最根本的分水岭是什么?不是看谁能背出更多的 PyTorch API,而是看谁拥有**“在写下第一行代码前,就能在草稿纸上精确算清整个系统算力、显存与网络通信物理账本”的硬核内功**!
很多初入大厂的同学,面对一个全新的大模型训练或推理任务时,往往两眼一抹黑:不知道该申请 8 张卡还是 64 张卡、不知道 Batch Size 设多大才不会 OOM、不知道nvidia-smi里的 GPU-Util 99% 背后其实隐藏着极其严重的内存等待、更不知道集群训练速度慢究竟是卡在 Tensor Core 算力不足、显存带宽受限(Memory-Bound)还是被跨机 AllReduce 网络活活拖垮。
性能工程的本质就是“算账”。本讲作为 Module 00 的终极集大成篇,我们将彻底告别盲目试错,用极客大白话、生活直觉比喻、手把手极简数字算盘与 Roofline 物理模型,带你手撕大模型 算力账本( )、显存四账本与跨卡通信账本,彻底掌握千卡集群资源规划的最高心法!
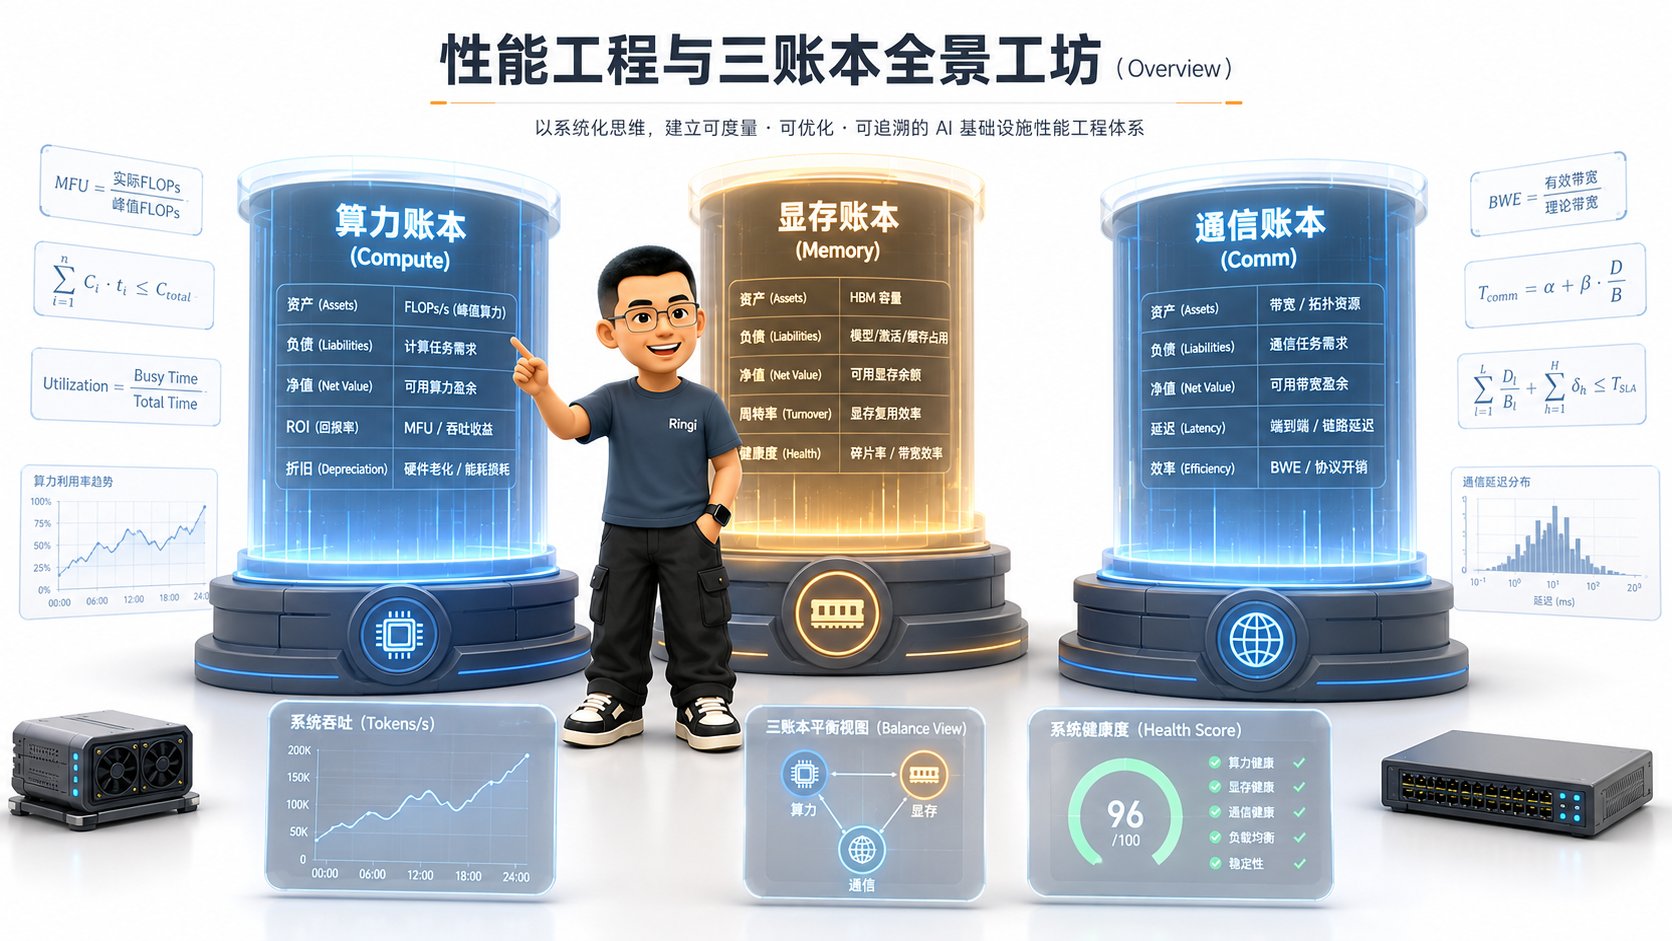
📑 目录导航
- 0. Ringi 开场:系统调优的第一步不是写代码,而是“算账”!
- 1. 核心性能指标体系与大厂 SLO 深度解构
- 2. 账本一:算力计算量账本(Compute Ledger)
- 3. 账本二:显存容量与吞吐账本(Memory Ledger)
- 4. 账本三:跨卡跨机通信账本(Communication Ledger)
- 5. 性能瓶颈归因:Roofline 算术强度模型与决策树
- 6. 工业级白板大实战:LLaMA-2/3 7B 与 70B 全生命周期资源大算盘
- 7. 动手实战与代码实验室(Minimal Runnable Code)
- 8. Ringi 避坑指南与生产最佳实践
- 9. Ringi 5 点核心速记口诀、自我检验清单与课后深度思考题
- 10. 📚 参考资料与核心源码/经典论文指引
- 附录:Appendix A — 大厂硬核高频面试题与白板推导(Interview Drill)
0. Ringi 开场:系统调优的第一步不是写代码,而是“算账”!
0.1 汽车改装与赛道账本比喻:为什么 AI Infra 工程师必须精通算账?
假设你是一位世界顶级的赛车改装总工程师。车队准备参加一场 500 公里的拉力赛:- 你会在比赛前一天盲目地把油箱加满,然后跟赛车手说:“你上去随便开,开到哪算哪,跑慢了我们再换发动机”吗?
- 绝对不可能!在发车前,你必须在战术板上精确计算好每一笔账:每圈消耗多少升燃油(算力/能耗账本)、轮胎磨损极限在第几圈(显存账本)、进站加油换胎需要多少秒(通信/IO 账本)。只有把这三本账算到毫秒级,车队才能夺冠!
- 一台装配了 8 张 NVIDIA H100 的服务器售价高达上百万元,集群租金每小时都在飞速燃烧美金;
- 一个合格的 AI Infra 工程师,绝不能靠盲目尝试去调优系统! 在你提交训练任务或上线推理服务之前,你必须能够用一张纸、一支笔,在 3 分钟内精准手算出:这个模型需要消耗多少 TFLOPS 算力、显存峰值会不会突破 80GB、跨机网络传输会不会卡死流水线!
0.2 线上真实惨案:资源预估偏差 3 倍引发的千万元算力预算打水漂事故
在参与某大厂千亿大模型预训练集群规划时,我曾亲历过一起因“不会算账”而导致的重大事故:- 业务需求:算法团队计划在 3 个月内预训练一个 70B 模型,目标训练数据量为 2 万亿(2T)Tokens;
- 草率估算:负责人简单拍脑袋:“70B 模型嘛,我们租 128 张 A100-80GB 显卡跑 3 个月肯定够了”;
- 残酷现实:任务上线跑了一个月后,发现才刚刚跑完 20% 的进度!
- 血淋淋的物理账本复盘:
- 训练 70B 模型需要总算力:
- 128 张 A100 即使在极限 50% MFU 效率下,每秒总算力仅为: ;
- 跑完 2T Tokens 所需的物理净时间为:
- 后果:原本规划 3 个月的项目延期了整整一年多,不得不紧急追加采购 512 张 GPU,浪费了数千万元的算力闲置与违约成本!
0.3 AI Infra 核心性能指标与大厂 SLO 映射全景表
1. 核心性能指标体系与大厂 SLO 深度解构
1.1 吞吐量指标:Tokens/s、Samples/s 与集群吞吐
- 训练吞吐(Training Throughput):通常用
Samples/sec(每秒训练多少条样本)或Tokens/sec/GPU(单卡每秒消费多少 Token)衡量; - 推理吞吐(Serving Throughput):衡量单个推理节点在满足延迟约束(SLO)的前提下,每秒钟能够并发生成的总
Output Tokens/sec。
1.2 时延指标:TTFT(首字延迟)、TPOT(字间延迟)与 P99 长尾分布
在大模型在线服务(LLM Serving)中,用户体验被拆解为两个截然不同的物理时延:- TTFT(Time To First Token):由 Prefill 阶段 决定。因为要一次性处理用户输入的全部上下文,计算量极大,属于 算力受限(Compute-Bound);
- TPOT(Time Per Output Token):由 Decode 阶段 决定。每一步只生成 1 个 Token,但每一步都要把几十 GB 的模型权重完整搬运一遍,属于 显存带宽受限(Memory-Bound);
- P99 长尾延迟(Tail Latency):在大并发下,99% 的请求都能在几秒内返回,但由于显存碎片或排队阻塞,最后 1% 的请求可能会卡死几十秒。
1.3 算力利用率:TFLOPS、HFU 与 MFU 的第一性原理与数学推导
在大厂性能评测中,衡量一个分布式训练系统是否顶级,唯一公认的硬核指标就是 MFU(Model FLOPs Utilization)。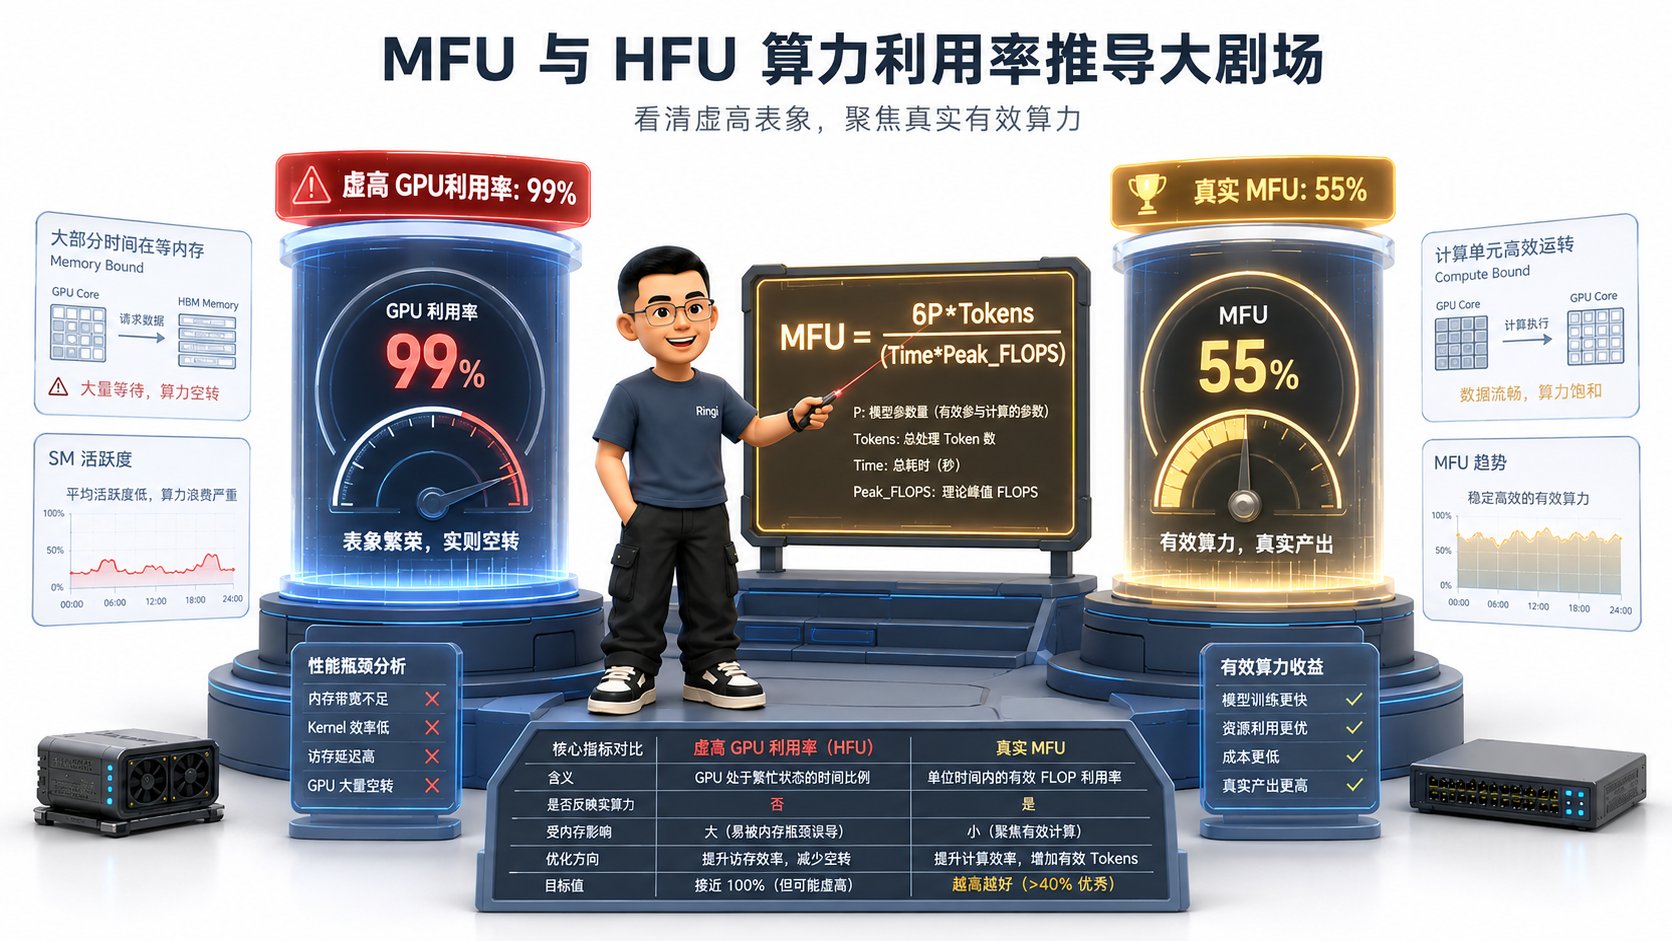
1. 硬件理论峰值算力(Peak Hardware TFLOPS)
以 NVIDIA A100-SXM4-80GB 为例:- FP32 传统 CUDA Core 算力: ;
- BF16 / FP16 Tensor Core 密集算力: (不考虑稀疏化)。
2. 硬件浮点利用率(HFU, Hardware FLOPs Utilization)
3. 模型浮点利用率(MFU, Model FLOPs Utilization,最高准则)
💡 Ringi 工程师第一性原理:
- 如果你为了省显存开启了激活值全重计算(Full Checkpointing),硬件实际上多算了 的计算量(总计算量变成了 );
- 此时,
HFU会显得很高(因为 GPU 确实在拼命多算),但MFU严格只除以理论净计算量 !- 只有 MFU 才能真实反映你消耗的电费和美金到底有多少转化为了有效的训练进度! 在大厂万卡集群上,MFU 能够达到 50%~55% 就属于世界顶级水准。
1.4 惊天谎言:为什么 nvidia-smi 里的 GPU-Util 99% 根本不代表卡跑满了?!
这是无数小白工程师最容易犯的致命误区:
💥 Ringi 揭秘底层硬件真相:
nvidia-smi中的GPU-Util采样指标,其底层定义是:在过去 1 秒钟内,GPU 内部至少有 1 个 Warp 处于活动状态的时间百分比!- 如果你的代码在每个 Step 都从 HBM 慢速读取显存,或者卡在 Python CPU Launch 发射瓶颈上,GPU 核心处于 90% 的空转等待(Warp Stalled on Memory),但因为内核尚未结束,
nvidia-smi依然会极其讽刺地显示GPU-Util: 99%!- 看 GPU 真实利用率的唯一权威指标是:实际算力 TFLOPS / MFU 与 GPU 功耗瓦数(Power Usage)!
2. 账本一:算力计算量账本(Compute Ledger)
现在我们手把手推导 AI 性能工程最著名的 计算量法则。2.1 单次 GEMM 矩阵乘法的计算量为什么是 FLOPs?
设有两个矩阵相乘: 与 ,相乘得到 。🔢 极简数字小算盘推导:
- 输出矩阵 总共有 个元素;
- 为了计算 中的每一个元素 ,需要将 的第 行(长为 )与 的第 列(长为 )做向量内积:
- 计算这一个元素需要:
- 次乘法(Multiply);
- 次加法(Add);
- 总计需要 次浮点运算(FLOPs)!
- 总计算量推导:
2.2 大模型推理单 Token 计算量推导:为什么是 FLOPs/token?
设一个 Transformer 模型的总参数量为 (以 70B 模型为例, ):- 在自回归推理(Decode 阶段)生成 1 个 Token 时,输入张量维度为 ;
- 输入向量需要与模型中所有的全连接权重矩阵( )依次进行矩阵相乘(GEMV);
- 对于每一个参数矩阵 ,输入为 ,其计算量为:
- 将全模型所有层的参数矩阵累加求和,忽略占比不足 1% 的 LayerNorm 和 Softmax:
💡 极简直觉记忆:大模型推理生成 1 个 Token,相当于让模型的每一个参数都参与了 1 次乘法和 1 次加法(共 2 次浮点运算)!
2.3 大模型训练单 Token 计算量推导:为什么前向 + 反向 = FLOPs/token?
在模型训练过程中,每个 Token 的生命周期包含 前向传播(Forward) 与 反向传播(Backward) 两个阶段:📌 Ringi 工程师第一性原理:
反向传播的计算量恰好是前向传播的 整整 2 倍( )!因为反向传播必须执行两次独立的矩阵乘法:一次用于将梯度传给浅层(算 ),另一次用于更新本地权重参数(算 )。
2.4 激活值重计算下的计算量膨胀:为什么 Full Checkpointing 会变成 FLOPs?
在大模型训练中,为了防止反向传播保存过多中间激活值而导致显存 OOM,业界普遍采用 激活值重计算(Activation Checkpointing):- 前向计算:正常执行一次前向( FLOPs),但不保存任何 Block 的中间激活值;
- 反向计算:在反向求导到达某一层之前,重新跑一遍该层的前向计算(多花 FLOPs),再立即执行反向梯度求解( FLOPs);
- 总计算量膨胀:
- 性能代价(Trade-off):计算量增加了 ,但换来了显存占用从 到 的惊人飞跃!
3. 账本二:显存容量与吞吐账本(Memory Ledger)
在大模型系统中,显存消耗可以被绝对清晰地划分为 静态显存 与 动态显存 两大部分。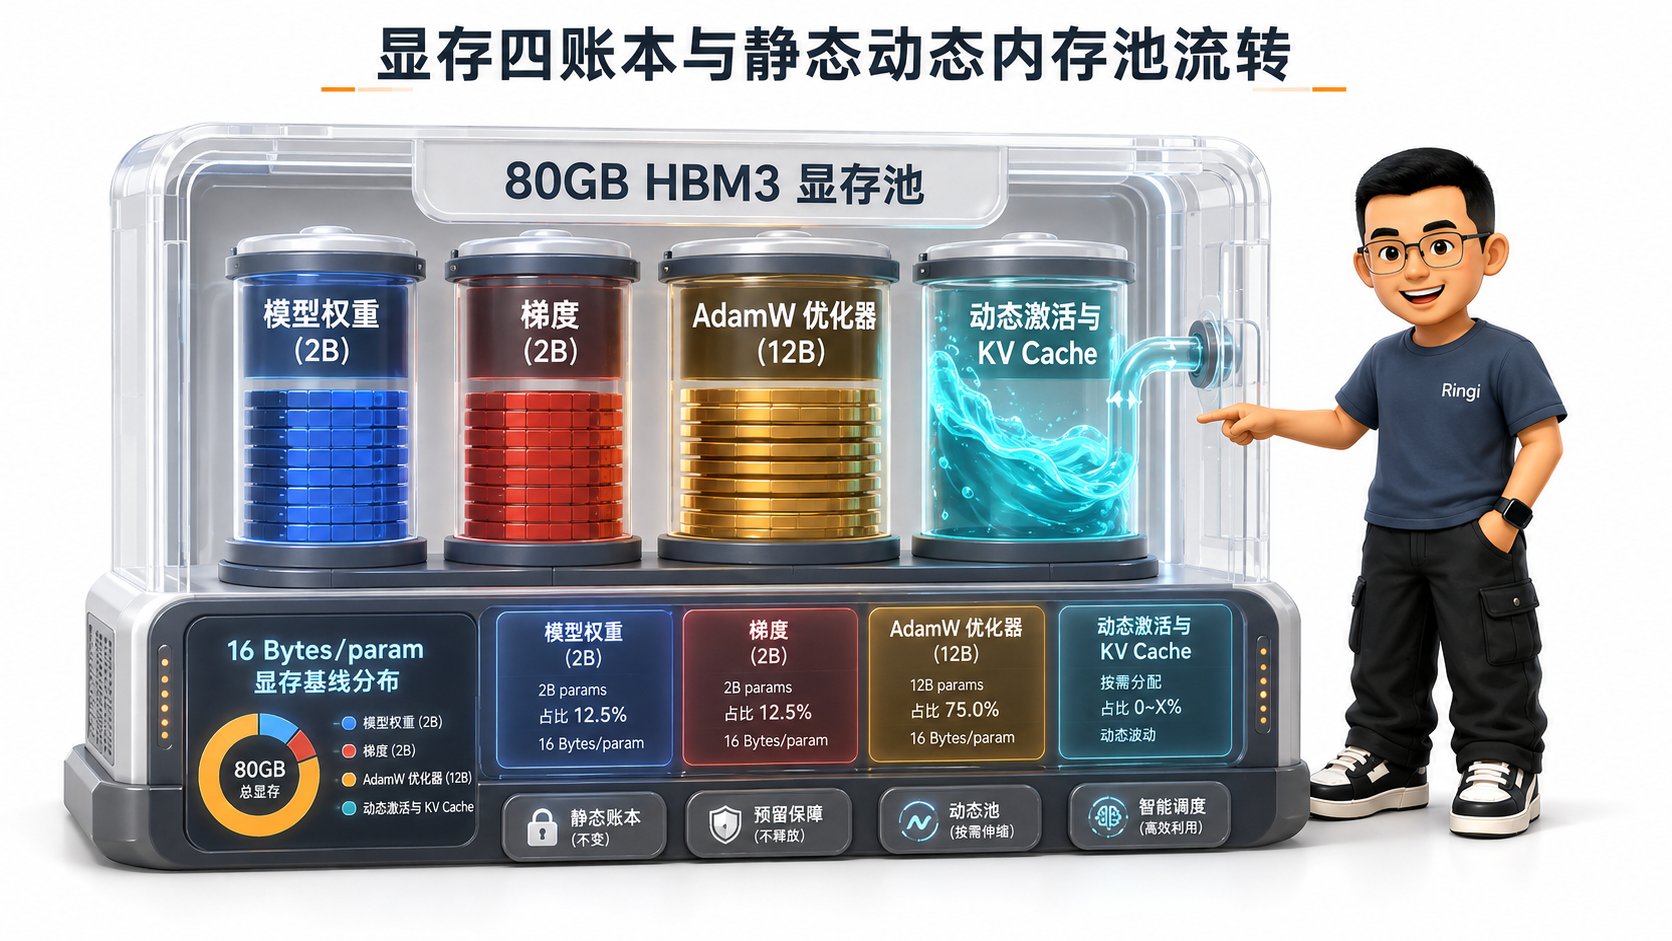
3.1 静态显存四账本:Weights、Gradients、AdamW 优化器(16 Bytes/param)与 Master Weights
以标准混合精度训练(Mixed Precision Training, FP16/BF16)为例,每个参数 在显存中对应四笔不可动摇的刚性开销:3.2 动态显存账本 1:前向激活值(Activations)显存精细手算公式
前向计算过程中,算子(如 RMSNorm、Attention Softmax、SwiGLU)产生的中间输出张量必须被暂存在显存中,供反向传播求导使用。 设单层 Transformer Block 的配置为:批大小 ,序列长度 ,隐藏维度 ,头数 :- 未开启 FlashAttention 时的单层激活值显存:
- 开启 FlashAttention-2 后(消灭了 中间矩阵存储):
3.3 动态显存账本 2:推理 KV Cache 显存手算公式与并发海啸
在 LLM 在线推理服务中,KV Cache 是随并发请求与序列长度疯狂膨胀的显存巨兽:🔢 极简数字小算盘手算(LLaMA-3-70B,采用 GQA):
- 配置: 层,KV 头数 ,单头维度 ,FP16 占 2 字节;
- 单 Token 的 KV Cache 显存为:
- 当并发批大小 ,上下文长度 时:
3.4 动态显存账本 3:临时工作区(Workspace Buffers)与显存碎片留白
在 GPU 运行时中,cuBLAS / CUTLASS 矩阵乘法、NCCL 集合通信缓冲区通常需要预留 的 Workspace 临时显存。此外,为了防止 PyTorch 显存分配器碎片化引发虚假 OOM,线上生产系统必须保留至少 10%~15% 的显存安全余量(Headroom)!
4. 账本三:跨卡跨机通信账本(Communication Ledger)
在大模型分布式训练中,不同并行范式的跨卡网络通信量可以通过参数量 进行精确量化:5. 性能瓶颈归因:Roofline 算术强度模型与决策树
5.1 Roofline 物理模型坐标系的人话直觉(横轴 FLOP/Byte vs 纵轴 TFLOPS)
Roofline(屋顶线模型,Williams et al., 2009)是计算机体系结构中定位一切性能瓶颈的最高裁判所: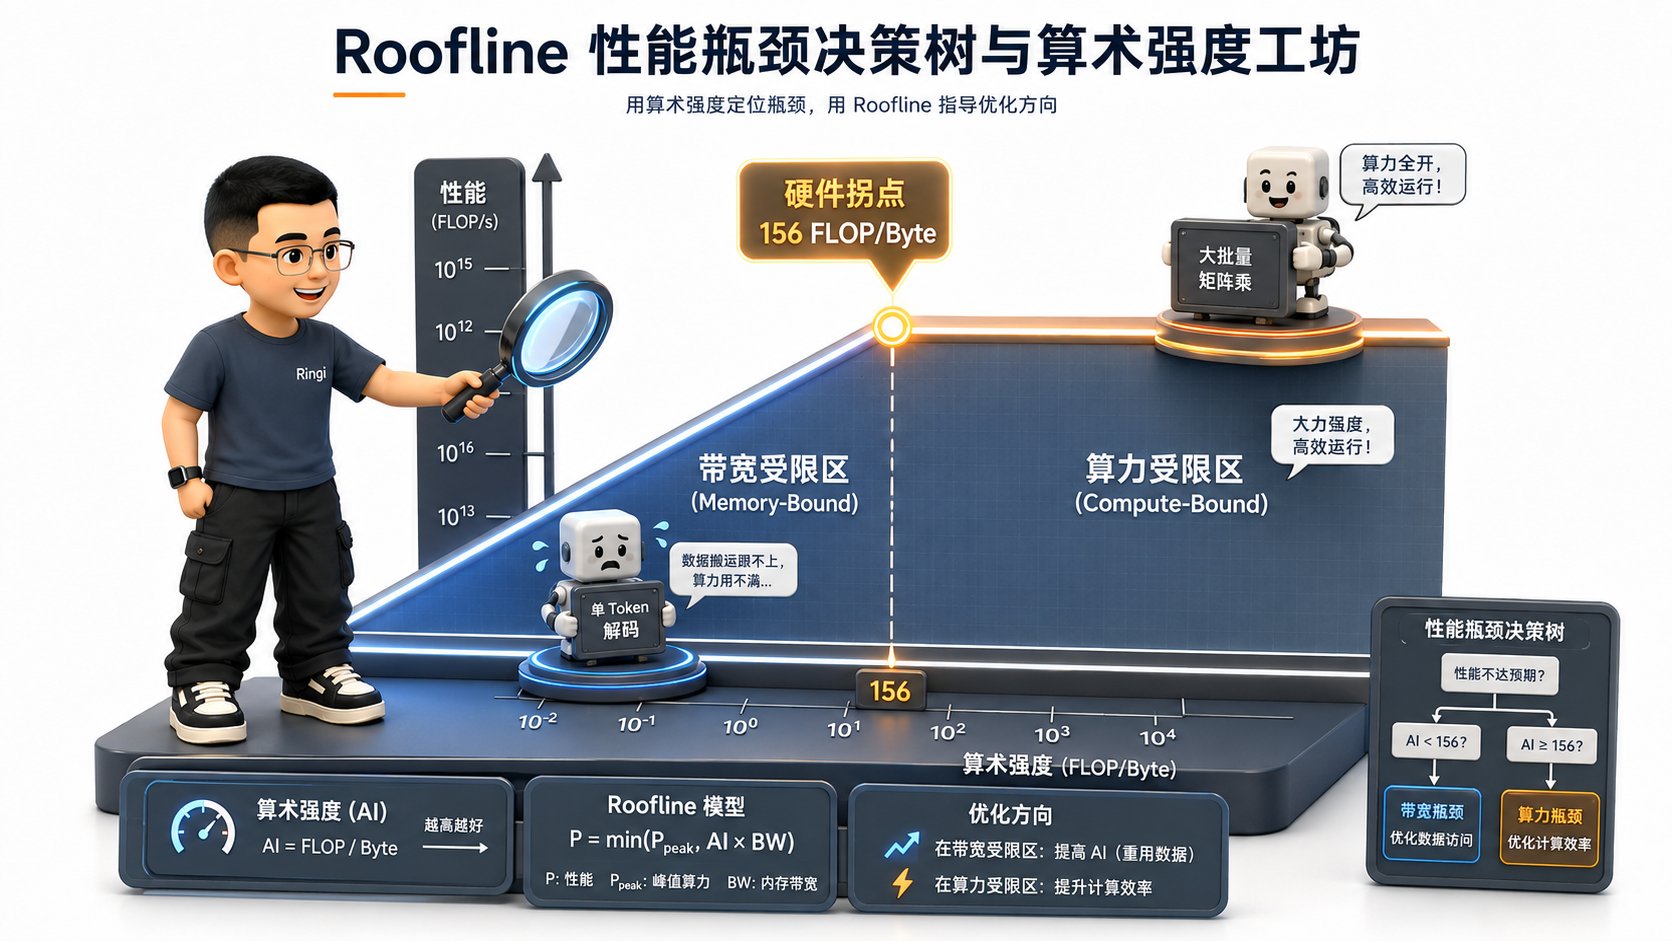
- 横坐标:算术强度(Operational / Arithmetic Intensity, AI):
- 人话解释:“每从慢速显存里搬运 1 个字节的数据,GPU 核心能对它做多少次计算?”
- 纵坐标:实际性能(Attainable Performance):以
TFLOPS为单位的实际计算吞吐。
5.2 硬件拐点(Turning Point)计算公式与物理意义
屋顶由斜坡(带宽上限)和天花板(算力上限)构成,两者的交点就是 硬件物理拐点(Turning Point, ):🔢 顶级 GPU 硬件拐点手算:
- NVIDIA A100-SXM4-80GB:
- 峰值算力: (BF16 Tensor Core)
- 显存带宽: (HBM2e)
- NVIDIA H100-SXM5-80GB:
- 峰值算力: (FP16/BF16 Dense)
- 显存带宽: (HBM3)
5.3 三大性能瓶颈归因决策树:Compute-Bound、Memory-Bound 与 Comm/Launch-Bound
6. 工业级白板大实战:LLaMA-2/3 7B 与 70B 全生命周期资源大算盘
6.1 实战 1:单台 8 卡 A100-80GB 训练 LLaMA-7B 的显存四账本与 MFU 预测
1. 显存规划手算:
- 静态参数(BF16): ;
- 梯度(BF16): ;
- AdamW 优化器状态(FP32): ;
- 采用 ZeRO-2 显存切分(8 卡均摊):
- 每张卡分摊的优化器显存:
- 每张卡分摊的梯度显存:
- 单卡静态显存底座:
- 剩余可用显存: ,足以容纳 的动态激活值!
6.2 实战 2:64 卡 H100 训练 70B 模型的 3D 并行切分(TP+PP+DP)与吞吐手算
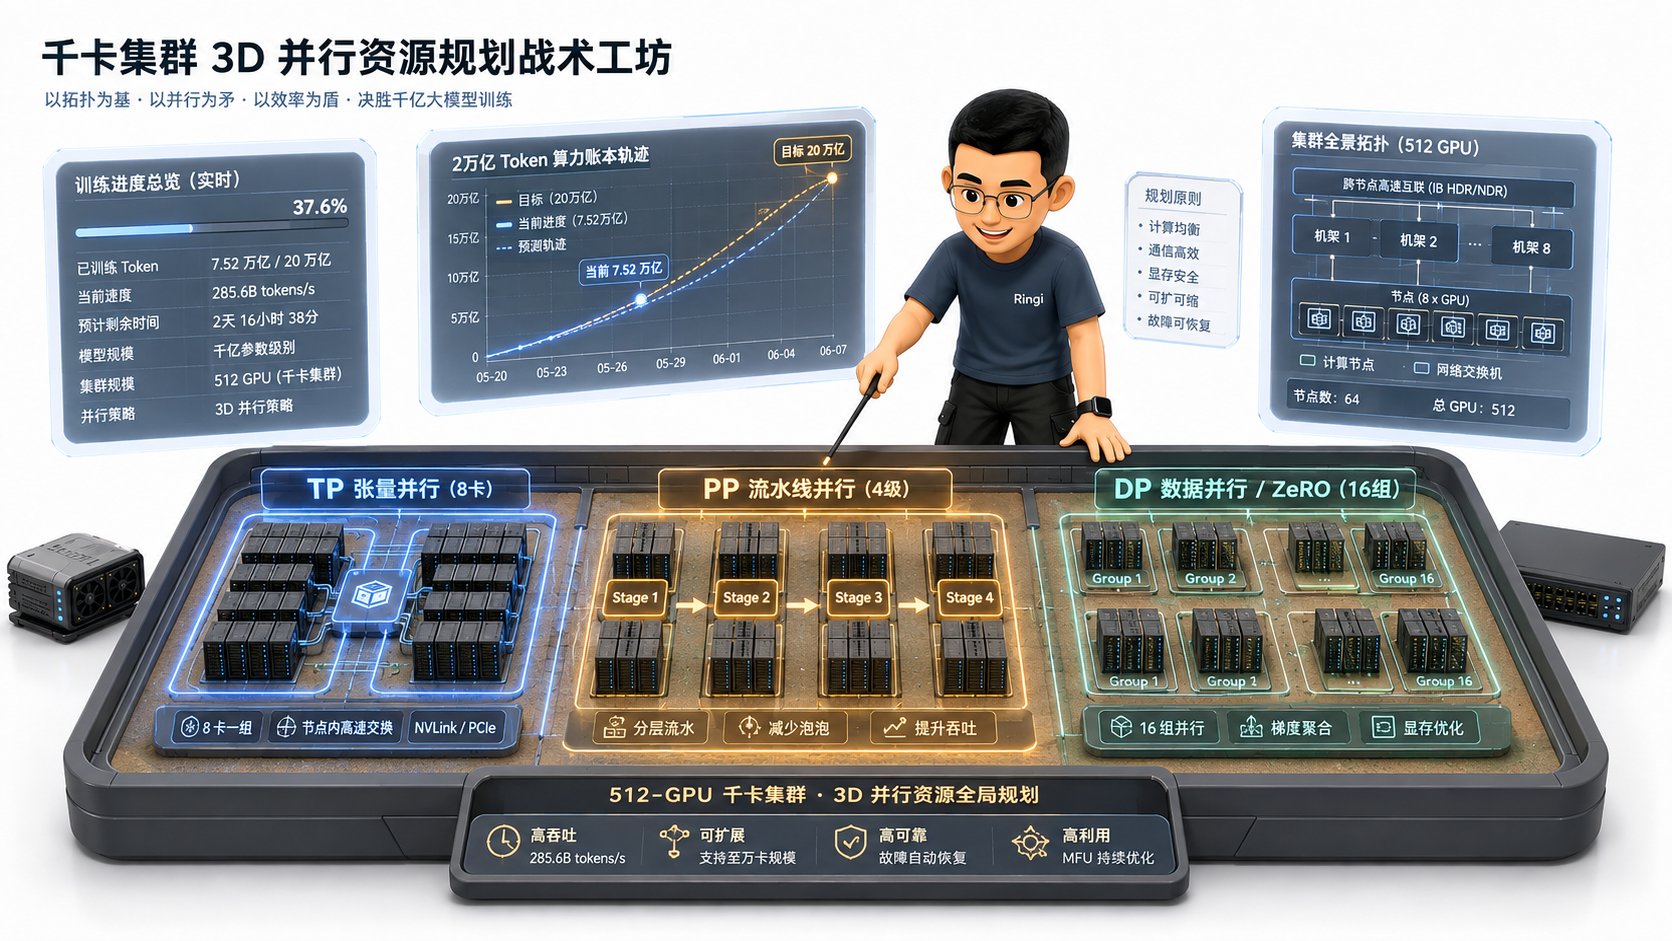
- 集群拓扑:8 台 H100-SXM5 服务器(共 64 张卡);
- 3D 并行切分策略:
- TP(张量并行)= 8:严格限制在单机 8 卡内部(NVLink 900GB/s);
- PP(流水线并行)= 4:跨机切分为 4 个 Stage(每 2 台机器 16 卡为一个 Stage);
- DP / ZeRO-1(数据并行)= 2:全集群跨 2 个副本数据并行;
- 验证: !
- 单步吞吐与 MFU 预测:
- 目标 MFU 设定为业界顶级 52%;
- 单卡有效算力: ;
- 64 卡集群每秒训练 Token 数:
7. 动手实战与代码实验室(Minimal Runnable Code)
下面我们通过 4 个纯原生、不依赖额外复杂工具的 Python 实验,亲手运行大模型性能工程的算力与显存预测模拟!7.1 实验 1:真实测算单个 GEMM 算子的物理 TFLOPS 与 MFU 计算器
7.2 实验 2:大模型训练静态与动态显存预测模拟脚本
7.3 实验 3:Roofline 性能分析与不同算子算术强度(AI)定位测试
7.4 实验 4:7B/70B 大模型集群资源规划与成本估算器
8. Ringi 避坑指南与生产最佳实践
8.1 避坑表格(❌ 常见小白错误理解 vs ✅ 大厂 AI Infra 正确理解)
8.2 生产性能工程黄金 Checklist
- 项目启动三必算:开工前必须白板手算:① 总算力需求与集群天数( );② 显存四账本底座;③ 通信算力比与网络带宽瓶颈;
- 拒绝单一指标欺骗:评测性能必须综合抓取 MFU、GPU 功耗瓦数(Power)、实际 TFLOPS 与端到端 Step 耗时,严禁只看
GPU-Util; - 分阶段优化策略:
- Prefill 阶段:主攻 Tensor Core 算力与 FlashAttention Tiling;
- Decode 阶段:主攻 PagedAttention 显存碎片消除、KV Cache 量化与 CUDA Graph 消除发射延迟;
- 集群扩展阶段:主攻通信计算重叠(Overlap)与网络拓扑亲和性绑定。
9. Ringi 5 点核心速记口诀、自我检验清单与课后深度思考题
9.1 5 点押韵核心速记口诀
9.2 10 条白板自我检验清单
- Q1:能不看资料,推导为什么单次 GEMM 矩阵乘法的计算量是 FLOPs 吗?
- Q2:请手撕大模型推理 、训练 与重计算 FLOPs/token 的数学来源。
- Q3:请列出 AdamW 混合精度训练下的静态显存四账本,并说明为什么单参数需要 16~18 字节?
- Q4:请推导大模型推理 KV Cache 的显存手算公式,并手算出 LLaMA-70B 单 Token 占多少 KB 显存?
- Q5:什么是 Roofline 模型中的硬件拐点(Turning Point)?请手算出 A100 的硬件拐点数值。
- Q6:为什么单 Token 自回归 Decode 阶段是极端的 Memory-Bound?其算术强度约为多少?
- Q7:为什么
nvidia-smi中的 GPU-Util 99% 不能代表 GPU 真正跑满了? - Q8:请写出 MFU(Model FLOPs Utilization)的标准定义公式,并说明它与 HFU 的核心区别。
- Q9:在 8 卡 A100 上训练 7B 模型,采用 ZeRO-2 分片后,单卡静态显存底座是多少 GB?
- Q10:请手算使用 512 张 H100(50% MFU)训练一个 70B 模型(2T Tokens)需要多少天?
9.3 3 道高阶开放式课后思考题(含极限 Corner Case)
- 混合精度 FP8 训练算力账本跃迁题:随着 NVIDIA Hopper / Blackwell 架构对 FP8 的全面支持,如果将训练的 GEMM 矩阵乘法从 BF16 切换为 FP8,计算量账本(FLOPs)、显存四账本(Weights/Gradients/Optimizer)与 Roofline 硬件拐点分别会发生什么剧烈变化?为什么反向传播的某些高精度累加仍需维持 FP32?
- Decode 阶段投机采样(Speculative Decoding)的算术强度救赎题:针对单 Token Decode 阶段极端受制于 HBM 带宽( )的死穴,投机采样(使用小模型一次猜 5 个 Token,大模型一次性前向验证 5 个 Token) 是如何将 Memory-Bound 转化为 Compute-Bound 的?结合 Roofline 模型分析其加速比上限。
- 千万卡集群训练中的“隐形通信税”思考题:当集群规模从 512 卡扩展到 16,384 卡时,虽然 Ring-AllReduce 的每卡数据量恒定为 ,但由于光纤链路故障、交换机丢包重传以及跨机房延迟抖动,通信时间往往不再符合理想的 - 模型。作为 AI Infra 架构师,你会从网络协议栈(如 NCCL NET Plugin / RoCE Adaptive Routing)和容灾 Checkpoint 的角度如何构建确定性性能保障?
10. 📚 参考资料与核心源码/经典论文指引
- 性能工程开山与奠基论文:
- Williams et al. (2009): “Roofline: An Insightful Visual Performance Model for Multicore Architectures”. Communications of the ACM.(Roofline 屋顶线模型开山奠基论文);
- Kaplan et al. (2020): “Scaling Laws for Neural Language Models”. OpenAI.(大模型计算量 与 Scaling Law 规模法则理论基石);
- Chowdhery et al. (2022): “PaLM: Scaling Language Modeling with Pathways”. Google Research.(首次系统定义并标准化推广 MFU 与 HFU 评估指标);
- Narayanan et al. (2021): “Efficient Large-Scale Language Model Training on GPU Clusters Using Megatron-LM”. SC21.(系统化提出 3D 并行切分显存与通信账本建模);
- Kwon et al. (2023): “Efficient Memory Management for Large Language Model Serving with PagedAttention”. SOSP 2023.(大模型推理显存建模与碎片消除标杆)。
- 权威工业级开源性能分析工具与源码库:
- PyTorch Profiler:
torch.profiler—— 抓取 GPU 微秒级 Trace 与算子算术强度; - NVIDIA Nsight Systems / Nsight Compute:
NVIDIA Developer—— 追踪 SM 利用率、Tensor Core 占空比与 Memory Stalled 根因分析; - Megatron-LM 性能账本计算脚本:
NVIDIA/Megatron-LM—— 研读工业级分布式训练框架中 MFU 计算与吞吐打点实现。
- PyTorch Profiler:
附录:Appendix A — 大厂硬核高频面试题与白板推导(Interview Drill)
💡 题目一:请在白板上手推大模型训练的 MFU(Model FLOPs Utilization)计算公式
面试官追问:已知一个 70B 模型在 64 张 A100-SXM4-80GB(单卡峰值 312 TFLOPS)上训练,Global Batch Size 为 256,序列长度为 4096,单步迭代耗时(Iteration Time)为 4.2 秒。请手算出该训练系统的实际 MFU 是多少?属于什么性能水平?
🎯 答题思考路径与推导步骤:
- 单步处理的总 Token 数手算:
- 单步理论最小有效计算量手算(按 标准公式):
- 集群在 4.2 秒内的理论最大峰值算力:
- MFU 计算与代入:
- 结论与评级:
实际 MFU 为 ,在 64 卡跨机训练 70B 模型场景下,超过了 50% 的工业级分水岭,属于世界顶级(World-Class)分布式训练优化水平!
💡 题目二:利用 Roofline 模型证明为什么大模型 Decode 单 Token 生成是 Memory-Bound?
面试官追问:请手算单 Token Decode 时的计算量与 HBM 访存读取量,推导出其算术强度,并对比 A100 的硬件拐点说明为什么此时 Tensor Core 处于严重饥饿状态?
🎯 答题思考路径与标准答案:
- 单 Token 生成时的物理账本:
- 设模型参数量为 (以 70B 模型为例,采用 FP16 精度,每个参数占 2 字节);
- 计算量(FLOPs):每个参数参与 1 次乘法和 1 次加法,计算量为 ;
- HBM 访存量(Bytes):生成这 1 个 Token,必须把全网 70B 权重从显存完整读取到片上寄存器一次,读取字节数为 (140 GB);
- 算术强度(AI)计算:
- 对比 A100 硬件拐点:
- A100 的硬件物理拐点为 ;
- 实际算术强度( )比硬件拐点( )低了整整 150 多倍!
- 归因结论:
系统处于极端的 Memory-Bound(访存受限) 状态。GPU 计算核心在 99% 的时间里都在眼巴巴等待慢速 HBM 搬运数据,算力被彻底闲置浪费。
💡 题目三:深度对比 ZeRO-3 与 FSDP 的显存节省与通信量代价(Trade-off 算盘)
面试官追问:ZeRO-3 将参数、梯度和优化器全部进行了 分片。请从通信账本与显存账本的角度,手算它相比标准 DDP 多付出了多少通信代价?在什么场景下才值得开启?
🎯 答题思考路径与标准答案:
- 显存账本收益对比:
- 标准 DDP:单卡静态显存为 (70B 模型需要 1120 GB,必须 16 张卡才能放下);
- ZeRO-3 / FSDP:单卡静态显存降为 (在 64 卡下,单卡静态显存仅需 ,完美放入 80GB 卡内);
- 通信账本代价手算:
- 标准 DDP:只在反向求导后执行 1 次
AllReduce梯度同步,单步单卡通信量为 字节; - ZeRO-3:
- 标准 DDP:只在反向求导后执行 1 次
- 前向计算:执行 1 次
AllGather临时拉取权重,通信量为 ; - 反向求导:再次执行 1 次
AllGather重新拉取权重,通信量为 ; - 梯度同步:执行 1 次
ReduceScatter规约分片存储梯度,通信量为 ; - 单步单卡总通信量为 ;
- Trade-off 结论:
ZeRO-3 的通信量相比 DDP 增加了整整 50%( )!
决策准则:只有在单卡显存实在装不下模型(如 70B 模型在小集群训练)时才开启 ZeRO-3;如果通过张量并行或卡数扩展已经能装下模型,优先选择通信量更小的 ZeRO-2(仅需 通信量)!
💡 题目四:单台 8 卡 A100-80GB 服务器,部署 LLaMA-70B 在线推理服务,如何进行显存与并发规划?
面试官追问:70B 权重本身占 140GB(FP16),单卡显然放不下。请给出张量并行(TP)切分方案,并手算在保持 4096 上下文长度时,单台机器最多能承载多大的并发 Batch Size?
🎯 答题思考路径与标准答案:
- 张量并行切分(TP=8):
将 70B 模型权重均分到 8 张 A100 上,每张卡承担:
- 单卡剩余可用显存手算:
- A100 总显存: ;
- 扣除权重:
- 扣除 CUDA 运行时与 Workspace 缓冲区(约 )及 10% 碎片留白( );
- 单卡实际可分配给 KV Cache 的显存空间为: ;
- TP=8 下的单 Token KV Cache 显存手算(LLaMA-70B GQA):
- 全模型单 Token 的 KV Cache 为 ;
- 在 8 张卡上通过 GQA 均分,单卡单 Token 的 KV Cache 仅为 ;
- 最大并发 Batch Size 规划:
- 设单请求长度为 Tokens,单个请求在单卡上占用的 KV Cache 为:
- 单台 8 卡服务器支持的最大并发请求数(Batch Size)为:
- 生产建议:
在生产环境中配合 vLLM (PagedAttention),可以将并发稳定维持在 的极高吞吐区间,单台机器每秒可吐出上万个 Token!