第01讲:AI Infra 工程师的 C++ 与 Python 底层必修课
主讲人:👓 Ringi(AI Infrastructure 工程师)AI Infra 处在算法、框架、编译器、操作系统和硬件的交界处。同一个问题往往要在多种语言和工具之间来回切换:用 Python 描述模型与实验,用 C++ 实现性能敏感路径,用 CUDA 驱动 GPU,再用 Linux 工具定位进程、内存、动态库和网络问题。 本讲不追求把 C++ 语法完整背一遍,而是建立一条贯通算力底座的主线:能读懂、能修改、能调试,也知道每一微秒性能成本与显存开销发生在哪里。
所属模块:Module 00:性能工程与系统前置
关键词:C++17 / RAII / 智能指针 / 移动语义 / 模板 / PyBind11 / ATen / PyTorch C++ Extension / Autograd
学习目标:建立从 Python API 一路追踪到 C++、ATen、CUDA/设备执行层的能力,并能够独立编写、编译、导入和验证一个最小 PyTorch C++ 扩展。
📑 目录导航
- 0. Ringi 开场:为什么会 Python 还远远不够?
- 1. 现代 C++(C++11/14/17)核心必备武器库
- 2. Python C 扩展与 PyTorch 桥梁:PyBind11 实战
- 3. PyTorch C++ 扩展:从 torch::Tensor 到 ATen
- 4. 手写 PyTorch C++ Extension 算子实战
- 5. 编译模式:JIT 即时编译 vs AOT 预编译
- 6. 大厂 AI Infra 避坑指南与经典面试题
- 7. 总结与自我检验清单
写在前面:这不是一篇“C++ 语法大全”
很多同学第一次接触 AI Infra,会有一个很自然的疑问:
“我会 Python,也会 import torch,模型能训练、能推理,为什么还要学 C++?”
如果你的目标只是调用现成模型,Python 确实已经足够强大。
但如果你的目标是下面这些工作:
- 优化大模型推理延迟;
- 修改 vLLM / TensorRT-LLM / SGLang 的核心执行路径;
- 编写 CUDA Kernel;
- 定位 PyTorch 算子性能问题;
- 处理 Tensor 的生命周期、显存与 Stream;
- 排查 NCCL、CUDA Runtime、动态链接库问题;
- 为 PyTorch 增加自定义算子;
- 阅读框架内部 Dispatcher / ATen / C10 代码;
- 做 CPU / GPU 性能工程;
0. Ringi 开场:为什么会 Python 还远远不够?
0.1 Python 更像“控制面”,C++ 更像“数据面”
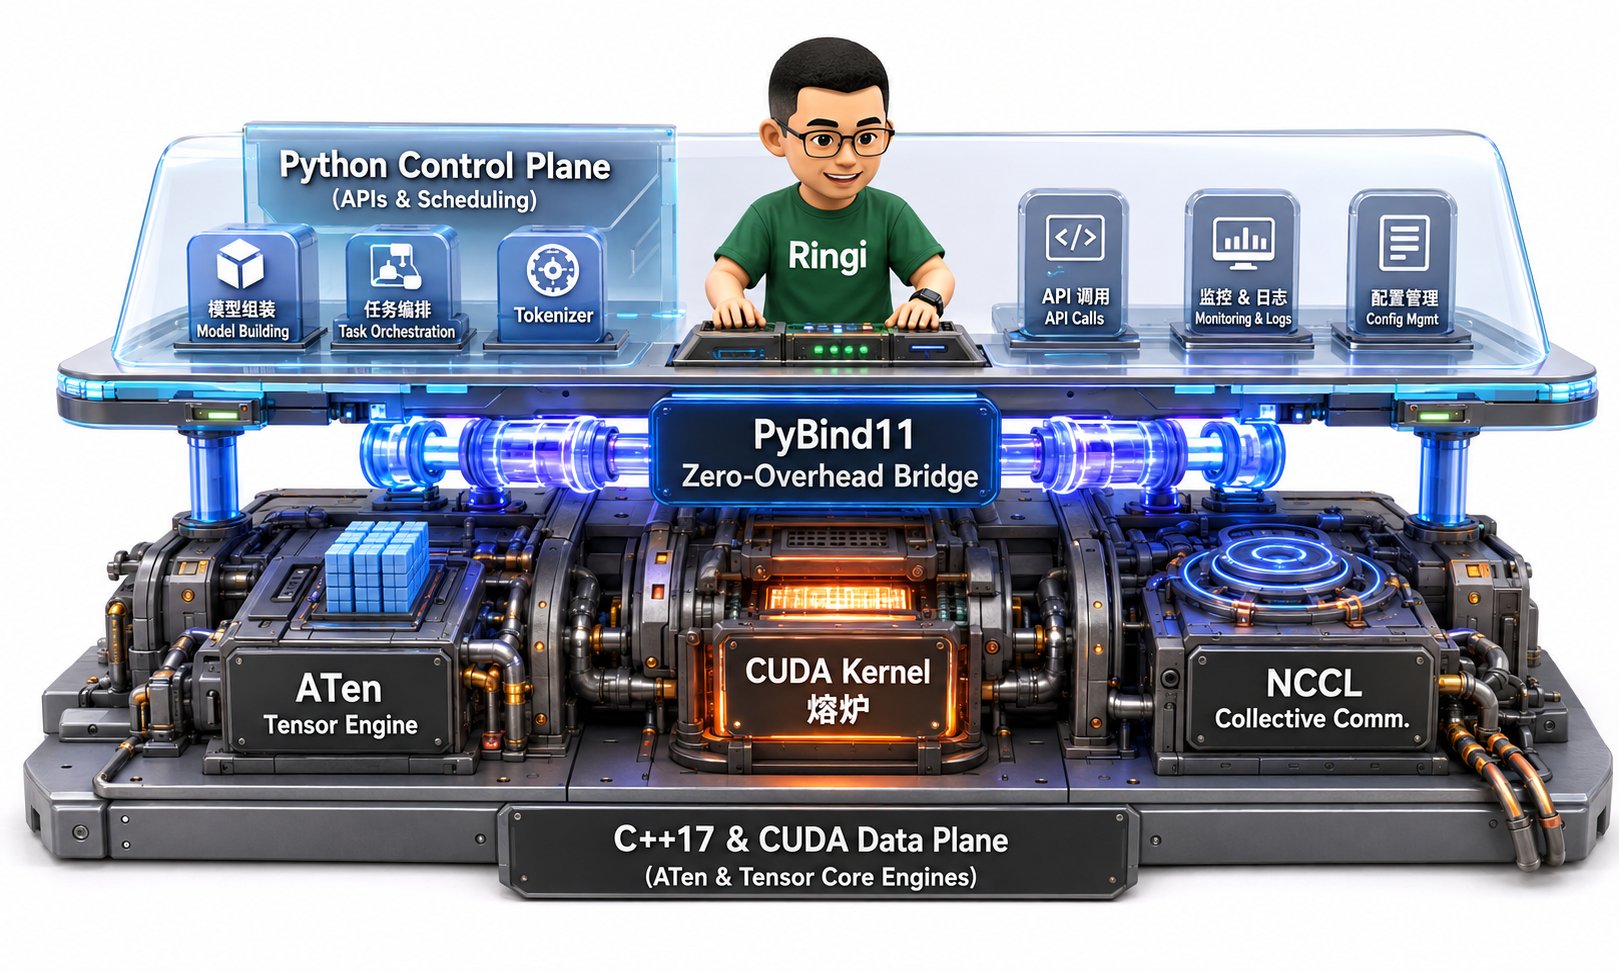
Python 的最大优点是开发效率高。
C++ 的最大优点是:
- 生命周期可控;
- 内存布局可控;
- 可以直接调用系统 API;
- 可以接入 CUDA / NCCL / Driver;
- 模板可以在编译期生成高性能特化代码;
- 没有 Python 对象模型带来的逐元素动态开销。
Python 负责“我要做什么”,C++ / CUDA 负责“具体怎么高效做”。
0.2 Python 的性能开销到底在哪里?
0.2.1 解释器与动态分派
考虑一个纯 Python 循环:x + y 都不是简单的一条 CPU 浮点加法指令。
解释器需要处理:
- Python 对象;
- 类型检查;
- 操作符分派;
- 引用计数;
- Python list 的对象指针;
- 动态内存管理。
- 内联;
- 自动向量化;
- 展开循环;
- 使用 SIMD;
- 消除不必要的边界检查。
0.2.2 Python 对象不是“裸数据”
在 C++ 中:x 可以直接对应内存中的 4 个字节浮点数据。
而 Python:
x 更准确地说是一个名字,绑定到一个 Python 对象。
这个对象除了数值本身,还需要类型、引用计数等运行时元数据。
因此:
float。
Python list 本质上更接近:
- contiguous;
- dtype;
- shape;
- stride;
- storage;
- data pointer;
- zero-copy。
0.2.3 GIL:要理解,但不要背成一句口号
传统 CPython 默认构建中存在 GIL(Global Interpreter Lock)。 这意味着在一个进程中,多个线程通常不能同时执行 Python 字节码。 所以:“有 GIL,所以 Python 线程完全没用。”实际情况是:
- 阻塞 I/O 期间可以让其他线程运行;
- NumPy / PyTorch 等原生扩展可以把耗时计算放到 C/C++;
- C/C++ 扩展可以在安全条件下释放 GIL;
- GPU Kernel 启动后,实际计算发生在 GPU 上。
0.3 什么时候应该下沉到 C++?
不要一看到 Python 就重写成 C++。 推荐优化顺序:边界调用太碎。AI Infra 中常见的正确优化不是:
1. 现代 C++(C++11/14/17)核心必备武器库
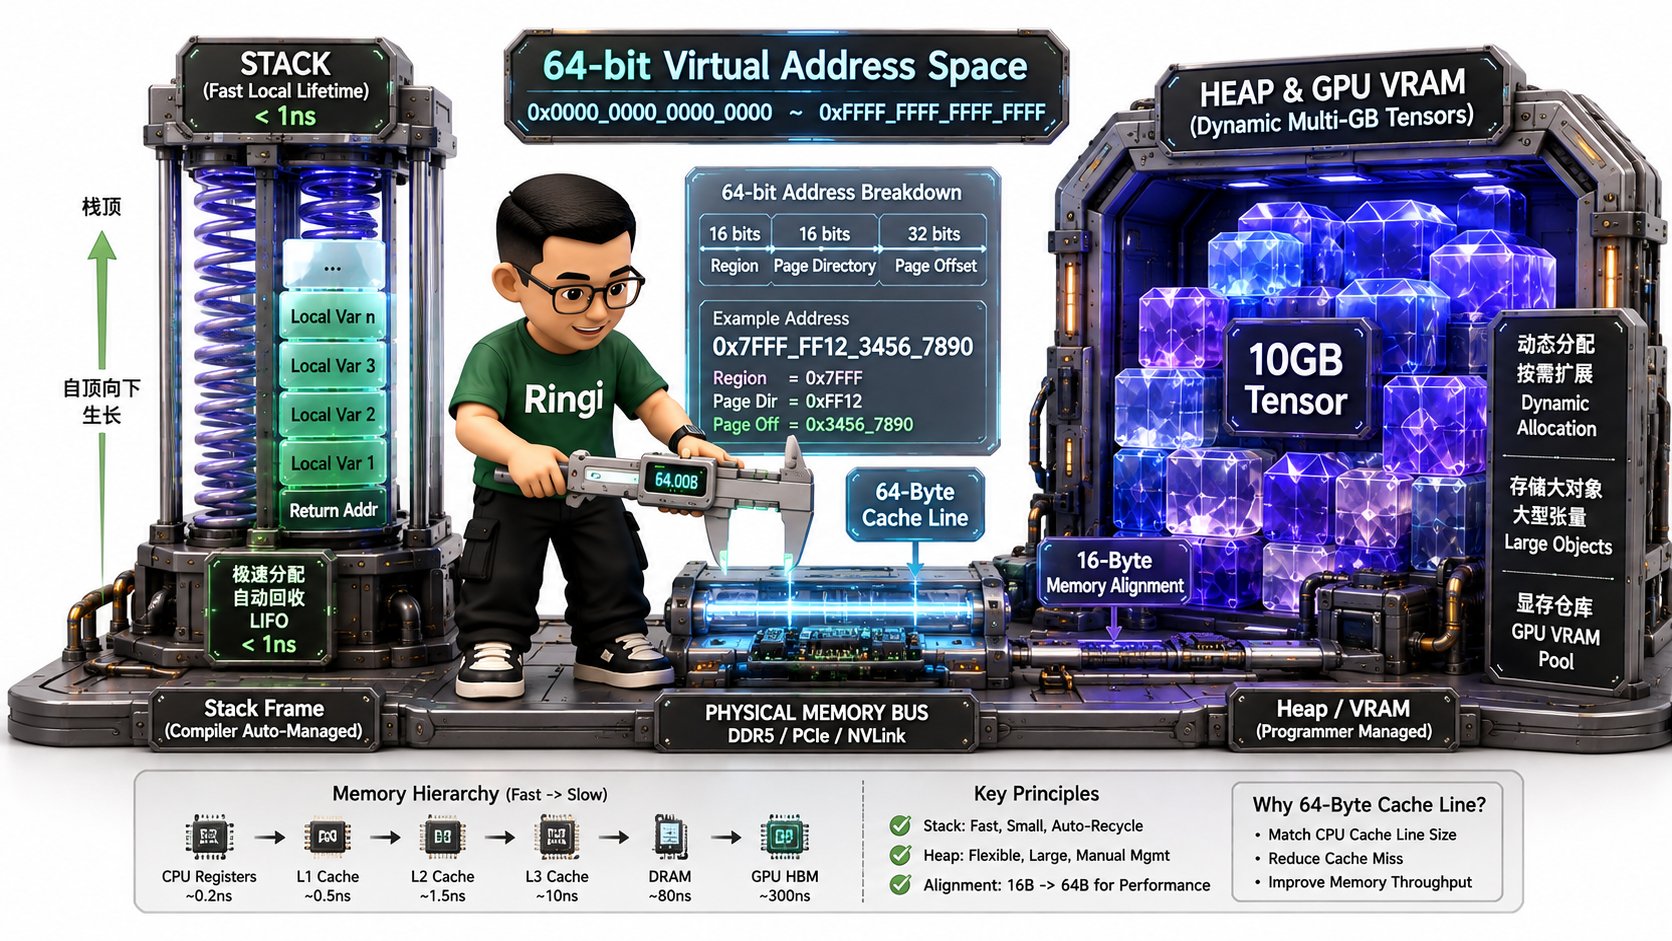
1.1 先建立物理直觉:变量、地址、指针与引用
在 64 位 Linux 进程里,每个进程看到的是自己的虚拟地址空间。 例如:x 的地址。
1.2 指针:保存地址的变量
1.3 引用:已有对象的别名
在 AI Infra 代码中你会经常看到:
我需要访问x,但这个函数不拥有x,也不打算复制x这个 C++ 句柄。
1.4 const T& 为什么如此常见?
假设:
Config。
如果只读:
对 torch::Tensor 这种本身就是轻量引用计数句柄的类型,“按值传 Tensor”与“复制整块 Tensor 数据”完全不是一回事。
这是后面理解 at::Tensor 的关键。
1.5 栈、堆与“真正应该关心的东西”:生命周期
初学 C++ 时常听到:- 栈;
- 堆。
这个对象活多久?谁负责释放?例如:
p 这个指针变量没了,但 new int(42) 分配的内存还在。
没有人再能释放它。
这叫:
delete 后仍然访问:
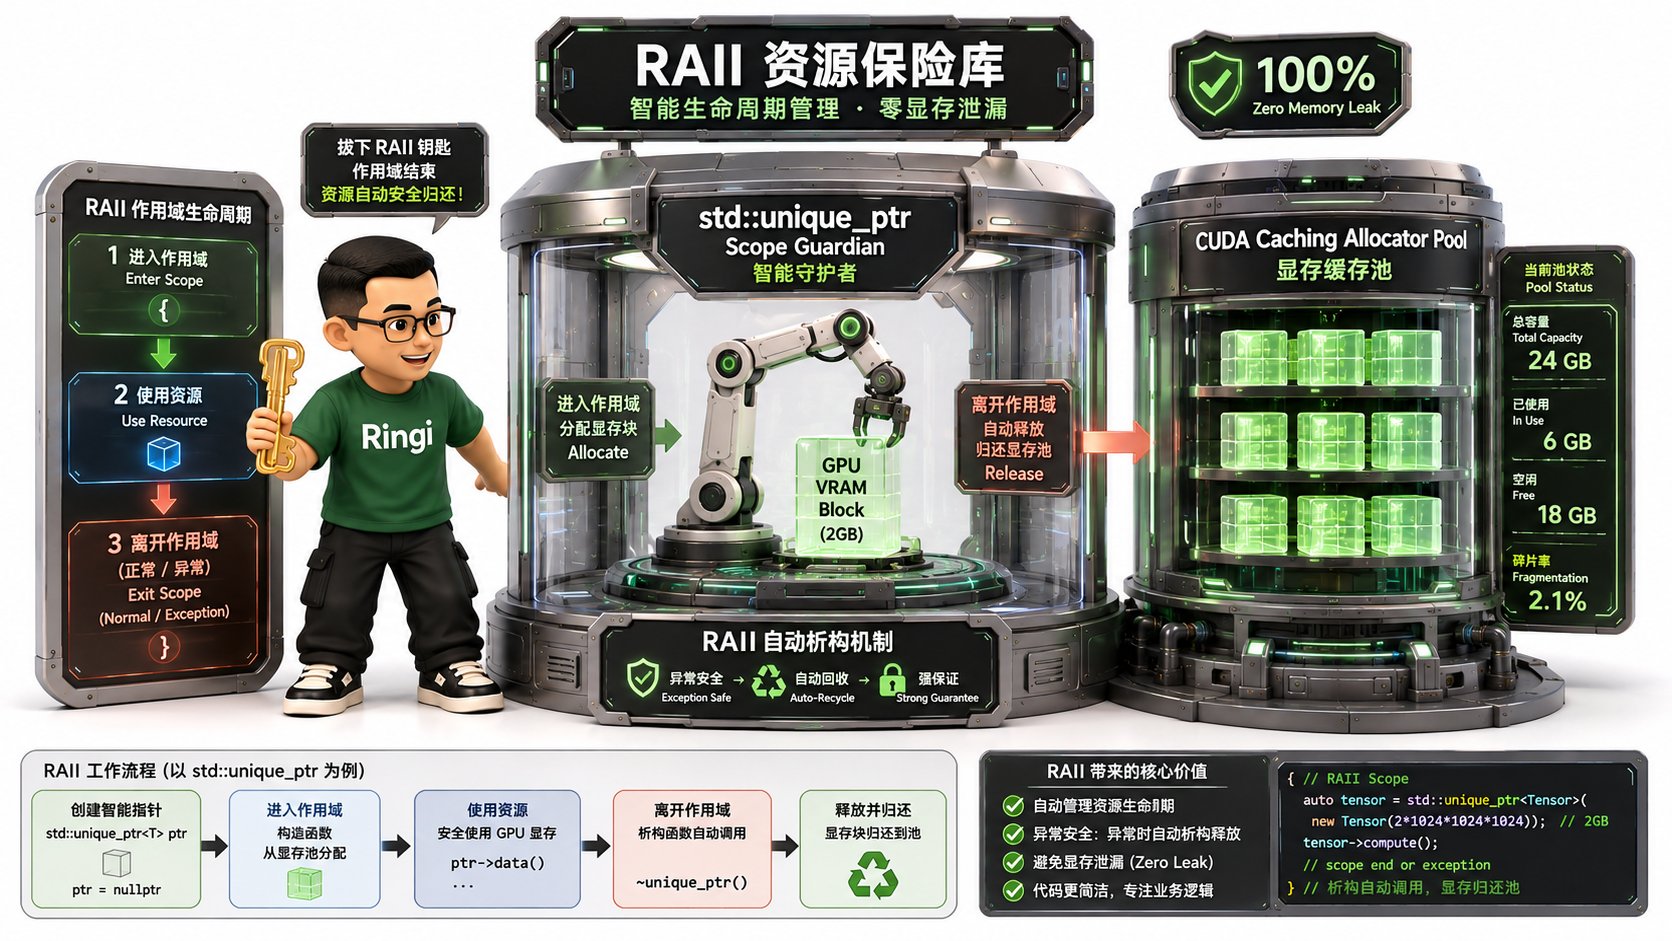
1.6 RAII:现代 C++ 最重要的思想之一
RAII = Resource Acquisition Is Initialization 不要只把它理解成一句翻译:资源获取即初始化。真正工程意义是:
把资源的生命周期绑定到 C++ 对象生命周期。对象进入作用域时拿资源。 对象离开作用域时自动释放资源。
1.6.1 手工资源管理为什么危险?
fclose 可能永远不会执行。
1.6.2 RAII 写法
do_something() 抛异常,栈展开时 File::~File() 仍然执行。
1.6.3 RAII 在 AI Infra 中管理什么?
malloc/free、裸 cudaMalloc/cudaFree 满天飞”的根本原因。
严格来说,不是“永远不能手写 malloc/free”,而是资源所有权必须被封装,异常路径和提前返回路径也必须安全。
1.7 智能指针:让所有权写进类型系统
C++ 中最常用:1.7.1 std::unique_ptr
唯一所有权。
b。
推荐原则
如果资源不需要共享所有权,优先 unique_ptr。
1.7.2 std::shared_ptr
共享所有权。
- 控制块;
- 引用计数;
- 多线程下引用计数通常需要原子操作;
- 循环引用问题。
shared_ptr 不是“懒得想生命周期时的默认答案”。
1.7.3 std::weak_ptr
用于观察 shared_ptr 管理的对象,但不增加强引用计数。
典型用途是打破循环引用。
1.8 移动语义:std::move 到底做了什么?
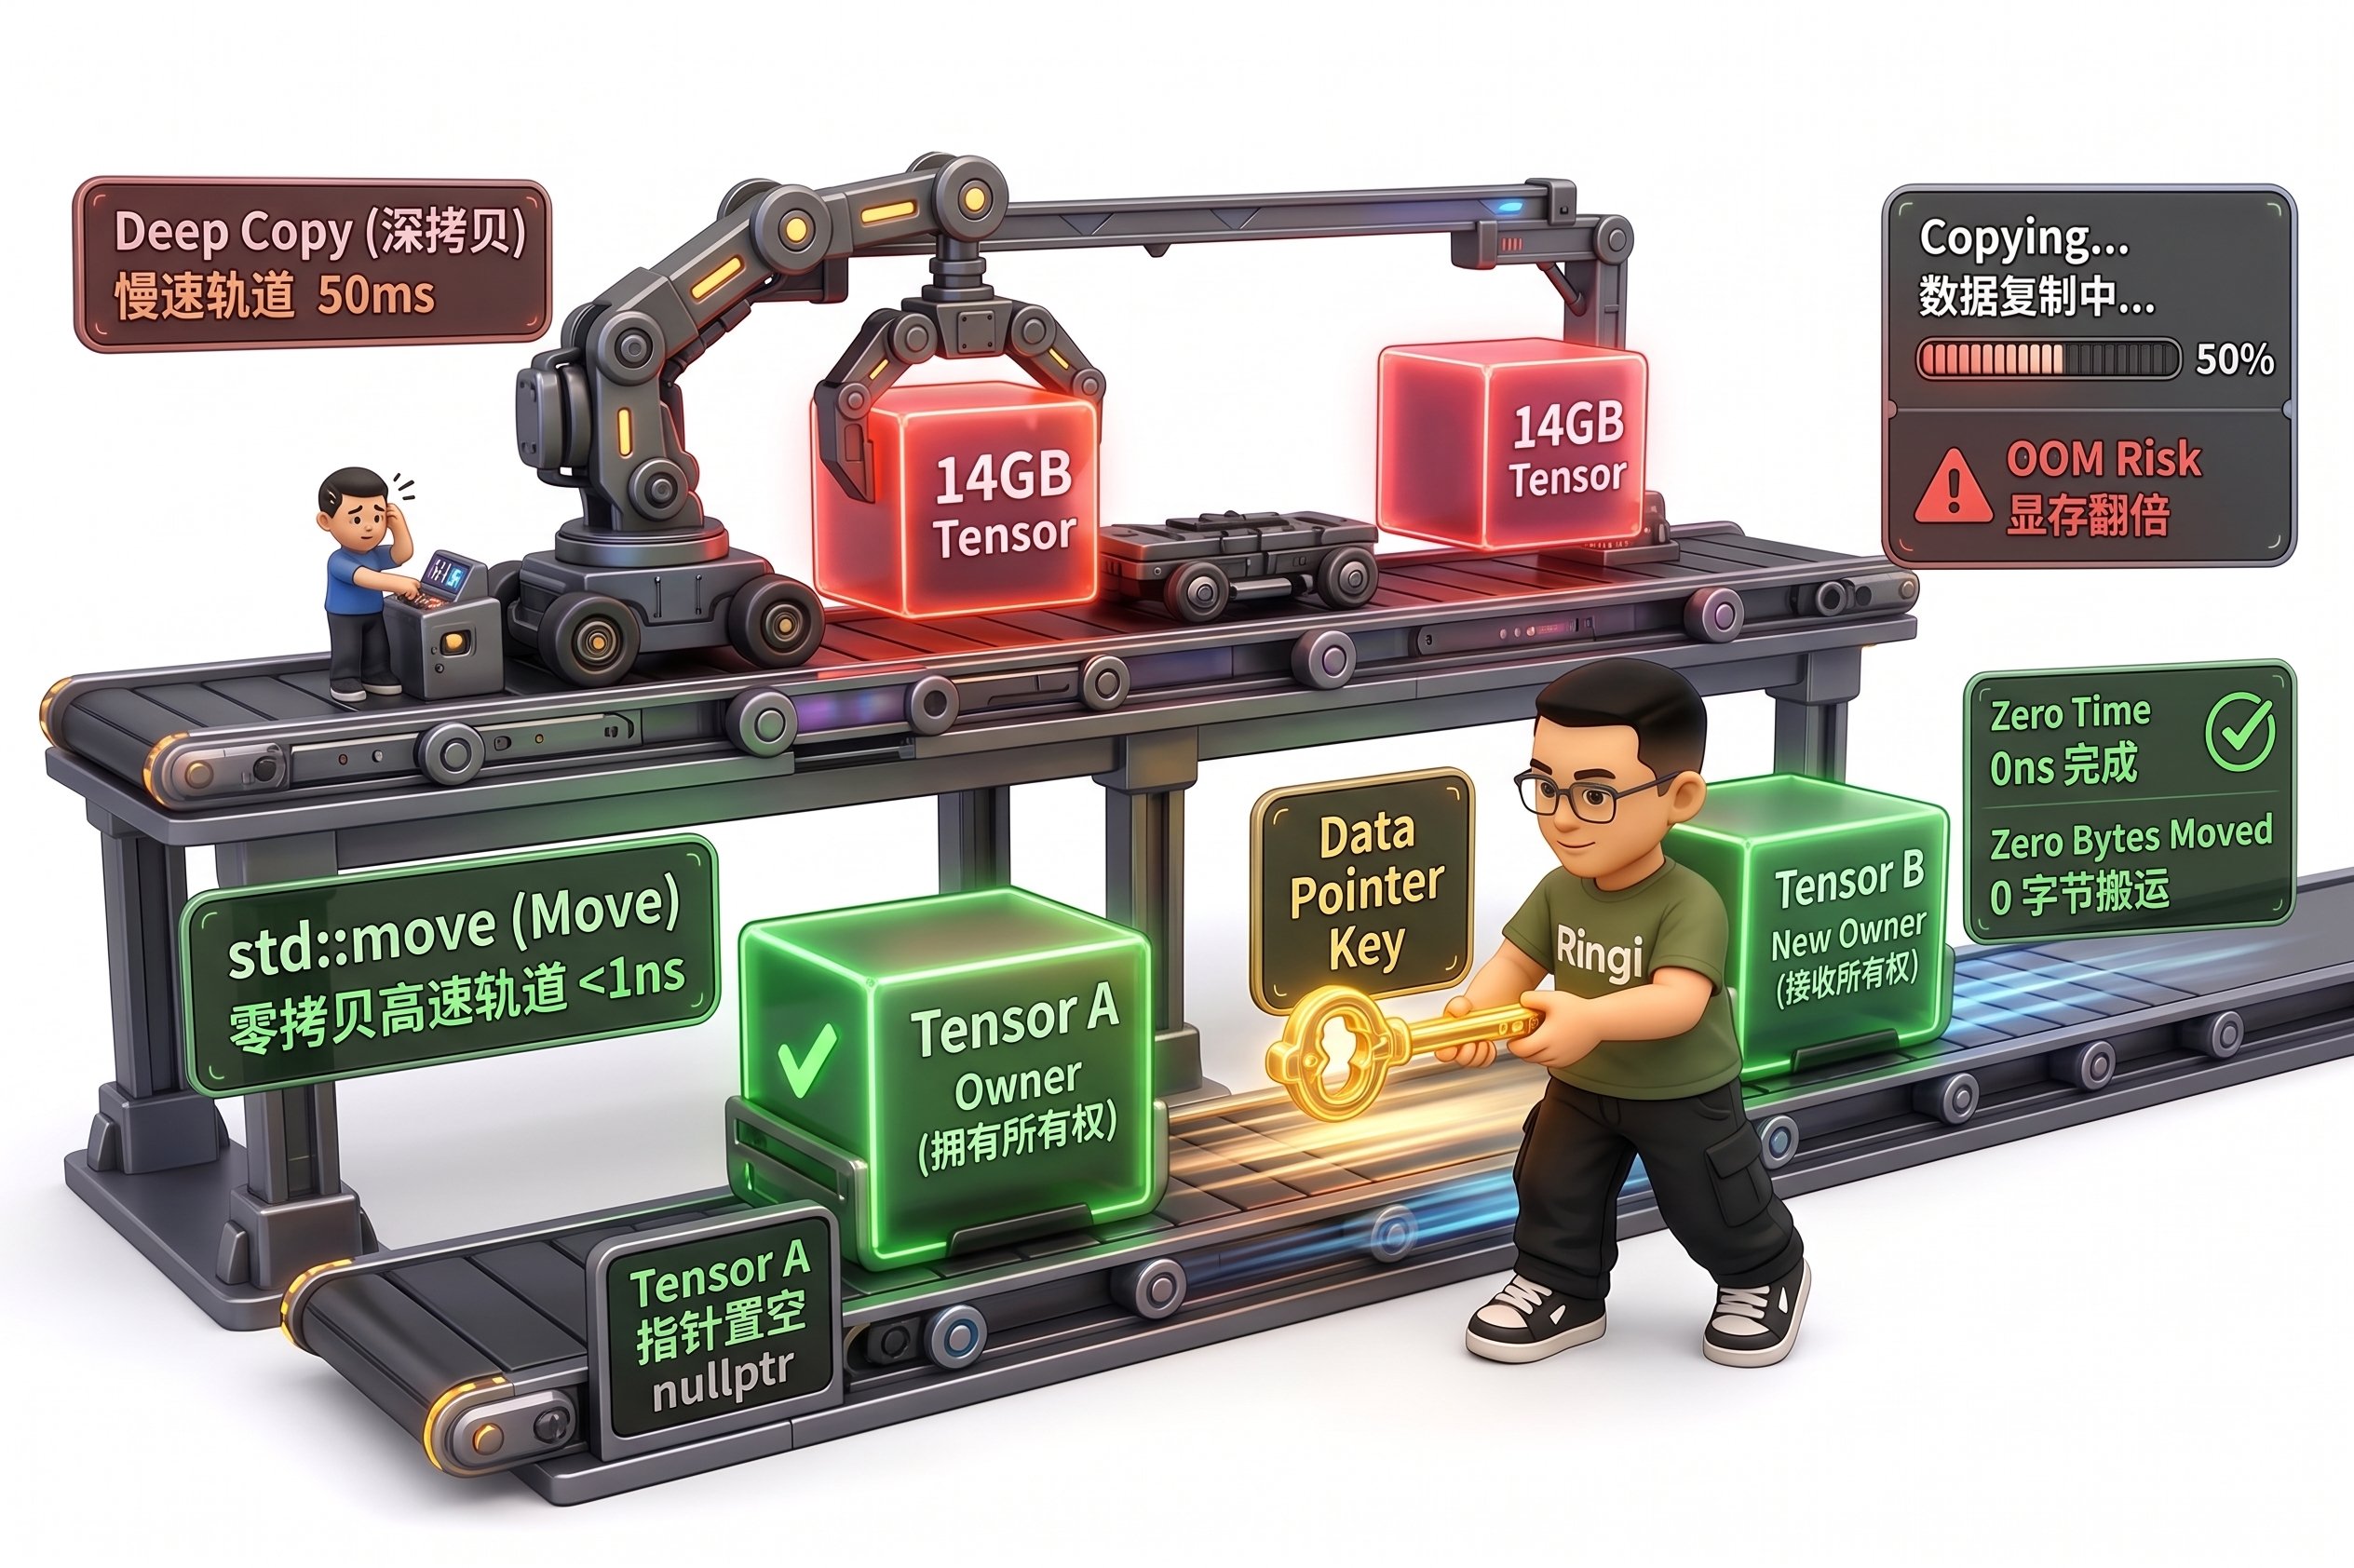
b = a 是复制。
可能需要重新申请大块内存,然后复制所有元素。
1.8.1 移动
std::vector,通常可以直接把:
- data pointer;
- size;
- capacity;
b。
概念上:
1.8.2 关键纠正:std::move 本身并不“移动任何数据”
std::move(x) 本质上是把表达式转换成可以匹配右值引用的形式。
它告诉编译器:
“如果目标类型支持移动语义,现在可以把这个对象的资源拿走。”真正执行资源转移的是:
1.8.3 不要把 std::move 神化成“Tensor 零拷贝按钮”
例如 PyTorch 的 at::Tensor 本身是一个引用计数句柄。
复制:
TensorImpl,并更新引用计数。
所以面试中回答:
“大 Tensor 一定要 std::move,否则会复制几 GB 显存。”
这是不准确的。
正确回答应该是:
对拥有大型资源的 C++ 容器或对象,移动语义可以转移所有权,避免深拷贝;但具体收益取决于类型。对 at::Tensor 这类引用计数句柄,复制句柄本身并不会复制底层 Tensor Storage。
1.9 完美转发:std::forward
移动语义解决:
“对象已经是右值时,如何移动?”完美转发解决:
“模板函数收到参数后,如何保留调用方原本的左值/右值属性?”典型写法:
std::forward 会根据原始参数类型决定:
- 继续当左值;
- 还是继续当右值。
1.10 模板:为什么 AI / CUDA 代码里到处都是 <T>?
看一个最简单模板:
1.10.1 为什么 Kernel 很适合模板?
AI 中同一个算子可能需要支持:1.10.2 模板的性能意义
模板不仅是为了复用代码。 它还允许:- 编译期特化;
- 常量传播;
- inline;
- 消除动态类型分派;
- 根据 dtype / block size 生成不同 Kernel。
1.11 一个很重要的现代 C++ 原则:Rule of Zero
如果你的类成员本身都是 RAII 类型:Rule of ZeroAI Infra 底层代码越复杂,越应该让所有权逻辑尽可能局部、机械、可证明。
2. Python C 扩展与 PyTorch 桥梁:PyBind11 实战
2.1 Python 是怎么 import C++ 的?
假设 Python:
fastops 是 C/C++ 扩展,那么磁盘上实际可能存在:
Linux:
.pyd 本质上也是 Windows DLL 形式的 Python 扩展模块。
Python 导入时大致经历:
帮你把复杂的 Python C API 封装成现代 C++ 接口。
2.2 PyBind11 最小实战:C++ 向量加法
项目结构:2.2.1 vector_add.cpp
2.2.2 CMakeLists.txt
2.2.3 创建环境
2.2.4 编译
2.2.5 test.py
2.3 std::vector vs Python list:一个非常关键的性能陷阱
你可能会看到:
“这里用了 const &,所以 Python list 没复制。”
错。
当你:
list 转成:
const std::vector<float>& 只能避免进入 C++ 函数之后再复制一次这个 vector,不能消除 Python ↔ C++ 边界转换。
2.4 真正的 Zero-Copy 应该看什么?
高性能接口应该尽量直接传连续 Buffer。 典型选择:2.4.1 NumPy 思路
PyBind11 支持:std::vector<float>。
但是 zero-copy 永远有前提:
- dtype 是否匹配;
- contiguous 是否满足;
- alignment 是否满足;
- 谁拥有内存;
- C++ 使用期间 Python 对象是否还活着;
- 是否允许写;
- 生命周期是否跨线程。
Zero-Copy 从来不只是“拿一个裸指针”。它本质上是内存所有权与生命周期协议。
2.5 PyBind11 与 GIL
Python 调用 PyBind11 C++ 函数时,PyBind11 默认不会自动把 GIL 放掉。 如果 C++ 函数执行很久,并且整个计算期间:- 不访问 Python 对象;
- 不调用 Python C API;
- 不回调 Python;
一旦 C++ 代码需要访问 Python 对象,必须重新满足 Python 的线程状态 / GIL 要求。不要为了“看起来高级”随便释放 GIL。
2.6 Python ↔ C++ 边界的性能原则
记住四条:原则 1:减少调用次数
差:原则 2:避免 Python 容器逐元素转换
差:原则 3:清楚生命周期
不要让 C++ 保存一个指向已经释放 Python Buffer 的指针。原则 4:C++ 热路径不要频繁回调 Python
否则会重新引入:- GIL;
- Python frame;
- 类型转换;
- 动态分派。
3. PyTorch C++ 扩展:从 torch::Tensor 到 ATen
3.1 PyTorch 的 C++ 底座:ATen
你在 Python 中:3.2 at::Tensor 不是“整块数据对象”
- 对 TensorImpl 的引用;
- shape;
- stride;
- dtype;
- device;
- storage relation;
- dispatch / autograd 等元数据。
3.3 为什么 Tensor View 可以很便宜?
例如 Python:view 很多时候不复制底层 Storage。
只是产生新的:
shape 一样,不代表内存布局一样。例如:
y 可能不是 contiguous。
如果你的 C++ / CUDA Kernel 假设输入连续,却没有检查 stride,就可能直接算错。
3.4 最小 PyTorch C++ Extension
我们先做最简单的:3.4.1 项目结构
3.4.2 op.cpp
3.5 用 torch.utils.cpp_extension.load JIT 编译
test_cpp_extension.py:
3.6 JIT load() 在背后做了什么?
简化来看:
3.7 torch.utils.cpp_extension.load 常见参数
如果源码包含:
3.8 AOT:不要每次启动程序都现场编译
教学阶段:3.9 更正式的 PyTorch Custom Operator:Dispatcher 注册
上面的 PyBind 例子很好理解。 但如果你希望自定义算子更完整地参与:3.10 自定义 C++ 算子如何保持 Autograd 可导?
这是面试高频题。 要分情况回答。情况 A:C++ 函数内部只组合已有 ATen 可导算子
例如:情况 B:你自己写了一个“黑盒” CPU/CUDA Kernel
例如:torch.library / C++ Dispatcher 注册机制补齐 Autograd。
并且应该使用:
3.11 torch.autograd.Function 和 Custom Operator 是一回事吗?
不是。
torch.autograd.Function 是自定义前向/反向的一种机制。
但一个完整的 PyTorch Operator 还可能需要兼容:
- Dispatcher;
torch.compile;- export;
- vmap;
- FakeTensor;
- device dispatch;
- schema;
- alias / mutation contract。
“自定义算子 = 写一个 torch.autograd.Function。”
现在更应该理解完整的 Operator 注册体系。
4. 动手实战:从 0 跑通一个 C++ Extension
这一节直接给出最小可运行包。4.1 环境要求
建议:4.2 项目结构
4.3 op.cpp
4.4 test_cpp_extension.py
4.5 运行
4.6 为什么这个例子能测 Autograd?
因为:4.7 如何证明没有把 Tensor 数据复制到 Python list?
我们传入的是:std::vector<float>”。
这正是为什么高性能框架都围绕 Tensor / Buffer 抽象设计。
4.8 如果下一步改成 CUDA 会发生什么?
项目会变成:- device;
- current CUDA stream;
- async launch;
- synchronization;
- kernel error;
- dtype dispatch;
- contiguous;
- alignment;
- shared memory;
- warp;
- occupancy;
- memory coalescing。
5. Ringi 避坑指南
5.1 ❌ 返回局部对象引用
错误:5.2 ❌ 返回局部变量指针
错误:5.3 ❌ 以为裸指针等于 Zero-Copy
某个地址上可能有 float。它没有告诉你:
- 内存是不是还活着;
- 谁负责释放;
- 长度是多少;
- 在 CPU 还是 GPU;
- contiguous 吗;
- 谁拥有它;
- 什么时候能释放;
- 是否正在被异步 Kernel 使用。
裸指针只是地址,不是完整的数据协议。
5.4 ❌ shared_ptr 到处用
如果所有东西都是:
- 谁真正拥有资源不清楚;
- 生命周期变长;
- 循环引用;
- 引用计数有成本;
- 释放时机不可预测。
5.5 ❌ 以为 std::move 后对象“不能用了”
标准 C++ 更准确的说法是:
moved-from object 仍然必须处于有效但通常未指定的状态。例如:
5.6 ❌ 对函数返回值乱加 std::move
例如:
std::move 反而可能妨碍优化。
5.7 ❌ C++ 算子里频繁调用 Python API
例如:- GIL;
- Python object;
- callback;
- 边界转换;
- 解释器开销。
5.8 ❌ 忽略 Tensor dtype
错误:5.9 ❌ 忽略 device
你拿到:5.10 ❌ 忽略 contiguous / stride
错误思维:- 支持 arbitrary stride;
- 或明确要求 contiguous;
- 或内部调用
.contiguous()。
.contiguous()”也可能成为性能问题。
5.11 ❌ 忽略 GPU 异步执行
CUDA Kernel launch 通常是异步的。 CPU 发起:torch.utils.benchmark 等合适工具。
5.12 ❌ 一出编译错误就重装 CUDA
C++ Extension 出错可能发生在:6. 大厂面试高频题
面试题 1:std::unique_ptr 与 std::shared_ptr 区别?
推荐回答:
unique_ptr 表示唯一所有权,不可复制但可以移动,额外成本很低,应该作为默认拥有型指针。shared_ptr 表示共享所有权,通过控制块和引用计数管理生命周期,适合确实存在多个 owner 的对象,但有额外计数成本,并要注意循环引用;循环引用通常使用 weak_ptr 打破。
面试题 2:RAII 为什么对 CUDA 显存管理重要?
推荐回答: CUDA 内存属于资源,可能遇到异常、提前返回、多分支路径。如果直接在业务代码中手工cudaMalloc/cudaFree,容易遗漏释放或重复释放。RAII 把 cudaFree 放到析构函数中,让资源生命周期与 C++ 对象作用域绑定,可以显著降低泄漏和错误释放风险。Stream、Event、NCCL communicator 也可以使用同样的设计。
面试题 3:std::move 为什么能提高大对象传递性能?
不要回答:
“std::move 会自动做零拷贝。”
更好的回答:
std::move 只是把表达式转换成右值形式,使类型可以选择移动构造或移动赋值。如果类型拥有 heap buffer,例如 std::vector,移动通常可以转移内部指针和容量,从而避免逐元素深拷贝。具体收益取决于类型;对 at::Tensor 这样的引用计数句柄,普通复制句柄本身也不会复制整个 Tensor Storage。
面试题 4:Python list 传到 const std::vector<float>& 是 Zero-Copy 吗?
不是。
PyBind11 的 STL 自动转换通常需要把 Python list 的元素转换到一个 C++ std::vector 中。
const & 只能避免 C++ 函数内部再次复制这个 vector。
高性能接口应该优先考虑:
面试题 5:为什么 PyTorch Tensor 复制句柄很便宜?
因为at::Tensor 更接近引用计数 handle。
多个 Tensor 对象可以指向同一个 TensorImpl / Storage。
例如:
面试题 6:PyTorch Tensor 的 shape 与 stride 分别是什么?
shape/sizes 描述每个维度长度。
stride 描述沿某个维度移动一个元素时,在底层 Storage 中需要跨多少个元素。
因此 transpose 可以只修改 stride,而不复制 Storage。
这也是为什么自定义 Kernel 不能只看 shape。
面试题 7:PyTorch 自定义 C++ 算子怎样支持 Autograd?
要分两类:- 如果 C++ 中只是组合已有 PyTorch/ATen 可导算子,Autograd 可以沿已有算子继续记录;
- 如果注册了自己的黑盒 CPU/CUDA Kernel,就必须为该 Operator 提供正确的 Autograd/backward 注册,并验证梯度与 Operator schema 契约。
面试题 8:为什么 C++ 扩展可能比 Python 还慢?
常见原因:- 每次调用计算量太小;
- Python ↔ C++ 边界开销占主导;
- list / vector 来回转换;
- 不必要 memcpy;
- 线程创建;
- cache miss;
- 没向量化;
.contiguous()发生复制;- GPU Kernel 太小;
- 强制同步;
- 编译参数没优化;
- 算法复杂度没变。
C++ 不是性能魔法,性能工程必须 measurement-driven。
面试题 9:什么时候释放 GIL?
当 C/C++ 扩展进入一个较长的原生计算区间,并且该区间:- 不访问 Python 对象;
- 不调用 Python C API;
- 不需要 Python callback;
面试题 10:为什么不能返回局部对象引用?
局部对象离开作用域后生命周期结束。 返回其引用或地址会产生:7. Debug:C++ Extension 出错怎么定位?
建立固定排查顺序。7.1 第一步:确认 Python 与 PyTorch
7.2 第二步:确认编译器
7.3 第三步:确认 Ninja
7.4 第四步:如果包含 CUDA,确认工具链
7.5 第五步:看完整编译命令
使用:7.6 第六步:区分 compile / link / import
编译错误
典型:链接错误
典型:import 错误
典型:8. 性能工程视角:这节课真正要建立的思维
8.1 从“值”升级到“Buffer”
初学编程看:8.2 从“函数”升级到“边界”
看到:custom_op 做了什么数学运算?还要问:
8.3 从“代码正确”升级到“生命周期正确”
一个 C++ 函数即使数学公式对,也可能因为:- use-after-free;
- data race;
- dangling pointer;
- double free;
- async lifetime;
- stream ordering;
9. 本讲自测 Checklist
学完这一讲,你应该能回答:- Python 为什么适合做编排,但不适合承担所有性能敏感路径?
- GIL 限制的究竟是什么?
- 指针和引用的核心区别是什么?
- 什么是对象生命周期?
- RAII 为什么比“记得 free”更可靠?
-
unique_ptr和shared_ptr如何选择? -
std::move本身是否真的移动数据? - 什么叫 moved-from valid but unspecified state?
- 为什么模板适合 dtype dispatch?
- Python
list转std::vector为什么通常不是 Zero-Copy? - PyBind11 在跨语言调用里解决了什么?
- 什么情况下可以释放 GIL?
-
at::Tensor为什么不是整块 Tensor 数据本身? - Storage / TensorImpl / Tensor handle 大致是什么关系?
- shape 和 stride 为什么必须同时理解?
-
torch.utils.cpp_extension.load做了什么? - JIT 与 AOT Extension 有什么区别?
- 为什么自定义 CUDA Kernel 需要额外处理 Autograd?
- C++ Extension 报错时如何区分 compile / link / import?
- 为什么“用 C++ 重写”不一定自动变快?
10. 课后练习
练习 1:修改 C++ Add
把:练习 2:增加 dtype 检查
只允许:练习 3:测试非 contiguous Tensor
Python:练习 4:观察 Tensor 共享
Python:练习 5:比较 list 与 Tensor 边界
分别实现:练习 6:实现 RAII Buffer
实现:- 构造时申请内存;
- 析构时释放;
- 禁止复制;
- 支持移动;
- 可以查询 size。
11. Ringi 总结
这一讲最重要的不是:第一:所有权意识
任何资源都要问:第二:生命周期意识
任何指针都要问:第三:数据布局意识
任何 Tensor 都要问:第四:边界意识
任何 Python/C++ 调用都要问:第五:异步意识
任何 GPU 操作都要问:第六:测量意识
任何性能优化都要先问:你最终要形成这样的思维链:
12. 下一讲承接
下一讲建议进入:第02讲:GPU 执行模型与 CUDA C++ 入门——Thread / Block / Grid / Warp / Memory Hierarchy这一讲学到的:
- 指针;
- RAII;
- 模板;
- Tensor Storage;
- C++ Extension;
附录 A:最小代码包
A.1 op.cpp
A.2 test_cpp_extension.py
附录 B:参考资料
本文基于课程大纲重新组织与原创撰写,并参考以下项目/官方文档用于知识校验与延伸阅读。
-
AIInfraGuide:编程语言基础
https://github.com/caomaolufei/AIInfraGuide/blob/main/docs/guides/%E6%A8%A1%E5%9D%97%E4%B8%80-%E5%89%8D%E7%BD%AE%E7%9F%A5%E8%AF%86/%E7%AC%AC1%E7%AB%A0-%E7%BC%96%E7%A8%8B%E8%AF%AD%E8%A8%80%E5%9F%BA%E7%A1%80.md -
lilinji / DevopsBooklet:Python 实例手册增强完善版
https://github.com/lilinji/DevopsBooklet/blob/master/Python%E5%AE%9E%E4%BE%8B%E6%89%8B%E5%86%8C_%E5%A2%9E%E5%BC%BA%E5%AE%8C%E5%96%84%E7%89%88.md -
PyTorch Documentation:Custom C++ and CUDA Operators
https://docs.pytorch.org/tutorials/advanced/cpp_custom_ops.html -
PyTorch Documentation:
torch.utils.cpp_extension
https://docs.pytorch.org/docs/stable/cpp_extension.html -
PyTorch Documentation:Extending PyTorch
https://docs.pytorch.org/docs/stable/notes/extending.html -
PyTorch Documentation:
torch.library
https://docs.pytorch.org/docs/stable/library.html -
PyBind11 Documentation:STL Containers
https://pybind11.readthedocs.io/en/stable/advanced/cast/stl.html -
PyBind11 Documentation:Global Interpreter Lock
https://pybind11.readthedocs.io/en/stable/advanced/misc.html -
CPython Documentation:Free-threaded Python
https://docs.python.org/3/howto/free-threading-python.html -
PyTorch Source:ATen
TensorBase/TensorImpl
https://github.com/pytorch/pytorch/blob/main/aten/src/ATen/core/TensorBase.h
https://github.com/pytorch/pytorch/blob/main/c10/core/TensorImpl.h
Ringi 的一句话复盘:
Python 让你快速调用 AI 系统;C++ 让你真正看见这个系统如何管理内存、调度算子、连接 GPU,并最终解释“为什么它快、为什么它慢、为什么它挂”。