🏛️ 第03讲:计算机体系结构前置——CPU 存储层次、Cache Line 与 NUMA 架构
主讲人:👓 Ringi(大厂 AI Infrastructure 工程师)
所属模块:Module 00: 性能工程与系统前置
篇章范式:🏛️ 性能工程与系统前置篇(Performance Engineering & System Baseline)
核心导读:在大模型分布式训练与高并发推理中,GPU 算力利用率(MFU)低下往往不是因为 GPU 算子写得不够好,而是因为主机 CPU 端与数据流水线发生了严重阻塞(CPU Bubble)!从 CPU 存储金字塔(L1/L2/L3/DRAM)、64 字节 Cache Line、MESI 缓存一致性与伪共享风暴,到内存自然对齐、NUMA 跨 Socket 拓扑绑定以及 Pinned Memory 锁页 DMA 传输,本讲带你用大厂工程师的第一性原理彻底击穿 CPU 与内存架构,消灭数据搬运瓶颈。
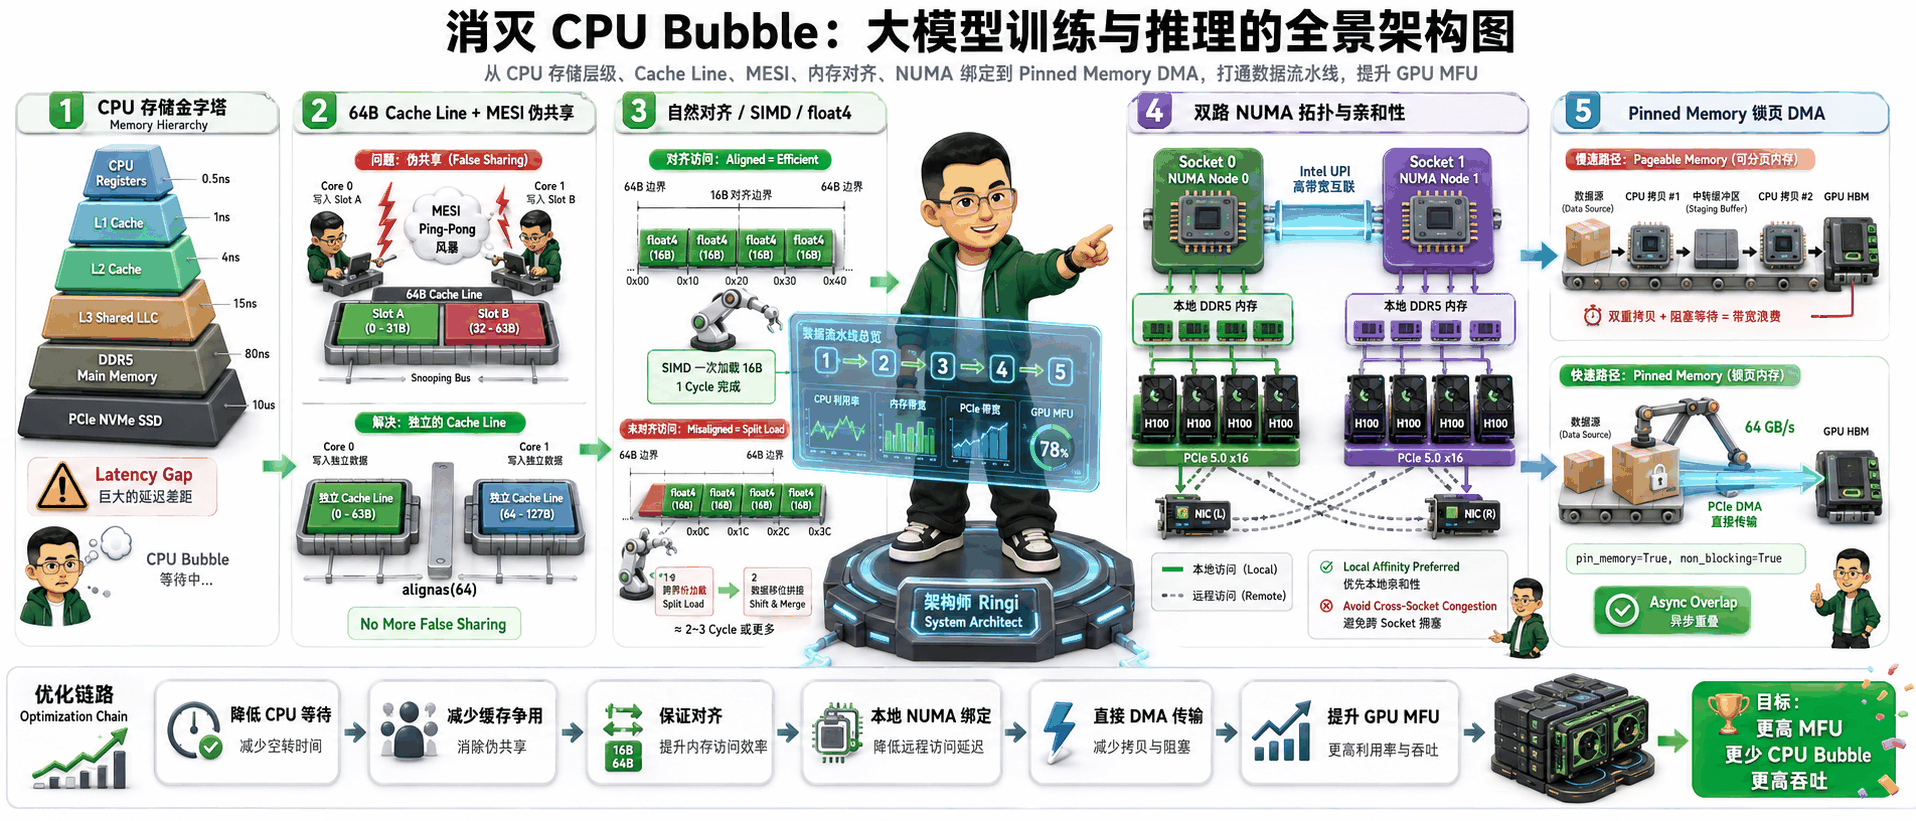
📑 目录导航
- 0. Ringi 开场:GPU 饿死往往是因为 CPU 没喂饱!
- 1. 经典计算机存储层次(Memory Hierarchy)与纳秒级时间账本
- 2. 缓存一致性与伪共享(False Sharing)性能陷阱
- 3. 内存对齐(Memory Alignment)与 SIMD / GPU 向量化
- 4. NUMA(非统一内存访问架构)深度剖析与拓扑感知
- 4.1 从 SMP 对称多处理到 NUMA 架构的演进必然
- 4.2 双路 / 多路服务器物理拓扑:Socket、本地内存控制器与 UPI/QPI 互联总线
- 4.3 本地访问 vs 远程跨 Socket 访问:延迟翻倍与带宽腰斩
- 4.4 Linux NUMA 内存分配策略(Local Alloc / Interleave / Preferred / Bind)
- 4.5 PCIe 拓扑与 NUMA 对齐:Root Complex(RC)与 GPU / NIC 亲和性
- 4.6 跨 Socket 灾难:当 GPU 0 挂在 Socket 0,而 DataLoader 线程跑在 Socket 1 时会发生什么?
- 5. 主机内存与 GPU 显存的高速通道:Pinned Memory、DMA 与 GPUDirect
- 6. 动手实战与排障调优工具箱(Hands-on Benchmark & Production Tuning)
- 7. Ringi 避坑指南与大厂经典面试题
- 8. Ringi 5 点核心速记口诀、自我检验清单与课后深度思考题
- 9. 📚 参考资料与经典论文
0. Ringi 开场:GPU 饿死往往是因为 CPU 没喂饱!
0.1 大模型训练中的经典怪象:GPU 利用率忽高忽低
刚进入大厂做 AI Infra 时,我和很多同学一样,把 90% 的精力都放在了 GPU 算子调优(CUDA / Triton)、Tensor Core 利用率、FlashAttention 和 NCCL 通信优化上。 但在一次 8 卡 H100 训练多模态大模型(Vision-Language Model)的集群排障中,监控系统报出了一个诡异的现象:- GPU 算力利用率(
Volatile GPU-Util)呈现剧烈的**“锯齿状震荡”**:前 1 秒飙到 98%,接下来 2 秒直接跌到 10% 甚至 0%; - 查看 GPU Kernel 的执行耗时,每个 GEMM 算子都跑在理论峰值的 85% 以上,Kernel 本身没有任何性能劣化;
- 用 PyTorch Profiler 抓取 Timeline,赫然发现:GPU 在大量的时间片内处于完全空闲状态(GPU Idle),都在等待 CPU 把下一个 Batch 的张量从 Host 端搬运到 Device 端!
0.2 算力与搬运的物理鸿沟:Host-to-Device 瓶颈
我们来算一笔真实的系统账本:- GPU 端算力:单张 NVIDIA H100 SXM 拥有高达 989 TFLOPS 的 BF16 Tensor Core 密集算力,其片上 HBM3 显存带宽高达 3.35 TB/s;
- 主机总线带宽:PCIe 5.0 x16 的理论单向带宽仅为 64 GB/s(双向 128 GB/s);
- CPU 内存带宽:单路 8 通道 DDR5-4800 理论峰值约 307 GB/s;如果跨越 CPU Socket(NUMA 跨插槽),跨片 UPI 总线带宽直接骤降至 64~80 GB/s。
0.3 为什么 AI Infra 工程师必须精通 CPU 体系结构?
许多初学者误以为:“AI Infra 只属于 GPU 和网络。”实际上,在真正的生产级大厂基础设施中:
- 数据加载底座(Data Pipeline):Megatron-LM、vLLM、DeepSpeed 的 DataLoader 和 Prefill 阶段调度器全运行在 CPU 上;
- 异构内存管理(Heterogeneous Memory Management):ZeRO-Offload、Llama.cpp、vLLM CPU-Offloading、Kimi 级长文本缓存换入换出,完全由 CPU 内存与 PCIe DMA 吞吐决定生死;
- 拓扑感知调度(Topology-Aware Scheduling):Kubernetes / Slurm 调度器如果不做 CPU 核心与 GPU/NIC 的 NUMA 拓扑绑定,分布式训练吞吐可能直接腰斩!
1. 经典计算机存储层次(Memory Hierarchy)与纳秒级时间账本
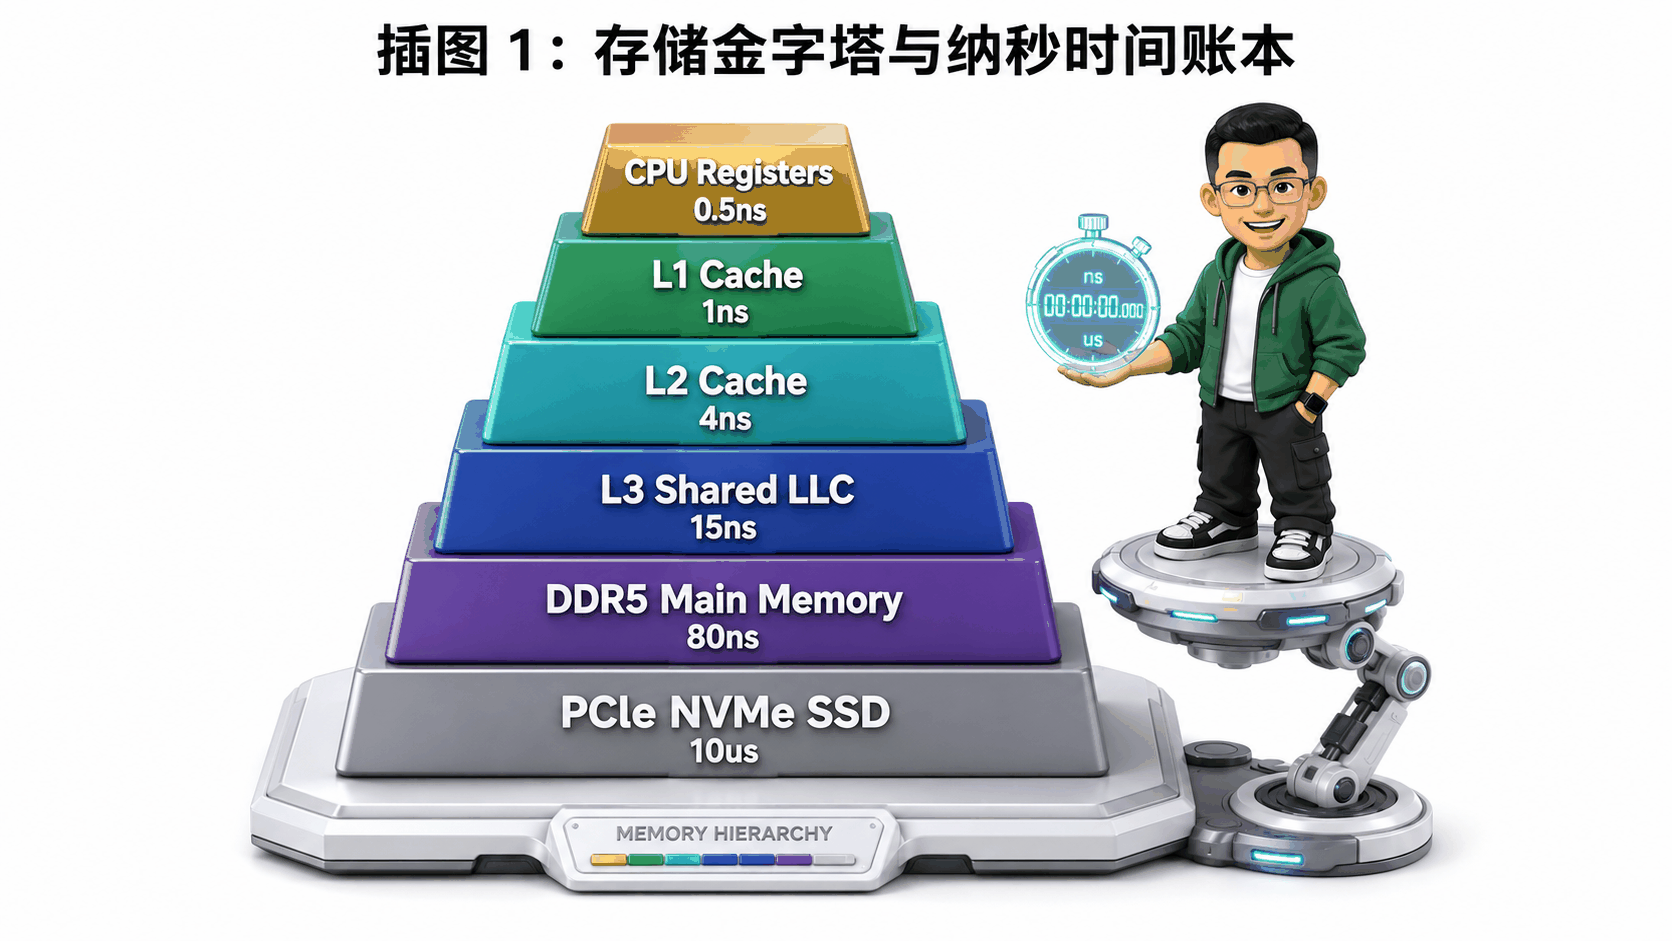
1.1 存储金字塔:从纳秒(ns)到毫秒(ms)的物理鸿沟
为了让抽象的纳秒(ns)建立起工程师的物理直觉,计算机体系结构宗师 Jim Gray 曾提出过著名的**“时钟周期放大类比法”**:💡 Ringi 的物理直觉放大镜:
假设 CPU 执行一条寄存器指令(1 个时钟周期,约 0.33 ns)相当于 “心跳 1 次(1 秒钟)”:
- 访问 L1 Cache(~1 ns):相当于从自己的上衣口袋掏出一支笔(花费 3 秒);
- 访问 L2 Cache (~4 ns):相当于站起身从身后的书架取一本书(花费 12 秒);
- 访问 L3 Cache (~15 ns):相当于下楼去楼下咖啡机倒一杯咖啡(花费 45 秒);
- 访问主内存 DRAM (~90 ns):相当于离开大楼,步行 10 分钟到街角便利店买便当(花费 4.5 分钟);
- 跨 Socket 远程 NUMA DRAM (~180 ns):相当于骑自行车 10 分钟去隔壁街区(花费 9 分钟);
- 从 NVMe SSD 读取数据 (~20 μs):相当于坐高铁从北京去上海出差 1 个月(花费 17 小时);
- 从机械硬盘或跨机房网络读取 (~10 ms):相当于人类文明经历 1 年的漫长岁月!
1.2 局部性原理:时间局部性(Temporal)与空间局部性(Spatial)
现代计算机层次化存储能以极高的性价比运行,完全依赖于程序执行的两大基本物理特征——局部性原理(Principle of Locality):- 时间局部性(Temporal Locality):
- 定义:被访问过一次的内存位置,在不久的将来极有可能被再次访问。
- AI Infra 场景:Transformer 的权重矩阵 在同一个 Batch 内被所有 Token 共享;自回归解码中的当前 Token 向量在 Attention 计算中反复与所有历史 向量做点积。
- 空间局部性(Spatial Locality):
- 定义:如果一个内存位置被访问,其物理上相邻的内存位置很快也会被访问。
- AI Infra 场景:连续读取张量的一行数据(行优先连续存储)、按顺序加载 Token IDs、顺序遍历 Embedding 向量。
1.3 CPU Cache 硬件映射原理:Direct-Mapped、Set-Associative 与 Fully-Associative
CPU 从内存加载数据时,绝不是按单个字节(Byte)去抓取的,而是以固定大小的 Cache Line 为最小原子单位进行搬运。在几乎所有现代 x86_64(Intel / AMD)与 ARM64 服务器上,Cache Line 大小均为 64 字节(64 Bytes = 512 Bits)。 一个物理内存地址在硬件 Cache 中是如何寻址的?CPU 会将 64 位物理地址切分为三个字段:1.4 为什么现代 CPU 统一采用 64 字节 Cache Line?
为什么不是 8 字节,也不是 4096 字节?这是一个经典的计算机体系结构工程 Trade-off:- 如果 Cache Line 太小(如 8 字节):
- 空间局部性收益极低;每次读取连续数组都需要触发多次 Cache Miss 和总线仲裁;
- 硬件 Tag 存储开销占比急剧上升(每个 8B 都要存一个 40+ 位的 Tag,硬件极其浪费)。
- 如果 Cache Line 太大(如 1024 字节):
- 搬运延迟过高:每次 Miss 都需要在慢速 DRAM 上读取 1KB,阻塞流水线;
- 缓存污染(Cache Pollution):如果程序是随机离散访存(如哈希表查询、稀疏矩阵),加载 1024 字节只用了其中 4 字节,浪费了 99.6% 的有效缓存容量与总线带宽。
- 64 字节的黄金平衡点:
- 刚好能放下 16 个单精度浮点数(
float32)、8 个双精度浮点数(float64)、或者 32 个半精度浮点数(fp16/bf16); - 完美匹配现代 DDR 内存的 Burst Length 突发传输模式(DDR4/DDR5 每次 Burst Transfer 刚好传输 64 字节)。
- 刚好能放下 16 个单精度浮点数(
2. 缓存一致性与伪共享(False Sharing)性能陷阱
2.1 MESI 协议与总线嗅探(Bus Snooping)底层流转
在现代多核 CPU 中,每个核心(Core)拥有独立的私有 L1 和 L2 Cache。当多个核心同时读取和修改同一个物理内存地址时,如何保证所有核心看到的内存数据是一致的? 硬件层面采用经典的 MESI 缓存一致性协议(Modified, Exclusive, Shared, Invalid):
总线嗅探(Bus Snooping)机制:每个核心都在时刻监听内部互联总线上的广播事件。一旦 Core 0 要向处于
S 状态的 Cache Line 写入数据,Core 0 必须向总线发出 BusInval(失效广播);所有缓存了该行的其他 Core(如 Core 1)嗅探到该事件后,必须强制将自己的 Cache Line 状态从 S 置为 I(失效)!
2.2 什么是伪共享?两个独立变量为何引发总线风暴?
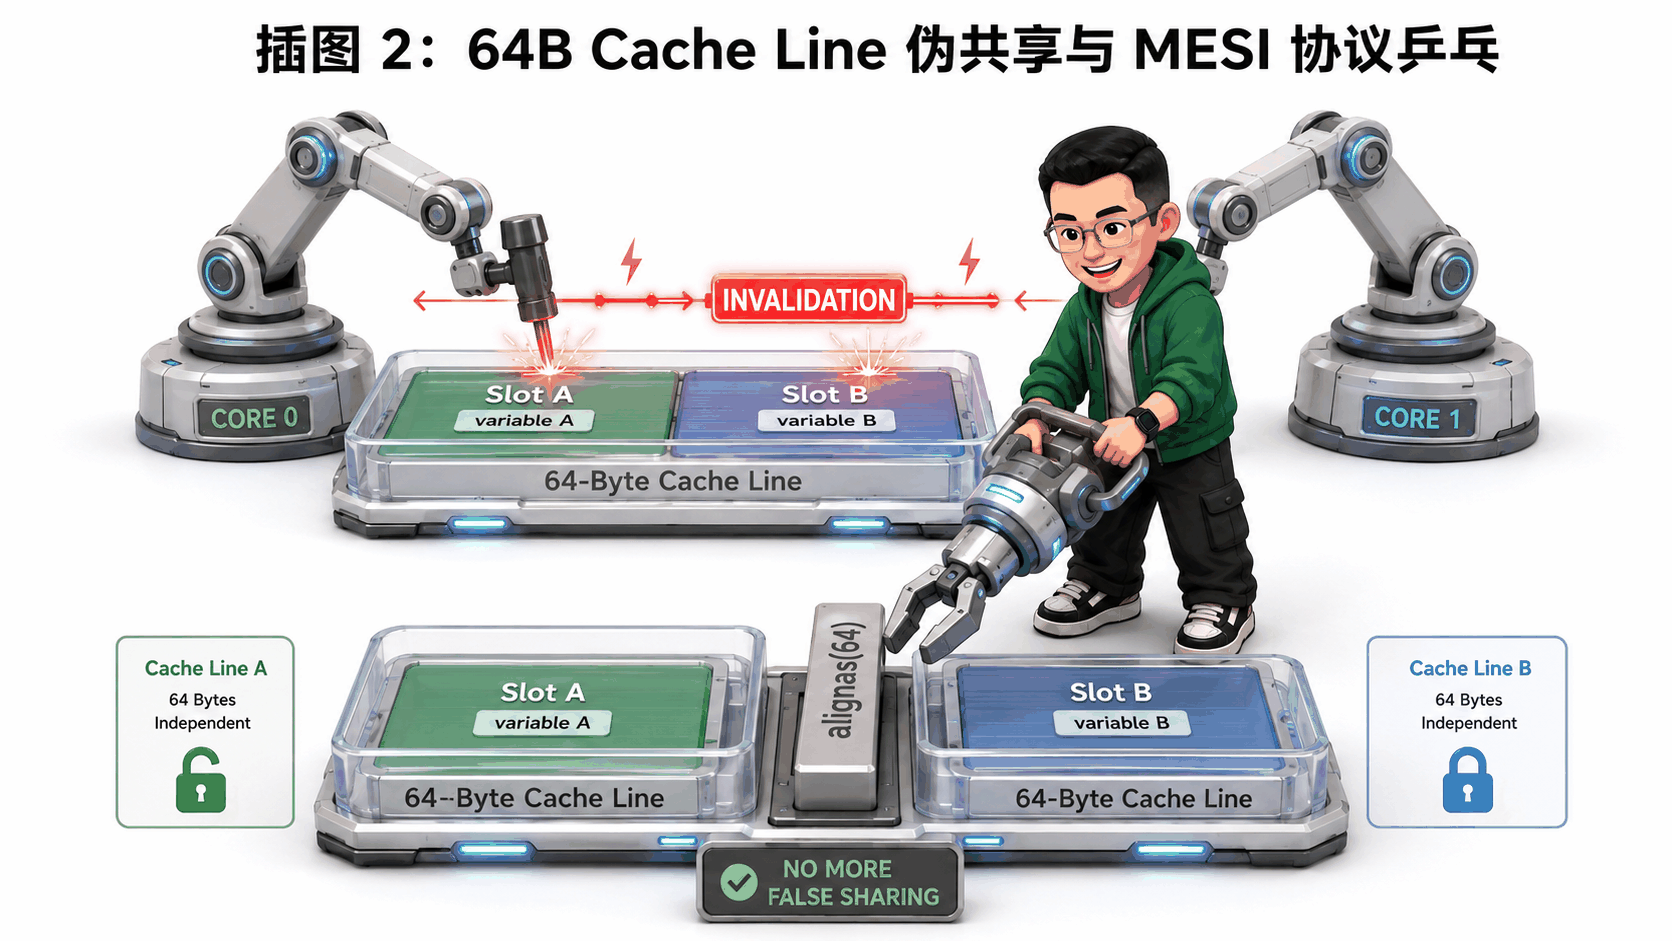
🚨 物理冲突根源
假设内存中有两个完全独立的变量:uint64_t counter_A(线程 0 专用累加器,8 字节);uint64_t counter_B(线程 1 专用累加器,8 字节)。
- 时刻 T1:Core 0 读取该 Cache Line,执行
counter_A++。Core 0 将该 Line 标记为M(Modified),并向总线广播:将 Core 1 的该 Cache Line 置为I(Invalid); - 时刻 T2:Core 1 准备执行
counter_B++,发现自己的 Cache Line 是I(失效),触发 Cache Miss!Core 1 必须暂停流水线,强制让 Core 0 将脏数据写回 L3/内存,再重新加载到 Core 1; - 时刻 T3:Core 1 修改
counter_B,又将该 Line 标记为M,反向将 Core 0 的 Cache Line 置为I; - 时刻 T4:Core 0 再次访问
counter_A,又触发 Cache Miss……
2.3 伪共享在多线程 C++ 与 DataLoader 多 Worker 中的真实破坏力
这种伪共享风暴会导致:- CPU 私有 L1/L2 缓存完全瘫痪:原本 1ns 的 L1 Hit 变成了 20~50ns 的跨核嗅探与 L3 仲裁;
- 总线带宽被无效的一致性广播挤爆;
- 多线程加速比严重倒挂:开 8 个线程跑累加,耗时竟然比单线程慢 5~10 倍!
2.4 消除伪共享的黄金法则:alignas(64)、Padding 填充与线程私有化
消除伪共享的核心原则只有一条:强制让每个并发写变量独占一个完整的 64 字节 Cache Line!
方法 1:使用 C++11 标准对齐关键字 alignas(64)(推荐)
方法 2:显式手动 Padding 填充
3. 内存对齐(Memory Alignment)与 SIMD / GPU 向量化
3.1 自然对齐(Natural Alignment)的硬件第一性原理
在计算机底层,数据存放在内存中的起始地址必须是其自身大小的整数倍,这被称为自然对齐(Natural Alignment)。- 1 字节数据(
char,int8):可存放在任意物理地址( ); - 2 字节数据(
int16,half,bfloat16):地址必须是 2 的倍数(地址末 1 位为 0); - 4 字节数据(
int32,float32):地址必须是 4 的倍数(地址末 2 位为 0); - 8 字节数据(
int64,double, 指针):地址必须是 8 的倍数(地址末 3 位为 0); - 16 字节数据(SIMD 向量
__m128, GPUfloat4):地址必须是 16 的倍数(地址末 4 位为 0)。
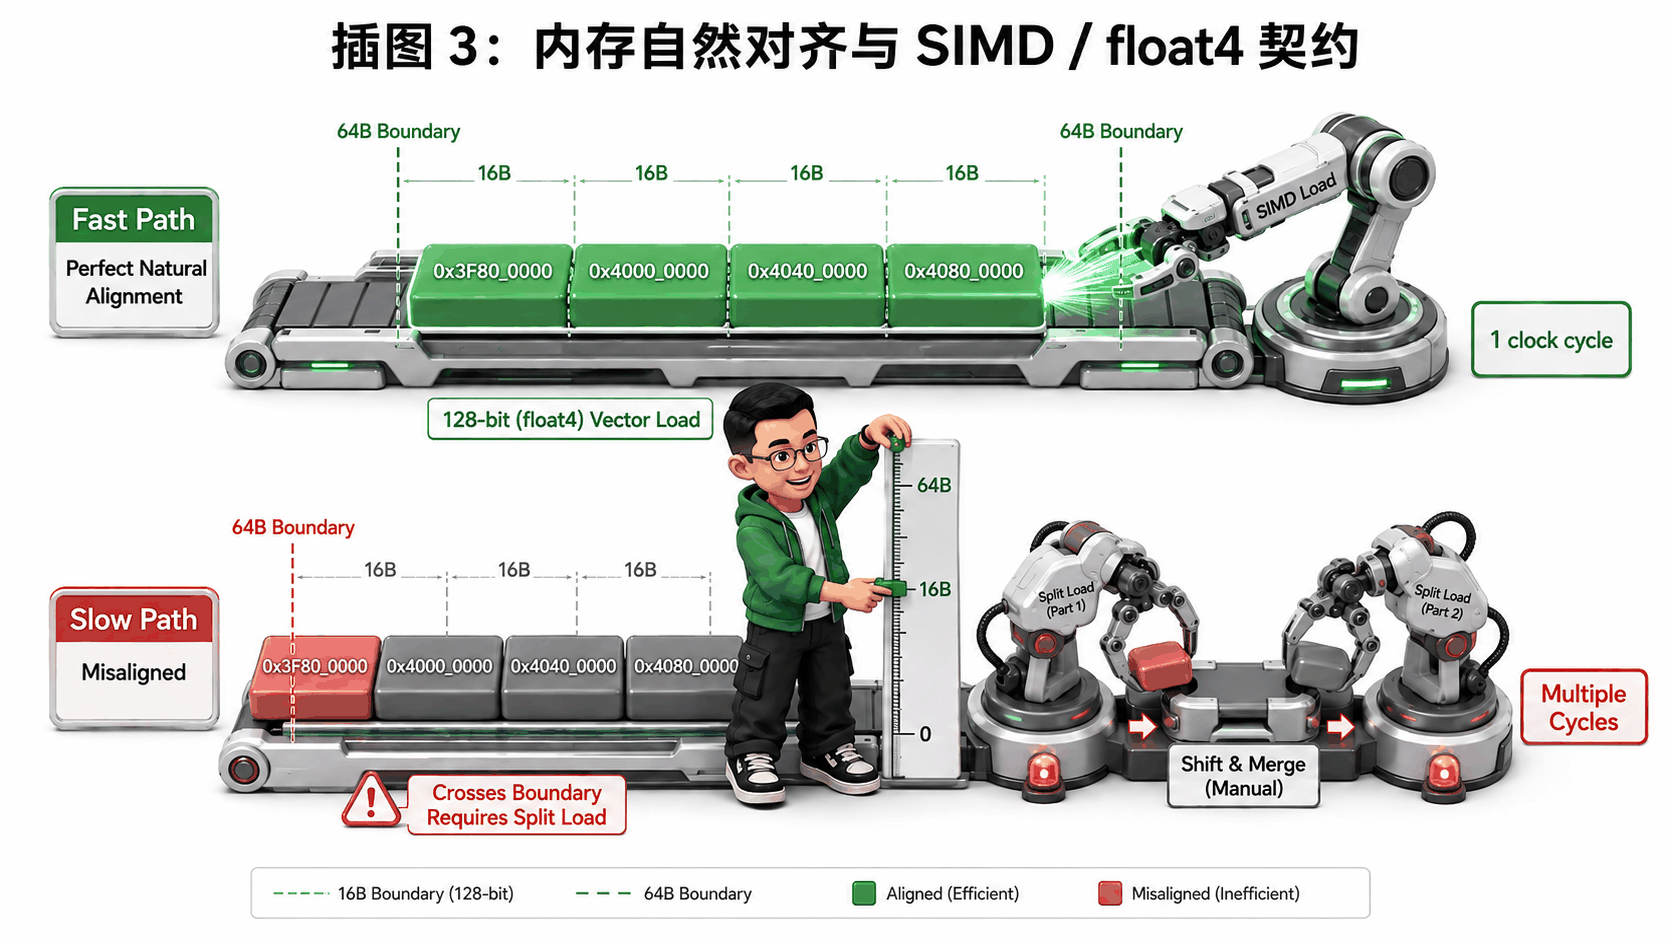
double 存放在地址 0x0005:
- 硬件必须先发起一次总线读取
0x0000 ~ 0x0007; - 再发起第二次总线读取
0x0008 ~ 0x000F; - CPU 内部的对齐逻辑单元(Alignment Network)进行移位、掩码和拼接,合成为一个 64 位寄存器值。
3.2 跨 Cache Line / 跨页非对齐访问的惩罚代价
如果非对齐的地址刚好横跨了 64 字节 Cache Line 边界 甚至 4KB 虚拟内存页(Page Boundary):- 跨 Cache Line 访问(Split Lock / Split Access):必须同时加载两个 Cache Line,消耗双倍缓存容量,并在多核并发时可能触发硬件总线锁(Bus Lock),导致整机所有核心瞬间停顿!
- 跨 Page 边界访问:如果前一个页在物理内存中,而后一个页被操作系统换出到了磁盘(Page Fault),CPU 甚至会触发中断去读磁盘,带来微秒级甚至毫秒级的灾难性停顿。
3.3 C/C++ 结构体内存对齐规则与结构体瘦身实战
C/C++ 编译器会自动按照结构体成员的最大对齐数进行内存填充(Structure Padding)。 来看一个生动的算例:3.4 CPU AVX-512 / AVX2 与 GPU float4 / int4 向量化加载对齐契约
在 AI Infra 性能敏感算子(如 CPU 端的量化解包、GPU 端的 FlashAttention IO)中,我们大量使用 SIMD / 向量化指令:
- CPU AVX-512:一次加载 512 位(64 字节 = 16 个 FP32)。如果地址未做 64 字节对齐,调用
_mm512_load_ps会直接触发硬件段错误(Segmentation Fault / General Protection Fault),必须退化为慢速的_mm512_loadu_ps(Unaligned Load); - CUDA 向量化加载:使用
float4(16 字节)一次加载 4 个 float。CUDA 官方硬件规范明确规定:float4指针必须严格按照 16 字节自然对齐。如果传入一个非 16 字节对齐的指针执行*(float4*)ptr,在 GPU 硬件上将直接触发未定义行为或内存访问降速。
4. NUMA(非统一内存访问架构)深度剖析与拓扑感知
4.1 从 SMP 对称多处理到 NUMA 架构的演进必然
在早期多核服务器中,采用的是 SMP 架构(Symmetric Multi-Processing,对称多处理):当 CPU 核心数增加到 32、64、128 核时,集中式总线瞬间成为整个系统的超级瓶颈,所有核心都在争抢总线仲裁,发生了著名的 内存墙(Memory Wall) 坍塌。 为了突破 SMP 的物理极限,现代多路服务器全面转向了 NUMA 架构(Non-Uniform Memory Access,非统一内存访问)。
4.2 双路 / 多路服务器物理拓扑:Socket、本地内存控制器与 UPI/QPI 互联总线
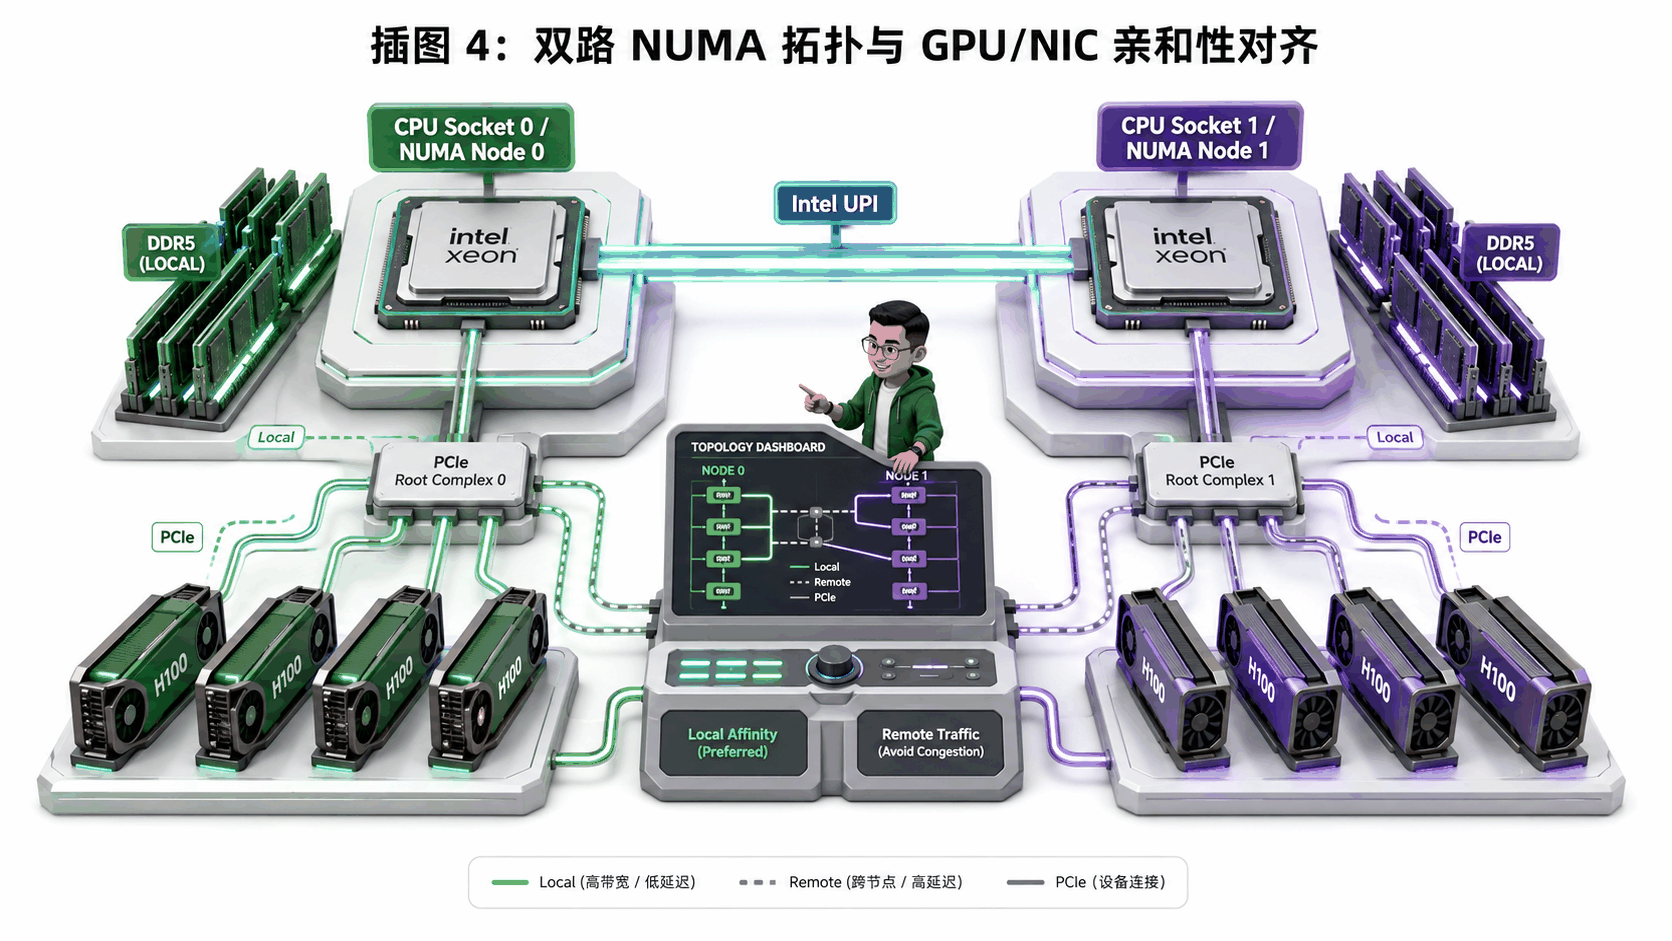
- 每个 CPU Socket 内部集成了独立的本地内存控制器(Integrated Memory Controller, IMC),直接连接插在自己身边的本地 DDR5 内存插槽;
- 两个 CPU Socket 之间通过点对点的高速相干互联总线连接(Intel 称为 UPI (Ultra Path Interconnect) / QPI,AMD 称为 Infinity Fabric)。
4.3 本地访问 vs 远程跨 Socket 访问:延迟翻倍与带宽腰斩
在 NUMA 系统中,CPU 访问不同位置的内存,成本存在天壤之别:- 本地访问(Local Node Access):Core 0 访问挂在 Socket 0 上的本地内存。请求直接通过片内总线到达 IMC,延迟仅需 ~65-75 ns,享受满血 ~300 GB/s 内存带宽;
- 远程访问(Remote Node Access):Core 0 访问挂在 Socket 1 上的远端内存。请求必须:
- 离开 Core 0,通过 Socket 0 片内 Mesh 路由;
- 跨越 Socket 间的 UPI 物理链路;
- 进入 Socket 1 的 IMC 读取数据;
- 再通过 UPI 链路将数据打包发送回 Socket 0。
4.4 Linux NUMA 内存分配策略(Local Alloc / Interleave / Preferred / Bind)
Linux 内核提供了四种核心 NUMA 内存分配策略(Memory Policy):4.5 PCIe 拓扑与 NUMA 对齐:Root Complex(RC)与 GPU / NIC 亲和性
这是很多软件工程师容易忽略的核心体系结构事实:PCIe 插槽(PCIe Slot)不是悬空连接在主板上的,而是物理直连在某个特定的 CPU Socket 的 PCIe Root Complex(根复合体)上的!例如在一台典型的 8 卡 H100 双路服务器中:
- Socket 0(NUMA Node 0):直接管理 PCIe Root Port 0~3,下挂 GPU 0、GPU 1、GPU 2、GPU 3 以及 InfiniBand 网卡
mlx5_0; - Socket 1(NUMA Node 1):直接管理 PCIe Root Port 4~7,下挂 GPU 4、GPU 5、GPU 6、GPU 7 以及 InfiniBand 网卡
mlx5_1。
4.6 跨 Socket 灾难:当 GPU 0 挂在 Socket 0,而 DataLoader 线程跑在 Socket 1 时会发生什么?
我们来还原大厂生产环境中一次真实的**“拓扑未对齐灾难”**:GPU 0 数据加载的 DataLoader 进程调度到了 Socket 1 的核心上:
- DataLoader 在
Socket 1的内存池中解析并转换图像/文本张量; - 当执行
tensor.cuda(0)时,GPU 0 的 DMA 引擎发起 PCIe 读取; - 由于数据位于
Socket 1的内存中,PCIe 传输必须强行穿过 CPU Socket 0 与 Socket 1 之间的 UPI 互联总线; - UPI 总线带宽被庞大的训练数据流彻底打满,产生严重的排队拥塞;
- 同时,分布式通信(NCCL)和 GPU 0 的其他控制信令也因 UPI 拥塞而发生抖动延迟;
- 最终后果:GPU 0 数据加载延迟从 3ms 飙升至 25ms,GPU 算力利用率从 95% 暴跌至 40%!
5. 主机内存与 GPU 显存的高速通道:Pinned Memory、DMA 与 GPUDirect
5.1 Pageable Memory(可分页内存)vs Pinned Memory(锁页内存)
在 Linux 操作系统中,普通的内存分配(如malloc、C++ new、普通 PyTorch CPU Tensor)默认都是 Pageable Memory(可分页内存):
- 操作系统为了最大化利用物理内存,维护着一套虚拟内存分页机制;
- 当物理内存紧张时,操作系统可以随时将某些不活跃的内存页换出(Swap Out)到磁盘 Swap 分区;
- 物理内存页的物理地址(Physical Address)在程序运行期间是随时可能发生迁移和改变的。
mlock 或 CUDA 驱动的 cudaHostAlloc / cudaHostRegister)向操作系统申请的特殊内存:
- 操作系统向硬件承诺:这块内存在生命周期内绝对不会被换出到磁盘,且物理内存地址永久固定不变!
5.2 为什么 GPU DMA 必须访问物理连续且不被换页的 Pinned Memory?
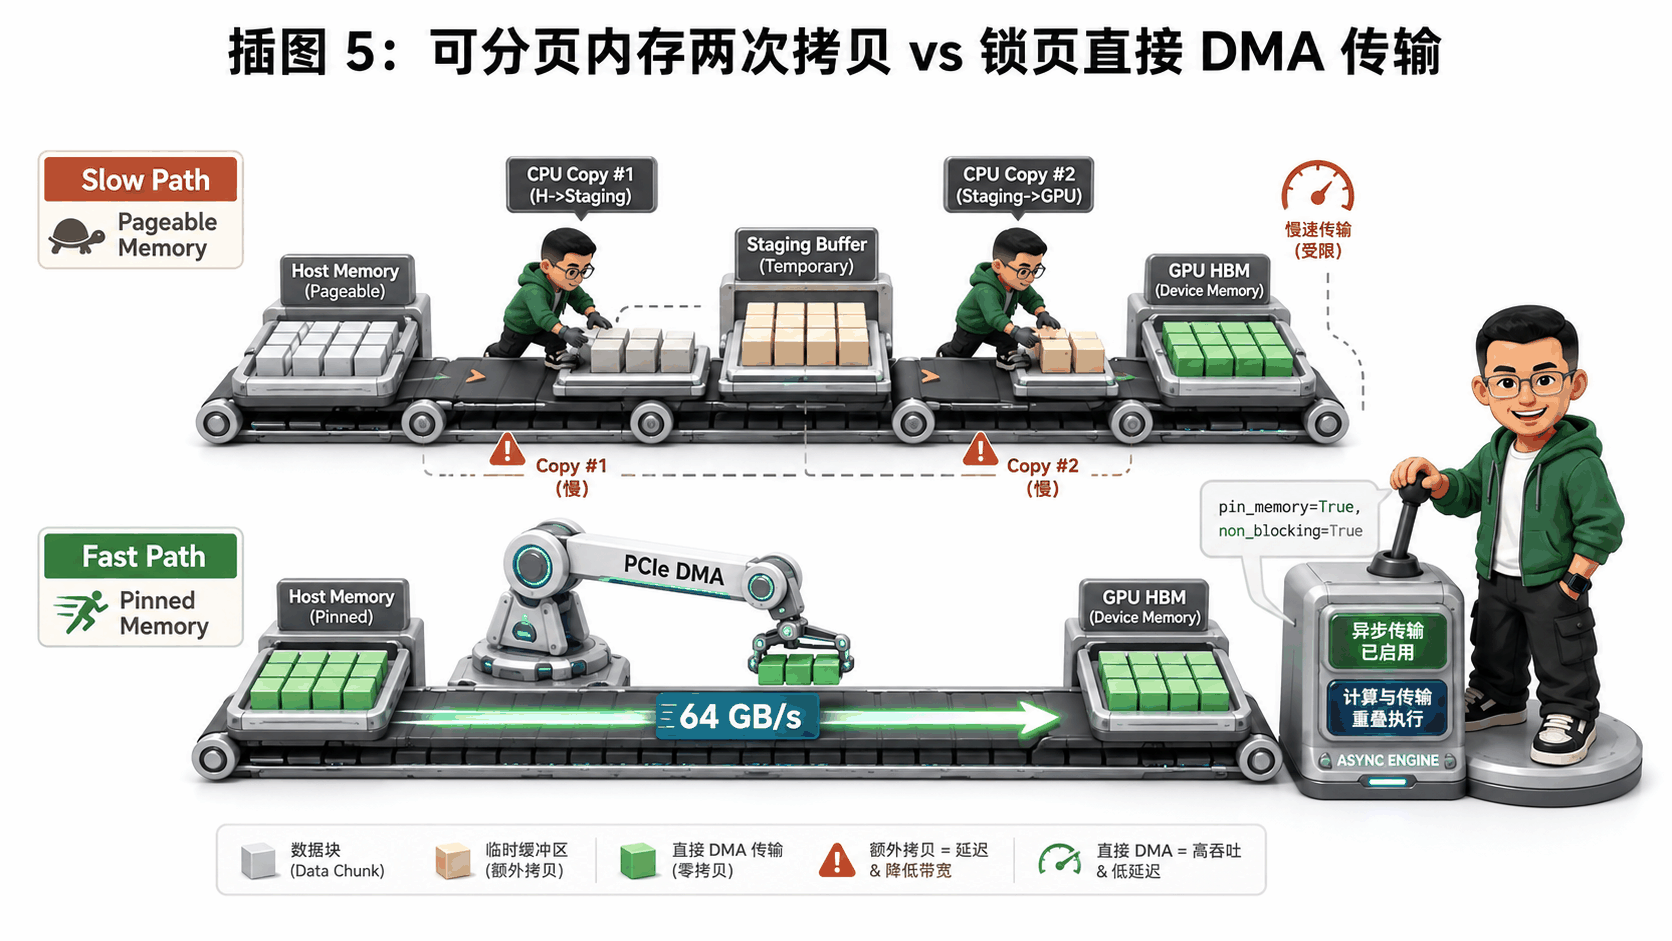
1. 传统 Pageable 内存传输路径(慢速两次拷贝)
如果一个 PyTorch Tensor 是普通内存:- GPU DMA 无法直接读取它(因为操作系统随时可能换页或改变物理地址);
- 第一步(CPU 强力介入):CUDA 驱动必须在后台临时申请一块临时的 Pinned Staging Buffer,并由 CPU 调用
memcpy将数据从用户内存拷贝到 Staging Buffer; - 第二步(DMA 传输):GPU DMA 引擎从 Staging Buffer 发起 PCIe DMA 传输到 GPU HBM 显存;
- 性能代价:消耗双倍主机内存带宽,强行占用 CPU 算力,且无法实现真正的异步重叠(Synchronous Blocking)!
2. Pinned 锁页内存传输路径(零拷贝直达 DMA)
如果是 Pinned Memory:- 物理地址已知且绝对锁定;
- GPU DMA 引擎直接通过 PCIe 总线拉取数据,CPU 完全不参与搬运,0 额外内存拷贝,达到 PCIe 物理带宽峰值!
5.3 cudaMemcpyAsync 与 DataLoader(pin_memory=True, non_blocking=True) 的异步流水线重叠机制
在 PyTorch 训练主循环中,要想彻底消除 CPU 搬运等待,必须同时开启两个黄金开关:
⚙️ 为什么必须组合使用?
pin_memory=True:保证了张量位于锁页内存中,使得 CUDA 底层能够调用真正的异步硬件传输指令cudaMemcpyAsync;non_blocking=True:使得 Python 主线程在向 CUDA Stream 发起传输指令后立即返回,无需等待数据传输完毕。GPU 的 DMA 拷贝引擎与 Tensor Core 计算引擎在硬件上是独立并行的,由此实现了 当前 Batch 计算与下一个 Batch 数据搬运的 100% 异步重叠!
5.4 GPUDirect Storage (GDS) 与 GPUDirect RDMA:绕过 CPU 的直通高速路
随着 GPU 算力进一步暴涨,即便经过 Pinned 内存,CPU 主存依然会面临带宽瓶颈。因此,NVIDIA 推动了 GPUDirect 革命:- GPUDirect Storage (GDS):基于 PCIe P2P(Peer-to-Peer)DMA 技术,NVMe SSD 上的 Checkpoint 或多模态数据集直接通过 PCIe Switch 写入 GPU HBM 显存,彻底绕过 CPU 主机内存与 CPU 核心,吞吐提升 3~5 倍,端到端延迟降低 80%;
- GPUDirect RDMA:跨节点分布式训练(AllReduce)中,InfiniBand / RoCE 网卡直接从 GPU 显存读取数据并通过网络发送,无需在 CPU 内存做二次中转。
6. 动手实战与排障调优工具箱(Hands-on Benchmark & Production Tuning)
6.1 工具箱 1:Linux NUMA 与 CPU 拓扑探测实战(lscpu, numactl, numastat, nvidia-smi topo -m)
在大厂运维或排障的第一步,就是使用 Linux 体系结构工具箱对宿主机进行体检:
1. lscpu 查看核心与 NUMA 拓扑
2. numactl --hardware 查看 NUMA 距离矩阵
💡 解读:本地访问距离权重为 10,跨 Socket 访问距离权重高达 21(延迟超 2.1 倍)!
3. nvidia-smi topo -m 查看 GPU 与 CPU NUMA 绑定关系
💡 关键发现:GPU 03 亲和在 NUMA Node 0,GPU 47 亲和在 NUMA Node 1!
6.2 实战 2:C++ 测量不同步长遍历数组的 Cache Line 阶梯时延(L1/L2/L3/DRAM 实测)
通过改变访存步长(Stride),我们可以清晰地测出 64 字节 Cache Line 的物理拐点:📊 典型测试输出与深度剖析
💡 原理解析:
当stride <= 16( 字节)时,一次 Cache Line 加载读入的 64 字节数据能被后续多次循环复用(空间局部性极佳),单次访问均摊耗时小于 1ns;
一旦stride > 16( 字节),每一次访问都跨越到了下一个全新的 Cache Line,每次访问都必然触发一次新的 Cache 检索甚至 Miss,耗时直接成倍暴增!
6.3 实战 3:C++ 伪共享性能压测与 alignas(64) 优化前后对比
下面用一段工业级多线程压测代码,直观展示 alignas(64) 如何产生 8 倍以上的性能逆袭:
📊 典型压测结果对比
6.4 实战 4:PyTorch DataLoader CPU 核心亲和性绑定与 NUMA 拓扑对齐脚本
在实际多卡训练时,如何用 Python 优雅地把 DataLoader Worker 严格锁定在 GPU 所属的 NUMA Node 上?7. Ringi 避坑指南与大厂经典面试题
7.1 避坑表格(❌ 常见小白错误理解 vs ✅ 大厂 AI Infra 正确理解)
7.2 4 道大厂硬核体系结构与 AI Infra 面试题(附白板推导、系统设计与标准答题路径)
💡 面试题 1:什么是 Cache Line 伪共享(False Sharing)?在多线程数据预处理或 C++ 自定义算子中如何排查与彻底消除?
🎯 大厂标准答题路径:
- 物理机理解释:现代 CPU 的最小缓存管理单位是 64 字节 Cache Line。当多线程并发修改位于同一个 Cache Line 中的两个或多个逻辑独立变量时,根据 MESI 缓存一致性协议,任意一个核心的写入都会向总线广播
BusInval使其他所有核心的 Cache Line 副本失效; - 后果剖析:导致 Cache Line 在多核之间频繁进行无效的状态乒乓(Bouncing),私有 L1/L2 缓存命中率暴跌,总线拥塞,多线程性能严重倒挂;
- 排查方法:
- 使用 Linux
perf c2c(Cache-to-Cache 分析工具)精准定位发生 False Sharing 的内存地址与代码行; - 观察
perf stat中的L1-dcache-load-misses与跨核总线嗅探命中数;
- 使用 Linux
- 消除方案:
- 使用 C++11 的
alignas(64)显式声明变量或结构体 64 字节对齐; - 手动添加 Padding 占位字节(如
uint8_t pad[56]); - 将全局共享统计变量重构为线程局部变量(Thread Local Storage,
thread_local),在计算完成后做一次单次汇总规约。
- 使用 C++11 的
💡 面试题 2:请详细推导 CPU L1、L2、L3 到 DDR5 主存的访问延迟与带宽量级。为什么说现代 GPU 训练中 CPU 端也会产生 Pipeline Bubble?
🎯 大厂标准答题路径:
- 量级推导与对比:
- L1 Data Cache:~1ns(
4 时钟周期),单核带宽 35 TB/s; - L2 Cache:~4ns(
14 时钟周期),单核带宽 1.52 TB/s; - L3 Shared Cache:~15-20ns(
50-70 时钟周期),总带宽 400800 GB/s; - 本地 DDR5 主内存:~70-90ns(
250-300 时钟周期),带宽 200300 GB/s; - 跨 Socket 远端内存:
140-180ns,带宽骤降至 60100 GB/s;
- L1 Data Cache:~1ns(
- CPU Bubble 产生机制:
- 深度学习训练前向与反向计算是在 GPU 上异步执行的;
- CPU 必须在后台执行 Dataset 读取、解压缩、数据增强、Tokenize 与张量转换;
- 如果 CPU 发生 Cache 严重颠簸、跨 NUMA 内存搬运或非锁页内存二次拷贝,导致单 Batch 准备耗时 ;
- GPU 执行完当前 Batch 后,不得不向 Host 发出等待同步请求,GPU 计算流水线出现大面积真空停顿(Pipeline Bubble),算力利用率(MFU)暴跌。
💡 面试题 3:为什么 GPU 的 cudaMemcpyAsync 必须依赖 Pinned Memory?DataLoader(pin_memory=True) 底层到底发生了什么?
🎯 大厂标准答题路径:
- DMA 物理机制:GPU 主机通信由硬件 DMA 引擎驱动。DMA 独立于 CPU 运行,只接受物理连续且固定不变的物理内存地址。普通 Pageable 内存随时可能被 Linux 内核换页或迁移物理地址,导致 DMA 发生非法内存访问;
- 普通内存的退化路径:如果传输 Pageable 内存,CUDA 驱动必须在后台隐式申请一块临时 Pinned 缓冲区,先由 CPU 通过
memcpy将数据拷贝到临时缓冲区,再发起 DMA。这导致了双倍内存开销与 CPU 阻塞; pin_memory=True底层机制:- DataLoader 在初始化内存池时,通过 C++ 底层的
cudaHostAlloc或mlock提前分配锁页内存; - DataLoader Worker 将解析后的 Batch 直接写入这块物理锁定的内存中;
- 当调用
.to('cuda', non_blocking=True)时,CUDA 驱动直接将该物理地址提交给 GPU DMA 引擎,发起真正的异步硬件传输,释放 CPU 线程,实现计算与传输的完全并发。
- DataLoader 在初始化内存池时,通过 C++ 底层的
💡 面试题 4:什么是 NUMA 架构?在一台 8 卡 H100 双路 Intel Xeon 服务器上,如何设计训练任务的 CPU 核心、NUMA 节点、网卡与 GPU 拓扑绑定方案?
🎯 大厂标准答题路径:
- NUMA 架构定义:非统一内存访问架构,多 Socket 拥有各自的本地内存控制器,通过 UPI/QPI 高速互联。本地访存快,跨 Socket 访存延迟翻倍、带宽减半;
- 物理拓扑勘测:
- 通过
nvidia-smi topo -m和lscpu确定 PCIe 挂载树: - GPU 0
3 与 NIC 0 挂在 Socket 0(NUMA Node 0,CPU Core 055); - GPU 4
7 与 NIC 1 挂在 Socket 1(NUMA Node 1,CPU Core 56111);
- 通过
- 端到端绑定方案设计:
- 进程级 NUMA 绑定:使用
numactl或启动脚本控制 Local Rank 03 绑定7 绑定NUMA Node 0,Local Rank 4NUMA Node 1: - 网络亲和性绑定:设置 NCCL 环境变量,让 Rank 0~3 强制使用同 Socket 的网卡:
- Worker 亲和性:在 DataLoader
worker_init_fn中调用os.sched_setaffinity细化子进程核心池,彻底消除跨 Socket 内存与 PCIe 流量污染。
- 进程级 NUMA 绑定:使用
8. Ringi 5 点核心速记口诀、自我检验清单与课后深度思考题
📝 Ringi 5 点核心速记口诀
🧪 自我检验清单(Self-Check Quiz)
- 你能否脱稿画出 CPU 寄存器、L1、L2、L3、DRAM、PCIe 与 SSD 的延迟与容量金字塔?
- 为什么现代 x86/ARM CPU 统一采用 64 字节作为 Cache Line 大小?
- 解释 MESI 协议中的 4 种状态,以及为什么 Core 0 写入会导致 Core 1 的 Cache Line 变为
I? - 什么是伪共享(False Sharing)?如何用一行 C++ 代码
alignas(64)消除它? - 为什么非对齐的内存访问可能会导致性能严重下降甚至触发总线锁(Split Lock)?
- 在双路服务器中,什么是 Local Node 与 Remote Node?跨 Socket 访问经过了什么硬件总线?
- 为什么 GPU DMA 必须使用 Pinned Memory,而不能直接读取普通 Pageable Memory?
- 在 PyTorch 中,
DataLoader(pin_memory=True)配合tensor.to(..., non_blocking=True)是如何实现 Overlap 的? - 如何使用
lscpu和nvidia-smi topo -m命令排查 GPU 与 CPU 的 NUMA 亲和性? - 如果 GPU 0 挂在 Socket 0,而训练进程被操作系统调度到了 Socket 1,会发生什么后果?
🧠 课后深度思考题
- 极端边界探索:如果把 CPU 的 Cache Line 从 64 字节增大到 256 字节,在大模型推理自回归 Decode 阶段(随机离散访问 KV Cache)和训练阶段(密集连续 GEMM 访问),性能会分别发生什么变化?
- 系统架构权衡:在 CXL(Compute Express Link)时代,CXL.mem 允许 GPU 和 CPU 共享统一的低延迟内存池。请思考:CXL 架构对现代 NUMA 编程范式和 GPU 异构内存管理(Heterogeneous Memory Management)会带来怎样的颠覆?
- 生产排障实战:假设你在集群监控中发现某台训练节点的 GPU 利用率只有 30%,但 CPU 利用率高达 100%。你会使用哪些 Linux / 体系结构性能工具(如
top,perf,numastat,htop,nsight systems)按照什么顺序一步步定位根因?
9. 📚 参考资料与经典论文
本文严格基于经典计算机体系结构第一性原理与大厂生产实践原创撰写,并参考以下权威教材、经典论文与官方技术白皮书用于深入钻研与知识校验:
📖 体系结构经典教材与专著
- John L. Hennessy & David A. Patterson: Computer Architecture: A Quantitative Approach (6th Edition), Morgan Kaufmann, 2017. —— 存储层次结构(Memory Hierarchy)、多核缓存一致性与硬件性能度量圣经。
- Randal E. Bryant & David R. O’Hallaron: Computer Systems: A Programmer’s Perspective (CS:APP 3rd Edition), Pearson, 2015. —— 空间与时间局部性、Cache 组相联映射、内存对齐与系统级性能优化。
- Ulrich Drepper: What Every Programmer Should Know About Memory, Red Hat Inc., 2007. —— 深入到晶体管与内存总线级别的经典长文,系统剖析 Cache Line、TLB、DMA 与 NUMA 机制。
📄 关键学术论文与工业白皮书
- STREAM Benchmark: Memory Bandwidth: Sustained Storage Performance on High-Performance Computers (John D. McCalpin, 1995). —— 衡量 CPU 内存带宽与多核可扩展性的业界黄金基准。
- PagedAttention / vLLM: Efficient Memory Management for Large Language Model Serving with PagedAttention (Woosuk Kwon et al., SOSP 2023). —— 借鉴操作系统虚拟内存分页机制,彻底消除大模型推理 KV Cache 显存碎片。
- GPUDirect Storage (GDS): GPUDirect Storage: A Technology Introduction (NVIDIA Technical Whitepaper, 2023). —— 绕过 CPU 内存与内核中转,实现 NVMe SSD 到 GPU HBM 的 PCIe P2P DMA 零拷贝直达。
- Megatron-LM: Megatron-LM: Training Multi-Billion Parameter Language Models Using Model Parallelism (Mohammad Shoeybi et al., arXiv:1909.08053). —— 分布式训练中异步数据流水线(DataLoader Overlap)与 Host-to-Device 瓶颈消除。
- Intel Ultra Path Interconnect (UPI): Intel Xeon Scalable Processor Architecture Specification (Intel Corporation). —— 多路服务器 UPI 点对点互联总线拓扑、相干协议与 NUMA Distance 延迟建模。
🛠️ 官方开发文档与开源项目
- Linux Kernel Documentation: NUMA Memory Policy
https://www.kernel.org/doc/html/latest/admin-guide/mm/numa_memory_policy.html - NVIDIA CUDA C++ Programming Guide: Page-Locked Host Memory & Asynchronous Concurrent Execution
https://docs.nvidia.com/cuda/cuda-c-programming-guide/index.html#page-locked-host-memory - PyTorch Documentation:
torch.utils.data.DataLoaderpin_memory & worker_init_fn
https://pytorch.org/docs/stable/data.html#memory-pinning - GitHub 开源项目:
- AI-fundamentals (Microsoft): https://github.com/microsoft/AI-fundamentals
- AIInfraGuide (caomaolufei): https://github.com/caomaolufei/AIInfraGuide
- nccl-tests (NVIDIA): https://github.com/NVIDIA/nccl-tests
下一讲预告:搞懂了底层硬件体系结构与内存拓扑后,我们将正式进入 Linux 操作系统与性能调优核心工具箱——第04讲:Linux 系统基线与性能分析核心工具箱(perf / eBPF / sar / cgroups),带你手把手掌握大厂性能工程师必备的系统排障手术刀!