📐 第02讲:AI Infra 数学第一性原理——从张量物理寻址、GEMM 算力账本到自动微分与数值防爆
主讲人:👓 Ringi(大厂 AI Infrastructure 工程师)
所属模块:Module 00: 性能工程与系统前置
篇章范式:📐 模型架构、算法与显存建模篇(Model Architecture & Memory Ledger Paradigm)
核心导读:AI Infra 不要求每天手推纯数定理,但要求看到公式时能立刻回答 Ringi 三问:张量是什么 Shape?需要多少 FLOPs 计算与显存带宽?底层硬件怎样实现才稳定? 本讲融合 6 张 16:9 手办级 3D 架构工坊插图、全流程数学手算推导、8 大工业综合算例、4 组可运行 PyTorch 验证代码与 12 道课后思考题,带你用“第一性原理”彻底击穿 AI Infra 核心数学底座!
📑 目录导航
- 0. Ringi 开场:AI Infra 工程师怎么看数学?
- 1. 学习目标、符号与三类核心工程问题
- 2. 线性代数:张量、变换、分解与物理内存布局
- 2.1 标量、向量、矩阵与张量
- 2.2 Shape、索引和 Strides 步长寻址机制
- 2.3 零拷贝转置与 is_contiguous 避坑
- 2.4 逐元素运算与广播机制(Broadcast)
- 2.5 点积与余弦相似度(Attention 几何投影)
- 2.6 范数(Norm)与浮点容差(atol / rtol)
- 2.7 矩阵乘法是一组点积
- 2.8 Batched Matrix Multiplication(BMM 批矩阵乘)
- 2.9 线性变换与仿射变换
- 2.10 转置、单位矩阵与逆矩阵
- 2.11 线性相关、张成空间与矩阵秩(Rank)
- 2.12 特征值与特征向量
- 2.13 奇异值分解(SVD)
- 2.14 LoRA 的低秩参数更新原理
- 3. 分块矩阵与 GEMM 工程直觉
- 4. 概率论:从随机变量到大模型生成采样
- 5. Softmax、交叉熵与信息论
- 6. 微积分与反向传播(Backpropagation)深度解构
- 7. 优化算法、梯度稳定性与归一化
- 8. 数值计算与混合精度训练(Mixed Precision)
- 9. AI Infra 核心实战综合大算例(8 大全景案例)
- 10. 动手实战:PyTorch 最小可运行验证代码包
- 11. Ringi 避坑指南(❌ 错误理解 vs ✅ 正确理解)
- 12. 大厂 AI Infra 经典面试题与白板推导题
- 13. Ringi 5 点核心速记口诀、自我检验清单与 12 道课后思考题
0. Ringi 开场:AI Infra 工程师怎么看数学?
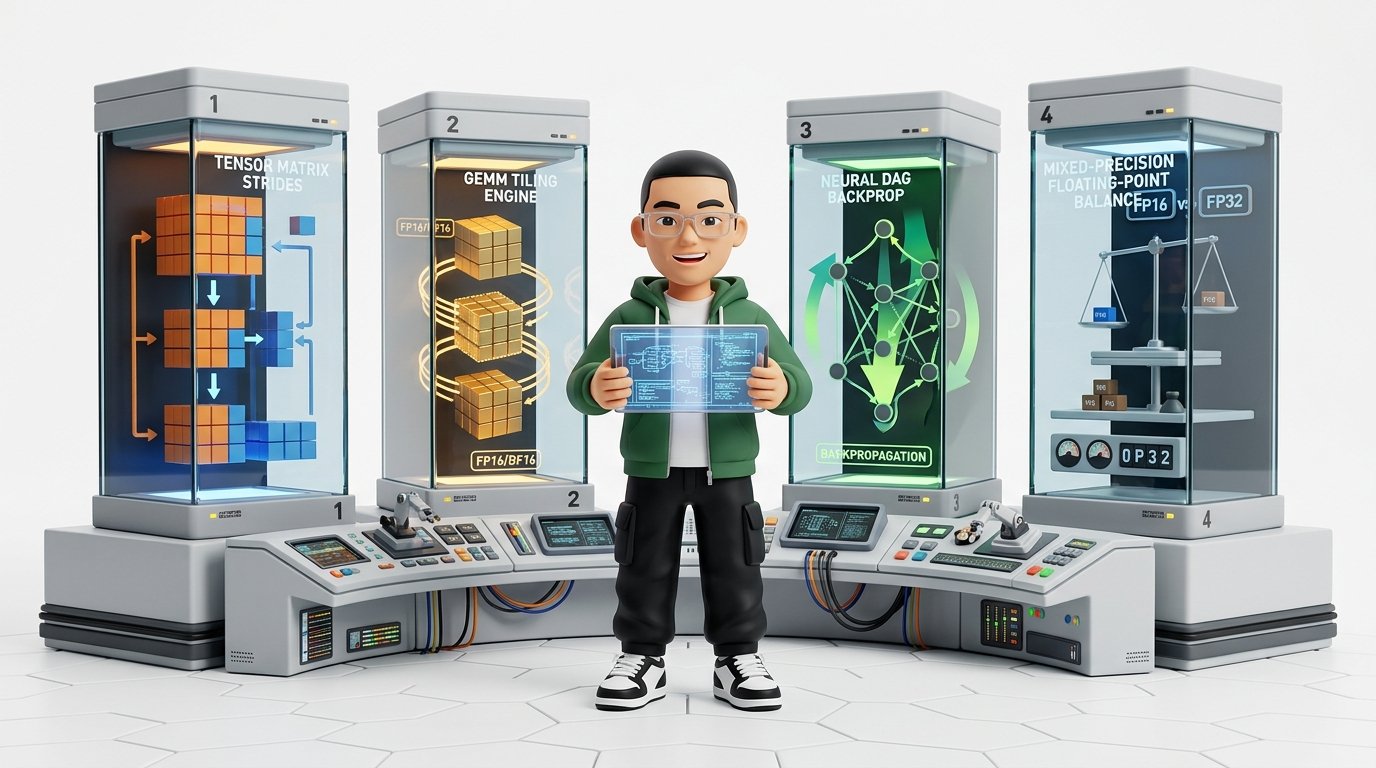
“Ringi,做 AI 基础设施到底需要多深的数学底子?需要像算法研究员那样天天推导泛函分析和复杂的收敛性定理吗?”我的回答永远是:不需要死记硬背枯燥的形式化定理,但必须对公式背后的“硬件账本”具备极强的物理直觉! 在算法研究员眼里,一个公式代表的是模型的语义表达能力;而在大厂 AI Infra 工程师眼里,每看到一个数学公式,脑海中必须立刻闪现出 Ringi 三问:
1. 学习目标、符号与三类核心工程问题
1.1 学习目标
完成本章后,你将建立起顶级 AI Infra 工程师的直觉反应能力:- 区分标量、向量、矩阵和高阶张量,熟练推导任何算子运算前后的 Shape 与物理 Strides;
- 解释点积、范数、矩阵乘法、秩、特征分解与 SVD 的物理直觉与工程映射;
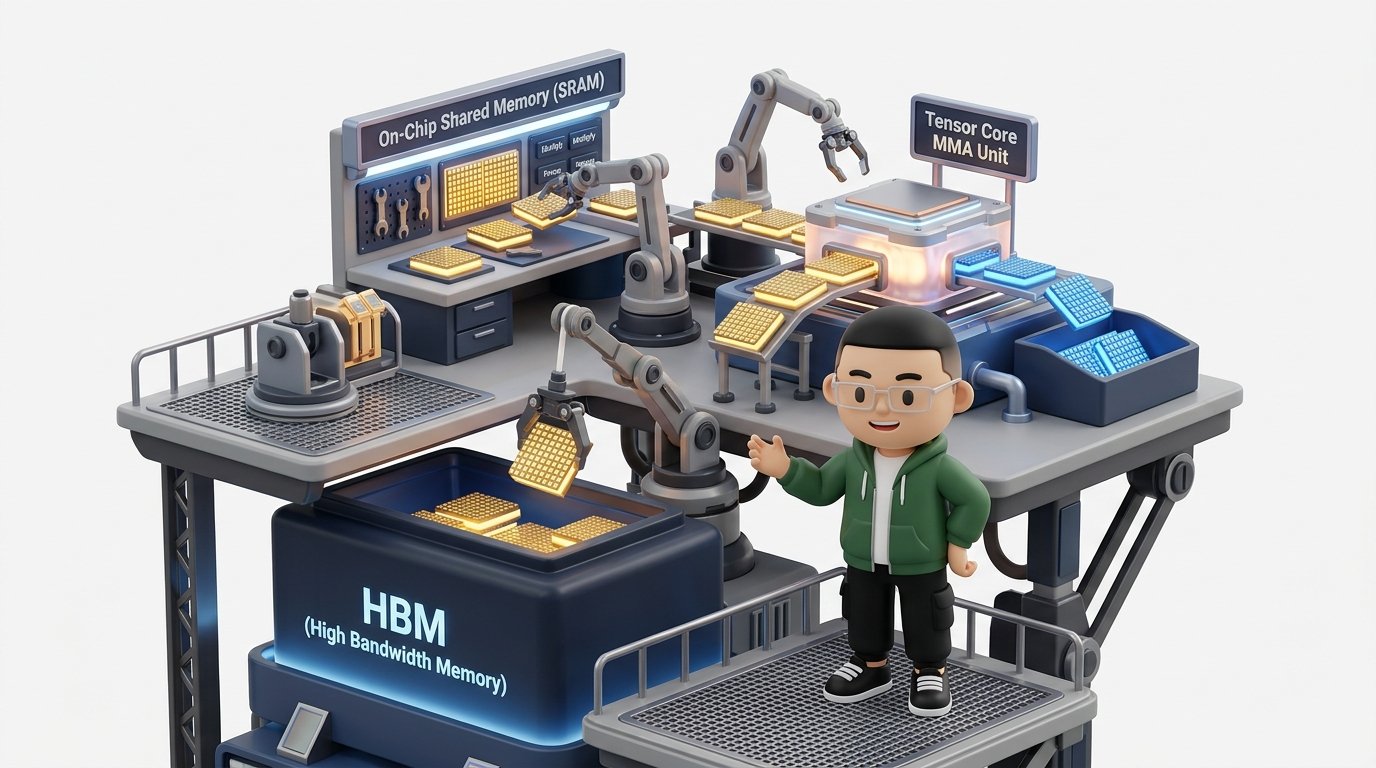
- 把矩阵乘法拆成 Block,从数学等价性理解 GEMM Tiling 与片上 SRAM 数据复用;
- 熟练推导自回归生成序列的概率链式分解,编写温度采样、Top-k 与 Top-p 算法;
- 掌握 Stable Softmax、LogSumExp 的数值防爆机制与算子融合;
- 用链式法则读懂计算图,手推线性层反向传播,证明为什么反向计算量恰好是前向的 2 倍;
- 洞悉 IEEE 754 浮点编码结构,掌握混合精度训练、动态 Loss Scaling 与 NaN 排查 Runbook;
- 准确估算任何 Transformer 算子的参数量、激活量、FLOPs、访存量与算术强度(Arithmetic Intensity)。
1.2 本章符号对照表
在分布式与大模型代码中,统一采用 Batch-First 记法:
- :Batch Size(批大小);
- :Sequence Length(序列长度);
- :Hidden Size(隐藏层维度);
- :Vocabulary Size(词表大小);
- :Attention Head 数量;
- :每个 Attention Head 的特征维度。
1.3 读公式时的 Ringi 三问
以语言模型输出投影层为例:- 第一问:Shape 是否匹配? 内维 相同,输出 Shape 是 。
- 第二问:代价是多少? 每个输出元素做 次乘加,计算量为 。
- 第三问:底层实现风险是什么? 权重和输出 Logits 极大;必须考虑数据类型(FP16/BF16)、内存布局、SRAM 分块、张量并行切分与 Softmax 数值稳定性。
2. 线性代数:张量、变换、分解与物理内存布局
2.1 标量、向量、矩阵与张量
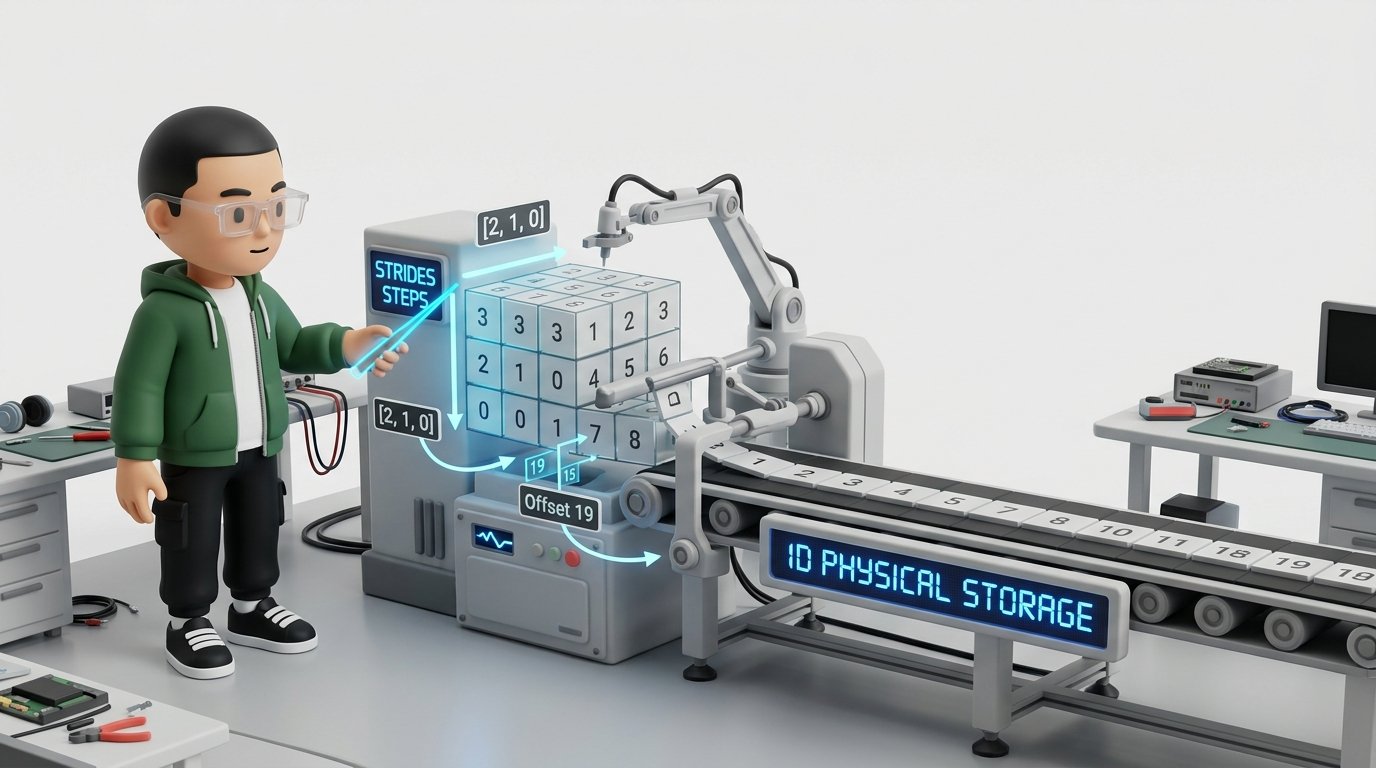
在 Python 层面我们操作的是torch.Tensor 对象,但在物理底层硬件中,张量是携带元数据的一维连续字节数组指针:
2.2 Shape、索引和 Strides 步长寻址机制
以一个 Shape 为(2, 3) 的行主序(Row-Major)矩阵为例:
底层物理存储是一个一维连续数组:[1, 2, 3, 4, 5, 6]。
- Strides 步长数组 为
(3, 1)(第 0 维换行需跨越 3 个元素,第 1 维换列跨越 1 个元素); - 物理寻址映射公式:
2.3 零拷贝转置与 is_contiguous 避坑
执行转置 时:
- Shape 变为:
(3, 2); - Strides 变为:
(1, 3); - 物理数据完全没有搬运!
💥 避坑实战:为什么转置后调用 .view() 会报错?
当张量被转置后,内存中相邻逻辑元素的物理间距不再是 1(stride[-1] != 1),破坏了紧凑行优先顺序(is_contiguous() == False)。
.view():强制要求连续,返回共享同一 Storage 的新视图;.contiguous():开辟新显存,做一次真实的全局数据深拷贝重排;.reshape():若连续则调用 view,若非连续则隐式调用 contiguous。
2.4 逐元素运算与广播机制(Broadcast)
逐元素加法 要求两矩阵 Shape 相同。而广播机制允许张量在特定维度虚拟扩展: 从尾部维度向前对齐时,每对维度必须满足:- 两者大小相等;或
- 至少一个大小为 1;或
- 某一方不存在该维度。
- 物理实现: 在底层并未复制 份,而是被赋予了
stride[0]=0, stride[1]=0, stride[2]=1的逻辑视图; - 语义陷阱:若将本应为 的张量误写为 且某维恰好为 1,广播机制会静默运行出错误结果,不报任何异常!
2.5 点积与余弦相似度(Attention 几何投影)
两个 维向量的点积: 两种经典工程直觉:- 加权求和: 是加权系数, 是特征数值;
- 方向相似性:余弦相似度 。
2.6 范数(Norm)与浮点容差(atol / rtol)
常见向量范数与矩阵 Frobenius 范数:- 范数:
- 范数:
- 范数:
- Frobenius 范数:
- FP32 对齐:
atol = 1e-5, rtol = 1e-4 - FP16 / BF16 对齐:
atol = 1e-2, rtol = 1e-2
2.7 矩阵乘法是一组点积
若 ,输出 的每个元素 都是 的第 行与 的第 列的向量内积。 标准 GEMM 形式: 。矩阵乘法满足结合律 ,但不满足交换律。选择不同的乘法结合顺序,中间张量显存与 FLOPs 会有天壤之别!
2.8 Batched Matrix Multiplication(BMM 批矩阵乘)
在多头注意力(Multi-Head Attention)中: 前两维 是 Batch 维,每个(batch, head) 独立并发执行一个标准的 GEMM 矩阵乘。
2.9 线性变换与仿射变换
- 严格线性变换: ,对应无偏置矩阵乘 ;
- 仿射变换(Affine):包含偏置项 。
由于连续多个线性层可以无损合并为一个大矩阵,因此非线性激活函数(ReLU, GELU, SwiGLU)是深层网络拥有非线性拟合能力的唯一源泉。
2.10 转置、单位矩阵与逆矩阵
- ;
- ;
- 。在工程求解线性方程组 时,绝不显式求逆矩阵 (计算慢且误差大),而是采用 LU / Cholesky / QR 分解直接回代求解。
2.11 线性相关、张成空间与矩阵秩(Rank)
矩阵的秩(Rank) 代表矩阵中线性无关的特征方向数量。若矩阵低秩( ),则矩阵存在极大的信息冗余,可以分解为 ( ),将参数量从 骤降至 。
2.12 特征值与特征向量
对方阵 ,若存在非零向量 与标量 使得: 则 为特征向量, 为特征值。矩阵变换在该方向上只做缩放、不改变方向。特征值的大小决定了系统经过多层变换后信号是放大( )还是衰减( \lambda < 1 ),直接关联到梯度爆炸与消失。2.13 奇异值分解(SVD)
任意实矩阵 都可以进行奇异值分解: 其中 对角线上是降序排列的奇异值 。截断前 个最大奇异值得到的矩阵 是该矩阵在 Frobenius 范数下的理论最优秩- 近似。2.14 LoRA 的低秩参数更新原理
对预训练大模型权重 ,LoRA 冻结 ,仅训练低秩增量矩阵: 以 为例:- 原全量参数: (约 16.7M 参数);
- LoRA 参数量: (约 0.13M 参数);
- 参数量缩减了 99.22%!极大地节省了微调时的可训练参数与 AdamW 显存开销。
3. 分块矩阵与 GEMM 工程直觉
3.1 为什么必须分块计算(Tiling)?
3.2 朴素 GEMM 计算量(2MKN)与访存灾难
对于 :- 输出元素数: ;
- 每个元素执行 次乘法与 次加法;
- 总计算量:
- 若无 Tiling 分块,每个元素重复从 HBM 读取,访存字节数为 ,将直接导致 GPU 算力严重饥饿!
3.3 算术强度(Arithmetic Intensity)与 Roofline 瓶颈定位
对于理想分块优化的 FP16 GEMM:3.4 Tile 尺寸权衡:不是越大越好
更激进的 Tile 尺寸虽然提高了数据复用率,但会消耗巨量的片上 Shared Memory 和寄存器,导致每个 SM 能够同时驻留的 Active Block / Warp 数量暴跌(Occupancy 降低),丧失了隐藏指令延迟的能力。必须在数据复用、占用率与边界开销之间寻找最佳平衡点。3.5 尾块(Boundary Tile)、Padding 与 Tensor Core 对齐
当矩阵维度无法被 Tile 大小整除时,边界线程会越界。工业级实现通常:- 边界 Mask 保护:增加分支判断(略微增加控制开销);
- 硬件 Padding 对齐:NVIDIA Tensor Core MMA 指令要求 最好是 8、16 或 64 的整数倍。将 Vocab 从 32001 Padding 到 32256,端到端吞吐量反而提升 10% 以上!
3.6 浮点分块结果为什么可能不逐位一致?
实数加法满足结合律,但浮点加法不满足结合律( )。不同的 Tile 划分、Warp 规约树顺序与 Tensor Core 累加路径会微调浮点累加次序。因此:优化后的 CUDA Kernel 与参考实现之间存在微小数值差异是完全正常的,必须使用
atol + rtol 进行验证。
4. 概率论:从随机变量到大模型生成采样
4.1 随机变量与自回归序列链式分解
大语言模型在数学上是一个条件概率模型。由概率论乘法法则:- 训练阶段:并行输入全部历史 Token,一次性计算全序列交叉熵;
- 推理阶段:每一步自回归采样出下一个 Token 并追加到末尾。
4.2 联合概率、边缘概率与条件概率
- 联合概率: ;
- 边缘概率:
- 条件概率:
4.3 独立与条件独立性
若 ,则两变量独立。分布式数据并行(DDP)与随机采样均基于样本独立同分布(i.i.d.)假设。4.4 Bayes 公式
先验(Prior)、似然(Likelihood)与后验(Posterior)的概率转化枢纽。4.5 期望:概率加权平均及其线性性质
离散期望: 。线性性质: (不要求 独立!)。大模型训练的优化目标即为最小化真实数据分布上的期望损失。
4.6 方差、标准差与 LayerNorm 总体方差
方差公式: 。深度学习算子中统一采用除以 的总体方差:
4.7 协方差、相关系数与 PCA
协方差矩阵 对称半正定。主成分分析(PCA)通过对协方差矩阵做特征分解,提取方差最大的主成分方向。4.8 样本均值、方差与 Mini-batch 统计
用 Mini-batch 样本均值 近似全量分布。分布式训练时,不同 Rank 必须通过全局规约才能得到准确统计量。4.9 最大似然估计(MLE)与负对数似然(NLL)
\mathcal{L}_{NLL} = - \sum_{t=1}^T \log P_\theta(x_t \mid x_{<t}) 对数将连乘转化为求和,从根本上防止了浮点下溢。5. Softmax、交叉熵与信息论
5.1 Logits 的本质与 Softmax 平移不变性
Logits 经过 Softmax 转换为概率: 平移不变性: 。5.2 为什么计算 会崩?——Stable Softmax(Max-Trick)
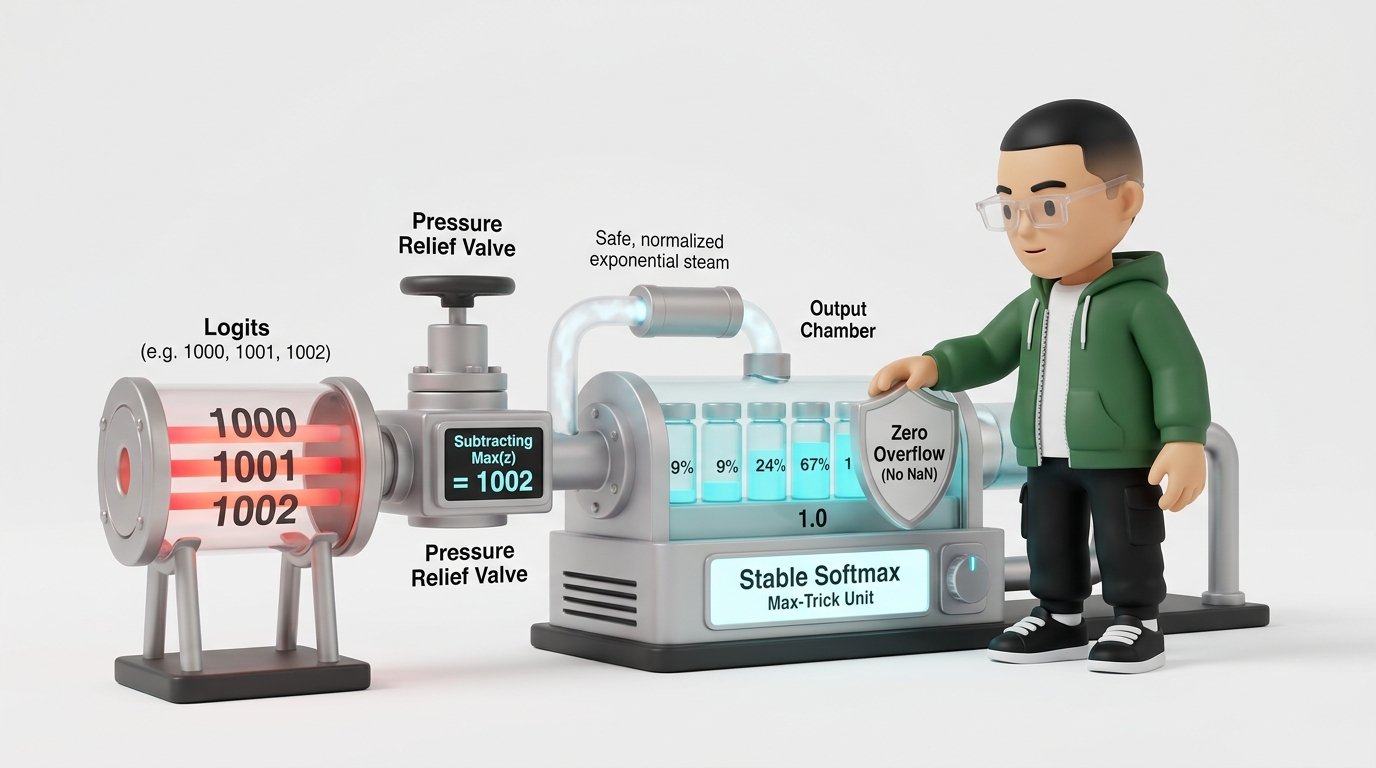
inf。
Max-Trick 稳定化:令 ,计算:
最大输入变为 , ,彻底杜绝溢出!
5.3 LogSumExp(LSE)与交叉熵算子融合
融合算子直接计算 ,避免生成巨大的中间概率张量。5.4 温度参数 Temperature 物理机制
- :退化为 Greedy Search(贪心);
- :原生概率分布;
- :分布平坦,富有创造力。
5.5 交叉熵 Loss 计算
真实分布 与模型分布 的交叉熵: 。对于 One-hot 标签 ,简化为 。5.6 信息熵(Entropy)
衡量系统的不确定性。当均匀分布时熵最大( ),当完全确定时熵为 0。5.7 KL 散度(Kullback-Leibler Divergence)
交叉熵可分解为: 。在 RLHF / PPO 中用于约束新旧策略的偏移。5.8 大模型困惑度(Perplexity, PPL)
表示模型在预测下一个词时平均面临的“有效候选词数”。5.9 解码采样策略:Greedy、Top-k 与 Top-p (Nucleus)
- Greedy:选择最大 Logit 对应的词;
- Top-k:截取概率最大的前 个词;
- Top-p:按概率降序累加,截取累计概率达到 (如 0.9)的动态最小子集。
6. 微积分与反向传播(Backpropagation)深度解构
6.1 导数:局部变化率
6.2 偏导数与梯度下降
梯度 指示函数上升最快方向,更新公式: 。6.3 Jacobian 雅可比矩阵与 Hessian 曲率
- Jacobian: (一阶偏导矩阵);
- Hessian: (二阶曲率矩阵)。
6.4 链式法则与复合函数求导
6.5 计算图与反向模式自动微分(VJP)
PyTorch 采用反向模式自动微分(Vector-Jacobian Product),从标量 Loss 逆向遍历 DAG,仅需 1 次反向即可求出所有参数梯度。6.6 为什么反向传播需要保留中间 Activation?
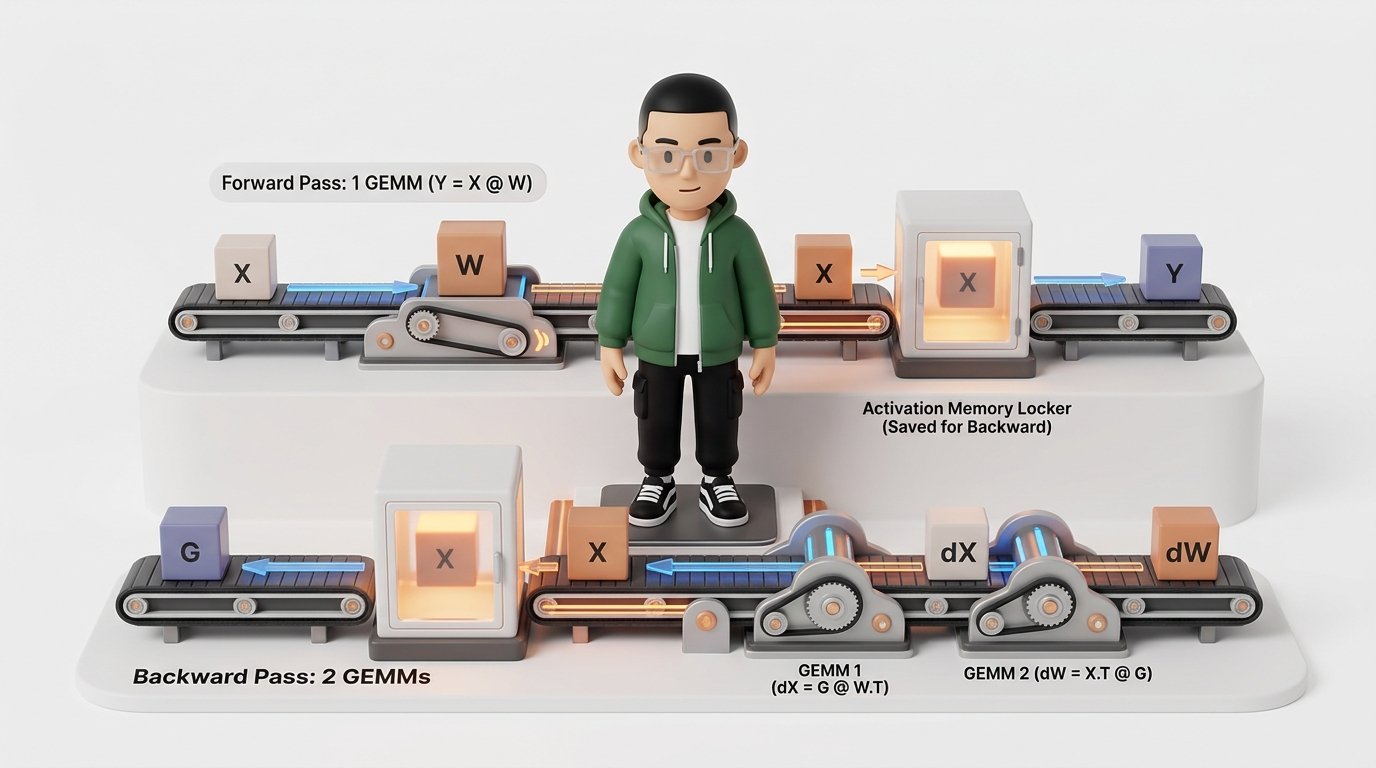
6.7 线性层反向传播手算:两次 GEMM 与一次归约
设前向: ,上游梯度为 :- 输入梯度(GEMM 1):
- 权重梯度(GEMM 2):
- 偏置梯度(Reduction):
💡 核心定理:前向 1 次 GEMM( FLOPs),反向 2 次 GEMM( FLOPs),反向计算量恰好是前向的 2 倍!
6.8 Softmax 的 Jacobian 矩阵
6.9 Softmax + 交叉熵联合求导的神奇简化
若真实标签为 ,梯度即为预测概率减真实标签,误差越大修正力度越大!6.10 梯度检查(Gradient Checking)有限差分法
用于检验手写 CUDA/C++ 反向算子的数学正确性。7. 优化算法、梯度稳定性与归一化
7.1 全量梯度、SGD 与 Mini-batch
经验风险最小化使用 Mini-batch 梯度 进行随机估计更新。7.2 动量 Momentum 机制
平滑短期噪声,在持续一致的梯度方向上加速。7.3 Adam 与 AdamW 状态自适应与 16 字节显存账本
AdamW 维护一阶矩 与二阶矩 。对于每个模型参数:- 模型权重(FP16):
- 梯度(FP16):
- FP32 Master Weights:
- FP32 Momentum :
- FP32 Variance :
- 总显存消耗: !
7.4 梯度消失与梯度爆炸物理根源
深层网络反向传播是多个 Jacobian 矩阵的连乘: 。矩阵谱半径持续偏离 1 将引发指数级衰减或爆炸。7.5 残差连接(Residual Connection)Jacobian 恒等通路
残差块 的 Jacobian 矩阵为 。单位阵 提供了无阻碍的梯度高速通道,使得千层深度的网络依然能够稳定训练。7.6 初始化尺度与方差传播控制
Xavier / Kaiming 初始化根据 控制方差传递,防止深层前向信号饱和或归零。7.7 LayerNorm 算子实现
减均值并除以标准差,需要 2 次跨维度规约(均值与方差)。7.8 RMSNorm 物理算子精简
不减均值,仅需 1 次规约,Kernel 访存显著精简。7.9 全局梯度裁剪(Gradient Clipping)与跨卡 AllReduce
在分布式训练中,汇总所有显卡上的全局梯度范数必须触发一次跨节点的AllReduce 通信。
8. 数值计算与混合精度训练(Mixed Precision)
8.1 IEEE 754 浮点编码结构表
8.2 精度(Precision)vs 动态范围(Dynamic Range)
- 指数位决定动态范围:防止数值溢出(
inf)或下溢(0); - 尾数位决定精度:减少微小数值相加时的舍入截断误差。
8.3 舍入误差与机器精度
二进制无法精确表示很多十进制小数(如0.1 + 0.2 != 0.3)。当更新量 远小于主权重 的最小可表示步进时, ,更新会被直接抹杀!
8.4 浮点加法非结合性与并行归约误差
。多 GPU 并行规约次序轻微变动会导致分布式训练的 Loss 在末尾几位小数无法逐位一致。8.5 溢出、下溢与非有限值(NaN / inf)
排查 Loss 变成NaN 时,必须定位第一个非有限张量,常见根源包括除零、开负数方根、未缩放的 Attention 打分与 FP16 动态 Loss Scale 超调。
8.6 灾难性消减与 Welford 在线方差算法
避免使用 (两接近大数相减丢失有效位)。采用 Welford 增量算法保持数值单遍稳定:8.7 条件数(Condition Number)与病态问题
矩阵条件数 描述输入扰动对输出的放大倍数。区分“问题本身的病态性”与“算法实现的数值稳定性”。8.8 混合精度训练的基本模式
- 大型 GEMM 输入采用 FP16/BF16,走 Tensor Core;
- 乘加累加器在内部采用 FP32 累加;
- Softmax、LayerNorm 与优化器状态保持 FP32。
8.9 Loss Scaling 动态缩放原理
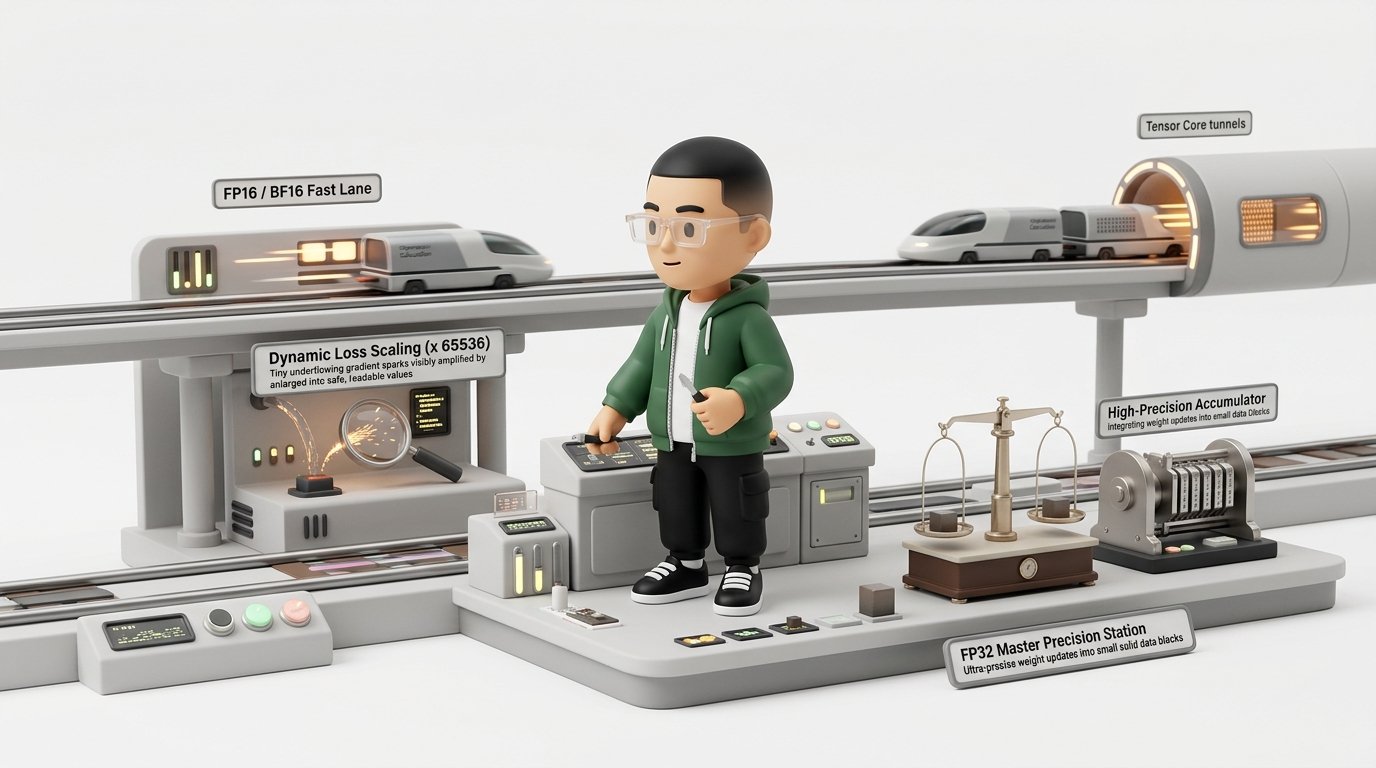
8.10 稳定算法与算子融合的天然契合
Stable Softmax、Welford 方差与 Fused CrossEntropy 不仅解决了数值稳定性,更通过减少 HBM 读写搬运极大提升了端到端性能。9. AI Infra 核心实战综合大算例(8 大全景案例)
9.1 算例一:Transformer 线性层的 Shape、FLOPs 与显存代价
设 ,线性层权重 ( ):- 输入张量展平:
- 前向计算量:
- 反向计算量:
9.2 算例二:多头 Attention 完整维度与 显存爆炸推导
从输入 生成 :- 分数矩阵:
- 显存占用(FP16): ;
- 当 时:
- 结论:这就是为什么长上下文必须用 FlashAttention(不显式物化 矩阵)!
9.3 算例三:为什么 Attention 点积必须除以 ?
假设 独立同分布:- 点积 的方差为 ;
- 标准差为 。除以 使方差恢复为 1,避免 Softmax 进入极端饱和区导致梯度消失。
9.4 算例四:Online Softmax 分块状态合并推导(FlashAttention 数学核心)
将 Logits 拆成多个 Tile 块。已处理部分的状态为 (最大值与指数和),新 Tile 块状态为 :- 全局最大值更新: ;
- 指数和重标定合并:
9.5 算例五:LoRA 微调的参数比例与额外前向 GEMM 开销
在 的线性层上加 rank=16 LoRA:- 参数量占比仅为 ;
- 在线推理需多执行 2 次小矩阵乘: 与 ;
- 部署时可将 离线合并回主权重消除额外延迟。
9.6 算例六:分布式训练中为什么全局均值必须加权?
Rank 0 处理 7 个有效 Token(Loss 均值 2.0),Rank 1 处理 5 个有效 Token(Loss 均值 3.0):- 错误算法:简单平均 ;
- 正确算法:加权平均 。各 Rank 必须分别规约
loss_sum与token_count后相除。
9.7 算例七:大模型训练与推理单张量显存估算公式
对于 Shape 为 、类型为 字节的张量: 例如 BF16 的 : 。9.8 算例八:从数学公式到 CUDA Kernel 的 10 步工程检查表
- 📐 输入、输出与中间张量的 Shape 分别是什么?
- 🔄 哪些维度保留,哪些维度被归约(Reduce)?
- 📦 算子能否分块(Tiling)?分块状态如何递推合并?
- 💰 FLOPs 计算量与理论最小 HBM 访存量是多少?算术强度处于哪个区间?
- ⚠️ 是否存在非连续 Strides、转置或隐式广播?
- 🎯 哪些累加操作必须提升到 FP32 高精度?
- 🛡️ 是否存在指数溢出、除零或灾难性消减?
- ⚡ 中间临时张量能否通过算子融合在片上消除?
- 📏 边界条件与非 8/16 倍数尾块如何 Padding?
- 🧪 使用什么参考实现与复合容差(atol/rtol)进行单元测试?
10. 动手实战:PyTorch 最小可运行验证代码包
11. Ringi 避坑指南(❌ 错误理解 vs ✅ 正确理解)
12. 大厂 AI Infra 经典面试题与白板推导题
题 1【概念题】:为什么 PyTorch 自定义 CUDA 算子通常要求输入张量必须是 contiguous 的?
- 思考路径:
- CUDA 线程通常用一维全局索引
idx = blockIdx.x * blockDim.x + threadIdx.x; - 如果张量非连续(如转置过),物理地址与一维线性索引脱节,直接按指针偏移读取会读到错误数据;
- 连续张量才能实现相邻线程访问相邻显存地址,触发 GPU 关键的 Memory Coalescing(全局内存合并访问)。
- CUDA 线程通常用一维全局索引
题 2【白板推导题】:请现场手推一个线性层 的反向传播公式并给出 FLOPs。
- 思考路径:
- 写出 ;
- 前向计算量: FLOPs;
- 上游梯度 ;
- 推导 (计算量 );
- 推导 (计算量 );
- 结论:反向总计算量为 FLOPs,是前向的 2 倍。
题 3【性能工程题】:大模型 Decode 阶段为什么不能充分利用 GPU 算力?从数学角度如何解释?
- 思考路径:
- 列出算术强度公式 ;
- 指出 Decode 阶段每次只输入 1 个 Token,此时 ;
- 将 带入公式,化简得到 ;
- 结合 H100 硬件 Roofline 拐点( ),得出 Decode 是极度严重的 Memory-bound,算子大部分时间在等权重和 KV Cache 从 HBM 搬运。
题 4【系统设计题】:在千卡混合精度训练中,为什么 AdamW 优化器需要为每个参数消耗 16 字节显存?
- 思考路径:
- 模型前向/反向权重与梯度使用 FP16/BF16(各 2 字节);
- AdamW 优化器为了数值稳定,维护 FP32 Master Weights(4 字节);
- 维护 FP32 一阶动量 Momentum (4 字节);
- 维护 FP32 二阶方差 Variance (4 字节);
- 加上 FP16 梯度本身的 2 字节与 FP16 权重的 2 字节,参数相关总显存为 !
13. Ringi 5 点核心速记口诀、自我检验清单与 12 道课后思考题
✅ 自我检验清单
- 看到
(B, S, H) @ (H, V)能立即写出输出 Shape 与 FLOPs - 能区分逐元素乘、点积、矩阵乘与 Batched Matmul
- 能根据 Shape 和 Strides 准确计算任意位置的物理内存线性偏移
- 能解释范数、秩、特征值与奇异值分解 SVD 的物理直觉
- 能推导低秩分解与 LoRA 的参数量缩减比例
- 能从 Block 矩阵乘法解释 GEMM Tiling 的数学等价性
- 能估算 GEMM 的 FLOPs、理论最小 HBM 访存量与算术强度
- 能推导自回归语言模型的概率乘法链式分解
- 能手写数值稳定的 Stable Softmax 与 LogSumExp
- 能说明交叉熵、信息熵与 KL 散度的数学联系
- 能用链式法则手推线性层对输入 、权重 和偏置 的梯度公式
- 知道 Softmax + 交叉熵对 Logits 的梯度是优雅的
- 能解释残差连接 Jacobian 恒等通路为何能解决深层梯度消失
- 能区分 IEEE 754 中精度与动态范围的物理权衡
- 能说明 FP16 为什么必须搭配 Loss Scaling,而 BF16 通常不需要
- 能解释为什么浮点非结合性导致分布式训练 Loss 无法逐位一致
- 能从 Attention Shape 推导 显存爆炸( 需 64GB)
- 能根据 10 步工程检查表完成一个新算子的系统性能剖析
📝 12 道课后深度思考题
- 推导
(B, Nh, Sq, Dh) @ (B, Nh, Dh, Sk)的输出 Shape,并指出 Batch 维与归约维。 - 给定 的 FP16 GEMM,计算总 FLOPs 与理想最小 HBM 输入输出字节数。
- 编写程序验证 ,并比较 Naive 实现与 Stable 实现在超大 Logits 下的差异。
- 从 Softmax Jacobian 矩阵与交叉熵 Loss 开始,在白板上手推 。
- 推导 的反向 Shape 传播链路。
- 比较 FP16、BF16 和 FP32 对序列
[1.0, 1e-3, 1e-3, ...]求和时的舍入误差,并改变累加求和顺序观察结果。 - 实现 Welford 方差增量算法,与经典公式 在“大均值、极小方差”数据上进行数值精度对比。
- 对一个 的全连接权重,计算 Rank 8、16、64 LoRA 的参数比例和额外前向 FLOPs。
- 计算 时显式物化 FP16 Attention Score 矩阵所需的显存大小。
- 两个 Rank 分别处理 7 个和 5 个有效 Token,局部 Loss 均值分别为 2.0 和 3.0;计算正确的全局均值,并说明为什么简单平均是错的。
- 使用有限差分中心差分法验证手写线性层反向算子,尝试不同扰动步长 并观察截断误差与舍入误差的权衡。
- 任意挑选一个 PyTorch 常用算子,按照本讲的“10 步工程检查表”撰写一份一页纸系统性能分析报告。
14. 参考资料与经典论文
- 📖 Deep Learning Book: Chapter 2 Linear Algebra, Chapter 3 Probability, Chapter 4 Numerical Computation
- 📄 Matrix Calculus: Matrix Calculus for Deep Learning (Parr & Howard, arXiv:1802.01528)
- 📄 Automatic Differentiation: Automatic Differentiation in Machine Learning: a Survey (Baydin et al., JMLR 2017)
- 📄 Mixed Precision Training: Mixed Precision Training (Micikevicius et al., ICLR 2018)
- 📄 LoRA 论文: LoRA: Low-Rank Adaptation of Large Language Models (Hu et al., ICLR 2022)
- 📄 FlashAttention 论文: FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness (Dao et al., NeurIPS 2022)
- 📚 PyTorch 源码:
torch/csrc/autograd/&aten/src/ATen/native/