🏛️ 第39讲:从“流式卡死”到毫秒级自愈——生产级 LLM Serving 高可用架构、DCGM 全维可观测与基于 KV Cache 水位的 KEDA 自动扩缩容全栈实战
主讲人:👓 Ringi(大厂 AI Infrastructure 工程师)
所属模块:Module 06: 云原生 AI 平台与生产工程
篇章范式:☁️ 云原生 AI 平台、生产运维与系统设计篇(Cloud-Native AI Platform & System Design Paradigm)
核心导读:传统微服务运维奉为圭臬的“CPU 利用率 > 70% 触发 HPA 扩容”,在大模型推理场景下完全是一场灾难:vLLM 容器刚启动,PagedAttention 就把整张显卡的 80GB 显存几乎全部划为 KV Cache 池,GPU 显存利用率恒定在 95%;只要有连续请求在跑,nvidia-smi就会显示 GPU-Util 恒定在 100%。但此时服务可能已经因为排队队列积压了 500 个请求,导致首字延迟(TTFT)从 100ms 暴击到 15 秒,流式打字彻底停摆,传统 HPA 却因指标失真毫无反应;更严重的是,当流量洪峰将 KV Cache 榨干到 100% 时,推理引擎会陷入频繁抢占重算(Recomputation)的恶性死循环,引发全链路 504 雪崩。本讲将带你并肩拆解生产级 LLM Serving,从 DCGM 硬件微架构监控、TTFT/TPOT 黄金指标体系、KEDA 复合弹性伸缩到自适应网关背压治理,彻底构筑大模型在线服务的高可用铁壁。

📑 目录导航
- 0. Ringi 开场:生产真实现场与痛点冲突
- 1. LLM Serving 黄金指标体系:从黑盒硬件到语义观测
- 2. Prometheus + DCGM 深度监控架构实战
- 3. 自动化扩缩容设计:传统 HPA vs 基于 KEDA 的智能弹性伸缩
- 4. 生产级高可用与背压(Backpressure)治理架构
- 5. 动手实战与代码实验室(Minimal Runnable Code)
- 6. Ringi 避坑指南与生产黄金准则
- 7. Ringi 5 点核心速记口诀、自我检验清单与课后深度思考题
- 8. 📚 参考资料与核心源码/经典论文指引
- 附录:Appendix A — 大厂硬核高频面试题与白板推导
- 🎨 【配图工坊生图 Prompt 暂存区 · 仅剩蓝图 1 待生成】
0. Ringi 开场:生产真实现场与痛点冲突
0.1 真实工程矛盾:为什么传统 HPA 在 LLM Serving 场景下彻底“失灵”?
在传统互联网微服务架构中,自动水平扩缩容(HPA, Horizontal Pod Autoscaler)通常是运维工程师最省心的“银弹”:配置一条targetCPUUtilizationPercentage: 70,当流量高峰来临、CPU 超过 70% 时自动加副本,流量退去后自动缩容,简单而优雅。
然而,当你把这一套原封不动搬到以 vLLM、TensorRT-LLM 为底座的大模型推理服务上时,等待你的将是一场彻头彻尾的灾难!
让我们来看看大模型容器拉起瞬间的底层物理真相:
- 显存静态吞噬(Static Pre-allocation):现代推理引擎几乎全员标配 PagedAttention 技术。为了消除显存碎片、实现极速的动态分页管理,引擎在初始化加载完模型权重后,会立刻将物理 GPU 剩余的全部显存一次性申请完毕,作为统一管理的 KV Cache 物理块池(Block Pool)!
- 结果:
nvidia-smi赫然显示显存占用 95%;Prometheus 采集到的显存指标是一条死死顶在上限的直线!
- 结果:
- 算力虚假饱和(Kernel Loop Illusion):在大模型的连续批处理(Continuous Batching)机制下,调度器会高频执行前向传播循环(Iteration Loop)。即便当前只有一个很小的请求在慢慢 Decode,GPU 的 CUDA 流上也持续有矩阵向量乘法(GEMV)算子在跑。
- 结果:
nvidia-smi的GPU-Util长期显示为 100%!
- 结果:
0.2 线上真实事故复盘:一次流式卡死引发的 504 网关雪崩风暴
大厂的核心大模型助手在一次上线营销活动中,曾遭遇过一次极其惨烈的“504 网关雪崩”。 当时后台 Serving 集群部署了 16 台 8 卡 A100(共 128 张卡),通过标准的 Kubernetes Ingress 暴露流式 Server-Sent Events(SSE)接口。活动开始后,高并发的长文本问答请求瞬间涌入:- KV Cache 显存告急:单个用户的平均输入 Prompt 达到 4,000 Tokens。在并发达到 200 时,单实例分配给请求的 KV Cache 物理块瞬间被占满(达到 水位);
- 连续批处理抢占(Preemption & Swapping)触发:
- 当没有空余显存给当前步生成的 Token 分配空间时,vLLM 引擎启动了自保机制:强制将正在解码的部分请求的 KV Cache 逐出到 Host CPU 内存(Swapping),甚至直接丢弃其已生成的上下文,退回到等待队列准备日后重计算(Recomputation)!
- 用户体验雪崩:正在看着流式打字的前端用户突然发现打字机停滞了——因为模型被挂起等待显存,客户端出现长达 20 秒的静默死寂;
- 重试放大风暴(Retry Storm):
- 前端 App 设定了客户端超时(例如 10 秒无数据自动重试);
- 用户因为卡顿频繁刷新页面,每个用户无意中放大了 3~5 倍的并发请求;
- 智能网关在没有任何背压(Backpressure)机制的情况下,老实地把这些垃圾重试流量全量压给底层已经濒死的 vLLM;
- 连锁崩盘:vLLM 进程因为极度频繁的 CPU-GPU 显存换页,陷入严重的操作系统不可中断睡眠态(D 状态),K8s 存活探针(Liveness Probe)超时判定容器失败,重启容器!正在生成中的所有请求彻底被切断,全网大面积爆发
504 Gateway Timeout!
缺乏毫秒级的显存水线监控、缺乏基于队列事件的 KEDA 极速弹性伸缩、网关缺乏自适应背压阻断。
0.3 AI Serving 可观测与治理分层全景速查表
在深入具体治理技术前,我们先建立一套大模型在线服务的全栈防线大图:1. LLM Serving 黄金指标体系:从黑盒硬件到语义观测
💡 架构全景速览:在深潜源码前,先在白板上建立坚不可摧的大模型在线服务全栈可观测、KEDA 弹性伸缩与优雅停机物理底账。
1.1 传统指标 vs 大模型语义指标的断层:为什么 nvidia-smi GPU-Util 是个谎言?
在计算机体系结构和 GPU 编程原理中,nvidia-smi 打印出来的 GPU-Util 其官方定义非常微妙:
这意味着什么?在一张拥有 132 个流式多处理器(SM)的 NVIDIA H100 显卡上,如果一个程序发射了一个极其微小的 Kernel,只使用了 1 个 SM 里的 1 个 Warp(32 个线程),其余 131 个 SM 都在睡觉,只要这个微小的 Kernel 连续跑满了 1 秒钟,
nvidia-smi 汇报的 GPU 利用率就是 !
在大模型 Decode(自回归解码)阶段,每个 Step 每次前向计算只生成一个 Token。由于 Batch Size 较小,很多时候 GPU 硬件的 Tensor Core 计算单元根本没喂饱,算力处于严重空转饥饿状态,但由于连续批处理不断在发 Kernel,导致 GPU-Util 虚高。
因此,在 AI Infra 领域,绝对不能把 nvidia-smi 的利用率作为衡量在线服务健康度的依据! 我们必须转向真正的 大模型语义黄金四指标。
1.2 四大核心延迟指标五步穿透(TTFT, TPOT, ITL, E2E Latency)
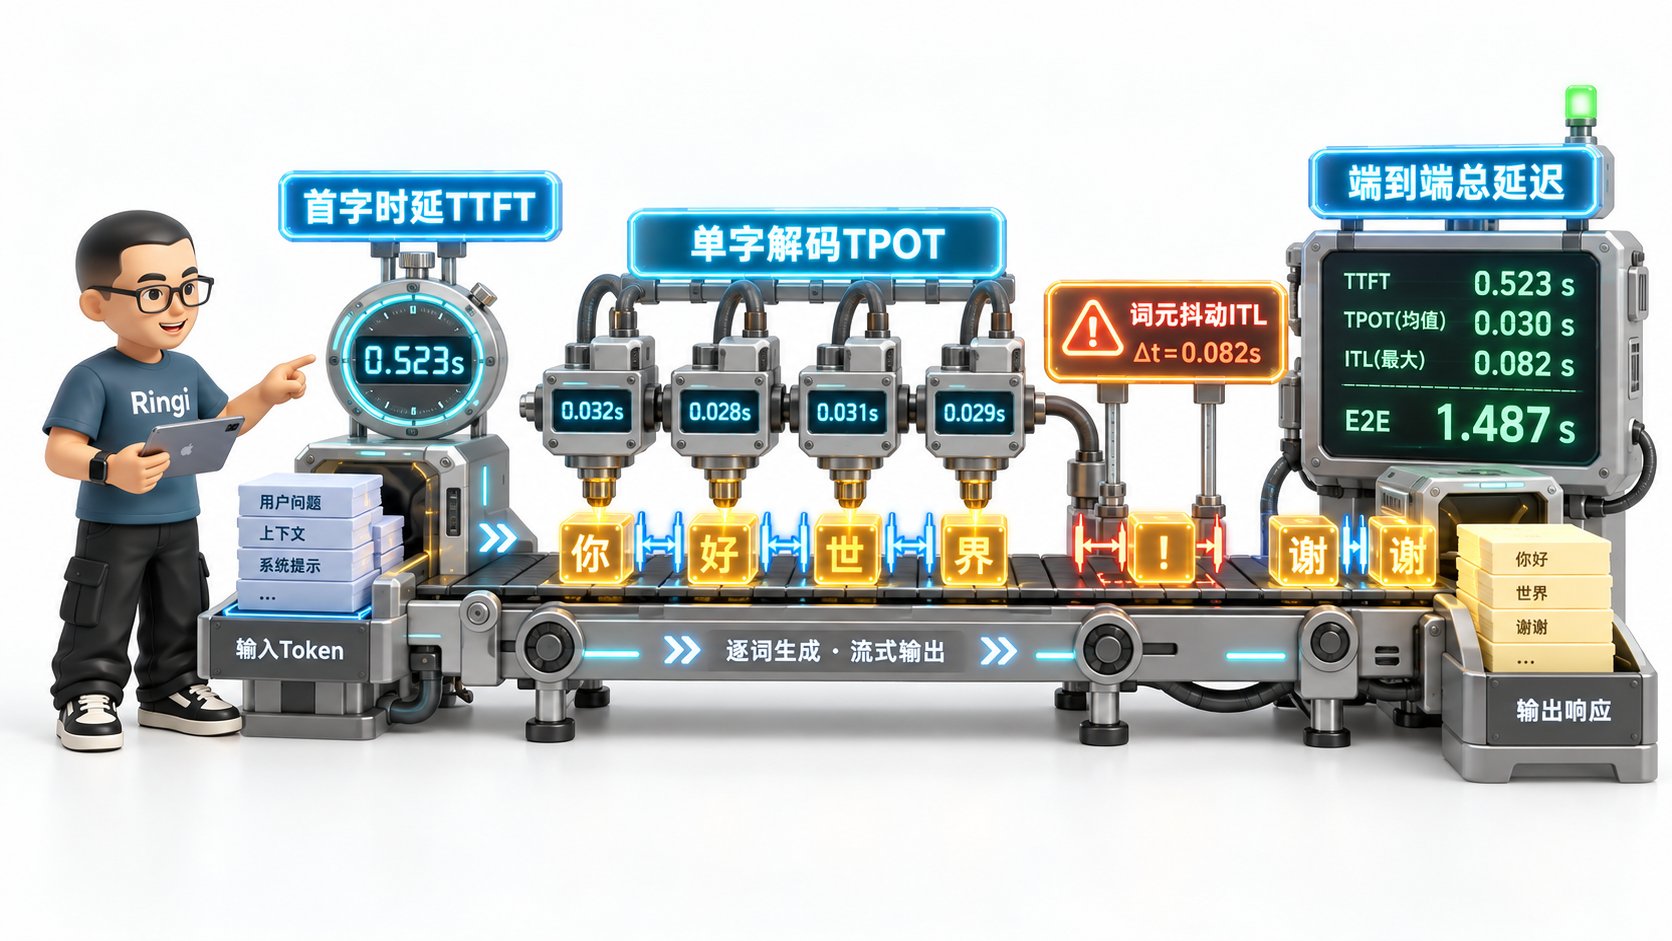
1. TTFT(Time To First Token,首字时延)
- ① 为什么算它:用户按下回车后,界面需要多长时间给出第一个字的反应。它直接决定了产品的“跟手感”和交互响应敏捷度。
- ② 物理直觉:就像去餐馆点菜,从服务员下单到第一道开胃菜上桌的时间。包括了排队等候时间和把整本菜单看一遍(Prefill)的时间。
- ③ 数字手算:假设排队耗时 ,输入 Prompt 长度为 Tokens,Prefill 吞吐为 。
。
。 - ④ 理论公式:
- ⑤ 数量级校验:大厂在线 Chat 业务的 TTFT P95 必须控制在 以内,超过 用户流失率将呈指数上升。
2. TPOT(Time Per Output Token,单字生成时延)
- ① 为什么算它:在流式打字输出时,模型每产生一个字需要多少毫秒。决定打字速度快慢。
- ② 物理直觉:厨师做完第一道菜后,后面炒每道热菜的节奏间隔。
- ③ 数字手算:如果模型以每秒输出 个 Token 的速度吐字,则单字耗时为:
。 - ④ 理论公式:
- ⑤ 数量级校验:人类正常阅读速度约为每秒 5
8 个汉字(约合 812 Tokens)。生产服务要求 TPOT 稳定在 (对应 25~50 tokens/s),低于 10 tokens/s 用户会明显感知到卡顿。
3. ITL(Inter-Token Latency,词元间抖动)
- 物理本质:在生成第 个 Token 与第 个 Token 之间的瞬时耗时。由于连续批处理中每个 Step 可能会有新的请求插入进来执行 Prefill(抢占了计算和带宽),导致某一步的 ITL 突然跳起到 200ms。ITL 的方差决定了打字机输出是否平滑,是否会出现“狂飙五个字,卡死半秒钟”的恶劣体验。
4. E2E Latency(端到端总时延)
- 综合公式:
1.3 核心吞吐与负载生命线:Tokens/s、队列深度与 KV Cache 水位
除了延迟,平台架构师必须死死盯住以下三大系统级负载指标:vllm:num_requests_waiting(等待队列请求数):- 处于就绪状态但由于显存不足无法进入当前批次的请求总数。只要此数值持续大于 0,说明当前算力池已处于饱和透支状态,必须立即触发扩容!
vllm:gpu_cache_usage_factor(KV Cache 显存水线占用比):- 当前已分配的物理显存块与总 KV Cache 池的比例(取值 );
- (健康安全区):服务运行平稳,支持突发流量;
- (扩容警戒区):触发自动扩缩容控制器(KEDA)拉起新副本;
- (极度危险熔断区):随时可能发生换页抢占(Swapping),网关必须立即启动自适应背压拒绝新请求!
Generation Throughput(输出生成吞吐量):- 集群每秒总共吐出的 Token 数量( )。这是向公司财务证明 GPU 资源投资回报率(ROI)的最硬核依据。
2. Prometheus + DCGM 深度监控架构实战
2.1 NVIDIA DCGM 架构剖析:从 NVML 到硬件级性能计数器
在节点物理硬件层面,传统的nvidia-smi 走的是 NVML(NVIDIA Management Library)的低速用户态查询接口。每秒查询多次会导致 CPU 开销暴增甚至锁死驱动。
NVIDIA 为超大规模数据中心推出了 DCGM(Data Center GPU Manager)。
它直接嵌入在 GPU 的微架构控制器中,可以采集到纳秒级的硬件级 PMU(Performance Monitoring Unit)计数器,并通过独立的守护进程
nv-hostengine 提供高效缓存。第三方工具(如 dcgm-exporter)读取指标时,只是在读共享内存,对正在执行的大模型推理零性能损耗!
2.2 DCGM 关键指标白皮书与 Field ID 映射(SM Active vs DRAM Active)
在配置 Prometheus 监控大盘时,AI Infra 工程师必须准确掌握以下 DCGM 核心字段与生产阈值:2.3 生产级 dcgm-exporter 部署与 ServiceMonitor 采集规则
在大厂 Kubernetes 集群中,通常以 DaemonSet 方式部署dcgm-exporter。为了采集大模型推理所必需的指标,必须通过 ConfigMap 自定义指标采集清单:
ServiceMonitor,以 5 秒一次的高精度频率 抓取,杜绝指标滞后:
2.4 vLLM 原生 Prometheus 端点深度解密与关键指标对齐
不仅要有硬件指标,大模型服务自身必须吐出语义指标。以生产环境最广泛使用的 vLLM 为例,启动时加入--enable-metrics,它会在 :8000/metrics 暴露出以下黄金指标:
3. 自动化扩缩容设计:传统 HPA vs 基于 KEDA 的智能弹性伸缩
3.1 传统 HPA 面对 GPU 静态显存与长连接的三大致命硬伤
为什么我们断言传统 Kubernetes 原生 HPA 搞不好大模型在线推理?它有三个与生俱来的硬伤:- 指标单一且失真:原生 HPA 依赖
metrics-server,主要监听 CPU 和内存使用率。大模型服务由于前述的 PagedAttention 静态预占与常驻 Kernel 循环,CPU/内存利用率与真实服务压力完全解耦; - 采集轮询周期过长(Laggy Feedback Loop):原生 HPA 默认每 15 秒或 30 秒评估一次,等指标采集上来、计算出期望副本数、再经过冷却时间,往往 2 分钟已经过去了!对于在线突发流量,2 分钟的等待足够产生数千个超时的坏请求;
- 缩容缺乏语义感知(Blind Scale-in):传统 HPA 在决定把副本从 5 缩到 3 时,Kubelet 会随机挑 2 个 Pod 发送终止信号。被挑中的 Pod 可能正好在给一位 VIP 用户生成一篇长达 3000 字的研报,输出到第 2800 字时被宿主机强行一刀切断,导致极差的用户投诉。
3.2 KEDA 架构第一性原理:从外部事件到 Pod 副本伸缩引擎
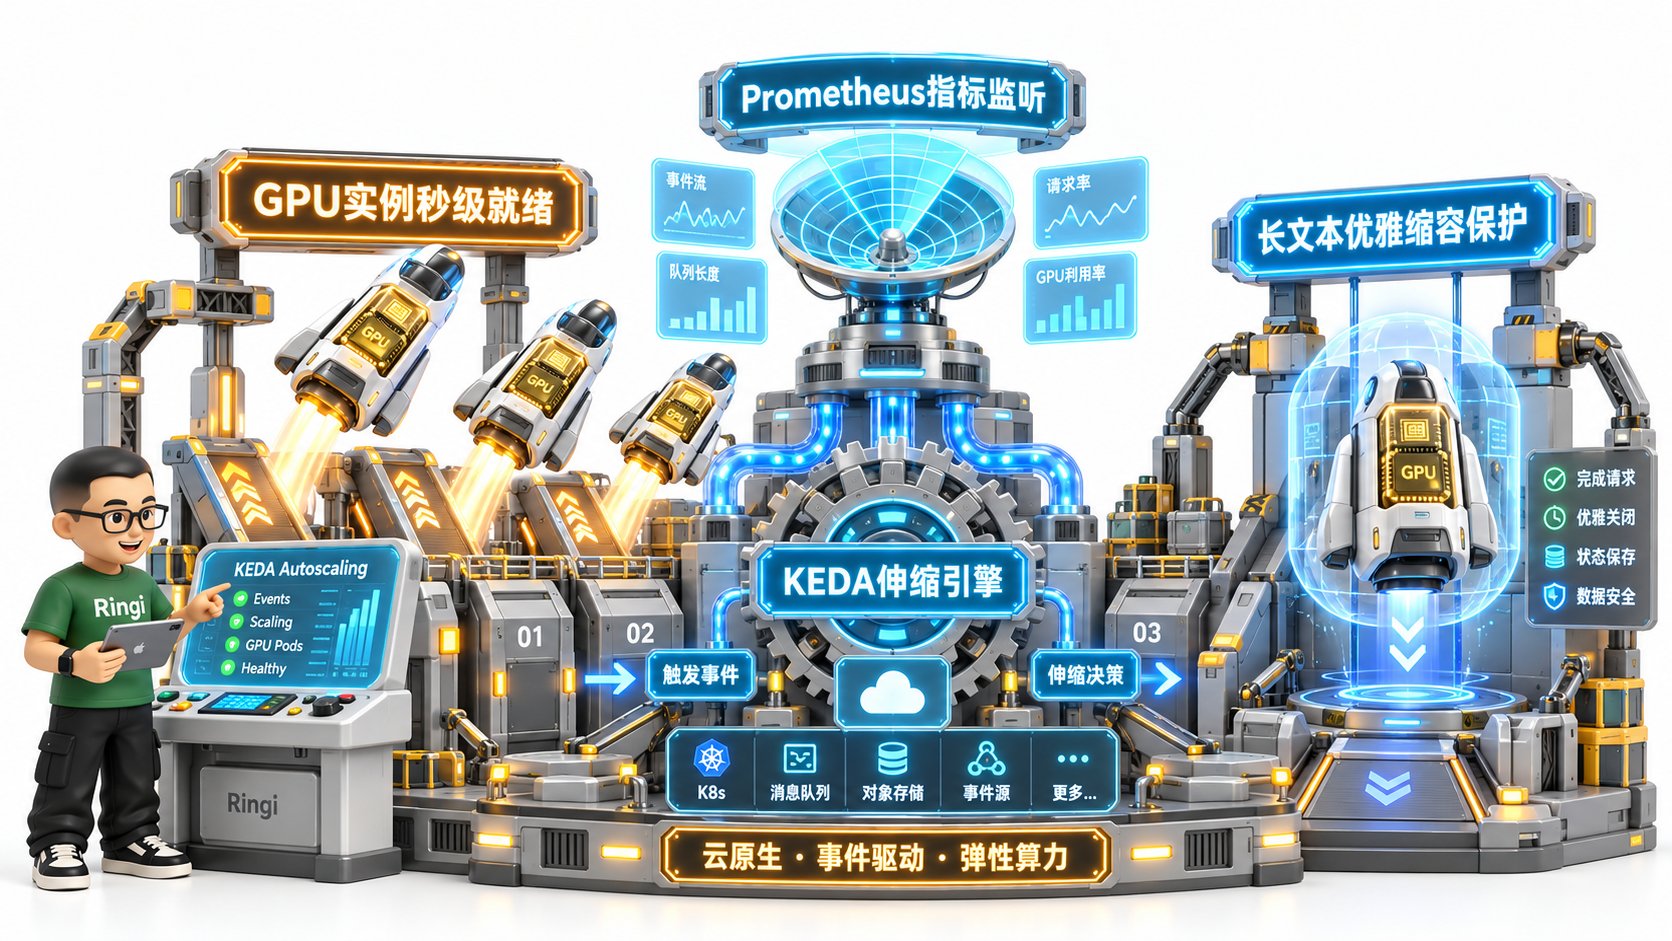
- 直连 Prometheus:通过
prometheusScaler,直接执行任意复杂的 PromQL 表达式; - 支持缩容到零(Scale-to-Zero):在开发测试环境无流量时自动释放昂贵的 GPU;
- 毫秒级灵敏度:轮询间隔(
pollingInterval)可精细控制在 5 秒以内,实现真正敏捷的事件驱动弹性。
3.3 生产级复合自动扩缩容数学模型与算法公式
在大厂生产中,我们绝对不能只依据单一指标扩容,而必须采用 复合多维决策模型(Multi-dimensional Metric Model)。 扩容必须同时满足 算力充裕度 与 队列健康度 的约束: 其中:- 基于排队深度的伸缩分量( ):
3.4 优雅缩容保护机制:防止长文本流式输出被 K8s 暴力截断
自动缩容时的“平滑退出”是考验 AI Infra 团队功力的试金石。 当流量消退、KEDA 决定减少 Pod 副本时,必须走完以下闭环流程:4. 生产级高可用与背压(Backpressure)治理架构
4.1 当 KV Cache 突破 95% 警戒线:抢占换入换出与重计算雪崩机理
如果遭遇极端流量洪峰,扩容出来的物理 GPU 启动需要时间(冷启动拉镜像、加载 70GB 权重通常需要 1~2 分钟)。在这 2 分钟的真空期内,存量 Pod 的 KV Cache 一旦被完全挤爆(达到 ),底层到底会发生什么?- 显存物理耗尽:连续批处理调度器在下一个 Step 尝试为请求申请物理 Block 时,发现空闲块链表为空;
- 被迫发起 Swapping(内存换出):
- 调度器不得不挑选一个优先级最低的请求,将其部分 KV Cache 通过 PCIe 链路从 GPU HBM 拷到 Host 内存;
- 此时 PCIe 吞吐瞬间打满,引起通信拥塞;
- 被迫发起 Recomputation(重计算):
- 如果 CPU 内存也满了,调度器只能采取终极残酷手段:杀死该请求当前的上下文状态,释放其占用的全部显存块!
- 当未来显存腾出空间后,该请求必须从第 1 个 Token 重新开始做 Prefill 计算!
- 性能雪崩(Thrashing):
- 原本一次前向计算就能解决的事,变成了“算了一半被杀 -> 重新排队 -> 重新算 -> 显存又爆了 -> 又被杀”。
- 算力被大量的无效重复重算彻底吞噬,集群有效吞吐暴跌至接近零!
4.2 智能网关层自适应背压与分级熔断策略设计
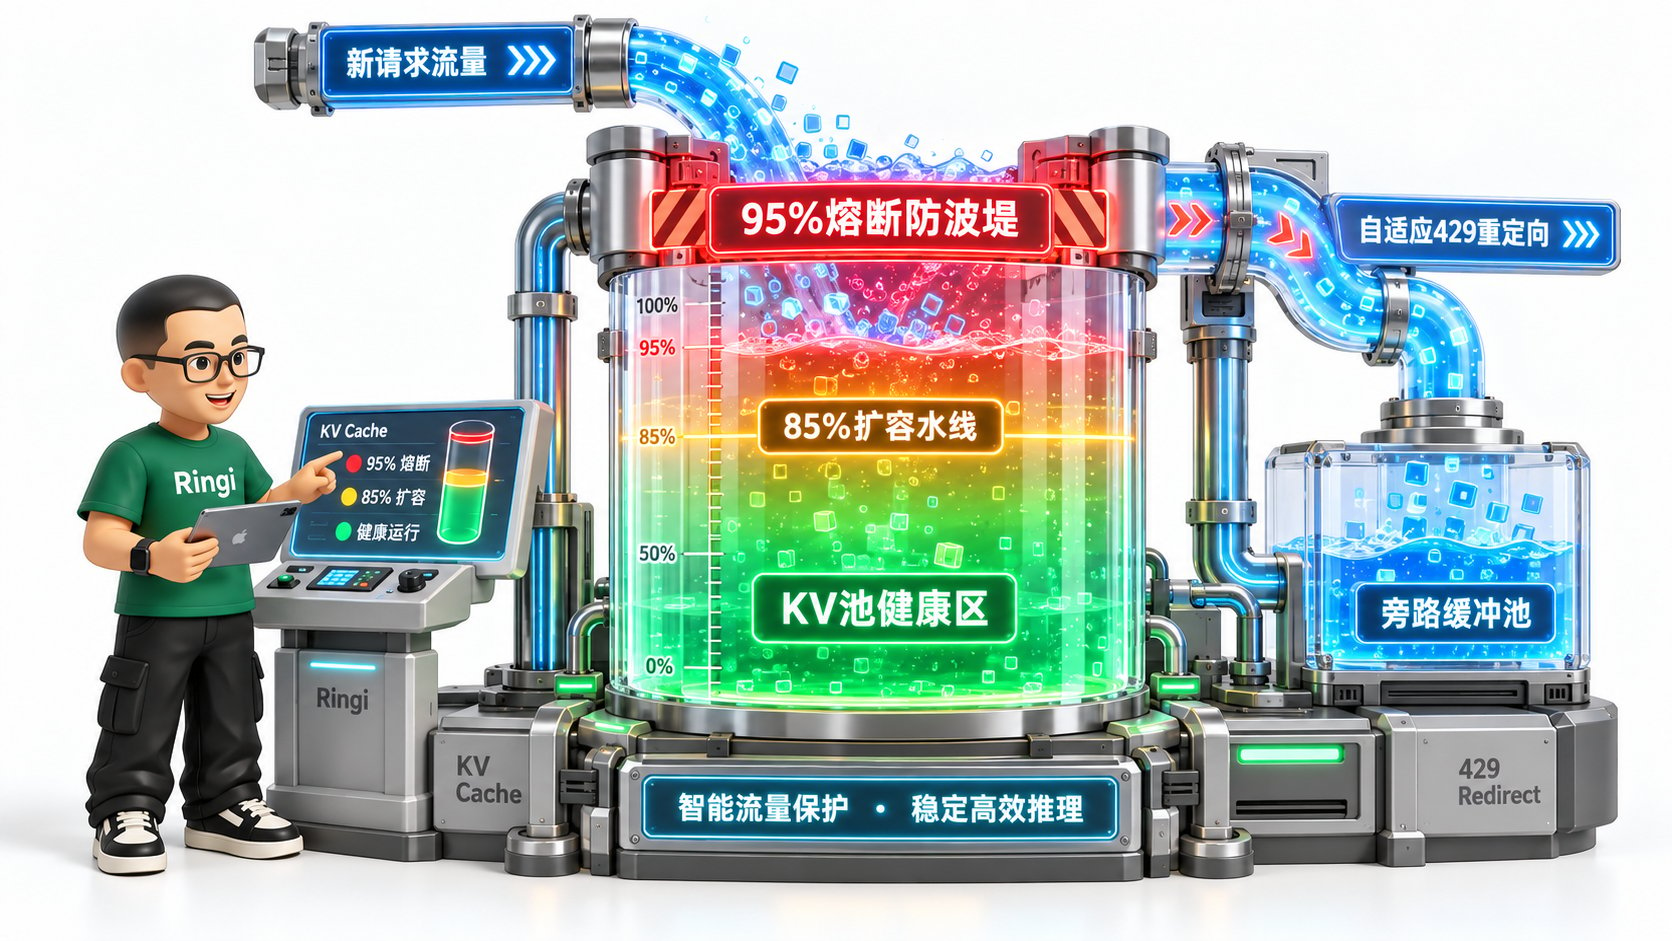
4.3 故障快速转移与跨可用区异构容灾方案
除了流量突发,硬件掉卡(Xid 79 / ECC 双比特翻转)在千卡集群中常态化发生。 生产级的高可用网关必须实现 双活容灾与被动健康检查(Passive Health Check):- 即时重试与摘除:当某个 Pod 所在的 GPU 突然硬件挂死,Pod 的 TCP 连接异常断开时,网关在收到连接重置(ECONNRESET)的一瞬间,在客户端无感的情况下,自动将该请求重试路由到健康的备份 Pod;
- 快速标记下线:如果一个 Pod 连续两次返回 500 错误或心跳丢失,网关立即将其剔除出活跃路由表,并向 K8s 告警触发自愈控制器。
5. 动手实战与代码实验室(Minimal Runnable Code)
本讲提供 4 个可以直接在本地或集群上运行的高可用与可观测实战工程源码。5.1 实战 1:纯 Python 模拟高并发 LLM Serving 负载与 KV Cache 水位仿真器
为了让大家亲眼看到随着并发增长,KV Cache 是如何一步步被占满,以及 TTFT 和排队延迟是如何呈指数爆炸恶化的,我们编写了以下自主仿真器:5.2 实战 2:生产级 DCGM + vLLM 监控 Prometheus 告警规则 YAML 配置
下面给出可以直接应用到生产 Prometheus 的完整告警规则组,精准覆盖硬件掉卡、显存溢出、P99 首字时延劣化与排队积压:5.3 实战 3:KEDA 针对 vLLM 排队与 KV Cache 复合指标的 ScaledObject 配置实战
下面给出基于 KEDA 的大模型在线服务弹性伸缩生产级配置。通过监听 Prometheus 中的排队等待数与显存水线,实现秒级扩缩容:5.4 实战 4:轻量级 Python 反向代理网关自适应流式背压与熔断中间件
在网关层,如何阻断流量雪崩?下面给出一个用 Python 实现的高性能自适应流式网关核心逻辑,它能够主动检测后端健康度并在高危时返回标准 HTTP 429:6. Ringi 避坑指南与生产黄金准则
6.1 避坑表格(❌ 常见小白错误理解 vs ✅ 大厂 AI Infra 正确理解)
6.2 生产环境 AI Serving 可观测与弹性伸缩黄金 Checklist
在大模型在线服务正式接入线上网关与生产流量前,请严格逐项审查以下 10 条黄金准则:- 1. 【DCGM Exporter 部署】:确认全集群 GPU 节点已部署
dcgm-exporter,并已开启 Field ID 203(SM Active)与 204(Mem Copy Util)指标采集。 - 2. 【原生语义指标暴露】:推理框架(vLLM/TGI)启动参数必须开启
--enable-metrics,验证:8000/metrics能正常抓取到排队数与 KV Cache 比例。 - 3. 【KEDA 毫秒级配置】:弹性伸缩器强制使用 KEDA 代替原生 HPA,将轮询间隔(
pollingInterval)设为 5 秒,扩容稳定窗口设为 0 秒(秒级激进扩容)。 - 4. 【长文本优雅缩容】:Pod 规范中显式声明
terminationGracePeriodSeconds: 300(5 分钟),推理进程捕获SIGTERM并在 drain 完在途请求后主动退出。 - 5. 【网关层自适应背压】:智能网关(Envoy/APISIX)配置基于健康探针的主动限流策略,KV Cache 水位超过 90% 时果断拦截并返回
HTTP 429。 - 6. 【客户端指数退避】:前端 SDK 与移动端必须支持捕获 429 状态码,并严格遵循
Retry-After头指示进行带随机抖动的指数退避,禁止连续重刷。 - 7. 【SLO 破线报警布防】:Prometheus 告警规则必须覆盖 P99 TTFT > 2.0s 与排队等待请求 > 10,并在 1 分钟内推送报警至值班群。
- 8. 【Xid 掉卡自动摘机】:配置规则监控
dcgm_xid_errors > 0,一旦发生硬件错误,3 秒内自动剔除 Endpoints,阻断新流量灌入坏卡。 - 9. 【冷启动预热探针】:Pod 配置
readinessProbe,必须使用一个极简 Prompt 调用一次前向推理验证权重已全量就绪后,方可加入网关负载均衡。 - 10. 【防破坏预算(PDB)】:线上核心 Serving 强制绑定
PodDisruptionBudget,设定minAvailable: 50%,防止集群维护升级时导致服务归零。
7. Ringi 5 点核心速记口诀、自我检验清单与课后深度思考题
7.1 5 点押韵核心速记口诀
7.2 10 条白板自我检验清单
- 为什么在 vLLM 服务启动后,通过
nvidia-smi看到的显存占用率高达 90% 以上是正常现象? - 为什么说
nvidia-smi的GPU-Util是个“具有欺骗性”的指标?DCGM 的哪个指标能够真实反映 SM 活跃度? - 大模型在线推理的 TTFT(首字时延)与 TPOT(单字时延)分别受到哪种硬件瓶颈的制约(Compute-bound 还是 Memory-bound)?
- 什么是 ITL(Inter-Token Latency)?它为什么会产生剧烈抖动?
- 传统 Kubernetes HPA 在面对大模型长连接流式输出时,缩容机制存在什么致命缺陷?
- KEDA 的工作原理是什么?相比原生 HPA,它为什么更适合大模型弹性伸缩?
- 当 vLLM 的 KV Cache 显存占用率达到 100% 时,推理引擎在底层会采取哪些自保动作?为什么这会引发性能雪崩?
- 在智能流量网关层,自适应背压(Backpressure)是如何防止客户端重试风暴压垮推理集群的?
- 为什么在生产环境部署大模型 Pod 时,
terminationGracePeriodSeconds通常需要设置到 300 秒甚至更长? - DCGM 的指标采集是如何做到对正在执行的 GPU 计算完全零性能干扰的?
7.3 3 道高阶开放式课后思考题(含极限 Corner Case)
思考题 1:长上下文(128K)突刺与显存雪崩防御
某知识库检索场景下,用户频繁上传长达 100K Tokens 的长文档进行对话总结。单个请求在执行 Prefill 阶段时,一次性吃掉了单卡 60% 的 KV Cache 块,导致其他正在生成的 30 个小请求瞬间被剥夺显存引发抢占换页。作为平台架构师,你该如何从引擎参数(如--max-num-batched-tokens 块切分 Chunked Prefill)、网关调度策略(长短文本队列解耦)与资源配额层面设计彻底的隔离防御体系?
思考题 2:跨多机张量并行(TP=8)集群的极速冷启动
在高峰期通过 KEDA 扩容一个 70B 模型的副本时,该服务需要申请 8 张卡并在启动时拉取 140GB 的权重文件。常规从对象存储拉取需要 5 分钟,严重拖慢了自动扩容的时效性。你将如何结合 P2P 镜像分发(Dragonfly)、共享分布式只读缓存(3FS/JuiceFS)与 GPU 内存预热技术,将大模型副本的冷启动时间压缩到 30 秒以内?思考题 3:基于用户 SLA 分级的流式优雅降级
假设系统遭遇了超越集群极限 3 倍的不可抗力流量洪峰,且外部云厂商已无法提供更多的 GPU 算力资源。在无法水平扩容的前提下,如何设计一套自适应降级算法(例如:动态调低大模型的max_tokens 生成上限、将高计算代价的采样算法温度调为贪婪 Greedy、或对低优先级用户动态切换至小参数量模型进行保底响应)?
8. 📚 参考资料与核心源码/经典论文指引
在撰写本讲与进行系统级溯源时,本文严格对照并引用了以下一手权威工程源码与官方文献:- NVIDIA 官方开源项目与监控白皮书:
NVIDIA DCGM官方源码仓库与架构手册:https://github.com/NVIDIA/DCGMdcgm-exporterPrometheus 采集器仓库:https://github.com/NVIDIA/dcgm-exporter- NVIDIA Data Center GPU Monitoring 最佳实践白皮书
- 云原生弹性伸缩与大模型推理核心项目:
KEDA(Kubernetes Event-driven Autoscaling) 官方规范:https://github.com/kedacore/kedavLLM官方开源推理系统源码:https://github.com/vllm-project/vllm- Kubernetes Horizontal Pod Autoscaler (HPA) 架构文档
- 本地 AI_BOOK 知识库精准检索对照:
AI_BOOK/AI-fundamentals/03_ai_cluster_ops/01_gpu_ops/05_dcgm_monitoring.md(DCGM 核心指标详解与实操)AI_BOOK/AI-fundamentals/03_ai_cluster_ops/01_gpu_ops/02_gpu_utilization_myth.md(GPU 利用率神话与真实硬件活跃度拆解)AI_BOOK/llm-action/llm-interview/llm-inference.md(首 Token 延迟 TTFT 与端到端时延权威推导)AI_BOOK/llm-action/docs/llm-base/dcgmi.md(dcgmi命令与监控拓扑实战)
附录:Appendix A — 大厂硬核高频面试题与白板推导
面试题 1:为什么在大模型在线 Serving 平台中,绝对不能直接基于 CPU 或内存利用率配置 HPA 自动扩缩容?
考察维度:对大模型推理底层系统机制(连续批处理、PagedAttention 显存预占)的理解深度。标准解题思路与满分回答路径:
- 显存静态预占机制:现代大模型推理框架(如 vLLM)普遍采用 PagedAttention。为了避免内存碎片并在运行时实现极速分配,容器启动后会将剩余物理显存全量预分配为 KV Cache 块池。因此,无论业务有无请求,硬件监控显示的显存占用率恒定在 90%~95%,指标处于伪饱和状态;
- CPU 与推理压力脱敏:大模型的矩阵计算与 Attention 算子完全运行在 GPU 上,CPU 仅负责简单的调度循环与分词(Tokenization)。当流量激增时,CPU 利用率可能仅从 10% 微涨至 25%,传统 CPU 指标完全无法感知系统过载;
- 正确解法:必须采用语义级和队列级事件驱动扩缩容(通过 KEDA),核心监听指标为
vllm:num_requests_waiting(排队等待请求数) 与vllm:gpu_cache_usage_factor(KV Cache 实际使用率)。
面试题 2:如何用 Prometheus + DCGM 精确区分一个大模型推理服务处于算力受限(Compute-bound)还是显存带宽受限(Memory-bound)?
考察维度:对 Roofline 模型、GPU 硬件微架构(SM vs HBM 内存控制器)以及大模型 Prefill/Decode 物理差异的穿透认知。标准解题思路与满分回答路径:
- 核心观察指标对照:
- 提取 DCGM Field 203:
DCGM_FI_DEV_GPU_UTIL或DCGM_FI_PROF_SM_ACTIVE(代表计算核心 SM 的活跃程度); - 提取 DCGM Field 204:
DCGM_FI_DEV_MEM_COPY_UTIL或DCGM_FI_PROF_DRAM_ACTIVE(代表 HBM 显存控制器的读写带宽活跃程度);
- 提取 DCGM Field 203:
- 状态判定逻辑:
- Compute-bound(算力受限):SM Active 处于高位(如 > 80%),而 DRAM Active 处于中低位。这通常出现在 Prefill 阶段(批量并行处理长输入 Prompt,算术强度高);
- Memory-bound(访存受限):DRAM Active 逼近物理极限(如 > 85%),而 SM Active 较低。这通常出现在 自回归 Decode 阶段(每个 Step 只能生成 1 个 Token,但每一步都需要将数十 GB 的模型权重和 KV Cache 全量读一遍,算术强度极低,硬件处于访存瓶颈);
- 架构调优指导:针对 Prefill 受限可做 Chunked Prefill 或并行度扩容;针对 Decode 受限应采用张量并行分摊显存带宽、量化(W8A8/FP8/AWQ)或使用多副本并发处理。
面试题 3:如果突发极端流量导致 vLLM 的 KV Cache 显存被彻底耗尽(100%),推理系统内部会发生什么?作为平台架构师该如何防御?
考察维度:对连续批处理抢占调度算法的理解、生产级雪崩机理与高可用背压方案设计。标准解题思路与满分回答路径:
- 系统内部雪崩机理:
- 当没有空闲 KV Block 分配给正在解码的请求时,引擎为了避免直接崩溃退出,会触发自保机制:强制将低优先级请求的上下文 换出(Swapping)到 Host 内存,甚至直接 重置(Preempt/Recompute);
- 被打断的请求在未来有空间时必须从头重新做 Prefill 计算,导致极其昂贵的算力被无效浪费;系统进入频繁换页的“震荡假死(Thrashing)”状态,最终导致全链路请求超时;
- 防御架构三道防线:
- 第一道(引擎内部):配置安全水位限制(如保留 5% 的显存预留垫);
- 第二道(弹性扩缩容):配置 KEDA 在水线达到 80% 时瞬间激进扩容新 Pod;
- 第三道(网关背压):在 Ingress/网关层实现自适应熔断,当探测到后端水线突破 90% 时,直接快速失败返回
HTTP 429 Too Many Requests,坚决不让新的大请求涌入引擎,保住存量在途请求正常输出。
面试题 4:在大模型长连接流式输出(SSE)场景下,如果 Kubernetes 发生 Pod 缩容或滚动更新,如何做到在线用户“零卡顿、零截断”?
考察维度:对 Kubernetes 生命周期钩子(Lifecycle Hooks)、连接排空(Draining)与长连接协议的工程治理实操。标准解题思路与满分回答路径:
- 核心痛点:普通微服务请求通常只有几十毫秒,而大模型生成一个长回答可能需要 30 秒甚至数分钟。如果直接缩容或滚动发布,默认 30 秒的终止期会导致正在输出的用户被强行斩断;
- 生产解决方案三部曲:
- 第一步(流量立即摘除):将 Pod 从 Service 的 Endpoints / Ingress 列表中剔除,保证后续新请求不会再分配进来;
- 第二步(大幅延长宽限期):在 Pod Spec 中设置
terminationGracePeriodSeconds: 300(5 分钟),给长文本生成预留充分的时间窗口; - 第三步(实现优雅 Drain 信号捕获):推理服务主进程捕获操作系统发送的
SIGTERM信号后,进入只读排空模式:继续维持已有的在途 SSE 长连接并持续吐字,直至所有当前请求的vllm:num_requests_running == 0,随后进程主动退出。
🎨 【配图工坊生图 Prompt 暂存区 · 仅剩蓝图 1 待生成】
提示:蓝图 2、3、4 已成功归档并回填正文。当前仅保留蓝图 1(Serving 高可用全景工坊),供创作者使用 Midjourney / DALL-E 3 生成工业级架构插图。生成并归档 assets/arch_39_serving_ha_observability_slo_governance.svg 后,可彻底删除本区块及目录导航对应链接。
蓝图 1:生产级 LLM Serving 高可用、可观测与自动扩缩容全景工坊
- 文件路径:
assets/arch_39_serving_ha_observability_slo_governance.svg - 核心中文标签:
智能流量网关、连续批处理与KV池、DCGM全维可观测、KEDA弹性伸缩、自适应背压熔断
🇨🇳 中文直接生图指令(推荐直接发给 ChatGPT / DALL-E 3):
🌐 中英双语精准 Prompt(Midjourney / DALL-E 3 专用):