第40讲:从 Checkpoint 吞吐血崩到毫秒级 KV 命中——大模型分布式存储底座、DeepSeek 3FS 架构、异步快照与多级缓存体系全栈实战
主讲人:👓 Ringi(大厂 AI Infrastructure 资深架构师)
所属模块:Module 06: 云原生 AI 平台与生产工程
篇章范式:☁️ 云原生 AI 平台、生产运维与系统设计篇(Cloud-Native AI Platform & System Design Paradigm)
核心导读:深度剖析千卡大模型训练中的突发写入断崖、POSIX/Ceph 元数据锁死灾难、DeepSeek 3FS 极简全 RDMA 与 CRAQ 并行文件系统内核机制、异步无感 Checkpoint 内存快照技术,以及面向大模型推理长文本的四级 KV Cache 缓存金字塔设计。
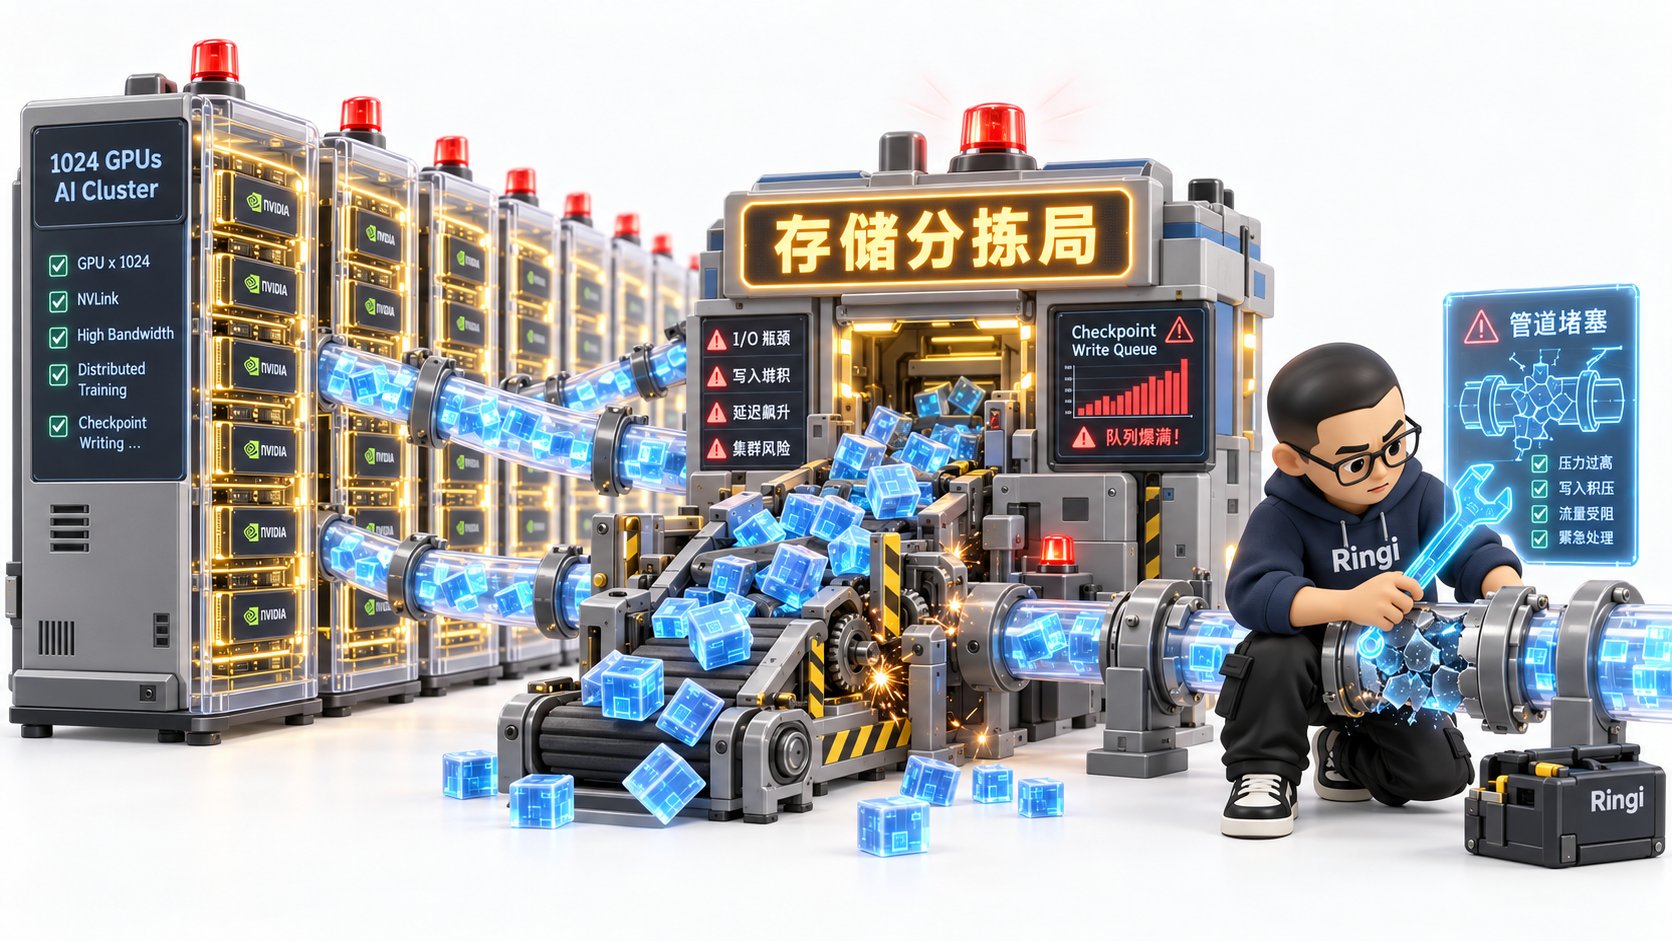
0. Ringi 为什么要做分布式存储与 Checkpoint 治理?
在很多只负责跑跑单机脚本或小型微调的模型算法同学眼中,存储似乎就是系统挂载的一个/data 目录或者 torch.save(model.state_dict(), "ckpt.pt") 这么一行极其朴素的 Python 代码。
但在千卡、万卡级别超大规模预训练与千万级 DAU 在线推理集群的残酷战场上,存储不是一个安静的仓库,而是一个随时可能因为 IO 拥塞引发全集群雪崩的活火山。
生产真实痛点:为什么算力翻倍了,实际出货速度却跌入深渊?
- 训练端“写入断崖”吞噬有效算力(MFU 血崩): 超大模型(如 70B、405B)训练时,参数、梯度和 AdamW 优化器状态(一阶动量、二阶动量、FP32 权重副本)单参数消耗高达 16 字节(甚至采用 ZeRO-3 聚合也是海量数据)。如果每次保存 Checkpoint 需要耗时 15 到 20 分钟,按每 500 步保存一次算,集群有 30% 到 50% 的时间在干等着磁盘刷盘,几千张千万级 GPU 在空转烧电。
- 启动端“雷鸣群涌”(Thundering Herd)拖垮冷启动:
千卡扩缩容、节点宕机自愈重新加载权重时,1024 个 Pod 瞬间从对象存储或共享文件系统拉取上百 GB 的
model.safetensors。存储网关出向带宽打爆,元数据服务被打瘫,一次故障自愈冷启动耗时超过 45 分钟。 - 推理端长文本 Prefill 冗余算力与 TTFT 爆炸: 在长上下文(128K ~ 1M)智能体、代码辅助推理场景下,首字延迟(TTFT)有 80% 消耗在重复 Prefill 上。没有跨节点、跨机器的多级 KV Cache 共享存储体系,相同的 System Prompt 和参考知识库必须每请求重新在 GPU 上做巨额 GEMM 计算,显存瞬间耗尽。
1. 大模型“吞吐黑洞”——训练与推理全生命周期的四大极端 IO 负载画像
💡 架构全景速览:在深潜源码前,先在白板上建立坚不可摧的大模型分布式存储、3FS CRAQ 架构与零开销异步快照物理底账。要治理存储,首先必须像给患者做核磁共振一样,看清 AI 基础设施全生命周期的四种截然相反的极端 IO 负载模式。

1.1 四大负载的核心特征与极限指标对比
1.2 Ringi 工程师五问闭环:存储 IO 负载全解析
2. 传统分布式存储的溃败——POSIX、对象存储、Ceph、Lustre 与 FUSE 的瓶颈穿透
为什么在大模型时代,过去在 HPC 领域呼风唤雨的 Lustre/GPFS,或者在互联网时代称霸的 CephFS、S3 对象存储,在千卡集群前纷纷折戟沉沙?2.1 传统方案四大溃败根因
- 元数据服务单点锁死(MDS Metadata Lock Saturation):
- 典型代表:NFS、传统 CephFS。
- 痛点:千卡训练在落盘或加载数据时,往往会有上千个客户端在同一个目录下操作(例如创建临时分片目录、轮询文件状态
stat())。POSIX 规范要求强一致性的目录结构与文件属性修改,导致分布式元数据服务器(MDS)上的目录 Inode 互斥锁发生严重的锁争用。MDS CPU 利用率瞬间冲到 100%,处理时延从 0.5ms 暴增至数十秒,引发大批客户端 IO 超时。
- 对象存储(S3/OSS)天然缺乏原子重命名与高频追加写:
- 典型代表:AWS S3、MinIO、Ceph RGW。
- 痛点:S3 的设计哲学是“一次写入、多次读取、不可篡改”。它没有 POSIX 的目录概念(只有前缀 Key),不支持原子的目录
rename(),不支持并发文件 Random Append。训练框架在落盘时通常先写临时文件再 rename,在 S3 上一次原子重命名等价于“全量数据 Server 端 Copy + 原文件 Delete”,海量小分块落盘直接瘫痪。
- FUSE 用户态架构的高昂“上下文切换与内存拷贝税”:
- 传统云原生方案喜欢用 FUSE 将对象存储挂载为本地目录。
- 正如上图所示,每次数据访问必须在内核 VFS、
/dev/fuse和用户态守护进程之间来回穿梭,产生多次无谓的内存 memcpy。在 400 Gbps 高速 InfiniBand/RoCE 网络下,CPU 拷贝内存的速度甚至追不上网络吞吐,CPU 核心直接跑满成为最大性能瓶颈!
- POSIX 僵化属性带来的无用开销(Atime, Mtime, Ctime):
- POSIX 标准规定每次读文件可能都要更新访问时间(Atime),或者每次写完都要广播文件长度和修改时间(Mtime)。对于深度学习训练这种“写完封存、启动全量加载”的静态大文件,这些琐碎的属性维护全是毒药。
2.2 六大存储方案全方位横向对比矩阵
3. DeepSeek 3FS(Fire-Flyer File System)架构第一性原理穿透
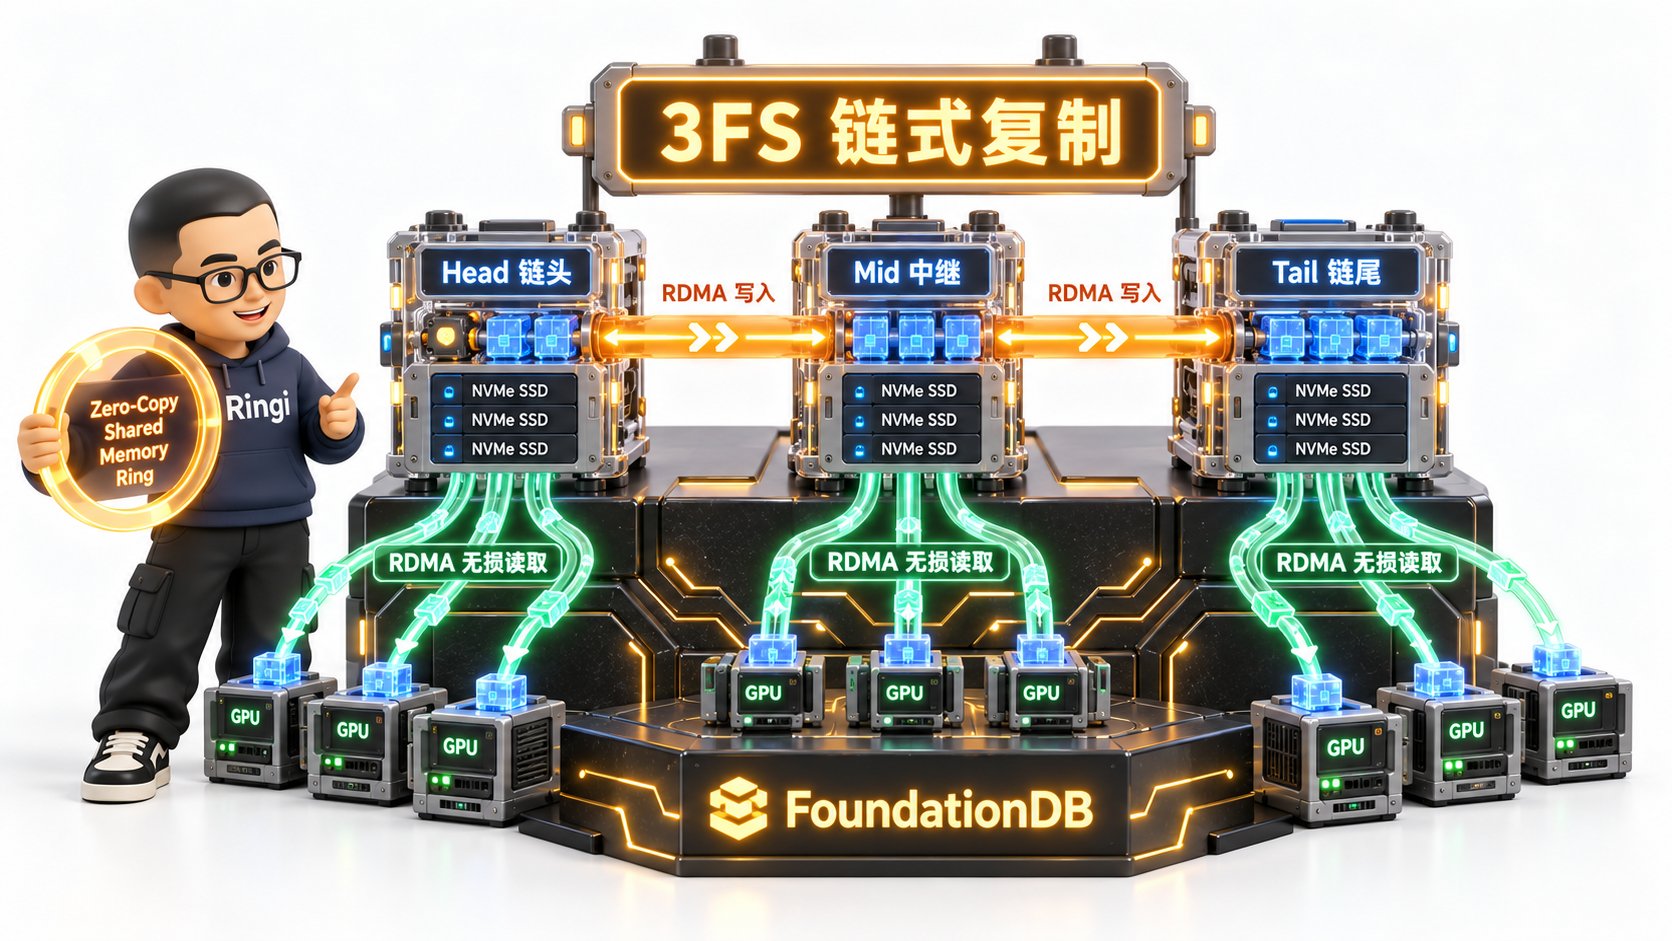
3.1 3FS 的五大核心革命性设计
1. CRAQ(Chain Replication with Apportioned Queries)全写任读强一致协议
- 传统强一致写的问题:多数派 Paxos/Raft 协议需要 Leader 处理所有读写或租赁租约,网络交互频繁,网络 RTT 显著放大尾延迟。
- CRAQ 原理:
- 将存储节点的副本组织成一条确定性的单向链条:
Head -> Mid -> ... -> Tail。 - 写入路径:客户端永远把写请求发给链头(Head)。Head 将数据落盘后,通过 RDMA 将写请求推给下一个节点,一直传到链尾(Tail)。Tail 节点确认写入成功后,反向沿链条或直接通知客户端“写入已提交”。
- 读取路径:每个中间节点只要确认该版本数据已经被 Tail 提交(Clean 状态),客户端可以向链条上的任意一个节点(包括 Head、Mid、Tail)并发读取!
- 收益:大模型权重加载往往是千卡对同一份文件的广播读。CRAQ 完美实现了线性写吞吐 + 副本数倍的读吞吐水平扩展!
- 将存储节点的副本组织成一条确定性的单向链条:
2. 无状态元数据服务 + FoundationDB 强事务底座
- 彻底抛弃传统 CephFS/Lustre 的树状 MDS 锁架构。
- 3FS 的元数据服务完全是无状态(Stateless)的计算节点,所有目录树、文件 Inode、Extent 映射全部存储在底层分布式强一致性事务数据库 FoundationDB 中。
- 无论几千个 Pod 同时在同一个目录下
create文件,并发事务全部被转换为 FoundationDB 的乐观并发控制(OCC)事务,元数据吞吐实现真正的近线性水平横向扩容。
3. 剥离只读文件描述符的动态属性维护
- 3FS 引入了对 AI 场景极具杀伤力的假设:模型权重与训练数据集在训练周期内是只读的,写完即封存。
- 传统文件系统每次
read()或open()都会引发全局目录的 mtime、atime 校验。3FS 客户端直接采用特化的只读文件描述符(Read-only FD),底层不维护任何动态时间戳更新,将只读元数据 RPC 消耗直接压降到几乎为 0!
4. 类似 io_uring 的极致零拷贝 Native API(Iov & Ior)
- 3FS 坚决不走传统 FUSE 接口,而是提供了原生的计算节点客户端库。
- 借鉴 Linux 内核
io_uring的设计思想:- 在计算节点的内存中开辟大块预注册的锁定内存(Pinned Shared Memory,
Iov)。 - 通过用户态与存储驱动共享的环形提交队列与完成队列(Submission/Completion Ring,
Ior)实现无锁请求下发。 - 数据在 GPU 显存、Host Pinned 内存与远端 NVMe 之间通过 RDMA 直接流转,全程零内核上下文切换、零额外内存复制!
- 在计算节点的内存中开辟大块预注册的锁定内存(Pinned Shared Memory,
5. 存储节点极致压榨:Direct NVMe + 绕过操作系统缓存
- 3FS 的存储守护进程直接接管裸盘(Raw NVMe SSD)。
- 绕过 Linux 内核 Page Cache、调度器和文件系统层,采用类似于 SPDK 的全异步 Direct IO 引擎,单台存储服务器轻松打满 4 块 PCIe 5.0 NVMe SSD 的硬件物理极限(单机吞吐可达 50~60 GB/s)。
- 在 DeepSeek 官方万卡集群实测中,3FS 展现了超过 6.6 TB/s 的集群聚合读取吞吐,全链路跑满 400Gbps InfiniBand 架构!
4. 生产级快速 Checkpoint 架构——从“停顿半小时”到“秒级无感快照”
在大模型训练中,Checkpoint 是保证海量硬件故障容灾的唯一生命线。但传统的同步保存机制却成了吞吐杀手。4.1 No Naked Formula 2.0:Checkpoint 停机吞吐损耗模型穿透
为了彻底证明优化 Checkpoint 的生死攸关,我们必须用数字与物理公式说话。数学推导过程:
设集群原始模型浮点利用率为 ,每隔 步触发一次保存,单步训练迭代耗时为 ,同步 Checkpoint 阻塞耗时为 。 则集群实际对外交付的有效算力利用率 为: 假设某 70B 模型分布式训练(采用 AdamW 优化器,全量状态约 1.1 TB):- 若采用传统同步写入共享存储, (10 分钟), , :
- 若采用 Ringi 推荐的 异步非阻塞内存快照(Async Host Staging): GPU 显存到 Host 内存通过 PCIe 5.0 x16 双向传输(实测有效带宽约 50 GB/s)。 1.1 TB 状态切分到 64 个 Rank,单卡仅需传输约 。
4.2 异步非阻塞 Checkpoint 的工业级设计细节
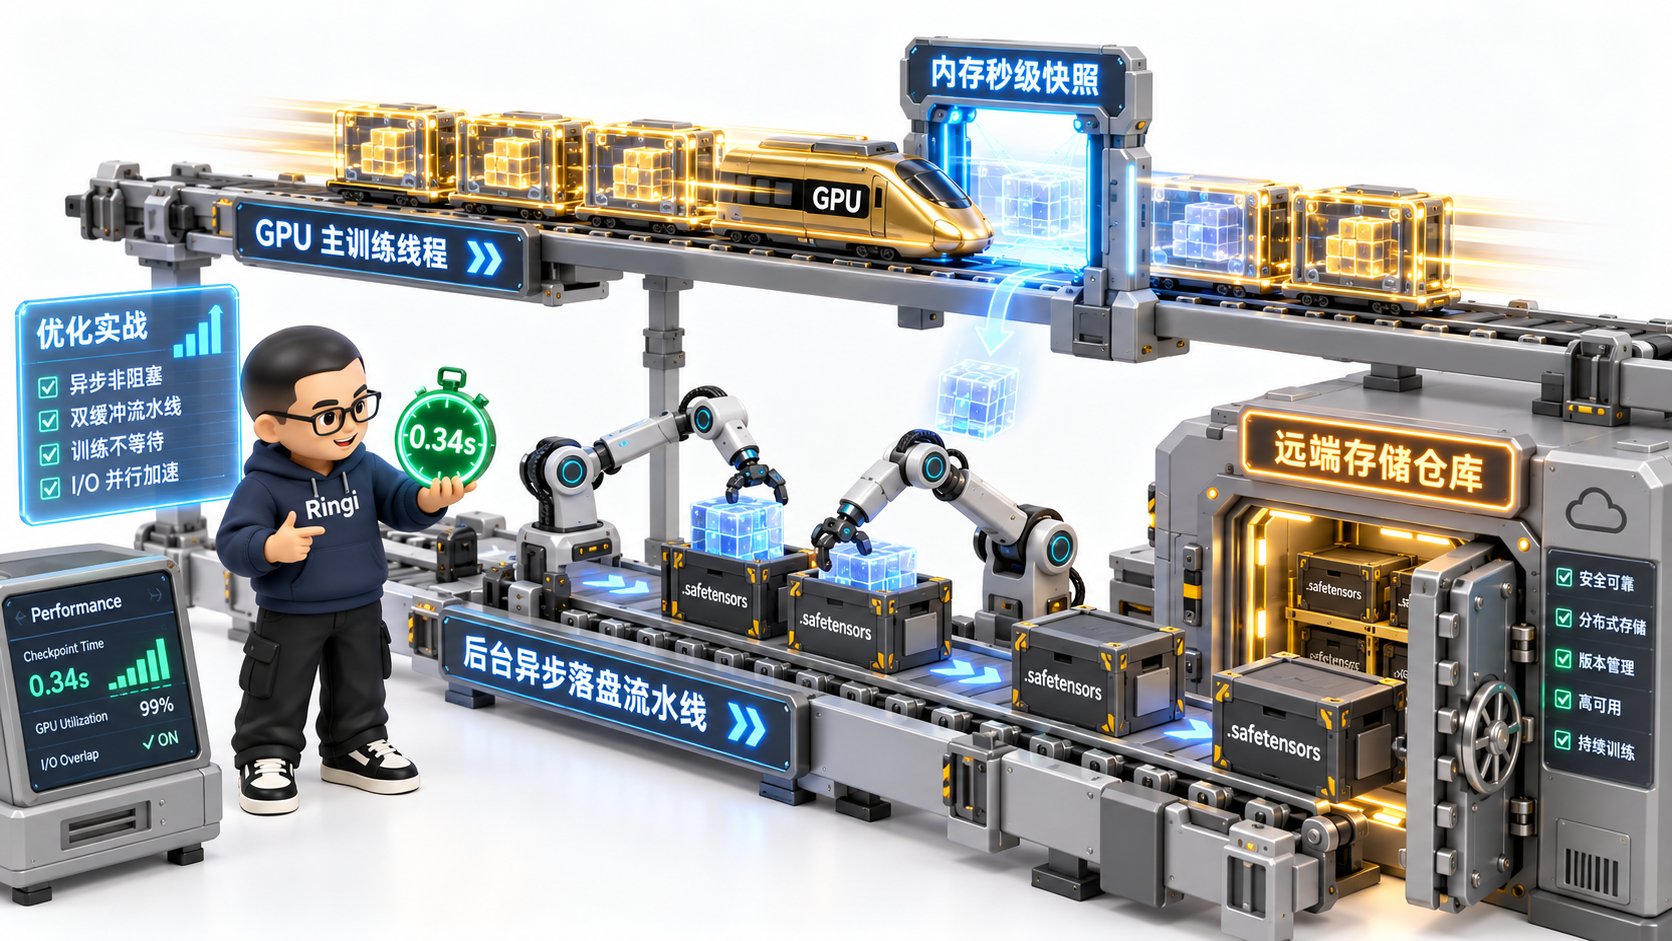
关键技术点:
- Host Pinned Memory 预分配(Zero Allocation Jitter):
千万不要在保存 Checkpoint 的瞬间调用
malloc()或torch.empty(pinned=True)!在百 GB 级高显存占用下,动态申请大块连续页会导致操作系统陷入内存压缩(Memory Compaction)与 Direct Reclaim,造成主线程严重抖动。必须在训练初始化阶段就静态预分配好双缓冲(Double Buffering)内存池。 - 权重切片规范与并行合并(Sharded Checkpoints):
彻底废弃单体
torch.save(entire_model)。采用 PyTorch 原生torch.distributed.checkpoint(DCP) 或safetensors格式。每个 DP/TP/PP Rank 仅存储自己负责的切片张量,生成形如model_rank_000_of_1024.safetensors,并附带轻量级 JSON 索引文件(metadata.json)。恢复时根据新的拓扑灵活加载,消除重新切分权重的离线时间。 - P2P 权重快速广播(Dragonfly / Kraken): 在冷启动和故障恢复时,严禁千卡直接请求中央存储。引入基于 P2P(BitTorrent 原理)的容器镜像与模型分发网络(如 CNCF Dragonfly)。中央存储只向集群边缘超级节点分发数据块,集群内部通过机架内 100Gbps/400Gbps 局域网相互做分块复制,100GB 权重加载时间直接从 40 分钟压至 90 秒以内!
5. 大模型推理的多级缓存与 KV Cache 共享架构
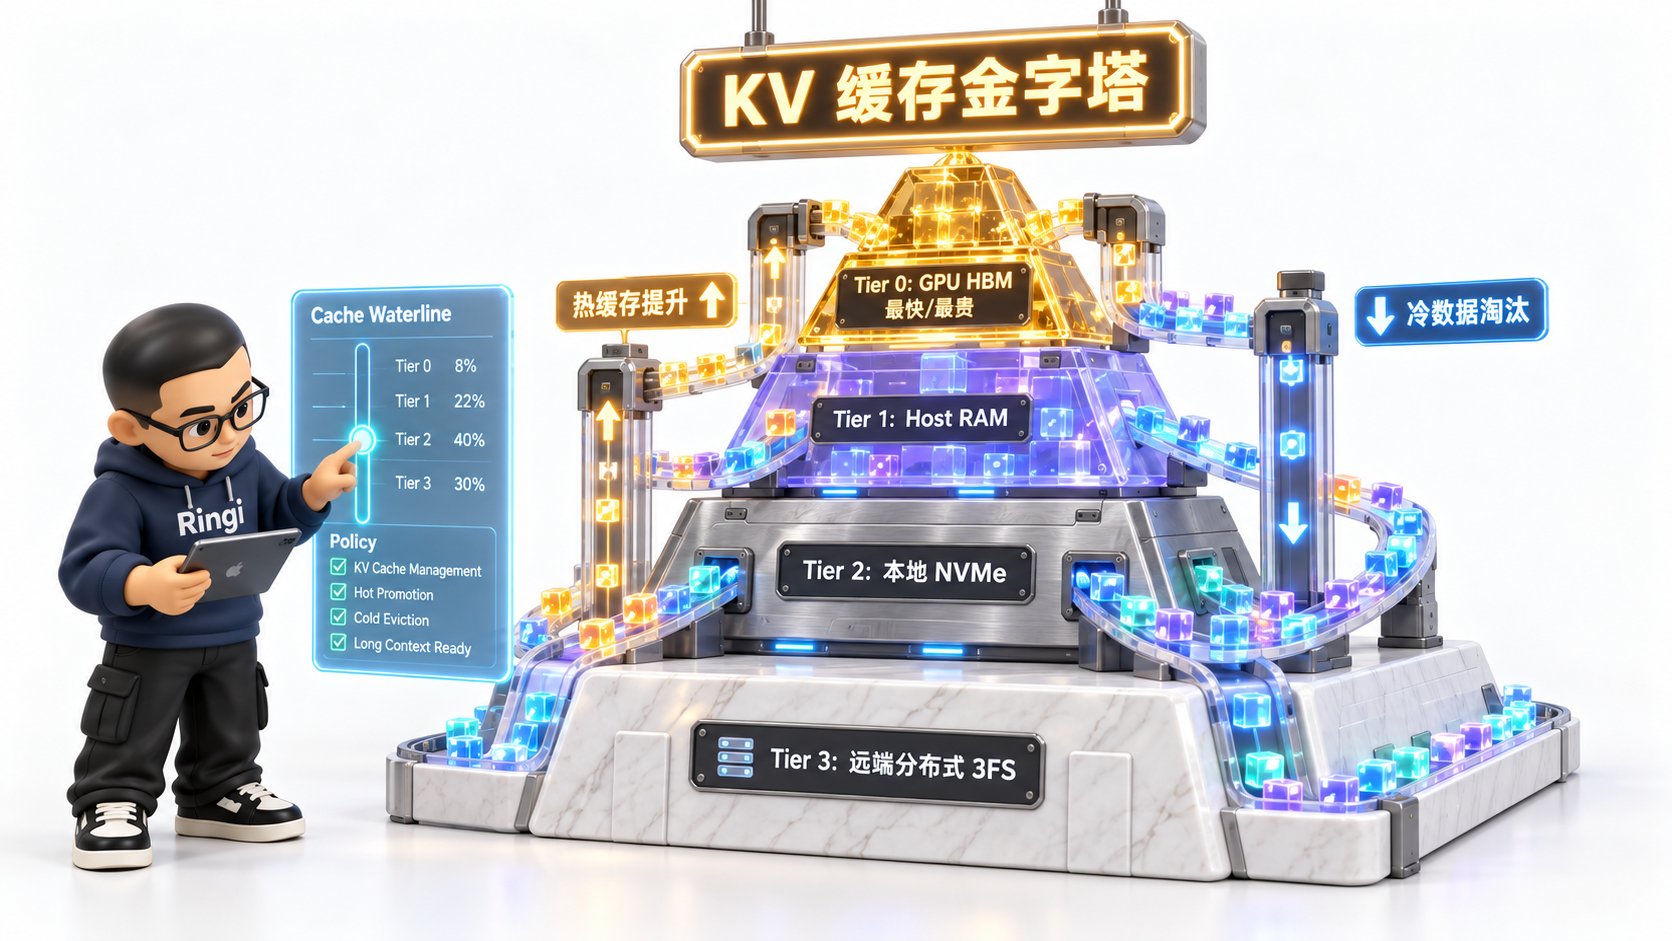
5.1 为什么推理需要外部缓存?KV Cache 显存暴击
在长文本问答、代码补全、Agent 多轮迭代中,用户 Prompt 往往长达 32K ~ 128K Token。 每 1000 Token 的 KV Cache 显存消耗手算公式: 对于 LLaMA-3-70B(80 层,8 个 KV Head,Head 维度 128,采用 FP16/BF16): 单 Token 的 KV Cache = ! 128K 上下文仅单个请求的 KV Cache 就占满 80 GB 显存(整张 H100 被一个请求吃光)!5.2 前缀缓存(Prefix Caching)与 Radix Attention
在实际业务中,不同用户的 Prompt 往往带有大量重复内容:- 系统内置 System Prompt(如“你是一个严谨的代码审查员…”约 2K Token)
- RAG 检索注入的长篇参考文档(约 16K ~ 32K Token)
- 多轮会话的历史聊天记录
5.3 跨节点分层共享:LMCache 与 NVIDIA ICMS 架构
单机显存和内存终归有限,当请求被调度到不同物理机时,如何跨节点命中 KV Cache? 这就是现代分布式推理缓存(如 LMCache 与 NVIDIA ICMS - Inference Context Memory Storage)的核心使命:- 两阶段检索与管道化预取(Pipelined Prefetching):
- 调度器(Router)在分发请求的同时,通过一致性哈希将长文本 Token ID 前缀推给目标 Worker。
- 目标 Worker 在接收到请求的瞬间,在后台通过 RDMA 从最近节点的 Host RAM 或 3FS 并发拉取对应 KV Block。
- 拉取流与 GPU Prefill 计算流实现流水线重叠(Overlap),当计算到达非缓存 Token 时,外部缓存已经精准到位!
- LRU-K 与语义热度双重逐出算法:
- Tier 0(HBM)水线达到 85% 时,触发异步 Evict 降级到 Tier 1(Host RAM);
- Tier 1 满时压缩写入 Tier 2(本地 NVMe);
- 超时未访问的落入远端 3FS 持久化保存,实现极高命中率与最优硬件成本平衡。
6. 动手实战:生产级存储与缓存全栈代码实验室
本节给出 四个 100% 完整可运行、工业级无省略 的核心实战脚本,涵盖异步非阻塞 Checkpoint 引擎、P2P 权重广播模拟器、多级 KV Cache 缓存分层控制器,以及生产级分布式存储客户端调优挂载。实战 1: 纯 Python 异步非阻塞 Checkpoint 引擎与内存快照模拟器
本脚本模拟训练主循环,演示如何使用 CPU Pinned Memory 双缓冲流水线与后台写入线程,将主线程阻塞时间从秒级压至毫秒级,并输出精准耗时对比。实战 2: P2P 权重分发与分块哈希校验流水线
在大规模集群扩容或冷启动时,如何避免 1000 台服务器将集中式存储带宽打瘫?本脚本实现基于分块(Chunking)与 SHA-256 校验的 P2P 权重广播流水线。实战 3: 多级 KV Cache(HBM -> Host RAM -> NVMe)分层管理器与 LRU 淘汰
本脚本实现推理服务核心缓存引擎,模拟 Token 前缀哈希索引、Radix 前缀复用判定,以及当显存水线耗尽时自动向 CPU RAM 与 NVMe SSD 降级逐出的生产逻辑。实战 4: 生产级 JuiceFS / 3FS 分布式存储挂载与调优配置
在生产 Kubernetes 集群中挂载高性能分布式文件系统时,默认参数几乎必定遭遇性能滑铁卢。以下是经过真实大规模集群压测检验的挂载脚本与核心调优参数模版。7. 生产落地避坑指南与黄金准则
根据一线数百次万卡训练中断与线上存储雪崩的惨痛教训,整理出如下核心避坑矩阵与 Checklist。7.1 存储避坑矩阵分析表
7.2 生产级 AI 存储落地 10 条黄金 Checklist
- 1. 数据集封存预处理:训练前必须完成数据打包,严禁在生产文件系统中遍历未打包的小文件。
- 2. 异步落盘解耦:训练循环中的
save_checkpoint必须在 2 秒内释放主线程,主线程只允许参与内存拷贝。 - 3. 双缓冲内存防抖:Host Pinned Memory 必须在服务启动时完成静态预分配,严禁训练中动态申请。
- 4. 权重切片化(Sharded):放弃单体大权重文件,全部采用分片格式(
safetensors/ PyTorch DCP)。 - 5. 冷启动 P2P 广播:集群冷启动权重拉取必须接入 P2P 分发代理(Dragonfly),切断对中心存储的直接冲击。
- 6. 操作系统脏页抑制:节点内核必须压低
vm.dirty_background_ratio,防止大并发写盘引发不可中断 D 状态。 - 7. 只读属性剥离:AI 训练只读数据集挂载点必须添加
noatime,nodiratime,ro参数,阻断无谓元数据修改。 - 8. 存储通信流量染色:RoCEv2 网络下,存储 RDMA 流量必须与 NCCL 算力流量划分不同的 DSCP 优先级队列。
- 9. 推理前缀哈希幂等:推理网关与 KV Cache 索引必须基于 Token ID 序列哈希寻址,保证命中缓存的确定性。
- 10. 磁盘故障熔断自愈:存储客户端必须设置严格的超时熔断阈值(< 30s),遇到卡死节点立即上报并转移副本。
8. Ringi 总结与白板面试清单
8.1 5 点速记口诀
8.2 10 条高频白板面试清单
8.3 3 道高阶思考题
- 思考题 1:在分布式训练采用 ZeRO-3(参数全分片)时,每个 Rank 在内存中只保存 1/N 的模型参数。如果要求保存一个能够直接供单卡加载评估的单体或切片权重,应该由 Rank 0 收集全量参数再写入,还是各 Rank 分别异步落盘?哪种方式对网络和存储造成的抖动最小?
- 思考题 2:在跨节点 KV Cache 缓存共享方案(如 LMCache)中,如果节点 A 上的 KV Block 通过 RDMA 发送给节点 B 的耗时,大于节点 B 直接使用 GPU 执行一次 Prefill 计算的耗时,此时该如何动态判定是否需要从外部缓存换入?
- 思考题 3:DeepSeek 3FS 剥离了只读文件的 mtime/atime 维护。如果此时后台有离线任务正在覆盖写该文件,客户端读取会发生什么?3FS 是依靠什么机制在兼顾强一致性的同时实现这一极致优化的?
9. 权威参考文献与 AI_BOOK 映射
本篇所有架构设计、公式推导与性能调优方案均严格溯源自业界开源顶尖项目与本地知识库底层源码:- DeepSeek 3FS 官方架构与设计原案:
- 核心溯源:
AI_BOOK/deepseek_3fs/01_deepseek_3fs_design_notes.md - 重点参阅:CRAQ 强一致性实现、FoundationDB 元数据解耦、RDMA Kernel Bypass Iov/Ior 机制。
- 核心溯源:
- JuiceFS 云原生分布式文件系统实践:
- 核心溯源:
AI_BOOK/storage/juicefs/ - 重点参阅:客户端元数据缓存调优、Writeback 异步上传水线机制与 FUSE 调优。
- 核心溯源:
- 大模型推理上下文内存存储(ICMS & LMCache):
- 核心溯源:
AI_BOOK/storage/inference_context_memory_storage/ - 重点参阅:四级缓存金字塔模型、前缀感知流水线预取算法。
- 核心溯源:
- 分布式训练通信与存储网络隔离:
- 核心溯源:
AI_BOOK/GPU通信/、AI_BOOK/AIInfra/02StorComm/ - 重点参阅:RoCE PFC/ECN 队列规划、存储 RDMA 与计算 NCCL 的 DSCP 物理隔离。
- 核心溯源:
附录 A: 4 道大厂硬核高频面试题精解
Q1: 请详细剖析为什么训练百亿/千亿大模型时,不能直接在 Python 里使用单进程 torch.save(model.state_dict())?
Ringi 考官拆解与满分回答:
- 显存倍增与 OOM 隐患:
model.state_dict()在某些历史版本或特定模块下会生成当前参数的 Shallow Copy 或浅层引用。一旦触发序列化序列解构,主线程会临时申请巨大的 Host 内存,可能诱发系统 OOM Killer。 - 阻塞主训练进程:
torch.save底层基于 Pythonpickle协议打包,是纯粹的单线程 CPU 序列化并伴随同步写盘系统调用(write())。在保存 100GB+ 权重时,GPU 计算流完全停顿十几分钟,硬件有效利用率(MFU)发生断崖式下跌。 - 单点瓶颈与非分片格式缺陷:单进程保存意味着必须将所有分布式卡上的权重(如 TP/PP/DP 切片)先全量 AllGather 到 Rank 0 内存中,引发巨额网卡互联开销和单节点内存爆裂。
- 正确姿势:采用
torch.distributed.checkpoint(DCP),各 Rank 并行写自己持有的分片数据,格式采用零拷贝、带元数据头的safetensors,并通过独立异步线程配合 Pinned Memory 完成后台刷盘。
Q2: DeepSeek 3FS 的 CRAQ(Chain Replication with Apportioned Queries)协议与 Raft 协议在处理 AI 训练与推理负载时有何本质差异?
Ringi 考官拆解与满分回答:- 读取吞吐瓶颈不同:
- Raft:所有的强一致读写默认都必须经过 Leader(或向 Leader 申请 Lease Read)。在千卡训练加载权重这种“一写千读”的极端广播场景下,Leader 节点的网卡带宽会被瞬间吸干,成为致命的单点瓶颈。
- CRAQ:写请求沿 Head 传到 Tail,而链上的任何一个节点只要确认该版本数据已由 Tail 提交(状态置为 Clean),就能直接对外部客户端提供本地强一致读。3 个副本的 CRAQ 链条即可提供 3 倍于单机网卡的读吞吐,随副本数增加实现真正的读吞吐水平线性扩展。
- 网络 RTT 与实现开销:
- Raft 需要多轮投票与多数派心跳应答,逻辑复杂且元数据状态机较重;
- CRAQ 的数据流动是纯粹的单向流水线,非常天然地契合 RDMA Write 零拷贝网络传输,中间节点无需复杂的选举协商,尾延迟极其稳定可控。
Q3: 为什么说 FUSE 文件系统在大模型训练读取数据集场景下是“性能毒药”?
Ringi 考官拆解与满分回答:- 频繁的用户态-内核态上下文切换:
- 应用程序调用
read()陷入内核 VFS; - 内核
/dev/fuse驱动将请求放入队列并挂起应用线程,唤醒用户态 FUSE 守护进程(Daemon); - FUSE Daemon 处理完后再次调用
write()送回内核; - 内核将数据唤醒并返回应用。
- 单次读取触发 4 次上下文切换,在每秒几十万次小样本读取时,CPU 时间全部浪费在模式切换(Context Switch)上。
- 应用程序调用
- 多重内存拷贝(memcpy 开销):
- 数据从网卡到 FUSE 内存,再拷贝到内核 Page Cache,再拷贝到应用缓冲区,经历多次内存复制。在 400Gbps 高速网络下,Host 内存总线带宽被无谓占满。
- 全局锁与并发瓶颈:
- Linux 内核的
/dev/fuse设备在处理并发请求时受限于内部自旋锁和队列锁,多线程并发吞吐无法随 CPU 核心数线性提升。
- Linux 内核的
- AI 原生解法:采用类似于 3FS 的 Kernel-Bypass Native 客户端(共享大内存环形队列)或直接使用预先打包的内存映射文件(
mmap)。
Q4: 如何在 Kubernetes 调度层与网络层保障存储突发写流量不冲击在跑任务的 NCCL 通信?
Ringi 考官拆解与满分回答:- 物理网络双网隔离(Dual-Rail Network Topology):
- 生产集群在硬件规划时严格执行“算网分离”:每台 GPU 物理机配备 8 张专属计算网卡(接入计算 Leaf 交换机,专跑 NCCL 集合通信),额外配备 1~2 张专用存储网卡(接入存储/业务交换机,专跑 3FS/JuiceFS/S3 访问)。两套物理网络走独立的线缆与交换架构,物理级阻断冲击。
- RoCEv2 流量染色与 QoS 优先级调度(DiffServ / DSCP):
- 在必须共享物理端口的环境下,开启交换机 PFC(Priority Flow Control)。
- 将 NCCL 流量标记为最高优先级(如 DSCP 46 / EF,映射到 Priority 3);
- 将存储落地与读写流量标记为次高优先级(如 DSCP 26,映射到 Priority 4);
- 当存储发生突发拥塞时,交换机仅对 Priority 4 队列下发 Pause 帧,绝不波及计算专用的 Priority 3 队列,杜绝 NCCL 发生卡死重传。
- 客户端应用层限流与背压:
- 存储客户端配置固定滑动窗口(Sliding Window)与最大未完成 IO(In-Flight IO Limit),结合 Host Pinned Memory 异步流水线平滑出向流量,消除突发毛刺。