🏛️ 第37讲:从 cgroups 盲区到千万级异构拓扑调度——GPU 容器化底座、NVIDIA Container Toolkit 与 K8s Device Plugin / DRA 架构全栈解密
主讲人:👓 Ringi(大厂 AI Infrastructure 工程师)
所属模块:Module 06: 云原生 AI 平台与生产工程
篇章范式:☁️ 云原生 AI 平台、生产运维与系统设计篇(Cloud-Native AI Platform & System Design Paradigm)
核心导读:算法工程师往往以为“在 Dockerfile 里写一句FROM pytorch/pytorch,在 K8s 资源里填一个nvidia.com/gpu: 8”,GPU 就理所当然能在容器里飞驰。然而,Linux 原生的 Namespaces 和 cgroups 对 GPU 这类挂在 PCIe/NVLink 总线上的协处理器硬件存在天然的“物理盲区”;Kubernetes 传统的 Device Plugin 机制,更用一种极其幼稚的“整数标量计数法”将物理拓扑硬生生割裂成信息黑洞,甚至酿成跨 NUMA、跨 PCIe Switch 乱分配卡导致 AllReduce 吞吐暴跌 90% 的生产灾难!本讲将带你并肩拆开机器,从 Linux 内核字符设备、动态链接库注入、OCI Prestart Hook 拦截器一路深潜到 Kubelet gRPC 状态机与下一代 Kubernetes DRA(Dynamic Resource Allocation)结构化参数体系,彻底打通云原生 AI 算力底座的血脉。
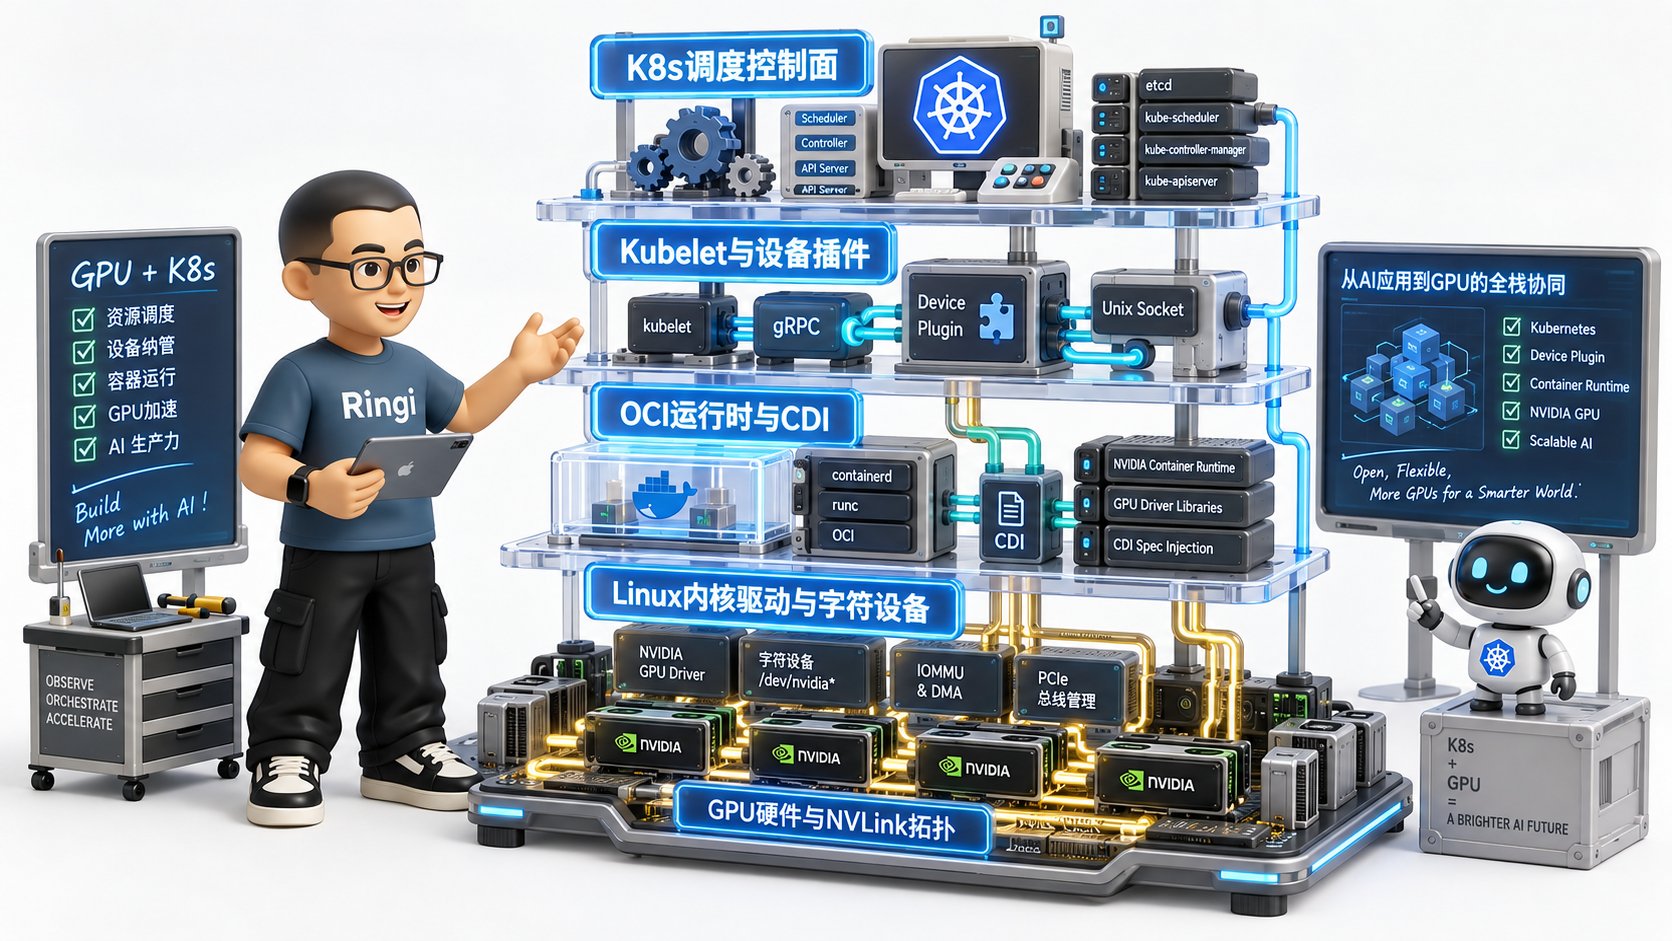
📑 目录导航
- 0. Ringi 开场:生产真实现场与痛点冲突
- 1. Linux 容器隔离机制的天然物理盲区与 GPU 硬件特异性
- 2. NVIDIA 容器运行时全栈演进与底层挂载机制
- 3. Kubernetes Device Plugin 架构第一性原理与生命周期状态机
- 4. 走向下一代架构:Kubernetes 动态资源分配(DRA, Dynamic Resource Allocation)
- 5. 生产级进阶:GPU 资源暴露、健康检查与 Xid 故障熔断
- 6. 动手实战与代码实验室(Minimal Runnable Code)
- 7. Ringi 避坑指南与生产黄金准则
- 8. Ringi 5 点核心速记口诀、自我检验清单与课后深度思考题
- 9. 📚 参考资料与核心源码/经典论文指引
- 附录:Appendix A — 大厂硬核高频面试题与白板推导
0. Ringi 开场:生产真实现场与痛点冲突
0.1 真实工程矛盾:为什么 docker run 裸容器看不到 GPU?
在刚接触大模型基础设施时,几乎每一个工程师都会经历这样一段令人费解的困惑:
你在宿主机上安装好了 NVIDIA 显卡驱动,敲下 nvidia-smi,8 张崭新的 H100 SXM5 显卡整整齐齐地亮着,功耗、温度、显存一切正常。接着,你信心满满地拉取了一个官方的 Ubuntu 镜像,启动了一个最基础的 Docker 容器:
nvidia-smi,终端直接给你泼了一盆冷水:
True,而是一个冷酷无情的字眼:
甚至有人尝试在 Dockerfile 里写下
RUN apt-get install -y nvidia-driver-535,试图在容器里“重新安装一遍显卡驱动”——结果要么构建直接报错退出,要么镜像体积飙到几十个 GB,启动依然报错。
为什么?因为大家把“容器”当成了“虚拟机(VM)”。在虚拟化世界里,Hypervisor 可以通过 PCIe 直通(PCIe Passthrough)或 SR-IOV 把物理硬件直接塞给虚拟机内部独立的操作系统内核。
但容器不是虚拟机!容器的本质,只是一组共享宿主机同一个 Linux 内核的隔离进程! Linux 原生内核的隔离武器是 Namespaces(隔离视野)和 cgroups(限制资源)。但这两把武器在设计之初,骨子里只有 CPU 时间片、物理内存页、网络栈和磁盘块设备。它们面对插在 PCIe 总线上的 GPU 加速卡时,在物理层面上根本就是“瞎”的!
0.2 线上真实事故复盘:一次千卡预训练集群的“NVLink 拓扑碎裂与性能雪崩”
更致命的冲突发生在 Kubernetes 集群的生产现场。 在某头部大厂千卡分布式预训练集群投产初期,我们曾遭遇过一次轰动整个技术部的“吞吐腰斩惨案”: 当时团队正在调度一个 70B 大模型的预训练任务,采用TP=8(张量并行 Tensor Parallelism 为 8,即单机内 8 张卡必须在每个 Transformer Block 中进行两次高频的 AllReduce 同步通信)。机型为标准的 8 卡 HGX H800 服务器。
任务提交给 Kubernetes 后,调度器看着节点容量 Allocatable: nvidia.com/gpu: 8,迅速调度成功,8 个 Pod 顺利拉起。然而,当监控大盘点亮时,所有人惊呆了:
- 正常的单步迭代时间(Iteration Time)应该稳定在 1.6 秒左右,模型算力利用率(MFU)应该达到 62%;
- 但实测单步时间直接飙升至 14.8 秒,MFU 断崖式跌落到 7.8%!
- 查看 PyTorch Profiler,算子计算(GEMM)耗时几乎没变,但
ncclKernel_AllReduce_RING_LL通信耗时从单步 180ms 狂飙到了惊人的 12,400ms!
原来,平台刚上线了一套任务混部逻辑。在此之前,节点上已经跑了一个占用了 2 张卡的小任务。当时 Kubelet Device Plugin 盲目地将
GPU2, GPU3 分配给了小任务。当 8 卡大模型任务申请 8 张卡时,节点上虽然还有 6 张本地卡,调度器没选它;但在另一个同样被碎片化占用的节点上,Kubelet 分配了非连续的
GPU0, GPU1, GPU4, GPU5 给一个 4 卡任务……而在出事故的这台 8 卡完整节点上,由于硬件维保更换了主板模块,8 张卡被物理切分成了两个通过 CPU 慢速总线(SYS)连接的独立的 4 卡环!
Kubernetes 官方原生的 Device Plugin 只有一个极其原始的机制:它只向 API Server 汇报一个数字——nvidia.com/gpu: 8!在 Kubernetes 调度器(Kube-scheduler)的脑子里,这 8 张卡和 8 个 CPU 核心、8 GB 内存没有任何区别,它们被视作完全均质、完全无拓扑关联的“纯整数(Integer Scalar)”。
调度器根本不知道:
- 哪些卡之间连着 900 GB/s 的 NVLink,哪些卡之间跨越了 NUMA 节点,走的是带宽只有 32 GB/s 的 PCIe;
- 哪个 GPU 旁边挂着那块直连的 400 Gbps CX7 InfiniBand 网卡(GPUDirect RDMA 依赖此拓扑);
- 分配给容器的设备 ID 到底是物理上的哪几张卡。
0.3 AI Infra 各层级映射全景速查表
在深入底层代码之前,我们先把从应用层import torch 一路穿透到物理硬件的完整全栈映射建立起来。这也是每一位大厂 AI Infra 工程师脑中的“全景地图”:
1. Linux 容器隔离机制的天然物理盲区与 GPU 硬件特异性
💡 架构全景速览:在深潜源码前,先在白板上建立坚不可摧的 GPU 容器化、Device Plugin 与 DRA 调度体系物理底账。

1.1 Namespaces 与 Cgroups 的“CPU/Memory 偏见”
为了真正理解 GPU 容器化,我们必须回答 Ringi 工程师五问中的第一问:在操作系统内核眼中,GPU 到底是什么? 在 Linux 传统的进程隔离体系中,容器仅仅是一个被轻度隔离的普通进程:- Namespaces(命名空间):决定了这个进程“能看到什么”。
pid让你看不到别人的进程,net让你拥有独立的虚拟网卡,mnt让你拥有独立的根文件系统视图。 - cgroups(控制组):决定了这个进程“能消耗多少资源”。通过 CFS 调度器周期记账来限制 CPU 配额,通过页表扫描和缺页异常记账来限制物理内存(RSS + Page Cache)上限。
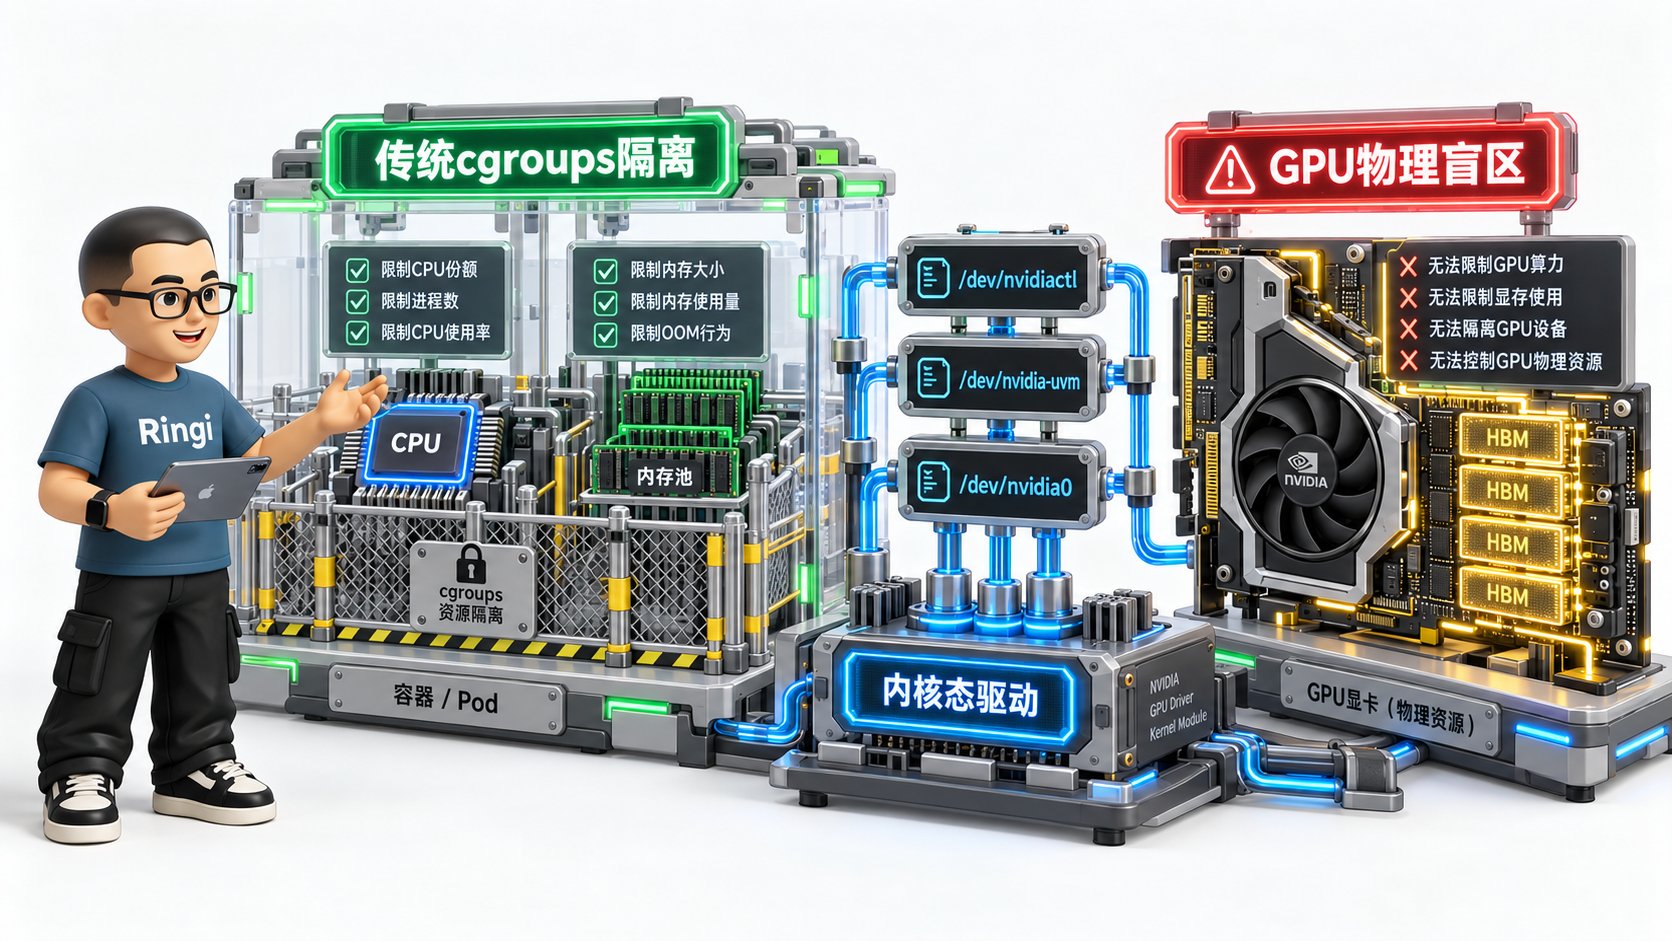
brk 或 mmap 系统调用,物理内存由 Linux 内核的伙伴系统(Buddy System)分配物理页,受到 cgroups memory.max 的严格限制。一旦超标,内核直接触发 OOM Killer 杀掉进程。
但当你在 PyTorch 里调用 torch.cuda.FloatTensor(1024, 1024, 1024) 时,底层发生了什么?
- PyTorch 调用
libcuda.so中的cuMemAlloc(); - 用户态驱动通过系统调用
ioctl(fd, NVIDIA_IOCTL_MEM_ALLOC, &args)发送指令给/dev/nvidia0设备文件; - Linux 内核接收到这个
ioctl后,直接把它透传给闭源的内核模块nvidia.ko; nvidia.ko操作 GPU 卡上的显存控制器,在 GPU 物理 HBM 颗粒上划分出一块地址空间,返回一个虚拟地址句柄给用户态;- 在整个过程中,宿主机 Linux 内核自身的物理内存用量完全没有增加(增加的只有微不足道的几 KB 描述符结构体),Linux cgroups 内存控制器全程处于完全失准的状态!
/dev/nvidia0 通过 --device 挂进一个普通容器,容器内的代码可以瞬间吃满整张卡 80GB 的显存,而设置在容器上的 --memory 4g 根本毫无反应!
1.2 GPU 设备文件家族解剖:/dev/nvidia* 字符设备的内核职责
ls -la /dev/nvidia*,你会看到以下这组典型的设备节点:
1. /dev/nvidia[0-7](单卡实例设备)
- 主设备号(Major):
195。次设备号(Minor):对应 GPU 物理索引0 ~ N-1。 - 职责:每一张物理卡或每一个独立的 MIG 实例对应一个字符设备。这是用户态程序与特定物理 GPU 通信的主通道。CUDA Context 的建立、命令队列的下发、显存分配的
ioctl指令,全部发向该设备。
2. /dev/nvidiactl(全局控制管理设备)
- 主设备号:
195。次设备号:255。 - 职责:全局控制器。当用户态程序(如
nvidia-smi或 PyTorch 初始化)首次启动时,必须先打开/dev/nvidiactl,查询当前系统挂载了多少张卡、每张卡的 UUID 是什么、驱动版本是多少。如果容器漏挂了这个文件,CUDA 初始化会直接报Failed to initialize NVML / Driver initialization error。
3. /dev/nvidia-uvm(统一虚拟内存设备)
- 主设备号:通常为动态分配的数字(如
235或240等)。 - 职责:Unified Virtual Memory(UVM)内核驱动设备。负责处理 CPU 内存与 GPU 显存之间的统一寻址空间管理、零拷贝内存映射(Zero-Copy Memory)、以及跨总线的缺页中断换页(Page Fault Handling)。现代大模型训练框架中大量使用 Managed Memory,必须挂载该设备。
4. /dev/nvidia-uvm-tools(UVM 调试与性能探针设备)
- 职责:专门用于 Nsight Systems、PyTorch Profiler 等性能分析工具抓取 UVM 换页事件与底层计数器。
5. /dev/nvidia-modeset(显示模式设置设备)
- 职责:在纯计算卡(如 H100、A100)上,它主要负责协助时钟频率调节与系统睡眠唤醒状态同步。
1.3 驱动用户态库与内核模块的“双生纠缠”
这就引出了容器化中最经典的一个面试题与工程难题:为什么我们不能直接把显卡驱动打包到 Docker 镜像里?
- 内核态驱动模块(Kernel Modules):包含
nvidia.ko、nvidia-uvm.ko等。它们运行在 CPU 的 Ring 0 特权级,必须与当前宿主机的 Linux 内核头文件(Kernel Headers)进行编译绑定,带有特定的Vermagic签名。容器没有特权加载内核模块,也不应该加载内核模块; - 用户态驱动库(User Space Driver Libraries):包含
libcuda.so(CUDA Driver API 实现)、libnvidia-ml.so(NVML 管理库)、libnvidia-ptxjitcompiler.so等。它们运行在 Ring 3,负责将上层的 CUDA Runtime API(libcudart.so)转换为向内核模块发送的二进制ioctl载荷。
535.129.03 的 libcuda.so 打进镜像,而宿主机的物理内核加载的是 525.85.12 的 nvidia.ko,当容器启动后,libcuda.so 向内核发起 ioctl 握手,内核发现 ABI 校验不匹配,会立即拒绝服务,抛出令无数工程师崩溃的错误:
容器镜像只能包含通用的应用程序和上层的 CUDA Runtime 库(
libcudart.so);而底层与内核对话的动态链接库(libcuda.so、libnvidia-ml.so 等)以及字符设备文件,必须且只能在容器启动的一瞬间,由宿主机的容器运行时工具链动态注入进去!
2. NVIDIA 容器运行时全栈演进与底层挂载机制
2.1 架构演进血泪史:从 nvidia-docker v1 到 CDI
搞清楚了容器不能打包驱动的原理,接下来就要解决:怎么把宿主机上的驱动库和设备安全、透明地挂进容器? 这一机制经历过四代极其漫长的工程演化:- 第一代(nvidia-docker v1):写了一个叫
nvidia-docker的命令行替代品,宿主机跑一个后台守护进程。通过docker volume的方式把宿主机驱动目录挂进容器。这种方案对于 Kubernetes 这种直接与 Docker Daemon 或 CRI 通信的编排系统完全不可用; - 第二代(nvidia-docker v2):实现了
nvidia-container-runtime,直接作为与runc平级的 OCI 运行时。Docker 需要配置default-runtime: nvidia。它直接修改了容器的 OCI 规范配置文件config.json; - 第三代(NVIDIA Container Toolkit,主流工业标准):放弃直接替代
runc,而是采用 OCI Prestart Hook 机制。容器运行时依然是标准的runc或crun。当容器根文件系统(RootFS)解压完成、容器进程启动之前,runc会主动调用配置好的 NVIDIA Hook 程序。Hook 会切换进目标容器的 Mount Namespace 和 Cgroups,完成设备节点的创建(mknod)和动态库的mount --bind; - 第四代(CDI, Container Device Interface):云原生设备接口规范,由 CNCF 推动(类似 CNI 和 CSI)。不再依赖 Hook 这种具有副作用的黑魔法脚本,而是使用标准 JSON 文件清晰声明容器需要的环境、挂载点和设备节点。
2.2 全栈控制流穿透:libnvidia-container 与 OCI Hook 底层流水线
在今天主流的大厂 Kubernetes 节点上,容器运行时大多基于containerd。我们来精确追踪一个带有 GPU 请求的 Pod 启动时,底层经历的秒级执行流:
ldd /usr/local/cuda/lib64/libcudart.so,它就能动态解析到位于 /usr/lib/x86_64-linux-gnu/libcuda.so.1——因为底层有一只无形的手(libnvidia-container),在容器进程出生的前一毫秒,将宿主机的文件精准地插进了容器的文件树中!
2.3 环境变量控制黑魔法:NVIDIA_VISIBLE_DEVICES 与 Capabilities
在日常开发和 Kubernetes Pod YAML 中,我们经常看到这两个环境变量:
NVIDIA_VISIBLE_DEVICESNVIDIA_DRIVER_CAPABILITIES
1. NVIDIA_VISIBLE_DEVICES:控制设备白名单
该环境变量告诉 Hook 该给这个容器暴露哪几张卡:
all:暴露节点上探测到的全部 GPU;0,1或1,3:按物理索引暴露特定卡;GPU-f5c7116e-8260-4966-ba4a-xxxx:按 GPU 的全局唯一 UUID 暴露(生产推荐!因为物理索引号在热插拔或驱动重载时可能发生漂移);void或none:不暴露任何 GPU,禁用所有 NVIDIA 驱动注入。
devices cgroup 写入该设备号的白名单。其他卡即使通过路径猜测也无法执行任何 open 操作,从而实现硬件隔离。
2. NVIDIA_DRIVER_CAPABILITIES:控制驱动功能切片
这个变量极其关键!它决定了 Hook 究竟把宿主机上的哪些动态链接库挂进容器。常见的取值组合如下:
在生产级 AI 容器中,推荐的标准配置为:
2.4 CDI(Container Device Interface)规范深度解密
尽管 OCI Prestart Hook 方案支撑了过去数年的云原生 AI 发展,但它存在一个严重的工程缺陷:黑盒与强耦合。Hook 是一个外部可执行程序,一旦它执行崩溃、挂起,容器创建就会直接陷入未知状态;而且容器运行时对 Hook 到底修改了什么一无所知。 为了终结这种混乱,CNCF 推出了 CDI(Container Device Interface)规范。
CDI 的核心思想是:以声明式的纯 JSON / YAML 静态文件替代动态 Hook 脚本! 在安装了最新版
nvidia-container-toolkit 的节点上,执行:
容器运行时(如 containerd 1.7+、CRI-O)在拉起容器时,原生理解 CDI 规范。Kubelet 只需告诉运行时:“请挂载设备
nvidia.com/gpu=0”。containerd 直接在内核层面读取对应的 deviceNodes 和 mounts 执行标准配置,全程没有任何第三方外挂 Hook 脚本参与! 这大幅提升了高并发启动千卡容器时的稳定性和可观测性。
3. Kubernetes Device Plugin 架构第一性原理与生命周期状态机
3.1 Device Plugin 核心架构与 Unix Domain Socket 通信网络
当单机层面的设备注入被NVIDIA Container Toolkit 解决后,问题来到了集群层面:Kubernetes 调度器如何知道一台节点上有几张 GPU?Kubelet 如何决定把哪张 GPU 分配给哪个 Pod? 这就是
Kubernetes Device Plugin 框架的使命。它的设计哲学非常干净:通过 gRPC over Unix Domain Socket(UDS),将特定硬件厂商的设备探测逻辑与 Kubelet 核心解耦。
核心设计规范
- 通信介质:所有的 gRPC 通信均建立在节点本地的 Unix Domain Socket 上(默认路径
/var/lib/kubelet/device-plugins/),杜绝跨网络的非必要安全开销与延迟; - 注册时序:
- Kubelet 启动,并在
/var/lib/kubelet/device-plugins/kubelet.sock开启Registration服务; - 作为 DaemonSet 运行的
nvidia-device-plugin启动,在同目录下创建自己的 Socket(如nvidia-gpu.sock); - Plugin 主动连接
kubelet.sock,发起Register(ResourceName="nvidia.com/gpu"); - Kubelet 验证通过后,反向建立到
nvidia-gpu.sock的长连接通道。
- Kubelet 启动,并在
3.2 gRPC 协议三核心方法深度解剖:Options、ListAndWatch 与 Allocate
根据 Kubernetes 官方规范(k8s.io/kubelet/pkg/apis/deviceplugin/v1beta1),一个合法的 Device Plugin 必须实现以下 protobuf 定义的接口:
1. GetDevicePluginOptions(能力协商)
PreStartContainer 设备重置?”或者“我是否支持拓扑分配偏好协商?”
2. ListAndWatch(心跳与健康状态机)
这是一个 Server Streaming RPC(服务端流式推送接口)。
- 一旦建立连接,Device Plugin 必须立即推送当前节点上所有的设备 ID 及其健康状态(
Healthy或Unhealthy); - 此后,该 gRPC 连接必须永久保持不断开。Device Plugin 内部启动一个监控协程(通过 NVML 轮询或事件监听)。只要某张卡发生硬件故障(如掉卡、温度过载),插件立即顺着这个 Stream 向 Kubelet 推送一条更新消息;
- Kubelet 的动作:Kubelet 收到设备列表后,将其数量统计汇总,更新到 Node 对象的
status.capacity["nvidia.com/gpu"]和status.allocatable["nvidia.com/gpu"]中。
3. Allocate(运行态设备绑定翻译器)
当 Kubernetes 调度器把一个申请了 GPU 的 Pod 绑定到当前节点后,Kubelet 开始创建 Pod。在容器启动前,Kubelet 检查本地的设备分配记录本,挑选出可用的设备 ID(例如 ["GPU-0"]),然后调用插件的 Allocate 接口:
Allocate 中做的事情极其干脆:它把传入的设备 UUID 拼成一个逗号分隔的字符串,然后填入返回体的
envs["NVIDIA_VISIBLE_DEVICES"] = "GPU-xxx,GPU-yyy",或者填入 cdi_devices。随后,Kubelet 会将这些配置合并到 CRI 请求中发给 containerd!
3.3 容器设备分配端到端数据流与状态机时序图
让我们把所有环节串联起来,观察一个申请了resources.limits["nvidia.com/gpu"]: 2 的 Pod 从提交到运行的端到端完整时序:
3.4 Device Plugin 的“三大致命硬伤”
尽管 Device Plugin 构成了过去数年云原生 GPU 管理的基石,但在大规模 AI 集群生产实践中,它暴露出了三个无法通过局部打补丁解决的致命物理硬伤: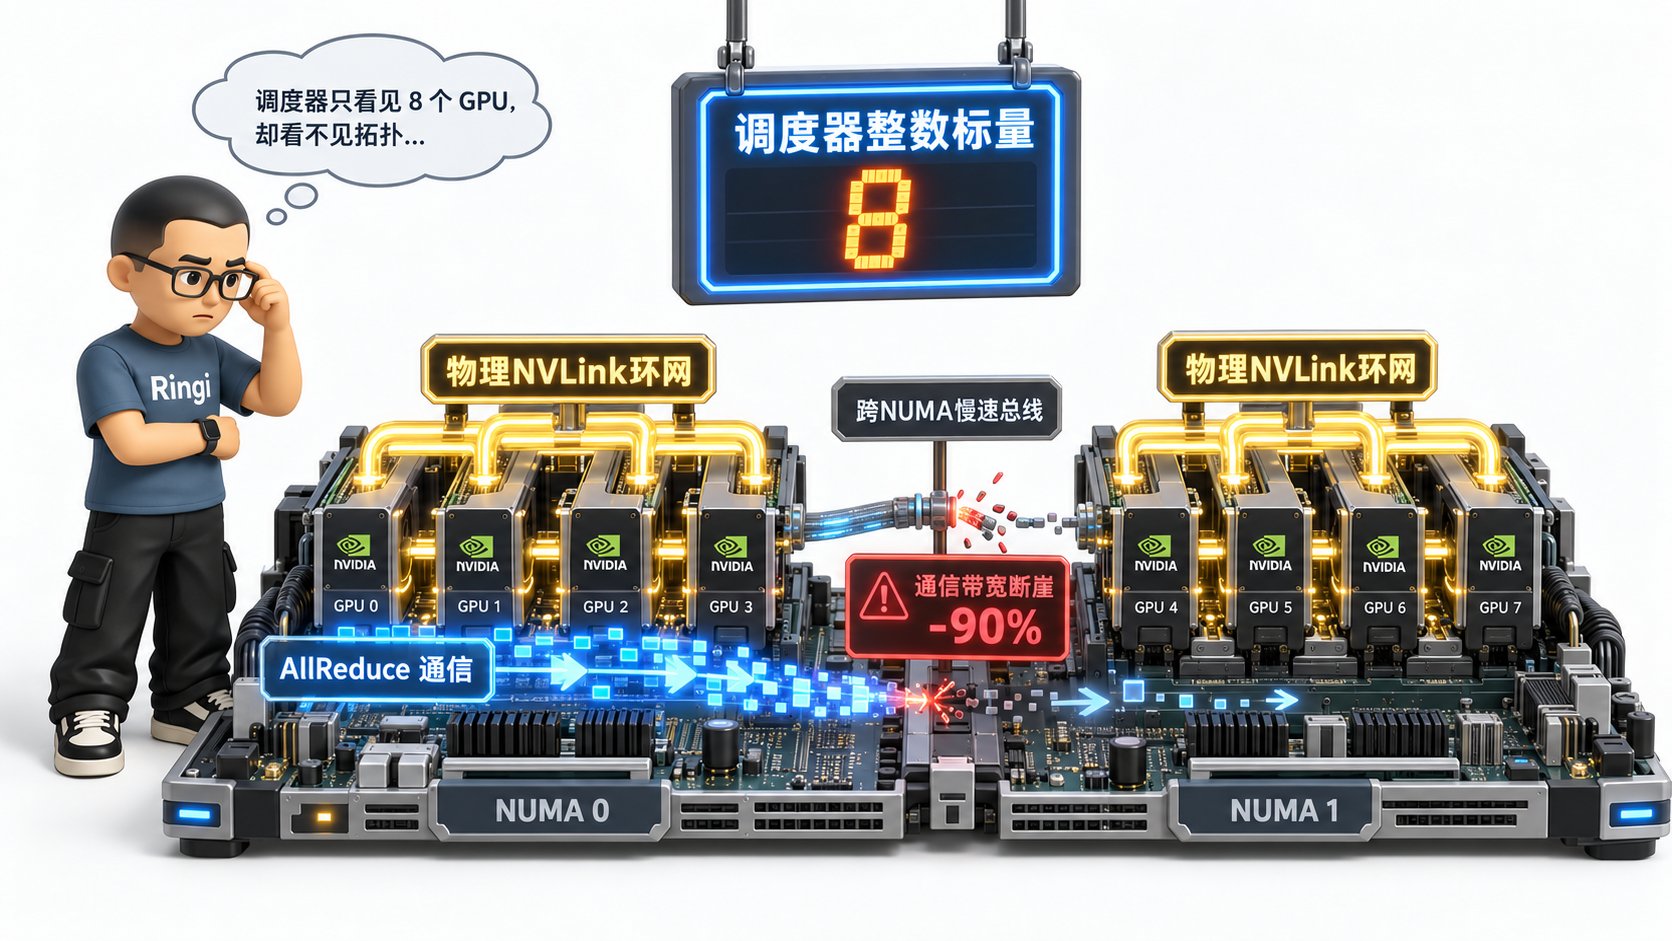
硬伤 1:纯整数标量(Integer Scalar Resource)
在 Kubernetes 核心资源模型中,扩展资源(Extended Resources)必须是整数,且不能超卖(Non-overcommit)。你无法在 Pod 规范中声明
nvidia.com/gpu: 0.2(申请 20% 算力或 16GB 显存)。这直接导致在轻量级模型推理、开发调试 Notebook 场景下,大量的 GPU 显存被彻底浪费。虽然业界诞生了腾讯云 qGPU、阿里 cGPU、开源的 HAMi 等各种通过劫持 CUDA API(cudaMalloc)的用户态/内核态显存切分方案,但它们全部是“外挂式 hack”,在原生 K8s API 看来极其别扭且无法形成统一的调度标准。
硬伤 2:全局调度器(Kube-scheduler)的“拓扑失明”
Kube-scheduler 在决定把 Pod 放到哪个 Node 时,手头掌握的唯一信息就是:Allocatable - Requested >= Pod Request。真正的设备选择权,被延后到了 Pod 已经降落到宿主机之后、由 Kubelet 本地的 Device Manager 决定。
调度器没有拓扑图,单机 Kubelet 没有全局视野。
这就造成了我们在第 0.2 节复盘的灾难:调度器以为自己把任务调度到了一个有 8 张卡的节点上,结果这 8 张卡被 Kubelet 随意分配了没有 NVLink 互联的跨 NUMA 卡,千卡集群的通信性能瞬间毁于一旦。
硬伤 3:多异构设备联合绑定的不可达
大模型训练不仅需要 GPU,更需要配套的 InfiniBand / RoCE 高速网卡 以及对应的 本地 NUMA CPU 核心与内存通道。在现有的架构下,GPU 有 GPU Device Plugin,Mellanox 网卡有 RDMA Device Plugin,CPU 有 Kubelet CPU Manager。三个组件各管各的 Socket,彼此之间形同陌路。在分配时,网卡分到了 NUMA 0,GPU 却分到了 NUMA 1,数据必须跨越 CPU UPI 总线“跑马拉松”,无法实现现代高性能计算所必需的 GPUDirect RDMA(GDR) 零拷贝通信!
4. 走向下一代架构:Kubernetes 动态资源分配(DRA, Dynamic Resource Allocation)
4.1 为什么需要 DRA?从“计数器分配”到“属性申领”的范式转移
为了彻底根除 Device Plugin 的历史包袱,Kubernetes 社区从 1.26 引入、并在 1.30+ 引入结构化参数(Structured Parameters)重塑了硬件纳管体系——这就是 DRA(Dynamic Resource Allocation,KEP-3063)。 DRA 的核心思想可以类比为:把对计算硬件的管理,从“无脑的 Pod Resources 计数”,升级为类似于存储体系“PV / PVC”的声明式“申领(Claim)模型”!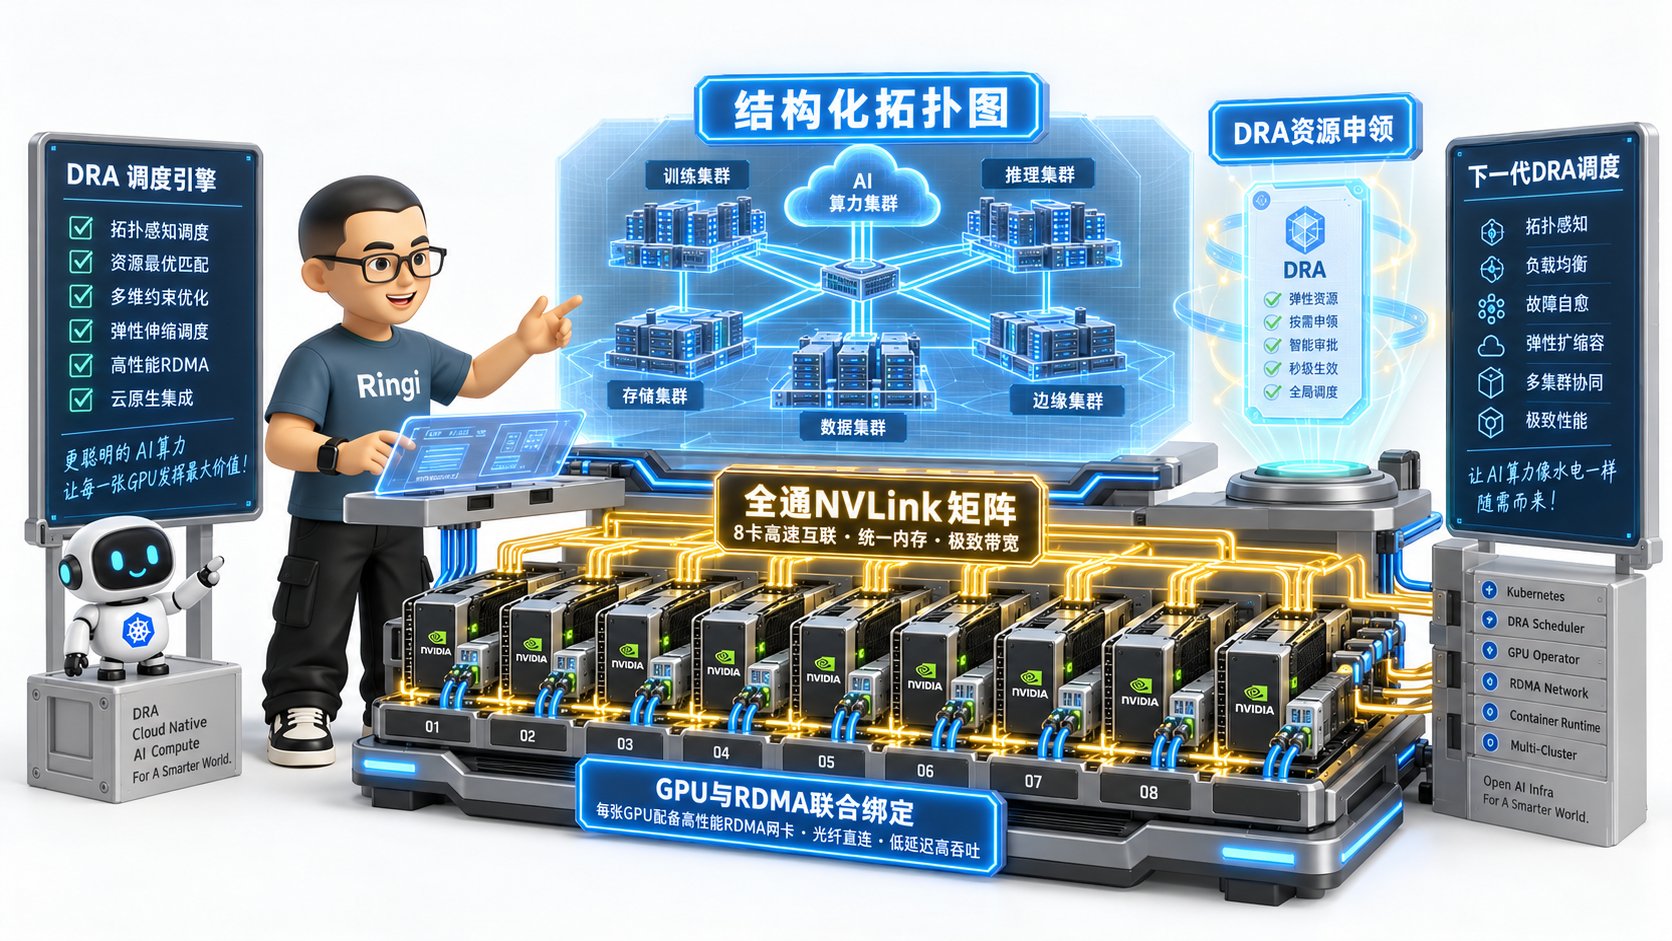
4.2 DRA 核心资源抽象四剑客:ResourceClass、Claim 与 Structured Parameters
DRA 在 Kubernetes API 中建立了一套极其严密的对象模型:1. DeviceClass(在早期版本为 ResourceClass)
定义某种设备大类,类似于存储的 StorageClass。由集群管理员预先创建:
2. ResourceClaimTemplate 与 ResourceClaim
定义用户的具体资源申领需求:
3. Structured Parameters(结构化参数)
在 Kubernetes 1.30+ 中,DRA 引入了结构化参数规范。硬件厂商的 DRA Driver 不再需要编写复杂的自定义调度器插件,而是直接使用通用的 CEL(Common Expression Language)表达式和预定义的拓扑约束,将硬件属性(如 PCIe Bus ID、NUMA Node、NVLink Mesh ID)直接发布到全局 API 对象中。4.3 DRA 控制流与调度器协同机制
我们来看 DRA 是如何彻底打破“调度器拓扑失明”困局的:在 DRA 体系下,选卡的决策权被直接收拢回了 Kube-scheduler(中央调度器)!
调度器不再是在黑暗中乱点鸳鸯谱,而是手中握着全集群所有 GPU 的物理互联拓扑地图,在调度阶段就敲定“分配 Node A 的 GPU 0,1,2,3,4,5,6,7”,从根本上消除了拓扑碎裂问题。
4.4 拓扑感知与多设备协同绑定实战
让我们来看一段生产级的 DRA 配置示例,看看它是如何优雅表达“GPU + RDMA 网卡 + NUMA”联合绑定的:4.5 Device Plugin vs CDI vs DRA 全维度对比矩阵
为了让大家在架构设计和技术选型时拥有清晰的依据,我们将三种技术的核心维度整理成标准表格:5. 生产级进阶:GPU 资源暴露、健康检查与 Xid 故障熔断
5.1 NVML 硬件健康检测机制与 ListAndWatch 故障上报
在千卡集群的残酷生产环境中,硬件故障不是“会不会发生”的问题,而是“每小时发生几次”的常态。 NVIDIA Device Plugin 的核心稳定器就是它的健康检查协程。在内部,它通过NVML(NVIDIA Management Library)与驱动保持轮询或事件监听:
Unhealthy 时:
- 它会在当前节点的
status.allocatable中减去这颗坏卡; - 但注意:Kubelet 绝不会主动驱逐当前正在这颗坏卡上运行的 Pod! 这一点在生产中极其危险,需要靠外部的自愈控制器来闭环。
5.2 致命 Xid 故障对 Device Plugin 的冲击与“静默黑洞”问题
在 GPU 运维史上,最令工程师闻风丧胆的当属 Linux Kernel 抛出的 Xid 错误码(通过dmesg -T 查看)。我们整理了最常见的生产级致命 Xid 速查表:
生产灾难:“静默黑洞(Silent Blackhole)”
这里必须揭露一个连很多资深运维都会踩坑的死穴:当发生 Xid 79(掉卡) 时,物理卡在 PCIe 配置空间上直接消失了。此时,如果 Device Plugin 尝试调用
nvmlDeviceGetHandleByUUID() 去查询健康状态,由于驱动底层的内核信号量死锁,NVML API 会直接陷入不可中断的睡眠态(D 状态)并永久阻塞(Hang 住)!
这导致什么后果?Device Plugin 整个进程直接假死,它的
ListAndWatch 连接中断。而 Kubelet 的逻辑是:“如果插件断开连接,在超时前保留最后的已知状态”。结果:Kubernetes 集群依然认为这 8 张卡是完好健康的!调度器继续把新的分布式训练任务疯狂派发给这台机器,所有投进来的任务瞬间报错退出,整个千卡集群的排队队列被这台“黑洞节点”快速吞噬烧毁!
5.3 故障快速自愈与节点打污点(Taint & Eviction)协同闭环
大厂的成熟 AI Infra 团队绝对不会单方面信任 Device Plugin 的健康状态上报,而是构建一套四层自愈防御纵深体系:6. 动手实战与代码实验室(Minimal Runnable Code)
本讲提供 4 个可以直接在本地或实验机器上运行的完整实战脚本,涵盖从 Device Plugin 模拟、容器环境诊断到物理拓扑检测与 CDI 生成。代码严格遵循完整可运行原则,无任何伪代码占位符。6.1 实战 1:纯 Python 手写符合 K8s 规范的 Mock GPU Device Plugin 服务端
为了彻底剥开 gRPC 与 Device Plugin 的技术黑盒,我们用 Python 编写一个完全遵循v1beta1 规范的 Mock GPU 插件服务端。该脚本启动一个 Unix Domain Socket 服务,能够响应注册并流式推送 4 张模拟的 GPU 设备状态:
6.2 实战 2:生产级容器内 GPU 运行时环境诊断与 Hook 注入验证脚本
在容器内遇到 GPU 异常时,不要盲目乱试。运行下面这个纯 Python 脚本,可以在 3 秒钟内精确定位是镜像缺库、Hook 注入丢失、还是设备权限不足:6.3 实战 3:GPU 物理拓扑侦测与 NVLink 互联矩阵提取工具
分布式训练前必须对物理节点的互联矩阵进行静态体检。下面这个 Python 脚本通过解析系统底层拓扑信息,自动生成带警告标记的 8 卡互联矩阵:6.4 实战 4:CDI 规范文件自动生成与 containerd 容器手动注入验证
下面给出在大厂生产节点上,如何使用nvidia-ctk 一键生成标准 CDI 配置,并在 containerd 环境中手动使用 crictl 进行无 Hook 设备注入的完整生产级操作脚本:
7. Ringi 避坑指南与生产黄金准则
7.1 避坑表格(❌ 常见小白错误理解 vs ✅ 大厂 AI Infra 正确理解)
7.2 生产环境 GPU 容器化与 Device Plugin 黄金 Checklist
在将任何一台 GPU 计算节点接入生产 Kubernetes 集群前,AI Infra 工程师必须严格逐项核对以下黄金检查清单:- 1. 【内核与驱动对齐】:确认宿主机驱动版本满足大模型框架最低要求,执行
nvidia-smi验证无Driver/library version mismatch。 - 2. 【持久化守护进程】:开启 NVIDIA Persistence Daemon(
nvidia-smi -pm 1),防止无计算任务时驱动频繁卸载导致的容器启动冷时延。 - 3. 【Container Toolkit 模式】:确认 containerd 已配置
nvidia-container-runtime或已正确配置 CDI 规范路径(/etc/cdi)。 - 4. 【UDS Socket 目录权限】:检查
/var/lib/kubelet/device-plugins/目录属主为 root,文件系统权限为0755,确保 gRPC 通信通畅。 - 5. 【UUID 模式强制启用】:在 Device Plugin DaemonSet 启动参数中,强制开启
--device-id-strategy=uuid,杜绝使用不可靠的连续整数索引。 - 6. 【拓扑信息静态打标】:在尚未全面落地 DRA 的集群中,通过 Node Feature Discovery(NFD)将节点的 GPU 拓扑(如
nvlink-connected=true、numa-nodes=2)打成 Node Label。 - 7. 【熔断探针联动】:部署基于 eBPF 或
dmesg的 Xid 故障监听 Agent,保证在发生 Xid 79/61 时 3 秒内完成节点打污点(Taint)。 - 8. 【UVM 模块开机自启】:确保
/dev/nvidia-uvm设备节点在开机时通过nvidia-modprobe -u -c=0正确初始化并赋予0666权限。 - 9. 【不可中断监控防挂死】:针对采集 NVML 状态的监控程序(如 DCGM-Exporter)设置合理的客户端超时(如 5 秒),严禁无限阻塞。
- 10. 【驱动能力白名单固化】:生产基础镜像中默认注入
NVIDIA_DRIVER_CAPABILITIES=compute,utility,非图形场景严禁随意下发all。
8. Ringi 5 点核心速记口诀、自我检验清单与课后深度思考题
8.1 5 点押韵核心速记口诀
8.2 10 条白板自我检验清单
你可以合上文章,在一张白板上自问自答以下 10 个硬核细节。如果每一条都能脱口而出,说明你已经真正吃透了这套体系:- 为什么用
docker run -v /dev/nvidia0:/dev/nvidia0启动容器,依然无法在 PyTorch 中使用这颗 GPU?(提示:缺了哪些字符设备与用户态驱动库?) nvidia-container-toolkit的 OCI Prestart Hook 是在容器进程启动前执行还是启动后执行?它依赖哪个 Linux Namespace 技术进入容器?- 容器环境变量
NVIDIA_VISIBLE_DEVICES是被谁读取并解析的?如果设为void会发生什么? - Kubernetes Device Plugin 是通过什么网络协议、哪种 IPC 通信方式与 Kubelet 对话的?Socket 默认放在哪个目录?
ListAndWatch接口为什么必须采用 gRPC Stream 而不是普通的 HTTP 轮询?- 在 Device Plugin 架构下,Kubelet 调用
Allocate返回配置后,是由 Device Plugin 亲自去mount文件,还是由别人完成?谁来完成? - 为什么原生的 Kubernetes 调度器无法感知 GPU 的 NVLink 拓扑?调度器眼中的
nvidia.com/gpu到底是什么? - 什么是 CDI?相比传统的 OCI Hook,CDI 带来了哪些架构优势?
- 什么是 DRA?DRA 的
ResourceClaim与传统 Pod 的resources.limits有何物理模型上的本质区别? - 当物理卡发生 Xid 79 掉卡时,为什么传统的 Device Plugin 可能会使该节点沦为“吞噬任务的静默黑洞”?
8.3 3 道高阶开放式课后思考题(含极限 Corner Case)
思考题 1:热插拔与设备漂移的极端并发竞争
在公有云裸金属 GPU 节点上,某块 H100 显卡因供电过载触发硬件自愈热重置(PCIe Reset),PCIe 总线地址短暂断开 200ms 后重新挂载。此时,Kubelet、NVIDIA Device Plugin 以及正在运行中的容器分别会感知到什么现象?如果你是平台架构师,你如何设计一套无感自愈或任务排队重建机制,防止后续进入该节点的新任务全部 Crash?思考题 2:如何用现有 Device Plugin 实现“伪拓扑感知”调度?
在 Kubernetes 集群尚未升级到全面支持 DRA 的版本(如仍运行在 K8s 1.25)之前,大模型预训练团队必须保证“8 卡任务必须独占完整的 NVLink 节点,4 卡任务必须分配同属一个 NUMA 节点的卡”。在不修改 Kubernetes 核心源码的前提下,你可以利用哪些原生调度器特性(Node Labels, Extended Resources, Webhook Mutating 等)拼装出一套生产级拓扑感知分配方案?其极限边界在哪里?思考题 3:GPU 算力切分与 DRA 结构化参数的融合
假设你现在要设计一套支撑上千名算法工程师共享使用 GPU 资源的开发测试平台,要求支持“申请 0.25 张卡 + 20GB 显存”的细粒度申领。结合 DRA 的 Structured Parameters(KEP-3063)与底层的切分技术(如 NVIDIA MIG 或 CUDA API 拦截),你将如何定义DeviceClass、ResourceSlice 以及对应的 DRA 驱动?请画出其完整的 API 数据流。
9. 📚 参考资料与核心源码/经典论文指引
在撰写本讲与进行系统级溯源时,本文严格对照并引用了以下一手权威工程源码与学术文献:- NVIDIA 官方开源代码库:
NVIDIA Container Toolkit核心源码仓库:https://github.com/NVIDIA/nvidia-container-toolkitNVIDIA K8s Device Plugin生产级源码:https://github.com/NVIDIA/k8s-device-pluginlibnvidia-containerC 语言底层实现:https://github.com/NVIDIA/libnvidia-container
- Kubernetes 官方规范与 KEP 增强提案:
- Kubernetes Device Plugin 框架官方文档:
https://kubernetes.io/docs/concepts/extend-kubernetes/compute-storage-net/device-plugins/ - KEP-3063: Dynamic Resource Allocation (DRA) 官方增强提案:
https://github.com/kubernetes/enhancements/tree/master/keps/sig-node/3063-dynamic-resource-allocation - Container Device Interface (CDI) 官方标准规范:
https://github.com/container-orchestrated-devices/container-device-interface
- Kubernetes Device Plugin 框架官方文档:
- 本地 AI_BOOK 知识库精准检索对照:
AI_BOOK/AI-fundamentals/04_cloud_native_ai_platform/k8s/01_nvidia_container_toolkit_analysis.md(深入剖析 Container Toolkit 运行栈)AI_BOOK/AI-fundamentals/04_cloud_native_ai_platform/k8s/02_nvidia_k8s_device_plugin_analysis.md(Device Plugin gRPC 源码深度解析)AI_BOOK/AI-fundamentals/04_cloud_native_ai_platform/gpu_manager/01_basic_theory.md(GPU 异构算力纳管与虚拟化切分理论)AI_BOOK/AI-fundamentals/04_cloud_native_ai_platform/gpu_manager/03_resource_management.md(DRA、MIG 与 GPU 显存调度全景)
附录:Appendix A — 大厂硬核高频面试题与白板推导
面试题 1:为什么不能直接把 NVIDIA 显卡驱动打包在容器 Dockerfile 镜像里?
考察维度:对 Linux 内核与驱动架构物理分层的理解深度、OCI 容器本质与系统调用边界。标准解题思路与满分回答路径:
- 明确系统物理分层:NVIDIA 显卡驱动严格分为 内核态模块(
nvidia.ko等) 与 用户态库(libcuda.so等); - 指出不可行性:
- 容器本质是宿主机上的隔离进程,共享同一个 Linux 内核。内核模块必须在宿主机启动时通过
insmod加载到 Ring 0,且强绑定宿主机的内核头文件与版本签名(Vermagic)。容器没有权限、也不应该重新加载内核模块; - 用户态驱动库与内核态驱动模块之间通过高度专有的二进制 ABI 协议通信。如果镜像内打包的用户态库版本(如 535)与宿主机内核模块版本(如 525)不完全一致,
ioctl握手时会直接校验失败,报出经典的Driver/library version mismatch错误;
- 容器本质是宿主机上的隔离进程,共享同一个 Linux 内核。内核模块必须在宿主机启动时通过
- 给出工业标准方案:镜像内只打包业务应用与通用的 CUDA Runtime 库(
libcudart.so),用户态驱动 API 库和字符设备文件由宿主机的容器运行时(NVIDIA Container Toolkit / CDI)在容器启动时动态 bind mount 挂载注入。
面试题 2:Kubelet 调用 Device Plugin 的 Allocate 接口后,底层到底经历了哪些步骤才把 GPU 挂载进容器?
考察维度:全链路数据流穿透能力。从 Kubelet、CRI、OCI Runtime 到 Linux 内核字符设备与命名空间。标准解题思路与满分回答路径:
- Device Plugin 的职责边界:Device Plugin 收到 Kubelet 的
AllocateRequest(deviceIDs)后,仅仅是做参数翻译,将 UUID 组装成环境变量(NVIDIA_VISIBLE_DEVICES=GPU-xxx)或 CDI 结构体返回给 Kubelet; - Kubelet 与 CRI 交互:Kubelet 拿到这些环境变量与注解,连同 Pod 原始配置拼装成 CRI 的
CreateContainerRequest,通过 UDS 发给containerd; - OCI 规范生成与 Hook 触发:
containerd根据请求生成标准的 OCI 规范文件config.json,其中包含了由 Toolkit 预先配置好的 OCI Prestart Hook;containerd调用runc create创建容器的 Namespaces 和 Cgroups 结构,并在进入真正的主进程前挂起;
- libnvidia-container 落地执行物理挂载:
runc触发 Prestart Hook,唤起nvidia-container-cli;- 核心 C 库以特权切入目标容器的 Mount Namespace 和 Devices Cgroup;
- 在容器内部执行
mknod创建对应的/dev/nvidia0、/dev/nvidiactl、/dev/nvidia-uvm字符设备,并将权限写入 cgroups 的devices.allow; - 将宿主机上的
libcuda.so、libnvidia-ml.so等动态链接库通过只读mount --bind挂入容器文件系统;
- 恢复执行:Hook 返回退出码 0,
runc start启动用户容器主进程,PyTorch 初始化成功。
面试题 3:Kubernetes 原生的 Device Plugin 为什么无法支撑好千卡大模型分布式训练?
考察维度:大规模分布式训练架构理解、GPU 物理拓扑感知、调度器架构缺陷。标准解题思路与满分回答路径:
- 整数标量失真:Device Plugin 将 GPU 抽象为均质的整数计数器(
nvidia.com/gpu: 8),完全忽略了卡间物理互联带宽的巨大非均质性(NVLink 900 GB/s vs PCIe 32 GB/s); - 调度器与分配器割裂(拓扑失明):
- 全局 Kube-scheduler 只负责数数(节点剩余卡数 >= 申请数),缺乏硬件拓扑图;
- 单机 Kubelet 在调用 Allocate 时只进行局部的贪心挑选,容易挑出跨 NUMA、跨 PCIe 树的非对称卡组合;
- 分布式通信雪崩:大模型训练的张量并行(TP)要求单机内每一步做极高频的 AllReduce。一旦卡间缺乏 NVLink 互联,通信带宽跌落一个数量级,导致整体 GPU MFU 从 60% 暴跌至 10% 以下,千卡集群算力被严重浪费;
- 异构联合绑定不可达:无法与 GPUDirect RDMA 所必需的 InfiniBand 网卡进行就近 NUMA 的协同图匹配;
- 演进出路:必须引入拓扑感知调度插件(如 Volcano / Scheduler Plugins),或全面走向下一代 Kubernetes DRA(动态资源分配)架构。
面试题 4:下一代 DRA(Dynamic Resource Allocation)是如何从根基上解决异构拓扑感知与资源共享难题的?
考察维度:对 Kubernetes 最新前沿架构(KEP-3063)的掌握深度、声明式 API 演进理解。标准解题思路与满分回答路径:
- 范式转变(从计数到申领):彻底废弃生硬的整数标量,引入类似 PVC 模型的
ResourceClaim,支持通过属性与参数进行多维声明; - 决策权统一收拢至调度器:
- 硬件厂商编写的 DRA 驱动将节点的物理拓扑图(PCIe Switch、NUMA、NVLink 互联矩阵)作为
ResourceSlice发布给集群; - Kube-scheduler 的 DRA 调度插件直接持有全集群的物理拓扑地图,在调度阶段就完成多维拓扑图匹配与打分,直接锁定最优秀的卡组合(如必须包含 NVLink Mesh ID 为 0 的 8 张卡);
- 硬件厂商编写的 DRA 驱动将节点的物理拓扑图(PCIe Switch、NUMA、NVLink 互联矩阵)作为
- 多资源协同联合求解:用户可以在同一个
ResourceClaim中同时申领 GPU 与 RDMA 网卡,并使用 CEL 表达式约束“网卡的 NUMA 必须等于 GPU 的 NUMA”,原生完美实现 GPUDirect RDMA 拓扑协同; - 与 CDI 原生融合:调度完成后由节点 DRA Agent 在本地生成无副作用的 CDI 规范,完全解耦旧版黑盒 OCI Hook,形成声明式、高性能的下一代云原生 AI 算力底座。