🏛️ 第36讲:为什么按平均 QPS 算集群上线必死?——大模型在线推理容量规划、SLO 治理与生产级故障排障全景实战
主讲人:👓 Ringi(大厂 AI Infrastructure 工程师)
所属模块:Module 05: LLM 在线推理系统与性能工程
篇章范式:🚀 LLM 推理服务与高性能 Serving 篇(Inference Serving & Systems Paradigm)
核心导读:在传统 Web 微服务时代,工程师习惯于拿“平均 QPS × 平均响应时间”掏出计算器估算微服务容器实例数,哪怕预留 20% 的 Buffer 也能平稳扛过早高峰。但在大模型在线推理(LLM Serving)的世界里,如果你胆敢拿着平均 QPS 去找采购申请 GPU 集群,上线当天你一定会经历职业生涯中最绝望的“全集群雪崩”——显存瞬时打满 OOM、Prefix Cache 遭遇长文本炸弹击穿、客户端因首字超时疯狂重试形成自残式踩踏、GPU 计算单元空转而排队队列堆积数万请求。为什么大模型推理的容量不是线性可加的?为什么吞吐量拉满反而意味着系统正在“自杀”?本讲将带你深入大模型在线生产真现场,彻底拆穿“伪容量规划”的谎言,从显存四账本与 Prefill/Decode 物理冲突的第一性原理出发,手算真实集群卡数算盘,建立以 Goodput 为核心的严苛 SLO 治理体系,并交给你一套经历过数十次线上实战淬炼的高可用排障 Runbook。
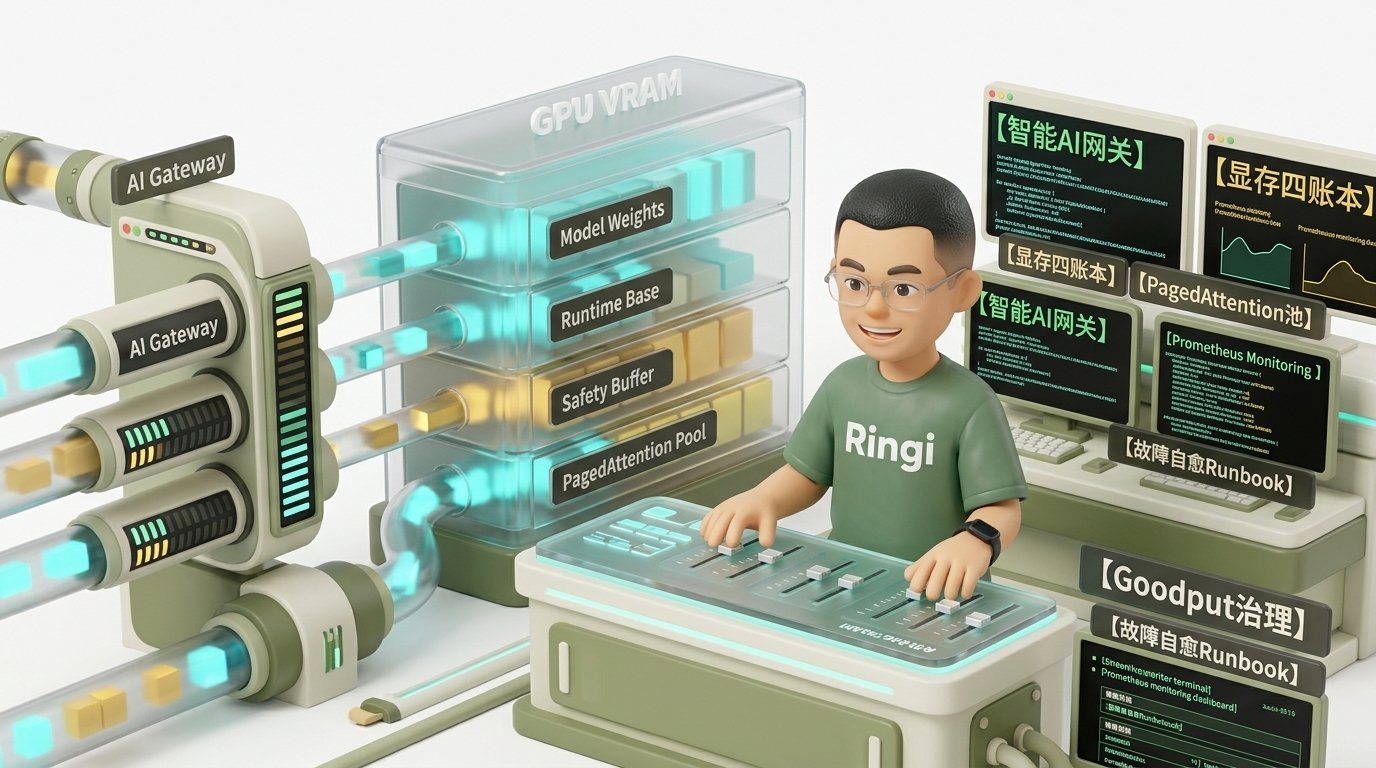
📑 目录导航
- 0. Ringi 开场:生产真实现场与痛点冲突
- 1. 第一性原理穿透:大模型在线推理的资源消耗方程与吞吐延迟权衡
- 2. 公式五步穿透:工业级 GPU 卡数与显存容量预测性规划模型
- 3. 核心 SLO 治理体系:从 Metrics 观测到 Goodput Pareto 边界
- 4. 智能路由与网关调度:把流量送到最懂它的 GPU 上
- 5. 现代 Serving 引擎内核配置与调优指南(vLLM / SGLang)
- 6. 生产级故障排障 Runbook:高频血泪事故诊断与解法
- 7. 动手实战与代码实验室(Minimal Runnable Code)
- 8. Ringi 避坑指南与生产黄金准则
- 9. Ringi 5 点核心速记口诀、自我检验清单与课后深度思考题
- 10. 📚 参考资料与核心源码/经典论文指引
- 附录:Appendix A — 大厂硬核高频面试题与白板推导(Interview Drill)
- 🎨 【配图工坊生图 Prompt 暂存区 · 生成配图后可一键整块删除】
0. Ringi 开场:生产真实现场与痛点冲突
0.1 真实工程矛盾:为什么按平均 QPS 规划卡数,上线当天直接被击穿?
作为一线 AI Infra 工程师,你大概率经历过或即将经历这样一场“悲剧”: 公司某核心业务(例如智能客服或研发 Copilot)准备全量接入最新的 72B 开源大模型。业务负责人拿着监控大盘找到你:“Ringi,我们目前业务的日均请求量是 86.4 万次,折算下来平均 QPS 只有 10。单次请求平均输入 1000 Tokens,输出 500 Tokens。按照每秒 10 个请求、单请求端到端 5 秒计算,并发池里平均也就 50 个请求。我们在测试机上一张卡压测单请求每秒能吐 40 个 Token,那是不是随随便便部署两台 8 卡机器(16 张 GPU)就能高枕无忧了?保守一点,我们给你批 3 台机器,够不够意思?” 如果你欣然点头,那么恭喜你,你正在亲手为自己的职业生涯埋下一颗“烈性核弹”。 上线当天上午 10:00,早高峰流量如约而至。监控大盘上的 QPS 甚至还没有突破 25,你的报警手机就已经被拨爆了:- 客户端狂报 504 Gateway Timeout:前端用户的流式文字卡在输入框里,转圈等待超过 15 秒没有任何反应;
- Prometheus 监控曲线呈现诡异断崖:系统总吞吐(Tokens/s)看似飙得极高,但业务侧的有效完结率(Completion Rate)暴跌到不足 30%;
- GPU 显存告警此起彼伏:部分推理节点触发 CUDA Out of Memory (OOM) 导致整个 Engine 进程被操作系统 OOM Killer 强行暴毙,K8s Pod 陷入 CrashLoopBackOff;
- 幸存节点的 GPU 利用率冰火两重天:有的节点 SM 利用率高达 95% 但都在疯狂重算被驱逐的 KV Cache;有的节点 HBM 显存吃得满满当当,算力单元却在旷工,排队队列(Waiting Queue)里堆积了 2000 多个请求动弹不得!
0.2 线上真实事故复盘:某头部代码助手在早高峰遭遇“长文本炸弹”与重试踩踏的 45 分钟雪崩
为了让你彻底看清这套崩溃传导链,我们复盘一次发生在大厂某知名研发协同平台的真实线上 P0 事故。事故拓扑与背景配置
- 模型:Qwen2.5-Coder-32B-Instruct(FP16 精度,单机 4 卡 H800 TP=4 部署,共 10 个推理 Pod,总计 40 张卡);
- Serving 框架:vLLM(版本当时启用 PagedAttention 与 Continuous Batching,未开启 Chunked Prefill,
gpu_memory_utilization=0.90); - 前置网关:标准 Nginx 轮询代理(Round-Robin),超时阈值设为 10 秒,前端客户端具备自动重试机制(默认失败重试 2 次)。
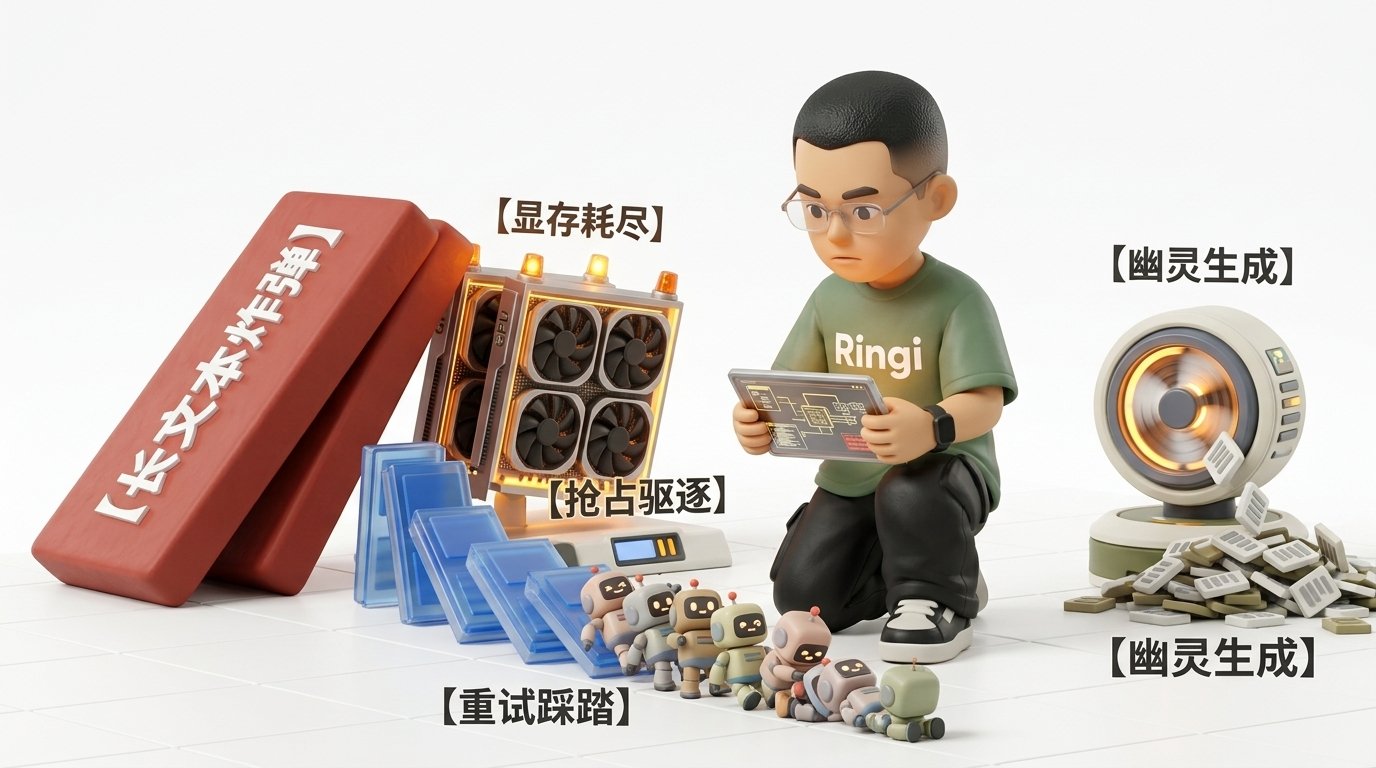
事故复盘解剖:五步致命传导
- 长文本炸弹首杀:某位开发者在 IDE 中对一个长达 2.4 万行的大型重构工程触发了“解释当前代码”。该请求携带了高达 24K Tokens 的 Prompt 瞬间打入 Pod 03;
- 调度器单核霸占与显存挤压:由于当时未开启 Chunked Prefill,Pod 03 的 GPU 在长达 1.2 秒内完全被这个 24K 的 GEMM 算子霸占,导致原本正在平稳流式吐字的 16 个 Decode 请求全部暂停(TTFT 正常,但 TPOT 瞬间被拉长到 1200ms 以上);更致命的是,24K 上下文瞬间吃掉了当前卡上近 15GB 的 KV Cache 物理块;
- 显存水线耗尽引发 Preemption(抢占驱逐):随后的几个常规请求需要申请新 Block 时,vLLM 发现物理显存不足,触发了内置的抢占策略(Preemption Mode)——将正在 Decode 的数个请求的 KV Cache 强行驱逐(Evict),打回等待队列;
- 客户端超时重试风暴(自残踩踏):前端客户端因为 10 秒没有收到后续流式 Token,判定连接超时,立即自动发起重试!而网关 Nginx 只是将重试请求根据轮询又投递给了 Pod 07;更可怕的是,Pod 03 此时根本没有捕获客户端的断连信号(Connection Reset by Peer),依然在后台耗费极其宝贵的 Tensor Core 算力继续计算那个已经没人要的“幽灵请求(Ghost Request)”;
- 全集群死锁雪崩:重试请求在全集群 10 个节点上像病毒一样扩散,每一个节点都陷入了“长文本抢占 -> 驱逐重算 -> 显存耗尽 -> 客户端超时重试 -> 产生更多幽灵请求”的恶性循环。最终,整个集群的吞吐量彻底归零,排队数堆积至几千个,只能依靠人工紧急接入修改网关限流规则并整机滚动重启才得以恢复。
0.3 离线批处理(Offline Batching)vs 在线低延迟(Online Serving)全栈维度对照速查表
在深入容量规划与治理之前,我们必须在全栈体系上将“离线批处理”与“在线服务”彻底剥离。许多工程师之所以搞砸生产,就是因为把离线 Benchmark 的漂亮数字直接搬进了在线系统。1. 第一性原理穿透:大模型在线推理的资源消耗方程与吞吐延迟权衡
💡 架构全景速览:在深潜源码前,先在白板上建立坚不可摧的大模型在线推理容量规划、SLO 治理与生产故障诊断底账。

1.1 经典微服务容量公式( )为什么彻底失效?
在传统互联网后台架构中,利特尔法则(Little’s Law)是容量规划的定海神针: 即:系统中平均并发请求数 等于到达率 (QPS)乘以平均停留时间 (Latency)。如果单个工作线程或微服务容器可以安全承载 个并发请求,那么所需的机器实例数就是: 为什么在 LLM 在线推理中,这个公式不仅毫无指导意义,反而会诱导灾难?原因一:处理延迟 根本不是常数,它被当前并发数 反向强耦合
在传统微服务中,只要 CPU 利用率在 60% 以下,单请求的耗时基本稳定在 50ms 左右。但在 LLM 推理中,根据 Roofline 模型:- 当并发数从 1 增加到 64 时,由于 Decode 阶段从 Memory-Bound 逐渐向 Compute-Bound 移动,单步 Decode 的耗时会从 12ms 逐渐攀升至 45ms;
- 更严重的是,随着并发增加,动态 Batching 调度器不得不频繁进行注意力计算排队,输入长度直接决定了 Prefill 耗时,输出长度直接决定了自回归循环步数。你的“单请求 Latency”是一个随着请求输入输出长度分布以及全系统瞬时拥挤度剧烈漂移的非线性函数!
原因二:工作单元承载能力 是动态缩水的气球
在传统微服务里,一个容器分 2GB 内存,开 50 个线程,哪怕吞吐跑满,内存几乎是平稳的。 但在 LLM 中,显存不仅要放固定的模型权重,还要为每一个并发请求动态分配 KV Cache:- 如果进来的全是短请求(Prompt=200, Output=100),一块 80GB 的 GPU 可能会轻松吃下并发 ;
- 但如果突然进来 5 个包含长文档分析的请求(Prompt=16K, Output=2K),这 5 个请求所占用的 KV Cache 显存就高达数十 GB,直接将整张卡的有效并发承载容量 从 120 强行压缩到 8!
- 如果你按照平均并发容量 去规划,系统就会在遇到长请求的瞬间被当场顶爆。
1.2 Prefill 与 Decode 动态异构负载下的资源错配:算力墙 vs 显存双墙
我们必须深刻复习本模块核心认知:大模型推理不是单一任务,而是两段物理特征截然相反的计算形态的强制交织。- Decode 被 Prefill 斩首:自回归解码要求每隔 20~40ms 必须走完一步,才能让前端用户感受到丝滑的打字机流式输出。然而,一旦调度器装入一个新的长 Prefill(比如 4096 Tokens),这个大 GEMM 算子在 GPU 上执行可能需要整整 200ms。在这 200ms 期间,所有正在 Decode 的请求全部被硬件流水线挂起等待!前端用户就会明显感觉到字间间隔出现了一次长达 200ms 的剧烈“抽搐(Jitter)”;
- Prefill 被 Decode 挤爆显存:如果你为了避免 Jitter,限制同时处理的 Prefill 数量,让大量的 Decode 请求占满整个 Continuous Batch,那么随着 Decode 步数步步推进,KV Cache 显存池会像涨潮一样迅速淹没安全水位,导致新请求根本无法分配首个 Prompt 的 KV Block,直接在队列外发生队头阻塞。
1.3 核心约束铁三角(Iron Triangle):TTFT、TPOT 与 Throughput 的不可兼得
在线大模型系统的架构设计,本质上是在一个不可能三角(The Impossible Iron Triangle)中走钢丝:- 追求极限 Throughput(吞吐偏向):
- 做法:将 Batch Size 尽可能拉大,设置超大的
max_num_batched_tokens(例如 8192),贪婪地把尽可能多的请求塞进每一次 Forward 执行; - 后果:Tensor Cores 算力利用率和 HBM 带宽利用率双双爆表,每美元产出的 Token 数最高;但每一次 Forward 耗时被拉长,TTFT 和 TPOT 双双恶化,尾延迟 P99 彻底失控。
- 做法:将 Batch Size 尽可能拉大,设置超大的
- 追求极致 TTFT(响应偏向):
- 做法:一旦有新请求到达,立即抢占调度,甚至单独为其开启一次大规格 Prefill 计算;
- 后果:首字极快返回;但每一次为了 Prefill 打断当前正在进行的 Decode 批次,严重破坏了自回归生成的节奏,导致现有所有并发流的 TPOT 频繁出现惊魂尖刺,整体系统吞吐暴跌。
- 追求极致 TPOT(平滑偏向):
- 做法:严格限制单个 Forward 中的 Token 预算,极度压低 Batch 并发数,并使用极小的 Chunked Prefill 尺寸(如 256);
- 后果:字间流式输出极其顺滑,如同真人高速敲键盘;但由于无法充分发挥 GPU 大规模矩阵乘法的硬件饱和效应,算力大量空转,系统总吞吐量极低,单 Token 运行成本直线上升。
2. 公式五步穿透:工业级 GPU 卡数与显存容量预测性规划模型
2.1 显存四账本硬核核算(Weights + Paged KV + Activation/Graph + Safety Buffer)
要算清一个 GPU 节点到底能承载多大容量,必须把整张卡的物理显存划分成绝对清晰的“四本物理账”。任何一本账算错,要么造成数百万的硬件闲置浪费,要么直接引发线上 OOM。 以经典的 80 GB (实际可用约为 ) 显存卡(如 NVIDIA H800 / A100-SXM4-80GB)为例:- 账本一:模型参数权重显存( )
- 计算公式:
- 注意:必须计入 Embedding 层及非 Transformer 层的显存占用(在部分框架中可能未切分)。
- 账本二:中间激活与运行时框架驻留显存( )
- 包含 PyTorch 运行时上下文、CUDA Driver Context(约 1~1.5 GB)、中间激活值(Activation Memory)以及 CUDA Graph 捕获专有内存池。
- 在启用 CUDA Graph 加速 Decode 时,引擎会为一系列固定的 Batch 尺寸预先捕获静态执行图,这部分显存开销通常在 2 GB ~ 4 GB 不等。
- 账本三:安全缓冲与内存防抖预算( )
- 生产环境中决不能将显存用至 100%。通常由引擎参数
gpu_memory_utilization严格控制(例如设定为 0.90,意味着主动扣除 10% 的物理显存作为系统防止碎片和瞬时申请崩溃的绝对安全垫)。
- 生产环境中决不能将显存用至 100%。通常由引擎参数
- 账本四:动态 Paged KV Cache 内存池( )
- 扣除上述三项后,剩下的全部连续物理显存,被划分为固定大小的 Page(Block,通常每个 Block 容纳 16 或 32 个 Tokens),构建成 PagedAttention 的动态内存池。
- 这一账本的大小,直接在物理上锁死了该节点能够同时容纳的 Token 宇宙上限!
2.2 公式五步穿透:单节点最大稳定并发数 与单卡极限吞吐推导
现在,我们要推导决定集群命脉的核心指标:单个节点在给定上下文长度下,到底能并发扛住多少个请求( )?第一步:为什么需要算它?(The Problem)
很多工程师在部署 vLLM 时,直接把max_num_seqs 默认拉到 256。结果一旦业务请求的平均输入长度从 500 漂移到 3000,集群立刻因为 KV Cache 耗尽发生剧烈 Preemption,大量请求被挂起。我们必须在物理上精准界定:在既定显存池大小和预期的 P90 上下文长度下,最大安全并发窗口是多少,从而为网关限流与引擎参数提供不可逾越的底账依据。
第二步:Mental Model(物理直觉)
想象一家高档餐厅(GPU 节点)。- 厨房和餐桌固定占了一半的店面空间(模型权重与系统开销);
- 剩下的一半空间摆放顾客的储物柜(KV Cache 显存池);
- 每个顾客进来消费,无论吃多久,只要没结账离开,他的随身行李(从 Prompt 到生成的新 Token)就必须全程塞在储物柜里;
- 店里面能同时坐多少个客人(并发数),根本不取决于你门口服务员端菜有多快,而是取决于你的储物柜总共有多少个格子,以及每个客人带的行李平均有多大!
第三步:Tiny Calculator(极简手算)
假设一个 Toy Transformer 模型:- 隐藏层数 层;
- 键值头数 ;
- 每个头的维度 ;
- 精度为 FP16( 字节);
- 显存池总共有可怜的 ;
- 单个请求的总序列长度 Tokens。
- 先算单 Token 在一层上的 KV 大小:
- 乘以 2 层,得到单个 Token 的 KV Cache 容量:
- 单个请求如果打满 512 Tokens,需要消耗:
- 这个 1MB 的显存池最多能同时容纳多少个并发?
第四步:Formal Model(标准通用工业公式)
对于任何具备 GQA(分组查询注意力)的现代大模型,单个 Token 在单张卡(经过张量并行切分 )上的 KV Cache 消耗公式为: 设单张 GPU 物理显存总量为 ,引擎预留比例为 (如 0.90),模型切分后占用的显存为 ,系统运行时开销为 。 则单卡可用于 KV Cache 的总容量为: 设业务场景中,并发请求在生命周期内的总上下文长度(Prompt 长度 + 生成长度 )的规划评估值为 。 则单节点支持的最大稳定物理并发数 为:第五步:Sanity Check(真实工业级数量级校验)
我们以生产环境最标杆的配置做一次实战验算:- 模型:Qwen2.5-72B-Instruct( , , , FP16 精度 );
- 硬件:单机 8 卡 H800( ,单卡 80GB HBM3,实际可用 );
- 参数显存:72B 模型切到 8 卡,单卡权重 ;
- 运行时开销: ;
- 安全阈值: (可用上限 );
- 则单卡 KV 池容量:
- 手算单 Token KV 显存:
- 假设长文档总结场景:输入 16K Tokens,输出 1K Tokens,合计 Tokens。 单个请求消耗单卡 KV 显存: 。
2.3 基于 24 小时真实潮汐流量曲线的集群卡数推导模型
在实际商业生产中,用户流量绝不是一条水平直线,而是呈现极具规律的“双峰潮汐特征”与不可预测的“突发脉冲”。核心规划输入参数矩阵
- :业务预测的 24 小时峰值请求到达率(必须取 P99 峰值,严禁使用日均值);
- 与 :请求输入和输出的 Token 数期望值;
- :SLO 承诺的单 Token 生成延迟上限(例如 30ms/Token,对应每秒单流吐字速度为 33.3 Tokens/s);
- :SLO 承诺的首字响应时间上限(例如 800ms);
- :业务抗突发流量的安全缓冲系数(通常取 1.25 ~ 1.35,即预留 25%~35% 的算力防线);
- :高可用容灾系数(生产集群必须满足 节点容灾,大型机房通常保留 的机房冗余)。
两条物理约束边界的联立求解
计算所需 GPU 总卡数,必须同时求解两个约束方程,并取其最大值:约束一:算力与吞吐通量平衡(Throughput-Bound Equation)
系统在峰值时,每秒钟必须向用户吞吐的生成 Token 总数为: 系统每秒钟必须吞吐的输入 Prefill Token 总数为: 设单张 GPU 在保证 前提下,实测所能提供的有效持续生成吞吐能力为 (Tokens/sec/GPU)。 则基于算力通量维度的卡数需求为:约束二:KV Cache 显存并发容量平衡(Memory-Capacity Equation)
单次请求在系统中的平均生命周期(从到达至完全结束)为: 根据利特尔法则,峰值时刻驻留在内存中、持续霸占 KV Cache 的在途活跃请求数(Concurrency)为: 已知单节点在最大允许并发下的容量上限为 (见 2.2 节推导),单节点卡数为 。 则基于显存容量维度的卡数需求为:最终决策方程:
工程大白话:- 如果业务是短输入、超长输出(如小说写作、代码生成),系统绝大多数时间卡在 Decode 带宽与算力上,此时 主导卡数规划;
- 如果业务是超长输入、短输出(如长文档审阅、法律合同 RAG、多轮巨型上下文客服),系统会瞬间被巨量的 KV Cache 塞爆,算力利用率可能才 30% 但显存已经耗尽,此时 主导卡数规划!
2.4 真实生产推演实战:Qwen2.5-72B 在 8×H800 节点上的真实容量规划实例计算
为了让你能够直接把这套模型带去大厂的架构评审会,我们进行一次 100% 真实参数的落地测算。业务背景设定
- 业务场景:企业级研发协同 AI Copilot 助手;
- 模型规格:Qwen2.5-72B-Instruct(FP16 精度,单机 8 卡 H800, );
- 流量特征:
- 早高峰峰值 ;
- 平均 Prompt 长度 Tokens;
- 平均生成长度 Tokens;
- SLO 承诺:
- P95 TTFT ;
- P95 TPOT (即每秒吐字不低于 33.3 Tokens);
- 冗余策略:
- 动态业务安全裕度 (预留 25%);
- 容灾与机房冗余 。
详细手算步骤
步骤 1:核算单请求的平均生命周期
步骤 2:核算系统峰值活跃并发连接数
步骤 3:核算单台 8 卡 H800 节点的显存容积与最大安全并发
由 2.2 节实测已知:- 单卡可分配 KV Cache 显存:
- 单 Token 在单卡上的 KV 开销:
- 单个请求平均总长度:
- 单个请求在单卡上消耗的 KV Cache:
- 单台 8 卡节点的最大并发承载力:
步骤 4:核算算力吞吐维度的单节点能力与集群需求
在生产实测中,一台 8 卡 H800 跑 Qwen2.5-72B,在保证单请求 TPOT 的严苛 SLO 约束下,整台机器能够维持的最高安全聚合生成吞吐量约为: 业务在峰值时刻每秒钟要求系统吐出的生成 Token 总数为: 由此计算满足算力吞吐所需的节点数: 叠加业务安全缓冲与容灾系数:步骤 5:容量交叉对账与反思
现在回过头来看:- 15 台节点总共能提供的并发容量池为: 个并发,而我们的峰值并发需求只有 504 个!
- 这意味着什么?在长生成短输入的对话场景下,系统是极其典型的“算力受限(Compute-Bound)”型架构!显存利用率长期只有 10%~20%,但为了满足 30ms 的 TPOT 与峰值 QPS,我们不得不采购 15 台机器去堆算力吞吐!
- 如果你当初按“显存放得下”去估算,你以为 1~2 台机器就能扛住 504 个并发,那么上线瞬间你的 1 台机器将被 16,000 Tokens/s 的生成洪峰活活打瘫,TPOT 飙升到 200ms 以上,系统彻底失去可用性!
3. 核心 SLO 治理体系:从 Metrics 观测到 Goodput Pareto 边界
3.1 现代 LLM Serving 的四维黄金指标体系与度量口径
评估大模型在线推理服务,严禁使用模糊的“平均响应时间(Average Latency)”。现代工业大厂必须构建毫秒级采样的“四维黄金指标体系”:3.2 到底什么是 Goodput(有效吞吐量)?拒绝“自欺欺人”的伪高吞吐
在基准测试(Benchmark)中,很多人喜欢吹嘘自己的框架能跑出“每秒 10,000 Tokens”的惊人吞吐。然而在真实业务中,如果这 10,000 个 Token 里,有 4,000 个是在用户已经点击取消、或者客户端已经超时报错之后由引擎吐出的,那么这些 Token 不仅毫无商业价值,反而消耗了极其高昂的 GPU 电力与算力! 这就引出了大模型在线治理中最核心的概念——有效吞吐量(Goodput)。3.3 Pareto 边界曲线实测绘制:Throughput 与 SLO 违约率的黄金拐点
在性能工程中,我们通过逐步调大并发施压,记录“系统总吞吐”与“P99 延迟违约率”的关系,绘制出经典的 Pareto 边界曲线。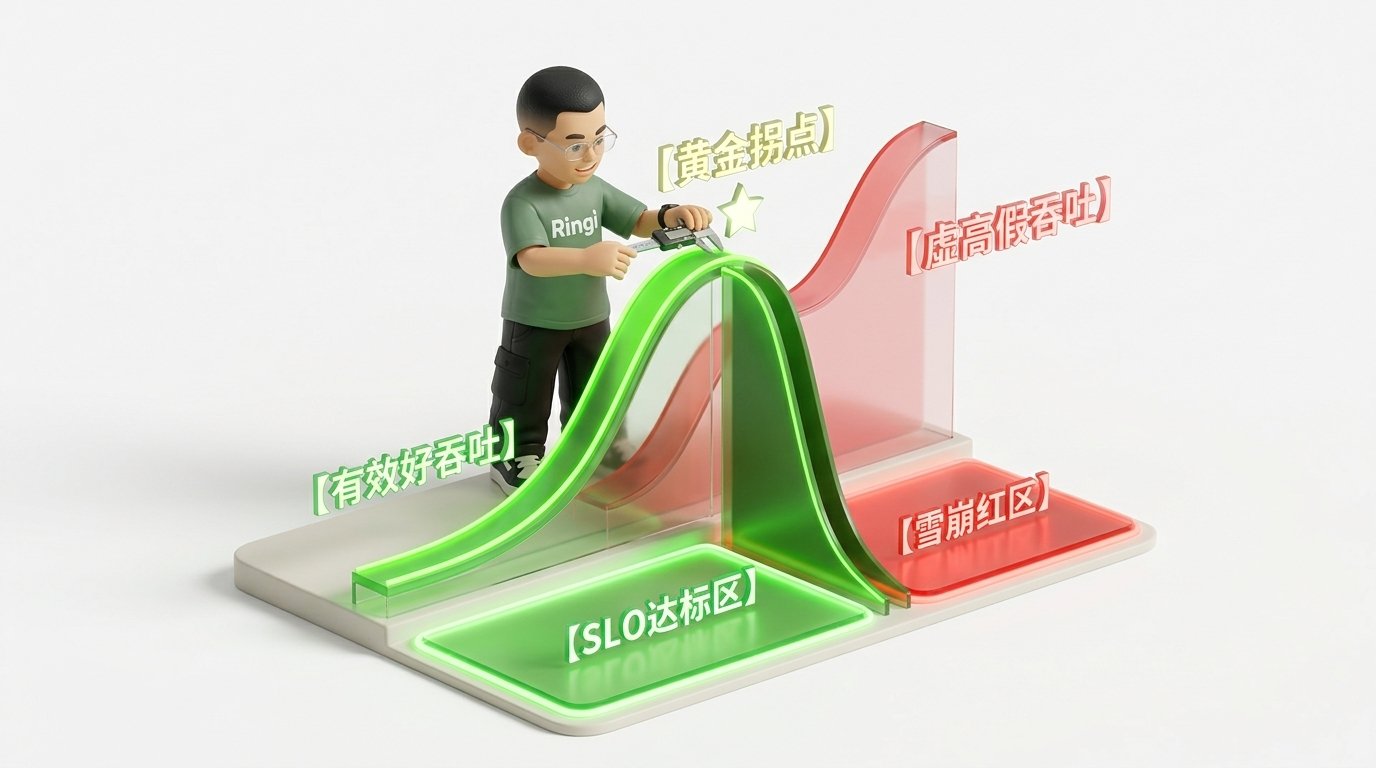
- 安全绿区(Linear Scalability Zone):
- 并发较小,硬件资源充裕,TTFT 与 TPOT 维持在极低水准,SLO 违约率 < 0.1\%。此时 Goodput 与 Raw Throughput 完全重合,随并发线性增长;
- 黄金运营拐点(Pareto Optimal Knee Point):
- 算力与显存带宽利用率达到 75%~85% 的甜点区,Continuous Batching 装箱紧凑,Goodput 达到全局峰值。这是容量规划所必须瞄准的黄金水位!
- 危险黄区(Degradation Zone):
- 调度队列开始堆积,长 Prefill 开始频频撞车 Decode,P99 延迟出现明显长尾抬头,违约率攀升至 5%~15%。此时 Raw Throughput 还在微幅上升,但 Goodput 已经开始掉头向下;
- 红色崩塌区(Total Collapse Zone):
- 显存池彻底告急,频繁触发 Preemption 驱逐换入,客户端大量超时触发重试,Goodput 呈自由落体式暴跌,系统消耗 100% 的电力,却交付不了几个合格的响应!
3.4 动态过载保护与分级服务质量(QoS):基于排队延迟预测的智能丢弃
当不可预知的突发脉冲(如微博热搜、突发大促)来袭,流量瞬间超出黄金拐点时,高可用系统绝不能“来者不拒”,而必须立即激活分级过载保护(Overload Protection)。核心机制:预测性排队丢弃(Predicted Queue Shedding)
传统网关的熔断器(如 Sentinel 或 Hystrix)通常基于“错误率”来判断是否熔断。但大模型推理单次耗时长,等你统计出 504 错误率飙升时,引擎里面早就积压了数百个必死无疑的请求! 大模型 AI 网关必须实施前向排队时间预测(Predicted Queue Latency):- 获取当前引擎水线:网关通过 Sidecar 或健康探测,每 100ms 拉取各推理实例当前排队队列中的 Token 积压总量 ;
- 计算预计等待耗时:
- 快速拒绝(Fail-Fast):当一个新请求到达,网关预估其排队时间已经超过了该业务设定的 TTFT SLO 门限(例如预计要排 3 秒,而业务 SLO 是 1.5 秒),网关层直接在 5 毫秒内原地返回 HTTP 429 Too Many Requests!
- 收益:避免毫无希望的请求侵入昂贵的 GPU 显存池,将全部宝贵算力留给当前正在生成的请求,确保正在服务的这批用户体验绝对不崩!
基于业务分级的 QoS 降级矩阵
4. 智能路由与网关调度:把流量送到最懂它的 GPU 上
4.1 传统轮询(Round-Robin)在 LLM 场景引发的长尾与队头阻塞
在微服务时代,Nginx 的轮询(Round-Robin)或随机(Random)负载均衡是工业标准。但在大模型集群前挂一个四层轮询网关,就是生产事故的温床!- 对输入长度盲目(Token-Blind):认为一个 50 Tokens 的 ping 与一个 32,000 Tokens 的巨型 PDF 提取都是“1 次 HTTP 请求”,交替分发直接导致部分节点被活活撑死,其他节点闲得发慌;
- 对内部状态盲目(State-Blind):无法感知目标 GPU 节点的剩余 KV Blocks 数量与当前活跃并发数,持续向濒临 OOM 的节点硬塞请求;
- 对前缀缓存盲目(Cache-Blind):在多轮对话或固定 System Prompt 场景下,同一个用户的第 5 轮提问被随机甩到了另一台全新机器上,原本可以秒级复用的几千 Token 前缀缓存彻底失效,被迫从头做一次昂贵的 Prefill 重算!
4.2 三维感知型智能调度:Queue Depth、KV Blocks 与 Prefix-Cache Affinity
现代企业级 AI 网关(如基于 Envoy/Higress/SGLang Router 深度定制的推理路由层),必须实现三维感知型调度:1. 前缀缓存亲和性路由(Prefix-Cache Affinity Routing)
在现代推理框架(如 vLLM / SGLang)中,Radix Tree 能够将所有处理过的 Prompt 组织成前缀树缓存。- 机制:网关维护一套全局轻量级的前缀布隆过滤器或 LRU 目录。当一个请求到达时,网关提取其 System Prompt 或历史对话前缀的 Hash;
- 效果:将同一个 Session 的多轮对话始终粘性路由到同一台物理 GPU 节点上。Prefill 阶段的计算直接跳过,TTFT 从 1.2 秒骤降到 40 毫秒,且单次请求减少了 80% 以上的显存申请!
2. 显存余量感知(Remaining KV Blocks Awareness)
网关通过长连接心跳,每秒同步各实例的free_gpu_blocks:
- 若节点可用 Block 充足(>40%),允许接收任何规格的请求;
- 若节点可用 Block 进入警戒区(15%~30%),触发选择性接客:只接收短文本请求(Prompt < 1000),拒绝大上下文请求;
- 若节点可用 Block 跌破 10%,停止向该节点分发任何新请求,让其专心跑完现存 Decode,直到显存自然释放回流。
4.3 客户端中断处理(Client Disconnection Handling):掐断幽灵生成(Ghost Decoding)
在大模型在线服务中,最昂贵、最可耻的算力浪费莫过于“幽灵生成(Ghost Decoding)”。场景重现
前端用户在聊天界面提问了一个极其复杂的问题。大模型开始逐字生成,吐了 20 个字后,用户发现模型理解偏了,于是果断点击了网页上的 【停止生成(Stop)】 按钮,或者直接关掉了浏览器标签页。 此时,客户端的 HTTP 连接瞬间断开(TCP RST 或 FIN 包到达网关)。 如果你的网关和推理引擎没有打通“断连感知管道”,会发生什么荒谬的景象?- 推理引擎底层的 Python 调度器和 CUDA 核心根本不知道外面发生了一切!
- 调度器依然在每个 Step 把这个请求装进 Batch 里,Tensor Cores 依然在拼命轰鸣,继续为其生成完剩下的 1980 个 Token;
- 生成完的 Token 被网络栈默默丢弃,而这个无用的请求却霸占了整整 15 秒的 KV Cache 显存与宝贵算力,同时将其他正常用户的排队请求活活卡在门外!
工业级防御架构:全链路中断信号透传
- 网关反向代理层必须启用客户端中断感知(如 Nginx 的
proxy_ignore_client_abort off;); - 推理引擎必须配置客户端断连检测并启用异步流式发生器的取消监听;
- 仅此一项优化,就能在大模型突发流量期为集群挽回 15% ~ 30% 的被盗算力!
5. 现代 Serving 引擎内核配置与调优指南(vLLM / SGLang)
参数配置不是玄学,每一项配置背后都对应着冷酷的计算机体系结构取舍。以下是一线高并发大模型集群生产环境中必须吃透的核心配置项。5.1 显存利用率 gpu_memory_utilization 与 block_size 的微调玄机
gpu_memory_utilization(默认 0.90)
- 物理本质:告知推理框架(如 vLLM),在扣除自身模型权重后,最多允许拿显卡物理总显存的百分之多少去初始化 KV Cache 内存池;
- 致命陷阱:很多初学者为了贪图更大的并发,直接将该值拉到
0.98。这会导致系统在启动时看似一切正常,但运行几分钟后,只要系统偶尔发生一次较大的动态张量申请(例如处理某一个大尺度多模态输入,或者 PyTorch 内核临时分配 Workspace 内存),GPU 就会因为瞬间缺乏即使几十兆的物理缓冲而当场发生硬性 CUDA OOM 猝死! - 生产黄金建议:
- 单纯纯文本大模型(7B~72B):设置为
0.90 ~ 0.92; - 涉及多模态(Vision LLM,包含图像高分辨率编码):保守设置为
0.85 ~ 0.88(给 Vision Encoder 的临时大张量留足呼吸空间)。
- 单纯纯文本大模型(7B~72B):设置为
block_size(支持 8, 16, 32,默认通常为 16)
- 物理本质:PagedAttention 中虚拟页(Block)容纳的 Token 数量;
- Trade-off 权衡:
block_size = 16:内存碎片更小(每个请求结束时,平均浪费的尾部空间只有半个 Block,即 8 个 Token 的显存)。适合平均序列较短(<1024)的通用交互场景;block_size = 32:每个 Block 容纳更多 Token,大幅减少了 Block Table 寻址元数据的开销,提升 GPU 访问 KV Cache 时的内存连续性与访存效率(带宽利用率提升约 3%~5%)。在长文本(>8K)场景下,强烈建议指定block_size = 32。
5.2 调度并发窗口:max_num_seqs 与 max_num_batched_tokens 的抗突发设计
max_num_seqs(最大并发序列数)
- 物理本质:单个 Forward Step 中允许同时处于 Running 状态的最大序列数量;
- 调优法则:该值必须严格按照我们第 2 节手算的稳定物理并发数 进行钳制!如果根据显存算出的最大安全并发是 128,你就必须硬性限制
max_num_seqs = 128。哪怕队列里排了一万个请求,也绝不放第 129 个请求进 Running 态。这是阻断“显存雪崩”的第一道物理防线!
max_num_batched_tokens(单批最大 Token 预算,默认如 2048 / 4096)
- 物理本质:单个 Forward 步骤中,所有请求处理的 Token 总数上限(包括 Prefill 的 Token 和 Decode 的 Token);
- 调优法则:
- 如果设置过大(如 16384):一旦进来一个 16K 的长 Prompt,调度器会试图一次性算完,导致这次 Forward 耗时超过 1.5 秒,严重冻结当期的所有 Decode 流式输出;
- 如果设置过小(如 512):不仅限制了大 Prefill 的吞吐,而且连正常的并发 Decode 都无法装满;
- 最佳实践:通常与 Chunked Prefill 联动,生产推荐设置为
2048 ~ 4096。
5.3 CUDA Graph 批处理捕获桶(Batch Buckets)调优:显存膨胀与 CPU 开销规避
在大模型 Decode 阶段,单步生成的 GPU Kernel 执行时间可能只有不到 10 毫秒。此时,Python 调度层向 GPU 下发 Kernel 的 CPU 开销(Kernel Launch Overhead)就会成为不可忽视的瓶颈。CUDA Graph 的魔力与代价
- 魔力:将一系列固定的 Kernel 下发时序“固化”录制为一个 Graph。下次执行只需一次 API 调用,CPU 几乎零开销,GPU 自行触发整条流水线;
- 代价:CUDA Graph 要求输入的 Tensor 地址和形状必须严格静态不变!但在线推理的 Batch Size 是动态变化的(一会儿 1 个并发,一会儿 37 个并发)。
- 解法:批处理捕获桶(Batch Buckets):框架会预先录制一组离散的并发尺寸,例如
[1, 2, 4, 8, 16, 24, 32, 48, 64, 80, 96, 112, 128]。 - 调优坑点:
- 录制每一个 Bucket 都要额外霸占大约 150MB~300MB 的专用显存;
- 如果桶划分得过密(例如从 1 到 256 每一个数字都录制一个 Graph),光是保存这些 Graph 就会吃掉 10GB 以上的宝贵显存,直接挤死 KV Cache!
- 如果划分得过疏(例如只有 1, 16, 64, 128),那么当实际并发是 17 时,系统不得不向上 Padding 到 64 来执行,白白浪费了 47 个并发的无效计算与带宽!
- 生产推荐配置:在目标峰值区间内密集分布,低谷和超大区间稀疏分布(如
[1, 2, 4, 8, 16, 32, 48, 64, 80, 96, 128])。
5.4 Chunked Prefill 混合装箱参数与平衡点实战
Chunked Prefill(分块预填充)彻底打破了“必须一次性算完整个 Prompt”的陈旧观念,是化解 TTFT 与 TPOT 冲突的最强武器。- 参数启用:在 vLLM 中通过
--enable-chunked-prefill开启; - 黄金切割尺寸(
block_size/max_num_batched_tokens):- 推荐单次 Chunk 尺寸切在
512或1024; - 既能让大 GEMM 在 Tensor Cores 上获得 80% 以上的高算术强度,又将单步 Forward 耗时死死压制在 50ms 安全线以内,彻底抹平了长尾 TPOT 的突发尖刺!
- 推荐单次 Chunk 尺寸切在
6. 生产级故障排障 Runbook:高频血泪事故诊断与解法
当凌晨三点报警电话将你惊醒,生产集群正在疯狂告警时,你没有时间翻阅教科书。你需要的是一套能够精确按照症状定级的工业级排障 Runbook。6.1 故障一:显存 OOM 猝死与动态申请雪崩
🚨 故障现场指征
- K8s 集群中推理 Pod 状态频繁变为
Error或OOMKilled,dmesg -T打印出Out of memory: Kill process (vLLM Engine); - 容器日志末尾抛出大红字:
torch.cuda.OutOfMemoryError: CUDA out of memory. Tried to allocate 256.00 MiB; - 节点重启后迅速再次 OOM。
🔍 根本原因解剖
gpu_memory_utilization过于贪婪:设为 0.95 以上,忽视了 PyTorch 的动态显存碎片和 Caching Allocator 的保留内存;- 长文本炸弹瞬间打穿预算:输入长度超过了模型本身训练外推的极限(例如 32K 模型突然进来了 64K 请求),导致 Attention 内部计算的中间张量呈二次方膨胀;
- 多模态或特定算子临时分配:部分自定义的惩罚项(Logits Processor)在 CPU/GPU 间进行全词表(如 15 万词表)张量拷贝,瞬间占爆显存。
🛠️ 紧急处置三步法
- 第一步(网关止血):立即在网关层下发规则,硬性截断所有请求的
max_tokens与输入长度: - 第二步(安全参数重启):修改 Deployment 配置,将
gpu_memory_utilization从 0.95 下调至0.88,并硬性设置--max-model-len 8192阻断超长序列; - 第三步(根治归档):检查是否未开启 PagedAttention 或配置了错误的外部张量分配器,上线长文本输入前置校验拦截器。
6.2 故障二:Prefix Cache 频繁驱逐抖动(Radix Tree 缓存击穿)
🚨 故障现场指征
- 集群总吞吐看起来很平稳,但业务侧疯狂告警:首字延迟 TTFT 呈现极其恶劣的锯齿状剧烈抖动(一会儿 80ms,一会儿 2500ms);
- 引擎内部的
vllm:prefix_cache_hit_rate指标从平时的 85% 瞬间暴跌至不足 10%。
🔍 根本原因解剖
- 动态变量污染了静态前缀:业务开发人员在 System Prompt 中插入了“动态时间戳”或“随机 SessionID”(例如
当前时间: 2026-09-08 15:32:01.234放在了最开头)。导致每一次请求的前缀哈希全部不同,Radix Tree 彻底失效! - 多机调度打散:网关没有开启 Session 粘性或前缀亲和路由,同一个用户的多轮对话在 10 台机器之间随机乱跳;
- 显存水线不足引发的恶性驱逐(Cache Thrashing):物理显存池吃紧,Radix Tree 为了给新请求腾挪空间,不得不刚把上一秒缓存的前缀驱逐出显存;下一秒用户的新会话到达,又不得不重新做一次完整的 Prefill 重算,引发全集群“缓存颠簸”。
🛠️ 生产排障与治理
- 代码审计前缀模板:严禁在 System Prompt 头部注入动态变化的变量!所有动态变量(时间、用户上下文)必须挪至 Prompt 的最末尾;
- 启用前缀感知路由(Prefix-Aware Routing):在网关层建立前缀哈希一致性路由,锁定目标机器;
- 预热长前缀(Prefix Pre-warming):在服务上线或节点重启后,主动向集群发送带有公共长 System Prompt 的 Dummy 请求,将其常驻锁定在各卡的 Radix Tree 头部,防止冷启动击穿。
6.3 故障三:TP 组内单卡掉队与通信死锁(NCCL Watchdog 诊断)
🚨 故障现场指征
- 多卡并行推理节点(如 8 卡 H800 TP=8)突然完全停止响应,既不吐字,也不报错;
nvidia-smi查看发现:某一张 GPU(如 GPU 3)的利用率恒定为 100%,而其他 7 张卡利用率全部为 0%;- 几分钟后日志抛出超时死锁:
Watchdog caught collective operation timeout: WorkNCCL timed out after 600 seconds。
🔍 根本原因解剖
- 硬件 PCIe / NVLink 链路降速(Degraded Link):某张 GPU 所在槽位的 NVLink 物理金手指接触不良或发生硬件错误,传输速率从 400 GB/s 骤降到 10 GB/s,成为拖慢整组 AllReduce 通信的“老头卡”;
- CPU 单核被绑死引发调度倾斜:多卡进程由不同 CPU 线程驱动,其中某个线程被主机上的其他高负载任务(如日志压缩、CoreDump 写入)抢占了 CPU 时间片,导致该卡无法按时向 GPU 下发 NCCL 指令,其余 7 张卡在
ncclAllReduce处陷入无限死等; - 硬件 XID 故障:某张卡遭遇了未报错退出的局部硬件单比特翻转(DBE)或温度墙降频。
🛠️ 诊断命令与治愈动作
- 第一步:排查 NVLink 与 PCIe 运行健康度:
- 第二步:排查 CPU 亲和性与进程绑定(NUMA Binding): 确保推理进程严格实施了 NUMA 节点与 GPU 之间的物理绑定(严禁跨 NUMA 访问远程 GPU 与内存);
- 第三步:开启 NCCL 守护日志定位掉队卡:
在环境变量中常态化配置 NCCL 通信超时看门狗:
一旦某个节点死等超过 60 秒,看门狗自动拉崩该 Pod,触发 K8s 漂移自愈,避免单卡暗死挂死整组集群!
6.4 故障四:突发热点引发排队风暴与级联超时(抢占驱逐重算 Preemption 治理)
🚨 故障现场指征
- 引擎日志中开始疯狂涌现:
Sequence 4102 was preempted by scheduler; - 原本已经生成了 200 个 Token 的请求,突然毫无征兆地卡住,甚至倒退重头生成;
- Prometheus 的
vllm:num_requests_waiting(等待队列长度)指数级爬坡至几千,客户端几乎 100% 出现 504 超时。
🔍 根本原因解剖
- 当 Running 队列中的请求所消耗的 KV Cache 总量达到 100% 显存边界,调度器为了不发生硬性 OOM 崩溃,不得不启动自卫性抢占(Preemption)。
- 被抢占的请求只有两种命运:要么被 Swap 到极其缓慢的主机 CPU 内存中(性能彻底完蛋);要么被直接丢弃 KV Cache(Recompute 模式),打回 Waiting 队列等显存空出来再重新做一次长 Prefill!
- 一旦发生抢占,意味着系统不仅没有向前推进生成,反而把已经做完的工作作废并进行昂贵的重算! 这是最严重的算力恶性倒退。
🛠️ 工业治愈 Runbook
- 调整抢占模式为直接拒绝或丢弃:生产环境中,宁可牺牲被抢占的这 1 个请求(立即向客户端返回服务过载),也绝不允许它打回队列进行耗时数秒的 Recompute,拉垮整车乘客;
- 网关层启用严格的并发漏桶(Leaky Bucket):绝不让超过物理安全上限的请求进入 Serving 引擎排队池;
- 开启 Chunked Prefill 削峰:确保即使有新请求在显存边缘挣扎,也不会用长 Prefill 瞬间击穿现有在途请求的显存防线。
6.5 生产排障诊断决策树与定位速查表
7. 动手实战与代码实验室(Minimal Runnable Code)
代码是最好的工程教科书。本节提供 4 个可以直接在本地运行、零多余第三方依赖(仅需标准 Python 3.9+ 运行环境)的工业级实战脚本。7.1 实验 1:工业级大模型推理容量与集群卡数规划模拟计算器
该脚本完整封装了第 2 节的全部公式推导,支持 GQA 架构、FP16/FP8 显存四账本核算,输入峰值 QPS 与 SLO,一键输出精准的 GPU 卡数与节点采购预算。7.2 实验 2:基于泊松分布的真实业务压测与 SLO Goodput Pareto 分析器
该脚本模拟生产环境真实的泊松过程请求到达、长短文本长尾分布以及 Continuous Batching 调度拥塞,直接输出不同并发下的 TTFT/TPOT 违约率与 Goodput 拐点。7.3 实验 3:轻量级感知型 AI 网关调度模拟器(RR vs Prefix-Affinity vs KV-Aware)
该脚本模拟一个拥有 4 台推理节点的集群,对比传统 Round-Robin 轮询调度与结合了“Prefix Cache 亲和”与“显存剩余感知”的智能路由,验证其对长尾延迟与缓存命中的巨大提升。7.4 实验 4:Serving 引擎实时监控探针与健康度巡检告警脚本
该脚本模拟 Prometheus 探针定期采集 Serving 引擎的四维指标(TTFT、Queue、Free Blocks、KV Cache Hit Rate),并在发生异常水线时触发自动化自愈建议。8. Ringi 避坑指南与生产黄金准则
8.1 避坑表格(❌ 常见小白错误理解 vs ✅ 大厂 AI Infra 正确理解)
8.2 生产容量与稳定性黄金 Checklist
- 1. 【容量核算】:在采购前必须完成显存四账本手算,明确 上限,并在算力吞吐与显存容量双重边界下取最大值。
- 2. 【安全缓冲】:生产环境引擎参数
gpu_memory_utilization严禁超过0.92,为 PyTorch Caching Allocator 保留足够的物理缓冲。 - 3. 【削峰防抖】:长文本服务必须硬性开启
--enable-chunked-prefill,将 Chunk 尺寸限制在 512 或 1024,彻底消除大 GEMM 对 Decode 流式输出的冻结。 - 4. 【断连掐断】:网关与引擎必须打通客户端 Abort 取消信号管道,确保用户停止生成或超时关闭时,立即释放 KV Cache 阻断幽灵计算。
- 5. 【前缀纯洁】:代码审计确保 System Prompt 头部绝对不包含动态时间戳、随机 ID 等易变变量,最大化 Radix Tree 命中率。
- 6. 【过载丢弃】:网关必须配置前向排队时间预测(Predicted Queue Latency),在预估排队超时不可逆时,毫秒级快速失败(Fail-Fast)返回 429。
- 7. 【长文本隔离】:在网关层对超过 8K 上下文的请求实施专用泳道隔离,防止长文本炸弹与短交互请求在同一个 Batch 中混跑争抢。
- 8. 【Watchdog 保活】:分布式张量并行(TP>1)节点必须开启 NCCL 看门狗(
NCCL_WATCHDOG_TIMEOUT=60),杜绝单卡死锁拖死全组。 - 9. 【SLO 实时大盘】:监控大盘必须同时绘制 Raw Throughput 与 Goodput 曲线,并将 P99 TTFT、P99 TPOT 与等待队列水线作为 P0 报警源。
- 10. 【定期压测寻拐点】:在灰度环境定期使用真实业务上下文分布进行阶梯加压,找出系统的 Pareto 黄金拐点并固化限流阈值。
9. Ringi 5 点核心速记口诀、自我检验清单与课后深度思考题
9.1 5 点押韵核心速记口诀
9.2 10 条白板自我检验清单
- 能否在白板上不查资料,手写推导出 GQA 架构下单 Token 的 KV Cache 显存计算公式?
- 为什么在容量规划中,利特尔法则必须用“端到端生命周期”而非纯生成时间来计算在途活跃请求?
- 显存四账本中,哪一本账本是固定不变的?哪一本账本直接决定了集群的最大并发承载上限?
- 为什么说追求极限 Raw Throughput(总吞吐量)反而可能会把一个在线 LLM Serving 系统的可用性推向深渊?
- 什么是 Goodput?请给出其标准数学表达式及与 SLO 的关联逻辑。
- 什么是 Chunked Prefill?它究竟解决了谁和谁之间的什么物理冲突?
- 为什么传统的四层负载均衡(Round-Robin)会导致大模型集群出现严重的显存热点倾斜?
- 什么是“幽灵生成(Ghost Decoding)”?为什么说没有断连感知的客户端重试是自残行为?
- 当
gpu_memory_utilization设为 0.98 时,为什么即使系统当前并发很低,也可能突然发生 OOM? - 当多卡 TP 推理发生死锁挂起时,你该如何利用
nvidia-smi和 NCCL 环境变量定位是哪张卡掉队?
9.3 3 道高阶开放式课后思考题(含极限 Corner Case)
思考题 1(极限 Corner Case:超长文本突发攻击)
某竞争对手恶意使用脚本,向你的公网 API 接口在一秒钟内并发打入 200 个经过精心构造的请求,每个请求的 Prompt 刚好是模型支持的上限(64K Tokens),并且输出设为 1 Token。- 请从网络防火墙、AI 网关、调度器(Scheduler)、显存池(Block Manager)到算子执行层,设计一套 5 级纵深防御体系,确保系统在遭受这种“长文本拒绝服务攻击(LDoS)”时,原有正常付费用户的交互丝毫不受影响。
思考题 2(前沿架构演进:PD 解耦下的容量规划重构)
随着 Prefill-Decode 解耦(PD Disaggregation,如 Mooncake 架构)走向成熟,Prefill 节点专门负责计算密集型大 GEMM,Decode 节点专门负责访存密集型逐字生成,中间通过 RDMA 传输 KV Cache。- 在这种架构下,传统的“单节点混合容量规划”该如何重构成“Prefill 节点池”与“Decode 节点池”的独立配比模型?如何根据 24 小时真实流量动态调整两个池子的卡数比例?
思考题 3(投机采样环境下的 SLO 与容量扰动)
如果在集群中全量启用了投机采样(Speculative Decoding,例如 Draft Model + Target Model 验证),单步生成的 Token 数量变成了动态的随机变量(命中 1~5 个不等)。- 这一机制对我们前面推导的 TPOT SLO、端到端生命周期 以及 KV Cache 的消耗速度会产生怎样非线性的影响?你在容量规划模型中该如何引入这个动态加速比因子?
10. 📚 参考资料与核心源码/经典论文指引
- vLLM 官方架构与调度器源码:
- 调度核心逻辑:
vllm/core/scheduler.py(深入查看Scheduler._schedule_running()与Scheduler._schedule_preempt()实现); - PagedAttention 显存分配器:
vllm/core/block_manager_v1.py;
- 调度核心逻辑:
- 经典学术论文:
- Efficient Memory Management for Large Language Model Serving with PagedAttention (Woosuk Kwon et al., SOSP 2023);
- Taming Throughput-Latency Tradeoff in LLM Serving with Chunked-Prefill (Sarathi-Serve, OSDI 2024);
- DistServe: Disaggregating Prefill and Decoding for Goodput-optimized Large Language Model Serving (OSDI 2024);
- 本地 AI_BOOK 核心知识库底账:
- 显存精确计算与容量规划推导:memory_analysis.md;
- 企业级 AI 推理架构与风险治理:07-实施建议与最佳实践.md;
- 推理服务通信与 AI 网关架构设计:06-推理服务架构设计.md。
附录:Appendix A — 大厂硬核高频面试题与白板推导(Interview Drill)
题目 1:设计支持 10K 并发、P99 TTFT < 500ms、P99 TPOT < 30ms 的企业级代码生成/聊天平台推理集群(端到端系统设计与卡数推导)
考察重点
考察候选人是否具备大厂全局 AI Infra 架构把控能力,能否跳出传统 Web 思维,从显存四账本、算力通量、Roofline 瓶颈、网关感知调度及 SLO 约束出发,给出严谨可落地的系统方案。思考路径与推导示范
- 统一业务输入画像:
- 10K 并发(Concurrency = 10,000 在途请求);
- 假定典型企业代码/聊天场景:平均 Prompt = 1500 Tokens,平均生成 = 500 Tokens,总长 = 2000 Tokens;
- 选定工业标准模型与部署方案:Llama-3.3-70B 或 Qwen2.5-72B(FP16,单机 8 卡 H800 TP=8)。
- 单节点容量推导(显存池限制):
- 单卡 KV 池容量:
- GQA 单 Token 单卡 KV 开销:
- 单请求消耗单卡显存:
- 单节点最大安全并发: 并发。
- 基于并发水线计算显存节点底线:
- 支撑 10,000 活跃并发,纯显存维度最少需要:
- 基于算力吞吐与 TPOT SLO 校验:
- 10,000 并发在流式生成中,每个请求要求 TPOT (即每秒吐 33.3 Tokens);
- 全集群在峰值时刻要求达到的聚合生成吞吐量为:
- 经验证,单台 8 卡 H800 在保 30ms TPOT 下,实际安全极限吞吐约为 1600 Tokens/s;
- 算力通量维度所需节点数:
- 架构决策与优化方案:
- 盲目采购 208 台节点成本无法接受,此时必须给出架构优化:
- 优化一(量化):启用 FP8 / INT4 权重与 FP8 KV Cache,单卡算力提升近 1 倍,吞吐能力提升至 3000 Tokens/s/节点,节点数骤降至约 110 台;
- 优化二(PD 分离):采用 Prefill-Decode 解耦架构,Prefill 节点打满算力,Decode 节点极致打满 HBM 显存带宽,综合集群成本再压降 30%~40%;
- 叠加 20% 安全缓冲与容灾,给出最终落地配置。
题目 2:在线集群遭遇突发长 Prompt 洪峰(例如用户上传 32K 报告),导致整个集群 TPOT 出现长达 2 秒的停顿,请详述从网关、调度器到算子内核的 4 级防御机制
考察重点
考察候选人对线上事故的应急治理深度,能否穿透全栈软件体系(Gateway -> Scheduler -> VRAM -> Kernel)给出纵深防御。标准参考答案(4 级防御体系)
- 第一级(AI 网关层):长短请求泳道物理隔离与限流
- 网关在 Tokenizer 阶段解析出输入长达 32K,严禁直接投递给通用低延迟交互集群;
- 将其重定向至专门的“长文档离线/批处理专用集群(Long-Context Pool)”,实现物理资源隔离,保卫主集群的打字机流式体验;
- 第二级(调度器层):开启 Chunked Prefill 强行切片
- 即使长请求误入通用集群,调度器绝不允许一次性执行 32K GEMM,而是强行将其切分成
Chunk=512的小碎片; - 每一个 Step 将 512 个 Prefill Token 与当前所有正在流式吐字的 Decode 请求混合装箱,将单步耗时严格锁死在 45ms 以内,用户端仅感知轻微平滑减速,绝无 2 秒长顿挫;
- 即使长请求误入通用集群,调度器绝不允许一次性执行 32K GEMM,而是强行将其切分成
- 第三级(显存管理层):Preemption 防护与智能保护
- 识别长请求的显存侵蚀速度,当单机剩余 Block 跌破 20% 时,立即暂停分配新请求,禁止该长请求霸占其余短请求的活跃 Block;
- 避免发生全盘驱逐与重算的恶性循环;
- 第四级(算子内核层):FlashAttention-3 / FlashDecoding 并发优化
- 在底层算子层面,使用支持异步与切分 KV 序列的 FlashDecoding,在注意力计算中避免单 Warp 长期等待,提升多 Head 并发执行效率。
题目 3:推导并解释为什么在 LLM Serving 中,单纯监控 GPU 显存利用率和 GPU SM 利用率是严重误导的?你应该监控哪些核心“黄金指征”?
考察重点
考察候选人是否具备大模型底层硬件与运行机制的第一性原理认知,能否指出传统监控指标在大模型推理场景下的失真本质。标准参考答案
- 为什么 GPU 显存利用率(VRAM Usage)是误导的?
- 现代推理引擎(如 vLLM)在启动阶段就会一次性向操作系统申请几乎全部可用显存(如
gpu_memory_utilization=0.90时,直接吃满 72GB); - 从
nvidia-smi来看,显存利用率永远是 90% 恒定不变!你根本看不出当前系统到底是一个请求都没有,还是已经濒临 OOM 的边缘! - 真实指标:必须监控推理框架暴露的
vllm:gpu_cache_usage_factor(KV Cache 实际占用比例) 与vllm:num_free_gpu_blocks!
- 现代推理引擎(如 vLLM)在启动阶段就会一次性向操作系统申请几乎全部可用显存(如
- 为什么 GPU SM 利用率(GPU Utilization %)是误导的?
nvidia-smi报告的 GPU 利用率,本质上只是“在某段采样时间内,至少有一个 SM 处于非空闲状态的时间占比”;- 在 Decode 阶段,GPU 处于强烈的 Memory-Bound(显存带宽瓶颈),SM 核心的 Tensor Cores 绝大部分时间在等 HBM 搬运权重,实际计算单元利用率可能连 10% 都不到,但
nvidia-smi依然显示 GPU 100% 忙碌! - 反过来,如果发生抢占重算,SM 利用率也会高达 100%,但这 100% 是在做完全无意义的自杀式重算!
- 一线生产必须盯死的三组“黄金指征”:
- 指征一(排队与健康水线):
vllm:num_requests_waiting(等待队列)、vllm:num_requests_running以及vllm:num_preempted_requests(抢占计数器,只要 >0 必须立即报警); - 指征二(用户体验核心 SLO):P90/P99 TTFT(首字响应)、P90/P99 TPOT(流式吐字间隔)与 ITL 抖动方差;
- 指征三(系统真实产出):Goodput(满足 SLO 的有效 Token 吞吐率) 与 Prefix Cache 命中率。
- 指征一(排队与健康水线):
🎨 【配图工坊生图 Prompt 暂存区 · 生成配图后可一键整块删除】
提示:本区块仅供创作者生成 Midjourney / DALL-E 3 架构配图使用。图片生成并归档至 assets 目录后,可直接删除本区块,不影响正文章节与目录结构。
蓝图 1:大模型在线推理容量规划、SLO 治理与排障全景工坊
- 文件路径:
assets/ringi_36_overview.png - 核心中文标签:
【智能AI网关】、【显存四账本】、【PagedAttention池】、【Goodput治理】、【故障自愈Runbook】
🇨🇳 中文直接生图指令(推荐直接发给 ChatGPT / DALL-E 3):
🌐 中英双语精准 Prompt(Midjourney / DALL-E 3 专用):
蓝图 2:线上级联雪崩事故传导时序图
- 文件路径:
assets/ringi_36_crash_timeline.png - 核心中文标签:
【长文本炸弹】、【显存耗尽】、【抢占驱逐】、【重试踩踏】、【幽灵生成】
🇨🇳 中文直接生图指令(推荐直接发给 ChatGPT / DALL-E 3):
🌐 中英双语精准 Prompt(Midjourney / DALL-E 3 专用):
蓝图 3:Throughput 与 Goodput 帕累托边界与崩溃悬崖
- 文件路径:
assets/ringi_36_pareto_curve.png - 核心中文标签:
【有效好吞吐】、【虚高假吞吐】、【黄金拐点】、【SLO达标区】、【雪崩红区】
🇨🇳 中文直接生图指令(推荐直接发给 ChatGPT / DALL-E 3):
🌐 中英双语精准 Prompt(Midjourney / DALL-E 3 专用):