🏛️ 第35讲:算存矛盾与解耦革命——分布式推理并行拓扑(TP/PP/DP/EP)与 PD 分离架构(Prefill-Decode Disaggregation)全景攻防
主讲人:👓 Ringi(大厂 AI Infrastructure 工程师)
所属模块:Module 05: LLM 在线推理系统与性能工程
篇章范式:🚀 LLM 推理服务与高性能 Serving 篇(Inference Serving & Systems Paradigm)
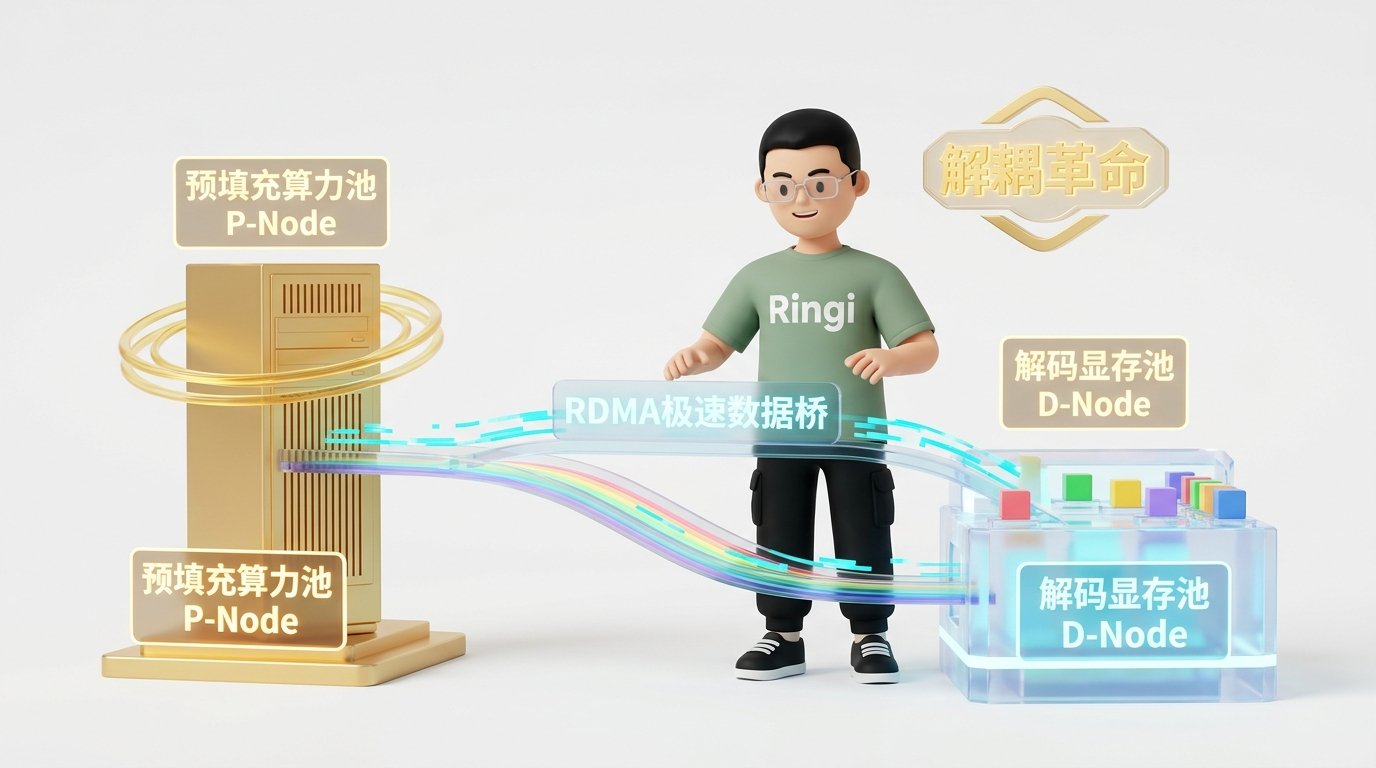
核心导读:在前面的课程中,我们攻克了 PagedAttention 的分页显存革命、Continuous Batching 动态调度,以及 vLLM 核心加速引擎(Prefix Caching、CUDA Graph、量化与投机采样)。然而,当你在真实企业级智算中心面对 32K、128K 乃至 1M 的超长上下文在线请求时,传统将 Prefill(首字预填充)与 Decode(自回归解码)捆绑在同一组 GPU 上的“合设架构(Collocated Serving)”会瞬间暴露出致命的物理死结:一个超长 Prompt 冲入集群,瞬时吞噬全部 Tensor Cores,导致几十个正在稳定吐字的 Decode 请求出现数十倍的长尾延迟突刺(P99 TPOT 飙升破秒),SLO 彻底崩溃!本讲我们将从第一性原理出发,系统梳理大模型推理场景下 TP/PP/DP/EP 四大并行拓扑的物理延迟边界,彻底剖析 Prefill(Compute-Bound)与 Decode(Memory-Bound)的硬件资源错配,并全面拆解下一代分布式 Serving 的终极形态——PD 分离架构(Prefill-Decode Disaggregation)。我们将深入 KV Cache 跨节点高速传输设计空间(RDMA、Layerwise 流水线隐藏、Push vs Pull)、分层缓存存储池(Mooncake)、全局智算调度(Conductor)与大厂真实容量规划。
📑 目录导航
- 0. Ringi 开场:生产真实现场与痛点冲突
- 1. 分布式推理并行拓扑与通信延迟边界(TP / PP / DP / EP)
- 2. PD 分离架构第一性原理:计算密集与访存密集的物理死结
- 3. 核心技术深水区:KV Cache 跨节点高速传输与设计空间
- 4. 工业级 PD 分离开源架构全景剖析(DistServe / Mooncake / vLLM V1)
- 5. 全局智算调度器与生产容量规划(Global Conductor & Capacity Planning)
- 6. 动手实战与代码实验室(Minimal Runnable Code)
- 7. Ringi 避坑指南与生产黄金准则
- 8. Ringi 5 点核心速记口诀、自我检验清单与课后深度思考题
- 9. 📚 参考资料与核心源码/经典论文指引
- 附录:Appendix A — 大厂硬核高频面试题与白板推导(Interview Drill)
- 🎨 【配图工坊生图 Prompt 暂存区 · 生成配图后可一键整块删除】
0. Ringi 开场:生产真实现场与痛点冲突
0.1 真实工程矛盾:当 100K 长文本 Prefill 砸向集群,为什么所有在线用户的打字机瞬间集体卡死?
在传统的模型服务架构中,几乎所有主流引擎(从最早的 FasterTransformer、TGI 到 vLLM 初期)都采用了一种极其符合直觉的架构设计——合设模式(Collocated Serving): 一个推理节点(无论是单卡还是 8 卡 TP 实例)同时负责处理这个请求的完整生命周期。请求来了,这组 GPU 先跑 Prefill 算出一堆 KV Cache;接着,同一组 GPU 原地转入 Decode,一个词接一个词地自回归吐字,直到输出<|endoftext|>。
在短文本、低并发的微调演示场景下,合设模式工作得相当平稳。但是,一旦将业务推向长文本问答、代码仓库分析、法律合同审查或 RAG 检索增强等真实企业级场景时,整个系统的性能表现会突然出现断崖式崩塌! 请观察下面这个在生产机房中每天都在上演的“灾难时刻”:
- 实例正在为 40 个在线用户并发执行自回归解码(Decode),每个用户的客户端正以丝滑的 35 Tokens/s(单步延迟约 28ms)匀速打印字句,用户体验极佳;
- 此时,突然有一个用户上传了一篇 64KB 的技术文档,发起了一个包含 32,000 个 Token 的分析请求;
- 调度器按照 Continuous Batching 规则将这个长 Prompt 纳入当前批次。
- 灾难瞬间降临:GPU 上的数十个 Streaming Multiprocessor(SM)和数百个 Tensor Cores 立刻被这个 32K Token 的巨型矩阵乘法(GEMM)吃得干干净净!
- 在接下来的 800 毫秒 内,整个 GPU 的计算核心处于绝对饱和状态;
- 而那 40 个正在等待吐字的普通用户,其客户端的打字机瞬间定格卡死! 原本 28ms 的字间延迟(TPOT)在一瞬间被强行拉长到 828ms!
- 用户的直观感受是:页面突然陷入卡顿假死,过了将近一秒钟才极其突兀地喷出下一个词。
0.2 线上真实事故复盘:某头部金融 RAG 助手合设部署遭遇长尾延迟雪崩——P99 TPOT 飙升破 3 秒,SLO 全面破产
2024 年秋,国内某头部券商上线了一套基于 LLaMA-3-70B 的智能投研助手,部署在 16 台 8 卡 H800(共 128 张 GPU)上,采用业界标准的 vLLM 合设集群方案,配置了 Tensor Parallelism (TP=8),开启了 Continuous Batching 与 Chunked Prefill(chunk_size=512)。 业务刚上线时,平均 Prompt 长度只有 500 Tokens,系统 P99 TTFT 为 320ms,P99 TPOT 为 32ms,服务等级目标(SLO,要求 P99 TPOT < 50ms)达成率高达 99.6%。 事故爆发:研报季流量突变 随着财报季来临,投研分析师们开始疯狂向系统批量投喂长达 40~80 页的上市企业财报 PDF(Prompt 长度普遍在 25,000 ~ 65,000 Tokens 之间):- 现象一(P99 延迟失控):系统的吞吐量并没有显著下降,但客户端监控报警全线飙红。P99 TPOT 从 32ms 狂飙至 3,850ms(恶化超 100 倍!),大量的在线前端请求触发超时熔断,用户投诉铺天盖地;
- 现象二(Chunked Prefill 救火失败):运维团队紧急将 Chunked Prefill 的分块大小从 512 调低到 256,试图为 Decode 腾出计算时间。结果发现:TPOT 抖动确实略有收敛(降到 800ms),但 TTFT 出现了灾难性膨胀!一个 64K 的研报请求需要被切分成 256 个 Chunk 逐步执行,光是完成预填充拿到第一个字,就需要等待 超过 12 秒!
- 现象三(硬件算力严重浪费):从监控上看,GPU 的 HBM 显存使用率常年维持在 95% 以上(被超长 KV Cache 占满),但 GPU 的 Tensor Core 算力利用率(MFU)在 Decode 阶段却凄惨地徘徊在 12% 左右!价值数千万元的高性能 H800 服务器,其昂贵的计算核心绝大部分时间都在空转等待 HBM 读数!
0.3 合设架构(Collocated)vs 解耦架构(Disaggregated)全景特性速查表
1. 分布式推理并行拓扑与通信延迟边界(TP / PP / DP / EP)
💡 架构全景速览:在深潜源码前,先在白板上建立坚不可摧的分布式推理拓扑、PD 分离架构与 KV Cache RDMA 传输底账。在拆解 PD 分离之前,我们必须首先在全栈视角下回答一个看似简单却极易踩坑的底层问题:在分布式推理场景下,经典的四大并行拓扑(TP、PP、DP、EP)是如何运行的?它们的硬件延迟边界究竟在哪里?

1.1 推理场景下的 TP(张量并行):为什么机内 NVLink 是生死底线?Decode 阶段小 Batch 对 AllReduce 延迟的极速反噬
在大模型训练中,我们常用 TP=8 将一个巨型模型的权重按行(Row Parallel)或按列(Column Parallel)切分到 8 张卡上。在 Transformer 的自注意力(Attention)与前馈网络(MLP)中,每一层都需要进行两次全规约(AllReduce)操作。为什么训练可以接受,而在线推理 Decode 阶段对 TP 的通信延迟如此致命?
我们用真实生产数据来算一笔账:- 在训练阶段:Batch Size 通常很大(例如 1024 Tokens),计算时间长达数十毫秒,单次机内 AllReduce 耗时约 ,通信时间在总时间中占比不足 5%,可以被计算轻松掩盖;
- 在推理 Decode 阶段:每个活跃请求每次只处理 1 个 Token!假设当前并发批次 ,矩阵维度为 。这根本不是标准的矩阵乘法(GEMM),而是访存受限的矩阵向量乘(GEMV)! 在 NVIDIA H100 GPU 上,这样一个极小规模的 GEMV 计算内核执行时间仅仅需要 !
- 机内 NVLink 通信:单次跨卡 AllReduce 硬件底噪时延在 左右;
- 单层 Transformer:包含 1 次 Attention 输出投影 AllReduce + 1 次 MLP 下投影 AllReduce = 2 次 AllReduce;
- 80 层的 LLaMA-3-70B 模型:单个 Decode Token 步进中,总共需要连续串行执行:
- 纯通信等待时间:
👓 Ringi 工程师铁律:
推理场景下的张量并行(TP)绝不能跨越机内物理拓扑边界!TP 的规模上限被物理锁死在单台服务器的最大 GPU 槽位数(通常为 8 卡 NVLink)。在 Decode 阶段,盲目追求大 TP 不仅无法降低单步延迟,反而会因为频繁的 AllReduce 硬件同步底噪导致 TPOT 严重恶化!
1.2 推理场景下的 PP(流水线并行):为什么 1F1B 在低并发推理中全是气泡(Bubble)?
在分布式训练中,流水线并行(PP)依靠将巨型 Batch 切分为成百上千个微批次(Micro-batch),通过精巧的 1F1B(One Forward, One Backward)调度让各个 Stage 像流水线工人一样持续满负荷运转,气泡率可以被压制到 10% 以下。 但在在线推理(尤其是自回归 Decode 阶段),PP 几乎是一个“吞吐陷阱”:- 请求异步到达:在线推理的请求具有随机性与泊松分布特征,无法凑齐数百个均匀的微批次;
- 气泡率数学定理:如果当前批次规模为 ,流水线级数为 ,则推理前向传播的气泡率公式为:
- 假设 (模型切在 4 台节点上),当线上并发较低、 时:
1.3 DP(数据并行)与分布式前缀路由:从简单副本扩展到集群全局前缀共享
数据并行(DP)在推理中表现为完全独立的服务实例复制: 每个 DP Worker 持有完整的模型权重副本(可能自身内部开启了 TP=8),独立接收并处理来自 API Gateway 的请求。 在现代长文本推理中,DP 的演进重点已经从简单的 Round-Robin(轮询)进化为 前缀感知路由(Cache-Aware Routing):- 传统无脑轮询:用户 A 针对某篇长研报发起了 5 轮对话,请求被随机分发到 DP-Node 1、DP-Node 3、DP-Node 2… 导致每台机器都在重复计算并缓存该研报的 KV Cache,显存被极度重复浪费;
- 现代分布式哈希路由:网关提取请求中 System Prompt 或历史文档的 SHA256 哈希值,采用**一致性哈希(Consistent Hashing)**将同一主题的会话固定调度到同一组 DP 节点上,使得节点本地的 Prefix Cache 命中率飙升至 80% 以上!
1.4 EP(专家并行)在 MoE 推理中的实战落地:DeepSeek-V2/V3 万亿 MoE 的跨机 All-to-All 挑战
随着 DeepSeek-V2、DeepSeek-V3 等顶级开源 MoE 架构的爆发,大模型推理全面进入了专家并行(Expert Parallelism, EP)时代:- 以 DeepSeek-V3 为例,总参数量高达 671B,包含 256 个细粒度路由专家(Routed Experts)与 1 个共享专家(Shared Expert),每个 Token 动态激活其中的 8 个专家;
- 671B 的权重不可能放在单机 8 卡内,必须通过 EP 切分到多台服务器(如 32 卡、64 卡);
- 在推理计算时:
- 前半段 Attention:使用常规机内 TP 或分布式 DP;
- 路由分拣:Router 算出门控权重后,必须通过 All-to-All 集合通信原语 将属于不同卡上专家的 Token 跨机打散发送过去(Dispatch);
- 各卡专家运算:专有专家计算 FFN 矩阵乘;
- 结果聚合:再次通过 All-to-All 将计算后的隐藏层张量原路收回并求和(Combine)。
🔍 核心矛盾:
Decode 阶段每个 Token 步进都必须经历两次跨机 All-to-All!如果走传统的慢速 NCCL 调度,每次 All-to-All 都会产生毫秒级的网络等待。这也是为什么 DeepSeek 必须自研 DeepEP(低延迟跨机通信库),利用硬件 RDMA 与常驻持久化内核(Persistent Kernel)将通信延迟压制到纳秒级别。
2. PD 分离架构第一性原理:计算密集与访存密集的物理死结
在搞清楚了分布式推理的并行底账后,我们终于可以直面整个推理系统工程中最核心的矛盾:为什么必须将 Prefill 与 Decode 彻底物理拆分?2.1 物理特征两极分化:Prefill 与 Decode 共享硬件的互毁效应
我们使用计算机体系结构的 屋顶线模型(Roofline Model) 来审视这两个阶段:1. Prefill 阶段:典型的 Compute-Bound
假设一个输入 Prompt 长度为 ,隐藏层维度 。 在 Attention 投影中,GEMM 计算量为 。读取一次模型权重需要的显存访问量仅为 。
其算术强度高达: 这远远超越了现代任何 GPU 的平衡转折点! 此时 GPU 的显存总线完全来得及供数,所有计算管线被全部填满,SM 上的 Tensor Cores 在极限轰鸣。
2. Decode 阶段:典型的 Memory-Bound
而在自回归生成的第 步,每个请求只有一个新生成的 Token( )。 此时执行同样的权重矩阵相乘:计算量为 。但为了这区区 3300 万次运算,GPU 必须把整整 33.5 MB 的权重完整地从 HBM 读取一遍!
其算术强度为: 在 H100 GPU(FP16 峰值 989 TFLOPs,HBM3 带宽 3.35 TB/s)上:
- 硬件平衡拐点为 ;
- 算术强度为 1,意味着 H100 强大的 Tensor Cores 只能发挥出不足 1% 的理论算力,剩下的时间全部在痛苦地等待 HBM 慢吞吞地将权重搬运过来!
3. 互毁效应(The Mutual Destruction)
当你强行把这两者调度在同一个 GPU 上组批执行时:- Prefill 摧毁 Decode 的平稳度:Prefill 的大矩阵运算会霸占 SM 调度器和计算单元,正在解码的请求只能在队列中挂起等待,导致 TPOT 出现严重的长尾抖动(Jitter);
- Decode 摧毁 Prefill 的计算能效:Decode 需要常驻海量存量请求的 KV Cache,挤占了极其宝贵的 GPU 显存容量空间,导致 Prefill 无法使用更大的 Batch Size 来跑满算力,TTFT 被迫拉长。
2.2 为什么 Chunked Prefill 只是“镇痛剂”而非“根治药”?
在 vLLM 等合设框架中,为了缓解上述矛盾,社区推出了著名的 Chunked Prefill(分块预填充) 技术: 如果一个用户的 Prompt 长达 8,192 Tokens,调度器不再一次性将其执行完,而是切成 16 个大小为 512 的 Chunk,分步塞进后续的每一个调度 Iteration 中,与存量的 Decode 请求一起拼成混合批次(Mixed Batch)。 Chunked Prefill 为什么无法彻底解决问题?- 显存总线竞争不可消除:在一个 Mixed Batch 中,Decode 依然在疯狂吞噬 HBM 读取带宽,而 Prefill 的中间激活值写入也在争抢显存总线,导致底层访存发生局部冲突,Decode 的延迟依然会上升 20%~40%;
- TTFT 线性劣化:原本一次性可以在 200ms 内算完的 8K Prompt,被强行切成 16 步后,必须经历 16 次调度循环和模型前向,端到端首字延迟(TTFT)往往会暴涨到 1200ms 以上;
- 容量扩缩容死结:当在线业务遭遇“白天高并发短问答(Decode 为主)、夜间批量离线长文档处理(Prefill 为主)”的潮汐流量时,合设集群无法独立对 Prefill 算力或 Decode 显存进行单向弹性扩缩容,导致巨大的资源闲置浪费。
2.3 硬件异构化诉求(Splitwise 原理):算力卡与显存带宽卡的最佳分离实践
在 ISCA 2024 的经典论文 Splitwise 中,系统架构师们指出了合设模式在经济账本上的荒谬之处:- Prefill 节点:只在乎 FLOPS / Dollar(单位算力性价比),它不需要保留海量的长期 KV Cache,处理完 Prompt 就可以将显存释放。因此,它最适合选用配备高密度 Tensor Cores、支持极致低精度算力的高端芯片(如 NVIDIA H100/H800、华为昇腾 910B);
- Decode 节点:只在乎 GB/s per Dollar(单位显存带宽性价比)与 GB per Dollar(单位容量性价比)。它的 Tensor Cores 根本吃不满,昂贵的 FP8/FP16 矩阵乘算力在小 Batch 下纯属摆设。因此,它更适合选用单卡拥有 96GB~144GB 超大显存、高带宽但算力相对较低的性价比芯片(如 NVIDIA H20、L40S、A100-80G)。
💡 核心结论:
PD 分离不仅是软件调度维度的解耦,更是硬件基础设施维度的解耦!它让算力卡专门跑 Prefill,让显存卡专门跑 Decode,在数据中心层面实现了算存比的帕累托最优(Pareto Optimality)。
3. 核心技术深水区:KV Cache 跨节点高速传输与设计空间
一旦我们在物理上把 Prefill 节点(P-Node)与 Decode 节点(D-Node)分开,整个分布式推理系统的生命线就落到了同一个技术咽喉上:Prefill 节点算出来的巨型 KV Cache,究竟该怎么搬运到 Decode 节点上?
3.1 公式五步穿透:大规模 KV Cache 跨机传输量与网络延迟数学小算盘(No Naked Formula 2.0)
很多初入分布式推理领域的工程师往往轻视网络传输,认为“几个张量跨机复制一下能有多慢?”。现在,我们用 No Naked Formula 2.0 将这笔物理账彻底穿透。步骤 1:为什么需要算它?
因为 KV Cache 的跨机网络传输延迟会直接累加在用户的端到端首字延迟(TTFT)之上!如果传输时间甚至超过了 GPU 的 Prefill 计算时间,那么 PD 分离在工程上就是负优化。步骤 2:Mental Model(物理直觉比喻)
把 Prefill 节点想象为中央厨房,把 Decode 节点想象为快餐厅。中央厨房切好了一整箱半成品食材(KV Cache)。如果等整桌 80 道菜全切完,再叫一辆货车(网络)整体运过去,快餐厅在货车到达前只能干等;而如果货车速度不够快,食材甚至会在路上堵半小时。步骤 3:Tiny Calculator(极简数字小算盘)
我们以业界标杆 LLaMA-3-70B(80 层,GQA 机制下 Key/Value 各有 8 个 Head,每个 Head 维度 ) 为例:- 单个 Token、单个 Layer 的 KV 大小:
- Key 张量:
- Value 张量:同样为 ;
- 单层合计:
- 单个 Token 在全部 80 层累积的 KV 大小:
- 当输入 Prompt 长度为 (4K)时:
- 当输入 Prompt 长度为 (32K)时:
- 当输入 Prompt 长度为 (128K)时:
步骤 4:Formal Model(标准物理公式与网络映射)
对于包含 层、每层具有 个 KV 注意力头、头维度为 的模型,在精度字节数为 (FP16/BF16 取 2,FP8 取 1)时,输入序列长度为 的 KV Cache 传输字节量为: 在有效传输带宽为 (GB/s)的网络中,理想跨机传输延迟为:步骤 5:Sanity Check(数量级校验与残酷现实)
我们对比两种常见的数据中心网络环境:- 场景 A:通用数据中心 100 Gbps 网络(有效带宽约 )
- 传输一个 32K Prompt 的 KV Cache(10 GB):
- 结论:在 100G 网络下,光是跨机传输就耗费了将近 1 秒钟!这比 H100 算这 32K Tokens 的时间还要长,PD 分离完全不可行!
- 场景 B:高性能智算中心 400 Gbps RoCE / InfiniBand 网络(有效带宽约 )
- 传输 10 GB KV Cache:
- 若开启 FP8 格式压缩( ): 数据量直接减半至 5 GB, 瞬间压缩至 约 111 ms!
3.2 传输三维设计空间:Push vs Pull、Eager vs Pipelined、完整 vs 增量
针对 KV Cache 的搬运,学术界与工业界(vLLM、LMCache、Mooncake)在系统设计空间上形成了三大维度的决策树:维度一:谁来发起传输?(Push vs Pull)
- Push 模式(以 LMCache 为代表):
- 机制:Prefill 节点知道自己的输出要交给哪台 Decode 节点。算完后,P 节点主动向 D 节点申请物理内存缓冲,通过 RDMA 强行将张量 Push 到 D 节点显存;
- 优缺点:Decode 节点极度省心,数据推到门口立即开算;但需要强耦合的外部协同器提前指定 P-D 绑定关系。
- Pull 模式(以 Mooncake 为代表):
- 机制:Prefill 节点算完将 KV Cache 注册到全局存储池;全局调度器(Conductor)通知 Decode 节点:“你的输入在 Node A 的显存里,去拉吧!”;D 节点按需通过 RDMA 发起 Read 语义拉取;
- 优缺点:架构高度解耦,支持复杂的 1 对多、多对 1 动态调度与重试;但首次 Decode 步进会有拉取启动开销。
维度二:什么时候传输?(Eager vs Pipelined)
- Eager 模式(整包阻塞):
- 等全部 80 层的 Prefill 计算完全结束,再把 10GB 数据打包推向网络。
- 代价:网络传输耗时(如 220ms)100% 暴露在主干时延中,直接导致 TTFT 显著增加。
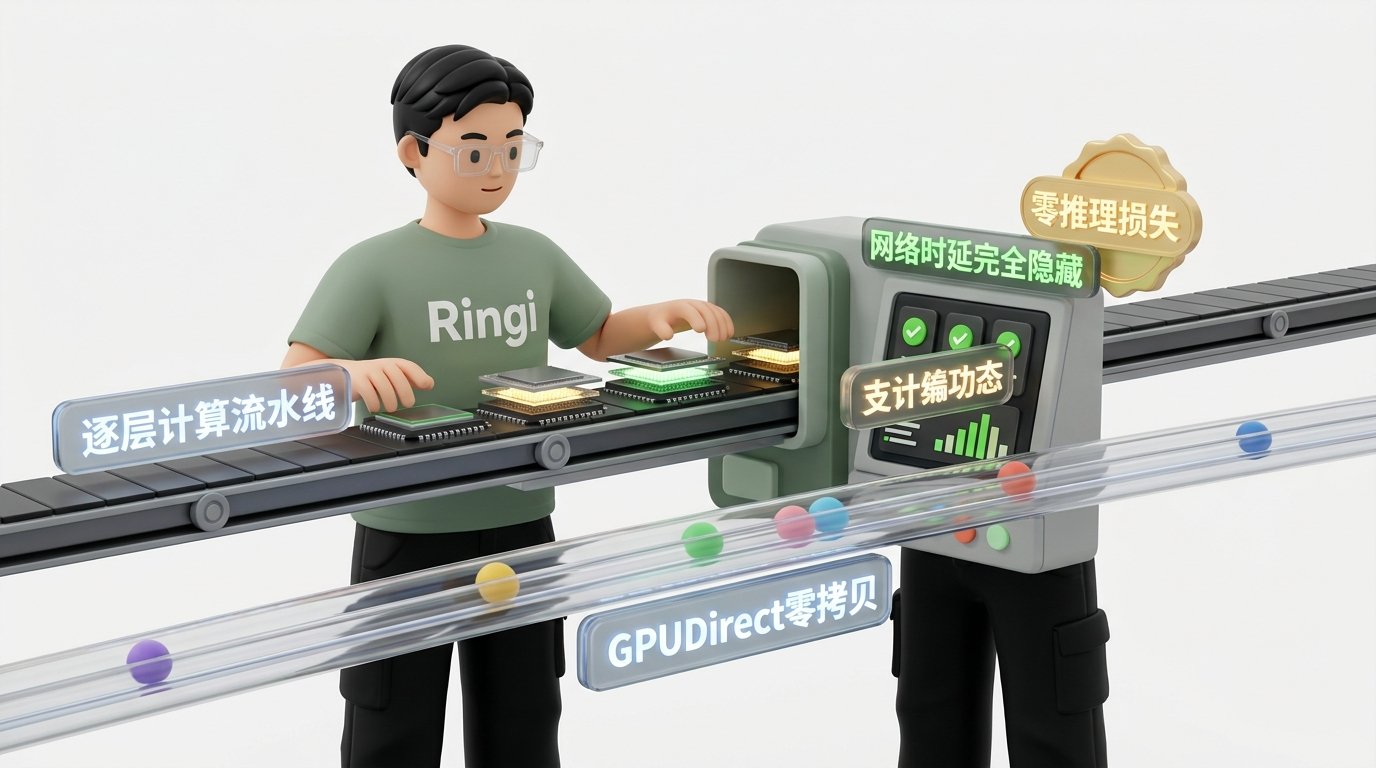
- Pipelined 模式(逐层流水线,Layerwise Overlap):
- 现代 PD 分离的核心标配!在 Prefill 进行时,当 Layer 0 的自注意力算完,立即将 Layer 0 的 KV Cache 抛给后台异步通信流通过 RDMA 发出;
- 当 GPU 在计算 Layer 1 时,网络正在传输 Layer 0;当 GPU 计算 Layer 2 时,网络正在传输 Layer 1…
- 时延收益:80 层网络传输被均匀摊薄在 80 次计算之间,最终只有最后一层(Layer 79)的微小传输时间(约 2.6ms)暴露在外部!网络延迟隐藏率高达 95% 以上!
维度三:传输什么内容?(完整传输 vs 增量传输)
- 完整传输:无论长短,将该 Prompt 涉及的全部 KV Cache 从头到尾推一遍;
- 增量传输(Prefix Delta):
- 结合全局前缀缓存机制:如果 Decode 节点本地已经缓存了该请求前 2,048 个 Token 的 System Prompt,P 节点只传输后半段未命中的新内容;
- 网络传输带宽开销直接下降 50% ~ 90%!
3.3 逐层流水线重叠(Layerwise Pipelining):如何利用 RDMA 将网络搬运时间彻底隐藏?
我们来微观拆解 Layerwise Pipelining 在硬件底层的调度时序: 假设在 NVIDIA H100 节点上,80 层的 70B 模型处理 32K Prompt,每层 Attention 的计算时间大约是 。 单层 32K Token 的 KV Cache 大小约为: 在 400 Gbps RDMA 网络(有效带宽 48 GB/s)下,单层传输耗时为: 看见这个物理奇迹了吗? 单层的网络搬运时间严格小于单层的 GPU 计算时间!4. 工业级 PD 分离开源架构全景剖析(DistServe / Mooncake / vLLM V1)
在当前的开源与工业界,有三个里程碑式的系统彻底定义了 PD 分离的技术走向:4.1 DistServe(OSDI ‘24):Goodput 驱动的解耦设计与两阶段资源独立调优
DistServe 是学术界与系统工程界首次将 PD 分离提升到工业级高度的开山之作。它首次明确提出了**“良好吞吐量(Goodput)”**的概念:传统的吞吐量(Throughput)只关注每秒处理了多少 Token,即使一个请求耗时 10 秒超时了,这些废 Token 依然被计入吞吐量;
Goodput 则极为严苛:只有同时满足 TTFT SLO(如 < 500ms)和 TPOT SLO(如 < 30ms)的成功请求,其产生的 Token 才能计入有效产出!
DistServe 的核心突破:
- 解除并行策略捆绑:
- 在合设模式下,Prefill 和 Decode 必须使用相同的 TP(如 TP=8)。
- DistServe 指出:Prefill 需要大 TP(如 TP=8)来降低单请求延迟;但 Decode 由于受限于小 Batch 下 AllReduce 的通信延迟,在 TP=1 或 TP=2 时吞吐与单步能效反而最高!
- 通过解耦,P 节点配置 TP=8,D 节点配置 TP=1 或 2,使得集群在同等成本下的 Goodput 飙升了 2 到 3 倍。
- 两阶段资源独立调优算法:根据线上实时流量中的 Prompt 长度分布与 Output 长度分布,通过自动化 Profiling 模型动态计算 P 节点与 D 节点的实例数量配比。
4.2 Mooncake(Moonshot Kimi):以 KV Cache 为中心的多层分布式存储池架构
月之暗面(Moonshot AI)为其国民级应用 Kimi 智能助手自研了 Mooncake 架构。面对百万级(1M)Token 上下文,Mooncake 做出了一个极其大胆的架构认知升级:在大模型推理集群中,算力不再是第一调度公民,KV Cache 存储才是!
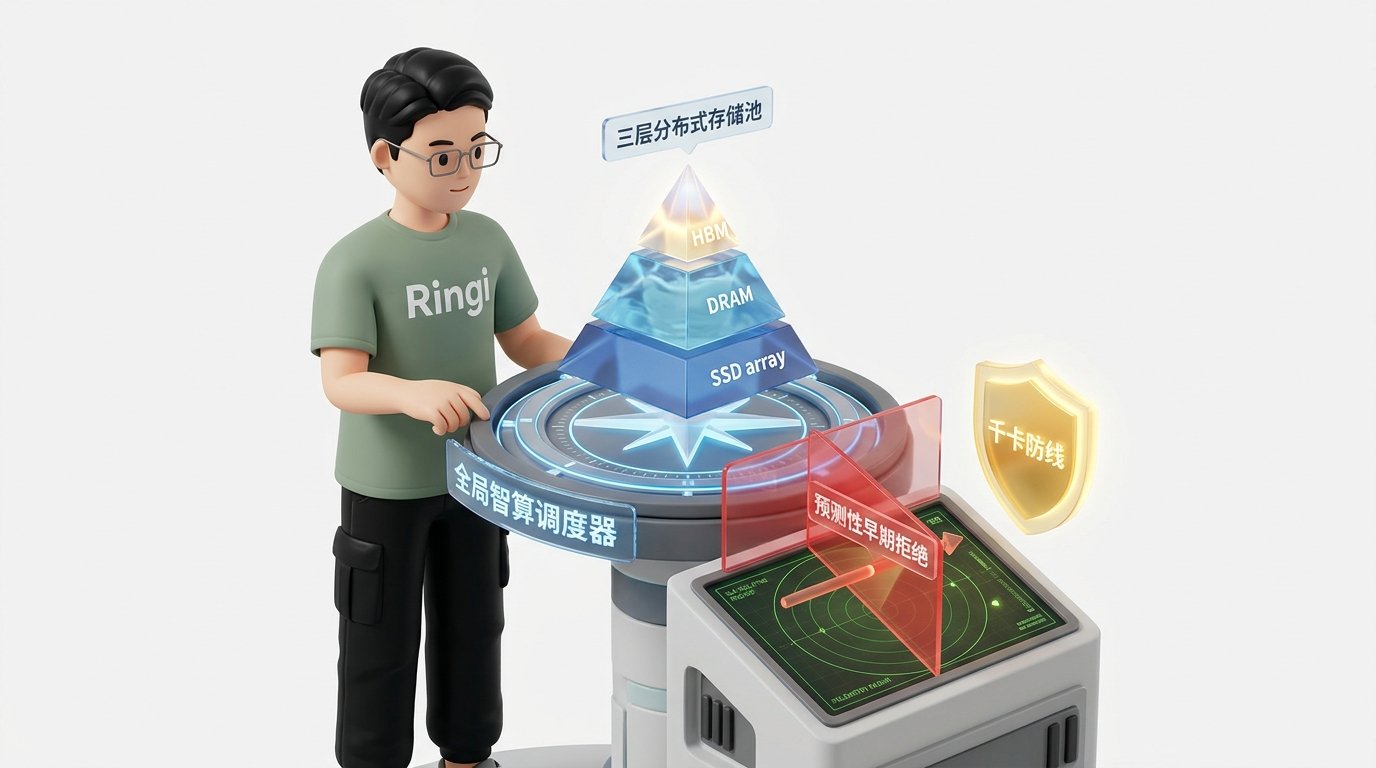
1. 三层分布式 KV 存储池(Hierarchical Memory Pool)
Mooncake 彻底打破了“KV Cache 只能存在 GPU 显存中”的局限,构建了一个全局的共享存储池:- L1(GPU HBM):容量最小(每卡 80GB),延迟最低(< 1μs),存放当前正在解码活跃请求的最热数据;
- L2(Host DRAM 跨机内存池):通过主板 PCIe 5.0 与高速 RDMA 网卡将集群数十台机器的主机内存(单机通常有 1TB~2TB DRAM)连成统一的分布式内存缓冲池。跨机访问延迟在 之间,极其适合存放几分钟内刚完成 Prefill 的长上下文;
- L3(Local NVMe SSD 池):挂载单盘读取速度高达 7 GB/s 的企业级 U.2 PCIe NVMe 固态硬盘,构建数十 TB 级别的本地持久化缓存,用于支撑超大文档的前缀复用。
2. 分块管道并行(CPP,Chunked Pipeline Parallelism)
Mooncake 自研了高性能 RDMA 通信组件 Messenger,采用 1024 Token/Chunk 的细粒度分块,在 P 节点计算和跨机传输之间实现纯硬件级的全流水线掩盖。根据其公开论文与工业落地数据,在 128K~1M 极限长文本下,Mooncake 比传统 vLLM 方案实现了高达 525% 的吞吐量提升,SLO 达标率达到 100%。4.3 vLLM V1 KV Connector 规范:标准解耦接口与可插拔后端抽象
2025 年初,vLLM 官方合入了划时代的 V1 架构重构(PR #15960),正式确立了标准化可插拔的KVConnectorBase_V1 架构契约:
- 追求最简单机对可插拔:挂接 LMCache;
- 追求大规模智算集群全局池化:挂接 Mooncake;
- 追求跨异构算力网络传输:挂接 NVIDIA NIXL。
5. 全局智算调度器与生产容量规划(Global Conductor & Capacity Planning)
当集群拥有了数十个 P 节点与数百个 D 节点后,最棘手的问题就转移到了最前置的**全局智能路由器(Global Conductor)**上。5.1 全局路由编排:前缀命中感知路由(Cache-Aware Routing)与动态负载打分模型
当一个新的推理请求到达 API 网关时,Conductor 必须在 5 毫秒内 回答两个问题:- 这个请求应该发给哪一个 Prefill 节点去算?
- 算出来的 KV Cache 应该送去哪一个 Decode 节点去接力?
- (前缀缓存命中率,Cache Hit Ratio):Conductor 查询全局前缀树(Radix Tree)。如果发现 P 节点 已经缓存了该请求 80% 的前缀( ),则意味着只需要计算剩下的 20%,不仅计算极快,而且需要传输的 KV Cache 极少;
- :该序列长度在硬件上的理论预填充耗时;
- (队列等待时延):实例 当前排队等待任务的预估清空时间;
- (自适应负载平衡权重):在业务高峰期调大 (优先保障各个节点不被撑爆),在业务平稳期调小 (优先追求前缀命中与算力节省)。
5.2 预测性早期拒绝(Predictive Early Rejection):保护高载集群的有效产出(Goodput)
在传统的合设系统中,一旦集群突发 20 倍瞬时洪峰,调度器会老老实实接收所有请求排队。其结果是:所有请求都在超时,所有计算都在白费! 用户在前端等了 10 秒后怒而关掉网页,而后端还在傻傻地为这个早已关闭的会话消耗着宝贵的 GPU 算力。 PD 分离下的前馈式预测拒绝(Predictive Early Rejection):
- 当请求到达 P 节点时,Conductor 不仅评估 P 节点能不能算完,更直接穿透预测未来 D 节点的负载状态;
- 如果根据预估的生成长度,预测该请求到达 D 节点后由于显存排队必然会违反 TPOT SLO;
- 系统在 Prefill 计算发起前 0 毫秒立即返回 HTTP 429 或主动降级!
- 这一机制截断了长尾无效计算,将全集群在极限过载场景下的有效吞吐量(Goodput)提升了 70% 以上!
5.3 生产级 P:D 节点动态配比算盘:基于业务流输入输出比(Lin / Lout)的容量规划
在大厂规划采购或搭建推理集群时,究竟该买多少张卡做 Prefill,买多少张卡做 Decode?绝不能拍脑袋决定。 我们建立一个严密的容量平衡方程: 设业务日志统计显示:- 平均输入 Prompt 长度为 ;
- 平均输出生成长度为 ;
- 单卡跑 Prefill 的理论吞吐为 (Tokens/s);
- 单卡跑 Decode 的理论稳态吞吐为 (Tokens/s)。
真实工程算例:
- 假设在 70B 模型上:
- H100 SXM 单卡 Prefill 吞吐约为 ;
- H20 单卡在满载并发下的 Decode 吞吐约为 ;
- 算力比值 ;
- 业务场景一(长输入、短输出的摘要/搜索场景): , 。
- 业务场景二(短输入、长推理思维链的 R1/o1 深度推理场景): , 。
👓 Ringi 工程师洞察:
没有固定不变的 P:D 配比!随着 DeepSeek-R1、OpenAI o1/o3 这类长思考、长推理链(Long-Thinking)模型的普及,未来大模型推理集群将呈现极端倾向于 Decode 节点的“超大规模自回归池”,PD 分离是这一范式转移下的必经之路。
6. 动手实战与代码实验室(Minimal Runnable Code)
6.1 实验一:基于真实张量流与跨节点模拟的 PD 分离与合设性能对比实验器(pd_disaggregation_simulator.py)
本实验使用纯 Python 标准库与数学模型,真实刻画长文本请求在**传统合设模式(Collocated Serving)与PD 分离架构(Disaggregated Serving)**下的运行轨迹。脚本直接模拟并发请求到达、计算与访存资源争用、网络 RDMA 延迟,并打印清晰的 TTFT、TPOT、P99 长尾延迟及违约率报表!
控制台安全输出预期:
6.2 实验二:工业级 KV Cache 跨机逐层流水线传输模拟器(layerwise_kv_streamer.py)
本实验模拟 Layerwise Pipelining(逐层流水线异步掩盖) 的真实逻辑,演示 GPU 计算主线程与异步网络搬运线程如何利用流水线将 10GB KV Cache 的传输耗时压缩至几乎不可见。
7. Ringi 避坑指南与生产黄金准则
7.1 8 大常见小白认知误区 vs 大厂 AI Infra 正确物理认知
7.2 生产 PD 分离系统落地与稳定性保障黄金 Checklist
- 1. 【网络物理底座检验】:全集群必须部署双口 200Gbps 或 400Gbps RDMA 网卡,并配置 PFC(基于优先级的流控)与 ECN,确保在大块 KV 持续突发传输时不发生严重丢包与重传。
- 2. 【GPUDirect RDMA 验证】:通过
nd_read_bandwidth或ib_write_bw实测 GPU-to-GPU 跨机内存直通带宽,确保跨机传输完全绕过 Host CPU 内存与内存拷贝。 - 3. 【传输流水线配置】:强制在引擎层启用 Layerwise Pipelining(逐层流水线异步传输),确保最后一层网络延迟暴露在 以内。
- 4. 【动态 P:D 配比监控】:在 Prometheus 中实时采集集群输入输出 Token 比例 ,建立弹性编排规则,依据潮汐负载动态调整 P 节点与 D 节点的容器副本数量。
- 5. 【前缀感知路由(Cache-Aware)生效】:网关层必须部署分布式前缀哈希树,确保长 Prompt 请求命中同一 P 节点本地缓存的概率 。
- 6. 【双重 SLO 熔断阈值建立】:严格分离 TTFT SLO(如 P99 < 800ms)与 TPOT SLO(如 P99 < 40ms),并在 Conductor 调度器中配置预测性丢弃阈值。
- 7. 【显存背压与换出机制】:为 D 节点配置 Host DRAM 二级缓存池,当突发并发导致 GPU HBM 水位超过 92% 时,自动触发异步 Swapping,杜绝进程因 CUDA OOM 暴毙。
- 8. 【KV Cache 精度对齐】:在支持的硬件上(如 Hopper 架构)全面推进 FP8 KV Cache 线路压缩传输,直接将跨机网络物理带宽消耗砍半。
8. Ringi 5 点核心速记口诀、自我检验清单与课后深度思考题
8.1 5 点押韵核心速记口诀
8.2 10 条白板自我检验清单
- 1. 能否脱口而出 Prefill 与 Decode 两个阶段的算术强度(Arithmetic Intensity)数量级差异?
- 2. 为什么在小 Batch 下,张量并行(TP)超过 8 卡会导致单步延迟反而增加?
- 3. 为什么流水线并行(PP)在低并发推理场景下的气泡率高达 ?
- 4. 能否在白板上手算一个 70B 模型在 64K 上下文下的 KV Cache 物理体量(GB)?
- 5. Chunked Prefill 的物理机制是什么?为什么它不能彻底根除 Decode 的长尾延迟抖动?
- 6. 什么是 Splitwise 硬件异构化理论?为什么 Prefill 适合算力卡而 Decode 适合显存带宽卡?
- 7. 什么是 Layerwise Pipelining?为什么单层的 RDMA 传输时间可以被单层的 Attention 计算时间完全掩盖?
- 8. Push 模式与 Pull-with-cache 模式在 KV Cache 跨机搬运中各有什么优劣和适用场景?
- 9. Mooncake 架构的 L1/L2/L3 三层存储池分别是什么硬件?Conductor 的打分公式如何权衡命中率与队列时延?
- 10. 什么是预测性早期拒绝(Predictive Early Rejection)?它如何保护高载集群的 Goodput?
8.3 3 道高阶开放式课后思考题(含极端 Corner Case)
- 【极限网络丢包 Corner Case】:在 PD 分离架构中,假设某台 P 节点正在通过 RDMA 逐层流水线向 D 节点传输一个 64K 上下文的 KV Cache。当传输到第 72 层时,机房交换机由于拥塞丢弃了该 RDMA QP(Queue Pair)的几个数据包,导致 RDMA 连接断开超时。此时 D 节点尚未开始生成第一个 Token。作为系统架构师,你该如何设计容灾状态机?是让 P 节点重传整包、仅重传失败层,还是将该请求降级在 P 节点原地执行 Decode?各种方案的延迟代价与显存风险是什么?
- 【超长思考链模型(Reasoning Models)冲击】:随着类似 DeepSeek-R1、OpenAI o1 这类倾向于输出数万 Token 思维链(CoT)的模型成为主流,传统的输入远大于输出( )假设被彻底颠覆,变成了输出远大于输入( )。在这种业务场景下,PD 分离架构的瓶颈会发生什么转移?P 节点和 D 节点的服务器配比会发生什么极限倾斜?
- 【异构芯片混编下的 KV Cache 兼容性】:假设某智算中心为了降本增效,采用国产算力卡跑 Prefill(生成特定布局的 KV Cache),而使用 NVIDIA A100 跑 Decode。此时两端硬件的底层 PagedAttention Block 内存布局(Layout)、对齐要求(Alignment)以及浮点量化格式可能完全不同。如果要在它们之间实现微秒级的跨机 RDMA 直通传输,中间的格式转换开销该如何抹平?
9. 📚 参考资料与核心源码/经典论文指引
- DistServe 经典论文:
- Zhong et al., “DistServe: Disaggregating Prefill and Decoding for Goodput-driven LLM Serving”, OSDI 2024.
- 详见本地知识库:05-2 PD分离.md(AIInfra/04LongInfer)
- Mooncake 生产架构论文与源码:
- Qin et al., “Mooncake: A KVCache-centric Disaggregated Architecture for LLM Serving”, arXiv:2407.00079.
- 详见本地知识库:mooncake_architecture.md(AI-fundamentals) 与 Mooncake.md(llm-action)
- Splitwise 硬件解耦经典论文:
- Patel et al., “Splitwise: Efficient Generative LLM Serving Using Disaggregated Prefill and Decode”, ISCA 2024.
- vLLM V1 KV Connector 核心规范:
- vLLM Project, “PR #15960: Standardized KV Connector API for Disaggregated Serving”, 2025.
- 详见本地知识库:01_disaggregated_prefill_kv_transfer.md(AI-fundamentals)
- 分布式推理并行拓扑深度剖析:
- 详见本地知识库:parallelism_strategies.md(AI-fundamentals) 与 Code02PDDispatch.md(AIInfra/03Dispatch)
附录:Appendix A — 大厂硬核高频面试题与白板推导(Interview Drill)
面试真题 1:请从底层硬件执行机制解释,为什么在小 Batch 并发下,推理模型的 Tensor Parallelism (TP) 超过 8 卡会导致性能大幅下降甚至不如单卡?
考察维度:GPU 硬件执行模型、GEMV 算子特性、集合通信底层底噪、Roofline 模型。
标准参考答案:
- GEMV 计算耗时极度微小(微秒级):在小 Batch(例如 到 )的 Decode 阶段,自回归计算退化为向量与矩阵相乘(GEMV)。在现代 GPU(如 H100)上,单个切分后的 GEMV 内核计算时间仅在 左右;
- 通信同步底噪反客为主:TP 每一个 Transformer 层需要严格串行执行 2 次 AllReduce 操作。即便在机内 NVLink 900 GB/s 的超高带宽下,由于多卡软硬件同步屏障(Barrier)、GPU Warp 调度与内核启动开销,单次 AllReduce 的最小物理底噪延迟为 ;
- 多卡通信惩罚超过算力红利:当 TP 从 8 卡扩展到跨机 16 卡时,必须跨越 PCIe 和 InfiniBand 网络,单次 AllReduce 时延飙升至 。整整 80 层的模型累积 160 次 AllReduce,通信等待时间从 1ms 暴增至 6ms 以上!此时通信等待时间已远远压倒计算时间,计算单元绝大多数时间处于阻塞挂起状态,导致推理延迟严重恶化。因此,推理场景下的 TP 严格被限制在单机 8 卡 NVLink 拓扑以内。
面试真题 2:白板手算:一个 70B 模型(80 层,GQA 8 Heads,头维度 128,BF16 精度)在 64K 上下文下,Prefill 产生多大体量的 KV Cache?在 400Gbps RDMA 网络下需传输多久?如何设计 Layer-by-layer 重叠隐藏网络耗时?
考察维度:KV Cache 容量手算、网络带宽理论估算、Layerwise Pipelining 异步流工程设计。
标准参考答案:
- KV Cache 体量精准手算:
- 单 Token、单层 KV 尺寸:
- 单 Token 全部 80 层总和:
- 64K(65,536 Tokens)总 KV Cache 体量:
- 网络传输物理耗时估算:
- 400Gbps RDMA 网络(RoCE v2 / IB)的有效双向单向传输带宽约为 ;
- 20.0 GB 数据的纯网络线缆传输耗时为:
- Layerwise Pipelining 重叠隐藏设计:
- 单层计算耗时 vs 单层传输耗时:
- 单层传输耗时: ;
- 70B 模型在 H100 8 卡上计算 64K Tokens 的单层 Attention+FFN 耗时大约为 ;
- 流水线掩盖机制:
- 当 GPU 计算完 Layer 的瞬间,立即将其 KV Cache 挂入独立的后台 CUDA Stream,触发 GPUDirect RDMA 异步发送给 Decode 节点;
- GPU 立即开启 Layer 的前向计算,此时底层网卡正在并发传输 Layer ;
- 因为 ,网络传输完全落入计算的阴影区被彻底掩盖;
- 最终暴露给端到端首字延迟(TTFT)的只有最后一层(Layer 79)的微小网络时延(约 5.5ms),成功将 444ms 的网络传输开销降低了 98% 以上!
面试真题 3:如果 Decode 节点突然遭遇瞬时流量洪峰导致显存即将耗尽(OOM 边缘),在工业级 PD 分离架构下有哪些优雅的降级与背压(Backpressure)防护手段?
考察维度:分布式服务韧性、多级存储换出、全局背压机制、系统容灾设计。
标准参考答案:
- 第一道防线:前馈式准入拒绝(Predictive Early Rejection / Gateway Backpressure):
- Decode 节点向全局 Conductor 实时同步其显存可用块水位;
- 当可用块水位低于安全红线(如 10%)时,Conductor 在 Prefill 节点发起前直接拒绝新接入的长文本请求(返回 HTTP 429),杜绝在 P 节点做无谓计算;
- 第二道防线:基于多层存储的分级换出(Hierarchical KV Cache Swapping):
- 参考 Mooncake 架构,利用高带宽 PCIe 5.0(单向 64 GB/s)将处于长静默期(如等待用户二次追问)的会话 KV Cache 异步热换出到 Host DRAM;
- 当显存进一步告警时,换出到本地 NVMe SSD,瞬间腾出 40%~60% 的 GPU HBM 显存以接纳当前活跃会话;
- 第三道防线:动态降级与临时回退(Chunked Prefill Fallback):
- 将超额的 Prefill 请求临时保留在 P 节点本地,转入短周期的自回归执行(暂时退化为单机服务),通过分布式路由隔离排队,等待 D 节点显存恢复后再迁移状态;
- 第四道防线:优雅抢占与重算(Preemption & Token Recomputation):
- 依据业务优先级(SLA 级别)挑选低优先级的后台长任务暂停,将其 KV Cache 物理块标记为可回收;待高优先级会话生成完毕后,调度器利用其已保存的前缀哈希在 P 节点极速重新预填充恢复。
🎨 【配图工坊生图 Prompt 暂存区 · 生成配图后可一键整块删除】
提示:本区块仅供创作者生成 Midjourney / DALL-E 3 架构配图使用。图片生成并归档至 assets 目录后,可直接删除本区块,不影响正文章节与目录结构。
蓝图 1:分布式推理与 PD 分离架构全景工坊
- 文件路径:
assets/ringi_35_overview.png - 核心中文标签:
预填充算力池 P-Node、解码显存池 D-Node、RDMA极速数据桥、解耦革命
🇨🇳 中文直接生图指令(推荐直接发给 ChatGPT / DALL-E 3):
🌐 中英双语精准 Prompt(Midjourney / DALL-E 3 专用):
蓝图 2:KV Cache 跨节点 RDMA 异步逐层流水线传输工坊
- 文件路径:
assets/ringi_35_kv_rdma_pipeline.png - 核心中文标签:
逐层计算流水线、GPUDirect零拷贝、网络时延完全隐藏、零推理损失
🇨🇳 中文直接生图指令(推荐直接发给 ChatGPT / DALL-E 3):
🌐 中英双语精准 Prompt(Midjourney / DALL-E 3 专用):
蓝图 3:Mooncake 多层存储池与 Conductor 全局智算调度工坊
- 文件路径:
assets/ringi_35_mooncake_conductor.png - 核心中文标签:
全局智算调度器、三层分布式存储池、预测性早期拒绝、千卡防线
🇨🇳 中文直接生图指令(推荐直接发给 ChatGPT / DALL-E 3):
🌐 中英双语精准 Prompt(Midjourney / DALL-E 3 专用):