🏛️ 第32讲:为什么吞吐高长尾却崩了?——LLM 在线推理两阶段(Prefill vs Decode)物理特性与核心 SLO 指标体系深度剖析
主讲人:👓 Ringi(大厂 AI Infrastructure 工程师)
所属模块:Module 05: LLM 在线推理系统与性能工程
篇章范式:🚀 LLM 推理服务与高性能 Serving 篇(Inference Serving & Systems Paradigm)
核心导读:大模型训练是一场追求极限算力吞吐(TFLOPS)的攻坚战,而在线推理(Inference Serving)却是一场在严苛服务等级目标(SLO)约束下、在算力墙与访存墙之间走钢丝的精密工程。为什么把并发数拉满时总吞吐飙升,但前端用户的打字机效果却卡得痛不欲生?为什么砸了数十万元采购的高端 GPU,在生成文字时核心计算单元却大部分时间在“旷工”?本讲不罗列空洞的参数字典,而是从计算体系结构的第一性原理出发,彻底穿透 Prefill(Compute-bound)与 Decode(Memory-bound)的天然物理错配,手算显存账本与 Roofline 平衡点,解构 TTFT、TPOT、Goodput 与 P99 尾延迟的数学本质,并层层推导 Continuous Batching、Chunked Prefill 直至当下前沿 PD 解耦(Disaggregation)架构的演进必然性。
📑 目录导航
- 0. Ringi 开场:生产真实现场与痛点冲突
- 1. 第一性原理穿透:Prefill 与 Decode 两阶段的物理本质与硬件错配
- 2. Roofline 模型硬核投影:为什么砸了几十万的 GPU,Decode 时算力却在“旷工”?
- 3. KV Cache 空间换时间:显存四账本与碎片化陷阱
- 4. 核心 SLO 指标体系:如何用大厂工程标准衡量一次在线推理的“好与坏”
- 5. 请求调度演进之路:从 Static Batching 到 Chunked Prefill 与统一 Token 预算
- 6. 架构前沿演进:PD 解耦(Prefill-Decode Disaggregation)与跨节点 KV 传输
- 7. 动手实战与代码实验室(Minimal Runnable Code)
- 8. Ringi 避坑指南与生产黄金准则
- 9. Ringi 5 点核心速记口诀、自我检验清单与课后深度思考题
- 10. 📚 参考资料与核心源码/经典论文指引
- 附录:Appendix A — 大厂硬核高频面试题与白板推导(Interview Drill)
- 🎨 【配图工坊生图 Prompt 暂存区 · 生成配图后可一键整块删除】
0. Ringi 开场:生产真实现场与痛点冲突
0.1 真实工程矛盾:为什么老板看总吞吐一片大好,前端打字机却“卡在喉咙里”?
在许多初涉大模型在线服务(LLM Serving)的团队里,经常会上演这样一幕荒诞剧: 运维监控大屏上,GPU 利用率稳定在 85%,系统每秒产出的总 Token 数(System Throughput)高达 6,000 Token/s,压测报告上的“平均延迟”只有区区 35ms/Token。CTO 看着报表频频点头,认为集群资源被利用到了极致。 然而,客服后台却早已被核心业务方的投诉塞爆:- 销售团队在前端使用智能话术助手,经常发现打字机光标在回答到一半时突然“窒息僵死”整整半秒钟,随后又像子弹一样噼里啪啦吐出一大串字;
- 研发团队在使用代码补全(Copilot)时,按下快捷键后光标转圈长达 1.5 秒毫无反应,开发者早已手动敲完了代码,补全建议才慢半拍弹出来,体验形同虚设!
0.2 线上真实事故复盘:某代码大模型 Copilot 集群因 16K 长上下文导致全集群 Decode 瞬时冻结 600ms
2024 年秋,国内某头部科技大厂的内部代码辅助生成系统(基于 32B 参数的开源代码基座模型,部署在 8 台双路 8 卡 H800 GPU 服务器上)遭遇了一次严重的服务劣化危机。 该服务承接了全公司数万名工程师的 IDE 代码续写请求。平时请求的 Prompt 平均长度在 200~500 Token 之间,服务配置了当时主流的 Continuous Batching(连续批处理)引擎,单步迭代时间(Step Time)稳定在 25ms 左右,前端打字感极度丝滑。 事故爆发经过:- 流量异常:上午 10:30,某位高级架构师在排查跨模块复杂调用链时,使用 IDE 插件发起了一次全工程上下文代码诊断。插件一次性打包了该工程师工程中的 14 个核心源代码文件,构建了一个高达 16,384 Token 的超长 Prompt;
- 调度抢占:网关将该请求路由至 Node-03 实例。该实例正在处理同批并发的 48 个小代码补全请求(均处于 Decode 逐字吐出阶段);
- 性能雪崩:
- 引擎调度器在下一个 Step 判定将该 16K 的长 Prompt 加入执行批次;
- 为了完成这 16K Token 的 Prefill,GPU 上的 Tensor Cores 被迫拉满执行超大矩阵乘法,这一单步前向传播直接耗时高达 640ms;
- 极其致命的是,在采用未分块的 Continuous Batching 架构下,同处于该批次的另外 48 个请求的 Decode 步骤全部被迫停摆,在 GPU 硬件队列中同步等待整整 640ms!
- 连锁反应:
- 这 48 个请求在前端表现为长达 0.6 秒的绝对停顿,直接打破了人类感官的连贯阈值(>100ms 即感顿挫,>300ms 产生烦躁);
- 前端用户的 IDE 客户端因判定首字超时,自动触发了重试机制,向网关二次注入相同的长代码请求;
- 恶性循环开启:新一轮的长 Prefill 再次霸占 GPU,Node-03 的 P99 延迟瞬间飙升至 2.8 秒,服务彻底进入雪崩状态!
- 上线 Chunked Prefill(分块预填充):强行将任何超过 512 Token 的 Prompt 拆解成若干个固定切片,每一步仅处理一个切片并与 Decode 请求交织混部,将单步最长耗时死死锁在 35ms 以内;
- 规划 Prefill-Decode 解耦(P/D Disaggregation)架构:在长短文本混合的超大规模集群中,彻底把处理长 Prefill 的节点与处理 Decode 的节点在物理机器层级剥离!
0.3 训练(Training)vs 在线推理(Inference Serving)全系统维度对照速查表
许多工程师在从分布式训练转向在线推理时,往往因技术直觉未转换而踩坑。下表从底层硬件、算子特征到系统指标,给出了全景对照:1. 第一性原理穿透:Prefill 与 Decode 两阶段的物理本质与硬件错配
💡 架构全景速览:在深潜源码前,先在白板上建立坚不可摧的 LLM 推理两阶段(Prefill vs Decode)物理本质与核心 SLO 底账。

1.1 自回归接龙的单向因果律:为什么下一个 Token 必须串行等待?
目前以 LLaMA、GPT、Qwen、DeepSeek 为代表的绝大多数主流大语言模型,底层均为基于因果掩码(Causal Mask)的 Decoder-only 架构。 所谓“自回归(Autoregressive)”,在数学上表达为一种单向因果联合概率分解: 在物理时间轴上,这意味着一个铁律:第 个 Token 的生成,必须以前面所有的 个历史 Token 作为上下文输入;没有计算出第 个 Token,整个世界没有任何人能知道第 个 Token 的输入向量是什么!这一不可打破的单向数据依赖,直接将大模型在线推理在时间维度上强行切分为两个截然不同的阶段:
- Prefill 阶段(预填充 / 上下文理解):用户把整段 Prompt(例如 500 个 Token)发送过来。因为这 500 个 Token 在一开始就已经确定,模型可以一次性、完全并行地把这 500 个向量送进 Transformer 的数十层网络中做前向传播,一口气算出所有隐层状态并吐出第一个输出 Token;
- Decode 阶段(逐字生成 / 解码):从第二个 Token 开始,系统陷入了串行死循环——把刚才生成的第 501 个 Token 作为输入,过一遍模型得到第 502 个;再把第 502 个作为输入,过一遍模型得到第 503 个……直到生成终止符(EOS)或达到最大输出长度。如果一个请求要输出 200 个字,就必须在物理硬件上完完整整地将整套神经网络连续执行 200 次!
1.2 Prefill(预填充)阶段:高度并行的矩阵乘法(GEMM)与算力饱食
在 Prefill 阶段,输入 Tensor 的形状为: 其中 为 Batch Size(通常为 1 到数十), 为输入 Prompt 序列长度(数十到数万不等), 为模型隐层维度(如 LLaMA-3 70B 为 8192)。 此时,模型内部的核心计算是通用稠密矩阵乘法(GEMM - General Matrix Multiply):- Q, K, V 投影:将形状为 的激活矩阵与形状为 的模型静态权重矩阵相乘;
- MLP / SwiGLU 升降维:将形状为 的激活矩阵与形状为 的 Gate/Up 权重矩阵相乘;
- Self-Attention 矩阵乘: 产生 的注意力得分矩阵。
- 权重搬运一次,计算成千上万次:GPU 从高带宽显存(HBM)中读取一次权重矩阵(几百兆字节),放入片上高速缓存(SRAM / Shared Memory),可以让这 2048 个 Token 并行复用!
- Tensor Cores 极度饱食:NVIDIA GPU(如 Hopper 架构)的 Tensor Core 阵列被完全喂饱,计算单元运转如飞,硬件利用率(MFU)通常可以达到 50% ~ 65%;
- 物理归宿:Prefill 是不折不扣的 Compute-Bound(算力受限型) 任务。限制其运行时间的最核心瓶颈,是 GPU 的峰值浮点算力(TFLOPS)。
1.3 Decode(逐字解码)阶段:每步单 Token 的矩阵-向量乘(GEMV)与访存饥渴
进入 Decode 阶段后,整个物理世界彻底反转。 在 Decode 的每一个独立 Step 中,对于某一个特定的请求,输入的 Tensor 形状缩水为: 注意中间那个刺眼的数字:!每一个正在生成的请求,在这一步仅仅贡献了 1 个 Token! 此时,原本威风凛凛的矩阵乘法(GEMM)退化成了矩阵-向量乘法(GEMV - General Matrix-Vector Multiply):- 输入向量的维度是 ;
- 权重矩阵的维度依然是庞大的 或 。
- GPU 为了计算这区区 1 个 Token 的前向传播,必须从显存(HBM)中把整个大模型数十吉字节(GB)的静态权重完整读取一遍到片上缓存!
- 每一个权重参数(2 字节)被辛苦地从 HBM 经过几毫米长的硅中介层搬运到 SM(流式多处理器)中,仅仅与这 1 个 Token 的输入分量做了一次乘加操作(2 FLOPs),随即就被丢弃!
- 计算单元的大规模空转:Tensor Cores 拥有每秒吞吐数百甚至上千太次(Tera-FLOPs)浮点数的恐怖胃口,但 HBM 的供水管道(显存带宽)每秒最多只能泵出几太字节(TB/s)的数据。计算单元就像一台吞吐量惊人的工业粉碎机,上游却只拿一根极细的吸管一滴一滴地给它喂料。
- 物理归宿:单请求或小批量的 Decode 是绝对的 Memory-Bound(访存受限 / 显存带宽受限型) 任务。此时 GPU 算力利用率理论上甚至不足 1%!限制其运行时间的根本不是算力有多强,而是显存带宽有多宽。
1.4 两阶段计算与访存特性全景对齐表
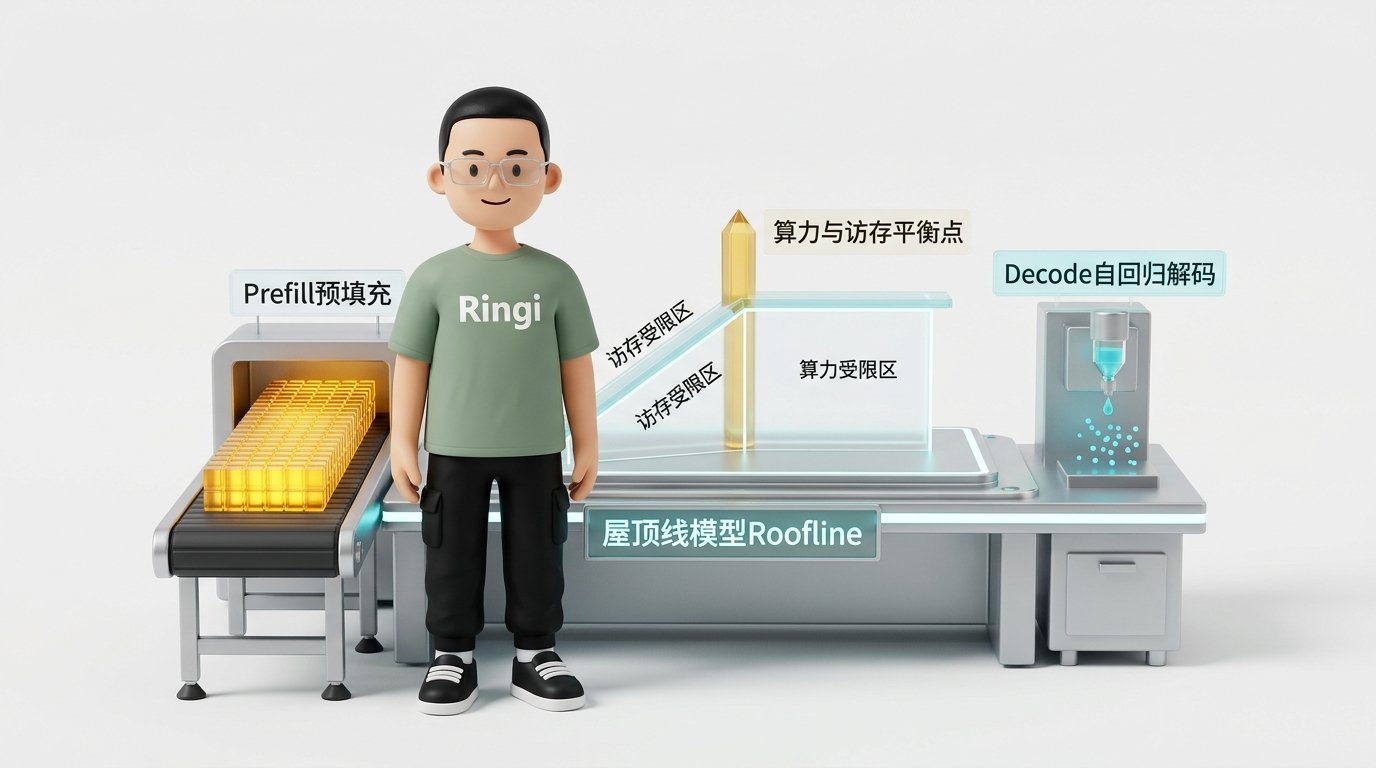
2. Roofline 模型硬核投影:为什么砸了几十万的 GPU,Decode 时算力却在“旷工”?
2.1 算术强度(Arithmetic Intensity)的物理本质
要定量解释为什么 Decode 阶段算力被极度闲置,必须引入计算机体系结构中最经典的分析工具——Roofline 模型(屋顶线模型)。 Roofline 模型建立在两个最基础的物理现实之上:- 处理器算力上限(Peak Compute Performance, ):单位为 (每秒万亿次浮点运算);
- 显存物理带宽上限(Peak Memory Bandwidth, ):单位为 (每秒万亿字节数据搬运)。
- 如果 极高:意味着数据搬上芯片后被反复复用计算了上千次,此时访存时间可以被繁重的计算完全掩盖,GPU 达到性能天花板 ,称为 算力受限(Compute-Bound);
- 如果 极低:意味着计算单元做几次运算就没数据了,只能停下来干等下一批数据从 HBM 爬过来,此时哪怕给它一万个 Tensor Core 也无济于事,性能受制于斜坡天花板 ,称为 访存受限(Memory-Bound)。
2.2 公式五步穿透:GPU 硬件平衡点(Balance Point)手算推导
① Why(为什么需要算它?)
在采购 GPU 或设计推理引擎前,必须知道一个硬指标:一个算子的算术强度必须达到多大,才能刚好把这块 GPU 的算力和带宽同时喂满? 这个分界点被称为 硬件平衡点(Machine Balance Point),它是划定 Memory-Bound 与 Compute-Bound 的绝对物理楚河汉界。② Mental Model(物理直觉比喻)
想象一个吃汉堡比赛:- 选手的咀嚼速度是每秒 1,000 口(算力);
- 服务员端盘子的速度是每秒 2 盘汉堡(带宽);
- 如果每盘汉堡只有 10 口肉(算术强度低),选手嚼 0.01 秒就得眼巴巴等盘子送来(访存瓶颈);
- 只有当每盘汉堡至少堆满 500 口肉时,选手才能一刻不停地咀嚼,服务员也刚好端得过来(达到平衡点)。
③ Tiny Calculator(极简数字手算)
以目前大厂推理集群最主流的 NVIDIA H100 SXM (80GB HBM3) 为例:- 稠密半精度(BF16/FP16)Tensor Core 算力: (注:官方宣传的 1979 TFLOPS 包含了 2:4 结构化稀疏,工业稠密基准按非稀疏计算);
- HBM3 显存实测理论峰值带宽:
- BF16 Tensor Core 算力:
- HBM2e 显存带宽: 。
④ Formal Model(标准公式与 GPU 算子/内存映射)
对于任意加速硬件与精度格式,硬件平衡点定义为: 在 Roofline 双对数坐标系中,系统的实际执行算力 严格服从:⑤ Sanity Check(数量级校验)
记住这个核心基准:在 H100 上,一个算子必须达到约 300 FLOP/Byte 的算术强度,才能碰触到算力天花板;在 A100 上,这个门槛是 150 FLOP/Byte。 低于这个数值,算子无论怎么写,注定在斜坡上爬行。2.3 Prefill 与 Decode 在 Roofline 上的双峰对立:1024 vs 1 FLOP/Byte 的百倍鸿沟
现在,让我们把大模型前向传播的数学计算代入算术强度公式。 考虑一个参数量为 (以参数个数计)的模型,采用半精度(FP16/BF16,每个参数占 2 字节,模型总权重字节数为 )。案例 A:单请求 Decode 阶段( )
- 计算量(FLOPs):根据 Transformer 的前向计算公式,每个参数对 1 个输入 Token 贡献一次乘法和一次加法(1 MAC = 2 FLOPs),因此总计算量为:
- 访存量(Bytes):必须把模型的所有权重从 HBM 加载到 SRAM 一次(忽略极小的单 Token KV Cache),数据量为:
- 单请求 Decode 算术强度:
案例 B:Prefill 阶段( )
- 计算量: 个 Token 同时进网络,每个参数被 1024 个 Token 共同复用:
- 访存量:静态权重依然只从 HBM 读取一次,数据量为 (暂时忽略 Attention 激活值):
- Prefill 算术强度:
2.4 为什么增大 Batch Size 是拯救 Decode 算术强度的唯一稻草?
既然 Decode 卡在 1 FLOP/Byte 的深渊里,怎么救? 审视 Decode 的算术强度公式:如果我们把并发请求打包成一个大小为 的 Batch,输入维度变为 :- 计算量: 个 Token 同时计算,总运算量线性增加为:
- 权重访存量:妙处正在于此——这 个 Token 共享相同的模型权重! 模型权重依然只需要从 HBM 读取一次,权重搬运量仍为 (假设忽略随 增长的 KV Cache 访存):
- 组批后的算术强度:
- 当 时, ,利用率 0.3%;
- 当 时, ,利用率攀升到约 10%;
- 当 时, ,利用率攀升到约 43%;
- 当 时, ,Decode 终于第一次跨过平衡点,把 H100 的算力彻底吃满!
💡 Ringi 工程师大实话: “把 Batch Size 搞大,单位 Token 的边际显存搬运成本就会被平摊。权重只搬一次,服务 100 个用户,吞吐量就能暴增 100 倍,而每一步的硬件执行耗时几乎没变!这就是 Continuous Batching 能够在降低单位 Token 算力成本上封神的物理根基。”
3. KV Cache 空间换时间:显存四账本与碎片化陷阱
3.1 为什么必须缓存?重算复杂度 vs 缓存复杂度
在前面的讨论中,我们留下了一个关键疑问:既然自回归每一步只需要当前这 1 个 Token 的输出,为什么注意力机制(Attention)会拖累整个系统? 回顾 Attention 的经典计算范式: 在 Decode 的第 步:- 当前输入的仅仅是第 个 Token,它通过线性投影产生当前的查询向量 ;
- 但是,为了计算第 个位置的自注意力, 必须与前序所有 个 Token 的键向量矩阵 做内积,并与值向量矩阵 做加权求和!
- 生成第 1 个 Token 时,计算长度为 1 的 Attention;
- 生成第 2 个 Token 时,重新把第 1、2 个 Token 走一遍模型算 ;
- 生成第 个 Token 时,必须把前 个历史 Token 全量重算一遍;
- 总浮点运算量关于序列长度呈现悲惨的二次方爆炸:
- 在第 1 步(Prefill)算完后,把所有 Prompt Token 的 和 矩阵保存在显存中;
- 随后每走一步 Decode,只计算当前这 1 个新 Token 的 ;
- 把新算出的 追加写入缓存;
- 直接与显存里的全量历史 做点乘(此时只需一次矩阵-向量乘法);
- 每步计算量从 降为 ,全流程计算量降至线性:
3.2 公式五步穿透:单个 Token KV Cache 显存容量精确手算
① Why(为什么需要算它?)
在大模型上线容量规划中,GPU 显存被分成两大块:静态权重 和 动态运行时显存。而动态显存的 90% 以上被 KV Cache 霸占。如果算不准单 Token 的 KV Cache 开销,就无法估算集群能承载的最大并发数,线上分分钟触发 CUDA Out of Memory (OOM) 崩溃。② Mental Model(物理直觉比喻)
把 Transformer 模型想象成一座 80 层高的摩天大楼(80 层 Transformer Layer)。 每一层都有专门的接待前台,配置了若干个账本盒子(KV Heads)。 每进来一个客人(1 个 Token),每一层的每个账本盒子里都必须为他塞进两张卡片(一张写他的 Key 特征,一张写他的 Value 特征)。层数越多、盒子越多、卡片越厚,整栋楼被塞满的速度就越快。③ Tiny Calculator(极简数字手算)
我们手算业界两款最标杆开源模型的单 Token 账本: 案例 1:LLaMA-3 8B (采用 GQA,8 对 KV Heads)- 层数 ;
- KV 头数 (注意:Query 头数是 32,但因为是 GQA,KV 头只有 8 个!);
- 头的维度 ;
- 存储精度:半精度 FP16 / BF16,每个元素占 2 字节( );
- 乘数 2:分别存储 Key 和 Value。
- 层数 ;
- KV 头数 ;
- 头的维度 ;
- 存储精度:FP16(2 字节)。
④ Formal Model(标准公式)
对于任意 Transformer 模型,单个 Token 在全局 KV Cache 中占据的字节数为: 对于一个并发数为 、平均上下文长度为 的在线服务,KV Cache 消耗的显存物理总量为:⑤ Sanity Check(数量级校验与震惊时刻)
以 LLaMA-3 70B 为例:- 单个 Token 占用 ;
- 长文本场景(32K 上下文):
- 并发场景(并发数 ,平均长度 4K):
3.3 传统连续预分配的显存灾难:内部碎片 + 外部碎片导致有效利用率 <40\%
在 vLLM 问世之前,主流的推理框架(包括早期的 HuggingFace Accelerate、FasterTransformer 等)在显存管理上都采取了原始的“连续张量预分配策略”。 因为 PyTorch 原生算子要求张量在物理内存中必须是连续地址,而系统在请求到达那一刻,根本不可能预知这个用户到底会输出多少个字(可能只回答一个“好”字,也可能滔滔不绝写一篇论文)。 传统的做法只能按最大可能长度(如 )为每个请求预留一块连续的显存空间。这就引发了极其恐怖的内存碎片黑洞:- 内部碎片(Internal Fragmentation):请求实际只生成了 100 个 Token 就遇到了 EOS,但系统为它保留的 1948 个 Token 显存空间直到请求完全释放前都无法被他人使用;
- 预留碎片(Reservation Waste):正在生成的请求其 KV Cache 是随时间递增的,但在最初时刻必须把未来的空间全部占住;
- 外部碎片(External Fragmentation):内存频繁申请与释放后,显存中散落着大量小碎片,无法拼凑成一个满足新请求 的连续大块。
3.4 从 MHA 到 GQA/MQA 的演进:为什么现代大模型架构几乎 100% 转向 GQA?
仔细审视单 Token KV Cache 计算公式: 在这几个参数中:- 层数 与隐层维度 直接决定了模型容量,不能轻易缩减;
- 数据精度 压缩到 FP8 已经是当下极限;
- 唯一的线性缩减暴击点,就是 (KV 头的数量)!
- Query、Key、Value 的头数完全一致:
- 每一个 Query 都有自己专属的一对 Key/Value 头。
- 让所有的 Query 头(如 32 个)全量共享仅仅 1 组 Key/Value 头( );
- 显存暴降:KV Cache 体积直接断崖式缩减为 MHA 的 (如 ,缩减 97%)!
- 代价:注意力表达能力受到明显损伤,在某些复杂关联推理任务上泛化能力下降。
- 将 个查询头分成 组(例如 32 个 Query 头分成 8 组,每组 4 个 Query 头);
- 每一组共享 1 对 Key/Value 头( );
- 显存收益:KV Cache 直接缩减为 MHA 的 (节省 75% 显存)!
- 精度表现:大厂实验证明,GQA 在几乎完全保持 MHA 语言理解与复杂推理能力的同时,让在线推理系统的最大并发度直接翻了 4 倍!
4. 核心 SLO 指标体系:如何用大厂工程标准衡量一次在线推理的“好与坏”
4.1 延迟类指标:TTFT(首字响应)、TPOT / ITL(字间间隔)与 E2E 延迟模型
衡量大模型服务的性能,“Latency(延迟)”不再是一个单一的标量,而是一个多维时序指标族。1. TTFT(Time To First Token,首字延迟)
- 定义:从客户端发送 HTTP/gRPC 请求开始,到客户端接收并渲染出第一个生成的 Token 的完整耗时;
- 物理构成:
- 核心主导项:在服务端高负载排队时受 主导;在平稳运行时受 主导;
- 用户心智阈值:人机交互黄金定律规定,TTFT 超过 1.0 秒 用户便开始感知迟钝,超过 2.0 秒 会引发用户二次刷新或放弃任务。
2. TPOT(Time Per Output Token,每输出字延迟)/ ITL(Inter-Token Latency,字间延迟)
- 定义:在进入自回归流式输出后,相邻两个 Token 之间的平均吐字时间间隔;
- 业界标准计量(NVIDIA GenAI-Perf 口径):
- 用户心智阈值:
- 人类的正常默读速度约为每秒 5~10 个汉字/单词(对应 TPOT 为 );
- 极佳的打字机视觉流速应维持在每秒 20~40 个 Token,即 ;
- 一旦 TPOT 恶化到超过 (即出字速度低于 10 字/秒),人眼就能明显察觉到字符蹦出时的“阻滞感”。
3. E2E Latency(端到端总延迟)
- 数学建模:
⚠️ 生产架构决策暗礁:你的场景被谁主导?
- 短输出场景(如搜索引擎摘要、分类标注、 ): 设 。 。 TTFT 占据了总耗时的 40%! 此时花大精力去把 TPOT 从 40ms 优化到 30ms 收益甚微,必须主攻 TTFT;
- 长输出场景(如代码生成、长篇写作、 ): 。 TPOT 占据了总耗时的 98.8%! 此时即使把 TTFT 优化到 100ms 也毫无存在感,必须不惜一切代价优化 TPOT。
4.2 吞吐类指标:系统级 Token/s、用户感知 Token/s 与 RPS 的辩证关系
在量化吞吐时,如果不加限定词,工程讨论往往会变成鸡同鸭讲。必须严格区分三个不同视角的吞吐概念:
残酷的零和博弈:
系统总吞吐(System Throughput)与单用户感知流速(User-perceived Speed)往往是互斥的!
- 为了提高系统总吞吐,调度器倾向于凑一个更大的 Batch(如从 提到 );
- 硬件虽然打满了,但由于显存带宽被更多 KV Cache 读取挤占,单步 Decode 耗时从 25ms 拖慢到 50ms;
- 结果是:系统总产出翻倍了,但每个独立用户看到的打字机流速直接腰斩跌了一半!
4.3 为什么不要相信平均值?P50 / P95 / P99 尾延迟与长尾效应(Tail At Scale)
在分布式系统中,最致命的陷阱就是盯着“平均值(Mean)”自我陶醉。 在大模型在线服务中,请求具有极强的异构性(Heterogeneity):- 有的用户 Prompt 只有 50 Token,有的用户一粘贴就是 8,000 Token;
- 有的用户只要求回答“Yes/No”,有的用户让模型写一篇 3,000 字的小说;
- 不同的显存块分配可能会偶发触发内存垃圾回收、CPU-GPU 同步阻塞或网络丢包重传。
- P50(中位数):50% 的请求延迟低于此值,代表系统在最佳状态下的“平均面貌”;
- P95 / P99(尾延迟):95% 或 99% 的请求低于此值。这 1% 的恶化长尾,才是导致核心客户流失、业务告警狂响的真正罪魁祸首!
4.4 生产终极指标:Goodput(有效吞吐)与 Pareto 最优前沿面(Pareto Frontier)
为了彻底撕下“平均吞吐量”的遮羞布,工业界正式引入了 Goodput(有效吞吐) 的概念。1. Goodput 定义
只有当一个请求的端到端指标严格满足预设的 SLO 条件时,它所产出的 Token 才被算作“有效 Token”;一切超时的 Token,哪怕 GPU 算得再辛苦,在商业和业务意义上均被视作“无效废物(Badput)”!2. Pareto 最优前沿面(Pareto Frontier)
在大模型容量规划与压测中,我们永远无法单方面追求“最低延迟”或“最高吞吐”。工程师的职责是在二者之间绘制出系统的 Pareto 边界曲线:5. 请求调度演进之路:从 Static Batching 到 Chunked Prefill 与统一 Token 预算
5.1 静态批处理(Static Batching)的短板效应:被最长序列锁死的“木桶”
在深度学习推理的最早期,系统沿袭了训练时代的 Static Batching(静态批处理):- 调度器在内存队列中积攒 个请求(比如 );
- 找到这 4 个请求中最长的那一个(假设是 1000 Token),把其余 3 个较短的请求用大量无意义的
<PAD>占位符强制填充到 1000 Token; - 将整个 的静态张量打包推给 GPU,进行前向计算。
- 无谓的计算浪费:GPU 浪费大量算力在无效的
<PAD>矩阵乘法上; - 提前结束者的幽灵等待:若请求 1 只需要生成 5 个字就退出了,而请求 2 需要生成 500 个字,请求 1 的资源和槽位必须被死死绑定,陪着请求 2 一起跑完剩下的 495 步才能被返回!
5.2 连续批处理(Continuous / In-Flight Batching):请求级动态进出与迭代级组批
2022 年,Orca 论文提出了划时代的 Continuous Batching(连续批处理 / 迭代级组批 Iteration-level Batching)。 其核心洞见在于:既然 Transformer 的 Decode 是单步逐字迭代执行的,为什么要把组批的粒度绑定在‘请求(Request)’生命周期上?为什么不在‘每一步迭代(Step)’上重新动态组批?
- 动态退出:在任一 Step,只要某一个请求遇到了 EOS,调度器立刻将其结果流式返回并从批次中剔除,其所占用的显存立即归还;
- 动态注入:在任一 Step,只要显存池中还有多余的 Block,排队中的新请求无需等待前序大任务结束,立刻见缝插针地被塞进当前 Step 的空闲槽位!
5.3 长 Prefill 对 Decode 的“降维打击”:TPOT 突刺的物理根源
然而,早期的 Continuous Batching 很快在生产中撞上了我们在 0.2 节复盘的那堵“高墙”:Prefill 与 Decode 的恶性资源争抢。 在朴素的 Continuous Batching 实现中,调度器每一步要做决策:- 既然来了一个新请求,我就把它的整段 Prefill,和正在运行的那批 Decode 请求塞在同一个 Step 里一起跑!
- GPU 的 Tensor Core 必须执行极其沉重的 级前向传播;
- 这一步的物理耗时从平时的 25ms 瞬间暴增至 300ms;
- 正在安静逐字流式输出的 16 位用户,其屏幕上的打字机全部突发性停顿卡死 300ms!
- 如果后续又有新的长 Prompt 请求接踵而至,TPOT 的监控曲线上将密密麻麻布满了致命的“摩天大楼”般的尖刺(Spikes)!
5.4 Chunked Prefill(分块预填充):把集装箱切成包裹,用小额 TTFT 牺牲换平稳 TPOT
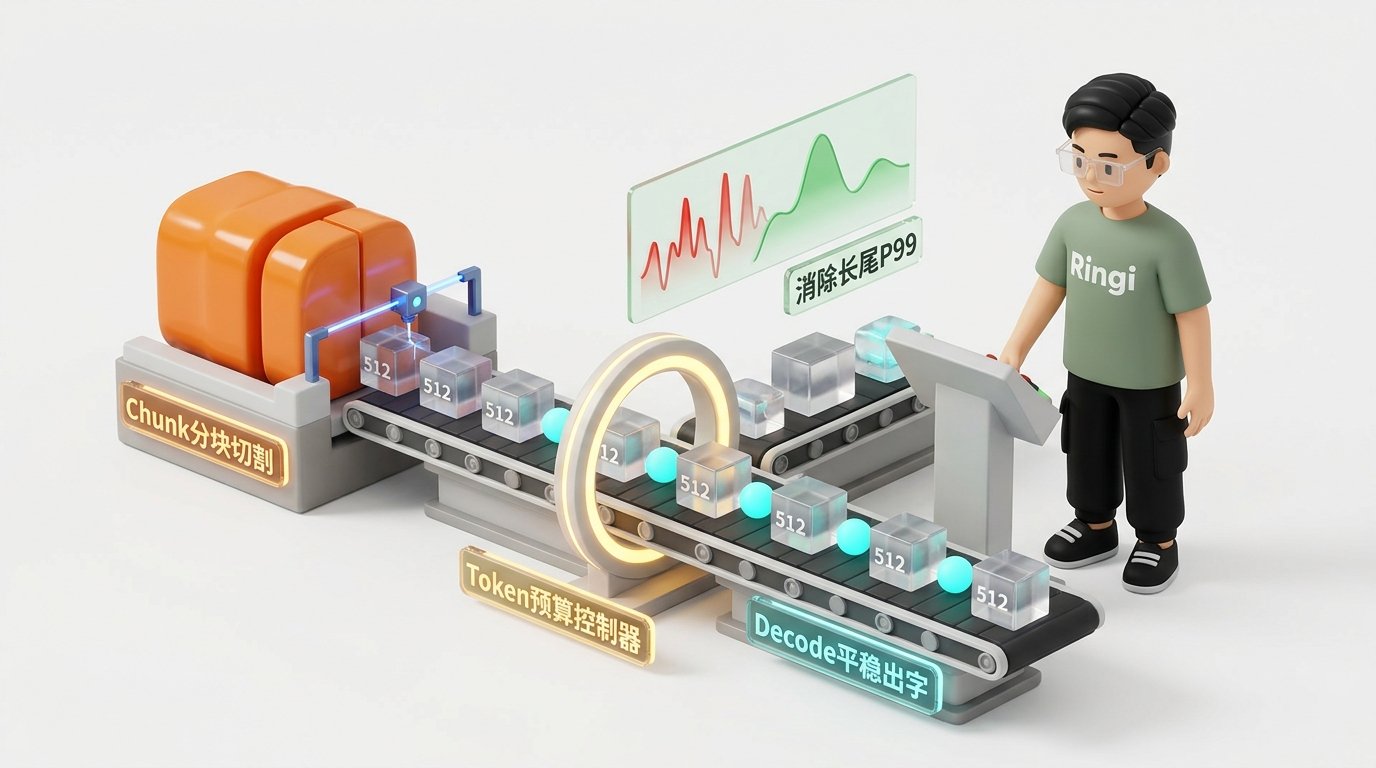
面对突发长 Prefill 阻塞流水线的绝境,业界(以 Sarathi-Serve 论文为代表)提出了极其精妙的解法——Chunked Prefill(分块预填充)。核心思想
凭什么规定一段 4000 Token 的长 Prompt 必须在单步内一口气吃完? 现实中高速公路上绝不允许超重集装箱横冲直撞堵死车道,而是必须将大宗货物拆装运输。- 我们给 Prefill 设定一个固定的 Chunk 大小(例如 );
- 当一个 4000 Token 的长请求到达时,系统将其强制切割为 8 个独立的 Chunk;
- 每一步只执行一个 512 Token 的 Chunk,并与正常的 Decode 请求混合批处理;
- 剩下的 7 个 Chunk 顺延至后续 Step 逐个消化!
工程收益与代价权衡
- 核心收益:每一单步的计算负载被硬性限制在一个极窄的区间内,单步耗时稳定在 30~40ms,彻底抹平了长尾 TPOT 尖刺,P99 稳定性提升数倍!
- 妥协代价:这个超长 Prompt 的首字延迟(TTFT)会有小幅增加(因为它被摊到了 8 步完成)。但在真实业务中,长文本用户对多等几十毫秒首字完全钝感,而前台成百上千个正在打字的用户却获得了丝般顺滑的稳定体验。这是一笔极具工程智慧的高价值交换!
5.5 vLLM V1 统一 Token 预算调度器(Unified Token Budget):抹平阶段二分
在 vLLM 的早期架构(V0)中,调度器内部充斥着两套逻辑:Prefill 队列与 Decode 队列被区别对待,逻辑盘根错节。 而在 vLLM V1 核心调度引擎 中,实现了一个极其优雅的抽象跃迁——统一 Token 预算调度器(Token Budget Scheduler)。核心哲学:在 GPU 眼里,天下没有任何阶段之分,只有“这一步要算几个 Token”!
调度器在每一步开始前,只持有唯独一个硬指标:当前 Step 的全局 Token 预算上限( ,如 2048)。 调度决策被高度抽象为一个纯粹的装箱字典映射:优先级准则:先保存量 Decode,余量给 Prefill
- 第一优先级(保流速):正在运行的所有存量 Decode 请求绝对优先分配预算(每个扣减 1 个 Token 额度),确保老用户的打字机绝不断流;
- 第二优先级(削峰填谷):计算剩余的可用 Token 预算( );
- 第三优先级(分块裁决):新请求的 Prefill 按照 进行自然截断,自动切成 Chunk!
6. 架构前沿演进:PD 解耦(Prefill-Decode Disaggregation)与跨节点 KV 传输
6.1 为什么物理拆分?计算卡与带宽卡的异构选型与成本收益比
尽管 Chunked Prefill 巧妙地平抑了同卡混部下的 TPOT 尖刺,但在超大规模公有云及万卡集群中,混部依然存在无法解决的硬件规格妥协死结:- 硬件利用率的零和妥协:
- 如果为 Prefill 选型配置昂贵的算力怪兽卡(如 NVIDIA H100/H200,989 TFLOPS),但在 Decode 阶段其强悍的 Tensor Core 依然在大面积空转等待带宽;
- 如果为 Decode 选型配置高性价比、大显存但算力较弱的卡(如 L40S 或定制内存卡),一旦遇到突发的大并发长 Prefill,系统立刻陷入算力瓶颈。
- 显存驻留冲突:
- Prefill 阶段瞬时需要巨大的激活值显存(Activation Memory);
- Decode 阶段长期需要巨大的持久化 KV Cache 显存池;
- 两种生命周期的内存互相挤占,造成显存碎片与提前触发驱逐(Eviction)。
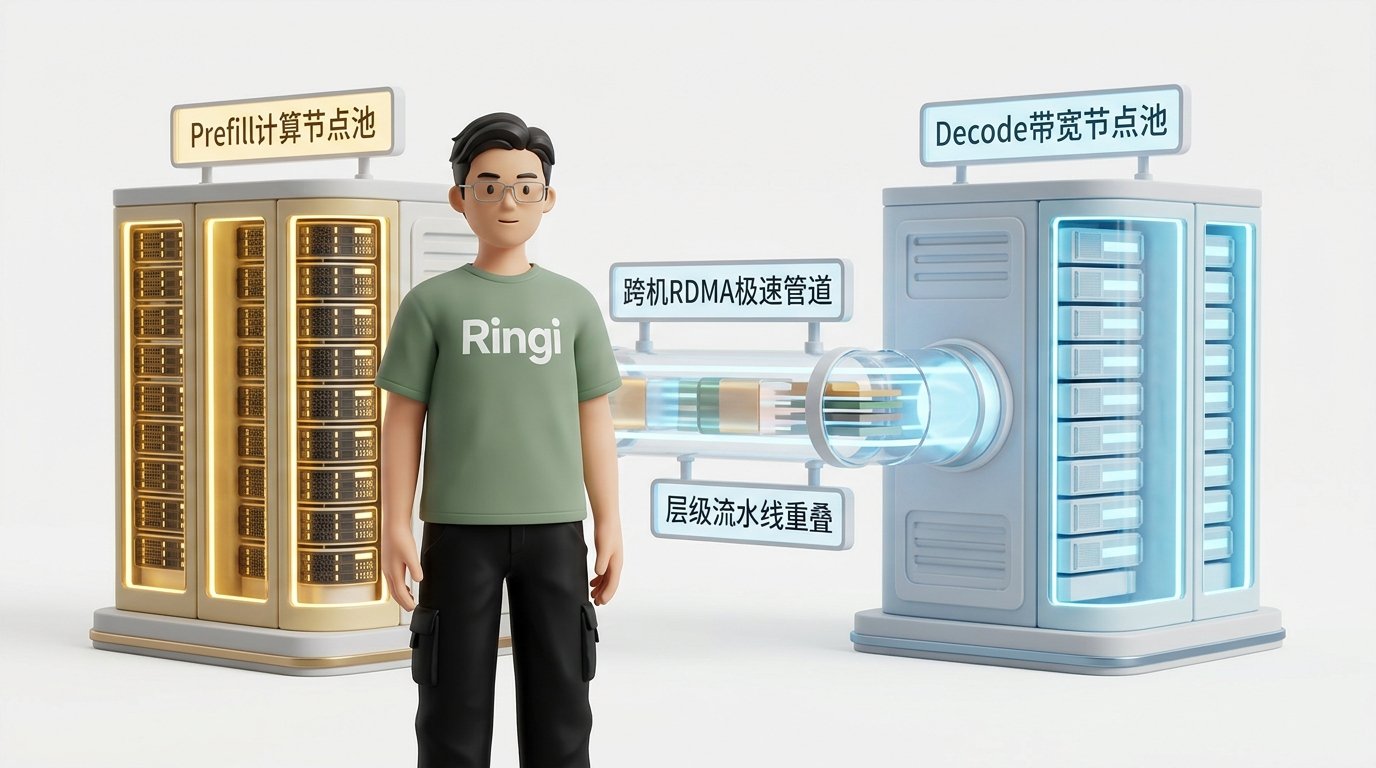
- Prefill 专职节点池(P-Pool):采购高算力规格的机器(甚至配置水冷超频算力),只干一件事——把客户端送来的 Prompt 飞速算完,生成初始 KV Cache 和第一个 Token;
- Decode 专职节点池(D-Pool):采购显存容量超大、显存带宽极宽的机型,专职挂载海量并发的会话,平稳维持流畅出字;
- 成本收益暴增:两端可以独立进行弹性水平伸缩(Auto-scaling),白天写长文档多就扩容 P-Pool,晚上多轮对话多就扩容 D-Pool,硬件 ROI(投资回报率)提升超过 40%。
6.2 新的物理墙:跨机 RDMA 传输百吉字节 KV Cache 的时延代价
然而,天底下没有免费的午餐。物理拆分虽然解开了单机内的硬件死结,却把系统推向了一堵全新的物理高墙——跨机网络带宽墙(Inter-Node Network Wall)。 在单机混部时,KV Cache 存在于本地显存中,Prefill 到 Decode 的切换是零开销的片内指针传递。 而在 PD 解耦架构下,Prefill 节点算出的完整 KV Cache,必须通过高速网络物理搬运到 Decode 节点的显存里!一笔令人不寒而栗的网络账本:
以 LLaMA-3 70B(80 层,8 个 KV 头,FP16,单 Token 约 320 KB)为例:- 一个 32,768 Token(32K)的长上下文请求,其生成的 KV Cache 总量高达:
- 假设集群配备了工业顶级的 400 Gbps InfiniBand / RoCE 网卡(单向理论有效带宽约为 );
- 纯网络硬件传输这一份 KV Cache 的理论物理耗时下限为:
6.3 传输三大决策维度:Push vs Pull、Eager vs Pipelined、Full vs Incremental
为了攻克这堵跨机网络高墙,学术界与大厂 Infra 团队在传输协议上探索出了三个维度的核心设计空间:- Push vs Pull(推送 vs 拉取):
- Push(推):Prefill 节点在前向计算的同时,主动通过 RDMA 向 Decode 节点目标内存推送。优势在于 Decode 节点随时可以零等待启动;劣势是 Prefill 节点必须提前知道下发给哪台 Decode 节点,依赖强大的外部编排器;
- Pull(拉):Decode 节点在被调度时按需向远端拉取,适合带有全局分布式缓存池的复杂拓扑。
- Eager vs Pipelined(一次性聚合 vs 层级流水线):
- Pipelined(层级流水线重叠)是生产环境的绝对标配!一个 80 层的模型,Layer 0 算完后立刻通过异步 RDMA 发射,当 GPU 正在算 Layer 3 的注意力时,Layer 0 和 Layer 1 的数据已经在跨机线缆中疾驰。通过计算与通信的无缝 Overlap,最终暴露给 TTFT 的仅剩最后一两层的极小传输气泡!
- Full vs Incremental(全量 vs 增量):
- 绝不傻傻地全量搬运!如果用户 Prompt 的前 10,000 个 Token 是一个通用的 System Prompt 或企业知识库前缀,而 Decode 节点本地已经命中了该 Prefix,则传输引擎仅需传输后序 6K 的增量差值!
6.4 工业界主流架构:vLLM KV Connector V1、LMCache PD Backend 与 Mooncake
当前,开源大模型与大厂自研体系在 PD 解耦领域已经形成了三足鼎立的落地实现:7. 动手实战与代码实验室(Minimal Runnable Code)
💻 Ringi 实验室守则:拒绝不可落地的理论空谈。本节提供两个完全自包含、纯 Python 原生运行、零复杂外部依赖的硬核实战脚本。直接复制到本地,即可清晰复现底层物理定理与调度优化实证。
7.1 实验一:基于 Roofline 理论的 Prefill/Decode 算术强度与硬件瓶颈极简推导器
本脚本根据输入的任意模型参数与 GPU 规格,自动推导硬件平衡点,并计算在不同输入长度、不同 Batch Size 条件下,Prefill 与 Decode 的实际算术强度、理论算力利用率与瓶颈归属。7.2 实验二:离散事件驱动模拟器(DES):Continuous Batching vs Chunked Prefill 消除 P99 TPOT 突刺全真仿真
本实验构建了一个精密的轻量离散事件推理调度模拟器。模拟真实生产环境下的泊松随机到达请求流(混合了普通短问答与罕见超长代码 Prompt)。对比在“朴素 Continuous Batching”与“启用 Chunked Prefill(512 Token 预算)”下,全生命周期的 TTFT 均值以及 P50 / P95 / P99 核心 TPOT 长尾延迟分布。8. Ringi 避坑指南与生产黄金准则
8.1 7 大常见小白认知误区 vs 大厂 AI Infra 正确物理认知
8.2 生产在线推理服务黄金 Checklist
在上线任何大模型在线服务前,必须严格对照以下生产基准逐一打勾验收:- 1. 显存动态安全预算校验(KV Cache Headroom):
- 严禁将
gpu_memory_utilization设为 1.0!生产基线推荐设为 0.90 ~ 0.92,必须强制为 CUDA 运行时、通信 Buffer(P2P/NCCL)以及偶发临时张量保留至少 6~8GB 物理缓冲底座,杜绝底层显存 OOM。
- 严禁将
- 2. 全面开启虚拟分页内存管理(PagedAttention):
- 弃用任何依赖物理连续内存的静态预分配引擎,使用 vLLM 或 TensorRT-LLM 分页管理器,将显存碎片率死死锁在 4% 以下。
- 3. 生产强制启用分块调度(Chunked Prefill):
- 在支持的引擎中将 Chunked Prefill 设为默认开启;
- 推荐基线配置:
max_num_batched_tokens设为 512 ~ 2048(针对 H100 建议 2048,A100 建议 512),在保障算力利用率的同时严控单步最大时延。
- 4. 严苛定义业务 SLO 与 Goodput 观测大盘:
- 严禁单纯监控 QPS 与 GPU 利用率;
- 告警大盘核心关注:P99 TTFT(建议 ) 与 P99 TPOT / ITL(建议 );
- 设置自动熔断机制:当长尾超时率超过 2% 时,网关主动启动排队限流降级。
- 5. 全面推行注意力架构 GQA / MQA:
- 严禁在长文本生产线上部署未经注意力头压缩的纯 MHA 稠密大模型;
- 对存量模型评估迁移至 GQA 或部署 FP8 KV Cache 量化(显存直接减半,吞吐翻倍)。
- 6. 区分短输出与长输出业务池,实施集群异构混部:
- 搜索增强(RAG)短摘要服务与代码生成(Copilot)长生成服务切忌混在同一个 Serving 实例池;
- 短输出池以优化 Prefill 算力为主,长输出池以扩展 Batch 显存带宽为主。
- 7. 长文本混合场景审慎评估 PD 解耦架构:
- 当平均输入上下文超过 8K ~ 16K,且长短混合流量明显引发 TPOT 剧烈抖动时,启动 PD 解耦专项改造;
- 必须配备不低于 200G/400G 的无损 RDMA(RoCE v2 / IB) 网络底座,并开启层级流水线(Pipelined Transfer)隐藏传输延迟。
9. Ringi 5 点核心速记口诀、自我检验清单与课后深度思考题
9.1 5 点押韵核心速记口诀
9.2 10 条白板自我检验清单
- 能否在白板上徒手画出 Roofline 模型,并标注出算术强度、硬件平衡点与水平/倾斜屋顶线?
- 为什么单请求( )Decode 阶段的算术强度近似等于 ?写出推导过程。
- 计算 H100 SXM(989 TFLOPS, 3.35 TB/s)的平衡点是多少?为什么低于这个值的算子称为访存受限?
- 如果不使用 KV Cache,自回归生成 个 Token 的全流程浮点计算量是多大?使用后降为多少?
- 手算 LLaMA-3 70B(80 层, 8 对 KV 头, FP16)单 Token 的 KV Cache 显存容量是多少?
- 什么是内部碎片与外部碎片?PagedAttention 解决传统连续显存预分配的核心思想是什么?
- 写出端到端延迟(E2E Latency)关于 TTFT、TPOT 和输出长度的数学表达式。短文本和长文本分别受谁主导?
- 什么是 Goodput?为什么说仅看系统平均吞吐(System Throughput)是具有欺骗性的?
- 朴素 Continuous Batching 遇到一个 16K 的超长 Prompt 时,为什么会导致正在出字的用户感到严重卡顿?
- Chunked Prefill 是如何利用 Token Budget(Token 预算)消除 TPOT 尖刺的?它的代价值得吗?
9.3 3 道高阶开放式课后思考题(含极限 Corner Case)
- 【极限时延与网络倒挂题】: 在 PD 解耦(Prefill-Decode Disaggregation)架构中,若某业务的平均输入长度仅为 256 Token,输出长度为 512 Token,但网络环境仅为 25Gbps 以太网(TCP/IP)。此时部署 PD 解耦会出现什么灾难性后果?试定量分析其网络传输延迟与本地执行延迟的倒挂临界点。
- 【显存抖动与超卖风险题】: PagedAttention 允许我们将显存物理块的利用率推高至 96% 以上。然而,如果系统调度器过度乐观地允许过多请求并发进入 Decode,在某一时刻所有请求同时遭遇长文本展开,导致物理显存 Block 耗尽,系统将发生什么?vLLM 是如何设计“抢占(Preemption)”与“重算/换入换出(Swapping)”机制来兜底的?
- 【架构颠覆题:投机采样(Speculative Decoding)对两阶段特性的反转】: 投机解码(Speculative Decoding)使用一个小模型(Draft Model)快速投机生成 个 Token,再由大模型(Target Model)在单步内一次性并行验证。请问:这一机制在底层究竟是如何改变了大模型在 Decode 阶段的算术强度与 Roofline 位置的?为什么说它本质上是在用 Prefill 的计算形态来解 Decode 的带宽难题?
10. 📚 参考资料与核心源码/经典论文指引
- [Orca 论文] Yu, G. I., et al. (OSDI 2022). “Orca: A Distributed Serving System for Transformer-Based Generative Models.” —— 提出了 Continuous / Iteration-level Batching 的奠基之作。
- [vLLM / PagedAttention 论文] Kwon, W., et al. (SOSP 2023). “Efficient Memory Management for Large Language Model Serving with PagedAttention.” —— 解决 KV Cache 内存碎片与动态分页管理的划时代论文。
- [Sarathi-Serve / Chunked Prefill 论文] Agrawal, A., et al. (OSDI 2024). “Taming Throughput-Latency Tradeoff in LLM Inference with Sarathi-Serve.” —— 提出 Chunked Prefill 与消除长尾 TPOT 尖刺的经典力作。
- [Mooncake 架构论文] Qin, Z., et al. (arXiv 2024). “Mooncake: A Kimi-Centric Disaggregated Architecture for LLM Serving.” —— 月之暗面团队开源的全球首个万卡规模 Kimi 生产级 PD 分离与分布式多层 KV Cache 架构实录。
- [Roofline 模型原著] Williams, S., Waterman, A., & Patterson, D. (CACM 2009). “Roofline: An insightful visual performance model for multicore architectures.” —— 计算机体系结构性能分析第一性原理必读文献。
- [vLLM 官方核心调度源码]
vllm/v1/core/sched/scheduler.py与vllm/core/scheduler.py—— 深入研读统一 Token Budget 调度器与 BlockManager 源码实现。
附录:Appendix A — 大厂硬核高频面试题与白板推导(Interview Drill)
面试题 1:为什么 Decode 阶段 GPU 算力利用率通常只有 1%~5%?如何通过架构与工程手段提升到 50% 以上?
🎯 考核考察点
- 考察候选人是否具备扎实的计算机体系结构第一性原理(Roofline 模型);
- 是否能跳出纯算法框架,从硬件物理限制与系统工程两个维度定位根本瓶颈并给出破局解法。
💡 解题思考路径
- 点明物理矛盾:Decode 阶段单步输入的向量极短( ),矩阵乘法退化为矩阵-向量乘法(GEMV),导致其算术强度极低(仅约 1 FLOP/Byte),远远低于现代 GPU(如 H100 的 295 FLOP/Byte)的平衡点,系统死死受制于 HBM 显存物理带宽墙;
- 给出数学证据: 时单步计算量为 ,搬运量为 ,利用率理论上不足 0.5%;
- 推导破局路径(如何拉升算术强度与硬件利用率):
- 路径一:增大 Batch Size(Continuous Batching): 。将 Batch Size 拉升至 128~256,让模型静态权重搬运一次能服务更多 Token,直接将利用率拉入 Compute-Bound 区域;
- 路径二:压缩权重访存量(Weight-Only 量化,如 W4A16 / W8A16):如果将 FP16(2 字节)压到 INT4(0.5 字节),模型权重搬运量锐减 75%,算术强度瞬间提升 4 倍,单步耗时直接砍掉一半以上;
- 路径三:改写计算范式(投机采样 Speculative Decoding):小模型跑 Memory-Bound 的生成,大模型一次性并行验证 个 Token(转变为短 Prefill 的 GEMM 算子),利用大算术强度把 Tensor Core 算力榨干。
面试题 2:现场白板手算:70B 模型(GQA, 8 对 KV heads, FP16)在并发 128、上下文 4K 条件下的显存需求与 H100 理论单步 TPOT 下限。
🎯 考核考察点
- 考察大厂 Infra 工程师必须肌肉记忆的公式推导与极速心算能力;
- 考察对生产容量规划(Capacity Planning)与硬件理论极限的认知深度。
💡 详细推导过程
步骤一:手算静态模型权重显存- 70B 模型(700 亿参数),半精度 FP16(每参数 2 字节):
- 在 8 卡 H100(TP=8)集群上,单卡均摊静态权重为:
- LLaMA-3 70B 架构参数:层数 , , , 字节;
- 单 Token 全局 KV 增量:
- 并发 ,平均长度 :
- 在 TP=8 下,KV 头数按卡均分(每张卡分到 个 KV 头),单卡均摊 KV Cache 为:
- 单卡显存总占用:
- 单卡单步需要从 HBM 搬运的数据量:
- 单张 H100 SXM5 的物理理论显存带宽为 ;
- 假定显存总线带宽利用率为极高水平的 80%(有效带宽 );
- 单步仅搬运数据所需的物理耗时下限为:
- 标准答案结论:在并发 128、4K 上下文下,单卡仅需 37.5GB 显存;H100 上的单步纯搬运理论 TPOT 下限约为 14ms 左右(对应单用户感知流速最高约 71 Token/s)。
面试题 3:设计题:面对突发 10x 流量峰值(如突发新闻、春晚红包),如何保证在线推理服务的 P99 TTFT 不击穿?请给出全栈容灾调度架构方案。
🎯 考核考察点
- 考察面对不可预测洪峰流量时,候选人是否具备端到端全链路稳定性架构设计能力;
- 是否懂得在网关、调度器、执行引擎与缓存多层级协同设防。
💡 全栈标准设计方案
- 第一道防线:网关层的高性能 Prefix Cache(前缀复用):
- 突发热点新闻通常伴随着高度相似的上下文(如同一段长新闻报道或同一套 Prompt 模板);
- 在网关层部署 RadixTree / LMCache 全局前缀缓存。一旦命中热点前缀,Prefill 计算量瞬间清零( ),将原本需要耗费大量 GPU 算力的大块计算直接退化为内存/网络零拷贝,洪峰直接被化解 70%!
- 第二道防线:调度层的 Token Budget 刚性硬顶与 Chunked Prefill:
- 调度器严禁放行无限制的大 Prefill,严格执行 ;
- 即使 10x 请求涌入,每单步 GPU 耗时被死死锚定在 30ms 左右,保证存量存活用户的打字感绝对平稳;
- 第三道防线:自适应降级与弹性超卖:
- 当检测到 P99 TTFT 逼近告警线(如 800ms)时,系统自动启动服务降级策略:临时关闭多轮历史拼接,或将新请求的最大输出 Token 上限由 2048 调低至 512,大幅缩短单会话生命周期;
- 动态启用 KV Cache FP8 量化,把单个 GPU 容纳的并发容量瞬时拉升 2 倍;
- 第四道防线:离线算力瞬间借调(PD 异构弹性转换):
- 联动 Kubernetes 集群控制面,将正在执行离线 Embedding 或非紧急离线微调任务的 GPU 节点通过热插拔机制临时切入推理集群的 Prefill 节点池,几分钟内完成算力翻倍扩容。
🎨 【配图工坊生图 Prompt 暂存区 · 生成配图后可一键整块删除】
提示:本区块仅供创作者生成 Midjourney / DALL-E 3 架构配图使用。图片生成并归档至 assets 目录后,可直接删除本区块,不影响正文章节与目录结构。
蓝图 1:LLM 在线推理两阶段与 Roofline 双峰全景工坊
- 文件路径:
assets/ringi_32_overview.png - 核心中文标签:
Prefill预填充、Decode自回归解码、屋顶线模型Roofline、算力与访存平衡点
🇨🇳 中文直接生图指令(推荐直接发给 ChatGPT / DALL-E 3):
🌐 中英双语精准 Prompt(Midjourney / DALL-E 3 专用):
蓝图 2:Chunked Prefill 削峰填谷与 Token Budget 调度工坊
- 文件路径:
assets/ringi_32_chunked_prefill_overlap.png - 核心中文标签:
Chunk分块切割、Token预算控制器、消除长尾P99、Decode平稳出字
🇨🇳 中文直接生图指令(推荐直接发给 ChatGPT / DALL-E 3):
🌐 中英双语精准 Prompt(Midjourney / DALL-E 3 专用):
蓝图 3:Prefill-Decode 物理解耦与跨机 RDMA KV 流转工坊
- 文件路径:
assets/ringi_32_pd_disaggregation.png - 核心中文标签:
Prefill计算节点池、Decode带宽节点池、跨机RDMA极速管道、层级流水线重叠
🇨🇳 中文直接生图指令(推荐直接发给 ChatGPT / DALL-E 3):
🌐 中英双语精准 Prompt(Midjourney / DALL-E 3 专用):