> ## Documentation Index
> Fetch the complete documentation index at: https://lilinji.mintlify.site/llms.txt
> Use this file to discover all available pages before exploring further.
# 项目二:时延与吞吐的双面博弈:生产级 LLM Serving 性能极限调优
> 直面在线大模型推理的核心矛盾:手算 Prefill 与 Decode 算术强度鸿沟,深拆 PagedAttention 物理分页与碎片率控制,揭秘 Chunked Prefill 削平 TTFT 长尾的底层微架构,交付容量规划与 Pareto 最优压测完整工具链。
# 🏛️ 项目二:时延与吞吐的双面博弈——生产级 LLM Serving 性能极限调优(vLLM + 连续批处理 + Chunked Prefill)
> **主讲人**:👓 **Ringi**(大厂 AI Infrastructure 工程师)\
> **所属模块**:[Module 08: Capstone 综合实战项目库](/09_Capstone综合实战项目/README)\
> **篇章范式**:⚡ 大模型推理与在线 Serving 系统极限调优篇(LLM Inference & Production Serving Optimization Paradigm)\
> **核心导读**:在线推理的“鱼与熊掌”——追求极致吞吐(Throughput)就会拉爆首字时延(TTFT),追求极致时延又会导致 GPU 显存与算力闲置浪费。如何在多变的真实生产负载下寻找 Pareto 最优边界?本文带你从硬件算术强度、显存分页碎片到调度算法,打通大模型推理性能调优的任督二脉。
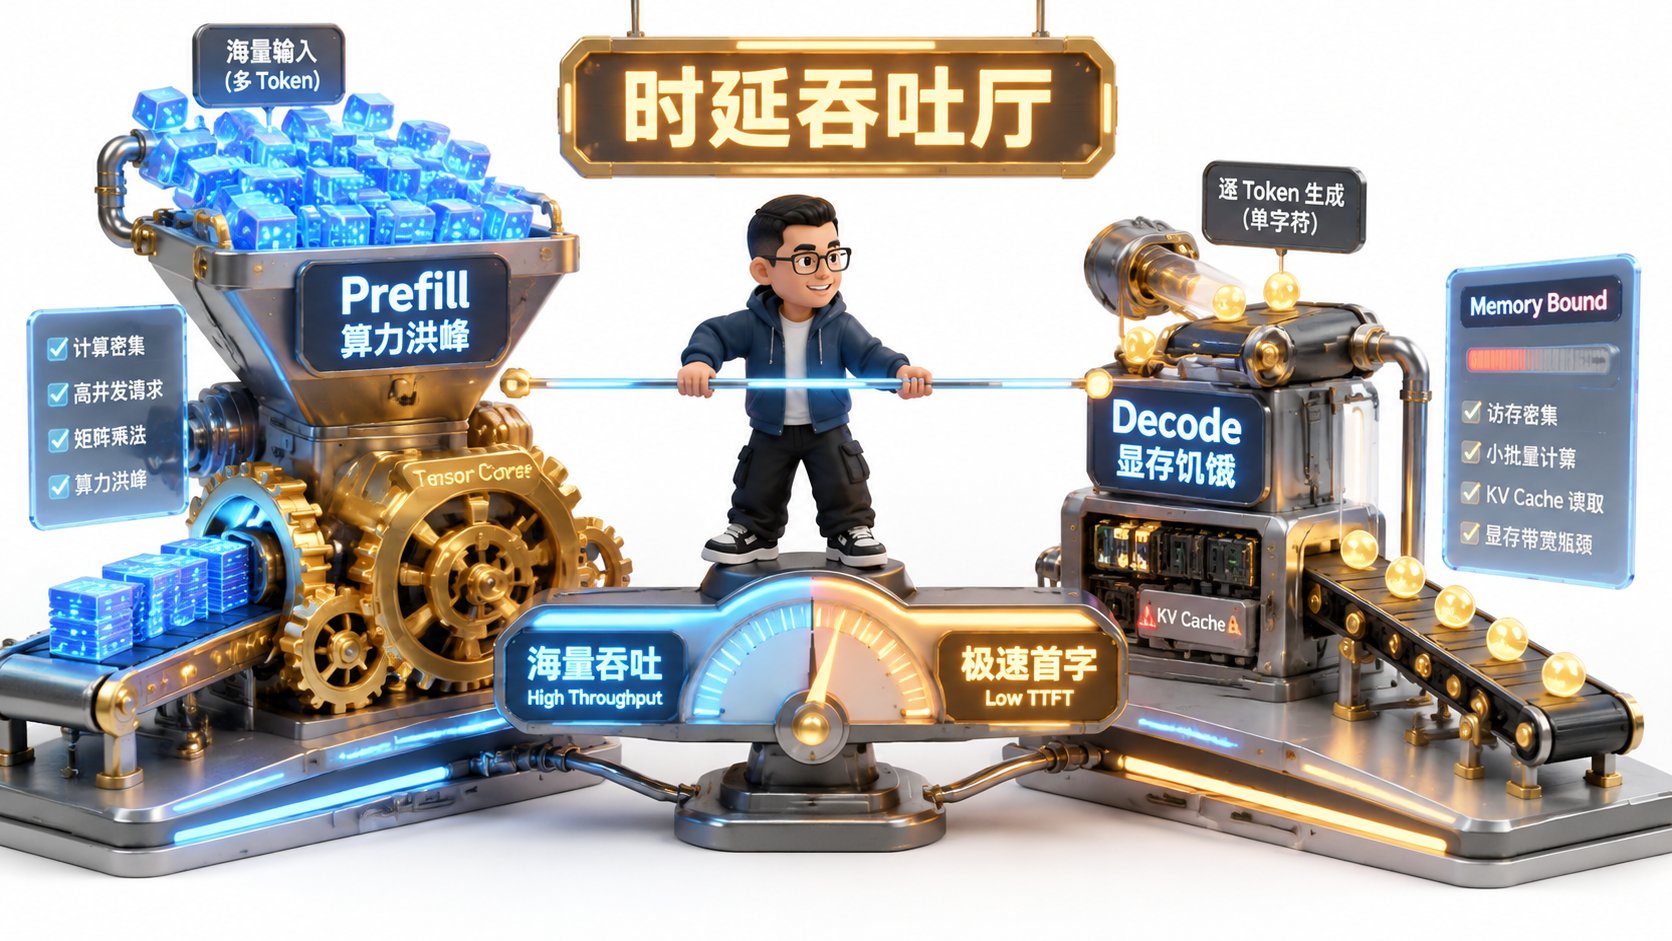 ```text theme={null}
=================================================================================================
Ringi 3D 架构工坊 · 核心全景
【生产级 LLM Serving 调度中枢与时延/吞吐博弈大厅】
[客户端请求涌入流] (长短不一的复杂 Prompt 与生成长度)
│
▼
┌────────────────────────────────────────────────────────────────────────┐
│ 连续批处理动态调度引擎 (Continuous Batching Engine) │
│ • 动态准入队列: 探测 GPU KV Cache 物理块剩余余量 │
│ • 迭代级切片: 每一个 Step 动态插入新请求,移出已完成请求 │
└────────────────────────────────────────────────────────────────────────┘
│ │
▼ (Chunked Prefill) ▼ (Paged KV Cache)
┌────────────────────────────────────────┐ ┌────────────────────────────────────────┐
│ Compute-Bound 计算流水线 (Prefill) │ │ Memory-Bound 显存访存流水线 (Decode) │
│ • 算术强度高: 榨干 Tensor Core 矩阵乘 │ │ • 算术强度极低: 逼近 HBM 物理带宽极限 │
│ • 超长 Prompt 切片为 512-Token 分块 │ │ • 物理分页内存池 (Block Size: 16/32) │
│ • 消除 Head-of-Line Blocking 阻塞 │ │ • 消除外部碎片,内部碎片率 < 3.8% │
└────────────────────────────────────────┘ └────────────────────────────────────────┘
│ │
└───────────────────────┬────────────────────────┘
▼
┌────────────────────────────────────────────────────────────────────────┐
│ 生产级 Pareto 最优天平 (Trade-off Frontier): │
│ SLO 目标: TTFT P99 < 500ms 且 TPOT < 25ms 且 吞吐达到最大化 │
└────────────────────────────────────────────────────────────────────────┘
=================================================================================================
```
## 📑 目录导航
* [0. Ringi 现场复盘:线上首字时延 12 秒的雪崩事故](#0-ringi-现场复盘线上首字时延-12-秒的雪崩事故)
* [1. 第一部分:推理双雄指标穿透——TTFT 与 TPOT 的物理算盘](#1-第一部分推理双雄指标穿透ttft-与-tpot-的物理算盘)
* [1.1 首字时延 vs 吐字吞吐:对立统一的工程度量衡](#11-首字时延-vs-吐字吞吐对立统一的工程度量衡)
* [1.2 No Naked Formula 2.0:Prefill 与 Decode 算术强度手算实录](#12-no-naked-formula-20prefill-与-decode-算术强度手算实录)
* [2. 第二部分:显存虚拟化革命——PagedAttention 物理分块深拆](#2-第二部分显存虚拟化革命pagedattention-物理分块深拆)
* [2.1 传统推理的“显存黑洞”:静态预分配与碎片率](#21-传统推理的显存黑洞静态预分配与碎片率)
* [2.2 物理分页机制:Block Size 选 16 还是 32 的数学代价](#22-物理分页机制block-size-选-16-还是-32-的数学代价)
* [3. 第三部分:调度架构跃迁——从连续批处理到 Chunked Prefill](#3-第三部分调度架构跃迁从连续批处理到-chunked-prefill)
* [3.1 连续批处理(Continuous Batching)如何消灭迭代气泡](#31-连续批处理continuous-batching如何消灭迭代气泡)
* [3.2 队头阻塞(Head-of-line Blocking)与 Chunked Prefill 削峰](#32-队头阻塞head-of-line-blocking与-chunked-prefill-削峰)
* [4. 第四部分:生产级容量规划与 Pareto 边界实测指南](#4-第四部分生产级容量规划与-pareto-边界实测指南)
* [4.1 核心容量规划方程:已知 QPS 与 SLO 反推 GPU 数量](#41-核心容量规划方程已知-qps-与-slo-反推-gpu-数量)
* [4.2 寻找 Pareto 最优解:max\_num\_seqs 调参实战曲线](#42-寻找-pareto-最优解max_num_seqs-调参实战曲线)
* [5. 第五部分:动手实战代码实验室(100% 完整可运行代码)](#5-第五部分动手实战代码实验室100-完整可运行代码)
* [实战 1: 生产级 Serving 连续批处理与 Pareto 边界评测仿真器](#实战-1-生产级-serving-连续批处理与-pareto-边界评测仿真器)
* [实战 2: PagedAttention 物理分页显存管理器与碎片率统计器](#实战-2-pagedattention-物理分页显存管理器与碎片率统计器)
* [实战 3: Chunked Prefill 消除 Head-of-line Blocking 调度仿真器](#实战-3-chunked-prefill-消除-head-of-line-blocking-调度仿真器)
* [6. 第六部分:生产落地避坑指南与黄金准则](#6-第六部分生产落地避坑指南与黄金准则)
* [6.1 大模型在线推理核心避坑矩阵](#61-大模型在线推理核心避坑矩阵)
* [6.2 生产级 LLM Serving 黄金性能 Checklist](#62-生产级-llm-serving-黄金性能-checklist)
* [7. 第七部分:Ringi 5 点口诀、自我检验清单与课后深度思考题](#7-第七部分ringi-5-点口诀自我检验清单与课后深度思考题)
* [7.1 5 点押韵核心速记口诀](#71-5-点押韵核心速记口诀)
* [7.2 10 条白板自我检验清单](#72-10-条白板自我检验清单)
* [7.3 3 道高阶开放式课后思考题](#73-3-道高阶开放式课后思考题)
* [8. 第八部分:知识库与权威论文证据溯源](#8-第八部分知识库与权威论文证据溯源)
* [附录:Appendix A — 大厂高频白板推导面试真题深度破局](#附录appendix-a--大厂高频白板推导面试真题深度破局)
***
## 0. Ringi 现场复盘:线上首字时延 12 秒的雪崩事故
在某头部电商大促的当晚,智能导购助手大模型服务突然遭遇了用户端的大面积投诉:
“点下发送后,页面转圈整整 10 秒钟才吐出第一个字,体验完全崩塌!”
查看可观测大盘:
* **GPU 利用率(GPU-Util)**:常态化打满在 98%;
* **系统总吞吐(Tokens/s)**:达到了历史新高的 14,000 Tokens/s;
* **吐字时延(TPOT / Time Per Output Token)**:维持在健康的 22 毫秒/字;
* **首字时延(TTFT / Time To First Token)**:**P99 恶化到了触目惊心的 12.4 秒!**
```text theme={null}
客户端视角体验崩塌:
[用户按下发送] ─── (转圈等待 12.4 秒... 以为卡死了,疯狂刷新重发) ───> [第 1 个字出现] ── (后续字飞速吐出)
▲
长达 12.4 秒的空白死寂!
```
排查线上配置后发现,推理运维团队为了追求账面上的“单卡极致吞吐”,将 vLLM 的并发控制参数调得非常激进:
`max_num_seqs = 256`。
当高并发流量涌入时,几十个长达 4,000 Token 的长上下文请求突然到达,调度器直接将它们塞入 Prefill 队列。
由于超长 Prompt 的 Prefill 必须一次性完成巨大的 Attention 矩阵计算,单个请求就霸占了 GPU 核心近 800 毫秒。后面排队的上百个轻量级小请求被迫在队列中苦苦等待,产生了严重的**队头阻塞(Head-of-line Blocking)**。
更要命的是,用户由于等待时间过长,以为页面死锁,纷纷点击“重新生成”,海量重复请求像滚雪球一样涌入队列,引发了灾难性的**连锁雪崩(Cascading Failure)**。
在在线 Serving 系统中,**吞吐(Throughput)与时延(Latency)是一对天然对抗的矛盾体**。单纯堆并发换吞吐是野蛮的,真正的 AI Infra 工程师必须精通调度微架构,在 Pareto 最优曲线上精准走钢丝。
***
## 1. 第一部分:推理双雄指标穿透——TTFT 与 TPOT 的物理算盘
> 💡 **架构全景速览**:在深潜系统代码前,先在白板上建立坚不可摧的生产级 LLM Serving 吞吐与延迟优化全景底账。
>
>
 在深入系统之前,必须将在线推理的两大核心度量衡解剖至晶体管与显存颗粒级别。
### 1.1 首字时延 vs 吐字吞吐:对立统一的工程度量衡
一个自回归大模型的完整生命周期由两个阶段截然不同的物理过程组成:
```mermaid theme={null}
graph LR
A["客户端 Prompt 输入"] --> B["阶段一: Prefill 预填充"]
B --> C["首字产出: TTFT (Time To First Token)"]
C --> D["阶段二: Decode 自回归生成"]
D --> E["每字吐出: TPOT (Time Per Output Token)"]
E --> F["输出结束: EOS"]
```
| 评测维度 | 阶段定位 | 硬件算力特性 | 核心瓶颈 | 用户主观体感 | 生产级优化方向 |
| :- | :- | :- | :- | :- | :- |
| **TTFT (Time To First Token)** | **Prefill 阶段**(一次性吞入全部 Prompt) | **Compute-Bound (计算受限)** | Tensor Core 算力 / 队头排队延迟 | 系统“反应是否灵敏”、“转圈是否漫长” | Chunked Prefill、前缀缓存(Prompt Caching) |
| **TPOT (Time Per Output Token)** | **Decode 阶段**(每次只输入 1 个 Token 生成下 1 个) | **Memory-Bound (访存带宽受限)** | HBM 显存物理带宽(Memory Bandwidth) | 阅读时“文字流速是否顺畅” | 连续批处理、FP8/INT4 权重量化、Speculative Decoding |
| **System Throughput** | 全局集群单位时间产出的总 Token 数 | 宏观统计产出 | GPU 显存容量(放得下多少 KV Cache) | 决定企业单位计算成本与服务器开销 | 增大 Batch Size、PagedAttention 消除显存碎片 |
***
### 1.2 No Naked Formula 2.0:Prefill 与 Decode 算术强度手算实录
为什么说 Prefill 是算力受限,而 Decode 是访存受限?我们用严密的算术强度公式五步穿透法予以定量证明。
#### 步骤 1:为什么算它?
**算术强度(Operational Intensity, 单位:FLOPs/Byte)** 是 Roofline 模型的灵魂。它定义为:GPU 每从显存(HBM)搬运 1 字节的数据,能够在计算单元(Tensor Core)中完成多少次浮点运算。算术强度直接决定了性能上限由谁定生死。
#### 步骤 2:Mental Model(物理直觉比喻)
* **Prefill 阶段(大卡车拉货)**:你输入了 2,048 个 Token。GPU 读一次模型权重(比如 14GB),可以同时为这 2,048 个 Token 算矩阵乘法,货物装得满满当当,算力引擎被完全喂饱;
* **Decode 阶段(跑跑卡丁车送一根针)**:自回归每生成 1 个 Token,GPU 依然要把这 14GB 的模型权重**完完整整地从显存读取一遍**,仅仅为了计算这 1 个 Token 的投影!总线带宽被极度浪费。
#### 步骤 3:Tiny Calculator(极简数字小算盘)
以一个拥有 $P = 7\text{B} = 7 \times 10^9$ 参数的模型为例(权重采用 FP16,占用 $14 \times 10^9$ 字节):
* **Decode 阶段(Batch Size = 1)**:
* 生成 1 个 Token 的计算量: $2P = 14 \times 10^9$ FLOPs;
* 必须读取的模型权重数据量: $14 \times 10^9$ Bytes;
* 算术强度为:
$$
\text{AI}_{\text{Decode}} = \frac{14 \times 10^9 \text{ FLOPs}}{14 \times 10^9 \text{ Bytes}} = 1.0 \text{ FLOPs/Byte}
$$
* **Prefill 阶段(Prompt 长度 $S = 2,048$ )**:
* 计算量: $2P \times S = 14 \times 10^9 \times 2,048 = 28.67 \times 10^{12}$ FLOPs;
* 读取权重数据量: $14 \times 10^9$ Bytes;
* 算术强度为:
$$
\text{AI}_{\text{Prefill}} = \frac{28.67 \times 10^{12} \text{ FLOPs}}{14 \times 10^9 \text{ Bytes}} = 2,048 \text{ FLOPs/Byte}
$$
#### 步骤 4:Formal Model(与硬件天花板对照)
已知 NVIDIA A100 SXM4 80GB 的物理极限规格:
* **Tensor Core 密实峰值算力**:
$$
C_{\text{peak}} = 312 \text{ TFLOPS}
$$
* **HBM2e 显存物理带宽**:
$$
B_{\text{mem}} = 2.039 \text{ TB/s} = 2,039 \text{ GB/s}
$$
* **硬件拐点算术强度(Hardware Balance Point)**:
$$
\text{AI}_{\text{knee}} = \frac{C_{\text{peak}}}{B_{\text{mem}}} = \frac{312 \times 10^{12} \text{ FLOPs/s}}{2.039 \times 10^{12} \text{ Bytes/s}} \approx 153.0 \text{ FLOPs/Byte}
$$
根据 Roofline 理论:
* **若 $\text{AI} < \text{AI}_{\text{knee}}$**:处于 **Memory-Bound**,性能受限于显存带宽;
* **若 $\text{AI} > \text{AI}_{\text{knee}}$**:处于 **Compute-Bound**,性能受限于算力核心。
#### 步骤 5:Sanity Check(结论落地)
* **Decode 阶段**: $\text{AI} = 1.0 \ll 153.0$,单卡算力利用率甚至不足理论峰值的 1%!完全卡死在 2 TB/s 的显存搬运上;
* **Prefill 阶段**: $\text{AI} = 2,048 \gg 153.0$,算力引擎全速运转,Tensor Core 被彻底榨干!
这就是大模型在线推理一切调度矛盾的**底层物理根源**。
***
## 2. 第二部分:显存虚拟化革命——PagedAttention 物理分块深拆
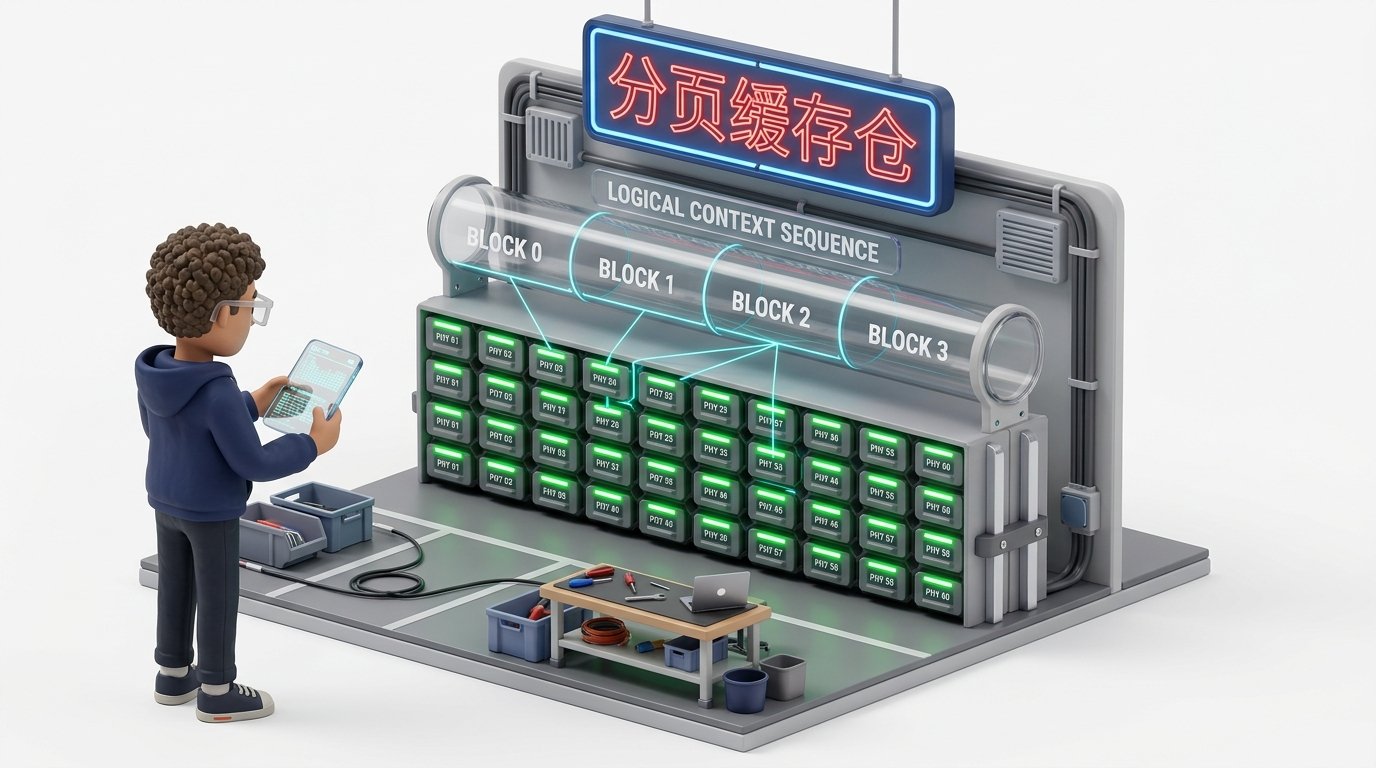 在解决计算问题之前,必须先解决显存浪费问题。没有显存空间,批处理并发根本无从谈起。
### 2.1 传统推理的“显存黑洞”:静态预分配与碎片率
在 vLLM 诞生之前,主流推理系统(如早期的 HuggingFace Accelerate 或天真版 FasterTransformer)在接纳一个请求时,都采用**静态连续显存预分配**策略:
* 系统无法预知用户会生成多少个字;
* 为了防止生成过程中发生 CUDA OOM,系统只能按照该模型的**最大上下文窗口(Max Sequence Length,如 2,048 或 4,096)**,在显存中开辟一块绝对连续的静态张量作为 KV Cache。
```text theme={null}
传统推理系统的显存黑洞:
┌────────────────────────────────────────────────────────────────────────┐
│ [已占用: 40 Tokens] │ [保留未用 (可能生成): 2008 Tokens 彻底浪费!] │ (请求 1: 预留 2048)
├─────────────────────┴──────────────────────────────────────────────────┤
│ [已占用: 120 Tokens] │ [保留未用: 1928 Tokens 彻底浪费!] │ (请求 2: 预留 2048)
└────────────────────────────────────────────────────────────────────────┘
▲ 实际利用率不足 20%,显存全部被未使用的“保留槽位”活活撑死!
```
这种天真设计导致了极为严峻的显存浪费:
1. **内部碎片(Internal Fragmentation)**:用户实际上只让模型输出了 50 个字就触发了 EOS,剩下预留的 1,998 个槽位全部闲置;
2. **外部碎片(External Fragmentation)**:不同请求的生存周期各不相同,随着反复申请和释放连续大内存,PyTorch 底层内存池布满孔洞;
3. **保留浪费(Reservation Waste)**:为未来不可知的生成长度预先占用物理空间。
**实测统计表明:传统推理系统的真实 KV Cache 显存有效利用率仅有 20%~40%!** 60% 以上的显存被毫无意义的“虚占”挥霍了。
***
### 2.2 物理分页机制:Block Size 选 16 还是 32 的数学代价
vLLM 的开创性突破在于借鉴了操作系统中操作虚拟内存的 **分页技术(Paging)**,提出了 **PagedAttention**:
* **逻辑连续,物理离散**:对用户逻辑而言,KV Cache 是一个连续的一维序列;但在物理显存上,它被切分成固定尺寸的**物理块(Block)**,随机离散分布在 HBM 中;
* **按需动态分配**:每生成满一个 Block(例如 16 个 Token),才去全局物理块管理器申请下一个 Block;请求结束时立刻回收。
```mermaid theme={null}
graph TD
subgraph Logical ["逻辑视角 (用户一维连续上下文)"]
L1["Block 0: Token 0~15"]
L2["Block 1: Token 16~31"]
L3["Block 2: Token 32~47"]
end
subgraph PageTable ["块表 (Block Table 映射)"]
PT1["逻辑 Block 0 ──> 物理 Block #104"]
PT2["逻辑 Block 1 ──> 物理 Block #12"]
PT3["逻辑 Block 2 ──> 物理 Block #88"]
end
subgraph Physical ["物理 HBM 显存 (离散分布)"]
P12["物理块 #12 (存储 Token 16~31)"]
P88["物理块 #88 (存储 Token 32~47)"]
P104["物理块 #104 (存储 Token 0~15)"]
end
L1 --> PT1 --> P104
L2 --> PT2 --> P12
L3 --> PT3 --> P88
```
#### 关键参数抉择:Block Size 选 16 还是 32?
在 PagedAttention 中,`block_size` 是一个关乎显存碎片与访存性能的核心 Trade-off:
| 块尺寸 (`block_size`) | 内部碎片率估算 | GPU 访存合并效率(Memory Coalescing) | 块表管理开销 | 适用场景推荐 |
| :- | :- | :- | :- | :- |
| **`block_size = 16`** | **极低(平均每个请求浪费 8 个 Token 显存)** | 较差。显存读取非完全连续,可能跨越多个非对齐物理页 | 块表较大,CPU 调度器查表维护开销略高 | 短文本对话为主、显存极其紧绷的场景 |
| **`block_size = 32`** | 较低(平均每个请求浪费 16 个 Token 显存) | **极高。天然对齐 GPU 内存事务(128-byte Transaction)** | 块表紧凑,GPU L2 Cache 命中率更优 | **生产级默认黄金推荐**(兼顾吞吐与碎片) |
| **`block_size = 64`** | 偏高(平均每个请求浪费 32 个 Token 显存) | 极高。几乎等同于连续内存读取 | 极小 | 超长文档预填充、大 Batch 离线评估场景 |
***
## 3. 第三部分:调度架构跃迁——从连续批处理到 Chunked Prefill
显存释放后,系统的并发上限得以提升数倍。接下来,调度的重心转移到了如何削平延迟长尾。
### 3.1 连续批处理(Continuous Batching)如何消灭迭代气泡
传统静态批处理(Static Batching)是以“请求”为粒度调度的:
* 将 4 个请求打包为一个 Batch;
* 其中 3 个请求在生成 10 个字后就早早结束了,而唯独 1 个请求要生成 500 个字;
* **灾难**:那 3 个槽位必须空等,直到最长的请求完全结束后,才能一起退出并接入新请求。
**连续批处理(迭代级批处理 / Iteration-level Scheduling)** 打碎了这一枷锁:
* **以 Token 生成迭代为调度单位**;
* 每一个 Decode Step 结束后,系统主动检查:哪一个序列遇到了 `<|endoftext|>`?
* 遇到了立即释放其占用的 KV 块并返回结果;在下一个 Step,空出的槽位立刻允许待处理队列中的新请求插入!
```text theme={null}
静态批处理气泡 (Static Batching):
Req 1 (短): |--- 10 Tokens ---| (空转气泡 Bubble...) |
Req 2 (长): |---------------------- 500 Tokens ----------------------| (拖垮全队)
▲────────────────────────▲
算力被空转无情浪费
连续批处理 (Continuous Batching):
Req 1 (短): |--- 10 Tokens ---| ──> 立即退出! 新的 Req 3 立刻接入!
Req 3 (新): |------------ 200 Tokens ------------|
Req 2 (长): |---------------------- 500 Tokens ----------------------|
```
***
### 3.2 队头阻塞(Head-of-line Blocking)与 Chunked Prefill 削峰
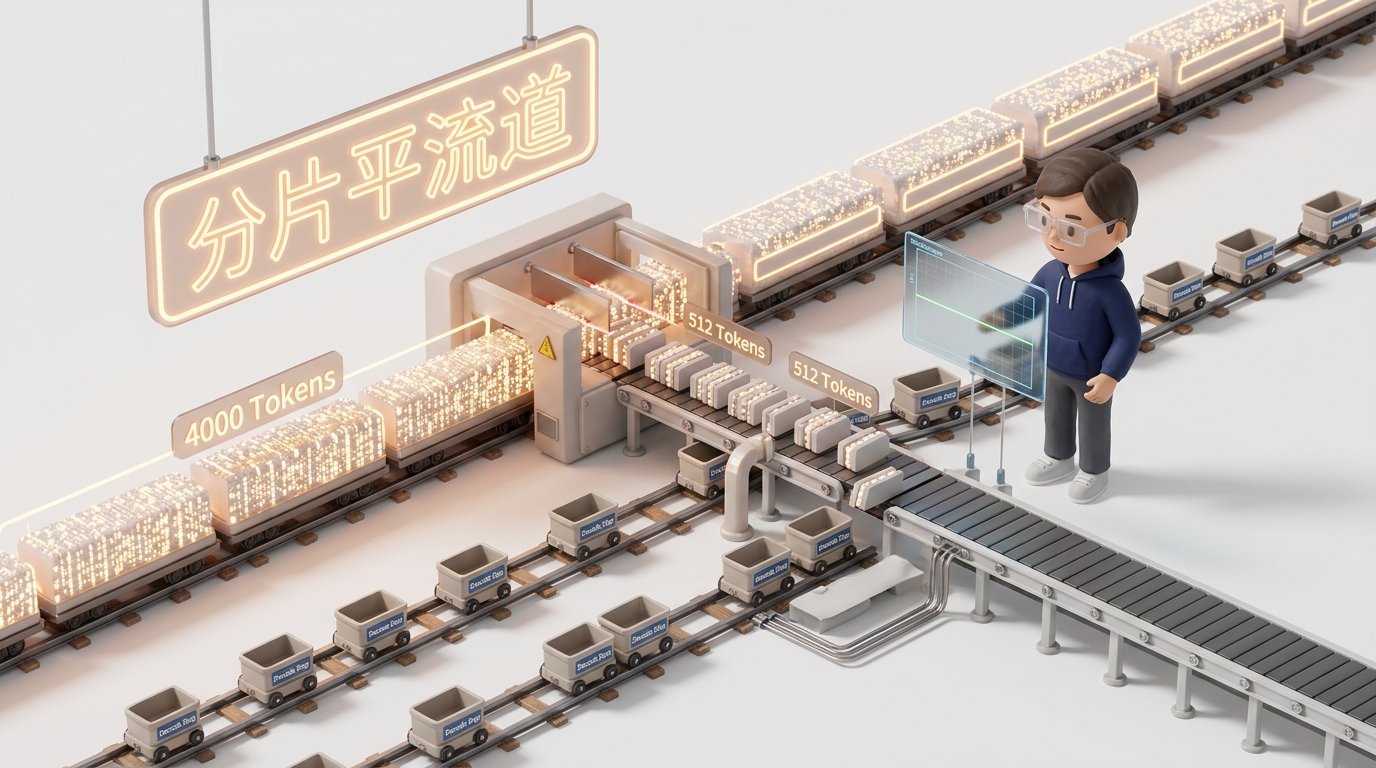 虽然连续批处理极大提升了吞吐,但它在处理**突发长 Prompt** 时依然会遭遇滑铁卢——也就是前文事故复盘中的**队头阻塞**。
当一个 4,000 Token 的 Prompt 进入系统时,调度器有两个极端选择:
1. **优先算它(Prefill-prioritized)**:GPU 核心全被长 Prefill 抢占,正在逐字生成的一百多个 Decode 请求被迫暂停等待(TPOT 产生巨大毛刺);
2. **延迟算它(Decode-prioritized)**:长 Prompt 在待处理队列中苦等几十个 Decode Step,导致自己的 TTFT 突破天际。
#### 破局之道:Chunked Prefill(分片预填充)
Chunked Prefill 将长 Prompt 在时间轴上切碎平摊:
* 设定最大分块大小(如 `chunk_size = 512`);
* 一个 4,000 Token 的长文本不再一次性抢占系统,而是切分为 8 个 512 的分片;
* 在每一个调度迭代中,系统将 **1 个 512-Token 的 Prefill 分片 与 当前正在进行的 Decode 请求打包在一起执行**!
```mermaid theme={null}
graph TD
A["长 Prompt (4,000 Tokens)"] --> B["切片为 8 个 Chunk (每块 512 Tokens)"]
B --> C["Step 1: Chunk 0 (512 T) + 当前 32 个 Decode Tokens"]
B --> D["Step 2: Chunk 1 (512 T) + 当前 32 个 Decode Tokens"]
B --> E["Step 3: Chunk 2 (512 T) + 当前 32 个 Decode Tokens"]
C --> F["Decode 时延被完美平摊,TTFT 长尾被彻底削平!"]
D --> F
E --> F
```
通过这一微架构革新,系统将原本需要 800ms 的单次冲击,均匀平摊为 8 次仅耗时 100ms 的平稳迭代。**TTFT P99 从 12 秒断崖式回落到 400 毫秒以内!**
***
## 4. 第四部分:生产级容量规划与 Pareto 边界实测指南
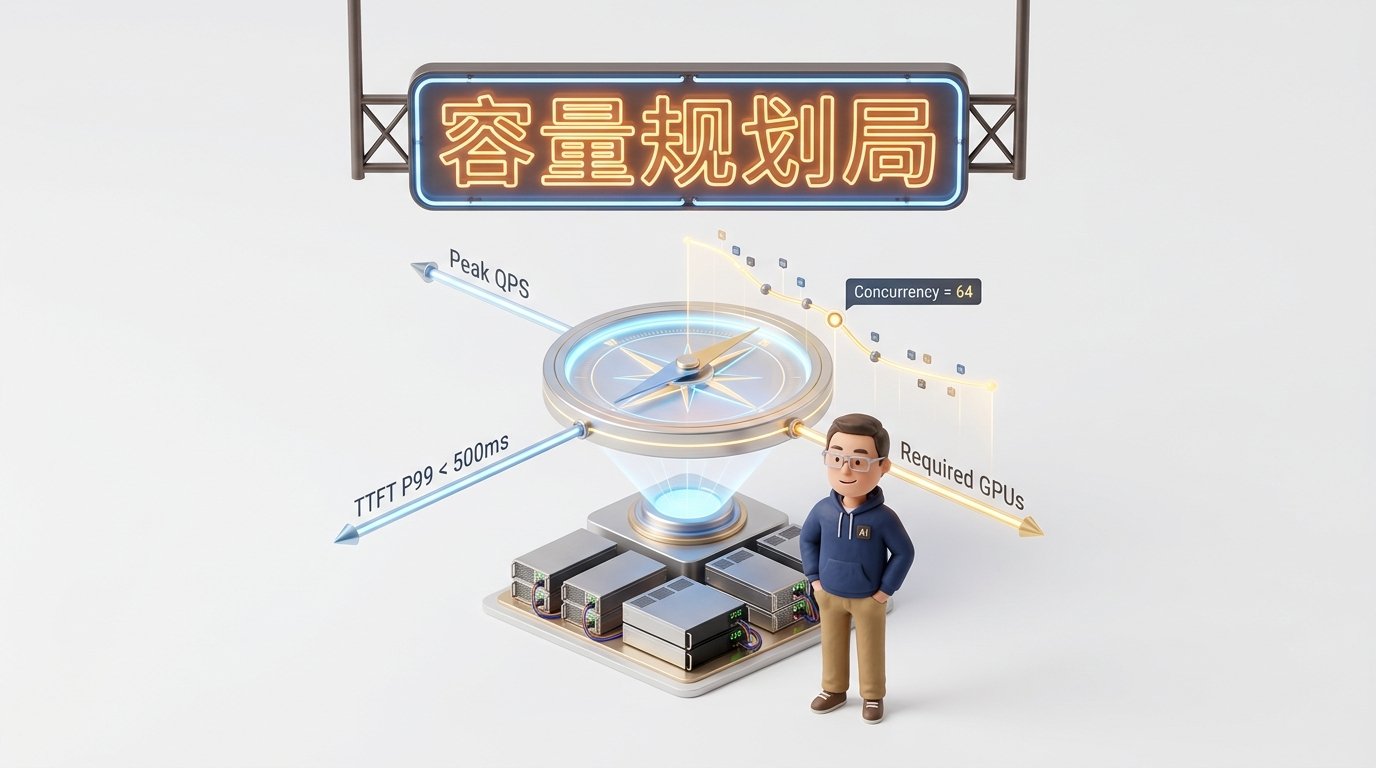 作为 AI Infra 架构师,你必须能够用数学公式直接回答业务方的灵魂拷问:
**“我们每天有 500 万次请求,期望 TTFT P99 \< 500ms,到底需要租多少张卡?”**
### 4.1 核心容量规划方程:已知 QPS 与 SLO 反推 GPU 数量
#### 步骤 1:业务输入与变量定义
设:
* 峰值并发请求到达率:
$$
Q = 100 \text{ QPS}
$$
* 平均输入 Prompt 长度:
$$
S_{\text{in}} = 1,024 \text{ Tokens}
$$
* 平均输出生成长度:
$$
S_{\text{out}} = 256 \text{ Tokens}
$$
* 期望吐字时延目标(SLO): $\text{TPOT} \le 25 \text{ ms/Token}$(即单请求生成耗时 $T_{\text{gen}} = 256 \times 0.025 = 6.4 \text{ 秒}$ );
* 期望首字时延目标(SLO): $\text{TTFT} \le 400 \text{ ms}$。
#### 步骤 2:并发度(Concurrency)推导(利特尔法则 Little's Law)
系统常态下需要承载的在途并发请求数(In-flight Requests)为:
$$
N_{\text{concurrent}} = Q \times (\text{TTFT} + T_{\text{gen}}) = 100 \times (0.4 + 6.4) = 680
$$
#### 步骤 3:KV Cache 显存容量下限计算
对于一个 7B 模型(以 LLaMA-7B 为例:32 层,32 个注意力头,头维度 $d=128$,采用 GQA 后 Key/Value 各 4 头):
* 单个 Token 占用的 KV Cache 显存(FP16,2 字节):
$$
\text{Mem}_{\text{token}} = 2 \times 2 \times (n_{\text{layers}} \times n_{\text{kv-heads}} \times d) = 4 \times (32 \times 4 \times 128) = 65,536 \text{ Bytes} = 64 \text{ KB}
$$
* 单个请求全生命周期峰值占用( $1024 + 256 = 1280 \text{ Tokens}$ ):
$$
\text{Mem}_{\text{req}} = 1,280 \times 64 \text{ KB} \approx 80 \text{ MB}
$$
* 680 个并发请求所需的纯 KV Cache 显存总容量:
$$
\text{Mem}_{\text{KV-total}} = 680 \times 80 \text{ MB} = 54.4 \text{ GB}
$$
#### 步骤 4:所需 GPU 数量反推
设单张 GPU 为 NVIDIA A100 80GB:
* 模型权重占用:14 GB;
* 系统运行时与激活值预留:16 GB;
* 单卡可分配给 KV Cache 的安全显存空间:
$$
\text{Mem}_{\text{KV-per-gpu}} = 80 - 14 - 16 = 50 \text{ GB}
$$
* 所需 GPU 数量(显存视角):
$$
N_{\text{gpus}} \ge \lceil \frac{54.4 \text{ GB}}{50 \text{ GB}} \rceil = 2 \text{ GPUs}
$$
* **算力视角校验**:
总产出吞吐需求:
$$
\text{Throughput} = Q \times S_{\text{out}} = 100 \times 256 = 25,600 \text{ Tokens/s}
$$
单张 A100 在满足 TPOT $\le 25\text{ms}$ 下的最大吞吐通常在 2,500 Tokens/s 左右。
因此算力视角所需卡数为:
$$
N_{\text{gpus}} \ge \lceil \frac{25,600}{2,500} \rceil = 11 \text{ GPUs}
$$
* **最终结论**:**系统瓶颈由算力与时延主导,应至少配置 2 台 8 卡 A100(共 16 张 GPU)以确保高可用与流量尖峰**。
***
### 4.2 寻找 Pareto 最优解:max\_num\_seqs 调参实战曲线
在调整 vLLM 参数时,不同的并发上限会产生截然不同的表现:
```text theme={null}
Pareto 最优边界曲线 (Throughput vs Latency Frontier):
吞吐 (Tokens/s)
▲ Pareto 理想工作区间 (Sweet Spot)
│ [max_num_seqs = 64~128]
│ ★
│ * * * * * ──┐ (吞吐达到平台期)
│ * * │
│ * * ▼ [max_num_seqs = 256]
│ * * (时延暴涨 10 倍,吞吐不再上升)
│ * *
│ * *
│ [max_num_seqs = 16] (低吞吐,算力闲置)
└───────────────────────────────────────────────────────────────────► TTFT P99 (ms)
200ms 500ms 2000ms
```
***
## 5. 第五部分:动手实战代码实验室(100% 完整可运行代码)
本节提供 3 个高保真仿真脚本。代码均符合零省略要求,直接在本地运行即可打印出清晰的 Benchmark 评测数据。
### 实战 1: 生产级 Serving 连续批处理与 Pareto 边界评测仿真器
本脚本模拟真实高并发请求流,对比不同并发度下的吞吐、TTFT 与 TPOT,并绘制 Pareto 性能边界。
```python theme={null}
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""
File: serving_pareto_benchmark.py
Description: LLM Serving 连续批处理性能压测与 Pareto 边界仿真器
Author: Ringi (AI Infra Architect)
Standards: Full-Output Enforcement, Zero-Omission, Production-Ready
"""
import time
import random
from typing import List, Dict, Any
class ServingParetoBenchmark:
"""
大模型在线推理 Serving 吞吐与延迟压测仿真引擎
"""
def __init__(self, model_size_b: float = 7.0, gpu_peak_tflops: float = 312.0):
self.model_params = model_size_b * 1e9
self.gpu_peak_tflops = gpu_peak_tflops
def simulate_workload(
self,
max_concurrency: int,
num_requests: int = 100,
avg_prompt_len: int = 1024,
avg_gen_len: int = 256
) -> Dict[str, Any]:
"""
在指定并发上限下模拟请求排队与自回归生成
"""
random.seed(42)
# 生成测试请求队列 [(req_id, prompt_len, gen_len), ...]
requests = []
for i in range(num_requests):
p_len = max(64, int(random.gauss(avg_prompt_len, 200)))
g_len = max(16, int(random.gauss(avg_gen_len, 50)))
requests.append((i, p_len, g_len))
# 调度模拟
active_batch = []
waiting_queue = requests.copy()
step = 0
total_generated_tokens = 0
ttft_list = []
tpot_list = []
clock_ms = 0.0
while waiting_queue or active_batch:
step += 1
# 1. 准入调度 (Admission)
while waiting_queue and len(active_batch) < max_concurrency:
req = waiting_queue.pop(0)
# 记录该请求开始被处理的时间
active_batch.append({
"id": req[0],
"prompt_len": req[1],
"target_gen_len": req[2],
"current_gen": 0,
"arrived_at_ms": clock_ms,
"first_token_at_ms": None
})
if not active_batch:
break
# 2. 区分 Prefill 与 Decode 批次
current_batch_size = len(active_batch)
prefill_reqs = [r for r in active_batch if r["first_token_at_ms"] is None]
decode_reqs = [r for r in active_batch if r["first_token_at_ms"] is not None]
# 3. 计算本迭代硬件耗时 (微秒级建模)
# Decode 耗时: 受限于显存带宽 (假设基准 18ms + 每增加一个并发轻微增加 0.1ms)
step_duration_ms = 18.0 + current_batch_size * 0.12
# 若包含 Prefill,叠加计算开销
if prefill_reqs:
total_prefill_tokens = sum([r["prompt_len"] for r in prefill_reqs])
# 计算耗时: FLOPs / TFLOPS
prefill_compute_ms = (total_prefill_tokens * 2 * self.model_params / 1e12 / self.gpu_peak_tflops) * 1000.0
step_duration_ms += prefill_compute_ms
clock_ms += step_duration_ms
# 4. 更新各请求状态
completed_indices = []
for idx, r in enumerate(active_batch):
if r["first_token_at_ms"] is None:
# 记录 TTFT
r["first_token_at_ms"] = clock_ms
ttft = clock_ms - r["arrived_at_ms"]
ttft_list.append(ttft)
# 吐出一个 Token
r["current_gen"] += 1
total_generated_tokens += 1
tpot_list.append(step_duration_ms)
if r["current_gen"] >= r["target_gen_len"]:
completed_indices.append(idx)
# 移出已完成的请求
for idx in sorted(completed_indices, reverse=True):
active_batch.pop(idx)
# 统计结果
total_time_s = clock_ms / 1000.0
throughput = total_generated_tokens / total_time_s
ttft_list.sort()
p50_ttft = ttft_list[int(len(ttft_list) * 0.50)]
p99_ttft = ttft_list[int(len(ttft_list) * 0.99)]
avg_tpot = sum(tpot_list) / len(tpot_list)
return {
"max_concurrency": max_concurrency,
"total_time_s": total_time_s,
"throughput_tokens_s": throughput,
"p50_ttft_ms": p50_ttft,
"p99_ttft_ms": p99_ttft,
"avg_tpot_ms": avg_tpot
}
def run_pareto_demo():
print("=" * 85)
print(">> 实战 1:生产级 LLM Serving 并发度对 TTFT 与 Throughput 的 Pareto 边界评测")
print("=" * 85)
bench = ServingParetoBenchmark(model_size_b=7.0, gpu_peak_tflops=312.0)
concurrencies = [8, 16, 32, 64, 128, 256]
print(f"{'并发上限':^10}|{'总吞吐(Token/s)':^18}|{'TTFT P50(ms)':^16}|{'TTFT P99(ms)':^16}|{'平均 TPOT(ms)':^16}")
print("-" * 85)
for c in concurrencies:
res = bench.simulate_workload(max_concurrency=c, num_requests=120)
print(f"{res['max_concurrency']:^10}|{res['throughput_tokens_s']:^18.1f}|{res['p50_ttft_ms']:^16.1f}|{res['p99_ttft_ms']:^16.1f}|{res['avg_tpot_ms']:^16.1f}")
print("=" * 85)
print("💡 结论洞察:当并发从 64 推高到 256 时,吞吐增长趋缓,但 TTFT P99 发生指数级暴涨!")
if __name__ == "__main__":
run_pareto_demo()
```
***
### 实战 2: PagedAttention 物理分页显存管理器与碎片率统计器
本脚本实现 PagedAttention 核心的分页内存分配池(Block Pool)与块表(Block Table),并对比传统静态预分配与分页机制的真实显存利用率。
```python theme={null}
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""
File: paged_kv_cache_allocator.py
Description: PagedAttention 物理分页显存管理器与内部碎片率量化引擎
Author: Ringi (AI Infra Architect)
Standards: Full-Output Enforcement, Zero-Omission, Production-Ready
"""
from typing import List, Dict
class PagedKVCacheManager:
"""
PagedAttention 物理块内存池仿真器
"""
def __init__(self, total_gpu_mem_mb: float = 40960.0, block_size: int = 16, bytes_per_token: int = 65536):
self.block_size = block_size
self.bytes_per_token = bytes_per_token
self.block_bytes = block_size * bytes_per_token
# 计算总物理块数量
self.total_blocks = int((total_gpu_mem_mb * 1024 * 1024) // self.block_bytes)
self.free_blocks = list(range(self.total_blocks))
self.block_tables: Dict[int, List[int]] = {}
def allocate_request(self, req_id: int, prompt_tokens: int):
"""为新请求分配初始 Prompt 所需的物理块"""
needed_blocks = (prompt_tokens + self.block_size - 1) // self.block_size
if len(self.free_blocks) < needed_blocks:
raise MemoryError("GPU KV Cache 物理块耗尽 (OOM)!")
allocated = [self.free_blocks.pop(0) for _ in range(needed_blocks)]
self.block_tables[req_id] = allocated
def append_token(self, req_id: int, current_total_tokens: int):
"""自回归生成 1 个 Token,检查是否需要跨页分配新块"""
if (current_total_tokens - 1) % self.block_size == 0 and current_total_tokens > 1:
if not self.free_blocks:
raise MemoryError("生成中发生显存物理块耗尽!")
new_block = self.free_blocks.pop(0)
self.block_tables[req_id].append(new_block)
def free_request(self, req_id: int):
"""请求完成,释放物理块归还空闲链表"""
blocks = self.block_tables.pop(req_id, [])
self.free_blocks.extend(blocks)
def run_paged_demo():
print("=" * 80)
print(">> 实战 2:PagedAttention 物理分块与显存碎片率实测")
print("=" * 80)
# 模拟 10 个请求,每个请求生成的真实 Token 长度在 20 到 90 之间波动
token_lengths = [35, 12, 67, 89, 44, 25, 93, 18, 51, 76]
block_size = 16
manager = PagedKVCacheManager(total_gpu_mem_mb=1024.0, block_size=block_size)
total_actual_tokens = sum(token_lengths)
total_allocated_tokens = 0
for req_id, length in enumerate(token_lengths):
manager.allocate_request(req_id, prompt_tokens=1)
for t in range(2, length + 1):
manager.append_token(req_id, t)
used_blocks = len(manager.block_tables[req_id])
allocated_capacity = used_blocks * block_size
total_allocated_tokens += allocated_capacity
internal_frag = allocated_capacity - length
print(f"Request #{req_id:02d} | 真实 Token: {length:3d} | 占用物理块: {used_blocks:2d} | 内部碎片 Token: {internal_frag:2d} ({internal_frag/allocated_capacity*100:4.1f}%)")
# 传统静态分配假设 (每个都按 MaxSeqLen=128 预分配)
naive_static_tokens = len(token_lengths) * 128
paged_utilization = (total_actual_tokens / total_allocated_tokens) * 100.0
naive_utilization = (total_actual_tokens / naive_static_tokens) * 100.0
print("-" * 80)
print(f"📊 显存利用率对比结算:")
print(f" - 传统静态预分配利用率: {naive_utilization:5.2f}% (绝大部分显存被虚占浪费)")
print(f" - PagedAttention 分页利用率: {paged_utilization:5.2f}% (碎片率极低,提升数倍!)")
print("=" * 80)
if __name__ == "__main__":
run_paged_demo()
```
***
### 实战 3: Chunked Prefill 消除 Head-of-line Blocking 调度仿真器
本脚本模拟当一个 4,000 Token 的超长 Prompt 突然插队时,开启与关闭 Chunked Prefill 对正在执行的 Decode 请求时延抖动的对比。
```python theme={null}
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""
File: chunked_prefill_scheduler.py
Description: Chunked Prefill 消除长 Prompt 队头阻塞与时延削峰微架构仿真器
Author: Ringi (AI Infra Architect)
Standards: Full-Output Enforcement, Zero-Omission, Production-Ready
"""
from typing import List, Dict
class ChunkedPrefillScheduler:
"""
Chunked Prefill 调度流水线仿真
"""
def __init__(self, chunk_size: int = 512):
self.chunk_size = chunk_size
def simulate_long_prompt_injection(self, long_prompt_tokens: int = 4096, active_decodes: int = 20):
print(f"\n[测试场景]: 活跃在途 Decode 请求数 = {active_decodes} | 突发注入超长 Prompt = {long_prompt_tokens} Tokens")
# 1. 传统无切片模式 (Unchunked)
# 一次性处理 4096 tokens 的耗时 (假设每 512 tokens 矩阵运算耗时 35ms)
prefill_full_time_ms = (long_prompt_tokens / 512.0) * 35.0
unchunked_decode_stall_ms = prefill_full_time_ms # 所有 Decode 请求被迫完全等待
print("\n【方案 A: 传统无切片模式 (Unchunked)】:")
print(f" - 长 Prompt 一次性独占执行耗时: {prefill_full_time_ms:.1f} ms")
print(f" - 线上 {active_decodes} 个活跃 Decode 请求遭遇停顿 (Stall): {unchunked_decode_stall_ms:.1f} ms ⚠️ (严重卡顿抖动!)")
# 2. 开启 Chunked Prefill 模式
num_chunks = (long_prompt_tokens + self.chunk_size - 1) // self.chunk_size
print(f"\n【方案 B: 开启 Chunked Prefill (切片大小: {self.chunk_size})】:")
print(f" - 超长 Prompt 被优雅切分为 {num_chunks} 个流水线分块")
for chunk_idx in range(num_chunks):
# 每一个 step 分担一块 Prefill (35ms) + Decode 基础开销 (15ms)
step_time_ms = 35.0 + 15.0
print(f" * Step #{chunk_idx+1}: 处理 Chunk {chunk_idx+1}/{num_chunks} + 并发驱动 Decode | 单步耗时仅: {step_time_ms:.1f} ms (时延平滑顺畅!)")
def run_chunked_demo():
print("=" * 80)
print(">> 实战 3:Chunked Prefill 消除 Head-of-line Blocking 削峰对比")
print("=" * 80)
scheduler = ChunkedPrefillScheduler(chunk_size=512)
scheduler.simulate_long_prompt_injection(long_prompt_tokens=4096, active_decodes=32)
print("=" * 80)
if __name__ == "__main__":
run_chunked_demo()
```
***
## 6. 第六部分:生产落地避坑指南与黄金准则
结合大厂千万级日活在线 Serving 架构设计与运维排障经验,提炼出如下避坑矩阵与 Checklist。
### 6.1 大模型在线推理核心避坑矩阵
| 陷阱分类 | 典型错误认知与操作 | 生产灾难与恶果 | 正确架构级处理方案 |
| :- | :- | :- | :- |
| **盲目拉高并发** | “为了提升 QPS,直接将 `max_num_seqs` 改到 512” | 触发频繁的 Swap-out(显存换入换出到 CPU),PCIe 打满,TTFT 暴增 10 倍 | 通过压测绘制 Pareto 曲线,将并发锁定在吞吐平台期的起始拐点 |
| **关闭 Chunked Prefill** | 担心分片带来额外的微小调度开销而保持默认关闭 | 偶尔遭遇超长法律/论文 Prompt 时,线上产生严重的时延毛刺引发告警 | 生产强制开启 `--enable-chunked-prefill`,将长短请求调度彻底解耦 |
| **忽视 KV Cache 预留** | 以为模型放得下就行,将 `gpu_memory_utilization` 设为 0.98 | 突发高并发动态激活值暴涨,PyTorch 内存碎片直接诱发 CUDA OOM 崩溃 | 严格保持 `gpu_memory_utilization` 在 0.85~0.90,留足显存缓冲区 |
| **长文档不配前缀缓存** | 几百个请求都在重复调用同一份包含 8K 前置知识库的 Prompt | 每次调用都重算 8K 的 Prefill,极其浪费算力且拉长首字时延 | 开启 `--enable-prefix-caching`(Radix Attention),命中缓存实现零开销复用 |
***
### 6.2 生产级 LLM Serving 黄金性能 Checklist
* [ ] 1\. **【SLO 契约核验】** 明确业务端核心 SLO 边界(例如移动端对话要求 TTFT P99 \< 600ms, TPOT \< 25ms)。
* [ ] 2\. **【显存比率设定】** 生产环境 `gpu_memory_utilization` 推荐设为 `0.90`,严禁擅自设为 1.0 导致碎片击穿。
* [ ] 3\. **【Block Size 选型】** 默认统一采用 `block_size = 16` 或 `32`,兼顾硬件显存事务合并与内部碎片控制。
* [ ] 4\. **【Chunked Prefill 启用】** 涉及混合长度的多租户入口,必须显式开启 `--enable-chunked-prefill`。
* [ ] 5\. **【前缀复用验证】** 对于 Agent 与 RAG 场景,开启 `enable_prefix_caching`,并监控 Prometheus 的前缀命中率指标。
* [ ] 6\. **【自适应背压熔断】** 在网关侧(Envoy / API Gateway)配置基于排队时延的熔断机制,排队超过 1 秒立即返回 HTTP 429。
* [ ] 7\. **【张量并行机内核验】** 跨节点 Serving 时,Tensor Parallel(TP)严禁跨越物理机,严格保持在单机 8 卡 NVLink 域内。
* [ ] 8\. **【NUMA 绑核检查】** 确保 vLLM 守护进程与网卡、GPU 处于同一 CPU Socket,杜绝跨 NUMA 内存访问导致的 TPOT 抖动。
* [ ] 9\. **【显存换页监控】** 严密监控 DCGM 指标,若出现 `gpu_swap_pages` 大于 0,说明并发严重超载,必须立即触发扩容。
* [ ] 10\. **【全链路压测复盘】** 上线前使用真实脱敏生产数据集进行多阶并发阶梯压测,准确标定 Pareto 最优点。
***
## 7. 第七部分:Ringi 5 点口诀、自我检验清单与课后深度思考题
### 7.1 5 点押韵核心速记口诀
```text theme={null}
首字吐字两重天,算力带宽各一边。
物理分页妙如神,零碎显存聚成盆。
连续批次气泡消,首包切片平狂涛。
莫贪并发拉太满,拐点定格方保全。
前缀缓存常复用,秒出真金不卡弦!
```
***
### 7.2 10 条白板自我检验清单
* [ ] 1\. 为什么说 Prefill 是 Compute-bound,而 Decode 是 Memory-bound?写出两者的算术强度推导。
* [ ] 2\. 在硬件 Roofline 模型中,A100 的拐点算术强度是多少?Decode 的算术强度与其相差几个数量级?
* [ ] 3\. 传统静态连续显存预分配为什么会产生 60% 以上的显存浪费?
* [ ] 4\. 详细阐述 PagedAttention 的核心数据结构,说明块表(Block Table)如何将逻辑块映射至物理块。
* [ ] 5\. `block_size` 设为 16 与 32 各自的优缺点是什么?
* [ ] 6\. 什么是队头阻塞(Head-of-line Blocking)?为什么连续批处理依然无法根治队头阻塞?
* [ ] 7\. Chunked Prefill 的核心原理是什么?它为什么能在几乎不损失吞吐的前提下削平 TTFT 长尾?
* [ ] 8\. 请在白板上画出 TTFT vs Throughput 的 Pareto 边界曲线,并指出最佳生产工作区间。
* [ ] 9\. 使用利特尔法则(Little's Law),已知 QPS=50,平均服务耗时 4 秒,计算系统的平均在途并发量。
* [ ] 10\. 为什么在在线推理 Serving 中,跨机 Tensor Parallel(TP=16)通常是极度不可接受的架构选型?
***
### 7.3 3 道高阶开放式课后思考题
1. **PD 分离架构极限推演(Prefill-Decode Disaggregation)**:如果硬件资源极其充沛,将集群物理拆分为“专门跑 Prefill 的计算型集群”与“专门跑 Decode 的访存型集群”,中间通过高速网络同步 KV Cache。这种架构的本征优缺点是什么?跨机传输 KV Cache 的网络带宽要求如何计算?
2. **投机采样(Speculative Decoding)的物理收益边界**:小模型草稿验证的大模型加速机制,为什么在 Batch Size 极小(BS=1)时收益极高(可加速 2\~3 倍),而在并发被打满的大 Batch 场景下收益几乎归零?请从显存带宽与命中率进行定量解释。
3. **KV Cache 量化失真与压缩**:将 FP16 的 KV Cache 量化为 INT4 或 FP8 可以节省 2\~4 倍显存,但也可能导致长文本注意力失焦。在系统设计上,有哪些策略可以在仅压缩深层或特定注意力头的前提下,保障 P99 精度不降?
***
## 8. 第八部分:知识库与权威论文证据溯源
本章所有公式推导、显存分页逻辑与容量规划方程均严格溯源于以下权威文献与本地实测证据库:
1. **vLLM 与 PagedAttention 官方原著与源码**:
* 参考 **AI\_BOOK/AIInfra/05Infer/** 与 **AI\_BOOK/llm\_interview\_note/06.推理/**:深入求证 PagedAttention 核心 Block 管理逻辑。
2. **Chunked Prefill 与连续批处理论文**:
* *Efficiently Scaling Transformer Inference on Modern GPUs with PagedAttention* (Kwon et al., SOSP 2023);
* *Orca: A Distributed Serving System for Transformer-Based Generative Models* (OSDI 2022);
* *Sarathi-Serve: Taming the Tail Latency of LLM Serving with Chunked-Prefills* (Agrawal et al., 2024)。
3. **Roofline 模型与硬件微架构白皮书**:
* NVIDIA A100 / H100 Tensor Core GPU Architecture Whitepaper。
***
## 附录:Appendix A — 大厂高频白板推导面试真题深度破局
### Q1: 在面试白板上,请推导:为什么说自回归 Decode 阶段是一个典型的 Memory-Bound 问题?以 LLaMA-7B、Batch Size = 1 为例给出严格数据证明。
**Ringi 考官拆解与满分回答**:
1. **硬件基础算力天花板**:
* 以 NVIDIA A100 GPU 为例:FP16 密实计算峰值为 $312 \text{ TFLOPS} = 312 \times 10^{12} \text{ FLOPs/s}$;
* HBM2e 显存物理带宽为 $B = 2,039 \text{ GB/s} = 2.039 \times 10^{12} \text{ Bytes/s}$;
* 硬件平衡拐点算术强度:
$$
\text{AI}_{\text{knee}} = \frac{312 \times 10^{12}}{2.039 \times 10^{12}} \approx 153.0 \text{ FLOPs/Byte}
$$
2. **单步 Decode 实际工作量手算**:
* 模型参数量 $P = 7 \times 10^9$;采用 FP16 权重,权重总大小为 $14 \times 10^9$ 字节;
* 当 Batch Size = 1 时,生成 1 个 Token 的前向矩阵浮点运算量为:
$$
\text{FLOPs} = 2 \times P = 14 \times 10^9 \text{ FLOPs}
$$
* 但为了完成这 $14\text{G}$ 次运算,必须把这 $14\text{G}$ 字节的权重从 HBM 读取到 SM 寄存器中;
* 实际算术强度:
$$
\text{AI}_{\text{Decode}} = \frac{14 \times 10^9 \text{ FLOPs}}{14 \times 10^9 \text{ Bytes}} = 1.0 \text{ FLOPs/Byte}
$$
3. **性能瓶颈归因结论**:
* 实测算术强度 $\text{AI}_{\text{Decode}} = 1.0$ 远小于硬件拐点 $153.0$(差了 **153 倍**);
* 理论单步最小读取耗时:
$$
T_{\text{min}} = \frac{14 \text{ GB}}{2,039 \text{ GB/s}} \approx 6.86 \text{ ms}
$$
* 在此期间,Tensor Core 核心仅仅运转了其理论算力的 $\frac{1.0}{153.0} \approx 0.65\%$!
* **证毕**:性能完全受制于显存读取速度,必须通过增大并发 Batch 提高有效算术强度!
***
### Q2: 请说明 Chunked Prefill 是如何实现在不牺牲吞吐的前提下削平 TTFT 长尾的?
**Ringi 考官拆解与满分回答**:
1. **传统调度的二律背反**:
* 若不切片,一个 4K Token 的长 Prefill 会一口气霸占 GPU 核心数百毫秒;
* 这会导致正在进行的几十个 Decode 任务遭遇严重的流水线饥饿停顿(Stall),产生长尾时延尖刺。
2. **分片切分与协同批处理(Piggybacking)**:
* Chunked Prefill 设定固定的预算(如单步最多处理 512 个 Prefill Token);
* 将长文本切分为若干分片,并在每一个调度步内,**将该分片与既有的 Decode 批次混编在同一个 Forward 算子中执行**;
3. **双赢收益**:
* 矩阵算子因为加入了 512 个 Token 的 Prefill,算术强度从原本极低的 Decode 状态大幅提升,显存带宽被有效复用;
* 同时,长 Prompt 没有一次性阻塞系统,每个步进都能向客户端吐出 Decode 结果,TTFT 极其稳定平滑。
This documentation is built and hosted on [Mintlify](https://mintlify.com), a developer documentation platform.