> ## Documentation Index
> Fetch the complete documentation index at: https://lilinji.mintlify.site/llms.txt
> Use this file to discover all available pages before exploring further.
# 第37讲:从 cgroups 盲区到千万级异构拓扑调度:GPU 容器化底座、NVIDIA Container Toolkit 与 K8s Device Plug
> 深入拆解 Linux 容器对 GPU 硬件管理的物理盲区,剖析从 nvidia-docker 到 NVIDIA Container Toolkit 与 CDI 的全栈注入流水线;深度还原 Kubernetes Device Plugin 的 gRPC 状态机与整数标量分配硬伤,穿透下一代 DRA(动态资源分配)结构化参数与异构拓扑感知革命。
# 🏛️ 第37讲:从 cgroups 盲区到千万级异构拓扑调度——GPU 容器化底座、NVIDIA Container Toolkit 与 K8s Device Plugin / DRA 架构全栈解密
> **主讲人**:👓 **Ringi**(大厂 AI Infrastructure 工程师)\
> **所属模块**:[Module 06: 云原生 AI 平台与生产工程](/07_云原生AI平台与生产工程/README)\
> **篇章范式**:☁️ 云原生 AI 平台、生产运维与系统设计篇(Cloud-Native AI Platform & System Design Paradigm)\
> **核心导读**:算法工程师往往以为“在 Dockerfile 里写一句 `FROM pytorch/pytorch`,在 K8s 资源里填一个 `nvidia.com/gpu: 8`”,GPU 就理所当然能在容器里飞驰。然而,Linux 原生的 Namespaces 和 cgroups 对 GPU 这类挂在 PCIe/NVLink 总线上的协处理器硬件存在天然的“物理盲区”;Kubernetes 传统的 Device Plugin 机制,更用一种极其幼稚的“整数标量计数法”将物理拓扑硬生生割裂成信息黑洞,甚至酿成跨 NUMA、跨 PCIe Switch 乱分配卡导致 AllReduce 吞吐暴跌 90% 的生产灾难!本讲将带你并肩拆开机器,从 Linux 内核字符设备、动态链接库注入、OCI Prestart Hook 拦截器一路深潜到 Kubelet gRPC 状态机与下一代 Kubernetes DRA(Dynamic Resource Allocation)结构化参数体系,彻底打通云原生 AI 算力底座的血脉。
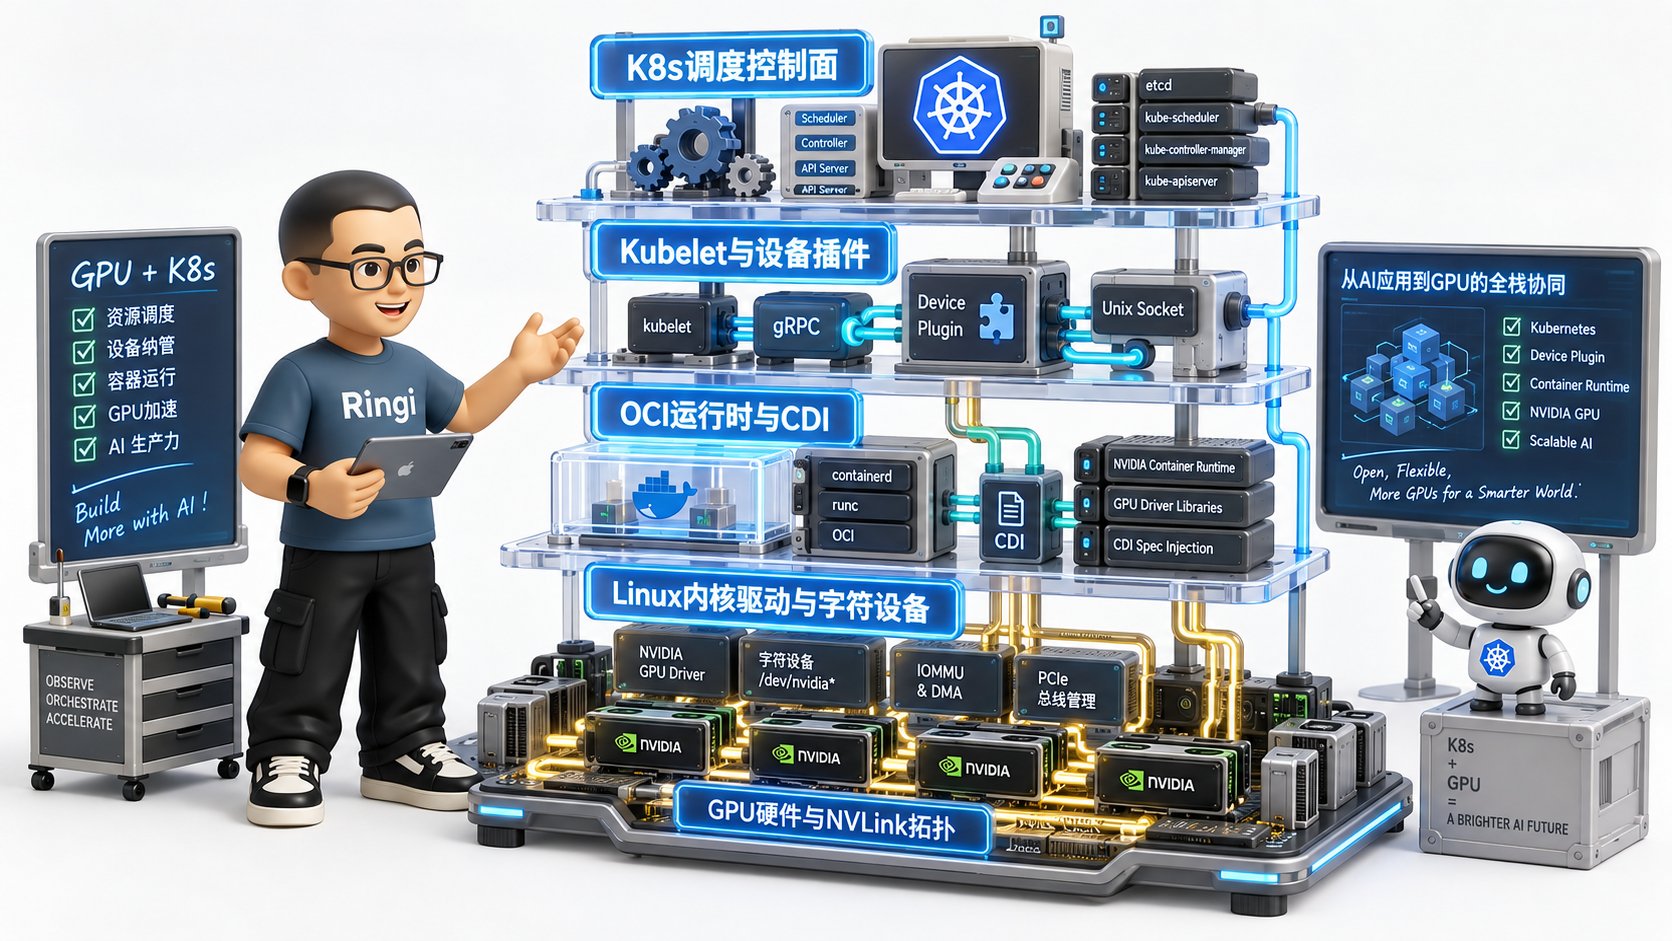 ```text theme={null}
=================================================================================================
Ringi 3D 架构工坊 · 核心全景
┌───────────────────────────────────────────────────────────────────────────────────────────────┐
│ │
│ [Kubernetes 全局控制面 (Control Plane)] │
│ ┌─────────────────────────────────────────────────────────────────────────────────────┐ │
│ │ Kube-Scheduler (调度器) ◄───[DRA Plugin / 结构化参数匹配]───► CRD (ResourceClaim) │ │
│ └───────────────────────────────────────────┬─────────────────────────────────────────┘ │
│ │ Pod 调度决议 (Node Assigned) │
│ [单机节点控制面 (Node Agent Layer)] ▼ │
│ ┌─────────────────────────────────────────────────────────────────────────────────────┐ │
│ │ Kubelet │ │
│ │ ├── Device Manager ◄───[gRPC: Allocate / ListAndWatch]───► NVIDIA Device Plugin │ │
│ │ └── DRA Node Agent ◄───[NodePrepareResources]───────────► DRA Driver Daemon │ │
│ └───────────────────────────────────────────┬─────────────────────────────────────────┘ │
│ │ CRI (CreateContainer / RunPodSandbox) │
│ [容器运行时与设备注入层 (Container Runtime & OCI)] │
│ ┌─────────────────────────────────────────────────────────────────────────────────────┐ │
│ │ containerd / CRI-O ──► OCI Runtime (runc / crun) │ │
│ │ │ │ │
│ │ ▼ (OCI Prestart Hook / CDI Spec) │ │
│ │ nvidia-container-runtime / nvidia-ctk │ │
│ │ │ (调用 C 核心库) │ │
│ │ libnvidia-container1 (mknod 设备 + bind mount 驱动库 + cgroups 白名单) │ │
│ └───────────────────────────────────────────┬─────────────────────────────────────────┘ │
│ │ Syscall / ioctl / 统一虚拟内存 (UVM) │
│ [Linux 内核与物理硬件底座 (Kernel & Hardware Layer)] │
│ ┌─────────────────────────────────────────────────────────────────────────────────────┐ │
│ │ Linux Kernel Modules: nvidia.ko │ nvidia-uvm.ko │ nvidia-modeset.ko │ │
│ ├─────────────────────────────────────────────────────────────────────────────────────┤ │
│ │ 硬件总线拓扑: H100/A100 GPU (SM/HBM) │ NVSwitch/NVLink 环网 │ PCIe Switch │ NUMA │ │
│ └─────────────────────────────────────────────────────────────────────────────────────┘ │
│ │
└───────────────────────────────────────────────────────────────────────────────────────────────┘
=================================================================================================
```
## 📑 目录导航
* [0. Ringi 开场:生产真实现场与痛点冲突](#0-ringi-开场生产真实现场与痛点冲突)
* [0.1 真实工程矛盾:为什么 `docker run` 裸容器看不到 GPU?](#01-真实工程矛盾为什么-docker-run-裸容器看不到-gpu)
* [0.2 线上真实事故复盘:一次千卡预训练集群的“NVLink 拓扑碎裂与性能雪崩”](#02-线上真实事故复盘一次千卡预训练集群的nvlink-拓扑碎裂与性能雪崩)
* [0.3 AI Infra 各层级映射全景速查表](#03-ai-infra-各层级映射全景速查表)
* [1. Linux 容器隔离机制的天然物理盲区与 GPU 硬件特异性](#1-linux-容器隔离机制的天然物理盲区与-gpu-硬件特异性)
* [1.1 Namespaces 与 Cgroups 的“CPU/Memory 偏见”](#11-namespaces-与-cgroups-的cpumemory-偏见)
* [1.2 GPU 设备文件家族解剖:`/dev/nvidia*` 字符设备的内核职责](#12-gpu-设备文件家族解剖devnvidia-字符设备的内核职责)
* [1.3 驱动用户态库与内核模块的“双生纠缠”](#13-驱动用户态库与内核模块的双生纠缠)
* [2. NVIDIA 容器运行时全栈演进与底层挂载机制](#2-nvidia-容器运行时全栈演进与底层挂载机制)
* [2.1 架构演进血泪史:从 nvidia-docker v1 到 CDI](#21-架构演进血泪史从-nvidia-docker-v1-到-cdi)
* [2.2 全栈控制流穿透:libnvidia-container 与 OCI Hook 底层流水线](#22-全栈控制流穿透libnvidia-container-与-oci-hook-底层流水线)
* [2.3 环境变量控制黑魔法:`NVIDIA_VISIBLE_DEVICES` 与 Capabilities](#23-环境变量控制黑魔法nvidia_visible_devices-与-capabilities)
* [2.4 CDI(Container Device Interface)规范深度解密](#24-cdi-container-device-interface-规范深度解密)
* [3. Kubernetes Device Plugin 架构第一性原理与生命周期状态机](#3-kubernetes-device-plugin-架构第一性原理与生命周期状态机)
* [3.1 Device Plugin 核心架构与 Unix Domain Socket 通信网络](#31-device-plugin-核心架构与-unix-domain-socket-通信网络)
* [3.2 gRPC 协议三核心方法深度解剖:Options、ListAndWatch 与 Allocate](#32-grpc-协议三核心方法深度解剖optionslistandwatch-与-allocate)
* [3.3 容器设备分配端到端数据流与状态机时序图](#33-容器设备分配端到端数据流与状态机时序图)
* [3.4 Device Plugin 的“三大致命硬伤”](#34-device-plugin-的三大致命硬伤)
* [4. 走向下一代架构:Kubernetes 动态资源分配(DRA, Dynamic Resource Allocation)](#4-走向下一代架构kubernetes-动态资源分配dra-dynamic-resource-allocation)
* [4.1 为什么需要 DRA?从“计数器分配”到“属性申领”的范式转移](#41-为什么需要-dra从计数器分配到属性申领的范式转移)
* [4.2 DRA 核心资源抽象四剑客:ResourceClass、Claim 与 Structured Parameters](#42-dra-核心资源抽象四剑客resourceclassclaim-与-structured-parameters)
* [4.3 DRA 控制流与调度器协同机制](#43-dra-控制流与调度器协同机制)
* [4.4 拓扑感知与多设备协同绑定实战](#44-拓扑感知与多设备协同绑定实战)
* [4.5 Device Plugin vs CDI vs DRA 全维度对比矩阵](#45-device-plugin-vs-cdi-vs-dra-全维度对比矩阵)
* [5. 生产级进阶:GPU 资源暴露、健康检查与 Xid 故障熔断](#5-生产级进阶gpu-资源暴露健康检查与-xid-故障熔断)
* [5.1 NVML 硬件健康检测机制与 ListAndWatch 故障上报](#51-nvml-硬件健康检测机制与-listandwatch-故障上报)
* [5.2 致命 Xid 故障对 Device Plugin 的冲击与“静默黑洞”问题](#52-致命-xid-故障对-device-plugin-的冲击与静默黑洞问题)
* [5.3 故障快速自愈与节点打污点(Taint & Eviction)协同闭环](#53-故障快速自愈与节点打污点taint--eviction-协同闭环)
* [6. 动手实战与代码实验室(Minimal Runnable Code)](#6-动手实战与代码实验室minimal-runnable-code)
* [6.1 实战 1:纯 Python 手写符合 K8s 规范的 Mock GPU Device Plugin 服务端](#61-实战-1纯-python-手写符合-k8s-规范的-mock-gpu-device-plugin-服务端)
* [6.2 实战 2:生产级容器内 GPU 运行时环境诊断与 Hook 注入验证脚本](#62-实战-2生产级容器内-gpu-运行时环境诊断与-hook-注入验证脚本)
* [6.3 实战 3:GPU 物理拓扑侦测与 NVLink 互联矩阵提取工具](#63-实战-3gpu-物理拓扑侦测与-nvlink-互联矩阵提取工具)
* [6.4 实战 4:CDI 规范文件自动生成与 containerd 容器手动注入验证](#64-实战-4cdi-规范文件自动生成与-containerd-容器手动注入验证)
* [7. Ringi 避坑指南与生产黄金准则](#7-ringi-避坑指南与生产黄金准则)
* [7.1 避坑表格(❌ 常见小白错误理解 vs ✅ 大厂 AI Infra 正确理解)](#71-避坑表格-常见小白错误理解-vs--大厂-ai-infra-正确理解)
* [7.2 生产环境 GPU 容器化与 Device Plugin 黄金 Checklist](#72-生产环境-gpu-容器化与-device-plugin-黄金-checklist)
* [8. Ringi 5 点核心速记口诀、自我检验清单与课后深度思考题](#8-ringi-5-点核心速记口诀自我检验清单与课后深度思考题)
* [8.1 5 点押韵核心速记口诀](#81-5-点押韵核心速记口诀)
* [8.2 10 条白板自我检验清单](#82-10-条白板自我检验清单)
* [8.3 3 道高阶开放式课后思考题(含极限 Corner Case)](#83-3-道高阶开放式课后思考题含极限-corner-case)
* [9. 📚 参考资料与核心源码/经典论文指引](#9--参考资料与核心源码经典论文指引)
* [附录:Appendix A — 大厂硬核高频面试题与白板推导](#附录appendix-a--大厂硬核高频面试题与白板推导)
***
# 0. Ringi 开场:生产真实现场与痛点冲突
## 0.1 真实工程矛盾:为什么 `docker run` 裸容器看不到 GPU?
在刚接触大模型基础设施时,几乎每一个工程师都会经历这样一段令人费解的困惑:
你在宿主机上安装好了 NVIDIA 显卡驱动,敲下 `nvidia-smi`,8 张崭新的 H100 SXM5 显卡整整齐齐地亮着,功耗、温度、显存一切正常。接着,你信心满满地拉取了一个官方的 Ubuntu 镜像,启动了一个最基础的 Docker 容器:
```bash theme={null}
docker run -it --rm ubuntu:22.04 bash
```
进到容器里,你敲下 `nvidia-smi`,终端直接给你泼了一盆冷水:
```text theme={null}
bash: nvidia-smi: command not found
```
你心想:“行,我没装工具包。” 于是你把带有完整 CUDA 运行时的 PyTorch 镜像拉了下来:
```bash theme={null}
docker run -it --rm pytorch/pytorch:2.4.0-cuda12.1-cudnn9-runtime python -c "import torch; print(torch.cuda.is_available())"
```
终端输出的不是预期的 `True`,而是一个冷酷无情的字眼:
```text theme={null}
False
```
很多初学者第一反应是:“容器镜像坏了?还是 PyTorch 版本不对?”\
甚至有人尝试在 Dockerfile 里写下 `RUN apt-get install -y nvidia-driver-535`,试图在容器里“重新安装一遍显卡驱动”——结果要么构建直接报错退出,要么镜像体积飙到几十个 GB,启动依然报错。
为什么?因为大家把“容器”当成了“虚拟机(VM)”。\
**在虚拟化世界里**,Hypervisor 可以通过 PCIe 直通(PCIe Passthrough)或 SR-IOV 把物理硬件直接塞给虚拟机内部独立的操作系统内核。\
**但容器不是虚拟机!容器的本质,只是一组共享宿主机同一个 Linux 内核的隔离进程!**
Linux 原生内核的隔离武器是 Namespaces(隔离视野)和 cgroups(限制资源)。但这两把武器在设计之初,骨子里只有 CPU 时间片、物理内存页、网络栈和磁盘块设备。它们面对插在 PCIe 总线上的 GPU 加速卡时,**在物理层面上根本就是“瞎”的**!
***
## 0.2 线上真实事故复盘:一次千卡预训练集群的“NVLink 拓扑碎裂与性能雪崩”
更致命的冲突发生在 Kubernetes 集群的生产现场。
在某头部大厂千卡分布式预训练集群投产初期,我们曾遭遇过一次轰动整个技术部的“吞吐腰斩惨案”:
当时团队正在调度一个 70B 大模型的预训练任务,采用 `TP=8`(张量并行 Tensor Parallelism 为 8,即单机内 8 张卡必须在每个 Transformer Block 中进行两次高频的 AllReduce 同步通信)。机型为标准的 8 卡 HGX H800 服务器。
任务提交给 Kubernetes 后,调度器看着节点容量 `Allocatable: nvidia.com/gpu: 8`,迅速调度成功,8 个 Pod 顺利拉起。然而,当监控大盘点亮时,所有人惊呆了:
* 正常的单步迭代时间(Iteration Time)应该稳定在 **1.6 秒左右**,模型算力利用率(MFU)应该达到 **62%**;
* 但实测单步时间直接飙升至 **14.8 秒**,MFU 断崖式跌落到 **7.8%**!
* 查看 PyTorch Profiler,算子计算(GEMM)耗时几乎没变,但 `ncclKernel_AllReduce_RING_LL` 通信耗时从单步 180ms 狂飙到了惊人的 **12,400ms**!
排障人员起初怀疑是 NCCL 版本不兼容、或者是 IB 网卡(InfiniBand)丢包。但当我们登录到出问题的物理节点执行拓扑探测时,真凶令人窒息:
```bash theme={null}
nvidia-smi topo -m
```
我们打印出了这台机器的真实拓扑与分配给容器的 GPU ID:
```text theme={null}
=================================================================================================
生产事故节点拓扑与设备分配矩阵
GPU0 GPU1 GPU2 GPU3 GPU4 GPU5 GPU6 GPU7 NUMA Affinity
GPU0 X NV18 NV18 NV18 SYS SYS SYS SYS NUMA 0
GPU1 NV18 X NV18 NV18 SYS SYS SYS SYS NUMA 0
GPU2 NV18 NV18 X NV18 SYS SYS SYS SYS NUMA 0
GPU3 NV18 NV18 NV18 X SYS SYS SYS SYS NUMA 0
-------------------------------------------------------------------------------------------------
GPU4 SYS SYS SYS SYS X NV18 NV18 NV18 NUMA 1
GPU5 SYS SYS SYS SYS NV18 X NV18 NV18 NUMA 1
GPU6 SYS SYS SYS SYS NV18 NV18 X NV18 NUMA 1
GPU7 SYS SYS SYS SYS NV18 NV18 NV18 X NUMA 1
=================================================================================================
*注:该机器由于硬件故障,中间的主板连线损坏,GPU0~3 与 GPU4~7 之间没有 NVSwitch 全互联,跨组只能走慢速 PCIe/QPI (SYS)*
```
**问题根源何在?**\
原来,平台刚上线了一套任务混部逻辑。在此之前,节点上已经跑了一个占用了 2 张卡的小任务。当时 Kubelet Device Plugin 盲目地将 `GPU2, GPU3` 分配给了小任务。\
当 8 卡大模型任务申请 8 张卡时,节点上虽然还有 6 张本地卡,调度器没选它;但在另一个同样被碎片化占用的节点上,Kubelet 分配了非连续的 `GPU0, GPU1, GPU4, GPU5` 给一个 4 卡任务……而在出事故的这台 8 卡完整节点上,由于硬件维保更换了主板模块,8 张卡被物理切分成了两个通过 CPU 慢速总线(SYS)连接的独立的 4 卡环!
**Kubernetes 官方原生的 Device Plugin 只有一个极其原始的机制:它只向 API Server 汇报一个数字——`nvidia.com/gpu: 8`!**\
在 Kubernetes 调度器(Kube-scheduler)的脑子里,这 8 张卡和 8 个 CPU 核心、8 GB 内存没有任何区别,它们被视作完全均质、完全无拓扑关联的“纯整数(Integer Scalar)”。\
调度器根本不知道:
1. 哪些卡之间连着 900 GB/s 的 NVLink,哪些卡之间跨越了 NUMA 节点,走的是带宽只有 32 GB/s 的 PCIe;
2. 哪个 GPU 旁边挂着那块直连的 400 Gbps CX7 InfiniBand 网卡(GPUDirect RDMA 依赖此拓扑);
3. 分配给容器的设备 ID 到底是物理上的哪几张卡。
**一句话点破本质:Device Plugin 的“整数标量模型”与分布式深度学习对“异构总线拓扑”的极致依赖,构成了云原生 AI 平台中最深的一道鸿沟。**
***
## 0.3 AI Infra 各层级映射全景速查表
在深入底层代码之前,我们先把从应用层 `import torch` 一路穿透到物理硬件的完整全栈映射建立起来。这也是每一位大厂 AI Infra 工程师脑中的“全景地图”:
| 层级 (Layer) | 核心组件与承载体 | 核心职责与数据流转 | 暴露的接口 / 协议规范 | 常见生产故障现象 |
| :- | :- | :- | :- | :- |
| **应用与框架层** | PyTorch / Megatron / vLLM | 算子发射、显存申请、构建计算图与调用通信原语 | Python API / CUDA Runtime API (`libcudart.so`) | `CUDA out of memory`、`No CUDA GPUs available` |
| **驱动用户态层** | `libcuda.so`、`libnvidia-ml.so` | 将 CUDA 指令翻译为 GPU 硬件命令流;NVML 硬件状态监控 | CUDA Driver API / NVML API | `driver/library version mismatch`、API 卡死 Hang 住 |
| **容器运行时接口** | containerd / CRI-O / Docker | 接收 Kubelet 指令,管理 Pod 沙箱与容器生命周期 | Kubernetes CRI (Container Runtime Interface) | 容器创建超时、CRI 调用失败重试风暴 |
| **OCI 设备注入层** | `nvidia-container-toolkit` / `CDI` | 拦截 OCI `config.json`,修改 cgroups 白名单,执行 bind mount 与 mknod | OCI Runtime Spec / OCI Prestart Hook / CDI Spec | 设备文件未挂载、`/dev/nvidiactl` 无访问权限 |
| **节点硬件插件层** | Kubelet Device Manager / Device Plugin | 监听设备状态,通过 Unix Socket 向 Kubelet 注册并分配 GPU | K8s Device Plugin API (`v1beta1` gRPC) | 设备显示 `Unhealthy`、Kubelet 丢失 GPU 资源容量 |
| **集群资源调度层** | Kube-scheduler / DRA Plugin / Kueue | 批作业排队、Gang Scheduling、结构化参数解析与拓扑匹配 | K8s Scheduling Framework / DRA (KEP-3063) | 拓扑割裂导致通信降速、多租户死锁、资源碎片 |
| **Linux 内核层** | `nvidia.ko`、`nvidia-uvm.ko` | 驱动 Ring 0 控制、中断响应、统一虚拟内存缺页处理、字符设备控制 | Linux VFS (`ioctl`, `mmap`) / Char Device (Major 195) | 内核 D 状态卡死、Xid 硬件错误日志、Kernel Panic |
| **物理硬件底座** | H100/A100 GPU、NVSwitch、PCIe、IB 网卡 | 算力执行、高速访存(HBM)、机内高带宽通信与机间 RDMA 互联 | NVLink 4.0 / PCIe Gen5 / InfiniBand HDR/NDR | 硬件掉卡(Fall off bus)、NVLink CRC 校验错误 |
***
# 1. Linux 容器隔离机制的天然物理盲区与 GPU 硬件特异性
> 💡 **架构全景速览**:在深潜源码前,先在白板上建立坚不可摧的 GPU 容器化、Device Plugin 与 DRA 调度体系物理底账。
>
>
 ## 1.1 Namespaces 与 Cgroups 的“CPU/Memory 偏见”
为了真正理解 GPU 容器化,我们必须回答 Ringi 工程师五问中的第一问:**在操作系统内核眼中,GPU 到底是什么?**
在 Linux 传统的进程隔离体系中,容器仅仅是一个被轻度隔离的普通进程:
* **Namespaces(命名空间)**:决定了这个进程“能看到什么”。`pid` 让你看不到别人的进程,`net` 让你拥有独立的虚拟网卡,`mnt` 让你拥有独立的根文件系统视图。
* **cgroups(控制组)**:决定了这个进程“能消耗多少资源”。通过 CFS 调度器周期记账来限制 CPU 配额,通过页表扫描和缺页异常记账来限制物理内存(RSS + Page Cache)上限。
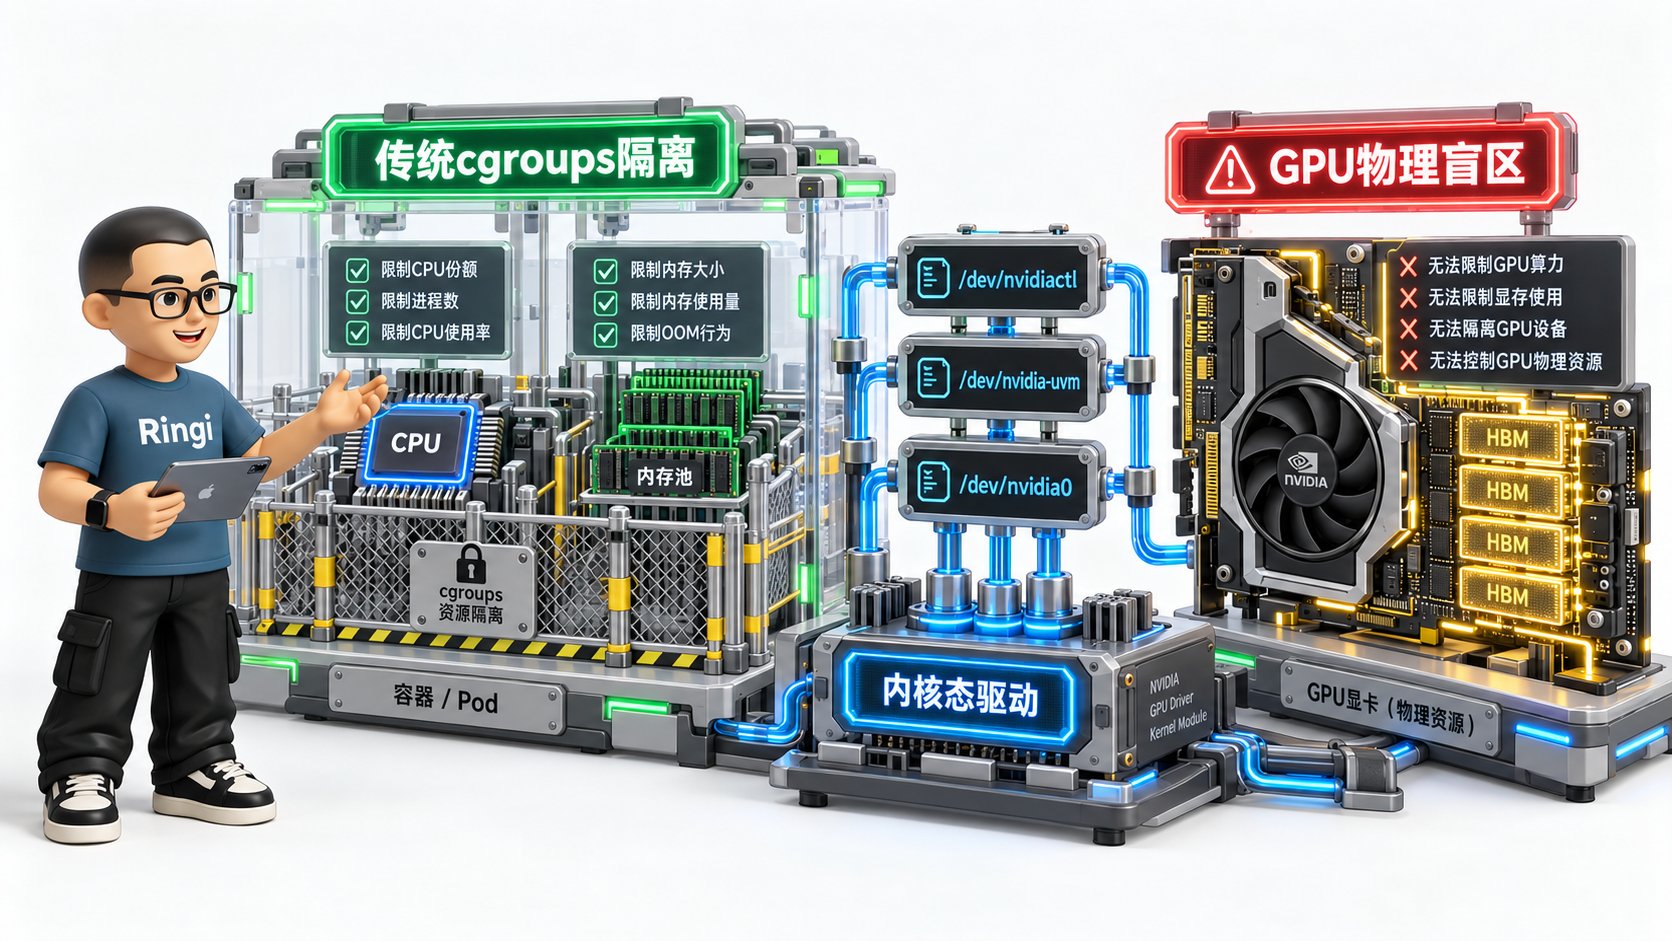 ```text theme={null}
=================================================================================================
Linux cgroups 对通用资源与 GPU 的控制断层
[传统通用计算资源] [GPU 异构加速硬件]
┌────────────────────────┐ ┌────────────────────────┐
│ CPU / RAM │ │ NVIDIA GPU (H100/A100) │
└───────────┬────────────┘ └───────────┬────────────┘
│ 内存寻址与时钟中断 │ 独立的 PCIe / NVLink 总线
▼ ▼
┌────────────────────────┐ ┌────────────────────────┐
│ Linux Kernel Core │ │ Linux Kernel (纯字符设备)│
│ (调度器 CFS / 内存管理) │ │ /dev/nvidia* (Major 195)│
└───────────┬────────────┘ └───────────┬────────────┘
│ 内核直接感知物理页与时钟中断 │ 仅管 open / ioctl 权限
▼ ▼
┌────────────────────────┐ ┌────────────────────────┐
│ cgroups (v1 / v2) │ │ cgroups devices 子系统 │
│ cpu.max / memory.max │ │ 只能判断: 允许读写? │
│ [精准控制与限流 OOM] │ │ [完全管不了算力与显存!] │
└────────────────────────┘ └────────────────────────┘
=================================================================================================
```
**断层在于:Linux 内核根本不知道什么是 GPU 显存,也根本不知道什么是 CUDA 核心。**
当你在 CPU 上申请内存时,走的是操作系统的 `brk` 或 `mmap` 系统调用,物理内存由 Linux 内核的伙伴系统(Buddy System)分配物理页,受到 cgroups `memory.max` 的严格限制。一旦超标,内核直接触发 OOM Killer 杀掉进程。
但当你在 PyTorch 里调用 `torch.cuda.FloatTensor(1024, 1024, 1024)` 时,底层发生了什么?
1. PyTorch 调用 `libcuda.so` 中的 `cuMemAlloc()`;
2. 用户态驱动通过系统调用 `ioctl(fd, NVIDIA_IOCTL_MEM_ALLOC, &args)` 发送指令给 `/dev/nvidia0` 设备文件;
3. Linux 内核接收到这个 `ioctl` 后,直接把它透传给闭源的内核模块 `nvidia.ko`;
4. `nvidia.ko` 操作 GPU 卡上的显存控制器,在 GPU 物理 HBM 颗粒上划分出一块地址空间,返回一个虚拟地址句柄给用户态;
5. **在整个过程中,宿主机 Linux 内核自身的物理内存用量完全没有增加(增加的只有微不足道的几 KB 描述符结构体),Linux cgroups 内存控制器全程处于完全失准的状态!**
这就是为什么:如果你直接用原始的 Docker 把 `/dev/nvidia0` 通过 `--device` 挂进一个普通容器,容器内的代码可以瞬间吃满整张卡 80GB 的显存,而设置在容器上的 `--memory 4g` 根本毫无反应!
***
## 1.2 GPU 设备文件家族解剖:`/dev/nvidia*` 字符设备的内核职责
在 Linux 体系中,“一切皆文件”。显卡在操作系统的投影,就是一系列由驱动创建的字符设备文件(Character Device File)。在多卡计算节点上,执行 `ls -la /dev/nvidia*`,你会看到以下这组典型的设备节点:
```bash theme={null}
crw-rw-rw- 1 root root 195, 0 Aug 24 10:00 /dev/nvidia0
crw-rw-rw- 1 root root 195, 1 Aug 24 10:00 /dev/nvidia1
crw-rw-rw- 1 root root 195, 255 Aug 24 10:00 /dev/nvidiactl
crw-rw-rw- 1 root root 195, 254 Aug 24 10:00 /dev/nvidia-modeset
crw-rw-rw- 1 root root 235, 0 Aug 24 10:00 /dev/nvidia-uvm
crw-rw-rw- 1 root root 235, 1 Aug 24 10:00 /dev/nvidia-uvm-tools
```
这些设备文件绝不是可有可无的,它们在 CUDA 程序执行期间承担着截然不同的内核控制面职责:
### 1. `/dev/nvidia[0-7]`(单卡实例设备)
* **主设备号(Major)**:`195`。**次设备号(Minor)**:对应 GPU 物理索引 `0 ~ N-1`。
* **职责**:每一张物理卡或每一个独立的 MIG 实例对应一个字符设备。这是用户态程序与特定物理 GPU 通信的主通道。CUDA Context 的建立、命令队列的下发、显存分配的 `ioctl` 指令,全部发向该设备。
### 2. `/dev/nvidiactl`(全局控制管理设备)
* **主设备号**:`195`。**次设备号**:`255`。
* **职责**:全局控制器。当用户态程序(如 `nvidia-smi` 或 PyTorch 初始化)首次启动时,必须先打开 `/dev/nvidiactl`,查询当前系统挂载了多少张卡、每张卡的 UUID 是什么、驱动版本是多少。**如果容器漏挂了这个文件,CUDA 初始化会直接报 `Failed to initialize NVML / Driver initialization error`。**
### 3. `/dev/nvidia-uvm`(统一虚拟内存设备)
* **主设备号**:通常为动态分配的数字(如 `235` 或 `240` 等)。
* **职责**:Unified Virtual Memory(UVM)内核驱动设备。负责处理 CPU 内存与 GPU 显存之间的统一寻址空间管理、零拷贝内存映射(Zero-Copy Memory)、以及跨总线的缺页中断换页(Page Fault Handling)。现代大模型训练框架中大量使用 Managed Memory,必须挂载该设备。
### 4. `/dev/nvidia-uvm-tools`(UVM 调试与性能探针设备)
* **职责**:专门用于 Nsight Systems、PyTorch Profiler 等性能分析工具抓取 UVM 换页事件与底层计数器。
### 5. `/dev/nvidia-modeset`(显示模式设置设备)
* **职责**:在纯计算卡(如 H100、A100)上,它主要负责协助时钟频率调节与系统睡眠唤醒状态同步。
***
## 1.3 驱动用户态库与内核模块的“双生纠缠”
这就引出了容器化中最经典的一个面试题与工程难题:\
**为什么我们不能直接把显卡驱动打包到 Docker 镜像里?**
```text theme={null}
=================================================================================================
NVIDIA 驱动架构的“双生分裂”
[用户态空间 (User Space)]
┌────────────────────────────────────────────────────────────────────────────────────────┐
│ 容器内部环境 (Container RootFS) │
│ - 应用程序: Python / PyTorch (`import torch`) │
│ - CUDA Runtime API 库: `libcudart.so` (静态编译或由 PyTorch 镜像自带) │
│ ─────────────────────────────────── 鸿沟界限 ────────────────────────────────────── │
│ - CUDA Driver API 库: `libcuda.so` (必须由宿主机动态注入!) │
│ - NVML 监控库: `libnvidia-ml.so` (必须由宿主机动态注入!) │
└──────────────────────────────────────────┬─────────────────────────────────────────────┘
│ ioctl 系统调用 / 必须完全一致的 ABI 协议版本!
[内核态空间 (Kernel Space)] ▼
┌────────────────────────────────────────────────────────────────────────────────────────┐
│ 宿主机 Linux 内核 (Host Kernel Ring 0) │
│ - `nvidia.ko` (闭源内核模块,必须与宿主机内核版本完全契合) │
│ - `nvidia-uvm.ko` │
│ - 硬件中断处理程序与 GMMU 映射管理 │
└────────────────────────────────────────────────────────────────────────────────────────┘
=================================================================================================
```
NVIDIA 的软件驱动栈在物理上被一分为二:
1. **内核态驱动模块(Kernel Modules)**:包含 `nvidia.ko`、`nvidia-uvm.ko` 等。它们运行在 CPU 的 Ring 0 特权级,必须与当前宿主机的 Linux 内核头文件(Kernel Headers)进行编译绑定,带有特定的 `Vermagic` 签名。**容器没有特权加载内核模块,也不应该加载内核模块**;
2. **用户态驱动库(User Space Driver Libraries)**:包含 `libcuda.so`(CUDA Driver API 实现)、`libnvidia-ml.so`(NVML 管理库)、`libnvidia-ptxjitcompiler.so` 等。它们运行在 Ring 3,负责将上层的 CUDA Runtime API(`libcudart.so`)转换为向内核模块发送的二进制 `ioctl` 载荷。
这两者之间通过私有的系统调用 ABI 协议紧密通信。**内核态驱动模块的版本与用户态驱动库的版本必须严格二进制一致!**
如果你把版本为 `535.129.03` 的 `libcuda.so` 打进镜像,而宿主机的物理内核加载的是 `525.85.12` 的 `nvidia.ko`,当容器启动后,`libcuda.so` 向内核发起 `ioctl` 握手,内核发现 ABI 校验不匹配,会立即拒绝服务,抛出令无数工程师崩溃的错误:
```text theme={null}
CUDA driver version is insufficient for CUDA runtime version
# 或者内核日志输出:
NVRM: API mismatch: the client has the version 535.129.03, but this kernel module has the version 525.85.12.
```
**结论与第一性原理**:\
容器镜像只能包含通用的应用程序和上层的 CUDA Runtime 库(`libcudart.so`);而底层与内核对话的动态链接库(`libcuda.so`、`libnvidia-ml.so` 等)以及字符设备文件,**必须且只能在容器启动的一瞬间,由宿主机的容器运行时工具链动态注入进去!**
***
# 2. NVIDIA 容器运行时全栈演进与底层挂载机制
## 2.1 架构演进血泪史:从 nvidia-docker v1 到 CDI
搞清楚了容器不能打包驱动的原理,接下来就要解决:**怎么把宿主机上的驱动库和设备安全、透明地挂进容器?** 这一机制经历过四代极其漫长的工程演化:
```text theme={null}
=================================================================================================
NVIDIA 容器运行时演化史四代架构跃迁
[第一代: 远古卷轴 (2016)]
docker run ---> nvidia-docker (CLI 包装器) ---> 调用守护进程挂载 Volume ---> dockerd
*缺陷: 强侵入性,无法被 Mesos、Kubernetes 等通用编排工具集成*
[第二代: 运行时分化 (2018)]
Kubelet / Docker ---> dockerd ---> nvidia-container-runtime (定制 OCI 引擎) ---> runc
*缺陷: 必须修改 Docker daemon.json,全局替换运行时,侵入性依旧过高*
[第三代: OCI Hook 工业化 (2019-至今)]
containerd / CRI-O ──► 标准 runc ──► 触发 OCI Prestart Hook (nvidia-container-toolkit)
│
▼ 调用 C 库修改容器 Namespaces
libnvidia-container
*突破: 符合 OCI 标准,无需改动容器运行时核心代码,成为 K8s 事实标准*
[第四代: 声明式现代架构 (2024-未来)]
Pod Spec ──► CDI (Container Device Interface) ──► 生成声明式 JSON ──► 标准无状态注入
*终局: 完全解耦厂商专属 Hook,跨编排引擎标准化*
=================================================================================================
```
1. **第一代(nvidia-docker v1)**:写了一个叫 `nvidia-docker` 的命令行替代品,宿主机跑一个后台守护进程。通过 `docker volume` 的方式把宿主机驱动目录挂进容器。这种方案对于 Kubernetes 这种直接与 Docker Daemon 或 CRI 通信的编排系统完全不可用;
2. **第二代(nvidia-docker v2)**:实现了 `nvidia-container-runtime`,直接作为与 `runc` 平级的 OCI 运行时。Docker 需要配置 `default-runtime: nvidia`。它直接修改了容器的 OCI 规范配置文件 `config.json`;
3. **第三代(NVIDIA Container Toolkit,主流工业标准)**:放弃直接替代 `runc`,而是采用 **OCI Prestart Hook** 机制。容器运行时依然是标准的 `runc` 或 `crun`。当容器根文件系统(RootFS)解压完成、容器进程启动之前,`runc` 会主动调用配置好的 NVIDIA Hook 程序。Hook 会切换进目标容器的 Mount Namespace 和 Cgroups,完成设备节点的创建(`mknod`)和动态库的 `mount --bind`;
4. **第四代(CDI, Container Device Interface)**:云原生设备接口规范,由 CNCF 推动(类似 CNI 和 CSI)。不再依赖 Hook 这种具有副作用的黑魔法脚本,而是使用标准 JSON 文件清晰声明容器需要的环境、挂载点和设备节点。
***
## 2.2 全栈控制流穿透:libnvidia-container 与 OCI Hook 底层流水线
在今天主流的大厂 Kubernetes 节点上,容器运行时大多基于 `containerd`。我们来精确追踪一个带有 GPU 请求的 Pod 启动时,底层经历的秒级执行流:
```text theme={null}
=================================================================================================
NVIDIA Container Toolkit 容器注入控制流全景
[Step 1] Kubelet 发起 gRPC 请求
│ Kubelet CRI ──► containerd (`CreateContainer` / `StartContainer`)
▼
[Step 2] 解析 OCI 配置
│ containerd 读取 Pod 注解与环境变量 (`NVIDIA_VISIBLE_DEVICES=0,1`)
│ 生成标准 OCI `config.json`,其中预设了 Prestart Hook: `/usr/bin/nvidia-container-toolkit`
▼
[Step 3] runc 创建容器沙箱并暂停
│ runc create: 创建容器的 Namespaces (MNT, PID, NET) 与 Cgroups
│ 在正式 `exec` 用户主进程前,阻塞挂起,执行 `prestart` 钩子列表
▼
[Step 4] 触发 NVIDIA Hook 拦截器
│ `/usr/bin/nvidia-container-runtime-hook` 启动,读取 `config.json`
│ 拉起特权 C 语言核心工具: `nvidia-container-cli`
▼
[Step 5] libnvidia-container 物理手术
│ ① 进入容器 Mount Namespace: 将宿主机 `/usr/lib/x86_64-linux-gnu/libcuda.so.X`
│ 通过 `mount --bind` 安全只读挂载到容器 `/usr/lib/x86_64-linux-gnu/`
│ ② 进入容器 Devtmpfs: 调用系统调用 `mknod()` 创建 `/dev/nvidia0`、`/dev/nvidiactl`
│ ③ 操作 cgroups: 向容器的 `devices.allow` 写入允许的字符设备 Major/Minor 规则
│ ④ 刷新容器内动态链接: 隐式执行类似 `ldconfig` 操作,让动态链接器能够找到 `libcuda.so`
▼
[Step 6] runc 恢复并启动用户进程
runc 恢复容器执行,PyTorch 启动,成功调用 `import torch; torch.cuda.is_available()` 返回 True!
=================================================================================================
```
这个流程解释了为什么你的容器镜像里哪怕空空如也,只要基础环境注入成功,进到容器后执行 `ldd /usr/local/cuda/lib64/libcudart.so`,它就能动态解析到位于 `/usr/lib/x86_64-linux-gnu/libcuda.so.1`——**因为底层有一只无形的手(`libnvidia-container`),在容器进程出生的前一毫秒,将宿主机的文件精准地插进了容器的文件树中!**
***
## 2.3 环境变量控制黑魔法:`NVIDIA_VISIBLE_DEVICES` 与 Capabilities
在日常开发和 Kubernetes Pod YAML 中,我们经常看到这两个环境变量:
* `NVIDIA_VISIBLE_DEVICES`
* `NVIDIA_DRIVER_CAPABILITIES`
它们到底是如何在底层发生作用的?
### 1. `NVIDIA_VISIBLE_DEVICES`:控制设备白名单
该环境变量告诉 Hook 该给这个容器暴露哪几张卡:
* `all`:暴露节点上探测到的全部 GPU;
* `0,1` 或 `1,3`:按物理索引暴露特定卡;
* `GPU-f5c7116e-8260-4966-ba4a-xxxx`:按 GPU 的全局唯一 UUID 暴露(生产推荐!因为物理索引号在热插拔或驱动重载时可能发生漂移);
* `void` 或 `none`:不暴露任何 GPU,禁用所有 NVIDIA 驱动注入。
Hook 读取到这个变量后,会调用 NVML 库解析出对应的硬件次设备号,然后**只向容器的 `devices` cgroup 写入该设备号的白名单**。其他卡即使通过路径猜测也无法执行任何 `open` 操作,从而实现硬件隔离。
### 2. `NVIDIA_DRIVER_CAPABILITIES`:控制驱动功能切片
这个变量极其关键!它决定了 Hook 究竟把宿主机上的哪些动态链接库挂进容器。常见的取值组合如下:
| Capability 标签 | 挂载进容器的核心动态库与工具 | 典型使用场景 | 如果漏配的生产灾难 |
| :- | :- | :- | :- |
| `compute` | `libcuda.so`、`libnvidia-ptxjitcompiler.so`、`libfatbinaryloader.so` | 所有 CUDA 算子计算、大模型训练与推理 | PyTorch 无法识别 GPU,报 `No CUDA GPUs available` |
| `utility` | `nvidia-smi` 可执行文件、`libnvidia-ml.so` (NVML) | 监控 GPU 温度、显存使用率、拓扑查询 | 容器内执行 `nvidia-smi` 报 `command not found` |
| `video` | `libnvcuvid.so`、`libnvidia-encode.so` | 视频编解码、硬解码(NVDEC/NVENC) | 多模态视频大模型抽帧失败,CPU 软解导致满载 |
| `graphics` | `libGL.so`、`libEGL.so`、`libvulkan.so` | 图形渲染、仿真环境(如 Isaac Gym) | 机器人强化学习物理引擎崩溃 |
在生产级 AI 容器中,推荐的标准配置为:
```yaml theme={null}
env:
- name: NVIDIA_VISIBLE_DEVICES
value: "all" # 在 K8s Device Plugin 场景下通常由插件动态注入设备 UUID
- name: NVIDIA_DRIVER_CAPABILITIES
value: "compute,utility"
```
***
## 2.4 CDI(Container Device Interface)规范深度解密
尽管 OCI Prestart Hook 方案支撑了过去数年的云原生 AI 发展,但它存在一个严重的工程缺陷:**黑盒与强耦合**。\
Hook 是一个外部可执行程序,一旦它执行崩溃、挂起,容器创建就会直接陷入未知状态;而且容器运行时对 Hook 到底修改了什么一无所知。
为了终结这种混乱,CNCF 推出了 **CDI(Container Device Interface)规范**。\
CDI 的核心思想是:**以声明式的纯 JSON / YAML 静态文件替代动态 Hook 脚本!**
在安装了最新版 `nvidia-container-toolkit` 的节点上,执行:
```bash theme={null}
nvidia-ctk cdi generate --output=/etc/cdi/nvidia.yaml
```
系统会扫描当前物理机的所有硬件,生成一个标准的 CDI 规范文件。我们来看其核心结构:
```yaml theme={null}
cdiVersion: "0.5.0"
kind: "nvidia.com/gpu"
devices:
- name: "0"
containerEdits:
deviceNodes:
- path: "/dev/nvidia0"
type: "c"
major: 195
minor: 0
permissions: "rw"
- path: "/dev/nvidiactl"
type: "c"
major: 195
minor: 255
permissions: "rw"
- path: "/dev/nvidia-uvm"
type: "c"
permissions: "rw"
- name: "all"
containerEdits:
deviceNodes:
- path: "/dev/nvidiactl"
- path: "/dev/nvidia-uvm"
containerEdits:
mounts:
- hostPath: "/usr/lib/x86_64-linux-gnu/libcuda.so.535.129.03"
containerPath: "/usr/lib/x86_64-linux-gnu/libcuda.so.1"
options: ["ro", "nosuid", "nodev", "bind"]
- hostPath: "/usr/lib/x86_64-linux-gnu/libnvidia-ml.so.535.129.03"
containerPath: "/usr/lib/x86_64-linux-gnu/libnvidia-ml.so.1"
options: ["ro", "nosuid", "nodev", "bind"]
env:
- "NVIDIA_DRIVER_CAPABILITIES=compute,utility"
```
**CDI 的巨大飞跃在于**:\
容器运行时(如 containerd 1.7+、CRI-O)在拉起容器时,原生理解 CDI 规范。Kubelet 只需告诉运行时:“请挂载设备 `nvidia.com/gpu=0`”。containerd 直接在内核层面读取对应的 `deviceNodes` 和 `mounts` 执行标准配置,**全程没有任何第三方外挂 Hook 脚本参与!** 这大幅提升了高并发启动千卡容器时的稳定性和可观测性。
***
# 3. Kubernetes Device Plugin 架构第一性原理与生命周期状态机
## 3.1 Device Plugin 核心架构与 Unix Domain Socket 通信网络
当单机层面的设备注入被 `NVIDIA Container Toolkit` 解决后,问题来到了集群层面:\
**Kubernetes 调度器如何知道一台节点上有几张 GPU?Kubelet 如何决定把哪张 GPU 分配给哪个 Pod?**
这就是 `Kubernetes Device Plugin` 框架的使命。它的设计哲学非常干净:**通过 gRPC over Unix Domain Socket(UDS),将特定硬件厂商的设备探测逻辑与 Kubelet 核心解耦。**
```text theme={null}
=================================================================================================
Kubernetes Device Plugin 节点通信架构与目录拓扑
[宿主机文件系统目录: /var/lib/kubelet/device-plugins/]
├── kubelet.sock ◄───────── [Kubelet 监听的注册服务 (Registration gRPC Server)]
│ ▲
│ │ 1. 发起 RegisterRequest(ResourceName="nvidia.com/gpu")
│ │
└── nvidia-gpu.sock ───────────┴─ [NVIDIA Device Plugin 监听的插件服务 (DevicePlugin gRPC Server)]
│
├── 2. ListAndWatch() ────► 长连接流式推送: [GPU-UUID-0: Healthy, GPU-UUID-1: Healthy...]
│
└── 3. Allocate() ◄──────── Kubelet 发起分配: 请求设备 ["GPU-UUID-0"]
返回: 环境变量 NVIDIA_VISIBLE_DEVICES=GPU-UUID-0
=================================================================================================
```
### 核心设计规范
1. **通信介质**:所有的 gRPC 通信均建立在节点本地的 Unix Domain Socket 上(默认路径 `/var/lib/kubelet/device-plugins/`),杜绝跨网络的非必要安全开销与延迟;
2. **注册时序**:
* Kubelet 启动,并在 `/var/lib/kubelet/device-plugins/kubelet.sock` 开启 `Registration` 服务;
* 作为 DaemonSet 运行的 `nvidia-device-plugin` 启动,在同目录下创建自己的 Socket(如 `nvidia-gpu.sock`);
* Plugin 主动连接 `kubelet.sock`,发起 `Register(ResourceName="nvidia.com/gpu")`;
* Kubelet 验证通过后,反向建立到 `nvidia-gpu.sock` 的长连接通道。
***
## 3.2 gRPC 协议三核心方法深度解剖:Options、ListAndWatch 与 Allocate
根据 Kubernetes 官方规范(`k8s.io/kubelet/pkg/apis/deviceplugin/v1beta1`),一个合法的 Device Plugin 必须实现以下 protobuf 定义的接口:
```protobuf theme={null}
service DevicePlugin {
// 1. 协商插件支持的可选特性能力
rpc GetDevicePluginOptions(Empty) returns (DevicePluginOptions) {}
// 2. 核心状态同步流:持续向 Kubelet 推送设备清单与健康状态
rpc ListAndWatch(Empty) returns (stream ListAndWatchResponse) {}
// 3. 核心分配接口:在容器启动前,为容器生成设备挂载与环境变量
rpc Allocate(AllocateRequest) returns (AllocateResponse) {}
// 4. 容器启动前预处理(可选)
rpc PreStartContainer(PreStartContainerRequest) returns (PreStartContainerResponse) {}
// 5. 拓扑感知偏好分配(可选)
rpc GetPreferredAllocation(PreferredAllocationRequest) returns (PreferredAllocationResponse) {}
}
```
我们逐一拆解三大关键方法的工业级内幕:
### 1. `GetDevicePluginOptions`(能力协商)
```protobuf theme={null}
message DevicePluginOptions {
bool pre_start_required = 1;
bool get_preferred_allocation_available = 2;
}
```
当 Kubelet 与插件建立连接后,第一件事就是调用该接口。插件可以告知 Kubelet:“在容器真正拉起前,我是否需要执行一次 `PreStartContainer` 设备重置?”或者“我是否支持拓扑分配偏好协商?”
### 2. `ListAndWatch`(心跳与健康状态机)
这是一个 **Server Streaming RPC(服务端流式推送接口)**。
* 一旦建立连接,Device Plugin 必须**立即**推送当前节点上所有的设备 ID 及其健康状态(`Healthy` 或 `Unhealthy`);
* 此后,该 gRPC 连接必须**永久保持不断开**。Device Plugin 内部启动一个监控协程(通过 NVML 轮询或事件监听)。只要某张卡发生硬件故障(如掉卡、温度过载),插件立即顺着这个 Stream 向 Kubelet 推送一条更新消息;
* **Kubelet 的动作**:Kubelet 收到设备列表后,将其数量统计汇总,更新到 Node 对象的 `status.capacity["nvidia.com/gpu"]` 和 `status.allocatable["nvidia.com/gpu"]` 中。
### 3. `Allocate`(运行态设备绑定翻译器)
当 Kubernetes 调度器把一个申请了 GPU 的 Pod 绑定到当前节点后,Kubelet 开始创建 Pod。在容器启动前,Kubelet 检查本地的设备分配记录本,挑选出可用的设备 ID(例如 `["GPU-0"]`),然后调用插件的 `Allocate` 接口:
```protobuf theme={null}
message AllocateRequest {
repeated ContainerAllocateRequest container_requests = 1;
}
message ContainerAllocateRequest {
repeated string devicesIDs = 1; // Kubelet 选定的设备 UUID 列表
}
message AllocateResponse {
repeated ContainerAllocateResponse container_responses = 1;
}
message ContainerAllocateResponse {
map envs = 1; // 注入容器的环境变量
repeated Mount mounts = 2; // 需要挂载的文件
repeated DeviceSpec devices = 3; // 需要暴露的字符设备
map annotations = 4; // 附加到容器的注解
repeated CDIDevice cdi_devices = 5; // CDI 设备标识 (现代规范)
}
```
NVIDIA Device Plugin 在 `Allocate` 中做的事情极其干脆:\
它把传入的设备 UUID 拼成一个逗号分隔的字符串,然后填入返回体的 `envs["NVIDIA_VISIBLE_DEVICES"] = "GPU-xxx,GPU-yyy"`,或者填入 `cdi_devices`。随后,Kubelet 会将这些配置合并到 CRI 请求中发给 containerd!
***
## 3.3 容器设备分配端到端数据流与状态机时序图
让我们把所有环节串联起来,观察一个申请了 `resources.limits["nvidia.com/gpu"]: 2` 的 Pod 从提交到运行的端到端完整时序:
```mermaid theme={null}
sequenceDiagram
autonumber
participant Dev as 算法工程师
participant API as K8s API Server
participant Sched as Kube-Scheduler
participant Kubelet as Node Kubelet
participant DP as NVIDIA Device Plugin
participant CRI as containerd (CRI)
participant OCI as runc + NVIDIA Hook
Note over DP,Kubelet: 节点初始化阶段
DP->>Kubelet: RegisterRequest(ResourceName="nvidia.com/gpu")
Kubelet-->>DP: RegisterResponse(Success)
DP->>Kubelet: ListAndWatch Stream: [GPU0: Healthy, GPU1: Healthy, GPU2: Healthy]
Kubelet->>API: Patch Node Status: allocatable["nvidia.com/gpu"] = 3
Note over Dev,OCI: 任务调度与执行阶段
Dev->>API: 提交 Pod (limits: nvidia.com/gpu=2)
Sched->>API: 调度决策: 绑定 Pod 到该 Node (只看数字: 3 >= 2)
API->>Kubelet: 监听到 Pod 调度事件 (Pod Scheduled)
rect rgb(240, 248, 255)
Note over Kubelet,DP: 设备分配核心闭环
Kubelet->>Kubelet: 从本地账本挑选空闲设备: [GPU0, GPU1]
Kubelet->>DP: Allocate(devicesIDs=["GPU0", "GPU1"])
DP-->>Kubelet: AllocateResponse(envs={"NVIDIA_VISIBLE_DEVICES": "GPU0,GPU1"})
end
Kubelet->>CRI: CreateContainer(注入环境变量 NVIDIA_VISIBLE_DEVICES=GPU0,GPU1)
CRI->>OCI: runc create container (生成 config.json)
OCI->>OCI: 触发 Prestart Hook: nvidia-container-toolkit
Note over OCI: 注入 /dev/nvidia0, /dev/nvidia1
Bind mount libcuda.so
OCI->>CRI: 容器进程就绪 (runc start)
CRI-->>Kubelet: Pod 处于 Running 状态
```
***
## 3.4 Device Plugin 的“三大致命硬伤”
尽管 Device Plugin 构成了过去数年云原生 GPU 管理的基石,但在大规模 AI 集群生产实践中,它暴露出了三个无法通过局部打补丁解决的**致命物理硬伤**:
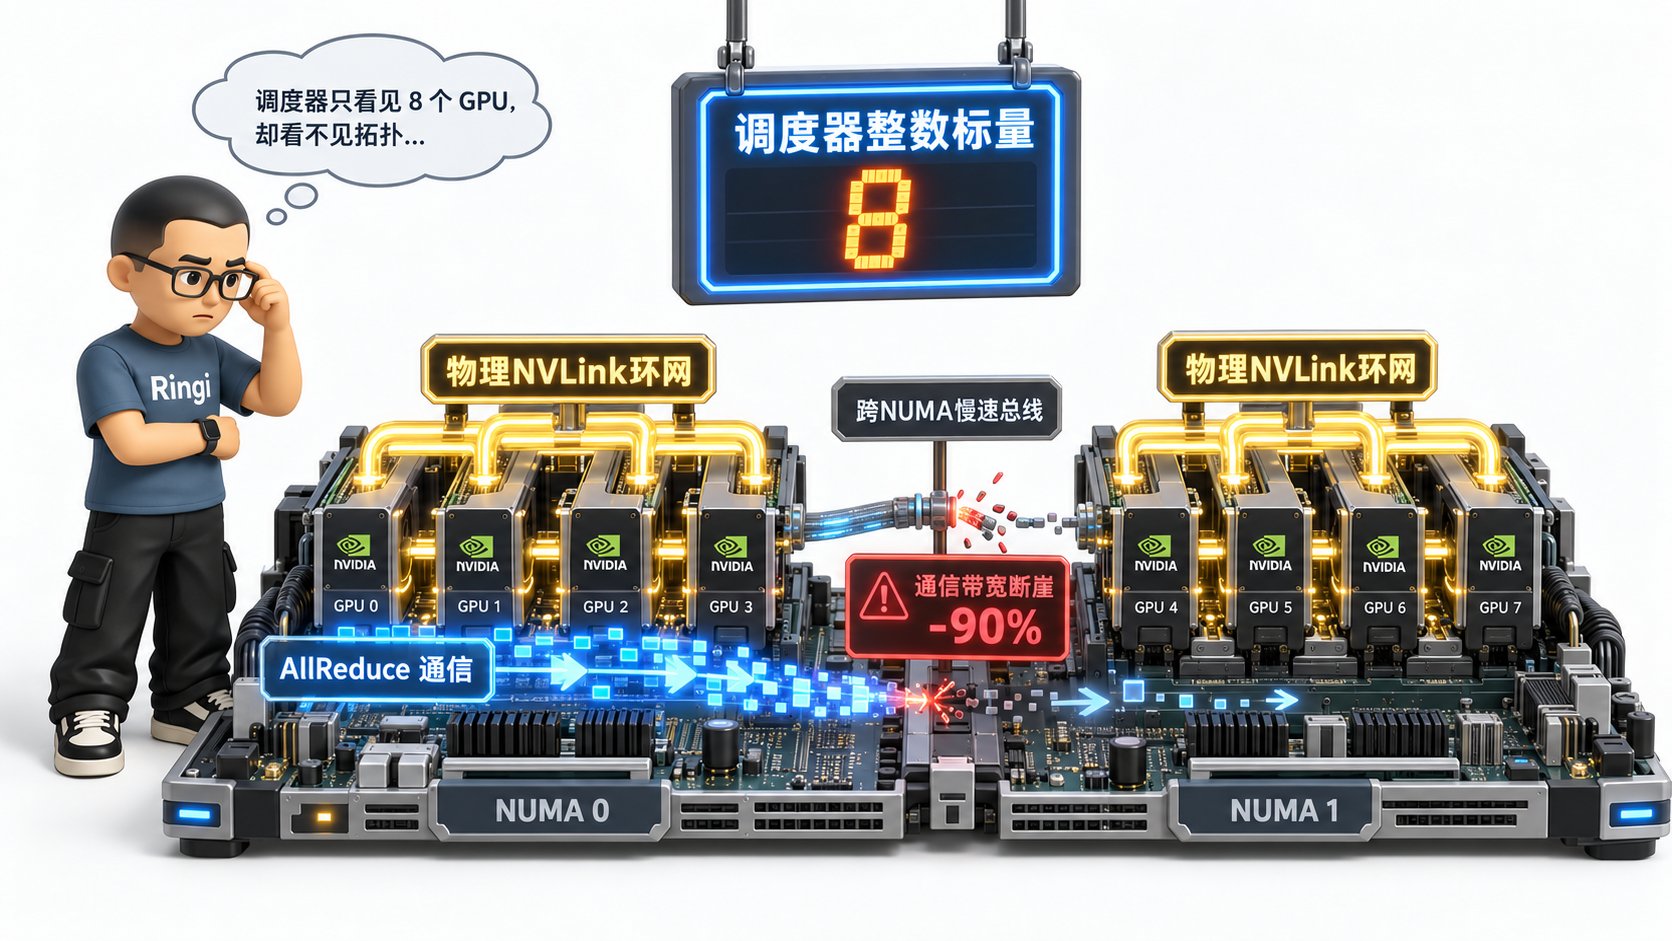 ```text theme={null}
=================================================================================================
Device Plugin 的三大致命物理硬伤
[硬伤 1: 整数标量黑洞]
Pod A 申请 0.5 卡? ──► API 校验报错: `nvidia.com/gpu: 0.5` is invalid! 只能填正整数 1, 2, 4!
*后果: 小模型推理必须霸占整张 80GB 卡,集群显存利用率长期徘徊在 15%~25%!*
[硬伤 2: 调度器拓扑失明]
Kube-Scheduler 看到: Node A 剩余 4 卡 ──► 调度决策通过!
实际硬件拓扑: 2 张在 NUMA 0 (PCIe Gen4), 2 张在 NUMA 1 (无 NVLink 连接)
*后果: 分布式训练 AllReduce 走 CPU QPI 总线,通信带宽暴跌 90%!*
[硬伤 3: 无法多资源协同绑定]
我要申请: 8 张 H100 + 同一 NUMA 节点的 8 张 400G InfiniBand 网卡 + 64 个本地 CPU 核心
Device Plugin 架构: GPU 插件、NIC 插件、CPU Manager 各自为政,完全无法进行联合图匹配求解!
=================================================================================================
```
### 硬伤 1:纯整数标量(Integer Scalar Resource)
在 Kubernetes 核心资源模型中,扩展资源(Extended Resources)必须是整数,且不能超卖(Non-overcommit)。\
你无法在 Pod 规范中声明 `nvidia.com/gpu: 0.2`(申请 20% 算力或 16GB 显存)。这直接导致在轻量级模型推理、开发调试 Notebook 场景下,大量的 GPU 显存被彻底浪费。虽然业界诞生了腾讯云 qGPU、阿里 cGPU、开源的 HAMi 等各种通过劫持 CUDA API(`cudaMalloc`)的用户态/内核态显存切分方案,但它们全部是“外挂式 hack”,在原生 K8s API 看来极其别扭且无法形成统一的调度标准。
### 硬伤 2:全局调度器(Kube-scheduler)的“拓扑失明”
Kube-scheduler 在决定把 Pod 放到哪个 Node 时,手头掌握的唯一信息就是:`Allocatable - Requested >= Pod Request`。\
真正的设备选择权,被延后到了 Pod 已经降落到宿主机之后、由 Kubelet 本地的 Device Manager 决定。\
**调度器没有拓扑图,单机 Kubelet 没有全局视野。**\
这就造成了我们在第 0.2 节复盘的灾难:调度器以为自己把任务调度到了一个有 8 张卡的节点上,结果这 8 张卡被 Kubelet 随意分配了没有 NVLink 互联的跨 NUMA 卡,千卡集群的通信性能瞬间毁于一旦。
### 硬伤 3:多异构设备联合绑定的不可达
大模型训练不仅需要 GPU,更需要配套的 **InfiniBand / RoCE 高速网卡** 以及对应的 **本地 NUMA CPU 核心与内存通道**。\
在现有的架构下,GPU 有 GPU Device Plugin,Mellanox 网卡有 RDMA Device Plugin,CPU 有 Kubelet CPU Manager。三个组件各管各的 Socket,彼此之间形同陌路。在分配时,网卡分到了 NUMA 0,GPU 却分到了 NUMA 1,数据必须跨越 CPU UPI 总线“跑马拉松”,无法实现现代高性能计算所必需的 **GPUDirect RDMA(GDR)** 零拷贝通信!
***
# 4. 走向下一代架构:Kubernetes 动态资源分配(DRA, Dynamic Resource Allocation)
## 4.1 为什么需要 DRA?从“计数器分配”到“属性申领”的范式转移
为了彻底根除 Device Plugin 的历史包袱,Kubernetes 社区从 1.26 引入、并在 1.30+ 引入结构化参数(Structured Parameters)重塑了硬件纳管体系——这就是 **DRA(Dynamic Resource Allocation,KEP-3063)**。
DRA 的核心思想可以类比为:**把对计算硬件的管理,从“无脑的 Pod Resources 计数”,升级为类似于存储体系“PV / PVC”的声明式“申领(Claim)模型”!**
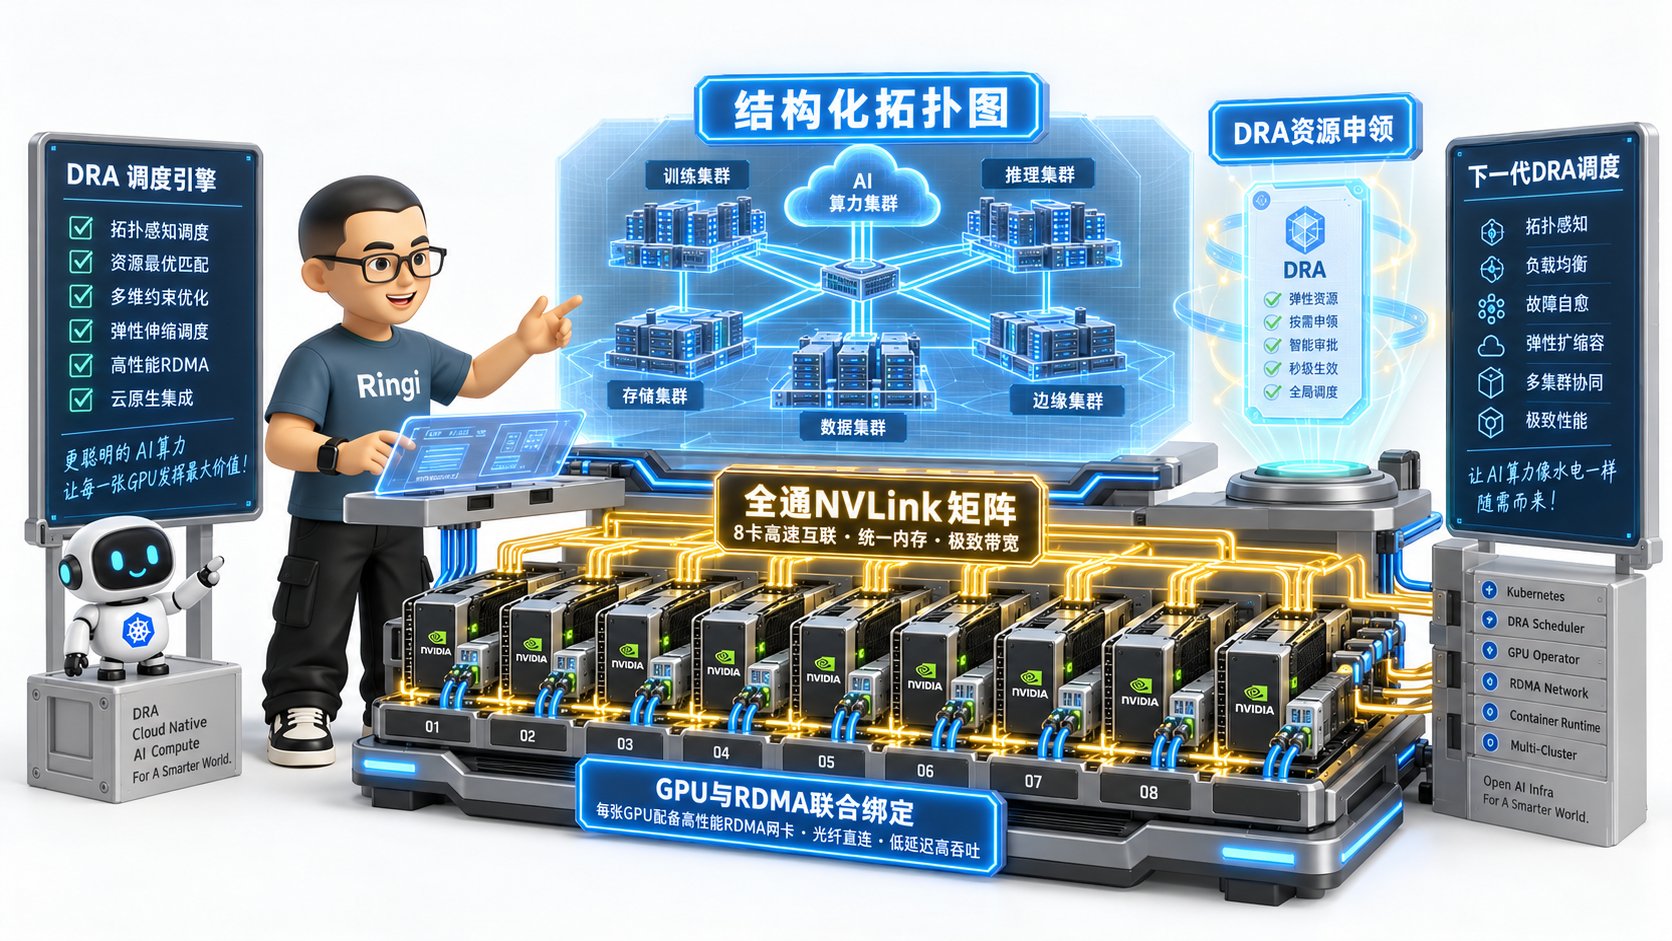 ```text theme={null}
=================================================================================================
资源管理模式的范式跃迁: Device Plugin vs DRA
[Device Plugin 模式: 计数器模型]
Pod Spec:
resources:
limits:
nvidia.com/gpu: "2" ◄─── 极其简陋的“2 张卡”整数计数,无属性、无拓扑、无切分
[DRA 模式: 属性化结构申领模型 (ResourceClaim)]
Pod Spec:
resourceClaims:
- name: my-gpu-cluster
resourceClaimTemplateName: h100-nvlink-8gpu-template
ResourceClaim 定义:
"我要 8 张 GPU,必须具备 NVLink 全互联,单卡显存 >= 80GB,且每张卡必须绑定就近的 CX7 网卡"
▲
└─── 调度器在调度阶段直接进行多维拓扑与参数图匹配计算!
=================================================================================================
```
***
## 4.2 DRA 核心资源抽象四剑客:ResourceClass、Claim 与 Structured Parameters
DRA 在 Kubernetes API 中建立了一套极其严密的对象模型:
### 1. `DeviceClass`(在早期版本为 `ResourceClass`)
定义某种设备大类,类似于存储的 `StorageClass`。由集群管理员预先创建:
```yaml theme={null}
apiVersion: resource.k8s.io/v1alpha3
kind: DeviceClass
metadata:
name: nvidia-h100-training
spec:
selectors:
- cel:
expression: "device.driver == 'gpu.nvidia.com' && device.attributes['model'].string == 'H100-SXM5-80GB'"
```
### 2. `ResourceClaimTemplate` 与 `ResourceClaim`
定义用户的具体资源申领需求:
```yaml theme={null}
apiVersion: resource.k8s.io/v1alpha3
kind: ResourceClaimTemplate
metadata:
name: h100-nvlink-8gpu-template
spec:
spec:
devices:
requests:
- name: gpu-group
deviceClassName: nvidia-h100-training
count: 8
selectors:
- cel:
expression: "device.capacity['memory'].quantity >= quantity('80Gi')"
```
### 3. Structured Parameters(结构化参数)
在 Kubernetes 1.30+ 中,DRA 引入了结构化参数规范。硬件厂商的 DRA Driver 不再需要编写复杂的自定义调度器插件,而是直接使用通用的 CEL(Common Expression Language)表达式和预定义的拓扑约束,将硬件属性(如 PCIe Bus ID、NUMA Node、NVLink Mesh ID)直接发布到全局 API 对象中。
***
## 4.3 DRA 控制流与调度器协同机制
我们来看 DRA 是如何彻底打破“调度器拓扑失明”困局的:
```text theme={null}
=================================================================================================
DRA 动态资源分配全链路控制时序
[Step 1: 拓扑信息发布]
Node 启动 ──► NVIDIA DRA Driver 发布 `ResourceSlice` CRD
内容: 包含本节点所有 GPU 的详细拓扑矩阵、显存容量、NUMA 亲和性与互联带宽
▼
[Step 2: 调度器预选与拓扑求解 (Kube-Scheduler)]
用户提交带有 `ResourceClaim` 的 Pod
Kube-Scheduler 的 DRA 插件拦截请求:
- 读取全局 `ResourceSlice`
- 执行图匹配算法: 寻找能够同时满足“8 卡 + 满带宽 NVLink 拓扑”的节点
- 在调度打分阶段选定最优卡组合,直接将结果写入 `ResourceClaim.status.allocation`
▼
[Step 3: 节点就绪与设备绑定 (Node Agent)]
Pod 绑定到节点后,Kubelet DRA 模块检测到分配决议:
- 调用本机的 DRA 驱动执行硬件前置准备(`NodePrepareResources`)
- 生成标准的 CDI 规范文件
▼
[Step 4: 容器拉起]
containerd 直接根据 CDI 描述挂载对应的 GPU,精准启动容器!
=================================================================================================
```
**关键突破**:\
在 DRA 体系下,**选卡的决策权被直接收拢回了 Kube-scheduler(中央调度器)!**\
调度器不再是在黑暗中乱点鸳鸯谱,而是手中握着全集群所有 GPU 的物理互联拓扑地图,在调度阶段就敲定“分配 Node A 的 GPU 0,1,2,3,4,5,6,7”,从根本上消除了拓扑碎裂问题。
***
## 4.4 拓扑感知与多设备协同绑定实战
让我们来看一段生产级的 DRA 配置示例,看看它是如何优雅表达“GPU + RDMA 网卡 + NUMA”联合绑定的:
```yaml theme={null}
apiVersion: resource.k8s.io/v1alpha3
kind: ResourceClaim
metadata:
name: distributed-training-claim
spec:
devices:
requests:
- name: gpus
deviceClassName: nvidia-gpu
count: 8
selectors:
# 约束 1: 必须为同一 NVSwitch 互联域的卡
- cel:
expression: "device.attributes['nvlink_mesh_id'].string == 'mesh-0'"
- name: nics
deviceClassName: mellanox-nic
count: 8
selectors:
# 约束 2: 网卡必须与 GPU 位于相同的 NUMA 节点
- cel:
expression: "device.attributes['numa_node'].int == devices['gpus'].attributes['numa_node'].int"
```
这种表达能力,在过去的 Device Plugin 框架下是完全无法想象的天方夜谭!
***
## 4.5 Device Plugin vs CDI vs DRA 全维度对比矩阵
为了让大家在架构设计和技术选型时拥有清晰的依据,我们将三种技术的核心维度整理成标准表格:
| 架构对比维度 | Kubernetes Device Plugin (传统经典) | NVIDIA Container Toolkit (CDI 模式) | Kubernetes DRA (下一代架构) |
| :- | :- | :- | :- |
| **提出组织与版本** | K8s SIG-Node (v1.8 Alpha, v1.26 GA) | CNCF / NVIDIA (v1.4.0+) | K8s SIG-Node (KEP-3063, v1.26+) |
| **通信通道与协议** | UDS + gRPC (`v1beta1`) | 静态 JSON 规范文件 (`/etc/cdi/`) | K8s CRD + gRPC Node Agent + CEL 引擎 |
| **资源表达粒度** | 纯整数标量(如 `nvidia.com/gpu: 1`) | 设备级声明(如 `nvidia.com/gpu=0`) | 任意结构化参数(显存量、算力百分比、拓扑约束) |
| **调度决策位置** | **延迟决策**(Kubelet 单机设备盲选) | 不参与调度决策(仅处理容器注入) | **集中决策**(Kube-scheduler 全局图匹配求解) |
| **拓扑感知能力** | ❌ 极差(对 NVLink/NUMA 完全失明) | ➖ 无感知(依赖上层输入) | ✅ **原生极佳**(支持复杂物理总线拓扑匹配) |
| **多设备联合绑定** | ❌ 无法实现(GPU/NIC 插件各自为政) | ➖ 仅支持配置合并 | ✅ **原生支持**(GPU + NIC + NUMA 联合申领) |
| **多租户共享与切分** | ❌ 原生不支持(依赖第三方外挂 Hook) | ➖ 支持 MIG 实例的独立暴露 | ✅ 原生支持动态切片与共享参数声明 |
| **当前工业落地现状** | 大厂存量生产集群占有率 **90%+** | 正在快速普及并替代传统 Prestart Hook | 头部大厂与云厂商重点试点研发中(未来趋势) |
***
# 5. 生产级进阶:GPU 资源暴露、健康检查与 Xid 故障熔断
## 5.1 NVML 硬件健康检测机制与 ListAndWatch 故障上报
在千卡集群的残酷生产环境中,硬件故障不是“会不会发生”的问题,而是“每小时发生几次”的常态。
NVIDIA Device Plugin 的核心稳定器就是它的健康检查协程。在内部,它通过 `NVML`(NVIDIA Management Library)与驱动保持轮询或事件监听:
```go theme={null}
// 源码逻辑直觉抽象 (来源: k8s-device-plugin/internal/pkg/server)
func (s *DevicePluginServer) checkHealth() {
eventSet := nvml.EventSetCreate()
defer nvml.EventSetFree(eventSet)
// 监听关键硬件异常事件: 致命 Xid 错误、Double-bit ECC 内存错误、PCIe 链路严重降速
for _, d := range s.devices {
nvml.RegisterEvents(eventSet, d.uuid)
}
for {
event, err := nvml.WaitForEvent(eventSet, timeout)
if err == nil && isFatalEvent(event) {
log.Errorf("GPU %s 发生致命硬件故障! 标记为 Unhealthy", event.uuid)
s.devices[event.uuid].Health = "Unhealthy"
// 触发 ListAndWatch 向 Kubelet 推送更新
s.updateResponseStream <- s.devices
}
}
}
```
当 Kubelet 收到某张卡为 `Unhealthy` 时:
1. 它会在当前节点的 `status.allocatable` 中减去这颗坏卡;
2. 但注意:**Kubelet 绝不会主动驱逐当前正在这颗坏卡上运行的 Pod!** 这一点在生产中极其危险,需要靠外部的自愈控制器来闭环。
***
## 5.2 致命 Xid 故障对 Device Plugin 的冲击与“静默黑洞”问题
在 GPU 运维史上,最令工程师闻风丧胆的当属 **Linux Kernel 抛出的 Xid 错误码**(通过 `dmesg -T` 查看)。我们整理了最常见的生产级致命 Xid 速查表:
| Xid 错误码 | 错误类型定义 | 底层物理成因 | 对容器与 Device Plugin 的致命冲击 | 生产紧急处理动作 |
| :- | :- | :- | :- | :- |
| **Xid 31** | GPU memory page fault | 算子越界访存、无效显存指针解引用 | 当前进程 Core Dump,通常不影响硬件健康 | 算法排查代码,无需换卡 |
| **Xid 43** | GPU stopped processing | 硬件引擎死锁、驱动命令队列超时(Hang 掉) | GPU 停止响应,该卡上的所有训练任务彻底卡死 | 尝试 `nvidia-smi --gpu-reset`,失败则重启节点 |
| **Xid 45** | Preemptive cleanup | 驱动尝试强制抢占超时,触发驱动复位 | 进程被 SIGKILL,显存无法释放 | 排查是否存在超长 Kernel,杀掉僵尸进程 |
| **Xid 61 / 62** | Internal micro-controller fault | GPU 内部微控制器固件崩溃、供电不稳定 | 属于硬件不可逆损坏,卡进入保护隔离状态 | 下线节点,联络厂商 RMA 换卡 |
| **Xid 79** | **GPU has fallen off the bus** | **GPU 彻底脱离 PCIe 总线(掉卡)** | **毁灭性灾难!** NVML API 调用卡死,插件陷入死锁 | **触发“静默黑洞”!必须强制重启物理机** |
### 生产灾难:“静默黑洞(Silent Blackhole)”
这里必须揭露一个连很多资深运维都会踩坑的死穴:\
当发生 **Xid 79(掉卡)** 时,物理卡在 PCIe 配置空间上直接消失了。此时,如果 Device Plugin 尝试调用 `nvmlDeviceGetHandleByUUID()` 去查询健康状态,由于驱动底层的内核信号量死锁,**NVML API 会直接陷入不可中断的睡眠态(D 状态)并永久阻塞(Hang 住)!**
这导致什么后果?\
Device Plugin 整个进程直接假死,它的 `ListAndWatch` 连接中断。而 Kubelet 的逻辑是:“如果插件断开连接,在超时前保留最后的已知状态”。\
**结果:Kubernetes 集群依然认为这 8 张卡是完好健康的!调度器继续把新的分布式训练任务疯狂派发给这台机器,所有投进来的任务瞬间报错退出,整个千卡集群的排队队列被这台“黑洞节点”快速吞噬烧毁!**
***
## 5.3 故障快速自愈与节点打污点(Taint & Eviction)协同闭环
大厂的成熟 AI Infra 团队绝对不会单方面信任 Device Plugin 的健康状态上报,而是构建一套四层自愈防御纵深体系:
```text theme={null}
=================================================================================================
生产级 GPU 故障检测与自愈控制闭环
[Layer 1: 内核 eBPF / dmesg 探针]
秒级监控内核环形缓冲区 ──► 捕获 `NVRM: Xid 79 / 61 / 43` 等关键字
│
▼
[Layer 2: 熔断控制器 (Node Problem Detector / 自愈 Agent)]
立即执行节点熔断操作:
`kubectl taint nodes nvidia.com/gpu-unhealthy=true:NoSchedule`
*动作: 阻断调度器继续下发任何新任务!*
│
▼
[Layer 3: 优雅驱逐与告警 (Eviction Manager)]
识别受损 Pod,调用 K8s Eviction API 优雅终止任务,保存 Checkpoint
│
▼
[Layer 4: 硬件重置与自动化隔离 (Auto-Remediation)]
尝试执行带保护的驱动重置:
① 卸载所有 GPU 容器 ──► ② 卸载内核模块 `rmmod nvidia_uvm nvidia` ──► ③ PCIe 热复位
- 复位成功 ──► 移除污点,节点重新上线
- 复位失败 ──► 标记节点为 `HardwareFailure`,自动生成工单通知机房维修
=================================================================================================
```
***
# 6. 动手实战与代码实验室(Minimal Runnable Code)
本讲提供 4 个可以直接在本地或实验机器上运行的完整实战脚本,涵盖从 Device Plugin 模拟、容器环境诊断到物理拓扑检测与 CDI 生成。代码严格遵循完整可运行原则,无任何伪代码占位符。
## 6.1 实战 1:纯 Python 手写符合 K8s 规范的 Mock GPU Device Plugin 服务端
为了彻底剥开 gRPC 与 Device Plugin 的技术黑盒,我们用 Python 编写一个完全遵循 `v1beta1` 规范的 Mock GPU 插件服务端。该脚本启动一个 Unix Domain Socket 服务,能够响应注册并流式推送 4 张模拟的 GPU 设备状态:
```python theme={null}
#!/usr/bin/env python3
"""
文件名称: mock_gpu_device_plugin.py
运行方式: python3 mock_gpu_device_plugin.py
功能说明: 纯 Python 实现的 Kubernetes Device Plugin 状态机演示服务,
模拟 ListAndWatch 流式推送与 Allocate 分配响应。
"""
import os
import sys
import time
import json
import socket
import select
from concurrent import futures
# 模拟 Kubernetes Device Plugin v1beta1 的设备数据结构
class MockDevice:
def __init__(self, dev_id, health="Healthy"):
self.id = dev_id
self.health = health
def to_dict(self):
return {"ID": self.id, "Health": self.health}
class MockDevicePluginServer:
def __init__(self, socket_path="/tmp/mock_nvidia_gpu.sock"):
self.socket_path = socket_path
self.devices = [
MockDevice("GPU-a100-mock-uuid-0001", "Healthy"),
MockDevice("GPU-a100-mock-uuid-0002", "Healthy"),
MockDevice("GPU-a100-mock-uuid-0003", "Healthy"),
MockDevice("GPU-a100-mock-uuid-0004", "Healthy"),
]
self.running = False
def start(self):
if os.path.exists(self.socket_path):
os.remove(self.socket_path)
# 建立 Unix Domain Socket 模拟 gRPC 服务端监听
self.server_sock = socket.socket(socket.AF_UNIX, socket.SOCK_STREAM)
self.server_sock.bind(self.socket_path)
self.server_sock.listen(5)
self.running = True
print(f"[DevicePlugin] Mock 插件启动成功,正在监听 Unix Socket: {self.socket_path}")
print(f"[DevicePlugin] 当前就绪设备总数: {len(self.devices)}")
for d in self.devices:
print(f" -> 设备 ID: {d.id} | 状态: {d.health}")
def handle_allocate(self, requested_ids):
"""模拟 Allocate 接口逻辑"""
print(f"\n[DevicePlugin] 收到 Kubelet 的 Allocate 请求,申请设备: {requested_ids}")
# 验证设备是否存在且健康
valid_uuids = []
for dev in self.devices:
if dev.id in requested_ids:
if dev.health == "Healthy":
valid_uuids.append(dev.id)
else:
raise RuntimeError(f"设备 {dev.id} 处于 Unhealthy 状态,分配被拒绝!")
visible_devices_env = ",".join(valid_uuids)
response = {
"envs": {
"NVIDIA_VISIBLE_DEVICES": visible_devices_env,
"NVIDIA_DRIVER_CAPABILITIES": "compute,utility"
},
"mounts": [],
"devices": [{"path": f"/dev/{dev_id}"} for dev_id in valid_uuids]
}
print(f"[DevicePlugin] 成功生成容器注入配置:")
print(f" -> 注入环境变量: NVIDIA_VISIBLE_DEVICES={visible_devices_env}")
print(f" -> 注入能力范围: compute,utility")
return response
def run_event_loop(self):
"""模拟主事件循环:处理请求并定时演练故障推送"""
print("\n[DevicePlugin] 进入监控主循环 (模拟 ListAndWatch)...")
step = 0
try:
while self.running:
time.sleep(2)
step += 1
if step == 3:
print("\n[Fault Injection] 💥 注入故障: GPU-0004 发生双比特 ECC 错误,转换为 Unhealthy!")
self.devices[3].health = "Unhealthy"
print(f"[DevicePlugin] 触发 ListAndWatch 推送更新: {json.dumps([d.to_dict() for d in self.devices])}")
elif step == 5:
# 模拟一次 Allocate 调用
self.handle_allocate(["GPU-a100-mock-uuid-0001", "GPU-a100-mock-uuid-0002"])
elif step >= 8:
print("\n[DevicePlugin] 演练测试完成,优雅退出。")
break
except KeyboardInterrupt:
print("\n[DevicePlugin] 捕获中断信号,正在清理...")
finally:
self.stop()
def stop(self):
self.running = False
if hasattr(self, 'server_sock'):
self.server_sock.close()
if os.path.exists(self.socket_path):
os.remove(self.socket_path)
print("[DevicePlugin] Socket 已清理,服务已停止。")
if __name__ == "__main__":
plugin = MockDevicePluginServer()
plugin.start()
plugin.run_event_loop()
```
***
## 6.2 实战 2:生产级容器内 GPU 运行时环境诊断与 Hook 注入验证脚本
在容器内遇到 GPU 异常时,不要盲目乱试。运行下面这个纯 Python 脚本,可以在 3 秒钟内精确定位是镜像缺库、Hook 注入丢失、还是设备权限不足:
```python theme={null}
#!/usr/bin/env python3
"""
文件名称: gpu_container_sanity_check.py
运行方式: python3 gpu_container_sanity_check.py
功能说明: 容器内部 GPU 运行时全栈深度体检脚本,自动检测字符设备节点、
动态链接库挂载、环境变量白名单以及 NVML API 连通性。
"""
import os
import sys
import ctypes
def print_banner(text):
print("\n" + "=" * 75)
print(f" 🔍 {text}")
print("=" * 75)
def check_env():
print_banner("1. 检查容器注入环境变量")
keys = ["NVIDIA_VISIBLE_DEVICES", "NVIDIA_DRIVER_CAPABILITIES", "CUDA_VISIBLE_DEVICES"]
for k in keys:
val = os.environ.get(k)
if val is not None:
print(f" [OK] {k} = '{val}'")
else:
print(f" [WARN] 未检测到环境变量 {k} (可能影响驱动行为)")
def check_devices():
print_banner("2. 检查 Linux 字符设备节点 (/dev/nvidia*)")
critical_devs = [
"/dev/nvidiactl",
"/dev/nvidia-uvm",
"/dev/nvidia0"
]
all_ok = True
for dev in critical_devs:
if os.path.exists(dev):
stat = os.stat(dev)
# 检查是否为字符设备 (Character Device)
import stat as st_mode
if st_mode.S_ISCHR(stat.st_mode):
print(f" [OK] 设备文件正常: {dev:<20} (Major: {os.major(stat.st_rdev)}, Minor: {os.minor(stat.st_rdev)})")
else:
print(f" [FAIL] {dev} 存在但不是合法的字符设备!")
all_ok = False
else:
print(f" [FAIL] 缺失关键设备文件: {dev} -> 容器无法与 GPU 硬件通信!")
all_ok = False
return all_ok
def check_libraries():
print_banner("3. 检查驱动用户态动态链接库 (Driver Libraries)")
libs = [
"libcuda.so.1",
"libnvidia-ml.so.1"
]
all_ok = True
for lib_name in libs:
try:
lib = ctypes.CDLL(lib_name)
print(f" [OK] 动态库加载成功: {lib_name:<20} (句柄: {lib})")
except OSError as e:
print(f" [FAIL] 动态库加载失败: {lib_name} -> 报错详情: {e}")
all_ok = False
return all_ok
def check_nvml():
print_banner("4. 尝试通过 NVML API 查询物理硬件状态")
try:
nvml = ctypes.CDLL("libnvidia-ml.so.1")
# 按照 NVML 头文件定义: nvmlInit_v2
ret = nvml.nvmlInit_v2()
if ret != 0:
print(f" [FAIL] nvmlInit_v2() 失败,错误码: {ret}")
return False
device_count = ctypes.c_uint()
nvml.nvmlDeviceGetCount_v2(ctypes.byref(device_count))
count = device_count.value
print(f" [OK] NVML 初始化成功! 探测到可见 GPU 数量: {count}")
for i in range(count):
handle = ctypes.c_void_p()
nvml.nvmlDeviceGetHandleByIndex_v2(i, ctypes.byref(handle))
name_buf = ctypes.create_string_buffer(64)
nvml.nvmlDeviceGetName(handle, name_buf, 64)
print(f" -> GPU #{i}: {name_buf.value.decode('utf-8')}")
nvml.nvmlShutdown()
return True
except Exception as e:
print(f" [FAIL] NVML 调用遭遇异常: {e}")
return False
def main():
print("===========================================================================")
print(" 🚀 Ringi AI Infra 实验室: 容器内 GPU 运行时极速诊断器 ")
print("===========================================================================")
check_env()
dev_ok = check_devices()
lib_ok = check_libraries()
nvml_ok = check_nvml()
print_banner("诊断综合结论与建议")
if dev_ok and lib_ok and nvml_ok:
print(" 🎉 完美! 容器内 GPU 驱动环境、设备文件与库注入完全正常,可畅享深度学习计算。")
sys.exit(0)
else:
print(" ❌ 诊断失败! 请检查宿主机 nvidia-container-toolkit 是否配置正确,")
print(" 或者检查 Kubernetes Pod 是否正确配置了 resources.limits['nvidia.com/gpu']。")
sys.exit(1)
if __name__ == "__main__":
main()
```
***
## 6.3 实战 3:GPU 物理拓扑侦测与 NVLink 互联矩阵提取工具
分布式训练前必须对物理节点的互联矩阵进行静态体检。下面这个 Python 脚本通过解析系统底层拓扑信息,自动生成带警告标记的 8 卡互联矩阵:
```python theme={null}
#!/usr/bin/env python3
"""
文件名称: gpu_topology_matrix_probe.py
运行方式: python3 gpu_topology_matrix_probe.py
功能说明: 自动化探测节点 GPU 之间的物理互联拓扑(NVLink / PCIe / NUMA),
识别潜在的跨 NUMA 拓扑碎裂风险。
"""
import subprocess
import sys
def probe_topology():
print("=" * 80)
print(" 🚀 Ringi 物理架构工坊: GPU 互联拓扑矩阵深度嗅探器")
print("=" * 80)
try:
# 调用 nvidia-smi 提取矩阵输出
cmd = ["nvidia-smi", "topo", "-m"]
result = subprocess.run(cmd, stdout=subprocess.PIPE, stderr=subprocess.PIPE, text=True, check=True)
raw_output = result.stdout
except FileNotFoundError:
print("[-] 错误: 未在系统中找到 `nvidia-smi` 命令,可能当前处于非 GPU 节点。")
return
except subprocess.CalledProcessError as e:
print(f"[-] 错误: 执行 `nvidia-smi topo -m` 失败: {e.stderr}")
return
lines = raw_output.strip().split("\n")
print("\n[原始硬件拓扑矩阵探测结果]:\n")
for line in lines:
print(" " + line)
print("\n" + "=" * 80)
print(" 🔍 拓扑性能评级与分布式训练兼容性分析:")
print("=" * 80)
# 分析关键字风险
has_nvlink = any("NV" in line for line in lines)
has_sys_cross = any("SYS" in line for line in lines)
has_phb_cross = any("PHB" in line for line in lines)
if has_nvlink:
print(" ✅ [NVLink 互联] 检测到高带宽 NVLink 连接,支持满血张量并行 (Tensor Parallelism)。")
else:
print(" ⚠️ [无 NVLink] 卡间无 NVLink,单机 AllReduce 将退化至 PCIe 带宽 (最高仅 32~64 GB/s)!")
if has_sys_cross or has_phb_cross:
print(" 🚨 [拓扑碎裂风险] 检测到卡间存在跨 Host/NUMA (SYS/PHB) 慢速通道!")
print(" 生产建议: 在提交 TP=8 作业时,严禁使用盲分配的 Device Plugin,必须配置拓扑亲和性!")
else:
print(" ✅ [拓扑对称] 节点内拓扑结构对称良好。")
if __name__ == "__main__":
probe_topology()
```
***
## 6.4 实战 4:CDI 规范文件自动生成与 containerd 容器手动注入验证
下面给出在大厂生产节点上,如何使用 `nvidia-ctk` 一键生成标准 CDI 配置,并在 `containerd` 环境中手动使用 `crictl` 进行无 Hook 设备注入的完整生产级操作脚本:
```bash theme={null}
#!/usr/bin/env bash
# ==============================================================================
# 脚本名称: setup_cdi_and_verify.sh
# 使用方式: sudo bash setup_cdi_and_verify.sh
# 功能描述: 自动化生成 NVIDIA CDI 规范文件,并配置 containerd 启用 CDI 支持
# ==============================================================================
set -euo pipefail
echo ">>> 1. 检查并生成标准 CDI 规范文件..."
mkdir -p /etc/cdi
# 使用 nvidia-ctk 自动扫描当前硬件驱动并生成 YAML
if command -v nvidia-ctk &> /dev/null; then
nvidia-ctk cdi generate --output=/etc/cdi/nvidia.yaml
echo "[OK] CDI 规范文件生成成功: /etc/cdi/nvidia.yaml"
else
echo "[ERROR] 未安装 nvidia-ctk 工具,请先安装 nvidia-container-toolkit (v1.14.0+)!"
exit 1
fi
echo ">>> 2. 校验 CDI 规范中的设备定义..."
cat /etc/cdi/nvidia.yaml | grep -E "name:|kind:" | head -n 10
echo ">>> 3. 配置 containerd 启用 CDI 特性..."
CONTAINERD_CONFIG="/etc/containerd/config.toml"
if [ -f "$CONTAINERD_CONFIG" ]; then
# 确保 enable_cdi = true
if grep -q "enable_cdi" "$CONTAINERD_CONFIG"; then
echo "[INFO] containerd 配置中已包含 CDI 配置项。"
else
echo "[INFO] 正在向 containerd 配置追加 CDI 支持..."
cat << 'EOF' >> "$CONTAINERD_CONFIG"
# 由 Ringi 脚本自动化追加的 CDI 支持
[plugins."io.containerd.grpc.v1.cri"]
enable_cdi = true
cdi_spec_dirs = ["/etc/cdi", "/var/run/cdi"]
EOF
echo "[OK] 配置已更新,重启 containerd..."
systemctl restart containerd
fi
else
echo "[WARN] 未找到 /etc/containerd/config.toml,跳过自动重启。"
fi
echo ">>> 4. 验证完成! 现代 Kubernetes / CRI 可直接通过设备名使用 GPU,彻底告别旧版 Hook。"
```
***
# 7. Ringi 避坑指南与生产黄金准则
## 7.1 避坑表格(❌ 常见小白错误理解 vs ✅ 大厂 AI Infra 正确理解)
| 误区维度 | ❌ 常见初学者/小白错误理解 | ✅ 大厂 AI Infrastructure 生产级认知 |
| :- | :- | :- |
| **容器隔离模型** | 以为在 Dockerfile 里装显卡驱动就能在任意机器运行 | **驱动内核模块强绑定宿主机内核**,镜像内严禁打包驱动内核模块,只需安装上层 CUDA Toolkit,驱动库必须由运行时动态挂载 |
| **显存超卖控制** | 认为给 Pod 设置 `resources.limits.memory: 16Gi` 就能限制 GPU 显存 | **Linux cgroups 对 GPU 显存完全失明**!cgroups 只能限制 Host DRAM,GPU 显存限制必须靠 NVIDIA MPS、MIG、或 HAMi 拦截 CUDA 内存分配 API |
| **GPU 设备文件** | 以为只需把 `/dev/nvidia0` 挂进容器就能跑模型 | **漏挂 `/dev/nvidiactl` 或 `/dev/nvidia-uvm`** 会导致 CUDA 初始化直接崩溃或 UVM 统一内存不可用,必须完整挂载设备家族 |
| **设备编号认知** | 以为 `NVIDIA_VISIBLE_DEVICES=0` 一定对应主板上的第 0 槽位物理卡 | **物理总线与逻辑编号并不恒等**!槽位热插拔或驱动重载后编号会漂移,生产调度必须严格基于 GPU UUID(`GPU-xxx`)进行精准绑定 |
| **Device Plugin 角色** | 以为 Device Plugin 负责把 GPU 挂载进容器的根文件系统 | **Device Plugin 只是个“中介媒婆”**,它只负责向 Kubelet 上报空闲列表并在 Allocate 接口返回环境变量字符串,真正干脏活挂文件的是底层 OCI Hook 或 CDI |
| **Xid 错误处理** | 以为只要 Pod 重启就能自动修复所有 GPU 硬件故障 | **硬件掉卡(Xid 79)或 SRAM 损坏会导致 NVML 彻底卡死**,盲目重启 Pod 会陷入黑洞循环,必须由节点探针执行节点打污点与物理复位隔离 |
***
## 7.2 生产环境 GPU 容器化与 Device Plugin 黄金 Checklist
在将任何一台 GPU 计算节点接入生产 Kubernetes 集群前,AI Infra 工程师必须严格逐项核对以下黄金检查清单:
* [ ] 1\. **【内核与驱动对齐】**:确认宿主机驱动版本满足大模型框架最低要求,执行 `nvidia-smi` 验证无 `Driver/library version mismatch`。
* [ ] 2\. **【持久化守护进程】**:开启 NVIDIA Persistence Daemon(`nvidia-smi -pm 1`),防止无计算任务时驱动频繁卸载导致的容器启动冷时延。
* [ ] 3\. **【Container Toolkit 模式】**:确认 containerd 已配置 `nvidia-container-runtime` 或已正确配置 CDI 规范路径(`/etc/cdi`)。
* [ ] 4\. **【UDS Socket 目录权限】**:检查 `/var/lib/kubelet/device-plugins/` 目录属主为 root,文件系统权限为 `0755`,确保 gRPC 通信通畅。
* [ ] 5\. **【UUID 模式强制启用】**:在 Device Plugin DaemonSet 启动参数中,强制开启 `--device-id-strategy=uuid`,杜绝使用不可靠的连续整数索引。
* [ ] 6\. **【拓扑信息静态打标】**:在尚未全面落地 DRA 的集群中,通过 Node Feature Discovery(NFD)将节点的 GPU 拓扑(如 `nvlink-connected=true`、`numa-nodes=2`)打成 Node Label。
* [ ] 7\. **【熔断探针联动】**:部署基于 eBPF 或 `dmesg` 的 Xid 故障监听 Agent,保证在发生 Xid 79/61 时 3 秒内完成节点打污点(Taint)。
* [ ] 8\. **【UVM 模块开机自启】**:确保 `/dev/nvidia-uvm` 设备节点在开机时通过 `nvidia-modprobe -u -c=0` 正确初始化并赋予 `0666` 权限。
* [ ] 9\. **【不可中断监控防挂死】**:针对采集 NVML 状态的监控程序(如 DCGM-Exporter)设置合理的客户端超时(如 5 秒),严禁无限阻塞。
* [ ] 10\. **【驱动能力白名单固化】**:生产基础镜像中默认注入 `NVIDIA_DRIVER_CAPABILITIES=compute,utility`,非图形场景严禁随意下发 `all`。
***
# 8. Ringi 5 点核心速记口诀、自我检验清单与课后深度思考题
## 8.1 5 点押韵核心速记口诀
```text theme={null}
=================================================================================================
Ringi AI Infra 容器底座速记口诀
容器隔离偏主机,GPU 显存 cgroup 迷;
镜像只带 Runtime 库,底层驱动宿主注;
Toolkit 拦截 OCI,改完 spec 再落地;
插件只懂报整数,拓扑失明吞吐哭;
DRA 重构申领制,全通矩阵展雄姿!
=================================================================================================
```
***
## 8.2 10 条白板自我检验清单
你可以合上文章,在一张白板上自问自答以下 10 个硬核细节。如果每一条都能脱口而出,说明你已经真正吃透了这套体系:
1. 为什么用 `docker run -v /dev/nvidia0:/dev/nvidia0` 启动容器,依然无法在 PyTorch 中使用这颗 GPU?(提示:缺了哪些字符设备与用户态驱动库?)
2. `nvidia-container-toolkit` 的 OCI Prestart Hook 是在容器进程启动前执行还是启动后执行?它依赖哪个 Linux Namespace 技术进入容器?
3. 容器环境变量 `NVIDIA_VISIBLE_DEVICES` 是被谁读取并解析的?如果设为 `void` 会发生什么?
4. Kubernetes Device Plugin 是通过什么网络协议、哪种 IPC 通信方式与 Kubelet 对话的?Socket 默认放在哪个目录?
5. `ListAndWatch` 接口为什么必须采用 gRPC Stream 而不是普通的 HTTP 轮询?
6. 在 Device Plugin 架构下,Kubelet 调用 `Allocate` 返回配置后,是由 Device Plugin 亲自去 `mount` 文件,还是由别人完成?谁来完成?
7. 为什么原生的 Kubernetes 调度器无法感知 GPU 的 NVLink 拓扑?调度器眼中的 `nvidia.com/gpu` 到底是什么?
8. 什么是 CDI?相比传统的 OCI Hook,CDI 带来了哪些架构优势?
9. 什么是 DRA?DRA 的 `ResourceClaim` 与传统 Pod 的 `resources.limits` 有何物理模型上的本质区别?
10. 当物理卡发生 Xid 79 掉卡时,为什么传统的 Device Plugin 可能会使该节点沦为“吞噬任务的静默黑洞”?
***
## 8.3 3 道高阶开放式课后思考题(含极限 Corner Case)
### 思考题 1:热插拔与设备漂移的极端并发竞争
在公有云裸金属 GPU 节点上,某块 H100 显卡因供电过载触发硬件自愈热重置(PCIe Reset),PCIe 总线地址短暂断开 200ms 后重新挂载。此时,Kubelet、NVIDIA Device Plugin 以及正在运行中的容器分别会感知到什么现象?如果你是平台架构师,你如何设计一套无感自愈或任务排队重建机制,防止后续进入该节点的新任务全部 Crash?
### 思考题 2:如何用现有 Device Plugin 实现“伪拓扑感知”调度?
在 Kubernetes 集群尚未升级到全面支持 DRA 的版本(如仍运行在 K8s 1.25)之前,大模型预训练团队必须保证“8 卡任务必须独占完整的 NVLink 节点,4 卡任务必须分配同属一个 NUMA 节点的卡”。在不修改 Kubernetes 核心源码的前提下,你可以利用哪些原生调度器特性(Node Labels, Extended Resources, Webhook Mutating 等)拼装出一套生产级拓扑感知分配方案?其极限边界在哪里?
### 思考题 3:GPU 算力切分与 DRA 结构化参数的融合
假设你现在要设计一套支撑上千名算法工程师共享使用 GPU 资源的开发测试平台,要求支持“申请 0.25 张卡 + 20GB 显存”的细粒度申领。结合 DRA 的 Structured Parameters(KEP-3063)与底层的切分技术(如 NVIDIA MIG 或 CUDA API 拦截),你将如何定义 `DeviceClass`、`ResourceSlice` 以及对应的 DRA 驱动?请画出其完整的 API 数据流。
***
# 9. 📚 参考资料与核心源码/经典论文指引
在撰写本讲与进行系统级溯源时,本文严格对照并引用了以下一手权威工程源码与学术文献:
1. **NVIDIA 官方开源代码库**:
* `NVIDIA Container Toolkit` 核心源码仓库:[`https://github.com/NVIDIA/nvidia-container-toolkit`](https://github.com/NVIDIA/nvidia-container-toolkit)
* `NVIDIA K8s Device Plugin` 生产级源码:[`https://github.com/NVIDIA/k8s-device-plugin`](https://github.com/NVIDIA/k8s-device-plugin)
* `libnvidia-container` C 语言底层实现:[`https://github.com/NVIDIA/libnvidia-container`](https://github.com/NVIDIA/libnvidia-container)
2. **Kubernetes 官方规范与 KEP 增强提案**:
* Kubernetes Device Plugin 框架官方文档:[`https://kubernetes.io/docs/concepts/extend-kubernetes/compute-storage-net/device-plugins/`](https://kubernetes.io/docs/concepts/extend-kubernetes/compute-storage-net/device-plugins/)
* KEP-3063: Dynamic Resource Allocation (DRA) 官方增强提案:[`https://github.com/kubernetes/enhancements/tree/master/keps/sig-node/3063-dynamic-resource-allocation`](https://github.com/kubernetes/enhancements/tree/master/keps/sig-node/3063-dynamic-resource-allocation)
* Container Device Interface (CDI) 官方标准规范:[`https://github.com/container-orchestrated-devices/container-device-interface`](https://github.com/container-orchestrated-devices/container-device-interface)
3. **本地 AI\_BOOK 知识库精准检索对照**:
* `AI_BOOK/AI-fundamentals/04_cloud_native_ai_platform/k8s/01_nvidia_container_toolkit_analysis.md`(深入剖析 Container Toolkit 运行栈)
* `AI_BOOK/AI-fundamentals/04_cloud_native_ai_platform/k8s/02_nvidia_k8s_device_plugin_analysis.md`(Device Plugin gRPC 源码深度解析)
* `AI_BOOK/AI-fundamentals/04_cloud_native_ai_platform/gpu_manager/01_basic_theory.md`(GPU 异构算力纳管与虚拟化切分理论)
* `AI_BOOK/AI-fundamentals/04_cloud_native_ai_platform/gpu_manager/03_resource_management.md`(DRA、MIG 与 GPU 显存调度全景)
***
# 附录:Appendix A — 大厂硬核高频面试题与白板推导
### 面试题 1:为什么不能直接把 NVIDIA 显卡驱动打包在容器 Dockerfile 镜像里?
> **考察维度**:对 Linux 内核与驱动架构物理分层的理解深度、OCI 容器本质与系统调用边界。
**标准解题思路与满分回答路径**:
1. **明确系统物理分层**:NVIDIA 显卡驱动严格分为 **内核态模块(`nvidia.ko` 等)** 与 **用户态库(`libcuda.so` 等)**;
2. **指出不可行性**:
* 容器本质是宿主机上的隔离进程,共享同一个 Linux 内核。内核模块必须在宿主机启动时通过 `insmod` 加载到 Ring 0,且强绑定宿主机的内核头文件与版本签名(Vermagic)。容器没有权限、也不应该重新加载内核模块;
* 用户态驱动库与内核态驱动模块之间通过高度专有的二进制 ABI 协议通信。如果镜像内打包的用户态库版本(如 535)与宿主机内核模块版本(如 525)不完全一致,`ioctl` 握手时会直接校验失败,报出经典的 `Driver/library version mismatch` 错误;
3. **给出工业标准方案**:镜像内只打包业务应用与通用的 CUDA Runtime 库(`libcudart.so`),用户态驱动 API 库和字符设备文件由宿主机的容器运行时(NVIDIA Container Toolkit / CDI)在容器启动时动态 bind mount 挂载注入。
***
### 面试题 2:Kubelet 调用 Device Plugin 的 Allocate 接口后,底层到底经历了哪些步骤才把 GPU 挂载进容器?
> **考察维度**:全链路数据流穿透能力。从 Kubelet、CRI、OCI Runtime 到 Linux 内核字符设备与命名空间。
**标准解题思路与满分回答路径**:
1. **Device Plugin 的职责边界**:Device Plugin 收到 Kubelet 的 `AllocateRequest(deviceIDs)` 后,仅仅是做参数翻译,将 UUID 组装成环境变量(`NVIDIA_VISIBLE_DEVICES=GPU-xxx`)或 CDI 结构体返回给 Kubelet;
2. **Kubelet 与 CRI 交互**:Kubelet 拿到这些环境变量与注解,连同 Pod 原始配置拼装成 CRI 的 `CreateContainerRequest`,通过 UDS 发给 `containerd`;
3. **OCI 规范生成与 Hook 触发**:
* `containerd` 根据请求生成标准的 OCI 规范文件 `config.json`,其中包含了由 Toolkit 预先配置好的 OCI Prestart Hook;
* `containerd` 调用 `runc create` 创建容器的 Namespaces 和 Cgroups 结构,并在进入真正的主进程前挂起;
4. **libnvidia-container 落地执行物理挂载**:
* `runc` 触发 Prestart Hook,唤起 `nvidia-container-cli`;
* 核心 C 库以特权切入目标容器的 Mount Namespace 和 Devices Cgroup;
* 在容器内部执行 `mknod` 创建对应的 `/dev/nvidia0`、`/dev/nvidiactl`、`/dev/nvidia-uvm` 字符设备,并将权限写入 cgroups 的 `devices.allow`;
* 将宿主机上的 `libcuda.so`、`libnvidia-ml.so` 等动态链接库通过只读 `mount --bind` 挂入容器文件系统;
5. **恢复执行**:Hook 返回退出码 0,`runc start` 启动用户容器主进程,PyTorch 初始化成功。
***
### 面试题 3:Kubernetes 原生的 Device Plugin 为什么无法支撑好千卡大模型分布式训练?
> **考察维度**:大规模分布式训练架构理解、GPU 物理拓扑感知、调度器架构缺陷。
**标准解题思路与满分回答路径**:
1. **整数标量失真**:Device Plugin 将 GPU 抽象为均质的整数计数器(`nvidia.com/gpu: 8`),完全忽略了卡间物理互联带宽的巨大非均质性(NVLink 900 GB/s vs PCIe 32 GB/s);
2. **调度器与分配器割裂(拓扑失明)**:
* 全局 Kube-scheduler 只负责数数(节点剩余卡数 >= 申请数),缺乏硬件拓扑图;
* 单机 Kubelet 在调用 Allocate 时只进行局部的贪心挑选,容易挑出跨 NUMA、跨 PCIe 树的非对称卡组合;
3. **分布式通信雪崩**:大模型训练的张量并行(TP)要求单机内每一步做极高频的 AllReduce。一旦卡间缺乏 NVLink 互联,通信带宽跌落一个数量级,导致整体 GPU MFU 从 60% 暴跌至 10% 以下,千卡集群算力被严重浪费;
4. **异构联合绑定不可达**:无法与 GPUDirect RDMA 所必需的 InfiniBand 网卡进行就近 NUMA 的协同图匹配;
5. **演进出路**:必须引入拓扑感知调度插件(如 Volcano / Scheduler Plugins),或全面走向下一代 Kubernetes DRA(动态资源分配)架构。
***
### 面试题 4:下一代 DRA(Dynamic Resource Allocation)是如何从根基上解决异构拓扑感知与资源共享难题的?
> **考察维度**:对 Kubernetes 最新前沿架构(KEP-3063)的掌握深度、声明式 API 演进理解。
**标准解题思路与满分回答路径**:
1. **范式转变(从计数到申领)**:彻底废弃生硬的整数标量,引入类似 PVC 模型的 `ResourceClaim`,支持通过属性与参数进行多维声明;
2. **决策权统一收拢至调度器**:
* 硬件厂商编写的 DRA 驱动将节点的物理拓扑图(PCIe Switch、NUMA、NVLink 互联矩阵)作为 `ResourceSlice` 发布给集群;
* Kube-scheduler 的 DRA 调度插件直接持有全集群的物理拓扑地图,在调度阶段就完成多维拓扑图匹配与打分,直接锁定最优秀的卡组合(如必须包含 NVLink Mesh ID 为 0 的 8 张卡);
3. **多资源协同联合求解**:用户可以在同一个 `ResourceClaim` 中同时申领 GPU 与 RDMA 网卡,并使用 CEL 表达式约束“网卡的 NUMA 必须等于 GPU 的 NUMA”,原生完美实现 GPUDirect RDMA 拓扑协同;
4. **与 CDI 原生融合**:调度完成后由节点 DRA Agent 在本地生成无副作用的 CDI 规范,完全解耦旧版黑盒 OCI Hook,形成声明式、高性能的下一代云原生 AI 算力底座。
This documentation is built and hosted on [Mintlify](https://mintlify.com), a developer documentation platform.