第30讲:模型并行与长序列基石——TP/PP/SP/CP 矩阵切分与硬件拓扑映射
主讲人:👓 Ringi(大厂 AI Infrastructure 资深性能架构师)
所属专栏:《AI_Infra大话西游之水滴石穿》 ➔ Module 04: 大模型分布式训练系统
篇章范式:🌐 大规模分布式训练系统范式(Distributed Training Systems Paradigm)
源码与实验环境:NVIDIA A100-SXM4-80GB / H100-SXM5-80GB | CUDA 12.4 | Python 3.10 | PyTorch 2.3+ | Megatron-LM v0.6+
知识底账索引:
- 张量并行与序列并行:第6章 张量并行TP与序列并行SP(AIInfraGuide)
- 流水线并行与气泡消除:第7章 流水线并行PP(AIInfraGuide)
- 长序列训练与上下文并行:第9章 长序列训练与上下文并行(AIInfraGuide)
- 3D 混合并行与拓扑编排:第11章 3D并行与混合并行策略(AIInfraGuide)
- 多维度混合并行深度剖析:6. 多维度混合并行(llm_interview_note)
📑 目录导航
- 0. Ringi 开场:生产真实现场与痛点冲突
- 1. 张量并行(Tensor Parallelism, TP)深度拆解与数学推导
- 2. 序列并行(Sequence Parallelism, SP)——消灭非 TP 区域的激活冗余
- 3. 上下文并行(Context Parallelism, CP)——突破 128K+ 序列长度墙
- 4. 流水线并行(Pipeline Parallelism, PP)与气泡率消除
- 5. 3D 混合并行与硬件拓扑对齐(Hardware Topology Mapping)
- 6. 全场景实战与实验代码(Minimal Runnable Code)
- 7. Ringi 避坑指南与生产黄金准则
- 8. Ringi 5 点核心速记口诀、自我检验清单与课后深度思考题
- 9. 📚 参考资料与核心源码/经典论文指引
- 附录:Appendix A — 大厂硬核高频面试题与白板推导(Interview Drill)
0. Ringi 开场:生产真实现场与痛点冲突
0.1 真实工程矛盾:当单层显存刺穿与 128K 序列长相遇,数据并行彻底失效
在前两讲(第 28 讲与第 29 讲)中,我们把数据并行(DDP)和显存分片技术(ZeRO / FSDP)拆到了晶体管和通信原语级别:- DDP 依靠反向异步 Bucket AllReduce 实现了极高的计算通信重叠;
- ZeRO-3 / FSDP 依靠流式按需拼装(On-demand AllGather),将单卡静态显存从 压低到了极限的 。
“既然 FSDP 已经可以把参数、梯度和优化器切到无限小,那是不是意味着我们只需要 FSDP 就足够统治一切大模型预训练了?”现实给了我们一记沉重的耳光:在生产环境里,纯粹的数据并行会瞬间撞上两堵坚不可摧的物理高墙!
- 单层 GEMM 算力与显存墙(Layer-level Memory Wall):
- 哪怕使用 FSDP,在前向执行某一个具体的 Transformer Block 时,系统也必须在显存中拼装出这一层完整的参数;
- 对于千亿模型(如 530B),单个中间隐藏层投影矩阵的尺寸高达 (单个权重矩阵就占近 1 GB 显存),而当执行大 Batch 或长序列前向时,仅这一层产生的单次矩阵乘法中间临时激活显存就会直接击穿单张 80GB 卡的物理上限!
- FSDP 根本无法把单个算子内部的计算和单层激活值切开!
- 长序列 长度墙(Sequence Length Wall):
- 当大模型从 2K 序列跃升至 32K、128K 乃至 1M 时,Self-Attention 的注意力矩阵计算量与显存开销随序列长度 呈二次方爆炸;
- 传统的 DDP/FSDP 是在 Batch 维度切分。当序列超长导致单卡哪怕只能跑 的单个样本时,单卡显存也当场爆仓!
这就是为什么顶级大模型训练集群必须走向 3D / 4D 混合并行 的终极原因。
0.2 线上真实事故复盘:某千亿模型拓扑乱配引发的“NVLink 闲死,IB 塞爆,MFU 跌破 15%”
2024 年,国内某智算中心在 64 台 8 卡 H800(共 512 张 GPU)集群上预训练一个 175B 规模的稠密模型。 初始启动时,架构团队分配了如下配置:- 全局 Batch Size 较大,配置了 ( )。
- 由于单机只有 8 张 GPU,配置 意味着张量并行组强行跨越了物理机界限:每 2 台机器的 16 张卡组成一个 TP 组。
- 网络交换机 PFC 流控风暴:机间 400G InfiniBand 网络的丢包与拥塞通知瞬间拉满;
- GPU 算力利用率暴跌:整机单步步时高达 28.6 秒,MFU(Model FLOPs Utilization)跌至凄惨的 13.8%;
- 硬件资源极度倒挂:节点内的 NVLink 跑道空空荡荡(利用率不足 10%),而机间 IB 网卡跑满发烫,90% 的时间 GPU 都在等待跨机 AllReduce 的握手同步!
- 张量并行(TP)是微观算子级并行,在单个 Transformer Block 内部每算一层 GEMM 就要触发一次通信,通信频率极其恐怖(单步数百次);
- 架构师错误地把高频通信的 TP 推到了机间慢速网络(400G IB 单向带宽仅 50 GB/s,且延迟高达数微秒);而节点内部单向带宽高达 400 GB/s、延迟仅几百纳秒的 NVLink 却被严重闲置!
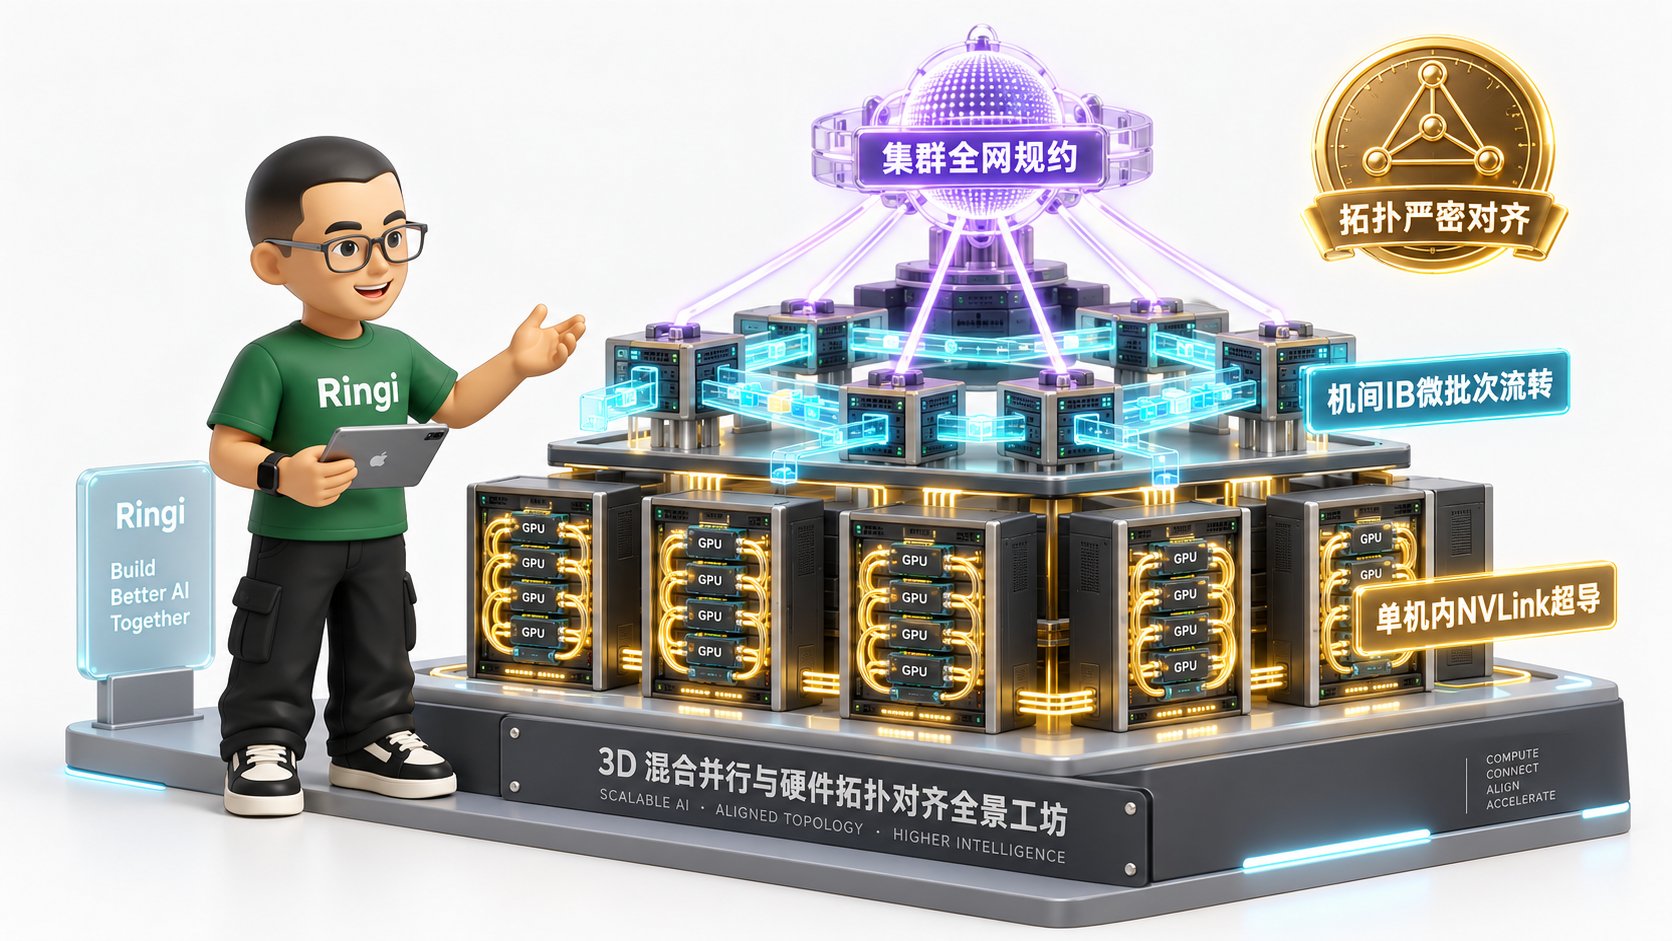
- 严格遵循硬件物理拓扑映射阶梯法则:强制把 TP 限制在单机 8 卡内部( ),锁死在 NVLink 高速公路;
- 将跨机切分交给流水线并行( )与数据并行( );
- 重构后,单步步时从 28.6 秒骤降到 4.1 秒,吞吐暴增近 7 倍,MFU 强势跃升至 54.2%!
0.3 模型并行与多维切分技术全景演进速查表
1. 张量并行(Tensor Parallelism, TP)深度拆解与数学推导
💡 架构全景速览:在深潜源码前,先在白板上建立坚不可摧的模型并行(TP/PP/SP/CP)与硬件物理拓扑映射底账。

1.1 为什么需要切矩阵:单层 GEMM 算力与参数物理分割
大模型的核心是由密集的通用矩阵乘法(GEMM)构成的。无论是注意力模块的 投影与输出投影,还是 MLP 模块的双层前馈网络,本质上都在反复计算: 其中:- 是输入激活张量,Shape 为 (Batch Size 序列长度 隐藏层维度);
- 是线性层权重矩阵,Shape 为 (或 MLP 中的 );
- 是输出激活张量,Shape 为 。
1.2 Column Parallel Linear(列切分)数学证明
① 切分方式
将权重矩阵 沿**列方向(输出特征维度)**均匀切分成 份( 为 TP 度,通常为 8):② 计算过程
每张 GPU 独立持有完整的输入激活 以及自己负责的那一列权重分片 。各卡在本地独立执行矩阵乘法:③ 输出拼接与通信
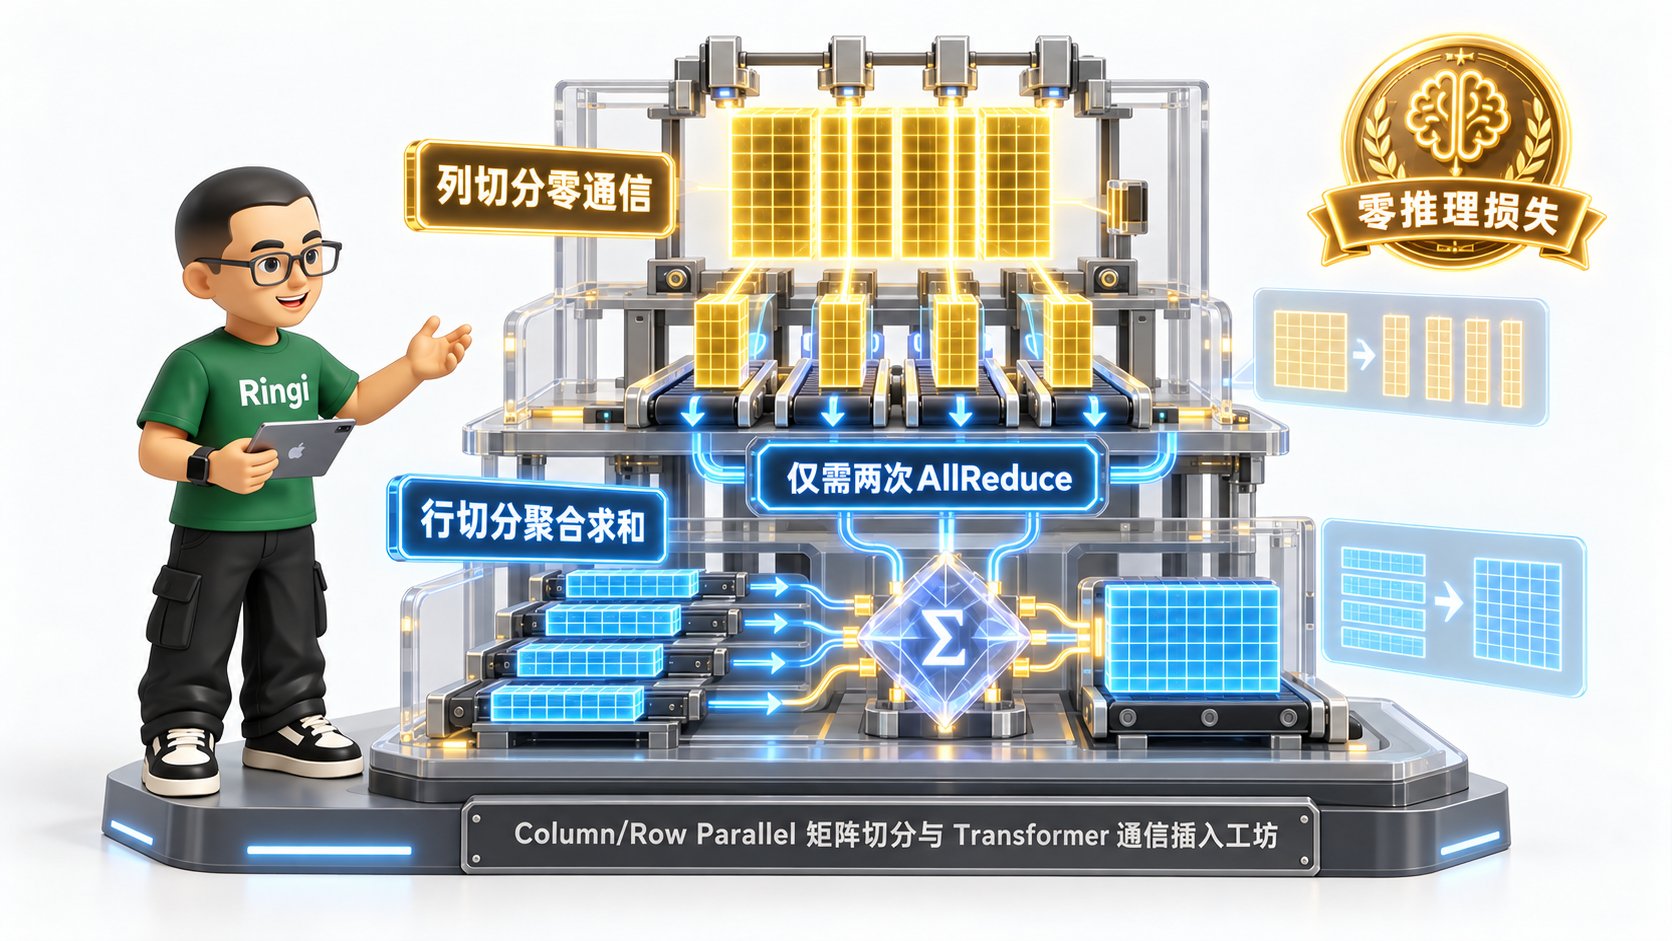
各卡计算出的 恰好拼成完整的输出矩阵 :- 惊艳特性:在前向传播过程中,Column Parallel 完全不需要任何卡间通信! 每张卡拿着完整的 ,各算各的列分片,算出来的结果 也是自然按列分片的。
1.3 Row Parallel Linear(行切分)数学证明
① 切分方式
将权重矩阵 沿**行方向(输入特征维度)**均匀切分成 份:② 输入要求
为了与切断的行矩阵相乘,输入张量 必须沿列方向切分,每张卡只持有对应的分片 。③ 计算过程
各卡在本地计算部分矩阵乘积:④ 输出聚合与通信
根据分块矩阵乘法法则:- 通信插入点:各卡算出的 具有完整的输出维度 ,但包含的只是“部分求和结果(Partial Sum)”。必须在各卡之间执行一次全局求和规约(AllReduce),才能恢复出数学上完全正确的完整输出 !
1.4 Transformer Block 的神级闭环组合:两层 GEMM 仅需 2 次 AllReduce
如果随便滥用列切和行切,每一层矩阵乘法前后都需要插入大量的 AllGather 或 AllReduce,网络瞬间爆炸。Megatron-LM 最天才的工程发明,就是将 Column Parallel 与 Row Parallel 巧妙配对,构成两个优雅的双层结构:
- MLP 模块:第一层 FC1 按列切,输出自然分成 份;直接送入逐元素的激活函数;第二层 FC2 恰好需要按行切的输入,两者无缝咬合!仅在 FC2 输出时做 1 次 AllReduce;
- Attention 模块: 投影按列切,由于多头注意力各个 Head 本身就是互相独立的,每张卡只需负责 个头;算完注意力矩阵后,输出投影矩阵按行切,仅在最终投影结束时做 1 次 AllReduce!
- 整层总结:一个包含 Attention 和 MLP 的标准 Transformer Block,在前向传播中总共只需要执行 2 次 AllReduce!
1.5 No Naked Formula 2.0 穿透 TP 通信量
我们严格执行 No Naked Formula 2.0,将 TP 的通信量底账算到每一个字节。① 为什么需要算它?
张量并行发生在微观层级,网络通信极其密集。必须精确算清每一步通信的字节数,用数学证明为什么 TP 绝对不能跨机,而只能活在 NVLink 内。② Mental Model(物理直觉比喻)
4 个数学家合力算一个庞大的多维方程组。大家先各自拿着全套题目,各自算出一部分变量(列切,零通信);接着大家把中间草稿直接代入下一阶段(无缝咬合);最后在得出总结果时,4 个人必须把手头的数字碰头加在一起汇总(Row Parallel 触发 AllReduce 求和)。③ Tiny Calculator(极简手算)
设:- Token 数量 ;
- 隐藏层维度 ;
- 张量并行度 ;
- 数据类型为 BF16(每个元素 2 字节)。
执行 Ring-AllReduce 时,单卡发送的数据量为:
④ Formal Model(标准公式)
对于一个隐藏层维度为 、序列长度为 、批大小为 的大模型:- 前向传播(Forward):
- Attention 输出投影后 1 次 AllReduce:数据大小为 ;
- MLP 输出投影后 1 次 AllReduce:数据大小为 ;
- 单卡前向通信总量(基于 Ring-AllReduce 发送量 ,当 时 ):
- 反向传播(Backward):
- 伴随矩阵求导法则,前向的 Row Parallel 在反向求梯度时变为 Column Parallel(需 1 次 AllReduce);
- 前向的 Column Parallel 在反向时变为 Row Parallel(需 1 次 AllReduce);
- 反向通信量与前向完全对称:同样为 (Words)!
- 单层单步总通信量:
⑤ Sanity Check(数量级校验)
以 LLaMA-3-70B( , 层数 )在 下单卡每步通信量为例:- 单层通信量: ;
- 全模型 80 层单步通信量: !
- 震撼结论:单步迭代哪怕只需 2 秒,单卡每秒必须吞吐 的通信流!
- 硬件审判:跨机 InfiniBand 400G 网卡的有效吞吐仅约 45 GB/s(瞬间被撑死,步时拉长数倍);而机内 NVLink(450~900 GB/s)吞吐轻松承载这 86 GB/s,通信占比被压缩至 10% 以内!TP 严禁出机是铁一般的物理法则!
2. 序列并行(Sequence Parallelism, SP)——消灭非 TP 区域的激活冗余
2.1 隐形显存刺客:LayerNorm 和 Dropout 上的全量激活冗余
Megatron-LM 的标准 TP 虽然优雅地切分了 GEMM,但工程团队很快发现:显存并没有像预期那样随着 TP 线性缩小! 仔细审视 Transformer Block 的内部结构:- Attention 和 MLP 内部的矩阵被切成了 ;
- 但是在 LayerNorm、Dropout 以及残差连接(Residual Addition) 区域,输入和输出张量都是全尺寸的 ;
- 为了执行反向求导,系统必须在显存中缓存这些区域的前向激活值。这些非 TP 区域的激活值,在每张 GPU 上都保存了一份 100% 重复的全量副本!
- 在长序列训练中,这些激活值显存甚至超过了模型参数本身!
2.2 Megatron-SP 的代数变换:AllReduce 拆解为 ReduceScatter + AllGather
Megatron-LM 团队在 2022 年(Korthikanti et al., 2022)提出了著名的 Megatron-SP(序列并行)。其核心洞察力堪称代数神来之笔: 我们知道集合通信原语存在一个恒等分解式:- ReduceScatter:将全尺寸张量规约求和,并将结果切成 份分散到各卡;
- AllGather:将各卡持有的 分片收集拼装成全尺寸张量。
2.3 零额外通信代价下的激活显存线性暴降
这笔账极其震撼:- 通信量守恒:经典 TP 在 Row Parallel 后做一次 AllReduce(传输量为 );而在 SP 中,变成了“一次 ReduceScatter( )+ 一次 AllGather( )”,总通信量完全守恒,没有增加任何一个字节!
- 显存收益巨大:整层 Transformer Block 中,不仅 GEMM 区域是 显存,连 LayerNorm、Dropout 和残差连接也全变成了 显存;
- 结论:Sequence Parallelism 是免费的午餐(Free Lunch)。在工业界生产中,只要启用了 TP,必须无条件同步开启 SP!
3. 上下文并行(Context Parallelism, CP)——突破 128K+ 序列长度墙
3.1 为什么长文本下 TP+SP 依然 OOM:Attention 计算的 极限
当我们将上下文长度推进到 128K、256K 乃至 1M 时,又遭遇了新的生死劫:- TP+SP 仅仅将序列切分到了单机 8 卡( ),序列长度从 降到了 ;
- 然而,在 Self-Attention 的核心区域,每个 Query Token 依然需要与全序列的所有 Key Token 进行点积,计算复杂度与中间 Softmax 显存依然是 ;
- 哪怕单卡 Batch Size 压低到 1,仅 的 KV 激活和 Attention Score 也会直接在单卡爆掉。
3.2 方案一:Ring-Attention 环形点对点流转与 Online Softmax 拼装
由 UC Berkeley(Hao Liu et al., 2023)提出的 Ring-Attention,是长序列领域极具颠覆性的工作。关键优势与 Corner Case:
- 通信计算完美 Overlap:P2P 传输下一个 KV 块的时间,完全被当前块的 GEMM 计算所掩盖;
- 因果掩码(Causal Mask)下的负载不均衡:
- 自回归模型中,靠前的 Token 无法看到靠后的 Token(下三角掩码);
- 在朴素切分下,持有序列前半段的 GPU 在后半程只能空转等车;
- 工业级解决方案(Zigzag / Striped Ring-Attention):不再按连续区间切分,而是采用跨步交错切分(如 GPU 0 持有 Token 0, 4, 8…),让每张 GPU 承担均等大小的有效计算三角区,算力利用率回升至近 100%!
3.3 方案二:DeepSpeed-Ulysses 的 All-to-All 注意力头维度转置
微软 DeepSpeed 团队提出的 DeepSpeed-Ulysses,采用了一种极其巧妙的“维度置换魔法”:3.4 Ring-Attention vs DeepSpeed-Ulysses 工业级选型决策
4. 流水线并行(Pipeline Parallelism, PP)与气泡率消除
4.1 纵向层间切分与 P2P 通信特征
当模型不仅单层放不下,而且全网层数高达 80 层、120 层时,单台机器连所有权重都装不下。流水线并行(Pipeline Parallelism, PP) 沿着神经网络的深度方向进行纵向切分:
- 设模型总层数为 ,流水线并行度为 (Stage 数量);
- 每个 Stage 分配连续的 层(例如 Stage 0 持有 1
20 层,Stage 1 持有 2140 层……); - 通信特征极其优越:只有相邻的两个 Stage 之间存在数据传输,且传输的仅仅是层间激活张量(Shape 为 )。通信完全是点对点(P2P),通信量与模型参数量完全解耦!
4.2 流水线调度演进与气泡率推导(Naive ➔ GPipe ➔ 1F1B ➔ Interleaved)
流水线并行面临的最大敌人是 Pipeline Bubble(流水线气泡):后一个 Stage 必须等待前一个 Stage 算完才能动工,导致 GPU 发生大面积空转。 我们运用 No Naked Formula 2.0,推导出四代流水线调度的气泡率演进公式: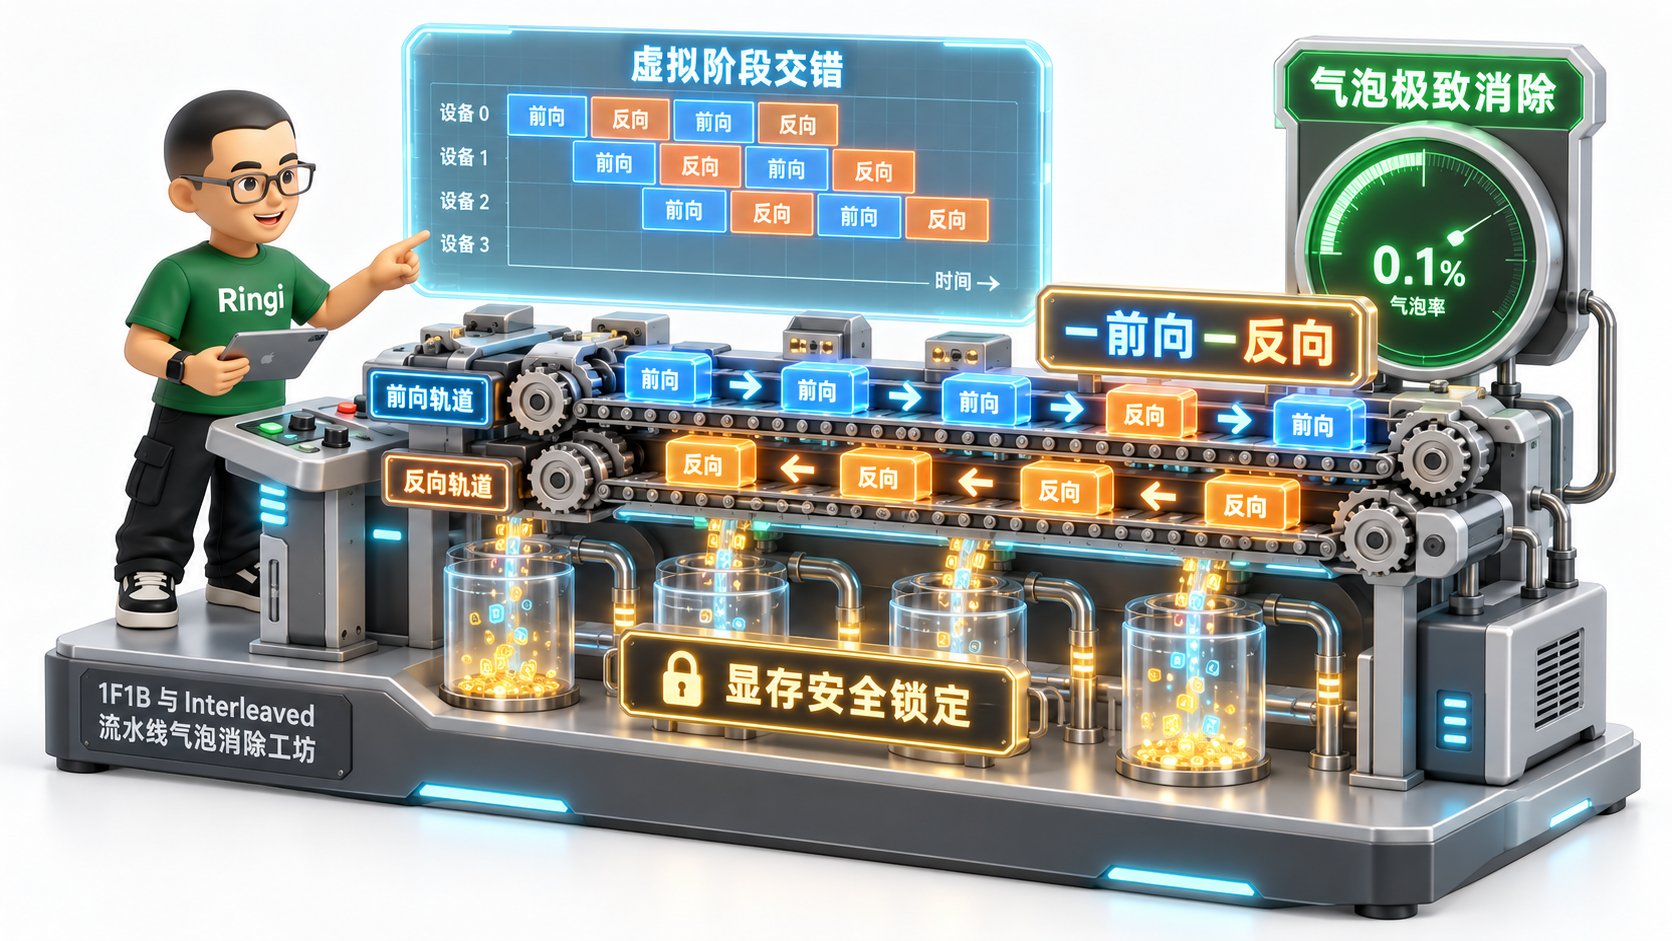
气泡率量化推导对比表:
4.3 显存峰值控制:1F1B 如何把激活显存从 份压至 份
在 GPipe 中,所有 Micro-batch 的前向必须全部跑完,才开始跑反向。如果我们将一个全局 Batch 切分成 个 Micro-batch,Stage 0 就必须在显存里死死保留整整 64 份完整的中间激活张量,显存当场炸穿。 1F1B 的破局之道(One-Forward-One-Backward):- Warmup 阶段:流水线先连续注入 个 Micro-batch 的前向计算;
- Steady 稳态阶段:流水线填满后,每执行一个 Micro-batch 的前向计算,立刻执行上一个已经就绪的 Micro-batch 的反向计算!
- 因果释放:一旦反向计算完成,该 Micro-batch 对应的中间激活显存立刻被
free()彻底释放! - 数学铁证:在整个稳态运行期间,任何一个物理 Stage 内部存活的活跃 Micro-batch 数量被严格封顶在 份以内(与总微批次数 彻底解耦),彻底解除了显存炸裂的后顾之忧。
5. 3D 混合并行与硬件拓扑对齐(Hardware Topology Mapping)
5.1 维度正交律与世界规模方程:
在超大规模集群中,单一的并行策略都存在致命缺陷:- 纯 DP:单卡显存装不下超大模型;
- 纯 TP:通信过于频繁,无法跨越物理节点;
- 纯 PP:气泡率随着 Stage 增加急剧上升,且降低了数据吞吐;
- 纯 CP:仅解决单条序列长度,无法解决总权重装填。
5.2 硬件拓扑映射的黄金四原则(带宽阶梯法则)
集群网络存在残酷的带宽金字塔:- 第一层:单机内 NVLink 4.0(双向 900 GB/s,延迟 < 1\mu s );
- 第二层:同机架机间 InfiniBand NDR 400G(双向 50 GB/s,延迟数微秒);
- 第三层:跨核心交换机网络(拥塞与跳步增加)。
5.3 Megatron-LM 内部笛卡尔积 Rank 编排与通信组构建
在 Megatron-LM 源码(megatron/core/parallel_state.py)中,进程组的初始化逻辑遵循极其严谨的局部性优先步长排列:
为了让物理相邻的 GPU(Rank 0~7)拥有连续的编号,Megatron 通常将 TP 放在最内层(步长为 1),随后是 CP,接着是 DP,最后是 PP:
- 任意一个 TP 组内的 8 张卡,其物理编号一定是连续的
[0, 1, 2, 3, 4, 5, 6, 7],完美与物理单机 8 卡 NVLink 对齐; - 跨机时,PP 和 DP 组按固定大步长跨越节点,将低频通信自然引向机间 IB 光纤。
5.4 工业级生产案例:千卡集群训练 70B / 530B 的黄金参数矩阵
6. 全场景实战与实验代码(Minimal Runnable Code)
6.1 实验一:纯 Python 原生实现的 TP 列切与行切矩阵数学对齐实战
本实验通过纯 Python 与 PyTorch 原生矩阵算子,从零模拟张量并行 Column Parallel 与 Row Parallel 的切分、独立计算与 AllReduce 聚合,并严格验证其数值与单卡全局 GEMM 误差达到机器精度( ):6.2 实验二:工业级 3D 并行拓扑配置器与通信/显存/气泡率综合评估器 megatron_3d_topology_planner.py
面对百卡、千卡集群,严禁拍脑袋配置 TP、PP、DP。本脚本实现了工业级 3D 并行拓扑推演评估器,精确手算显存分布、流水线气泡率、通信总负载并输出决策结论:
7. Ringi 避坑指南与生产黄金准则
7.1 7 大常见小白认知误区 vs 大厂 AI Infra 正确物理认知
7.2 生产模型并行工程黄金 Checklist
- 1. 【TP 单机闭环铁律】:张量并行度必须满足 (通常 ),严禁分配超出物理节点的高频 TP。
- 2. 【SP 无条件协同】:只要在 Megatron-LM 或框架中开启了
--tensor-model-parallel-size > 1,必须显式加上--sequence-parallel,享受免费的激活显存压降。 - 3. 【微批次倍数约束】:在配置流水线并行时,微批次数量 必须至少满足 ,确保流水线气泡率严格控制在 20% 以下。
- 4. 【Interleaved 虚拟 Stage 权衡】:仅在机间 InfiniBand 带宽极其充裕(如 8x400G IB)时才开启
v_virtual_stages >= 2,防止激活值跨机传输翻倍抵消算力收益。 - 5. 【GQA 头数整除性审查】:审查模型架构参数,确保 Query Head 与 KV Head 均能被
TP或TP / Group整除,杜绝隐式填充和非均匀切分。 - 6. 【Rank 笛卡尔积拓扑对齐】:启动脚本前必须打印并核验
parallel_state中的通信组 Rank 映射,确保 TP 进程严格绑定在同一 PCIe/NVSwitch 拓扑树下。 - 7. 【CP 方案根据 Head 与序列选型】:文本长度 且 Head 数充裕首选 DeepSpeed-Ulysses;文本长度 或 GQA 极度紧凑首选 Zigzag Ring-Attention。
8. Ringi 5 点核心速记口诀、自我检验清单与课后深度思考题
8.1 5 点押韵核心速记口诀
8.2 10 条白板自我检验清单
- 能否在白板上手画一个 Transformer Block,标明 FC1 列切、FC2 行切的矩阵维度变化以及 AllReduce 的具体插入位置?
- 为什么在 Column Parallel 中,前向传播不需要任何卡间通信,而通信压力全部转移到了反向传播?
- 阐明序列并行(SP)是如何利用 的代数恒等式,在零增加通信量的前提下砍掉非 TP 区域显存的?
- 闭卷推导标准 1F1B 流水线调度的气泡率公式:为什么微批次数 越大,气泡率越小?
- 为什么说 1F1B 并没有在数学上减少 GPipe 的稳态气泡,但它却是工业界唯一的救命稻草?
- 在 Interleaved 1F1B(虚拟 Stage)中,为什么将每个 GPU 切分为 个虚拟阶段能够将气泡率再除以 ?它付出的硬件代价是什么?
- 对比 Ring-Attention 与 DeepSpeed-Ulysses:它们分别使用了哪种集合通信原语?在 GQA 架构下各有什么限制?
- 为什么在 3D 并行拓扑映射中,必须严格遵循“TP 在机内、PP 跨节点、DP 在最外层”的硬件阶梯原则?
- 当训练长文本(如 64K)时,为什么不能简单地无脑把 TP 从 8 开到 16?
- Megatron-LM 的
parallel_state.py是如何利用步长乘积构建多维通信组 NCCL Communicator 的?
8.3 3 道高阶开放式课后思考题(含极限 Corner Case)
- 【GQA 架构下的 TP 极度非均匀切分 Corner Case】:在 LLaMA-3-70B 中,Query 头数为 64,但 KV 头数仅为 8(GQA 比率为 8:1)。如果我们设置 ,则每张 GPU 分配到 8 个 Q 头和 1 个 KV 头,切分完美均衡。但是如果我们为了追求更小的单卡显存,强行在跨节点多机上设置 :此时 8 个 KV 头无法均分给 16 张 GPU。工程上通常有两种处理方案:① 强制在每 2 张 GPU 之间复制一份相同的 KV Head;② 将 KV Head 重组为分组切分。请从计算冗余、显存浪费与 NCCL 通信原语变动三个维度,推导这两种方案对端到端 MFU 的致命冲击。
- 【超长上下文 CP 的因果掩码踩踏事故】:在自回归语言模型中,因果掩码(Causal Mask)呈现严格的下三角矩阵结构。假设采用朴素的 Ring Attention 沿序列均匀切分为 8 个 Chunk(GPU 0~7):GPU 0 负责第 1 块,GPU 7 负责最后 1 块。请画图推导演讲:在第 0 步和最后一步计算中,GPU 0 的计算量与 GPU 7 的计算量相差多少倍?为什么这种极度的算力倾斜会导致全网严重的 Straggler 阻塞?Zigzag Ring-Attention 是通过何种映射置换消除这一气泡的?
- 【跨机 PP 慢节点引发的“毒性扩散”】:在一个包含 8 个 Stage 的流水线并行集群中,假设位于 Stage 3 的某张 GPU 由于 PCIe 降速(如退化为 Gen3 x4)导致计算耗时拉长了 30%。请从 1F1B 调度的时间线推演:这个局部的微小延迟是如何像滚雪球一样向前反向传播(阻碍 Stage 2 的反向求导)、向后正向传播(延迟 Stage 4 的前向激活),最终导致整个千卡集群的 GPU 利用率全部腰斩的?针对这种跨机抖动,现代智算平台在调度与自动容灾上应如何设计心跳探测?
9. 📚 参考资料与核心源码/经典论文指引
权威学术论文:
- Megatron-LM TP 奠基之作:Shoeybi et al., “Megatron-LM: Training Multi-Billion Parameter Language Models Using Model Parallelism”, 2019. arXiv:1909.08053
- Megatron-SP 序列并行:Korthikanti et al., “Reducing Activation Recomputation in Large Transformer Models”, MLSys 2023. arXiv:2205.05198
- GPipe 微批次流水线:Huang et al., “GPipe: Efficient Training of Giant Neural Networks using Pipeline Parallelism”, NeurIPS 2019. arXiv:1811.06965
- PipeDream 1F1B 调度:Narayanan et al., “Memory-Efficient Pipeline-Parallel DNN Training”, ICML 2021. arXiv:2006.09503
- Ring-Attention 长序列:Liu et al., “Ring Attention with Block Paged Memory for Exceedingly Long Sequences”, 2023. arXiv:2310.01889
- DeepSpeed-Ulysses 序列转置:Jacobs et al., “DeepSpeed Ulysses: System Optimizations for Enabling Training of Extreme Long Sequence Transformer Models”, 2023. arXiv:2309.14509
工业级开源源码指引:
- Megatron-LM 张量切分源码:
megatron/core/tensor_parallel/layers.py(包含ColumnParallelLinear与RowParallelLinear) - Megatron-LM 序列并行通信:
megatron/core/tensor_parallel/mappings.py(包含reduce_scatter_to_sequence_parallel_region与gather_from_sequence_parallel_region) - Megatron-LM 3D 拓扑构建:
megatron/core/parallel_state.py(包含initialize_model_parallel笛卡尔积通信域构建)
本地 AI_BOOK 知识库精准映射:
- 张量并行与序列并行详解:第6章 张量并行TP与序列并行SP.md
- 流水线并行与气泡调度:第7章 流水线并行PP.md
- 长序列训练与上下文并行:第9章 长序列训练与上下文并行.md
- 3D 混合并行与拓扑映射:第11章 3D并行与混合并行策略.md
- 多维混合并行大厂面试总结:6. 多维度混合并行.md
附录:Appendix A — 大厂硬核高频面试题与白板推导(Interview Drill)
面试真题 1:请白板画图推导 Transformer Block 在 TP 下前向与反向通信量为什么是 ?为什么 TP 严禁出单机?
考察维度:张量并行微观通信机理、矩阵分块相乘法则、算力与网络延迟边界。
标准推导路径:
- 前向传播(Forward Pass)分析:
- Self-Attention 模块: 投影按列切分,无通信;输出投影矩阵按行切分,根据分块矩阵乘法 ,必须在各卡之间对大小为 的局部求和张量执行一次 AllReduce;
- MLP 模块:FC1 矩阵按列切分,逐元素激活函数无通信;FC2 矩阵按行切分,再次对大小为 的局部张量执行一次 AllReduce;
- 单卡发送量:每次 Ring-AllReduce 单卡发送数据量为 (Words);
- 前向总发送量:
- 反向传播(Backward Pass)对称性分析:
- 对行切分层求输入梯度时,依据伴随转置,反向计算变为按列切分;
- 对列切分层求输入梯度时,反向计算变为按行切分,必须再次插入一次 AllReduce;
- 因此反向传播同样需要精确触发 2 次 AllReduce,单卡发送量严格等于: 。
- 单层单步总通信量累加:
- 为什么严禁出机:
- 设单层前向 GEMM 耗时仅 1~2 毫秒;
- 若在机内 NVLink(900 GB/s,延迟 < 1\mu s ),传输几十兆数据仅需数十微秒,完全被计算掩盖;
- 若跨机走 InfiniBand(50 GB/s,跨交换机延迟 ),小包排队与协议栈延迟直接飙升到数毫秒,网络耗时反超计算耗时数倍,全集群 MFU 当场跌破 15%!
面试真题 2:白板推导 1F1B 流水线气泡率公式,Interleaved 1F1B 是如何通过虚拟 Stage 压缩气泡的?代价是什么?
考察维度:流水线并行调度原理、时间片甘特图推导、通信计算 Trade-off。
标准参考答案:
- 1F1B 稳态气泡率数学推导:
- 设流水线包含 个 Stage,全局批次被切分成 个微批次(Micro-batches);
- 设单个 Micro-batch 在单个 Stage 上的前向耗时为 ,反向耗时为 (通常 ),此处为简化推导设理想均匀时间片为 ;
- 充能与排空空转时间(Bubble Time):
- 在第 0 个微批次从 Stage 0 到达 Stage 的过程中,后序节点处于空等,共有 个时间步的空转;
- 在反向传播全部结束排空时,前序节点在等待后序节点反向,又有 个时间步的空转;
- 全流水线单个物理周期的总空转时间为:
- 全流程有效计算时间:
- 每个微批次必须完整跑完前向与反向,总有效微批次步数为 ;
- 端到端总执行时间:
- 稳态气泡率公式:
- Interleaved 1F1B 虚拟阶段压缩机理:
- 每个物理 GPU 不再只管一个大阶段,而是将其细化为 个交错的虚拟阶段(Virtual Stages);
- 单个微批次在每个虚拟阶段的计算耗时缩小为 ;
- 充能与排空等待时间缩短为 ;
- 压缩后气泡率:
- 气泡率被等效扩大了 倍的微批次数所稀释,气泡面积直接削减近 !
- 付出的代价(Trade-off):
- 物理 Stage 数量虽然不变,但层间切断的边界增加了 倍;
- 相邻虚拟 Stage 跨物理设备传递中间激活张量的通信频次与传输总量直接翻了 倍;
- 仅当集群机间网络带宽极其充裕时,这种“用额外通信换低气泡”的策略才能够带来正向收益。
面试真题 3:Ring Attention 与 DeepSpeed-Ulysses 在长上下文训练中的核心切分机制与通信原语有何本质不同?GQA 下如何选型?
考察维度:长序列并行最新演进、集合通信原语差异、现代 GQA 架构适配。
标准参考答案:
- 核心切分维度与通信原语本质差异:
- Ring Attention:
- 切分维度:将整条长序列沿 Sequence 维度切成 段,每张 GPU 拥有局部 ;
- 通信原语:使用环形点对点通信(P2P Send/Recv)。 留在原地,各卡将 块沿环逐跳传递,配合 FlashAttention Online Softmax 动态累积归一化因子;
- DeepSpeed-Ulysses:
- 切分维度:输入时沿 Sequence 维度切分,但在执行 Attention 计算前,通过 All-to-All 通信原语将序列切分转置为注意力头(Head)维度切分;
- 通信原语:注意力计算前后各执行一次全局 All-to-All。在注意力内核内部,每张卡直接跑全长度、少头数的标准 FlashAttention。
- 现代 GQA 架构下的选型决策:
- 问题瓶颈:在现代主流模型(如 LLaMA-3、Mistral)中,普遍采用分组查询注意力(GQA),KV 头数极其稀疏(通常仅 8 个);
- Ulysses 的致命短板:Ulysses 强制要求注意力头数必须能被 CP 并行度整除。若 KV Head=8,则 Ulysses 的上下文并行度绝对无法超过 8!若想扩展到 16 卡或 32 卡,必须引入极其复杂的跨卡 KV 复制;
- Ring Attention 的绝对优势:Ring Attention 沿序列本身切分,对 Head 数量没有任何整除性限制;在 GQA 下传输的 KV 分片尺寸极小,不仅能无缝扩展到数十上百张卡,通信量还获得了数倍的自然压缩;
- 选型结论:面对 GQA 稀疏头架构与 128K 以上极限长序列,必须首选 Zigzag Ring-Attention;而在 32K 级别、且 Query 与 KV 均为密集多头(MHA)的场景下,Ulysses 凭借优异的 All-to-All 吞吐具有更高的工程性价比。