第27讲:显存去哪儿了?——大模型训练与推理显存全景账本、FLOPs 白板手算与 KV Cache 容量规划
主讲人:👓 Ringi(大厂 AI Infrastructure 资深性能架构师)
所属专栏:《AI_Infra大话西游之水滴石穿》 ➔ Module 03: LLM 架构、FLOPs 与显存建模
篇章范式:📐 模型架构、算法与显存建模范式(Model Architecture & Memory Ledger Paradigm)
源码与实验环境:NVIDIA A100-SXM4-80GB / H100-SXM5-80GB | CUDA 12.4 | Python 3.10 | PyTorch 2.3+
知识底账索引:
- 显存与 KV 核心底账:大模型训练内存与参数计算(AIInfra)
- 推理内存与 KV Cache:大模型推理内存与参数计算(AIInfra)
- MFU 与算力利用率:CODE 03: MFU 模型利用率评估(AIInfra)
- ZeRO 显存切分实现:ZeRO 显存优化深入拆解(AIInfra)
📑 目录导航
- 0. Ringi 开场:生产真实现场与痛点冲突
- 1. 静态显存白板手算:权重、梯度与 AdamW 优化器( 底账)
- 2. 动态激活显存深度拆解:激活值的三档重算(Recomputation)博弈
- 3. 推理显存账本与 KV Cache 容量规划
- 4. 计算量(FLOPs)、MFU 与 HFU 工业级算盘
- 5. 全场景实战:编写工业级容量规划与显存诊断脚本
- 6. Ringi 避坑指南与生产黄金准则
- 7. Ringi 5 点核心速记口诀、自我检验清单与课后深度思考题
- 8. 📚 参考资料与核心源码/经典论文指引
- 附录:Appendix A — 大厂硬核高频面试题与白板推导(Interview Drill)
- 🎨 【配图工坊生图 Prompt 暂存区 · 生成配图后可一键整块删除】
0. Ringi 开场:生产真实现场与痛点冲突
0.1 真实工程矛盾:千卡训练的“幽灵 OOM” vs 线上推理的“虚胖碎片”
在 AI Infrastructure 性能工程的日常中,有两场灾难最让架构师夜不能寐: 第一场灾难发生在训练侧:千卡分布式预训练集群平稳运行了整整两周,一切监控指标看似风平浪静。突然在第 15,200 个 Step,某台计算节点毫无征兆地爆出
CUDA out of memory。分布式框架的容错机制触发,整组任务被强行拉起,但从 Checkpoint 恢复加载后仅仅跑了 3 个 Step,相同的节点又在同一个位置暴毙!算法同学信誓旦旦:“Ringi,我们的 Batch Size 根本没改,静态权重和优化器也是固定的,为什么训练突然就 OOM 了?这是不是显卡硬件显存坏块?”
答案往往是:数据采样遇到了极端长序列,前向传播激增的激活值(Activation)与反向传播的临时梯度 Buffer 瞬间交汇,在毫秒级瞬间刺穿了最后的显存红线! 第二场灾难发生在推理侧:
线上部署了 8 张 A100-80GB 推理卡,算法根据模型参数和理论 KV Cache 估算:每个请求占 1 GB,整机剩余显存 500 GB,理论上承载 500 并发绰绰有余。然而压测刚拉到 80 并发,显卡内存利用率就已经飙红到 98%,后续请求全部被拒。
运维同学惊呼:“为什么才 80 并发显存就满了?剩下的 400 GB 显存到底被谁吃掉了?!”
答案极其讽刺:显存根本没被真正用上,而是被框架朴素的连续显存预分配机制切割成了无数无法回收的“内部碎片与外部碎片”,系统虚胖致死!
0.2 线上真实事故复盘:某 1024 卡集群扩充 16K 上下文引发的全链路瘫痪
2024 年盛夏,国内某顶尖 AI 实验室在 1024 张 H800 GPU(128 个 8 卡节点)上进行 70B 稠密模型的第二阶段预训练(从 4K 上下文正式热扩充至 16K)。 为了保证吞吐,团队使用了 Tensor Parallel (TP=8) + Data Parallel (DP=128),并开启了 ZeRO-1(切分优化器状态)。在 4K 阶段,单卡显存稳固在 68 GB / 80 GB,系统安全裕量良好。 但在修改配置将max_position_embeddings 调整为 16384 并继续训练的第 1 个 Step:
- 前向传播执行到第 40 层 Transformer Block;
- 由于未开启选择性重算(Selective Activation Recomputation),Attention 算子内部的中间概率矩阵激活值开销随着序列长度呈 二次形式暴涨;
- 单卡动态激活值从 4K 时的 8.5 GB 瞬间膨胀到惊人的 34.8 GB;
- 静态显存(权重 17.5 GB + 梯度 17.5 GB + ZeRO-1 优化器 12 GB = 47 GB)叠加激增的 34.8 GB 激活值,瞬间达到 81.8 GB > 80 GB;
- 全集群 1024 张 GPU 在 2 秒内相继触发级联 OOM 崩溃,网络心跳超时,分布式通信拓扑彻底死锁。
- 将优化器与梯度切分升级为 ZeRO-2(单卡静态显存从 47 GB 压降至 21 GB);
- 开启基于 FlashAttention 的选择性激活重算(动态激活值压缩 72%);
- 最终在 16K 序列下,单卡显存不仅没有爆,反而降到了舒适的 48 GB,为后续进一步扩充到 32K 留足了护城河。
0.3 显存四大账本(容量 vs 流量)与全景指标速查表
1. 静态显存白板手算:权重、梯度与 AdamW 优化器( 底账)
为了在深入具体细节前建立完整的物理心智模型,下方给出了大模型显存四大账本、ZeRO 状态切分模型、动态激活值三档重算博弈与 FLOPs 矩阵计数的工业级全景架构拓扑:
1.1 混合精度训练的四重身:从 BF16 到 FP32 Master Weight
很多人直觉上认为:“我用 BF16 混合精度训练模型,显存里应该全都是 16 位的 2 字节数字。”大错特错! 在标准混合精度训练中,显存的大头从来不是 BF16,而是为了保证更新稳定性所维护的 FP32 主参数副本(Master Weight)。
为什么不能纯用 BF16 完成更新?
在优化器步进(optimizer.step())时,学习率 通常是一个微小的数字(如 到 )。当计算参数增量 时, 的数值通常处于 数量级。
而 BF16 只有 7 位尾数(有效数字仅 2~3 位十进制精度)。如果直接在 BF16 权重上累加: 由于两者的阶数相差过大,微小的 会在浮点对齐时被硬件直接截断(Underflow 消失)!这意味着模型在训练后期,权重根本得不到任何微小更新,训练彻底停滞。 因此,工业级标准实践必须维护一套完整的 FP32 状态体系:
1.2 为什么是 ?什么时候会膨胀到 或 ?
我们用严密的算盘,对一个参数量为 的稠密模型进行静态显存手算:标准 显存底账(主流 Megatron-LM / DeepSpeed 默认):
- 模型权重(Model Weights):BF16 存储,占用 字节;
- 模型梯度(Gradients):BF16 存储,占用 字节;
- AdamW 优化器状态(Optimizer States):
- FP32 Master Weight: 字节;
- FP32 梯度一阶动量(First Moment ): 字节;
- FP32 梯度二阶动量(Second Moment ): 字节;
- 优化器状态小计: 字节。
何时会膨胀到 ?
在部分对数值稳定性要求极高的框架中(如早期的 Apex 混合精度),为了防止梯度在跨 Micro-Batch 累加时溢出,梯度本身以 FP32 格式常驻:何时会膨胀到 ?
如果在分布式数据并行(DDP)同步规约中,额外开辟了一个全尺寸的 FP32 通信平坦缓冲区(Bucket Flat Buffer),则会再增加 的常驻开销,达到惊人的 。工业基准:在白板面试与工程估算中,一律以 为严谨基准!
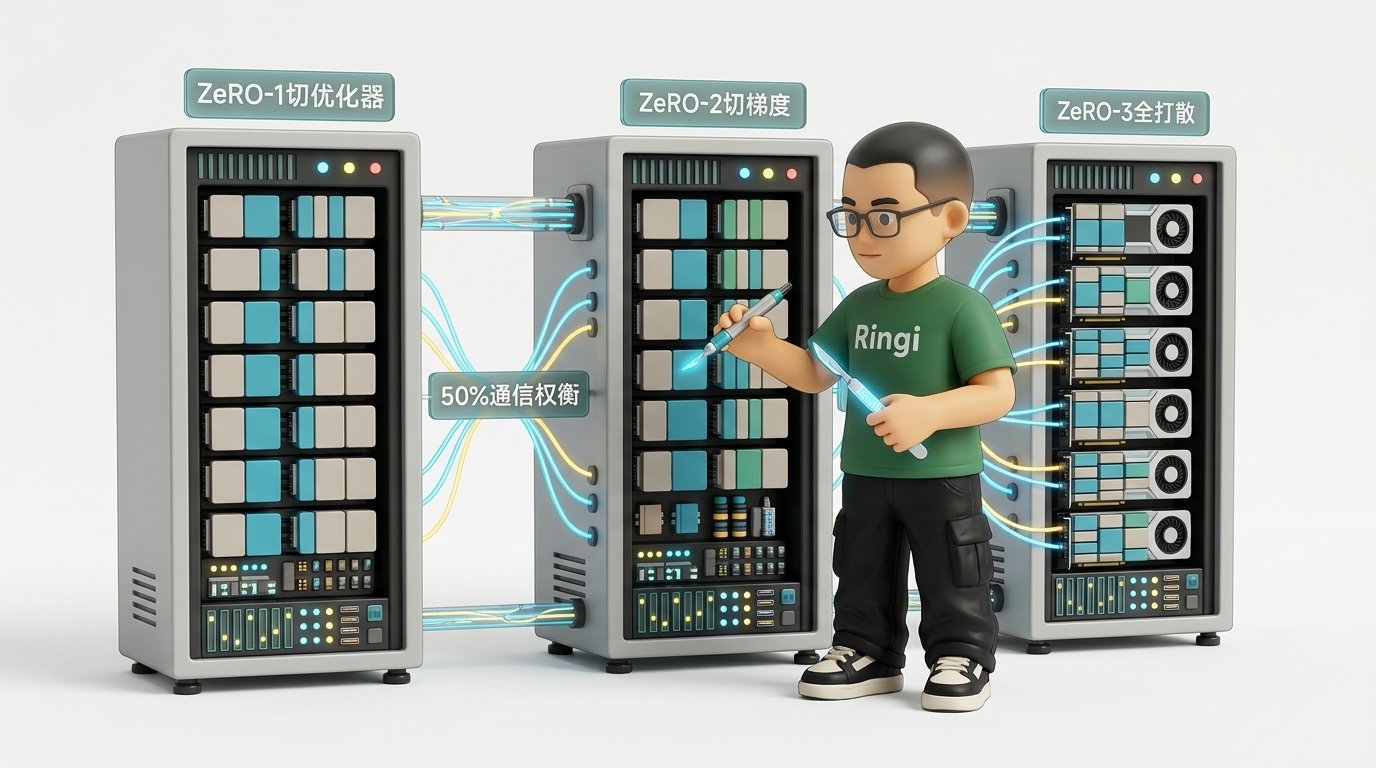
1.3 ZeRO-1 / ZeRO-2 / ZeRO-3 状态切分模型与单卡显存推导
对于一个 70B 模型( ), 意味着静态显存需要: 单张 80GB 卡显然不可能装下。微软提出的 ZeRO(Zero Redundancy Optimizer) 算法,通过数据并行维度的切分彻底粉碎了这一死局:1.4 ZeRO-Offload 的物理瓶颈:PCIe 带宽与 Host 内存延迟惩罚
当显卡显存极度紧张时,很多工程师会寄希望于开启ZeRO-Offload,将优化器状态甚至部分权重卸载到主机内存(Host CPU DRAM)甚至 NVMe SSD 上。
掏出工程算盘手算:这笔账到底划不划算?
假设你在单台 8 卡服务器上训练 70B 模型,通过 PCIe 4.0 x16 互联:
- PCIe 4.0 x16 双向理论带宽:约 32 GB/s(实际单向有效吞吐仅约 24 GB/s);
- 需要卸载的数据量:70B 模型的优化器状态占 ;
- 每次参数更新,GPU 必须把梯度通过 PCIe 搬运给 CPU,CPU 计算完 AdamW 后,再把更新后的参数通过 PCIe 搬运回 GPU;
- 单次跨 PCIe 搬运耗时:
这意味着:开启 ZeRO-Offload 之后,训练 Step Time 从 1.2 秒被硬生生拉长到 36.2 秒,整机算力利用率(MFU)暴跌至不足 3%!
生产结论:ZeRO-Offload 仅适合低成本个人微调或死里求生的救急场景,在大规模工业预训练中严禁作为主流方案。
2. 动态激活显存深度拆解:激活值的三档重算(Recomputation)博弈
2.1 逐层激活值公式白板推导:Attention 与 FFN 的激活开销
在前向传播中,除了静态权重,每一层计算出的中间变量(Activations)都必须缓存在显存中,直到反向传播求导用完后才能被销毁。 我们以单层标准 Transformer Block 为例,输入批大小 ,序列长度 ,主干维度 ,Query 头数 (为简化推导先按标准 MHA 分析,单头维度 ):1. Attention 模块激活值明细:
- 投影输入:共享输入 ,无需存三份,保存输入 (BF16): 字节;
- 投影产物:用于求导,需存 : 字节;
- 注意力得分矩阵 :尺寸为 ,元素数为 : 字节;
- Softmax 归一化概率矩阵 :尺寸同为 : 字节;
- Dropout 掩码(若开启):按 Byte 存储(1 字节/元素): 字节;
- Value 投影产物与 Attention 输出: 字节;
- 输出投射 与残差连接: 字节。
2. FFN 模块激活值明细(以标准 FFN 为例):
- 输入 LayerNorm 状态: 字节;
- 第一层升维线性投射产物: ,占用 字节;
- 激活函数(GELU/ReLU)中间保留值: 字节;
- 第二层降维线性投射输入与残差: 字节;
- FFN 激活值小计: 字节。
单层激活值总量大一统公式(无重算):
全模型 层的总激活显存为: 致命痛点:注意公式右侧的 !当序列长度从 放大到 (放大 16 倍)时, 项被放大了整整 256 倍!激活显存会瞬间突破数百 GB,这就是引发长文本 OOM 的头号元凶。
2.2 三档重算策略深度博弈:无重算 vs 全重算 vs 选择性重算
为了降服 的显存吞噬,系统工程师发明了激活值重算(Activation Checkpointing)。2.3 FlashAttention 反向融合如何抹平中间矩阵显存
在上一模块第 25 讲中,我们详细推导了 FlashAttention 的前向 Tiling。那么在显存账本中,FlashAttention 是如何拯救反向传播激活值的? 传统 PyTorch 原生 Attention: 必须将大小为 的中间注意力矩阵 和 Softmax 输出矩阵 完整落盘写出到 HBM,供反向传播求导读取。在 32K 序列下,仅这两个矩阵就要吞噬几十 GB 显存。 FlashAttention 反向融合机制: 在前向传播时,根本不存 和 !它仅把 Softmax 的行归一化统计量(标量向量 ,仅占微不足道的 字节)保留在 HBM 中。在反向传播时,Kernel 直接在 SM 内部的高速 SRAM 寄存器中,利用保留的 以及标量 ,当场重算局部的 块并立刻与梯度累加! 收益结算:通过将反向求导融合进同一个 GPU Kernel,直接把 激活值完全消除在 SRAM 中,使长文本下的 Attention 激活显存从“不可承受之重”降维打击为“几乎零感知”。
3. 推理显存账本与 KV Cache 容量规划
3.1 推理两阶段的物理分化:Prefill 阶段 vs Decode 阶段
在推理服务中,大模型的运行绝不是均匀同构的,而是分裂为特征完全相反的两个阶段:3.2 No Naked Formula 2.0 穿透 KV Cache 容量公式
我们再次调用最严谨的 No Naked Formula 2.0(公式五步穿透法):① 为什么需要算它?
Decode 阶段生成每个 Token 时,由于模型必须与历史所有 Token 做注意力计算,如果不缓存历史 Key 和 Value,每生成一个新词都要把所有历史词重新过一遍模型,计算复杂度将从 退化为 ,线上延迟彻底爆炸。② Mental Model(物理直觉比喻)
KV Cache 就像是你在读一本长篇侦探小说时手边做的人物关系笔记本。每一章新登场一个角色,你都在本子上记下一笔(新增 Key 和 Value)。书越读越厚,笔记本占用的桌面空间(物理显存)越来越大,直到桌子被本子堆满,你再也放不下一页新纸。③ Tiny Calculator(极简数字手算)
设单卡模型参数:- 层数
- 批大小
- 序列总长度
- 隐藏层大小 ,Head 维度 ,Query 头数 ,KV 头数 (GQA 2:1)
- 数据类型:BF16(2 字节/元素)
- Key 向量大小: 个元素,占 字节;
- Value 向量大小: 个元素,占 字节;
- 单 Token 单层 KV 字节: 字节。
总容量( ): 。
④ Formal Model(标准公式与映射)
对于一个 层、隐藏层大小 、Query 头数 、KV 头数 的模型,在精度字节数为 (FP16/BF16 时 ,FP8 时 )下: 单 Token 在全模型中产生的 KV Cache 显存为: 在并发请求数为 ,平均上下文长度为 时,全集群常驻的总 KV Cache 物理显存为:⑤ Sanity Check(数量级校验)
以 LLaMA-3-70B( ,即 GQA 1:8 分组)为例: 单 Token 全层 KV Cache 尺寸(BF16, ): 当部署在单机 8 卡 H100(TP=8)上时:- 单卡平摊每 Token 仅:
- 若并发 ,上下文平均长度 (8K):
- 80GB 显存扣除约 17.5 GB 静态权重后,剩余超过 50 GB 显存,服务运行非常宽裕!
3.3 传统连续预分配 vs PagedAttention 分页虚拟化
如果仅仅按上述理论公式计算,线上服务依然会频繁遭遇虚假的 OOM。为什么?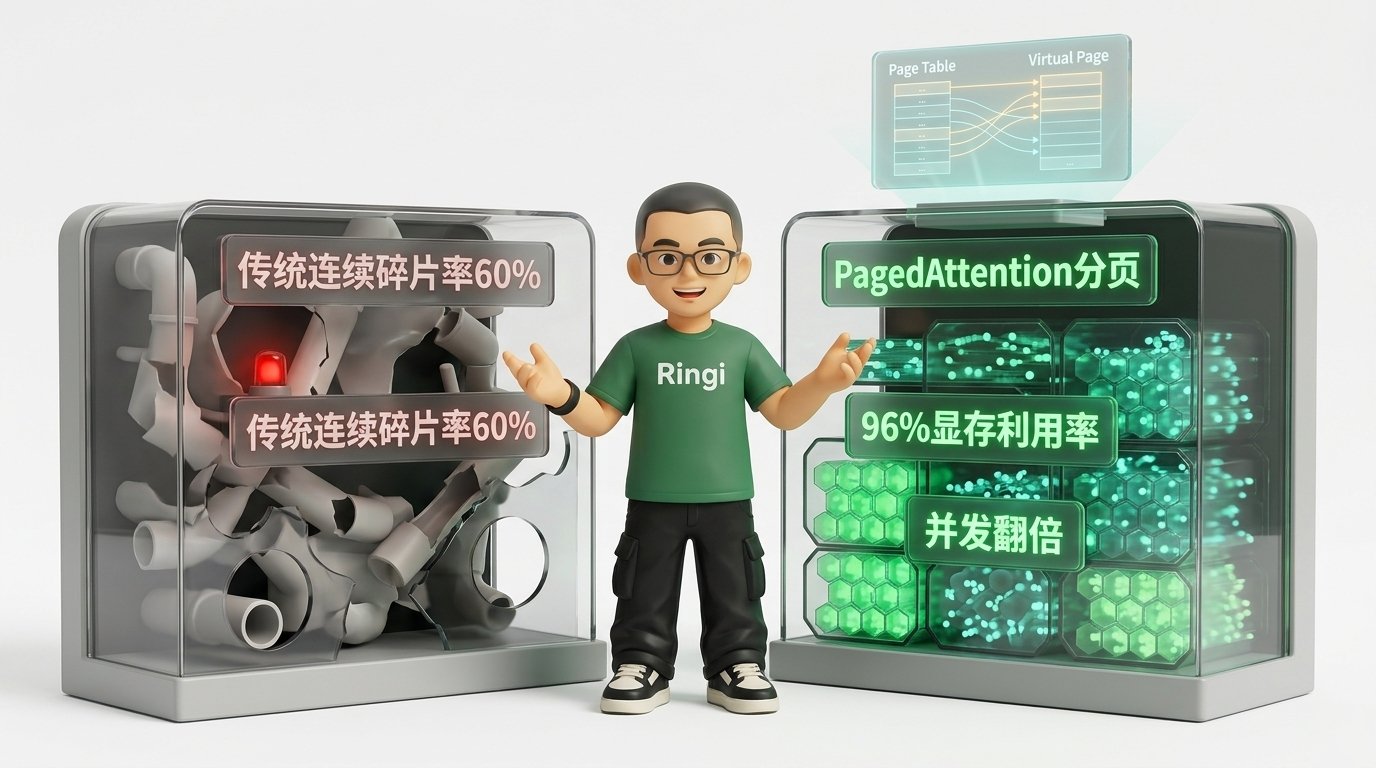
传统朴素推理引擎的致命痛点(显存虚胖):
在 HuggingFace 等朴素框架中,由于 PyTorch 的张量必须在物理上占据连续内存空间:- 预分配浪费(Internal Fragmentation):当用户设定最大生成长度为 4096 时,框架必须在请求刚进来的一瞬间,就立刻按 4096 长度分配出一整块连续显存空间!但实际用户可能问了一个简单问题,模型只吐出 50 个 Token 就输出了
<eos>结束符。剩下的 4046 个 Token 显存全部被白白锁死,无法给其他请求使用; - 外部碎片(External Fragmentation):由于不同请求的长度动态变化,频繁的分配与释放会导致 GPU 显存被割裂成无数细小、不连续的空闲碎片。当一个新请求需要 2 GB 连续空间时,虽然显存总空闲还有 10 GB,但最大的连续块只有 1.5 GB,系统依然报错 OOM!
PagedAttention(vLLM 核心算法)的破局之道:
借鉴现代操作系统虚拟内存的分页机制(Paging),PagedAttention 彻底打碎了物理连续的枷锁:- 逻辑连续,物理离散:将每个序列的 KV Cache 切分为固定大小的 Block(如每个 Block 存 16 个 Token);
- 页表路由(Page Table):在 CPU 侧维护一张逻辑块到物理块的映射页表。每当生成 16 个新 Token,引擎才向显存内存池申请一个新的物理 Block;
- Copy-on-Write 零拷贝分叉:在多轮对话或并行采样(Parallel Sampling)中,共享的前缀 Prompt 物理 Block 只有一份引用,仅在发生分叉写入时才申请新 Block。
3.4 稠密模型 vs MoE 混合专家模型的显存账本分化
随着 Mixtral 8x7B、DeepSeek-V2/V3 等 MoE(Mixture of Experts)模型席卷工业界,显存账本出现了革命性的分化:MoE 显存架构设计的工业 Trade-off:
- 显存容量是硬门槛:部署 MoE 必须按**全量总参数(Total Params)**来规划 GPU 显存容量。哪怕每个 Token 只激活 1 个专家,整张卡也必须把所有未激活专家的静态权重完整常驻显存;
- Decode 吞吐天然受益:在推理 Decode 阶段,由于算术强度由激活参数决定,MoE 模型以 13B 的微小计算量却拥有接近 70B 稠密模型的知识容量,使得端到端首字延迟(TTFT)和单字生成延迟(TPOT)表现极其优异;
- EP(专家并行)通信开销:当单机显存塞不下海量专家时,必须引入专家并行(Expert Parallelism),这会引发跨节点的
All-to-AllToken 路由通信,对集群机间 RDMA 带宽提出极高要求。
4. 计算量(FLOPs)、MFU 与 HFU 工业级算盘
4.1 前向 、反向 、训练 与全重算 的严格矩阵计数
在上一讲中我们推导了单 Token 的基本算盘。在此我们建立面向分布式全集群的完整 FLOPs 计数模型: 设非 Embedding 模型参数量为 ,全批次 Token 总数( ):- 前向传播(Forward Pass):
- 反向传播(Backward Pass,激活求导 + 权重求导 ):
- 标准训练(Standard Training,无全重算):
- 全激活重算训练(Full Activation Checkpointing): 由于前向过程被完整多算了一次:
4.2 Attention 二次项修正量:何时不能忽略 ?
在很多简化的参数计算中,大家往往习惯性使用 。但在超长上下文( )训练中,Attention 矩阵点乘带来的计算量绝对不容忽视! 对于 层 Transformer,每层包含两个与参数量无关的纯张量乘法:- : ,计算量为 ;
- : ,计算量同样为 。
因此,训练中 Attention 二次项的总计算量为:
临界对比分析:
以 LLaMA-3-8B( )为例:- 当 时:
- 参数矩阵乘计算量:
- Attention 二次项计算量:
- 二次项占比: (可作为扰动项修正);
- 当 (32K 长文本)时:
- 二次项占比飙升至: !
惊人事实:在 32K 长度下,Attention 二次项的计算量已经彻底压过了全模型权重矩阵乘!此时必须使用严格公式修正 FLOPs。
- 二次项占比飙升至: !
4.3 MFU(模型算力利用率)vs HFU(硬件算力利用率)
在评估万卡大模型集群的性能时,业内存在两个核心指标:两者的黄金关系:
如果开启了全激活重算,由于实际计算量由 增加到 : 警惕生产陷阱:在汇报性能数据时,有团队谎称自己的“利用率达到了 65%”,实际上他们汇报的是掺杂了全重算算力泡沫的 HFU!真实的行业评测一律以 MFU 为唯一客观铁律。4.4 为什么大厂集群真实 MFU 往往只有 35%~55%?
如果 GPU 算力足够强,为什么工业界顶级集群(如 Meta LLaMA-3、DeepSeek)的真实 MFU 往往只能做到 38% ~ 54%,剩下的 50% 算力到底被什么黑洞吞噬了?- 并行通信气泡(Communication Bubbles):
- 流水线并行(PP)中的 1F1B 调度天然存在 Warmup 和 Cooldown 气泡;
- 张量并行(TP)在每层 Attention 和 FFN 都要做 2 次跨卡
All-Reduce,当多机扩展时,跨节点网络延迟导致 Tensor Core 频繁挂起等待;
- Memory-Bound 访存受限算子的拖累:
- RMSNorm、Softmax、RoPE、SiLU 逐元素操作的算术强度极低,GPU 绝大部分时间被存储墙封锁;
- 数据 Padding 与长短不齐(Workload Imbalance):
- 在同一个 Batch 中,为了对齐最长序列,短文本被补入了大量无效的
<pad>Token,这部分消耗了硬件时钟却无法计入有效 MFU;
- 在同一个 Batch 中,为了对齐最长序列,短文本被补入了大量无效的
- 底层 Kernel Launch 开销与 CPU 调度延迟:
- 数千个细小算子的调度如果未被 CUDA Graph 捕获,CPU 与 GPU 之间的指令流水线会出现微小空隙。
5. 全场景实战:编写工业级容量规划与显存诊断脚本
5.1 实验一:原生 PyTorch 动态激活显存峰值与重算打点测试
本实验通过原生 PyTorch 模拟单层 Transformer 的前向与反向,通过torch.cuda.memory_allocated() 与 max_memory_allocated() 精确打点:
- 观察无重算时的激活值峰值;
- 观察开启 PyTorch 原生
checkpoint后的显存陡降与算力时间开销。
5.2 实验二:工业级全栈容量规划器 cluster_capacity_planner.py
在面对真实的集群规划、选型采买和架构排布时, Infra 工程师需要一套严密的计算引擎。本脚本实现了从任意模型参数手算集群节点配比、ZeRO 静态切分、动态激活值、长文本 KV Cache 与 MFU 倒推的全景规划器:
6. Ringi 避坑指南与生产黄金准则
6.1 7 大常见小白认知误区 vs 大厂 AI Infra 正确物理认知
6.2 生产容量工程黄金 Checklist
- 1. 【静态显存对账闭环】:集群建站前,严格按 校验单卡静态容量,若单卡静态显存超过物理容量的 60%,强制开启 ZeRO-2 或机内张量并行(TP)。
- 2. 【长文本重算三档选型】:序列长度 严禁开全重算; 强制开启基于 FlashAttention 的选择性重算;仅在 且即将 OOM 时降级开启全重算。
- 3. 【PagedAttention 块大小调优】:线上推理服务强制开启 PagedAttention,长文本问答场景推荐 Block Size 设置为 16 或 32,权衡页表检索开销与碎片利用率。
- 4. 【FP8 KV Cache 渐进灰度】:对于 16K 以上的长文本推理服务,推进部署 FP8(E4M3 或 E5M2)KV Cache 量化,直接释放 50% 动态显存并成倍提升 Decode 访存带宽吞吐。
- 5. 【MFU 硬性验收红线】:千卡分布式预训练集群上线前,单步 MFU 必须通过基准验收(A100 SXM 节点 MFU ,H100 SXM 节点 MFU ),未达标禁止开跑正式数据。
- 6. 【预留 15% 碎片安全护城河】:任何容量规划模型中,计算得到的动态 KV Cache 上限必须强制乘以 0.85 的安全系数,坚决不把物理显存吃满到最后一兆字节。
- 7. 【Padding 动态剔除】:训练数据加载管线务必启用
Packing / Sample Multiplexing(将多条短样本拼接为固定长序列),彻底消灭无效<pad>Token 对 FLOPs 的空耗。
7. Ringi 5 点核心速记口诀、自我检验清单与课后深度思考题
7.1 5 点押韵核心速记口诀
7.2 10 条白板自我检验清单
- 能否闭卷推导 AdamW 优化器占用 显存的三个独立组成部分?
- 能否推导为什么混合精度训练不能直接用 BF16 累加梯度更新权重(下溢原理)?
- 能否解释 ZeRO-1、ZeRO-2、ZeRO-3 各自切分了哪些状态,并写出对应的单卡静态显存公式?
- 能否白板推导单层 Transformer 无重算时的激活值显存公式,并指出二次项 的来源?
- 能否说明选择性重算(Selective Recomputation)为什么既能消灭 显存,又几乎不增加计算时间?
- 能否写出单 Token 全模型 KV Cache 显存大小的通用计算公式(含 GQA 分组比参数)?
- 能否解释传统连续内存预分配导致推理显存碎片率高达 60% 以上的两大物理诱因?
- 能否阐明 PagedAttention 的 Block 机制与操作系统虚拟内存页表的设计映射?
- 能否严格手算前向 、反向 、全重算 的矩阵乘累加过程?
- 能否用一句话清晰区分 MFU 与 HFU 的本质差异,并说明为什么全重算会拉大两者差距?
7.3 3 道高阶开放式课后思考题(含极限 Corner Case)
- 【万卡集群下的网络风暴 Corner Case】:在一个由 1024 台 8 卡节点(共 8192 张 H100)组成的超大规模集群中,如果我们完全不采用 Pipeline 并行和 Tensor 并行,而是暴力使用纯 ZeRO-3 全切分跑 70B 模型,底层网络(RDMA / InfiniBand)会面临什么致命瓶颈?网络时延抖动将如何把整机 MFU 拉垮到个位数?
- 【超长上下文推理的 KV Cache 临界翻转】:在 1M(100 万)上下文长度下,哪怕开启了 GQA(1:8)和 FP8 KV Cache,单请求的 KV 缓存体积也将达到惊人的量级。此时一个请求是否可能需要跨节点进行分布式 KV Cache 切分?这会给推理引擎的调度器(Scheduler)带来什么重构挑战?
- 【DeepSeek-V3 的 DualPipe 算力遮蔽神技】:DeepSeek-V3 在极低训练成本下实现了顶尖性能,其核心创新之一是
DualPipe(双向重叠流水线并行)。请从计算与通信重叠(Overlap)的角度分析:它是如何利用前向和反向的不同计算块,将全切分带来昂贵跨节点通信时间几乎 100% 完美隐藏在计算之下的?
8. 📚 参考资料与核心源码/经典论文指引
权威学术论文:
- ZeRO 显存切分奠基:Rajbhandari et al., “ZeRO: Memory Optimizations Toward Training Trillion Parameter Models”, SC 2020. arXiv:1910.02054
- 激活值选择性重算:Korthikanti et al., “Reducing Activation Recomputation in Large Transformer Models”, MLSys 2023. arXiv:2205.05198
- PagedAttention 与 vLLM:Kwon et al., “Efficient Memory Management for Large Language Model Serving with PagedAttention”, SOSP 2023. arXiv:2309.06180
- 混合精度训练理论:Micikevicius et al., “Mixed Precision Training”, ICLR 2018. arXiv:1710.03740
- FlashAttention-2:Dao, “FlashAttention-2: Faster Attention with Better Parallelism and Work Partitioning”, ICLR 2024. arXiv:2307.08691
- DeepSeek-V3 技术报告:DeepSeek-AI, “DeepSeek-V3 Technical Report”, 2024. arXiv:2412.19437
工业级开源源码指引:
- DeepSpeed ZeRO 引擎:
deepspeed/runtime/zero/stage3.py与stage2.py(工业级状态切分与通信原语实现) - Megatron-LM 激活重算实现:
megatron/core/tensor_parallel/cross_entropy.py与megatron/core/transformer/ - vLLM PagedAttention 内核:
csrc/attention/attention_kernels.cu(核心虚拟分页 CUDA Kernel)
本地 AI_BOOK 知识库精准映射:
- 训练显存分析:05TrainingMemory.md
- 推理显存与 KV:06InferenceMemory.md
- MFU 与算力评估:CODE03MFU.md
- ZeRO 原理与实战:Code01ZeRO.md
附录:Appendix A — 大厂硬核高频面试题与白板推导(Interview Drill)
面试真题 1:千卡集群训练 70B 模型,如果不开启张量并行(TP),仅使用纯数据并行 + ZeRO-3,单卡至少需要多大显存?网络通信量会暴涨多少?
考察维度:分布式切分边界、网络通信量手算、大规模集群拓扑常识。
标准推导路径:
- 单卡显存手算:
- 70B 稠密模型全量静态显存为 ;
- 在 1024 张 GPU 下,采用纯 ZeRO-3 全切分:
- 动态激活值(若使用选择性重算,设单卡 Batch=2, Seq=4096):约占 4.5 GB;
- 临时通信缓冲区与框架开销:约 3.5 GB;
- 单卡总显存开销: !
- 结论 1:纯从显存容量来看,单卡仅需不足 10 GB,哪怕用 24GB 的老旧显卡都能塞下!
- 通信量暴涨分析(致命死局):
- 在标准 DDP / ZeRO-1 中,通信仅在反向传播结束时发生 1 次权重梯度的
All-Reduce,总通信量为 ; - 在 ZeRO-3 中:
- 在标准 DDP / ZeRO-1 中,通信仅在反向传播结束时发生 1 次权重梯度的
- 前向传播:每一层计算前,必须通过
All-Gather动态从其他卡收集该层参数,前向完毕立刻释放,通信量为 ; - 反向传播:每一层反向求导前,必须再次通过
All-Gather重新收集一次该层参数,通信量为 ; - 梯度同步:计算完梯度后,通过
Reduce-Scatter将梯度分片规约并回写到对应的拥有卡,通信量为 ;
- ZeRO-3 总通信量: !
- 结论 2:通信量从 飙升到 (净增加 50%)!更致命的是,在千卡规模下,原本可以在机内 NVLink 解决的通信被迫泛滥到跨机低速网络中,千卡同时频繁执行跨节点 AllGather,网络交换机瞬间发生严重拥塞与排队丢包,导致整机 MFU 出现断崖式暴跌(可能不足 15%)。这就是为什么生产环境必须强制机内 TP=8 + 机间 ZeRO 的根本原因!
面试真题 2:在 8 卡 H100 集群上做 32K 超长上下文推理,为什么开启 FP8 KV Cache 比把模型权重做 INT4 量化对系统吞吐提升更显著?
考察维度:Roofline 瓶颈定位、Decode 阶段访存特征、量化收益归因。
标准参考答案:
- 瓶颈定位: 在 32K 长文本自回归生成(Decode)阶段,系统处于极端恶劣的 Memory-Bound(访存受限) 状态,算术强度极低,每个 Token 生成的延迟严格取决于:
- 数据量对比 hand-calculation:
以 70B 模型、并发 Batch=16、上下文平均 (32,768)为例:
- 权重读取量(每次生成 1 个 Token 固定发生):
- BF16 权重:
- INT4 量化权重: (节省了 105 GB 访存);
- KV Cache 读取量(随序列激增):
- 单 Token GQA KV Cache 约 320 KB;
- 并发 16 下,32K 长度的瞬时全量 KV Cache 为:
- 开启 FP8 KV Cache 后,每个元素从 2 字节降至 1 字节:
- INT4 权重虽然压缩了模型,但无法解决 KV Cache 吞噬显存的死局,最大并发数被死死卡在低水位;
- 而 FP8 KV Cache 不仅将庞大的 KV 访存量砍半,更直接将单卡可承载的最大并发容量翻了整整 2 倍!
- 并发翻倍意味着 GPU 能够在每个 Step 内并行服务更多的用户请求,端到端吞吐量(Tokens/s)直接实现翻倍跃迁。因此在长文本场景下,优化 KV Cache 永远享有第一优先级。
面试真题 3:请白板手算在单台 8 卡 A100-80GB 服务器上,训练一个 13B 稠密模型( ),在 Batch=16、SeqLen=2048 时,无重算与选择性重算下的激活值显存差值。
考察维度:激活值精确推导、二次项敏感度评估、工程直觉。
标准推导路径:
- 提取核心参数:
- 层数
- 维度
- 头数
- 批大小
- 序列长度
- 计算单层线性项与二次项系数:
- 单层线性项(Linear Part):
- 单层 Attention 二次项(Quadratic Part):
- 计算全模型(40 层)总和:
- 无重算模式(保留线性项 + 二次项):
- 选择性重算模式(抹除二次项,仅保留线性项):
- 得出差值与结论: