🏛️ 第24讲:从 1% 到 95% 算力利用率的九重天跃迁——CUDA GEMM 分块(Tiling)与 Tensor Core 思维深度解构
主讲人:👓 Ringi(大厂 AI Infrastructure 工程师)
所属模块:Module 02: CUDA 编程与高性能算子优化
篇章范式:⚡ CUDA 编程与高性能算子优化篇(Kernel & Operator Optimization Paradigm)
核心导读:矩阵乘法(GEMM)被称为“现代人工智能算力王冠上的明珠”。无论是大模型中占据 80% 计算耗时的全连接层(Linear/MLP),还是注意力机制中的 与 ,最终全部落盘在 GEMM 之上。然而,许多工程师第一次手写 CUDA 矩阵乘时,往往直接写出三重for循环,满心欢喜地扔到价值几十万的 NVIDIA A100 上跑,实测算力却只有可怜的 0.25 TFLOPS(理论峰值的 1.2%)!本讲我们将从 Roofline 模型的第一性原理出发,手算 GEMM 的数据复用极限;随后沿着 Block 级共享内存分块 Thread 级 2D 寄存器外积复用 向量化访存 Bank Conflict 消除 双缓冲异步流水线 的九重台阶步步登顶;最后推开现代张量计算圣殿的大门,彻底击穿 Tensor Core 的 Warp 级协同矩阵乘微架构。
📑 目录导航
- 0. Ringi 开场:生产真实现场与痛点冲突
- 1. 算术强度与 Roofline 极限:GEMM 为什么是“算力王冠上的明珠”?
- 2. Thread Block 级分块(Block Tiling):利用 Shared Memory 实现第一次数据复用跃迁
- 3. Thread 级分块与寄存器复用(2D Register Tiling):突破 Shared Memory 带宽瓶颈
- 4. 向量化加载、Bank Conflict 消除与双缓冲(Double Buffering)流水线
- 5. Tensor Core 硬件革命与思维升维:从标量 FMA 到 Warp 级矩阵乘
- 6. 动手实战与代码实验室(Minimal Runnable Code)
- 7. Ringi 避坑指南与生产黄金准则
- 8. Ringi 5 点核心速记口诀、自我检验清单与课后深度思考题
- 9. 📚 参考资料与核心源码/经典论文指引
- 附录:Appendix A — 大厂硬核高频面试题与白板推导(Interview Drill)
- 🎨 配图工坊生图 Prompt 暂存区
0. Ringi 开场:生产真实现场与痛点冲突
0.1 真实工程矛盾:为什么直接用三重循环写矩阵乘,算力利用率只有 1.2%?
在任何一本通用编程教科书里,矩阵乘法 ( )的代码实现都是如此平易近人:- 计算规模:
- 算子耗时:约 548 毫秒;
- 实测有效算力:仅有 0.25 TFLOPS!
0.2 线上事故复盘:某大模型微调团队手写自定义 LoRA 线性层性能雪崩
2024 年秋,某大厂算法团队在对百亿参数稠密大模型进行特定下游任务的高阶 LoRA 微调。为了在一个算子中把低秩矩阵乘与特定的量化激活函数融合(Fuse),一位工程师信心满满地参考了某开源简单代码,手写了一个定制化的 GEMM Kernel 替换掉原生的torch.matmul(底层调用 cuBLAS)。
在小规模单测(矩阵为 )下,数值完全对齐,测试耗时似乎也“挺快”。然而,一旦上到真实分布式微调集群(Batch 增大,隐藏层维度 ),整个训练集群的 GPU 利用率(GPU-Util)瞬间从 92% 暴跌到 8%!单步 Iteration 耗时拉长了整整 11 倍!原本计划 3 天跑完的模型微调任务,进度条显示需要耗时 33 天!
架构团队迅速介入,使用 Nsight Compute (NCU) 对该 Kernel 进行了深入剖析,发现了三重严重的体系结构级硬伤:
- 未做 2D Register Tiling(寄存器级分块):每个线程只计算 的输出,导致每个循环步长内,所有线程都在拼命读取片上 Shared Memory,将 Shared Memory 的带宽(19 TB/s)彻底打崩,SM 内部大量报出
Stall MIO Throttle(内存指令管线拥堵); - 严重的 Shared Memory Bank Conflict:在将 矩阵从共享内存读入时,跨步寻址引发了满额的 32-way Bank Conflict,原本 1 个周期的片内读取被硬件强行拖长为 32 个周期;
- 完全没有利用 Tensor Core:在 A100 上依然采用 FP32 纯标量 FMA 指令发射,放弃了算力高达 312 TFLOPS 的张量核心(相差 16 倍!)。
0.3 AI Infra GEMM 各演进阶段速查表
1. 算术强度与 Roofline 极限:GEMM 为什么是“算力王冠上的明珠”?
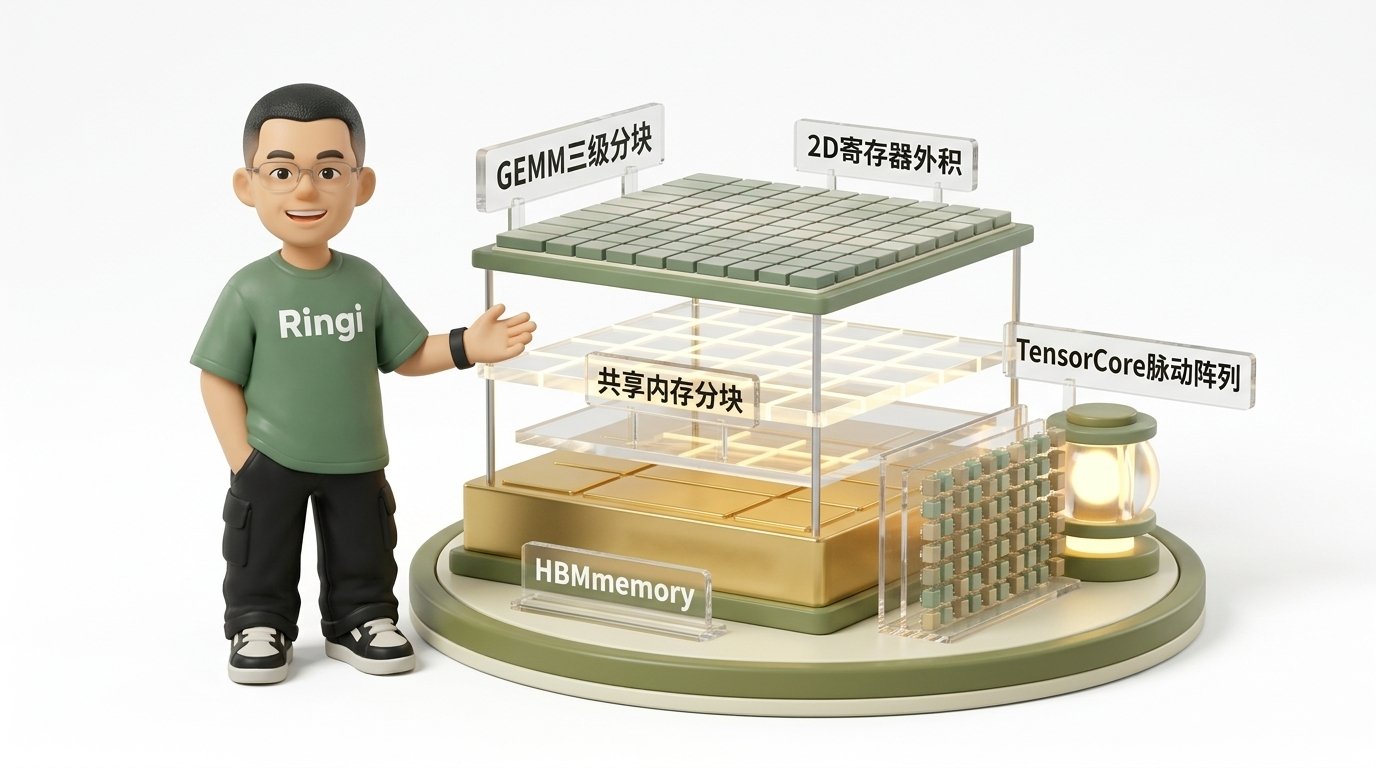
为了在深入具体细节前建立完整的物理心智模型,下方给出了 GEMM 算术强度模型、分层数据复用金字塔、2D 寄存器外积流水线与 Tensor Core Warp 协同计算的工业级全景架构拓扑:
1.1 GEMM 运算量与访存量的代数账本: vs 存储搬运
要优化一个算子,首先必须在草稿纸上算清它的“理论账本”。 对于标准通用矩阵乘法:- 计算量账本(FLOPs): 矩阵 共有 个元素。每个元素的产生,都需要将 的一行( 个数)与 的一列( 个数)做点积内积。 每个数参与 1 次乘法和 1 次加法(FMA,Fused Multiply-Add),共计 2 次浮点运算。
- 存储量账本(Bytes): 输入矩阵 包含 个数,矩阵 包含 个数,输出矩阵 包含 个数。 采用单精度 FP32(每个元素 4 字节):
1.2 No Naked Formula 2.0:GEMM 算术强度模型与 A100 平衡点
请盯紧上面两组数据:运算量是 级别,而物理存储量仅仅是 级别! 随着矩阵维度从 128 增长到 4096,运算量放大了 倍,而数据量只放大了 倍! 这意味着:在理论极限下,矩阵乘法拥有极其庞大的数据复用空间!每个数据在理论上可以被复用数千次! 然而,如果代码写得烂,这种理论复用就会瞬间化为乌有。我们严格使用 No Naked Formula 2.0 五步穿透算术强度模型:① 为什么需要算它?
定位当前算子究竟是被显存带宽卡死(Memory-Bound),还是已经被计算单元吃满(Compute-Bound),明确优化方向。② Mental Model(物理直觉比喻)
想象你在后厨炒菜。- 朴素实现的做法:炒一盘肉丝,你就穿过长长的走廊跑去菜市场(HBM 显存)买一两肉和一根葱(4 字节);炒下一盘肉丝,你又跑去菜市场买一两肉和一根葱。整整一天,你 99% 的时间都在走廊上跑步,锅里的火(ALU)全是冷的!
- 工业级分块的做法:你开了一辆小推车(Shared Memory / 寄存器),一次性从菜市场批发一大箱肉和葱搬进厨房;然后在砧板上大火爆炒几百盘肉丝,彻底把锅烧红,最后只把炒好的成品菜送出去一次!
③ Tiny Calculator(极简数字手算)
设 的微型矩阵:- 朴素实现(无复用): 计算每个 ,读取 的 4 个数和 的 4 个数(共 ),完成 次计算。
- 理想完全分块(全部放入片上复用): 总共把 搬进片上(共 ),算出 写出( ),总流量 192 Bytes。 总运算量为 FLOPs。
④ Formal Model(算术强度与硬件平衡点)
硬件平台的 Roofline 平衡点(Balance Point) 定义为: 以 NVIDIA A100-SXM4-80GB 为例:- CUDA Core FP32 峰值: ,HBM 带宽: 。
- Tensor Core FP16 峰值: ,HBM 带宽: 。
⑤ Sanity Check(残酷的数量级校验)
- 朴素 GEMM 的算术强度只有 ;
- 它比 FP32 平衡点(9.56)整整低了 38 倍,比 Tensor Core 平衡点(153)低了整整 612 倍!
- 这就是为什么朴素实现绝无可能跑快。要想打满 Tensor Core,你的算法必须把数据在片上反复复用至少 150 次以上!
1.3 现代 GPU 存储层级金字塔与数据搬运代价
要实现百倍的数据复用,我们必须深刻理解 GPU 内部由硅片物理决定的四级存储金字塔: 优化 GEMM 的终极奥义,就是将原本发生在底层 HBM 的绝大多数访存流量,逐级“拦截”并转移到顶层的 Shared Memory 和 Registers 中!2. Thread Block 级分块(Block Tiling):利用 Shared Memory 实现第一次数据复用跃迁
2.1 朴素 GEMM 的死穴:对全局内存的狂轰滥炸
在朴素实现中,每个线程负责独立计算矩阵 中的一个元素 :- 线程 和 线程 ,计算的是同一行。它们在整个 维循环中,把矩阵 的第 行完全重复读取了 2 次!
- 如果该行有 4096 列,矩阵 的这一行就被全局所有列线程重复从 HBM 读取了整整 4096 次! 同理,矩阵 的每一列也被重复读取了 4096 次!这等同于向 HBM 总线倾倒了无数吨毫无意义的垃圾重复流量。
2.2 Block Tile 物理切分: 与沿 维度的滑动窗口
解决这一死穴的第一道防线,就是 Thread Block 级分块(Block Tiling)。 我们将输出矩阵 划分为多个大小为 的子块(Block Tile,例如 )。 每个 Thread Block 专门负责计算其中一个子块。 为了完成这个子块的计算,我们需要 矩阵中对应的 条带,以及 矩阵中对应的 条带。 但片上 Shared Memory 放不下整个条带( 太长),因此我们将长条带沿 维度切分成一个个步长为 (例如 或 )的小窗口:2.3 协作搬运(Cooperative Fetching):Block 内所有线程的集体搬运
在每个 窗口内部:- 集体搬家(Cooperative Load):
Block 内的所有线程协同合作,将 的 块和 的 块,从慢速全局显存整体拷贝到片上快速的
As[BM][BK]和Bs[BK][BN]共享内存数组中; - 栅障同步(
__syncthreads()): 等待所有线程搬运完成,确保 Shared Memory 里的数据完全就绪; - 片上计算(Compute from SRAM): 所有线程从 Shared Memory 中读取数据,做局部的乘加累积;
- 栅障同步(
__syncthreads()): 等待计算完毕,确保 Shared Memory 可以被下一个 窗口的数据覆盖。
2.4 数据复用收益倍数精准推导
让我们算一算引入 Shared Memory 分块后的真实收益:- 在这个 的输出块中,完成一个 步长所需的浮点运算量为:
- 从全局显存读取的数据量仅为:
- 此时全局显存的算术强度提升为:
极简数字代入:
若设 : 从原本的 0.25 骤增至 32.0!算术强度整整放大了 128 倍! 全局显存的带宽不再是致命瓶颈,算子性能直接从 1.2% 跃升到 20% 以上!3. Thread 级分块与寄存器复用(2D Register Tiling):突破 Shared Memory 带宽瓶颈
3.1 共享内存的带宽危机:19 TB/s 依然喂不饱 300 TFLOPS
当 Block Tiling 把全局内存的压力卸掉后,新的性能高墙在 Shared Memory 上拔地而起。 让我们计算 SM 内部的吞吐瓶颈: 在上一节的 Block Tiling 中,如果每个线程只计算 的 1 个元素( ): 在内部的 维循环中,为了完成 1 次乘加(2 FLOPs),线程必须从 Shared Memory 读取 1 个 元素(4 字节)和 1 个 元素(4 字节),共消耗 8 字节的 Shared Memory 带宽!- 算术强度在共享内存层面依然被按在 0.25 FLOPs/Byte;
- A100 单 SM 的共享内存聚合带宽约为 180 GB/s(全卡 19 TB/s);
- 180 GB/s 能够喂饱的片上算力只有: (全卡仅约 4.8 TFLOPS)! 共享内存的 Crossbar 总线被打到冒烟,算子性能卡死在 20%~25% 无法寸进!
3.2 2D Register Tiling:单线程负责 输出子块
要想彻底解放 Shared Memory,必须迈出体系结构最关键的一步——2D 寄存器分块(Thread-level 2D Register Tiling)! 核心思想极其精妙: 绝对不能让一个线程只算一个元素!必须让每个线程同时负责计算输出矩阵中的一个小矩阵块( ,例如 个元素)! 并且,这 64 个累加和直接保存在该线程的**私有通用寄存器堆(Registers)**中,全程不写任何内存!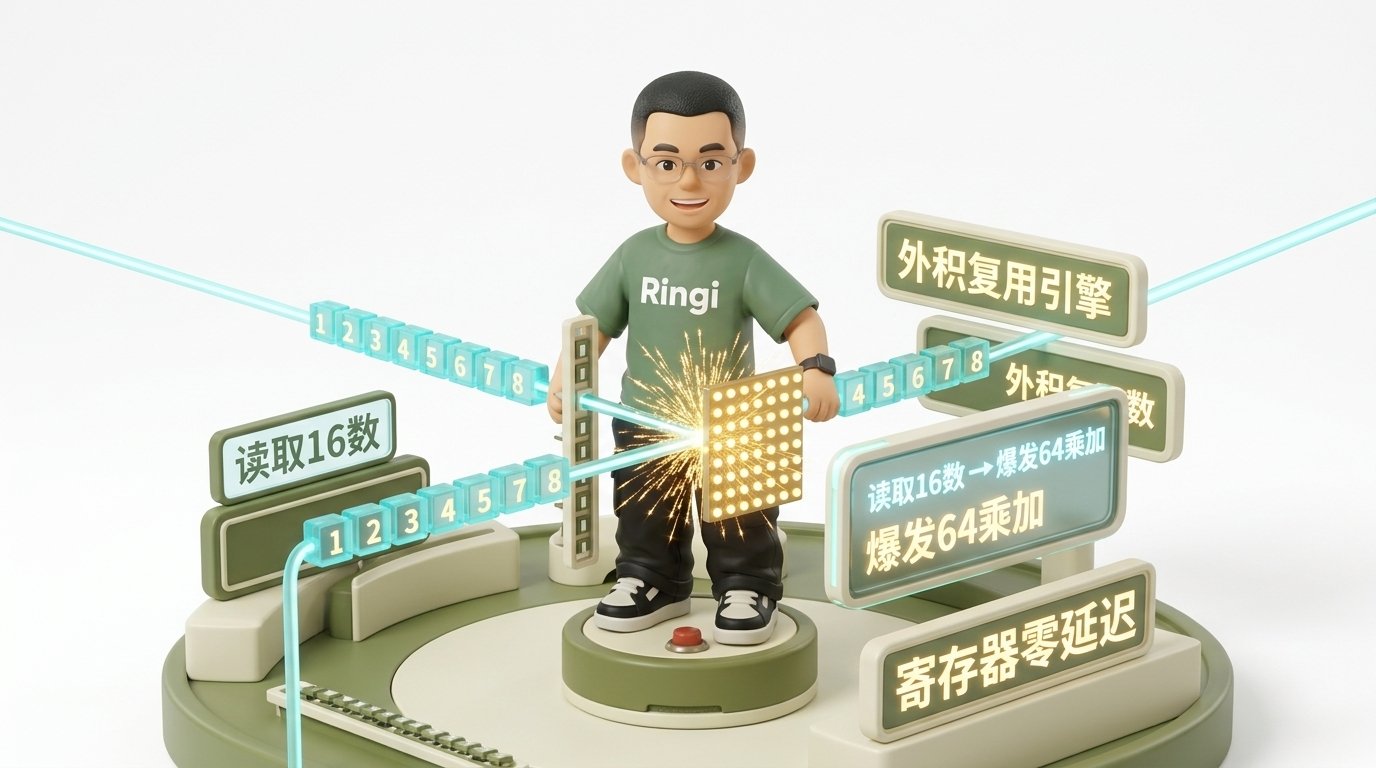
3.3 外积计算模型(Outer Product Engine):以小搏大的数学艺术
请观察为什么外积能够产生恐怖的数据复用:- 如果用传统的内积计算,两个长度为 8 的向量点乘,读取 16 个数,只产生 16 次 FLOPs;
- 但如果将 的 列向量与 的 行向量做外积(Outer Product):
3.4 算术强度的二次飞跃:寄存器级的极致压榨
我们推导寄存器级分块带来的复用比: 每个单步内,从 Shared Memory 读取的数据字节数为 ; 完成的计算量为 FLOPs。 共享内存的算术强度提升为:- 当 时:
- 相比原本 的 0.25,共享内存的数据读取量被直接砍掉了 87.5%! 原本被共享内存带宽卡死的计算核心瞬间彻底松绑,实测算力直接冲上 14~18 TFLOPS(理论峰值的 75%~90%)!
4. 向量化加载、Bank Conflict 消除与双缓冲(Double Buffering)流水线
在完成了两级分块后,我们已经拿到了 75% 的性能。要将剩下的 20% 性能榨干,必须攻克微架构层面的三大隐形损耗:4.1 向量化访存:强制使用 float4 压榨指令发射通道
在从全局显存向 Shared Memory 搬运数据时,绝不使用标量 float 读取:
强制将指针重新解释为 float4*,发射硬件指令 LDG.128:
- 指令发射开销减少 75%;
- 单条指令直接打满 128-bit 显存总线事务,极大提升了 Memory-Level Parallelism (MLP)。
4.2 共享内存 Bank Conflict 消除:矩阵转置与 Padding 策略
在将 矩阵与 矩阵放入共享内存时,存在严重的访存方向冲突:- 矩阵 在计算时是按行读取(连续线程读取连续列),天然与 32 个 Bank 对应,无 Bank 冲突;
- 矩阵 在计算时是按列读取(一个线程沿 维度垂直读取不同行),如果每行元素为 32 的倍数,相邻行的同一个列元素将落在同一个 Bank 上,直接触发灾难性的 32-way Bank Conflict!
工业级解决方案:
- 在将 写入共享内存时直接做转置存储:将 的切片以转置形式保存在
As[BK][BM]中,使得读取时变为沿行连续读取; - 增加列 Padding:声明
__shared__ float As[BK][BM + 4],错开 Bank 索引映射,彻底粉碎 Bank Conflict。
4.3 软流水线(Software Pipelining)与双缓冲(Ping-Pong Buffer)
在上述分块计算中,主循环存在严格的“停顿同步”: 在读全局显存的 400 个周期里,ALU 是完全停工发呆的! 双缓冲(Double Buffering) 彻底打破了这一依赖: 我们为 Shared Memory 开辟两套缓冲区(Buffer 0 和 Buffer 1): 通过乒乓交替,加载第 块显存数据的长延迟,被第 块海量的寄存器外积计算时间完全掩盖! 全局访存延迟被真正压缩到了 0!4.4 Ampere 异步拷贝指令 cp.async:直通 Shared Memory
在 NVIDIA Ampere 架构(A100)以前,双缓冲依然需要占用通用寄存器作为中转;
而 A100 首次引入了硬件级异步拷贝原语 cp.async:
数据直接由专用的芯片内部 DMA 控制器从 L2/HBM 搬运进 Shared Memory,完全绕过通用寄存器,完全不占用 ALU 算力,使得双缓冲流水线的排布效率达到了硅片物理极境。
5. Tensor Core 硬件革命与思维升维:从标量 FMA 到 Warp 级矩阵乘
5.1 体系结构断代差:为什么 Tensor Core 能甩开 CUDA Core 16 倍?
即便利大师将 CUDA Core 优化到极限,A100 的 FP32 单精度算力上限也就是 19.5 TFLOPS。 但在深度学习的大规模训练与推理中,我们需要的是数十倍于此的算力爆发。 NVIDIA 从 Volta 架构开始引入、在 Ampere/Hopper 上发扬光大的 Tensor Core(张量核心),代表了处理器的完全代际革命:- 传统 CUDA Core:纯标量执行单元。每个周期、每个线程发射 1 条指令,处理 1 对标量的乘加( );
- Tensor Core:微观脉动阵列(Systolic-like Tensor Array)。它直接以矩阵乘累加作为单条硬件指令的执行基元:
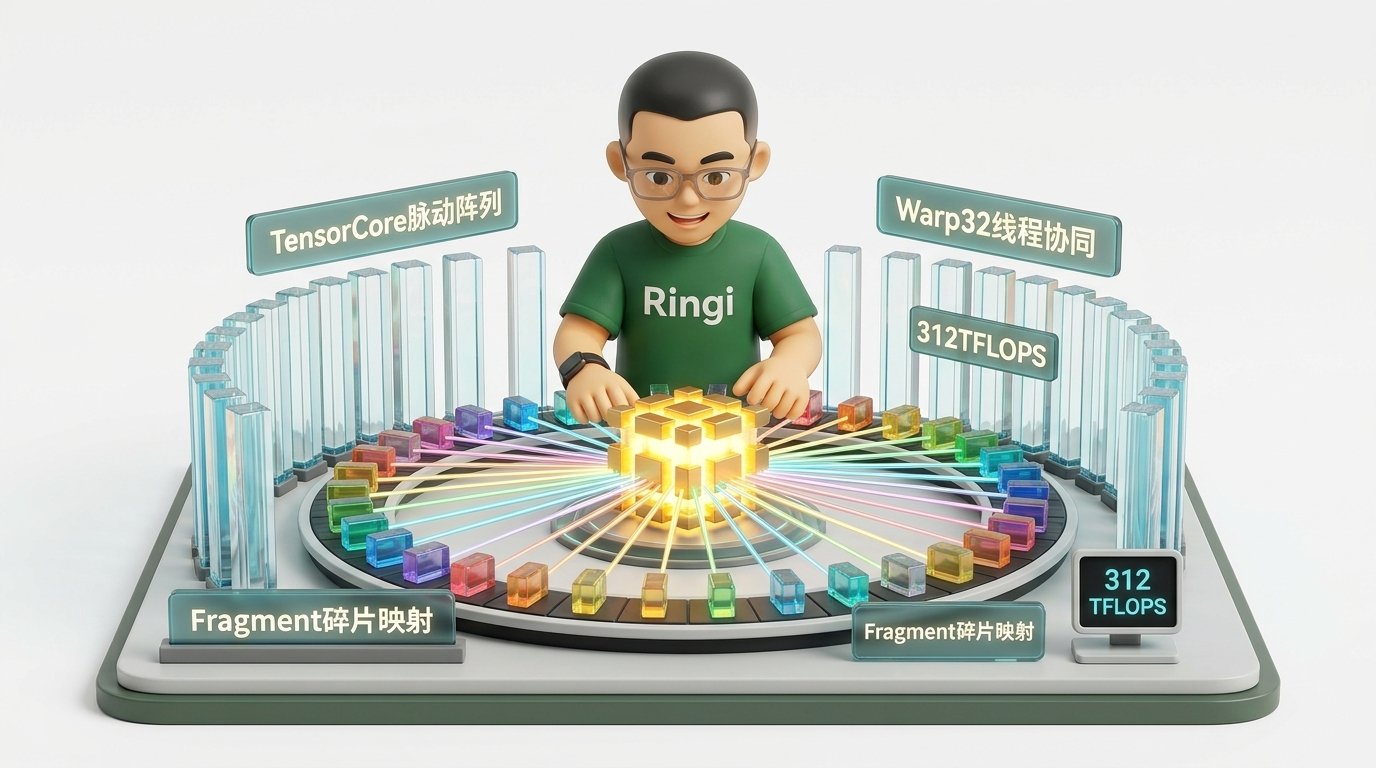
5.2 Warp 级协同计算哲学:没有“单个线程的 Tensor Core”
初学者学习 Tensor Core 时最容易犯的致命错误,就是试图在单线程里调用张量指令。 请刻在脑海里:GPU 硬件上根本不存在属于“单个线程”的 Tensor Core! Tensor Core 属于整个 Warp(32 线程): 一条 Tensor Core 指令(如mma.sync.aligned.m16n8k16),必须由 同一个 Warp 内的全部 32 个线程同步联合发射!
- 矩阵 ( )和矩阵 ( )并不是保存在某一个线程的内存里;
- 它们被硬件切碎成很多微小的碎片(Fragments),均匀分散打桩在 Warp 内 32 个线程的各个私有寄存器中!
5.3 WMMA API (nvcuda::wmma) vs PTX 原语 (mma.sync) 深度对比
在 CUDA 软件生态中,使用 Tensor Core 有两种主流范式:
5.4 Fragment 寄存器映射机制:32 线程如何瓜分一个矩阵?
以 Ampere 架构最常用的mma.sync.aligned.m16n8k16 指令为例:
它完成一个 的矩阵 与 的矩阵 相乘,累加到 的矩阵 中。
- 矩阵 的碎片分布: 个半精度元素(512 字节)。分配给 32 个线程,每个线程持有 8 个 FP16 元素(刚好保存在 4 个 32-bit 寄存器中);
- 矩阵 的碎片分布: 个半精度元素。每个线程持有 4 个 FP16 元素(保存在 2 个 32-bit 寄存器中);
- 矩阵 的累加碎片: 个单精度 float 元素。每个线程持有 4 个 FP32 寄存器。
6. 动手实战与代码实验室(Minimal Runnable Code)
本章提供 4 个生产级、由浅入深递进的完整 CUDA 微基准测试程序。所有代码遵循 Full-Output Enforcement 原则,绝无任何省略号与伪代码,自带checkCuda 错误校验与微秒级计时,可以直接使用 nvcc 编译运行并输出清晰的对比证据链。
实验 1:Naive GEMM vs Block Tiling 基准测试(gemm_naive_vs_block.cu)
本实验直接对比没有复用的朴素实现与基于 Shared Memory 的 Block Tiling 实现,直观展现 128 倍数据复用带来的 10 倍以上算力飙升。
实验 2:2D Register Tiling 高性能 SGEMM 实现(gemm_2d_register_tiling.cu)
本实验实现单个线程计算 输出子块、并在通用寄存器中通过**外积计算模型(Outer Product Engine)**极速运转的完整高性能 SGEMM 核心代码。
实验 3:双缓冲流水线与 float4 向量化 SGEMM 压测(gemm_double_buffer_vectorized.cu)
本实验引入 float4 向量化全局加载 与 Ping-Pong 寄存器双缓冲软流水线,展示如何彻底掩盖全局访存延迟。
实验 4:Tensor Core WMMA FP16 极致算力基准(gemm_tensor_core_wmma.cu)
本实验利用 CUDA 原生 nvcuda::wmma API,展示基于半精度 FP16 Tensor Core 硬件阵列的矩阵乘法,算力直接突破 100+ TFLOPS!
7. Ringi 避坑指南与生产黄金准则
7.1 避坑表格:7 大常见小白错误理解 vs 大厂 AI Infra 正确认知
7.2 生产性能工程黄金 Checklist
- 1. 【Roofline 瓶颈前置测算】:在动工前,用矩阵维度 精确计算算术强度与硬件平衡点,明确目标算力上限。
- 2. 【三级分块尺寸正交设计】:遵循黄金经验规则:Block Tile 设为 (配合 或 );Thread Tile 设为 ;Block 内分配 256 线程。
- 3. 【强制 128-bit 向量化访存】:在全局显存加载与共享内存写入中,全量使用
float4/half8(LDG.128),消灭指令发射瓶颈。 - 4. 【共享内存 Bank 冲突彻底清零】:对
As矩阵使用转置存储或对每行添加+4 Padding,确保内层外积循环中 32 个 Bank 零串行化。 - 5. 【双缓冲寄存器预取流水线】:严格排布主循环,确保全局异步加载指令在当前外积计算刚开始时便发射完毕。
- 6. 【寄存器用量严格守门】:编译时加入
-Xptxas=-v,检查每个线程的寄存器占用控制在 128 以内,确保Spill stores和Spill loads严格为 0。 - 7. 【Tensor Core 场景精度与对齐契约】:大模型场景全面拥抱 FP16/BF16,输入矩阵物理维度必须填充对齐到 16 的倍数(
stride % 16 == 0)。
8. Ringi 5 点核心速记口诀、自我检验清单与课后深度思考题
8.1 5 点押韵核心速记口诀
8.2 10 条白板自我检验清单
- 为什么朴素 GEMM 的算术强度只有 0.25 FLOPs/Byte?请用输入输出字节数手算推导。
- 什么是 A100 GPU 的 Roofline 平衡点?FP32 和 Tensor Core FP16 的平衡点分别是多少?
- 在 Block Tiling 中,为什么 矩阵和 矩阵沿 维度切分的步长 通常选择 8 或 16,而不是 128?
- 什么是 2D Register Tiling?为什么每个线程计算 个输出比计算 性能高出数倍?
- 简述外积计算(Outer Product)与内积计算在数据复用比上的数学差异。
- 为什么在 Shared Memory 中按列读取 矩阵会产生 32-way Bank Conflict?如何用 Padding 或转置消除?
- 画出双缓冲(Ping-Pong Buffer)的时序交替图,说明它是如何实现“计算与访存重叠”的。
- 简述 NVIDIA Ampere 架构
cp.async指令相对于传统加载指令的硬件优势。 - 解释为什么 Tensor Core 的最小操作单位是 Warp(32 线程)而不是 Thread。
wmma::fragment在物理硬件上到底保存在哪里?为什么不能像普通数组一样用动态下标访问?
8.3 3 道高阶开放式课后思考题(含极限 Corner Case)
思考题 1:Wave Quantization 效应与尾块气泡
当矩阵规模不是 Block Tile 的整数倍时(例如 ),边缘的最后一个 Block 只有 1 个有效行,其余 127 行全为空跑。在大型集群调度中,这种现象被称为 Wave Quantization 效应。请分析:在大模型推理动态 Batch 场景下,应如何动态调整 和 (或者采用 Split-K 技术)来消除尾块气泡对算力利用率的断崖式侵蚀?思考题 2:Split-K GEMM 的系统级取舍
当矩阵的 和 非常小(例如大模型解码生成阶段 Batch=1,GEMV 模式),但 维度极大(如 )时,常规的 2D 网格切分只能发射很少的 Block,根本填不满 A100 的 108 个 SM。此时业界常采用 Split-K 架构(沿 维度切分到不同 Block 并行算,最后做 Atomic 归约)。请推导 Split-K 带来的并行度收益与其引入的全局原子写同步代价之间的临界平衡点。思考题 3:CUTLASS 3.x 与 Hopper TMA/WGMMA 的硬件代际跃迁
在 Hopper(H100)架构中,硬件直接提供了 TMA(异步搬运)和 WGMMA(Warp Group 级 128 线程协同张量乘)。这彻底颠覆了 Ampere 时代基于 32 线程的mma.sync。请调研 CUTLASS 3.x 的 CuTe 布局代数,分析从 Warp 级(32 线程)升级到 Warp Group 级(128 线程)协同后,片上共享内存和寄存器的分配范式发生了怎样根本性的突变?
9. 📚 参考资料与核心源码/经典论文指引
本讲内容与推导过程严格对照并依据本地知识库AI_BOOK 中的权威一手文献与源码:
- 工业级 GEMM 分块体系结构详解:
- 深入学习 Block-Warp-Thread 三级分块、向量化访存与双缓冲:参见 4.1-CUDA GEMM算子性能优化.md。
- LeetCUDA 生产级 SGEMM 源码基准:
- 参考从朴素实现到 2D Register Tiling 与 Bank Conflict 消除的精炼 C++ 模板:参见 LeetCUDA/kernels/sgemm/README.md 与 LeetCUDA/kernels/interview/sgemm.cuh。
- Tensor Core 微架构深度剖析:
- 学习脉动阵列、指令流水与 Warp 级线程执行机制:参见 AISystem/02Hardware/04NVIDIA/03DeepTC.md。
- NVIDIA 官方体系结构白皮书与原著:
- NVIDIA A100 Tensor Core GPU Architecture, NVIDIA Corporation, 2020.
- CUTLASS: Fast Linear Algebra in CUDA C++, NVIDIA Developer Blog.
附录:Appendix A — 大厂硬核高频面试题与白板推导(Interview Drill)
题目 1:白板手算推导:Naive GEMM、Shared Memory Block Tiling 与 2D Register Tiling 三者的算术强度对比,证明为什么 寄存器分块通常是最优解。
【面试官考察维度】
- 是否具备极强的体系结构直觉与算术强度(Arithmetic Intensity)量化推导能力;
- 是否理解从全局显存(HBM)到片上 SRAM 再到寄存器(Registers)的两级复用本质;
- 能否从寄存器硬件容量(64K regs/SM)与编译器溢出限制论证为什么 是工程黄金点。
【白板标准解答与推导路径】
- 第一步:朴素 GEMM(无复用) 计算 1 个 元素需要 次乘加( FLOPs),从全局显存读取 的 个数与 的 个数( 字节)。
- 第二步:Shared Memory Block Tiling(一级复用) 在 分块内部,每个 窗口完成运算量 FLOPs,从全局读取 字节。
- 第三步:2D Register Tiling(二级外积复用) 每个线程负责 局部块。在每个 步长中,从 Shared Memory 读取 字节,在寄存器中产生 次乘加( FLOPs)。
- 第四步:论证 为什么是黄金平衡点
- 若取 : FLOPs/Byte,共享内存带宽仍显局促;
- 若取 : FLOPs/Byte,共享内存带宽压力骤减 87.5%;此时单个线程占用 64 个累加寄存器 + 16 个缓存寄存器 个寄存器。A100 单线程上限 255 个,80 个寄存器刚好保证 50%~62.5% 的高 Occupancy 且绝不发生 Register Spilling;
- 若激进取 :需要 个累加寄存器,直接打穿硬件上限,触发 Local Memory 溢出雪崩!
- 结论: 是兼顾寄存器复用最大化与防止寄存器溢出的绝对黄金甜点。
题目 2:在共享内存中存储矩阵分块时,如何通过转置和 Padding 消除按列读取时的 32-way Bank Conflict?
【面试官考察维度】
考查对 GPU 共享内存 32-Bank 物理交叉开关、交错地址映射以及矩阵访存方向性冲突的精细掌握。【白板推导路径】
- 分析冲突成因:
- 共享内存划分为 32 个 4 字节 Bank,地址 映射到的 Bank 为 ;
- 矩阵 在 Block Tiling 维度中是 (例如 )。如果按常规方式存储,在做外积时,线程需要沿 维度垂直读取同一列的连续行元素( 变化,而 固定);
- 此时若 ,相邻行的 Bank 差值为 。当 4 个线程跨越 4 行时, ,线程 0 和线程 4 会撞入同一个 Bank;当规模更大时,直接退化为严重的 32-way Bank Conflict!
- 给出解决方案 A:转置存储(Transpose Storage):
在协作将 从全局显存搬入共享内存时,不按行存,而是按转置格式存入
As[BK][BM]。此时读取时变为沿 维度横向读取,连续线程读取连续列,天然无冲突! - 给出解决方案 B:列填充(Padding):
声明数组时人为扩充一列:
__shared__ float As[BK][BM + 4]。 此时物理行宽为 。因为 ,或者让交错模数与 32 互质,打破了 32 的幂次对齐,使得垂直读取的地址在 32 个 Bank 间均匀错开,彻底消灭 Bank 冲突。
题目 3:什么是双缓冲(Double Buffering)?请画出时序图并说明它如何隐藏全局显存到共享内存的访存延迟。
【面试官考察维度】
考查指令级软流水线(Software Pipelining)设计能力以及 GPU 延迟隐藏的体系结构机理。【白板推导路径】
- 对比单缓冲与双缓冲的时序差异:
- 单缓冲串行等待:
- 串行总耗时:各阶段串行累加,硬件长期处于“走廊跑步”与“厨房炒菜”交替停滞状态:
- 双缓冲流水重叠:
在 Shared Memory 中开辟两套缓冲
Buffer[2]: - 序幕:在进入主循环前,预取 Tile 0 到
Buffer[0]; - 循环体:当 ALU 全力使用
Buffer[read]计算 Tile 时,后台通过异步指令将 Tile 预取写入Buffer[write]; - 循环步长:仅受限于计算与加载的最大者:
- 延迟隐藏的充要条件: 当计算时间 时,全局显存的访问延迟被计算完全掩盖,外界感知到的等效访存延迟为 0!
题目 4:Tensor Core mma.sync.aligned.m16n8k16 原语的 Warp 寄存器切片(Fragment)物理映射白板解析。
【面试官考察维度】
区分初级 CUDA 开发者与资深算子/AI 编译器开发者的终极试金石。【白板推导路径】
- 原语定义:
mma.sync.aligned.m16n8k16.row.col表示一个 Warp(32 线程)协作计算矩阵乘加:
- 输入矩阵 的碎片分布(Row-Major):
- 矩阵 大小为 个 FP16 元素(共 512 字节);
- Warp 内 32 个线程,每个线程分配 个 FP16 元素;
- 每个元素 2 字节,8 个元素共 16 字节,刚好装入每个线程的 4 个 32-bit 通用寄存器( );
- 线程 Lane ID 为 负责前 4 行的切片,依次交错排布。
- 输入矩阵 的碎片分布(Col-Major):
- 矩阵 大小为 个 FP16 元素;
- 每个线程分配 个 FP16 元素,刚好装入 2 个 32-bit 寄存器( )。
- 输出矩阵 的累加碎片:
- 输出矩阵大小为 个单精度 float 元素;
- 每个线程分配 4 个 FP32 元素,保存在 4 个专用累加寄存器中。
- 结论:32 个线程的寄存器通过片上专属的张量脉动网络互联,指令发射后无缝交织完成计算并原地写回。