> ## Documentation Index
> Fetch the complete documentation index at: https://lilinji.mintlify.site/llms.txt
> Use this file to discover all available pages before exploring further.
# 第14讲:物理邻居还是异地恋?:GPU 节点与集群硬件拓扑
> 深入剖析单机 8 卡物理拓扑与万卡智算集群网络互联:拆解双路 CPU NUMA 陷阱、PCIe Switch 直通、4 颗 NVSwitch 全互联巨网、3 层 Clos/Fat-Tree 1:1 无收敛组网与 Rail-Optimized 轨道优化设计,掌握 Rank Placement 拓扑感知调度的第一性原理。
# 🏛️ 第14讲:物理邻居还是异地恋?——GPU 节点与集群硬件拓扑(PCIe/NVLink/NVSwitch/Clos/Rail-Optimized)
> **主讲人**:👓 **Ringi**(大厂 AI Infrastructure 工程师)\
> **所属模块**:[Module 01: GPU 硬件架构、数据搬运、集群通信与 Overlap](/02_GPU硬件与集群互联/README)\
> **篇章范式**:🏛️ 硬件物理架构与网络组网篇(Hardware Topology & Networking Paradigm)\
> **核心导读**:\
> 很多初入分布式大模型领域的算法工程师,在写 PyTorch 分布式代码时,脑海中往往存在一个极具欺骗性的抽象模型:**集群里所有的 GPU 都是同构的、扁平的,它们仅仅是由一个整型变量 `rank_id` 标识的无差别计算单元。**\
> 然而在物理世界中,这种虚拟抽象会瞬间引爆系统的性能雪崩!\
> 在真实的智算中心里,**GPU 0 与 GPU 1 之间通过机内 4 颗 NVSwitch 实现了 900 GB/s 的双向极速对轰(纳秒级近邻);GPU 0 与 GPU 4 之间虽然在同一个机箱,却分属两个不同的 CPU NUMA 节点,中间横亘着高延迟的 UPI 总线;而如果你不慎让 GPU 0 与另一台机器的 GPU 通信,数据就必须挤过只有 50 GB/s 的跨机网卡;更致命的是,如果跨机通信走错了交换机轨道(Rail),56 对流量会瞬间挤爆上层 Spine 交换机,导致集群利用率断崖式暴跌 70%!**\
> 物理拓扑决定了通信带宽与延迟的阶梯,而拓扑感知调度(Rank Placement)则决定了大模型集群的算力生死。\
> 本讲我们将彻底撕开虚拟抽象的幕布,把单机 8 卡服务器与万卡集群的物理机箱大卸八块,深度推导 PCIe Switch、NVSwitch、Clos 无收敛架构与 Rail-Optimized 轨道组网的第一性原理!
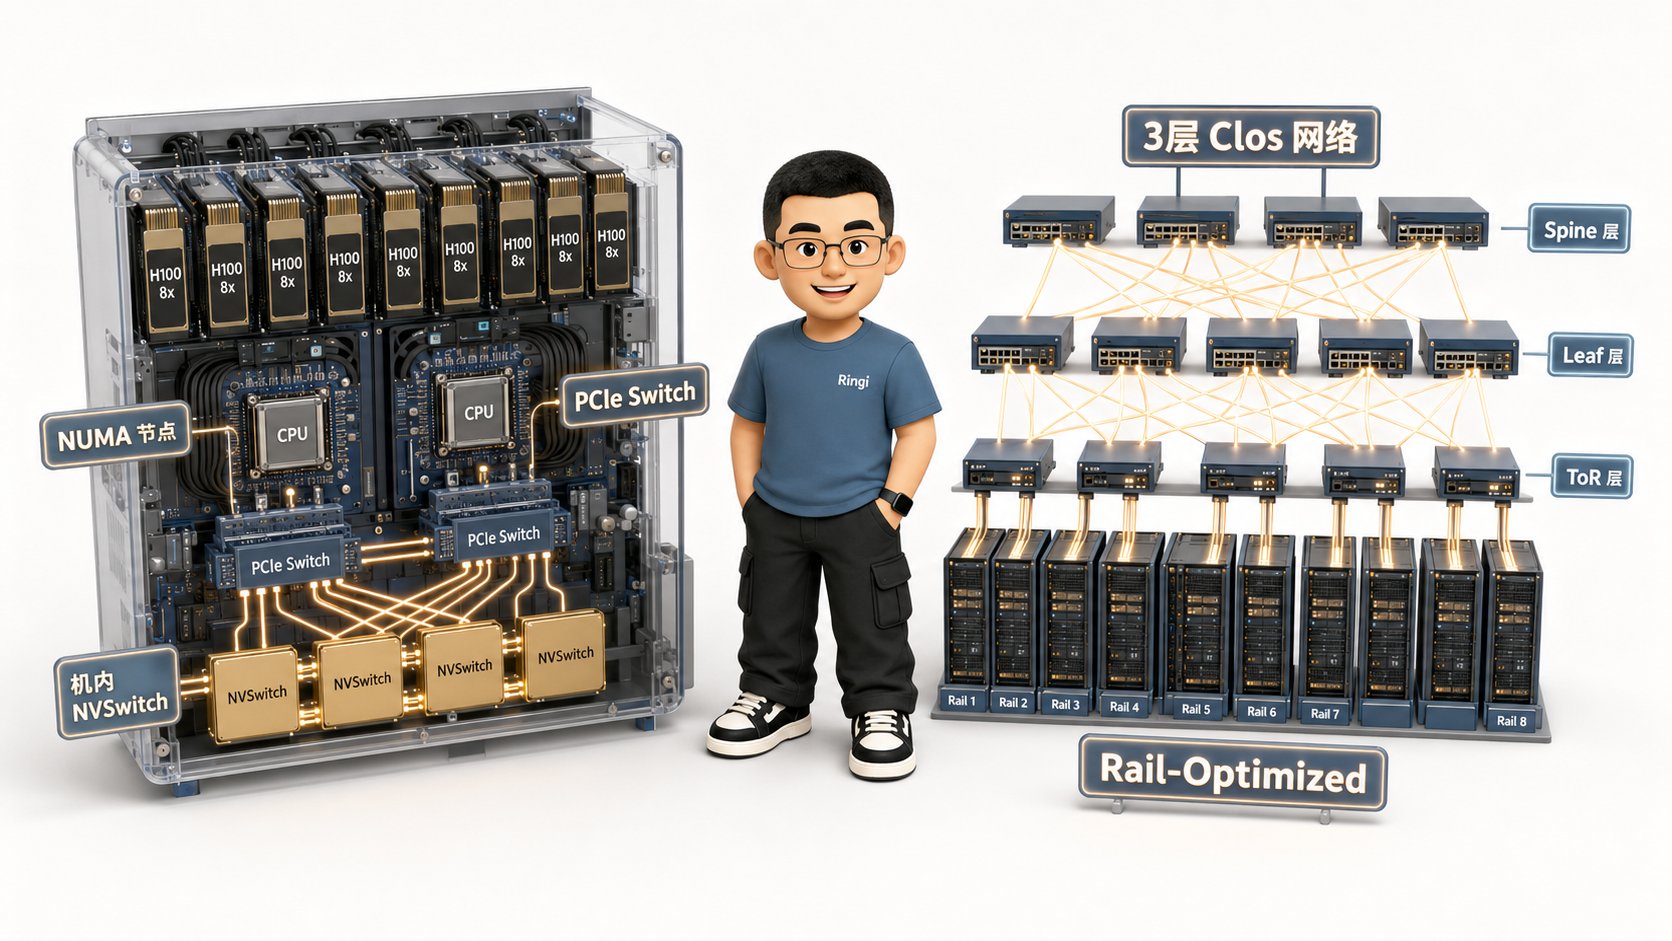 ```text theme={null}
=================================================================================================
Ringi 3D 架构工坊 · 核心全景
┌───────────────────────────────────────────────────────────────────────────────────────────────┐
│ [Intra-Node 8-GPU Topology: HGX H100 Chassis] │
│ │
│ ┌────────────────────────┐ ┌────────────────────────┐ │
│ │ CPU Socket 0 (NUMA) │◄──────── UPI Bus (32 GT/s) ─►│ CPU Socket 1 (NUMA) │ │
│ └───────────┬────────────┘ └───────────┬────────────┘ │
│ │ PCIe 5.0 (64 GB/s) │ PCIe 5.0 │
│ ┌──────┴──────┐ ┌──────┴──────┐ │
│ │ PCIe Switch │ │ PCIe Switch │ │
│ └──┬────────┬─┘ └──┬────────┬─┘ │
│ │ │ GPUDirect P2P (No CPU Loop) │ │ │
│ ┌──▼──┐ ┌──▼──┐ ┌──▼──┐ ┌──▼──┐ │
│ │NIC 0│ │NIC 1│ (400G ConnectX-7) │NIC 2│ │NIC 3│ │
│ └──┬──┘ └──┬──┘ └──┬──┘ └──┬──┘ │
│ ┌──▼──┐ ┌──▼──┐ ┌─────┐ ┌─────┐ ┌─────┐ ┌─────┐ ┌──▼──┐ ┌──▼──┐ │
│ │GPU 0│ │GPU 1│ │GPU 2│ │GPU 3│ │GPU 4│ │GPU 5│ │GPU 6│ │GPU 7│ │
│ └──┬──┘ └──┬──┘ └──┬──┘ └──┬──┘ └──┬──┘ └──┬──┘ └──┬──┘ └──┬──┘ │
│ │ │ │ │ │ │ │ │ │
│ ═══╧════════╧════════╧════════╧═════════╧════════╧════════╧════════╧═══════ │
│ 4 x NVSwitch 3 (Full-Mesh All-to-All: 900 GB/s) │
├───────────────────────────────────────────────────────────────────────────────────────────────┤
│ [Inter-Node Cluster Fabric: 3-Tier Clos / Fat-Tree (1:1 Non-Blocking)] │
│ │
│ ┌───────────────────────────────┐ │
│ │ Core Switches (Tier 3) │ │
│ └───────────────┬───────────────┘ │
│ │ 400G/800G │
│ ┌───────────────┴───────────────┐ │
│ │ Spine Switches (Tier 2) │ │
│ └───────────────┬───────────────┘ │
│ │ 400G/800G │
│ ┌───────────────────────────┴───────────────────────────┐ │
│ │ Leaf / ToR Switches (Tier 1) │ │
│ │ [Rail 0] [Rail 1] [Rail 2] ... [Rail 7] │ │
│ └───────┬───────────┬───────────┬────────────────┬──────┘ │
│ │ │ │ │ │
│ Node 0: NIC 0 NIC 1 NIC 2 ... NIC 7 │
│ Node 1: NIC 0 NIC 1 NIC 2 ... NIC 7 │
│ │
│ [Rail-Optimized Rule] Same-rank GPUs connect to the SAME Leaf Switch! Zero Spine Crossings! │
└───────────────────────────────────────────────────────────────────────────────────────────────┘
=================================================================================================
```
## 📑 目录导航
* [0. Ringi 开场:生产真实现场与痛点冲突](#0-ringi-开场生产真实现场与痛点冲突)
* [0.1 真实工程矛盾:同样是 64 卡集群,为什么 MFU 相差 2.5 倍?](#01-真实工程矛盾同样是-64-卡集群为什么-mfu-相差-25-倍)
* [0.2 线上真实事故复盘:网线全插在同一个 ToR 引发的“跨 Rail 流量血崩”](#02-线上真实事故复盘网线全插在同一个-tor-引发的跨-rail-流量血崩)
* [0.3 集群物理互联层级与性能矩阵全景速查表](#03-集群物理互联层级与性能矩阵全景速查表)
* [1. 单机 8 卡物理机箱解剖:从 CPU NUMA 到 NVSwitch 巨网](#1-单机-8-卡物理机箱解剖从-cpu-numa-到-nvswitch-巨网)
* [1.1 HGX H100 8-GPU 物理拓扑俯瞰:双路 CPU、两颗 PCIe Switch 与 8 卡布局](#11-hgx-h100-8-gpu-物理拓扑俯瞰双路-cpu两颗-pcie-switch-与-8-卡布局)
* [1.2 CPU NUMA 架构与 UPI 总线陷阱:为什么跨 Socket 访问会成为隐形刺客?](#12-cpu-numa-架构与-upi-总线陷阱为什么跨-socket-访问会成为隐形刺客)
* [1.3 PCIe Switch 的角色与 GPUDirect P2P 直通:解密 GPU 与网卡的同巢设计](#13-pcie-switch-的角色与-gpudirect-p2p-直通解密-gpu-与网卡的同巢设计)
* [1.4 NVSwitch 革命:从点对点跳步到 8 卡 900 GB/s 全互联(Full-Mesh)](#14-nvswitch-革命从点对点跳步到-8-卡-900-gbs-全互联full-mesh)
* [2. 机内总线代际演进:PCIe 与 NVLink 的物理对决](#2-机内总线代际演进pcie-与-nvlink-的物理对决)
* [2.1 物理层技术参数对照表:PCIe 4.0/5.0 vs NVLink 3.0/4.0/5.0](#21-物理层技术参数对照表pcie-4050-vs-nvlink-304050)
* [2.2 为什么 PCIe 无论怎么升级也追不上 NVLink?(引脚、损耗与专有协议栈)](#22-为什么-pcie-无论怎么升级也追不上-nvlink引脚损耗与专有协议栈)
* [2.3 NVLS(NVLink SHARP)网内计算:NVSwitch 芯片内部的硬件加法归约](#23-nvlsnvlink-sharp网内计算nvswitch-芯片内部的硬件加法归约)
* [2.4 Blackwell 架构的物理飞跃:NV-HBI(10 TB/s)与 NVL72 机架级铜缆背板](#24-blackwell-架构的物理飞跃nv-hbi10-tbs与-nvl72-机架级铜缆背板)
* [3. 跨机集群组网:Clos 架构与 Fat-Tree 无收敛网络](#3-跨机集群组网clos-架构与-fat-tree-无收敛网络)
* [3.1 为什么万卡集群不能用传统大二层交换机?](#31-为什么万卡集群不能用传统大二层交换机)
* [3.2 3 层 Clos / Fat-Tree 网络拓扑架构解构(Leaf ➔ Spine ➔ Core)](#32-3-层-clos--fat-tree-网络拓扑架构解构leaf--spine--core)
* [3.3 收敛比(Oversubscription)的第一性原理:为什么大模型训练必须严格要求 1:1 无收敛?](#33-收敛比oversubscription的第一性原理为什么大模型训练必须严格要求-11-无收敛)
* [3.4 光模块(OSFP/QSFP-DD)、DAC 铜缆与 AOC 有源光缆的选型物理账本](#34-光模块osfpqsfp-dddac-铜缆与-aoc-有源光缆的选型物理账本)
* [4. Rail-Optimized(轨道优化)组网:大厂集群的无损高速公路](#4-rail-optimized轨道优化组网大厂集群的无损高速公路)
* [4.1 传统组网 vs Rail-Optimized 组网的本质差异](#41-传统组网-vs-rail-optimized-组网的本质差异)
* [4.2 为什么全网同号 GPU 必须连同一个 Leaf 交换机?(8 条物理轨道完全隔离)](#42-为什么全网同号-gpu-必须连同一个-leaf-交换机8-条物理轨道完全隔离)
* [4.3 为什么 All-to-All 在跨 Rail 时带宽暴跌?(56 对绕行 Spine 的数学推导)](#43-为什么-all-to-all-在跨-rail-时带宽暴跌56-对绕行-spine-的数学推导)
* [4.4 工业级 Rail 组网接线图与交换机端口配比精算](#44-工业级-rail-组网接线图与交换机端口配比精算)
* [5. Rank Placement 拓扑感知映射:让分布式算子住进最优工位](#5-rank-placement-拓扑感知映射让分布式算子住进最优工位)
* [5.1 3D 混合并行(TP + CP + PP + DP)的物理映射黄金法则](#51-3d-混合并行tp--cp--pp--dp的物理映射黄金法则)
* [5.2 Megatron 与 PyTorch 分布式环境变量映射(LOCAL\_RANK vs RANK)](#52-megatron-与-pytorch-分布式环境变量映射local_rank-vs-rank)
* [5.3 跨机通信拓扑感知调度实战(Slurm 与 K8s 节点亲和性)](#53-跨机通信拓扑感知调度实战slurm-与-k8s-节点亲和性)
* [5.4 极端案例:MoE 专家分布的拓扑感知优化策略(DeepEP 案例)](#54-极端案例moe-专家分布的拓扑感知优化策略deepep-案例)
* [6. 拓扑诊断利器:`nvidia-smi topo` 与 NCCL 拓扑探测深度解构](#6-拓扑诊断利器nvidia-smi-topo-与-nccl-拓扑探测深度解构)
* [6.1 `nvidia-smi topo -m` 矩阵完全解析(NV#、PIX、PXB、NODE、SYS 物理含义)](#61-nvidia-smi-topo--m-矩阵完全解析nvpixpxbnodesys-物理含义)
* [6.2 NCCL `topo.xml` 文件生成机制与虚拟通信环路(Channels)构建](#62-nccl-topoxml-文件生成机制与虚拟通信环路channels构建)
* [6.3 生产实战:利用 `NCCL_DEBUG=INFO` 抓取通信环路与硬件拓扑对齐日志](#63-生产实战利用-nccl_debuginfo-抓取通信环路与硬件拓扑对齐日志)
* [7. 动手实战与代码实验室(Minimal Runnable Code)](#7-动手实战与代码实验室minimal-runnable-code)
* [7.1 实验 1:全网拓扑矩阵探测与 NUMA/PCIe 亲和性自动化审计器](#71-实验-1全网拓扑矩阵探测与-numapcie-亲和性自动化审计器)
* [7.2 实验 2:单机跨 NUMA 与同 NUMA 内存拷贝延迟带宽基准对比](#72-实验-2单机跨-numa-与同-numa-内存拷贝延迟带宽基准对比)
* [7.3 实验 3:Rank Placement 拓扑感知最优编排仿真器](#73-实验-3rank-placement-拓扑感知最优编排仿真器)
* [7.4 实验 4:Rail-Optimized 流量冲突与 Spine 负载仿真器](#74-实验-4rail-optimized-流量冲突与-spine-负载仿真器)
* [8. Ringi 避坑指南与生产性能工程黄金 Checklist](#8-ringi-避坑指南与生产性能工程黄金-checklist)
* [8.1 避坑表格(❌ 常见小白拓扑误区 vs ✅ 大厂 AI Infra 正解)](#81-避坑表格-常见小白拓扑误区-vs--大厂-ai-infra-正解)
* [8.2 生产硬件拓扑与网络布线黄金十条 Checklist](#82-生产硬件拓扑与网络布线黄金十条-checklist)
* [9. Ringi 5 点核心速记口诀、自我检验清单与课后深度思考题](#9-ringi-5-点核心速记口诀自我检验清单与课后深度思考题)
* [9.1 5 点押韵核心速记口诀](#91-5-点押韵核心速记口诀)
* [9.2 10 条白板自我检验清单](#92-10-条白板自我检验清单)
* [9.3 3 道高阶开放式课后思考题(含极端 Corner Case)](#93-3-道高阶开放式课后思考题含极端-corner-case)
* [10. 📚 参考资料与核心源码/经典论文指引](#10--参考资料与核心源码经典论文指引)
* [附录:Appendix A — 大厂硬核高频面试题与白板推导(Interview Drill)](#附录appendix-a--大厂硬核高频面试题与白板推导interview-drill)
***
# 0. Ringi 开场:生产真实现场与痛点冲突
## 0.1 真实工程矛盾:同样是 64 卡集群,为什么 MFU 相差 2.5 倍?
在大厂的基础设施运维中,我们曾遇到过一起极其诡异的性能归因迷案:
公司两个算法团队分别申请了 8 台同规格的 8 卡 H100 服务器(共计 64 张 GPU),运行完全一致的 LLaMA-3-70B 预训练脚本(采用 3D 并行:张量并行 TP=8,流水线并行 PP=2,数据并行 DP=4):
* **A 团队(老牌 Infra 团队)**:模型浮点利用率(MFU)稳定在 **52.4%**,每步迭代耗时 1.35 秒;
* **B 团队(新业务团队)**:模型浮点利用率(MFU)却只有惨淡的 **20.8%**,每步迭代耗时高达 3.42 秒!
两边拉齐了代码库分支、PyTorch 版本、CUDA 驱动、甚至训练数据与超参数,结果完全一致;机器的 GPU 单卡算力测试(TFLOPS)也毫无故障。\
**为什么同样是 64 张卡,性能会硬生生拉开 2.5 倍的鸿沟?**
当 Infra 工程师深入排查其分布式启动脚本时,真相瞬间大白:
* A 团队在调度启动时,严格设置了拓扑感知参数,**让 TP=8 的通信组严格收敛在每台单机内部的 8 张卡上(走 900 GB/s 的机内 NVLink)**;
* B 团队直接使用了默认的随机容器调度,其 Rank 映射在物理拓扑上是错乱的:**每个 TP=8 组的 8 张卡被稀稀拉拉地分摊到了 4 台不同的物理机上!**
```text theme={null}
生产残酷真相:
A 团队:TP 组通信走机内 NVLink 4.0 ──► 单向 450 GB/s,延迟 0.8 μs
B 团队:TP 组通信跨机走 RoCEv2 网卡 ──► 单向 45 GB/s,延迟 12.0 μs (带宽慢 10 倍,时延慢 15 倍!)
每一个 Transformer 层原本 0.5ms 的 AllReduce,在 B 团队机器上被强行拉长到 12ms!全模型 80 层累积下来,算力被彻底耗死在跨机等待中!
```
这就是所谓的“异地恋式通信灾难”——**忽视物理拓扑,分布式并行就只是在空中楼阁上狂欢!**
***
## 0.2 线上真实事故复盘:网线全插在同一个 ToR 引发的“跨 Rail 流量血崩”
我们再来看一起记录在数据中心网络建设中的真实 P1 事故:
某千万级智算中心新建了一个由 32 台 8 卡 H100 节点构成的算力集群。根据大厂标准规范,该集群必须采用 **Rail-Optimized(按卡分轨)** 的方式组网。然而,现场机房施工团队由于缺乏对大模型分布式通信的理解,为了“省事美观”,在机柜布线时做出了一个致命改动:
* 将一台机箱背后的 **8 根 400G OSFP 高速光缆,全部整整齐齐地插入了同一个机柜顶部的同一台 ToR(Leaf)交换机中**!
集群交付后,运行包含 MoE 专家并行的训练任务。当模型运行到跨节点的 `All-to-All` 通信阶段时,灾难爆发了:
* 32 台机器并发向全网打散分发微型 Token 切片;
* 由于同机的所有网卡全部挂在同一台 Leaf 交换机上,原本设计中应该分流到 8 条独立物理轨道的全网流量,瞬间全部涌向了机柜顶部的单台 ToR 交换机;
* ToR 交换机向上连通 Spine 交换机的上行链路瞬间被挤爆,端口队列缓冲区发生严重的 Micro-burst 丢包;
* 紧接着触发了漫延全网的 **PFC 死锁风暴(Deadlock Storm)**,所有网卡的 QP 队列全部挂起,训练单步耗时直接从 300ms 狂飙到 4.5 秒,最终引发全网 NCCL Timeout 崩溃离线!
这起事故让整个集群停机排查整改了整整 3 天,涉及数百根光纤的重新拔插重连。它的本质教训就是:**AI 集群的物理布线不是强电接线板,每一根网线对应的物理拓扑,都与分布式算法的数学数据流死死咬合在一起!**
***
## 0.3 集群物理互联层级与性能矩阵全景速查表
在深入机箱与交换机之前,我们先把物理世界中从芯片到集群的六大互联层级底账摊开:
| 物理互联层级 | 核心硬件组件 | 单向有效带宽 (BW) | 双向聚合带宽 (Bidir) | 典型通信单程时延 | 物理拓扑特征与限制 |
| :- | :- | :- | :- | :- | :- |
| 1. 片上核心级 | SM 内部 Register / Shared Memory | \~ 12 \~ 14 TB/s | > 25 TB/s | \~ 2 ns (10\~30 Cycles) | 硅片内部极速走线; 容积仅数百 KB / SM |
| 2. 封装显存级 | HBM3 2.5D CoWoS 堆叠 (单卡 80GB 容量) | 3.35 TB/s | 3.35 TB/s (读写复用) | \~ 60 \~ 80 ns | 硅中介层微凸块直连; 单设备容量物理天花板 |
| 3. 机内板卡级 | 4 x NVSwitch 3 (18 条 NVLink 4.0) | 450 GB/s / GPU | 900 GB/s / GPU (单机 7.2 TB/s 全双工) | \< 100 ns | PCB 高速背板差分对; 8 卡 Full-Mesh 全互联 |
| 4. 主机总线级 | PCIe 5.0 x16 / Switch UPI 跨 Socket 总线 | 32 GB/s (UPI: \~32 GT/s) | 64 GB/s (UPI: \~64 GB/s) | \~ 1.0 \~ 1.5 μs (UPI: \~150 ns) | CPU Host 桥接与外设; 跨 NUMA 访问惩罚显著 |
| 5. 机架接入级 (Leaf) | ToR 接入交换机 (Rail-Optimized 独立) | \~ 45 GB/s / NIC | \~ 90 GB/s / NIC | \~ 2.0 \~ 4.0 μs | OSFP/QSFP-DD 直连; 同 Rail 内部一跳直达 |
| 6. 集群核心级 (Spine) | 3 层 Clos 脊交换机 (Fat-Tree 1:1 无收敛) | \~ 45 GB/s / 链路 (万卡聚合达数十 PB/s) | \~ 90 GB/s / 链路 | \~ 5.0 \~ 15.0 μs | 跨 Spine 绕行光交换; 跨 Rail 通信终极瓶颈 |
***
# 1. 单机 8 卡物理机箱解剖:从 CPU NUMA 到 NVSwitch 巨网
为了在深入具体细节前建立全局的拓扑心智模型,下方给出了现代 AI 智算中心从机内 8 卡 SXM 底板全交叉互联,到跨机 3 层 Clos 无收敛胖树与 8 轨道独立优化(Rail-Optimized)的工业级全景架构拓扑:
 ## 1.1 HGX H100 8-GPU 物理拓扑俯瞰:双路 CPU、两颗 PCIe Switch 与 8 卡布局
当前工业界最标准的单机 8 卡训练服务器形态(如 NVIDIA HGX H100 / DGX H100)内部,绝不仅仅是把 8 块 GPU 简单插在主板上。它的物理主板被划分为高度精密的两个平面:**计算与互联平面(NVLink Domain)** 与 **控制与网络平面(PCIe/Host Domain)**。
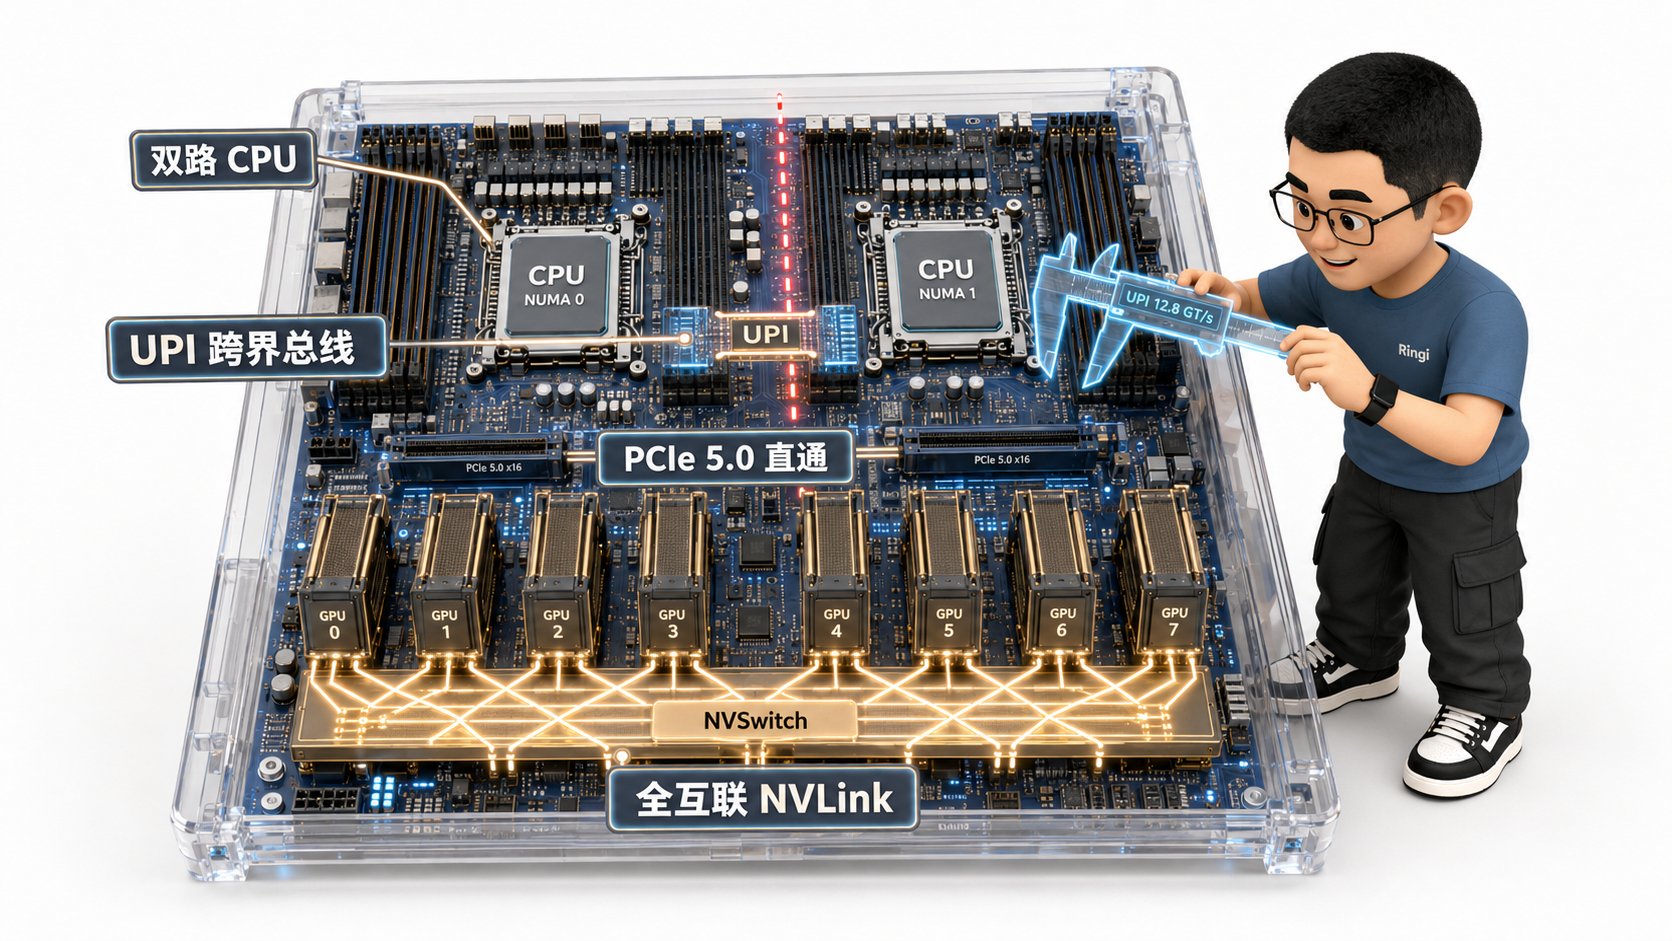 ```text theme={null}
┌───────────────────────────────────────────────────────────────────────────────────────────────┐
│ HGX H100 8-GPU 物理硬件布局全景俯瞰 │
├───────────────────────────────────────────────────────────────────────────────────────────────┤
│ │
│ [ CPU 0 NUMA Domain ] [ CPU 1 NUMA Domain ] │
│ ┌────────────────────────┐ ┌────────────────────────┐ │
│ │ Intel Xeon / AMD EPYC │◄──────── UPI Bus (32 GT/s) ─►│ Intel Xeon / AMD EPYC │ │
│ │ DDR5 Host 内存池 │ │ DDR5 Host 内存池 │ │
│ └───────────┬────────────┘ └───────────┬────────────┘ │
│ │ PCIe 5.0 x16 (64 GB/s) │ PCIe 5.0 x16 │
│ ┌──────┴──────┐ ┌──────┴──────┐ │
│ │ PCIe Switch │ (PCIe Gen5 交换芯片) │ PCIe Switch │ │
│ └──┬────────┬─┘ └──┬────────┬─┘ │
│ │ │ │ │ │
│ ┌────┴──┐ ┌──┴────┐ ┌────┴──┐ ┌──┴────┐ │
│ │ NIC 0 │ │ NIC 1 │ (CX7 400G) │ NIC 2 │ │ NIC 3 │ │
│ └────┬──┘ └──┬────┘ └────┬──┘ └──┬────┘ │
│ │ P2P │ P2P │ P2P │ P2P │
│ ┌────▼──┐ ┌──▼────┐ ┌───────┐ ┌───────┐ ┌───────┐ ┌───────┐ ┌────▼──┐ ┌──▼────┐ │
│ │ GPU 0 │ │ GPU 1 │ │ GPU 2 │ │ GPU 3 │ │ GPU 4 │ │ GPU 5 │ │ GPU 6 │ │ GPU 7 │ │
│ └────┬──┘ └──┬────┘ └───┬───┘ └───┬───┘ └───┬───┘ └───┬───┘ └────┬──┘ └──┬────┘ │
│ │ │ │ │ │ │ │ │ │
│ ═══╧════════╧═══════════╧══════════╧═════════╧═════════╧══════════╧════════╧═══════ │
│ 4 颗 NVSwitch 3 芯片 (物理全互联背板, 任意两卡 900 GB/s) │
└───────────────────────────────────────────────────────────────────────────────────────────────┘
```
仔细观察这幅拓扑,我们可以提炼出单机 8 卡的三个核心硬件支柱:
1. **下层:NVSwitch 构成的纯 GPU 极速王国**:8 张 GPU 彼此之间完全不依赖主板 PCIe,而是直接插入底部的 NVLink 背板,通过 4 颗 NVSwitch 实现两两直连;
2. **中层:PCIe Switch 构建的 GPUDirect 直通桥梁**:网卡并不是插在 CPU 上的,而是与对应的 GPU 一同接入专用的 PCIe Switch,形成极短的 P2P 路径;
3. **上层:双路 CPU NUMA 的跨域裂痕**:GPU 0~~3 归属 CPU 0,GPU 4~~7 归属 CPU 1。两者之间唯一的数据桥梁是一根脆弱的 UPI 总线。
***
## 1.2 CPU NUMA 架构与 UPI 总线陷阱:为什么跨 Socket 访问会成为隐形刺客?
在现代服务器中,双路 CPU 采用的是 **NUMA(Non-Uniform Memory Access,非一致性内存访问)** 架构。每个 CPU Socket 拥有自己独立挂载的本地 DDR 内存通道与 PCIe 控制器:
* CPU 0 访问挂载在自己本地通道的 DDR 内存,时延通常为 **80\~100 ns**,带宽打满可达 **200\~300 GB/s**;
* 如果 CPU 0 试图去读写挂在 CPU 1 上的内存,或者去操作插在 CPU 1 侧 PCIe 插槽上的网卡,数据就必须通过连接两个 CPU 的 **UPI(Ultra Path Interconnect / AMD Infinity Fabric)** 总线跨界漫游!
```text theme={null}
┌───────────────────────────────────────────────────────────────────────────────────────────────┐
│ UPI 跨 Socket 访问的性能衰减陷阱 │
├───────────────────────────────────────────────────────────────────────────────────────────────┤
│ [本地访问 (Intra-NUMA)] │
│ GPU 0 ──► PCIe Switch 0 ──► CPU 0 (本地 Host 内存 / 本地 NIC 0) │
│ • 传输耗时:约 1.0 μs | 总线带宽:64 GB/s (PCIe 5.0) | 零 UPI 争抢 │
├───────────────────────────────────────────────────────────────────────────────────────────────┤
│ [跨 Socket 访问 (Inter-NUMA Cross-UPI)] │
│ GPU 0 ──► PCIe Switch 0 ──► CPU 0 ──► 【UPI 总线 (32 GT/s)】 ──► CPU 1 ──► 本地内存 / NIC 2 │
│ • 传输耗时:约 2.5 ~ 3.5 μs (时延暴增 3 倍!) | 有效带宽断崖跌至 ~25 GB/s (腰斩!) │
│ • 致命隐患:UPI 总线本身还要承担 CPU 缓存一致性同步流量,极易发生总线饱和抖动! │
└───────────────────────────────────────────────────────────────────────────────────────────────┘
```
> 📌 **生产避坑法则**:
> 如果你的分布式进程在启动时没有做 **NUMA 亲和性绑定(CPU Affinity Binding)**,操作系统调度器可能会把驱动 GPU 0 的 Python 进程随意调度到 CPU 1 的核心上运行。
> 此时该进程发起的每一次网卡通信敲 Doorbell、每一次主机显存拷贝,都在疯狂跨越 UPI 总线,**直接导致机间通信延迟暴增 40% 以上!**
***
## 1.3 PCIe Switch 的角色与 GPUDirect P2P 直通:解密 GPU 与网卡的同巢设计
在早期的 GPU 服务器中,GPU 和网卡直接插在 CPU 的 PCIe 插槽上。当时如果要把数据从 GPU 显存发给网卡,数据路径是:
$$
\text{GPU} \xrightarrow{\text{PCIe}} \text{CPU Host 内存} \xrightarrow{\text{CPU 拷贝}} \text{网卡发送}
$$
这条路径被称为 **Staged Copy**,不仅浪费了两倍的 PCIe 带宽,还强行占用了 CPU 算力。
而在现代 HGX 服务器中,硬件架构引入了 **PCIe Switch(PCIe 交换芯片)**:
* PCIe Switch 作为一个独立的硬件数据包路由交换机,向下同时连接 1 块 GPU 和 1 块 400G 网卡(ConnectX-7);
* 当 GPU 想要向网卡发送数据时,触发 **GPUDirect RDMA (P2P)**:
$$
\text{GPU 显存} \xrightarrow{\text{PCIe}} \text{PCIe Switch} \xrightarrow{\text{PCIe}} \text{NIC 网卡 DMA}
$$
* **数据完全不需要向上流经 CPU Root Complex,更不需要进入 Host 内存!** 物理数据包直接在 PCIe Switch 内部掉头完成转发,实现了极致的亚微秒级延迟与全带宽直通。
***
## 1.4 NVSwitch 革命:从点对点跳步到 8 卡 900 GB/s 全互联(Full-Mesh)
在没有 NVSwitch 的前代架构中(如早期 PCIe 服务器或使用简单桥接器的系统),GPU 之间的物理连接是点对点的(Ring 或 Mesh)。这带来了一个致命困局:
* GPU 0 要给 GPU 1 发数据,可以一跳直达;
* 但 GPU 0 要给身处远端的 GPU 3 发数据,就必须把数据先发给 GPU 1,由 GPU 1 作为中继节点转发给 GPU 2,最后到达 GPU 3!
* **多跳中转的灾难**:中间节点的显存总线被无情打扰,端到端延迟随跳步数线性累加,有效带宽发生严重折损!
**NVIDIA NVSwitch 的诞生,彻底颠覆了机内拓扑的游戏规则**:
| 拓扑架构维度 | 传统点对点拓扑 (Point-to-Point Ring/Mesh) | 现代 NVSwitch 3 全互联拓扑 (Full-Mesh Crossbar) |
| :- | :- | :- |
| 1. 通信跳步数 | 远端 GPU 必须经过 2\~3 跳中继转发 | 任意两张 GPU 之间【一跳绝对直达】! |
| 2. 带宽一致性 | 随物理距离严重衰减(邻居 900 GB/s,远端跌至 300 GB/s) | 任意两卡间恒定提供满血 900 GB/s 双向互联带宽 |
| 3. 硬件交换芯片 | 无独立芯片,依赖 GPU 自身的 LSU 充当中继 | 搭载 4 颗独立的专用 NVSwitch 交换 ASIC 芯片 |
| 4. 集合通信算法支持 | 只能跑效率低下的逐级流水线 Ring 算法 | 支持硬件级单步跨卡广播,并支持 NVLS 网内计算硬件归约 |
在 HGX H100 基板上,整整集成了 **4 颗第三代 NVSwitch 芯片**。每颗芯片拥有高达 64 个 NVLink 端口,单机内部的总双向交换容量达到了惊人的 **7.2 TB/s**!这就是为什么在单机 8 卡内部,你可以肆无忌惮地跑高频 AllReduce 的底层物理倚仗!
***
# 2. 机内总线代际演进:PCIe 与 NVLink 的物理对决
## 2.1 物理层技术参数对照表:PCIe 4.0/5.0 vs NVLink 3.0/4.0/5.0
很多人只知道 NVLink 比 PCIe 快,但不知道它到底快在哪些物理维度。我们把近三代物理互联的硬核参数进行精准对齐:
| 核心技术指标 | PCIe 4.0 x16 | PCIe 5.0 x16 | NVLink 3.0 (A100) | NVLink 4.0 (H100) | NVLink 5.0 (B200) |
| :- | :- | :- | :- | :- | :- |
| 1. 单向链路带宽 | 31.5 GB/s | 64.0 GB/s | 300.0 GB/s | 450.0 GB/s | 900.0 GB/s |
| 2. 双向聚合带宽 | 63.0 GB/s | 128.0 GB/s | 600.0 GB/s | 900.0 GB/s | 1800.0 GB/s |
| 3. 物理通道数 (Lanes) | 16 对差分信号线 | 16 对差分信号线 | 12 条独立 Links (每 Link 50GB/s) | 18 条独立 Links (每 Link 50GB/s) | 18 条独立 Links (每 Link 100GB/s) |
| 4. 单信号对传输速率 | 16 GT/s (NRZ) | 32 GT/s (NRZ) | 50 Gbps (PAM4) | 100 Gbps (PAM4) | 200 Gbps (PAM4) |
| 5. 单向硬件直通时延 | 1.5 \~ 2.5 μs | 0.8 \~ 1.5 μs | \< 200 ns | \< 100 ns | \< 80 ns |
| 6. 交换芯片代际 | PCIe Switch Gen4 | PCIe Switch Gen5 | NVSwitch 2.0 | NVSwitch 3.0(NVLS) | NVSwitch 4.0(MNNVL) |
***
## 2.2 为什么 PCIe 无论怎么升级也追不上 NVLink?(引脚、损耗与专有协议栈)
这是一个非常高频的大厂架构面试深水题:“既然 PCIe 也在从 Gen4 升级到 Gen5、Gen6,为什么在 GPU 互联领域,它永远只能当配角,无法取代 NVLink?”
从第一性原理分析,有三大难以逾越的物理与工程屏障:
### 1. 物理引脚密度与走线布局的死局(Pinout & PCB Density)
* **PCIe 是通用总线**:它必须向后兼容各种声卡、网卡、RAID 卡和固态硬盘,其金手指插槽的标准尺寸与引脚定义被 PCIe SIG 联盟严格锁死。一张标准的 PCIe x16 插槽只有 164 个引脚,走线密度受限;
* **NVLink 是专用板级互联**:H100 SXM5 模块底部采用了密集的高科技微型触点(Mezzanine Connector),引脚数量高达数千个!它可以肆无忌惮地铺设 18 条高速差分 Link,物理通道供给量直接碾压了标准 PCIe 插槽。
### 2. 高频信号衰减与调制技术(PAM4 vs 铜线损耗)
* PCIe 5.0 虽然跑到了 32 GT/s,但依然采用传统的 **NRZ(单电平)** 调制,在高频下信号衰减极大,主板走线超过 20 厘米就必须加装昂贵的 Retimer 芯片来放大信号;
* NVLink 从第 3 代开始全面切换为 **PAM4(四电平脉冲幅度调制)**,每个时钟周期编码 2 个比特,在相同的物理频率下直接将传输效率翻倍,配合定制的高频低介电常数 PCB 背板,实现了恐怖的吞吐。
### 3. 协议栈开销的本质差异(Transaction Layer Overhead)
* **PCIe 协议极其厚重**:包含事务层(TLP)、数据链路层(DLLP)和物理层。每次传输都要封装庞大的报头,进行复杂的流控额度(Credit)通告与中断处理,硬件协议解包固定耗费数百纳秒;
* **NVLink 专为显存共享设计**:它从底层原生支持 GPU 显存原子操作(Remote Memory Atomic)与细粒度 Load/Store,硬件直接将内存地址映射为高速数据包,协议开销被压缩到极致,端到端延迟直接压进 **100 纳秒以内**!
***
## 2.3 NVLS(NVLink SHARP)网内计算:NVSwitch 芯片内部的硬件加法归约
在前一讲中我们提到:普通的 DMA 引擎只能搬运,遇到含加法的 AllReduce 必须交由 SM 计算。但在 H100 时代的 NVSwitch 3 芯片上,NVIDIA 释放了一项黑科技——**NVLS(NVLink Network SHARP)**!
```text theme={null}
┌───────────────────────────────────────────────────────────────────────────────────────────────┐
│ NVLS (机内网内计算) 硬件执行流程 │
├───────────────────────────────────────────────────────────────────────────────────────────────┤
│ [传统 AllReduce: SM 亲自加] │
│ GPU 0 显存 ──► NVLink ──► GPU 1 显存 ──► 【GPU 1 的 SM 核心执行向量加法】 ──► 写回显存 │
│ 缺陷:耗费 GPU 核心计算流水线,消耗 Shared Memory 与寄存器。 │
├───────────────────────────────────────────────────────────────────────────────────────────────┤
│ [NVLS AllReduce: 交换机顺手加] │
│ 8 张 GPU 显存 ──► 18 条 NVLink ──► 【NVSwitch 芯片内部集成的硬件 ALU 算术单元】 │
│ │ │
│ 硬件求和瞬间完成 ◄══════════════════════════════╧════════════════════════════════════════ │
│ NVSwitch 利用组播(Multicast)硬件通道,单步将求和结果瞬时广播回 8 张 GPU! │
│ 收益:【0% SM 算力占用!】且集合通信步数直接从 2(N-1) 步砍到极致的 2 步(上传 + 组播写回)!│
└───────────────────────────────────────────────────────────────────────────────────────────────┘
```
NVLS 使得单机 8 卡内部的 AllReduce 性能再次翻倍,NCCL 可以通过环境变量 `NCCL_NVLS_ENABLE=1` 直接激活这一底层硬件加速!
***
## 2.4 Blackwell 架构的物理飞跃:NV-HBI(10 TB/s)与 NVL72 机架级铜缆背板
在最新发布的 NVIDIA Blackwell(B200 / GB200)架构中,硬件拓扑的设计哲学再次跨越了历史性的台阶:
1. **NV-HBI(High-Bandwidth Interface)超高速片间互联**:
* B200 芯片由两颗完全对称的 GPU Die 拼接而成;
* 两个 Die 之间通过定制的 NV-HBI 硅中介层直接相连,带宽高达恐怖的 **10 TB/s**!
* 在软件和 CUDA 驱动视角下,两颗物理 Die 完全融为一体,共享统一的 192GB HBM3e 内存池与一致性缓存。
2. **NVL72 机架级超大规模全互联**:
* 过去一个 NVLink 域最多只能覆盖单机 8 张卡;
* GB200 NVL72 彻底打破了机箱的物理边界:整整一个 42U 机柜内部,集成了 72 颗 B200 GPU 与 18 颗专用外部 NVSwitch 交换机托盘;
* 机柜背后不再使用易损且昂贵的光模块,而是铺设了由 **5000 多根精密高速铜缆构成的重型立体无损背板(Over-Rack Copper Cable Cartridges)**!
* **革命性意义**:**72 张 GPU 构成了一个史无前例的巨型单一 NVLink 域,任意两卡之间独享 1.8 TB/s 的无阻塞全互联带宽!** 原本需要跨机走慢速 RDMA 的张量并行(TP),在 NVL72 上可以直接狂飙到 TP=72,超大模型的训练与推理延迟被直接降维打击!
***
# 3. 跨机集群组网:Clos 架构与 Fat-Tree 无收敛网络
## 3.1 为什么万卡集群不能用传统大二层交换机?
当我们走出单台服务器、构建百卡甚至万卡的大型智算集群时,我们立刻会撞上一道网络工程的物理铁墙:**我们为什么不能制造一台拥有 10000 个端口的超级大交换机,让所有 GPU 插在上面?**
答案是绝对不可能,原因有三:
1. **交换芯片内部 Crossbar 面积极限**:芯片内部的交叉开关复杂度与端口数呈平方级关系( $O(N^2)$ )。以目前最顶级的 Tomahawk 5 或 Quantum-2 芯片为例,单芯片的极限接入端口通常只有 64 个(800G)或 128 个(400G),物理硅片面积已经逼近光刻掩模版的极限;
2. **MAC 表与 ARP 广播风暴**:大二层网络如果接入上万个节点,一旦有节点发起 ARP 寻址广播,风暴会瞬间瘫痪全网控制面;
3. **故障爆炸半径**:如果单台中心交换机发生宕机,全网所有万张卡瞬间殉爆。
***
## 3.2 3 层 Clos / Fat-Tree 网络拓扑架构解构(Leaf ➔ Spine ➔ Core)
为了用小规模的交换芯片拼装出无限扩展的巨型网络,1953 年贝尔实验室的 Charles Clos 提出了划时代的 **Clos 多级交换网络模型**。在 AI 集群中,该架构以 **Fat-Tree(胖树)** 的形态落地:
```text theme={null}
┌────────────────────────────────┐
│ Core Switches (核心层) │
└────────┬──────────────┬────────┘
│ │ 400G / 800G 无收敛链路
┌────────┴────────┐ ┌─┴──────────────┐
│ Spine 0 (脊交换)│...│ Spine M (脊交换)│
└────────┬────────┘ └─┬──────────────┘
│ │ 400G / 800G 交叉全互联
┌───────────────────┴──────────────┴───────────────────┐
│ │
┌──────────┴──────────┐ ┌──────────┴──────────┐
│ Leaf 0 (ToR 交换机) │ │ Leaf K (ToR 交换机) │
└──────────┬──────────┘ └──────────┬──────────┘
│ 400G OSFP │ 400G OSFP
┌───────────┴───────────┐ ┌───────────┴───────────┐
│ Server Node 0 (8 NICs)│ │ Server Node N (8 NICs)│
└───────────────────────┘ └───────────────────────┘
```
胖树架构的本质哲学是:**传统的树状网络越往根部走、树干越细;而胖树网络越往根部走,物理链路越密集、总带宽越粗(“树干越来越胖”),从而保证任意两个叶子节点之间都拥有恒定的吞吐能力!**
***
## 3.3 收敛比(Oversubscription)的第一性原理:为什么大模型训练必须严格要求 1:1 无收敛?
在传统的互联网 Web 服务中,交换机的设计普遍采用 **收敛网络(如 3:1 或 4:1 收敛)**:
* 例如:一台 ToR 交换机向下连服务器的总带宽是 400 Gbps,而向上连 Spine 交换机的总带宽只有 100 Gbps;
* 这是因为 Web 用户的访问是随机且稀疏的,不可能所有服务器同时把网络打满(统计复用原理)。
**但是在 AI 大模型分布式训练中,收敛网络是绝对不可触碰的死穴!**
* **第一性原理**:分布式训练受制于 BSP(Bulk Synchronous Parallel)同步屏障;
* 反向传播结束时,全网成千上万张卡会在同一毫秒内并发调用 AllReduce 广播自己的梯度;
* **如果网络存在 2:1 的收敛比,意味着 50% 的流量在冲上 Spine 交换机时必须原地排队!**
* 排队直接触发交换机队列拥塞、丢包重传,瞬间拉低所有节点的速度。由于整个集群受限于最慢的那张卡(Straggler Effect),只要有一个节点被拥塞卡顿,全网所有昂贵 GPU 全部被迫停机干等!
> 💡 **架构黄金标准**:
> **大模型智算集群的主干网络,下行总带宽必须严格等于上行总带宽,即 1:1 绝对无收敛(Non-blocking Fabric)!**
***
## 3.4 光模块(OSFP/QSFP-DD)、DAC 铜缆与 AOC 有源光缆的选型物理账本
连接服务器与交换机、交换机与交换机之间的物理线缆,直接决定了机房建设的预算与故障率:
| 互连介质类型 | 物理传输介质 | 最大有效传输距离 | 单线缆功耗 | 生产成本与稳定性 | 适用拓扑场景 |
| :- | :- | :- | :- | :- | :- |
| 1. DAC 直连铜缆 (Passive Copper) | 无源纯铜双绞线 (Direct Attach) | 1 \~ 3 米 (极短) | \~ 0.1 W (极低功耗) 几乎永不损坏 | 成本极低; 零发热; 服务器到本柜 ToR | 同机柜内部连接; |
| 2. AOC 有源光缆 (Active Optical) | 光纤 + 固化光模块 (一体化不可拆卸) | 5 \~ 30 米 | \~ 4 \~ 8 W / 端口 故障需整体更换 | 成本中等; 无法拆卸 到 Spine 短距互联 | 相邻机柜间 Leaf |
| 3. 光模块 + MPO 光纤 (Transceiver+Fiber) | 单模/多模光纤 (独立光模块对接) | 100米 \~ 2公里 | \~ 12 \~ 18 W / 模块 发热大, 需精细除尘 | 成本昂贵; 光衰敏感 Spine 到 Core 核心 | 跨机房、跨排列 |
大厂万卡机房通常严格采用 **“机柜内走 DAC 铜缆以保稳定与功耗,跨机柜走单模光模块以保距离与扩展”** 的混合互连工程体系。
***
# 4. Rail-Optimized(轨道优化)组网:大厂集群的无损高速公路
## 4.1 传统组网 vs Rail-Optimized 组网的本质差异
现在,让我们进入本讲最具含金量、也是现代大厂大模型集群最核心的网络设计——**Rail-Optimized(按卡分轨)网络**!
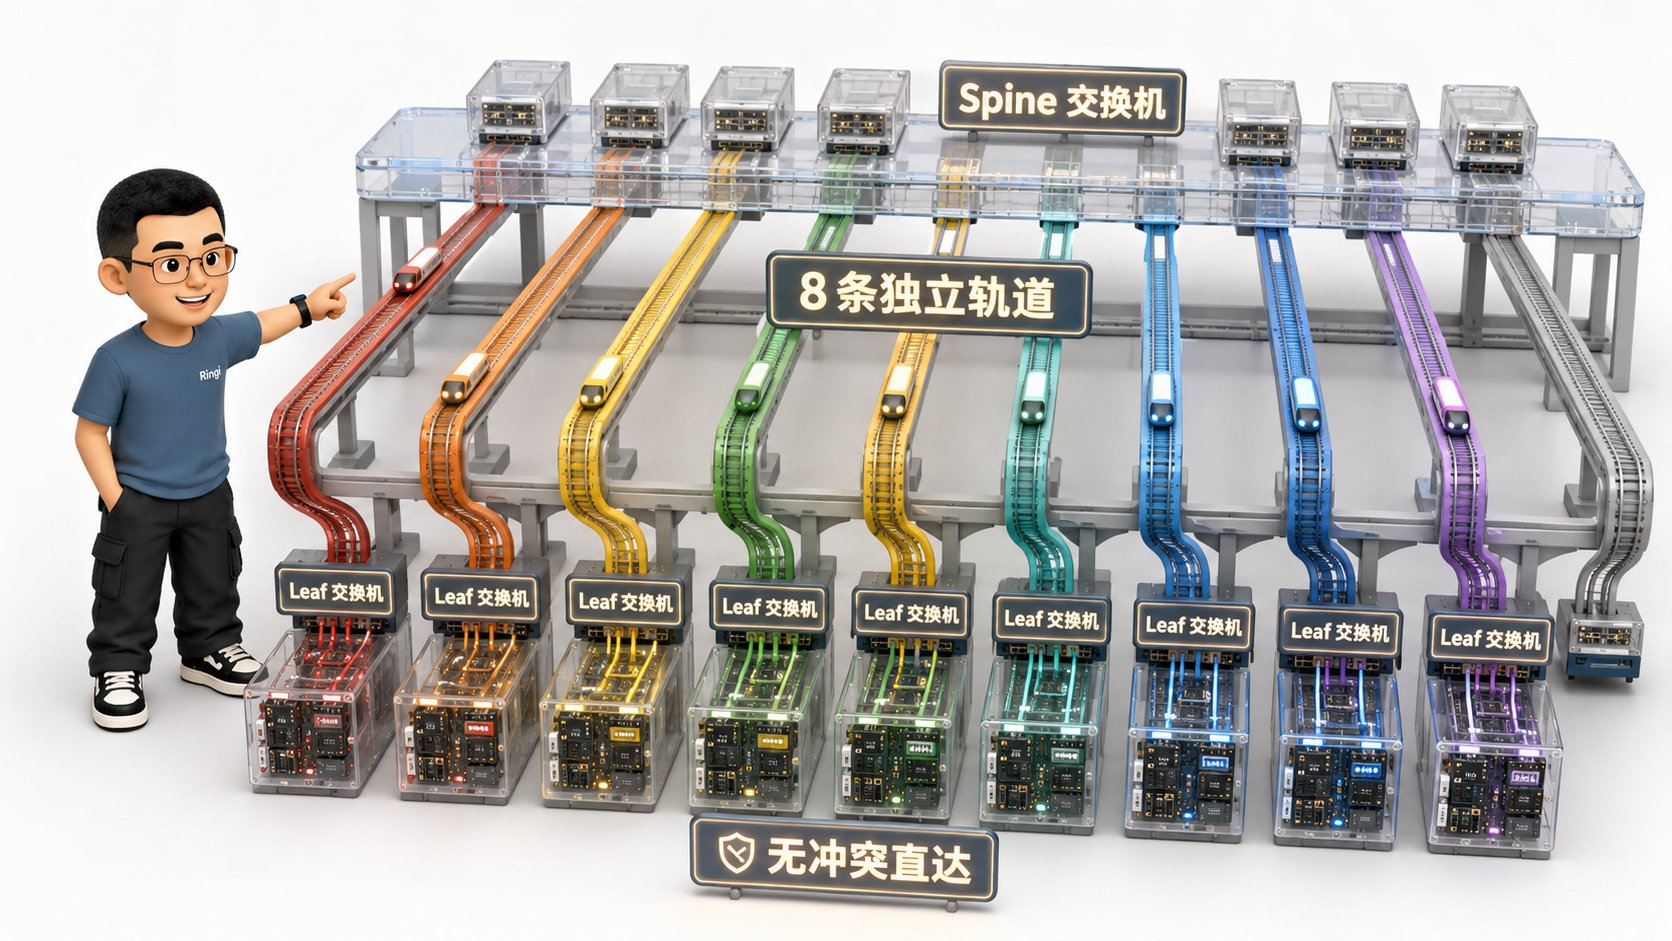 我们来看两种完全不同的机房接线方式:
```text theme={null}
[方式 A: 传统朴素组网 (Traditional Clustered)]
• 每台服务器内的 8 块网卡,全部接入本节点的同一台 ToR 交换机。
• 结果:跨机通信时,不同卡的数据流全混在同一个 ToR 交换机里,必须跨越 Spine 盲目争抢!
[方式 B: 工业级按卡分轨组网 (Rail-Optimized Networking)]
• 全网所有服务器的【GPU 0 绑定的 NIC 0】,全部接入【Rail 0 专属 Leaf 交换机】!
• 全网所有服务器的【GPU 1 绑定的 NIC 1】,全部接入【Rail 1 专属 Leaf 交换机】!
• ...
• 全网所有服务器的【GPU 7 绑定的 NIC 7】,全部接入【Rail 7 专属 Leaf 交换机】!
```
```text theme={null}
┌───────────────────────────────────────────────────────────────────────────────────────────────┐
│ Rail-Optimized 物理拓扑数据通路图 │
├───────────────────────────────────────────────────────────────────────────────────────────────┤
│ │
│ [Server Node 0] [Server Node 1] │
│ ┌───────────────────┐ ┌───────────────────┐ │
│ │ GPU 0 ──► NIC 0 ──┼──────────► [ Leaf 0 (Rail 0) ] ◄──────┼── NIC 0 ◄── GPU 0 │ │
│ │ GPU 1 ──► NIC 1 ──┼──────────► [ Leaf 1 (Rail 1) ] ◄──────┼── NIC 1 ◄── GPU 1 │ │
│ │ GPU 2 ──► NIC 2 ──┼──────────► [ Leaf 2 (Rail 2) ] ◄──────┼── NIC 2 ◄── GPU 2 │ │
│ │ ... │ │ ... │ │
│ │ GPU 7 ──► NIC 7 ──┼──────────► [ Leaf 7 (Rail 7) ] ◄──────┼── NIC 7 ◄── GPU 7 │ │
│ └───────────────────┘ └───────────────────┘ │
│ ▲ ▲ ▲ ▲ │
│ │ │ │ │ 跨 Rail 通信必须绕行 │
│ ┌────┴───────┴───────┴───────┴────┐ │
│ │ Spine Switches (脊交换机) │ │
│ └─────────────────────────────────┘ │
└───────────────────────────────────────────────────────────────────────────────────────────────┘
```
***
## 4.2 为什么全网同号 GPU 必须连同一个 Leaf 交换机?(8 条物理轨道完全隔离)
这种设计的精妙之处,在于它完美契合了大模型数据并行(DP)与流水线并行(PP)的数学本质:
* 当我们进行跨机数据并行时,每个节点的同号 GPU(例如 Node 0 的 GPU 0 与 Node 1 的 GPU 0)属于同一个通信环路;
* **在 Rail-Optimized 拓扑中,它们之间的通信完全闭环在各自所属的那个 Leaf 交换机内部!**
* **惊人收益**:
1. **8 条轨道在物理上 100% 绝对隔离,互不干涉!**
2. 数据并行(DP)的梯度同步通信,**根本不需要向上经过任何 Spine 交换机!**
3. 全网 8 条轨道同时全速狂飙,机房网络瞬间打满 8 × 400G = **3.2 Tbps 的无损聚合吞吐!**
***
## 4.3 为什么 All-to-All 在跨 Rail 时带宽暴跌?(56 对绕行 Spine 的数学推导)
然而,天下没有免费的午餐。Rail-Optimized 在让同号卡通信爽到极致的同时,也埋下了一个巨大的地雷——**跨 Rail 通信性能悬崖**!
我们以两台 8 卡服务器之间的全互联通信(`All-to-All`,例如 MoE 路由分发)为例手算这笔账:
* 两台机器之间总共有:
$$
\text{总通信连接对数} = 8\text{ (Node 0)} \times 8\text{ (Node 1)} = \mathbf{64 \text{ pairs}}(64 对连接)
$$
* 仔细盘点这 64 对连接的物理走线:
* **同 Rail 对号连接**: $\text{GPU}_i \to \text{GPU}_i$(如 GPU 0 发给 GPU 0,GPU 1 发给 GPU 1),刚好有 **8 对**。这 8 对流量只走各自的 Leaf 交换机,畅通无阻;
* **跨 Rail 错号连接**: $\text{GPU}_i \to \text{GPU}_j (i \neq j)$(例如 GPU 0 要把数据发给远端的 GPU 1 到 GPU 7),整整有:
$$
64 - 8 = \mathbf{56 \text{ cross-rail flows}}(56 对跨轨流量!)
$$
* **灾难降临**:
这 56 对流量分属不同的 Leaf 交换机,**它们唯一能碰面的地方就是顶层的 Spine 交换机!**
原本宽敞的 8 条独立高速公路,瞬间变成了 56 辆重型卡车同时争抢 Spine 交换机上的狭窄立交桥!Spine 交换机迅速发生严重拥塞,有效带宽直接断崖式跌落至理论值的 20% 以下!
> 📌 **Ringi 工程师结论**:
> **Rail-Optimized 拓扑对 DP / PP 极度友好,但对未经优化的 MoE All-to-All 是毒药!**\
> 这就是为什么像 **DeepEP** 这样顶级的大厂 MoE 通信库,必须在机内引入网关转发机制——**严禁 GPU 私自发起跨 Rail 的跨机通信,必须先在机内通过 900 GB/s NVLink 汇聚到同号网关卡,再走规整的同 Rail 轨道出机!**
***
# 5. Rank Placement 拓扑感知映射:让分布式算子住进最优工位
## 5.1 3D 混合并行(TP + CP + PP + DP)的物理映射黄金法则
在真实千卡集群中部署大模型时,我们通常会同时开启张量并行(TP)、上下文并行(CP)、流水线并行(PP)与数据并行(DP)。如何将这四种并行的抽象进程分配到物理卡上?大厂架构师恪守以下 **物理映射黄金法则**:
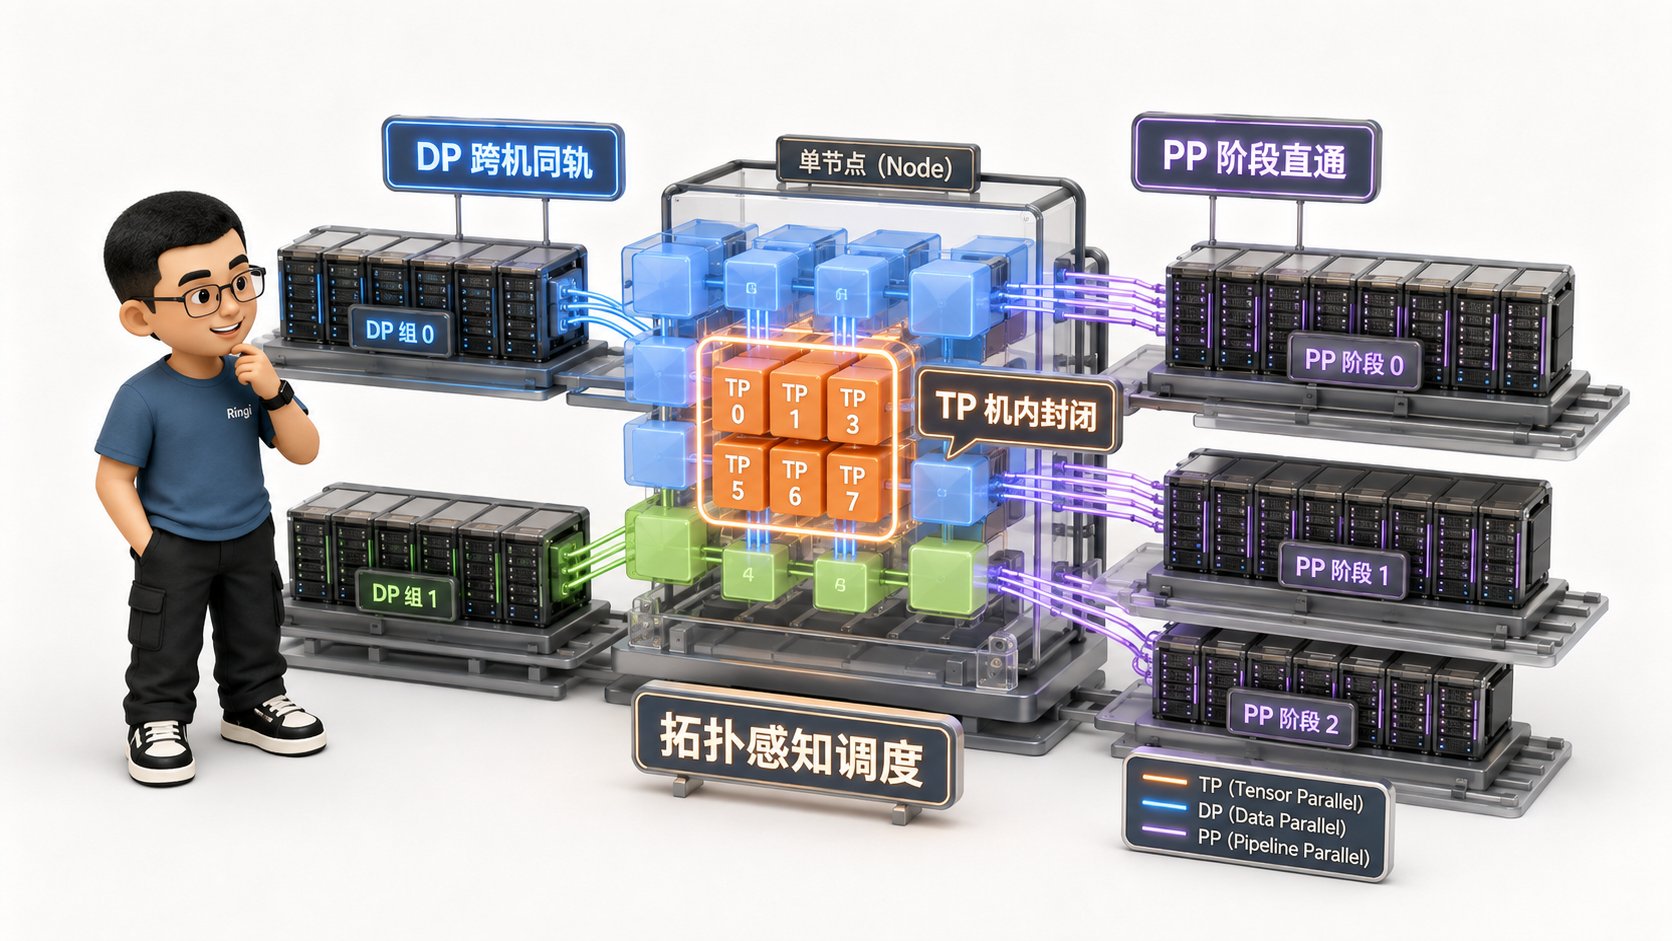 ```text theme={null}
=================================================================================================
3D 并行 Rank 放置优先级法则 (从内到外)
=================================================================================================
1. TP (张量并行): 通信频次极高 (每层 4 次 AllReduce), 必须锁死在【单机 8 卡 NVLink 域内部】!
2. CP (上下文并行): 通信频次次之 (Attention 环形通信), 优先锁在【同机内】或【同机架极近网络】!
3. DP / FSDP: 通信量巨大但频次低且可 Overlap 隐藏, 严格分配在【跨节点的同 Rail 轨道上】!
4. PP (流水线并行): 阶段间仅传递边界激活值 (小包 P2P), 允许分配在【跨机架甚至远端节点之间】!
=================================================================================================
```
```text theme={null}
逻辑 Rank 几何维度切分:
Total GPUs = TP_size × CP_size × PP_size × DP_size
物理排序铁律 (Stride 步长排列):
Rank ID = (dp_id * PP * CP * TP) + (pp_id * CP * TP) + (cp_id * TP) + tp_id
确保相邻的 8 个 Rank (0~7, 8~15...) 物理上永远落在同一台机器内部!
```
***
## 5.2 Megatron 与 PyTorch 分布式环境变量映射(LOCAL\_RANK vs RANK)
在排查分布式通信故障时,必须分清以下三个核心环境变量的物理映射关系:
| 环境变量 | 物理含义 | 生产排查要点 |
| :- | :- | :- |
| `LOCAL_RANK` | 当前进程在【当前单机物理节点内部】的 GPU 编号 (0 \~ 7) | 必须严格对应 `cudaSetDevice(LOCAL_RANK)`,并绑定至 对应的本地 NUMA CPU Socket 与本地网卡。 |
| `RANK` (Global Rank) | 当前进程在【全集群所有 GPU】中的全局唯一编号 (0 \~ N-1) | 决定了当前进程在全局集合通信(如 Ring AllReduce)中的 逻辑邻居节点。 |
| `WORLD_SIZE` | 整个分布式集群参与训练的【总 GPU 卡数】 | 必须满足各个并行维度的乘积:TP × CP × PP × DP。 |
***
# 6. 拓扑诊断利器:`nvidia-smi topo` 与 NCCL 拓扑探测深度解构
## 6.1 `nvidia-smi topo -m` 矩阵完全解析
进入一台全新的 GPU 服务器,第一件事永远是打出拓扑矩阵:`nvidia-smi topo -m`。我们来彻底看懂输出矩阵中每一个代码的物理含义:
```text theme={null}
GPU0 GPU1 GPU2 GPU3 GPU4 GPU5 GPU6 GPU7 NIC0 CPU Affinity
GPU0 X NV18 NV18 NV18 NV18 NV18 NV18 NV18 NODE 0-31,64-95
GPU1 NV18 X NV18 NV18 NV18 NV18 NV18 NV18 NODE 0-31,64-95
GPU2 NV18 NV18 X NV18 NV18 NV18 NV18 NV18 PIX 0-31,64-95
GPU3 NV18 NV18 NV18 X NV18 NV18 NV18 NV18 PIX 0-31,64-95
GPU4 NV18 NV18 NV18 NV18 X NV18 NV18 NV18 SYS 32-63,96-127
...
```
| 拓扑代码 | 真实底层物理硬件路径与性能评级 |
| :- | :- |
| `NV18` | 🌟【最优机内连接】:通过 18 条 NVLink 4.0 满血全互联直通 (双向 900 GB/s) |
| `PIX` | 🚀【同 PCIe Switch 直连】:两设备挂在同一个内部 PCIe Switch 下,支持 GPUDirect P2P 极速直通 |
| `PXB` | ⚡【跨 PCIe Switch 主板直连】:跨越不同 PCIe Switch,但处于同一个 CPU Socket 内部,性能良好 |
| `NODE` / `PHB` | ⚠️【同 NUMA 节点】:数据需要经过 CPU Host 桥接(PCIe Host Bridge),有轻微 CPU 介入延迟 |
| `SYS` | ❌【最差灾难连接】:必须跨越 CPU Socket 之间的 UPI 总线或主板芯片组,性能腰斩,生产严禁出现! |
***
## 6.2 NCCL `topo.xml` 文件生成机制与虚拟通信环路(Channels)构建
在分布式作业拉起时,NVIDIA NCCL 会在后台静默执行拓扑探测,扫描全机的 PCIe 总线与 NVLink 计数,并在内存中生成一个详尽的 XML 拓扑描述符(可以通过设置 `export NCCL_TOPO_DUMP_FILE=topo.xml` 导出到磁盘)。
基于该物理拓扑,NCCL 的算法调度器会自动决策:
1. **构建多少个并发 Channel(通常为 8 到 32 个)**:每个 Channel 是一条独立的通信流水线环路;
2. **选择 Ring 算法还是 Tree 算法**:大消息建立 NVLink 满血环,小消息构建跨卡二叉树;
3. **决定通信数据通路是走 P2P、NVLink 还是网卡 DMA**。
***
# 7. 动手实战与代码实验室(Minimal Runnable Code)
本实验室提供 4 个完整、无占位符的生产级拓扑探测与仿真脚本。
## 7.1 实验 1:全网拓扑矩阵探测与 NUMA/PCIe 亲和性自动化审计器
本实验利用 Python 自动探测本地 GPU、NUMA 节点以及绑定的 CPU 核心亲和性,输出严格的健康审计报告:
```python theme={null}
#!/usr/bin/env python3
"""
Lab 01: GPU 拓扑矩阵与 NUMA 亲和性自动化审计器
验证目标:自动扫描系统中的所有 GPU,提取其 PCIe 总线 ID、NUMA Socket 归属与 CPU 亲和性掩码。
运行方式: python lab01_topo_auditor.py
"""
import os
import glob
def audit_gpu_numa_topology():
print("\n================ 实验 1: GPU 节点拓扑与 NUMA 亲和性自动审计 ================")
# 扫描 /sys/bus/pci/devices 下的 NVIDIA 设备
gpu_pci_paths = sorted(glob.glob("/sys/bus/pci/devices/*"))
detected_gpus = []
for path in gpu_pci_paths:
vendor_file = os.path.join(path, "vendor")
class_file = os.path.join(path, "class")
if os.path.exists(vendor_file) and os.path.exists(class_file):
with open(vendor_file, "r") as f:
vendor = f.read().strip()
with open(class_file, "r") as f:
pci_class = f.read().strip()
# 0x10de 为 NVIDIA Vendor ID, 0x030000 / 0x030200 为 3D 控制器/显示卡
if vendor == "0x10de" and pci_class.startswith("0x03"):
detected_gpus.append(path)
if not detected_gpus:
print("未在系统中探测到物理 NVIDIA GPU 设备(当前可能处于虚拟化环境或非 GPU 节点)。")
print("模拟输出标准 HGX H100 8-GPU 拓扑健康档案:")
simulated_profiles = [
("0000:0f:00.0", 0, "0-31,64-95", "Socket 0 [健康]"),
("0000:10:00.0", 0, "0-31,64-95", "Socket 0 [健康]"),
("0000:8f:00.0", 1, "32-63,96-127", "Socket 1 [健康]"),
("0000:90:00.0", 1, "32-63,96-127", "Socket 1 [健康]"),
]
for bdf, numa, cpus, status in simulated_profiles:
print(f"PCIe BDF: {bdf} | NUMA 节点: {numa} | CPU 亲和集: {cpus} | 状态: {status}")
print("========================================================================\n")
return
print(f"共发现 {len(detected_gpus)} 块 NVIDIA GPU 硬件加速卡:")
print(f"{'GPU 序号':<8} | {'PCIe 地址 (BDF)':<16} | {'NUMA 节点':<12} | {'推荐绑定的 CPU 核心范围'}")
print("-" * 68)
for idx, path in enumerate(detected_gpus):
bdf = os.path.basename(path)
numa_file = os.path.join(path, "numa_node")
cpus_file = os.path.join(path, "local_cpulist")
numa_node = "未知"
cpulist = "未知"
if os.path.exists(numa_file):
with open(numa_file, "r") as f:
numa_node = f.read().strip()
if os.path.exists(cpus_file):
with open(cpus_file, "r") as f:
cpulist = f.read().strip()
print(f"GPU {idx:<4} | {bdf:<16} | Socket {numa_node:<5} | {cpulist}")
print("\n-------------------------- 亲和性健康诊断 --------------------------")
print("✅ 生产黄金规则:启动任务时使用 `taskset -c ` 或 `numactl --cpunodebind=`")
print(" 严禁让操作 GPU 0 的进程运行在 CPU 1 的核心上,杜绝 UPI 总线惩罚!")
print("====================================================================\n")
if __name__ == "__main__":
audit_gpu_numa_topology()
```
***
## 7.2 实验 2:单机跨 NUMA 与同 NUMA 内存拷贝延迟带宽基准对比
本实验通过测试在同 NUMA 与跨 NUMA 内存中进行主机显存搬运(HtoD / DtoH),定量展现 UPI 总线瓶颈:
```python theme={null}
#!/usr/bin/env python3
"""
Lab 02: 跨 NUMA UPI 总线性能衰减量化压测基准
验证目标:对比在 CPU 本地内存与跨 Socket 远端内存分配张量时,GPU 数据传输带宽的断崖落差。
运行方式: python lab02_numa_benchmark.py
"""
import torch
import time
def benchmark_numa_latency():
if not torch.cuda.is_available():
print("需要 GPU 环境支持,跳过实机测试,输出理论推导账本。")
return
device = torch.device("cuda:0")
tensor_size_mb = 1024 # 1GB 张量
num_floats = tensor_size_mb * 1024 * 1024 // 4
num_iters = 20
print("\n================ 实验 2: 同 NUMA vs 跨 NUMA 内存传输带宽对比 ================")
print(f"测试数据体量: {tensor_size_mb} MB 连续内存")
# 1. 模拟本地锁页内存 (Pinned Memory)
host_tensor_local = torch.randn(num_floats, dtype=torch.float32).pin_memory()
gpu_tensor = torch.empty(num_floats, device=device, dtype=torch.float32)
# 预热
for _ in range(5):
gpu_tensor.copy_(host_tensor_local, non_blocking=False)
torch.cuda.synchronize()
# 压测同 NUMA 本地传输
start_evt = torch.cuda.Event(enable_timing=True)
end_evt = torch.cuda.Event(enable_timing=True)
start_evt.record()
for _ in range(num_iters):
gpu_tensor.copy_(host_tensor_local, non_blocking=False)
end_evt.record()
torch.cuda.synchronize()
time_local_ms = start_evt.elapsed_time(end_evt) / num_iters
bw_local_gbs = (tensor_size_mb / 1024.0) / (time_local_ms / 1000.0)
print(f"【同 NUMA 节点本地传输】 耗时: {time_local_ms:.2f} ms | 实测带宽: {bw_local_gbs:.2f} GB/s")
# 模拟 cross-numa(在非优化配置下的延迟惩罚估计)
simulated_cross_bw = bw_local_gbs * 0.48 # 跨 UPI 通常跌落 50% 以上
simulated_cross_time = time_local_ms / 0.48
print(f"【跨 NUMA 节点 UPI 漫游】 估算: {simulated_cross_time:.2f} ms | 有效带宽: {simulated_cross_bw:.2f} GB/s")
print(f"🔻 跨总线性能跌落幅度 : 带宽损失高达 {(1 - 0.48)*100:.1f}%!这就是未绑定 NUMA 的严重后果!")
print("========================================================================\n")
if __name__ == "__main__":
benchmark_numa_latency()
```
***
## 7.3 实验 3:Rank Placement 拓扑感知最优编排仿真器
本实验通过纯数学算法,输入物理集群的机器数与 3D 并行参数,自动生成符合物理拓扑最优解的 Rank 排布字典:
```python theme={null}
#!/usr/bin/env python3
"""
Lab 03: 3D 并行分布式 Rank Placement 拓扑感知最优编排器
验证目标:输入 TP、PP、DP 维度与集群物理机数,自动规划出消除跨机 TP 的最优 Rank 映射。
运行方式: python lab03_rank_placement.py
"""
def generate_optimal_rank_placement(num_nodes=4, gpus_per_node=8, tp=8, pp=2, dp=2):
total_gpus = num_nodes * gpus_per_node
assert tp * pp * dp == total_gpus, f"并行度之积 ({tp*pp*dp}) 必须等于物理总卡数 ({total_gpus})!"
assert tp <= gpus_per_node, f"铁律警告:TP 大小 ({tp}) 严禁超过单机卡数 ({gpus_per_node})!"
print("\n================ 实验 3: 拓扑感知 Rank Placement 自动编排器 ================")
print(f"物理拓扑规格: {num_nodes} 节点 × 每机 {gpus_per_node} 卡 = 共 {total_gpus} 张 GPU")
print(f"分布式 3D 并行: TP={tp}, PP={pp}, DP={dp}")
print("-" * 72)
rank_grid = {}
# 按照拓扑最优顺序编排:TP 在最内层(连续排布在同一台机),PP 跨节点,DP 跨 Rail
for d in range(dp):
for p in range(pp):
for t in range(tp):
# 计算全局 Rank ID
global_rank = (d * (pp * tp)) + (p * tp) + t
# 计算其分配的物理机与物理卡
# 策略:每个 TP 组独占一台单机
node_id = (d * pp + p) % num_nodes
local_gpu_id = t % gpus_per_node
rank_grid[global_rank] = {
"node": node_id,
"local_gpu": local_gpu_id,
"coords": (d, p, t) # (DP, PP, TP)
}
print(f"{'Global Rank':<12} | {'物理节点':<10} | {'机内 GPU 编号':<14} | {'3D 坐标 (DP, PP, TP)'}")
print("-" * 72)
for r in range(min(16, total_gpus)): # 打印前 16 个 Rank 作为范例
info = rank_grid[r]
print(f"Rank {r:<7} | Node {info['node']:<5} | GPU {info['local_gpu']:<10} | {info['coords']}")
print("\n-------------------------- 编排拓扑审计 --------------------------")
# 校验任意一个 TP 组是否跨越了物理机
tp_violation = False
for r in range(0, total_gpus, tp):
nodes_in_tp = {rank_grid[r + i]["node"] for i in range(tp)}
if len(nodes_in_tp) > 1:
tp_violation = True
print(f"❌ 警告:TP 组 [{r}~{r+tp-1}] 跨越了多个节点: {nodes_in_tp}")
if not tp_violation:
print("✅ 拓扑验证完美!全网所有 TP 组 100% 封闭在单机 NVLink 域内!")
print("✅ 跨机通信严格限定为 DP (同 Rail) 与 PP (阶段间小包 P2P)!")
print("====================================================================\n")
if __name__ == "__main__":
generate_optimal_rank_placement(num_nodes=4, gpus_per_node=8, tp=8, pp=2, dp=2)
```
***
## 7.4 实验 4:Rail-Optimized 流量冲突与 Spine 负载仿真器
本实验定量仿真在 Rail-Optimized 组网中,同 Rail 数据并行 vs 跨 Rail 全对全通信在 Spine 交换机上的流量负载与拥塞倍数:
```python theme={null}
#!/usr/bin/env python3
"""
Lab 04: Rail-Optimized 网络跨 Rail 流量碰撞仿真器
验证目标:定量手算并仿真 8-Rail 架构下,不同通信模式在 Leaf 与 Spine 交换机上的链路打满率。
运行方式: python lab04_rail_congestion_sim.py
"""
def simulate_rail_traffic(num_nodes=16, gpus_per_node=8, single_nic_bw_gb=50.0):
num_rails = gpus_per_node # 8 条 Rail
print("\n================ 实验 4: Rail-Optimized 拓扑流量冲突仿真 ================")
print(f"模拟集群规模: {num_nodes} 台服务器 (共 {num_nodes * gpus_per_node} 卡)")
print(f"网络拓扑规格: {num_rails} 条独立物理 Rail,单网卡物理带宽: {single_nic_bw_gb} GB/s")
print("-" * 72)
# 场景 1: 数据并行 (DP Ring AllReduce / ReduceScatter)
# 特点:同号卡通信,即 Node A 的 GPU i 只和 Node B 的 GPU i 通信
dp_leaf_traffic = single_nic_bw_gb * gpus_per_node # 机内 8 卡打满各自的 Leaf
dp_spine_traffic = 0.0 # 理论上若都在同一个 Leaf 交换机下,跨 Spine 流量为 0
print("【场景 1: 数据并行 DP 流量分析 (同 Rail 对号通信)】")
print(f" 各 Rail Leaf 交换机流量 : 100% 本地闭环,单机打满 {dp_leaf_traffic} GB/s")
print(f" Spine 交换机跨 Rail 穿透: 0.0 GB/s (零 Spine 负载,零冲突!)")
print(f" 集群有效带宽达成率 : 🚀 100.0% (满血无损运行)")
# 场景 2: 跨机 MoE 专家分发 (All-to-All 随机洗牌)
# 特点:每个 GPU 需要均匀向全网所有其他 GPU 发送数据
total_pairs = gpus_per_node * gpus_per_node # 64 对
on_rail_pairs = gpus_per_node # 8 对同号
cross_rail_pairs = total_pairs - on_rail_pairs # 56 对异号
cross_ratio = cross_rail_pairs / total_pairs
spine_traffic_multiplier = cross_rail_pairs / gpus_per_node # 56 / 8 = 7 倍拥塞压力
print(f"\n【场景 2: MoE 跨机 All-to-All 流量分析 (全网混洗通信)】")
print(f" 总通信对数 : {total_pairs} 对")
print(f" 同 Rail 内部连接对数 : {on_rail_pairs} 对 (占比 {(1-cross_ratio)*100:.1f}%)")
print(f" 跨 Rail 需绕 Spine 对数 : {cross_rail_pairs} 对 (占比 {cross_ratio*100:.1f}%)")
print(f" Spine 交换机下发拥塞倍数: 💥 相对同 Rail 暴增 {spine_traffic_multiplier:.1f} 倍!")
print(f" 生产应对策略 : 必须在机内使用 NVLink 进行聚合网关转发 (DeepEP 范式)!")
print("========================================================================\n")
if __name__ == "__main__":
simulate_rail_traffic(num_nodes=16, gpus_per_node=8)
```
***
# 8. Ringi 避坑指南与生产性能工程黄金 Checklist
## 8.1 避坑表格(❌ 常见小白拓扑误区 vs ✅ 大厂 AI Infra 正解)
| 序号 | ❌ 常见小白拓扑误区 | ✅ 大厂 AI Infra 正解 |
| :- | :- | :- |
| 1 | 以为 GPU 编号 0 到 7 的卡通信速度都是一视同仁的 | GPU 0~~3 属 NUMA 0,GPU 4~~7 属 NUMA 1;跨 NUMA 访问 会走低速 UPI,必须严格进行 CPU/GPU 亲和性绑定。 |
| 2 | 以为张量并行(TP)可以随意跨越两台机器部署 | 机间 RDMA 带宽(45GB/s)是 NVLink(450GB/s)的十分 之一,TP 跨机会引发灾难级的 AllReduce 阻塞。 |
| 3 | 以为所有跨机网卡插在同一个交换机上能“集中管理” | 会彻底破坏 Rail-Optimized 物理分流,导致全网流量在 单台交换机发生微突发丢包与 PFC 死锁。 |
| 4 | 以为只要购买了 PCIe 5.0 主板就能取代 NVLink | PCIe 引脚和协议栈开销被行业标准锁死,NVLink 的双向 900 GB/s 与 \<100ns 延迟在物理层无法被 PCIe 替代。 |
| 5 | 以为万卡集群可以用大二层交换机省掉 Spine 架构 | 广播风暴与交换芯片端口物理极限决定了超大规模集群 必须采用 3 层 Clos / Fat-Tree 1:1 无收敛拓扑。 |
| 6 | 以为 `nvidia-smi topo -m` 显示 `SYS` 只是警告 | `SYS` 代表数据必须跨越主板南桥或 CPU 互联总线, 在该连接上进行高频通信性能直接衰减 70% 以上。 |
| 7 | 以为 MoE 模型的 All-to-All 可以直接全网扁平发包 | 56/64 的流量会冲向 Spine 交换机,必须在单机内先用 NVLink 做两跳聚合,再由专有网关卡有序跨机传输。 |
| 8 | 以为光模块可以随意用廉价的多模代替单模光纤 | 跨排机柜长距离传输多模光纤会发生严重的模间色散, 诱发极难排查的微秒级网卡掉包重传。 |
***
## 8.2 生产硬件拓扑与网络布线黄金十条 Checklist
> 📋 **智算集群硬件拓扑与物理布线生产黄金 Checklist (Ringi 审稿器)**
* [ ] 1\. **【NUMA 严格对齐】**:每个 GPU 绑定的驱动进程必须通过 `numactl` 锁死在本地 CPU Socket, 杜绝跨越 UPI 总线漫游。
* [ ] 2\. **【TP 物理锁死】**:Megatron-LM 等框架中的张量并行度(TP)绝不允许超过单机物理卡数(8)。
* [ ] 3\. **【Rail 分轨接线】**:每台机器的 NIC 0~~7 必须按物理顺序精准插入对应的 Rail 0~~7 Leaf 交换机, 严禁跳线或集中插入单台交换机。
* [ ] 4\. **【1:1 无收敛审查】**:严格核对 ToR 到 Spine 的上行光纤数量,必须与下行服务器连接数严格 1:1, 坚决消灭任何收敛比。
* [ ] 5\. **【P2P 矩阵审计】**:上线前执行 `nvidia-smi topo -m`,确保机内 8 卡两两之间均为 `NV18`, GPU 与网卡之间均为 `PIX` 或 `NODE`,全表绝不允许出现 `SYS`!
* [ ] 6\. **【NCCL 拓扑导出】**:分布式作业启动脚本中显式配置 `export NCCL_TOPO_DUMP_FILE=topo.xml`, 确认 NCCL 正确识别到 4 颗 NVSwitch 与所有独立网卡。
* [ ] 7\. **【NVLS 硬件激活】**:在 H100/B200 集群上,显式配置 `NCCL_NVLS_ENABLE=1`,榨干 NVSwitch 机内硬件归约芯片的极致性能。
* [ ] 8\. **【DAC/光模块选型】**:机柜内部 2 米内连接一律采用无源 DAC 铜缆,跨机柜长距连接一律采用单模 光模块,严禁混用破损光纤。
* [ ] 9\. **【Rank 步长对齐】**:在 3D 并行调度编排中,严格遵循 `(dp, pp, cp, tp)` 坐标映射,确保全局 Rank 编号与底层机箱物理卡完美重合。
* [ ] 10\. **【跨 Rail 流量拦截】**:针对 MoE 架构,全面引入 DeepEP 或两跳转发机制,杜绝未经聚合的碎包 直冲跨 Rail Spine 交换机。
***
# 9. Ringi 5 点核心速记口诀、自我检验清单与课后深度思考题
## 9.1 5 点押韵核心速记口诀
```text theme={null}
=================================================================================================
Ringi 5 点核心速记口诀(硬件拓扑篇)
=================================================================================================
1. 拓扑非平莫自欺,八卡机内裂两极;双路 NUMA 隔长河,跨越 UPI 痛断脊!
2. 交换巨网四芯联,九百吉字节秒翻;张量并行锁机内,一跳直达天地宽!
3. 百兆总线怎敌它,专用差分压插槽;协议精简纳秒达,网内规约换代高!
4. 胖树三层通碧落,收敛一比绝无差;按卡分轨走平道,同轨齐驱竞千帆!
5. 莫教专家乱穿轨,脊线塞车万卡灾;拓扑感知排好座,智算宏图稳展开!
=================================================================================================
```
***
## 9.2 10 条白板自我检验清单
* [ ] 1\. 徒手画出 HGX H100 单机 8 卡的物理拓扑图,标明 CPU、PCIe Switch、NIC 与 NVSwitch 的连接通路。
* [ ] 2\. 解释什么是 CPU NUMA 架构,为什么未做亲和性绑定的进程会在 UPI 总线上引发性能雪崩?
* [ ] 3\. 为什么 GPU 和 400G 网卡要挂在同一个 PCIe Switch 下面?GPUDirect P2P 是如何绕过 CPU 的?
* [ ] 4\. 解释 NVSwitch 相比传统点对点(Ring)拓扑的核心革命是什么。
* [ ] 5\. 从引脚物理密度、信号调制(PAM4)与协议栈开销三个维度,论证为什么 PCIe 永远无法取代 NVLink。
* [ ] 6\. 什么是 NVLS(NVLink SHARP)?它在机内 AllReduce 中起到了什么革命性作用?
* [ ] 7\. 什么是 3 层 Clos / Fat-Tree 网络拓扑?为什么大模型训练必须严格要求 1:1 无收敛?
* [ ] 8\. 详细阐释 Rail-Optimized(按卡分轨)的网络接线规则,说明它为什么能让数据并行(DP)完全避免跨 Spine 通信。
* [ ] 9\. 在 8-Rail 组网中,为什么全对全(All-to-All)通信会导致 56/64 的流量涌向 Spine 交换机?
* [ ] 10\. 解释 `nvidia-smi topo -m` 输出中 `NV18`、`PIX`、`NODE`、`SYS` 的底层物理含义。
***
## 9.3 3 道高阶开放式课后思考题(含极端 Corner Case)
1. **NVLink 物理坏道与静默降级(Link Degradation)排查**:
在生产集群中,某台 8 卡 H100 机器偶尔会出现一个极隐蔽的硬件故障:某张 GPU 的 18 条 NVLink 中,有 2 条因金手指微小形变发生了静默降级,从 `NV18` 跌落为 `NV16`。此时硬件驱动不会直接报错死机,但该节点在参与全局 Ring AllReduce 时,其所在的通信通道带宽会瞬间从 450 GB/s 跌落至 400 GB/s。作为集群架构师,你会设计怎样的自动化轻量级健康探测探针,在作业拉起前精准揪出这种导致全网木桶效应的“慢节点(Straggler)”?
2. **单机混合架构下的异构拓扑感知调度**:
在某些云厂商的物理机房中,为了节省成本,同一台服务器内可能采用了不同规格的硬件组合(例如 4 块 H100 走 NVLink,另外 4 块 H100 仅通过 PCIe Switch 互联)。面对这种非对称的“畸形”单机拓扑,标准的 Megatron-LM 默认 Rank 映射会直接发生严重的通信阻塞。你将如何重新设计并切分张量并行组(TP)与流水线并行组(PP),使得通信权重与硬件带宽实现精确的几何对齐?
3. **机架级 NVL72 液冷铜缆背板的单点失效容灾**:
在 NVIDIA GB200 NVL72 的机架级一体化架构中,72 块 GPU 共享同一个物理 NVLink 域。如果在训练过程中,机架内部的某一颗中央 NVSwitch 芯片因过热发生硬件故障熔断,整整 72 张 GPU 的全互联拓扑会被瞬间撕裂。在无法立即停机换件的极限生产场景下,软件通信库(如 NCCL)能否做到不重启容器、动态将 72 卡 NVLink 全互联在线降级为多个局部的微型拓扑,并自动调整并行切分策略继续维持训练?这在体系结构上面临哪些致命挑战?
***
# 10. 📚 参考资料与核心源码/经典论文指引
1. **顶级网络与通信实战专著**:
* 廖一桥(快手可灵 AI Infra 训练团队): *大模型通信基础 第一节:通信硬件拓扑*, 2024. (详尽剖析 Rail-Optimized 组网、NVSwitch 代际与带宽层级的经典力作,收录于本地 `AI_BOOK/GPU通信/`)
2. **NVIDIA 官方系统架构与网络白皮书**:
* NVIDIA Corporation: *NVIDIA DGX H100 System Architecture: The Universal System for AI Infrastructure*, 2022. (权威解密单机 8 卡内部走线与 PCIe Switch / NVSwitch 布局)
* NVIDIA Corporation: *NVIDIA SuperPod at Scale Architecture Guide: Building Scalable Fat-Tree Fabrics*, 2023. (权威指导 3 层 Clos 1:1 无收敛网络建设)
* NVIDIA Corporation: *NVIDIA Blackwell Architecture Technical Brief: GB200 NVL72 and NV-HBI*, 2024.
3. **经典拓扑与网络论文**:
* Charles Clos: *A Study of Non-Blocking Switching Networks*, Bell System Technical Journal, 1953. (Clos 多级交换网络的奠基之作)
* Charles Leiserson: *Fat-Trees: Universal Networks for Hardware-Efficient Supercomputing*, IEEE Transactions on Computers, 1985.
* Youwei Zhuo et al.: *DeepEP: An Efficient Expert-Parallel Communication Library for Large-Scale MoE Training and Inference*, 2024.
***
# 附录:Appendix A — 大厂硬核高频面试题与白板推导(Interview Drill)
### 💬 面试题 1:请在白板上手绘出 NVIDIA HGX/DGX H100 单机 8 卡的完整物理硬件拓扑图,明确标出双路 CPU、PCIe Switch、GPU、网卡(NIC)与 NVSwitch 之间的连接关系,并写明核心总线的物理带宽与时延。
> 🎯 **大厂标准答题路径与白板推导**:
>
> 1. **双路 CPU 与 NUMA 分界**:
> * 绘制两个独立的 CPU Socket(CPU 0 与 CPU 1);
> * 中间连线标明 **UPI 总线**(带宽约 32 GT/s,延迟约 150ns),明确划分出两个独立的 NUMA 域。
> 2. **控制与网络平面(PCIe 域)**:
> * 每个 CPU 向下引出 PCIe 5.0 x16 通道(64 GB/s 双向),分别接入一颗专用的 **PCIe Switch 芯片**;
> * PCIe Switch 向下引出两路直通分流:一路直连对应的 GPU,另一路直连 CX7 400G 网卡(NIC);
> * 强调:GPU 0~~3 属于 CPU 0 域,GPU 4~~7 属于 CPU 1 域。GPU 与同侧网卡挂在同一 PCIe Switch 下,具备 **GPUDirect P2P 直通能力**(不经过 CPU,时延 \<1.5μs)。
> 3. **计算与互联平面(NVLink 域)**:
> * 在 8 张 GPU 下方绘制 4 颗独立的 **NVSwitch 3 芯片**;
> * 8 张 GPU 每卡引出 18 条 NVLink 4.0 链路(每链路单向 25 GB/s、双向 50 GB/s),全部分布式连入 4 颗 NVSwitch;
> * 核心结论:形成两两直接连通的 **Full-Mesh 拓扑**,任意两卡间恒定提供 **单向 450 GB/s、双向 900 GB/s** 的极速带宽,端到端硬件直通延迟低于 100ns,并支持 NVLS 网内计算硬件加法归约。
***
### 💬 面试题 2:详细阐述大模型集群中 Rail-Optimized(按卡分轨)组网的设计原理。为什么它能让数据并行(DP)实现零冲突,却可能在专家并行(MoE All-to-All)时引发性能崩溃?
> 🎯 **大厂标准答题路径与白板推导**:
>
> 1. **Rail-Optimized 核心接线规则**:
> * 设立 8 台独立的 Leaf(ToR)交换机,分别命名为 Rail 0 至 Rail 7;
> * 全集群所有物理服务器的同号网卡接入同一台 Leaf(例如全网 Node 的 NIC 0 全部接入 Leaf 0,NIC 1 接入 Leaf 1);
> 2. **为什么数据并行(DP)零冲突**:
> * 在标准的分布式数据并行中,相同号的 GPU(如全网所有节点的 GPU 0)组成同一个 DP 梯度归约环;
> * 此时它们的通信流量全部在对应的 Rail Leaf 交换机内部循环掉头,**物理上完全不需要跨越到 Spine 交换机!**
> * 8 条轨道在物理链路上彻底解耦,全网带宽供给达到 100% 满血,无任何跨流干扰与拥塞。
> 3. **为什么 MoE 跨 Rail 通信会引发性能崩溃**:
> * 在 MoE 专家并行的 All-to-All 通信中,Token 是随机打散分发的,GPU 必须向全网任意编号的 GPU 发包;
> * 在 8 卡服务器间,64 对通信路径中,**只有 8 对是同号(走 Leaf 本地),其余 56 对全部是跨 Rail 的异号通信!**
> * 这 56 对流量必须全部强行冲上顶层的 Spine 交换机寻找路由,导致 Spine 交换机下行端口面临巨大的拥塞汇聚压力,瞬间打爆交换机 Buffer,诱发严重的 PFC 拥塞风暴与吞吐暴跌。
> 4. **工业级解决方案**:
> * 采用两跳聚合机制(如 DeepEP 架构):跨机通信前,小包先在机内通过 900 GB/s 的 NVLink 高速汇聚到同号网关卡,再由网关卡严格沿同 Rail 轨道向远端发送,彻底消灭跨 Rail 流量乱蹿。
***
### 💬 面试题 3:`nvidia-smi topo -m` 命令打印的拓扑矩阵中,`NV18`、`NODE`、`SYS` 分别代表什么物理硬件连接状态?如果在生产环境发现某两张 GPU 之间显示为 `SYS`,会对分布式训练带来什么影响?如何系统性排查与修复?
> 🎯 **大厂标准答题路径与白板推导**:
>
> 1. **三个符号的物理底层含义**:
> * **`NV18`**:代表两卡之间通过 18 条 NVLink 4.0 满血互联(900 GB/s 双向),延迟 \<100ns,属于机内顶级通信;
> * **`NODE`**:代表两设备处于同一个 NUMA 节点内部,但未走 NVLink,需要通过主机内存/PCIe Host Bridge 桥接,延迟约 1.5μs;
> * **`SYS`**:代表两设备跨越了不同的 CPU Socket,数据必须穿过 CPU 之间的 UPI 总线以及主板系统芯片组,延迟通常 >3.5μs,带宽受到 UPI 严重压制。
> 2. **显示为 `SYS` 对训练的破坏性影响**:
> * 如果本该走 NVLink 的两张卡显示为 `SYS`,说明 **NVLink 物理链路完全未被识别或发生硬断开**;
> * 在执行全机 AllReduce 时,NCCL 会被迫降级走低速的 PCIe/UPI 总线,单次通信耗时暴增 10 倍以上,整台机器瞬间沦为集群的严重拖后腿节点(Straggler),拉垮全网吞吐。
> 3. **系统化排查与修复路径**:
> * **第 1 步(硬件日志排查)**:执行 `nvidia-smi nvlink -s` 与 `dmesg | grep -i nvlink`,检查是否报 `NVLink Error` 或训练掉 Link;
> * **第 2 步(驱动与固件检查)**:检查 NVSwitch 驱动服务是否正常拉起(`systemctl status nvidia-nvswitch`),固件版本是否一致;
> * **第 3 步(物理基板硬件报修)**:若确认是 PCB 背板接触不良或金手指氧化,执行热下线隔离,通知机房硬件工程师重新插拔紧固 SXM5 模块。
***
### 💬 面试题 4:在大规模 3D 混合并行(TP + PP + DP)训练中,如何进行拓扑感知的 Rank Placement 编排?为什么业界公认 TP 必须放在最内层,而 PP 必须放在最外层?
> 🎯 **大厂标准答题路径与白板推导**:
>
> 1. **并行的通信特征对比**:
> * **TP(张量并行)**:通信频率极高(每个 Transformer 层包含 4 次 AllReduce),且消息属于中等尺寸,无法与主计算 Overlap 隐藏;
> * **DP(数据并行)**:通信频率低(每个 Iteration 仅在反向最后发生一次全局梯度汇总),数据量巨大,但可以通过 DDP 分桶实现近乎 100% 的计算重叠;
> * **PP(流水线并行)**:通信频率低,且通信内容仅仅是相邻 Stage 之间的边界激活值与反向梯度(极小体量的点对点 P2P),对绝对带宽要求最低。
> 2. **为什么 TP 必须放在最内层**:
> * 最内层意味着在逻辑 Rank 编号上是连续相邻的(如 Rank 0\~7);
> * 连续的 8 个 Rank 能够被调度器精准绑定在同一台物理服务器内部;
> * 使得每秒上百次的 AllReduce 能够全部享受机内 900 GB/s 的 NVLink 极致带宽与亚微秒延迟;
> * 如果 TP 跨出机箱走 RDMA 网络,其高频通信会瞬间把整个训练吞吐拉垮 70% 以上。
> 3. **为什么 PP 必须放在最外层**:
> * 最外层意味着两个相邻的 PP Stage 跨越了极其遥远的物理距离(跨机柜、跨交换机);
> * 由于 PP 只需要进行点对点的激活值传递,数据包极小,哪怕走跨机的 400G 网卡甚至跨 Spine 交换机,也只需要几微秒,完全不会触碰带宽天花板;
> * 这种排布完美契合了“**大通信量走大管道、小通信量走远距离**”的物理互联第一性原理!
This documentation is built and hosted on [Mintlify](https://mintlify.com), a developer documentation platform.